ट्रांसक्रिप्शन में स्पीकर लेबल: प्रारूप, उदाहरण और गलतियाँ
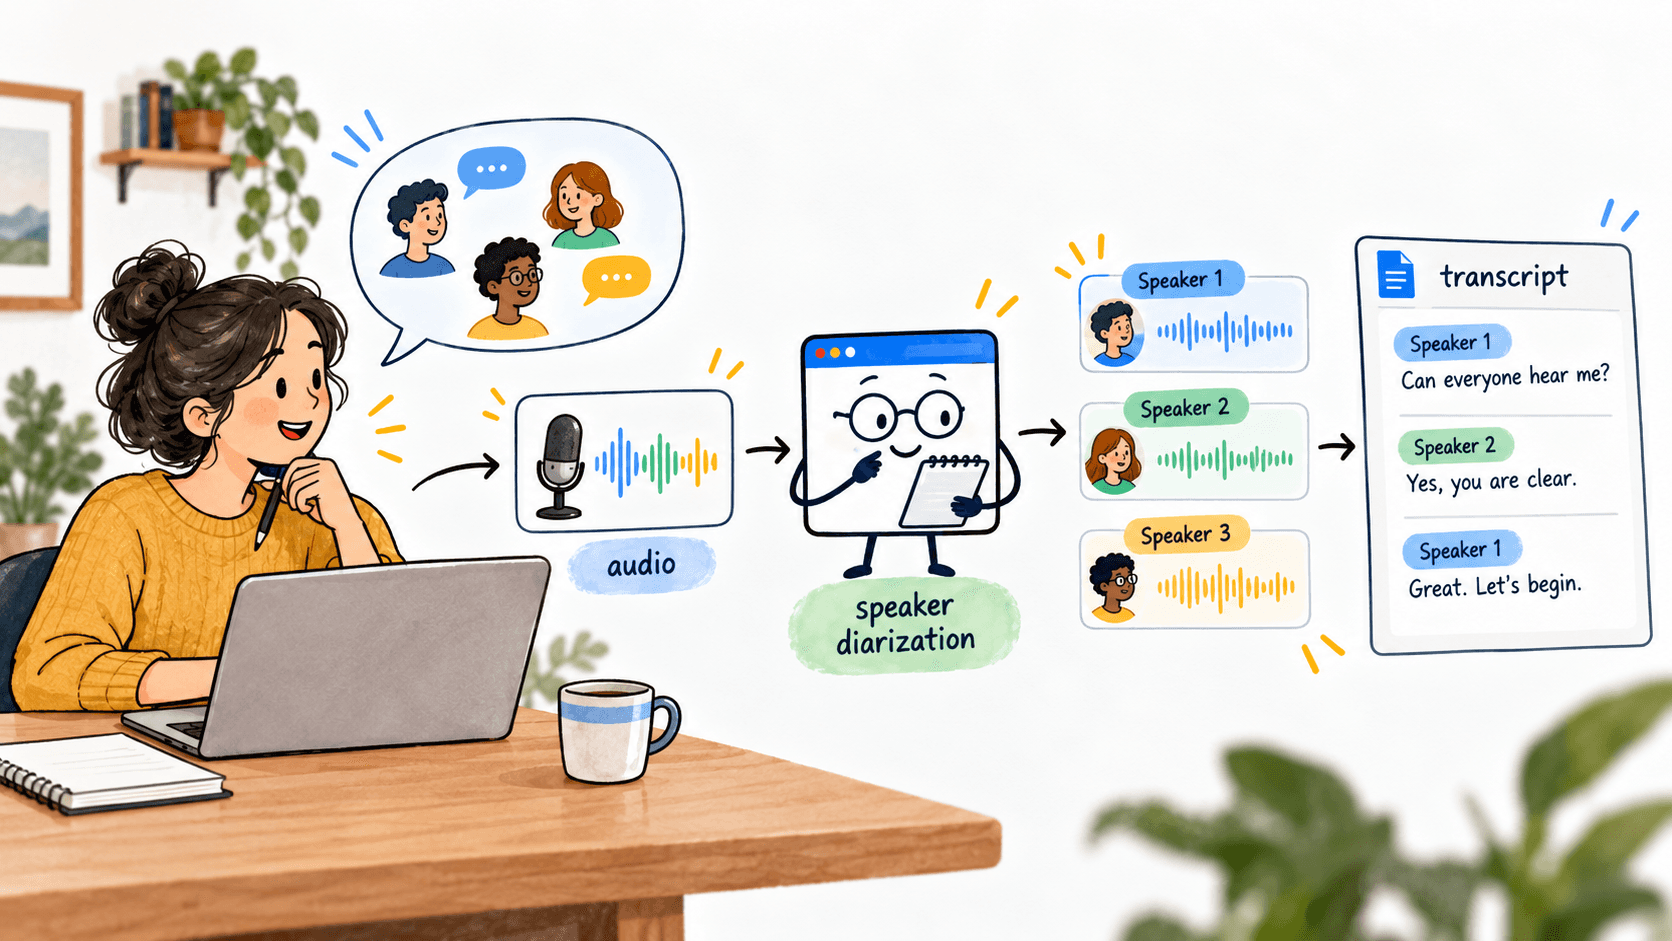
व्यावहारिक ट्रांसक्रिप्शन उदाहरणों के साथ स्पीकर लेबल फ़ॉर्मेट के बारे में जानें। जानें कि लगातार स्पीकर की पहचान कैसे करें और लेबलिंग की सामान्य गलतियों से कैसे बचें।
स्पीकर लेबल किसी ट्रांसक्रिप्ट के नेम टैग की तरह होते हैं। वे आपको बताते हैं कि किसने क्या कहा, एक आवाज़ कहाँ खत्म होती है और दूसरी कहाँ से शुरू होती है। ये लेबल अपने आप में बहुत सरल होते हैं। असली काम तब शुरू होता है जब इन्हें चुनना और लगातार सही ढंग से लागू करना होता है।
कल्पना कीजिए कि आप एक ऐसी बातचीत पढ़ रहे हैं जिसमें से सभी उद्धरण चिह्न (कोटेशन मार्क्स) हटा दिए गए हैं। आप शब्द तो पढ़ सकते हैं, लेकिन आपको यह समझने के लिए बार-बार रुकना पड़ता है कि कौन बोल रहा है।
स्पीकर लेबल के बिना कई वक्ताओं वाली ट्रांसक्रिप्ट ठीक ऐसी ही लगती है।
स्पीकर लेबल एक संक्षिप्त पहचानकर्ता होता है जो किसी व्यक्ति के बोलने से पहले लगाया जाता है। यह 'स्पीकर 1' जैसा कोई सामान्य लेबल, 'साक्षात्कारकर्ता' (इंटरव्यूअर) जैसी कोई भूमिका या किसी व्यक्ति का नाम हो सकता है। इसका उद्देश्य ट्रांसक्रिप्ट को औपचारिक दिखाना नहीं है, बल्कि बातचीत को समझने में आसान बनाना है।
यह सुनने में सीधा लगता है। लेकिन कोई ट्रांसक्रिप्ट बहुत जल्दी भ्रमित करने वाली बन सकती है जब बीच में ही लेबल बदल दिए जाएँ, किसी वक्ता को गलत पहचान दे दी जाए, या लेबलिंग का प्रारूप उपयोग के उद्देश्य से मेल न खाता हो।
तो चलिए देखते हैं कि स्पीकर लेबल क्या होते हैं, इनके सामान्य प्रारूप कौन-से हैं, कौन-सा प्रारूप कब काम आता है, और वे कौन-सी गलतियाँ हैं जो ट्रांसक्रिप्ट को पढ़ने में कठिन बना देती हैं।
स्पीकर लेबल क्या है?
स्पीकर लेबल ट्रांसक्रिप्ट में किसी वक्ता की बारी की शुरुआत को चिह्नित करता है। इसे प्रत्येक भाषण खंड से जुड़े एक छोटे नेम टैग की तरह समझें।
स्पीकर 1: क्या सभी मुझे सुन पा रहे हैं? |
इन लेबलों के बिना भी वे शब्द मौजूद रहेंगे, लेकिन जो गायब हो जाता है, वह है बातचीत की संरचना।
यह तब सबसे अधिक मायने रखता है जब एक से अधिक लोग बोल रहे हों। किसी एक व्यक्ति के वॉयस नोट में वक्ता स्पष्ट होता है। लेकिन किसी पॉडकास्ट, मीटिंग, इंटरव्यू, कस्टमर सपोर्ट कॉल या कानूनी बयान (डिपोजिशन) में यह जानना उतना ही महत्वपूर्ण हो सकता है कि किसने क्या कहा, जितना कि यह जानना कि क्या कहा गया था।
स्पीकर लेबल और स्पीकर डायराइजेशन संबंधित हैं, लेकिन एक जैसे नहीं
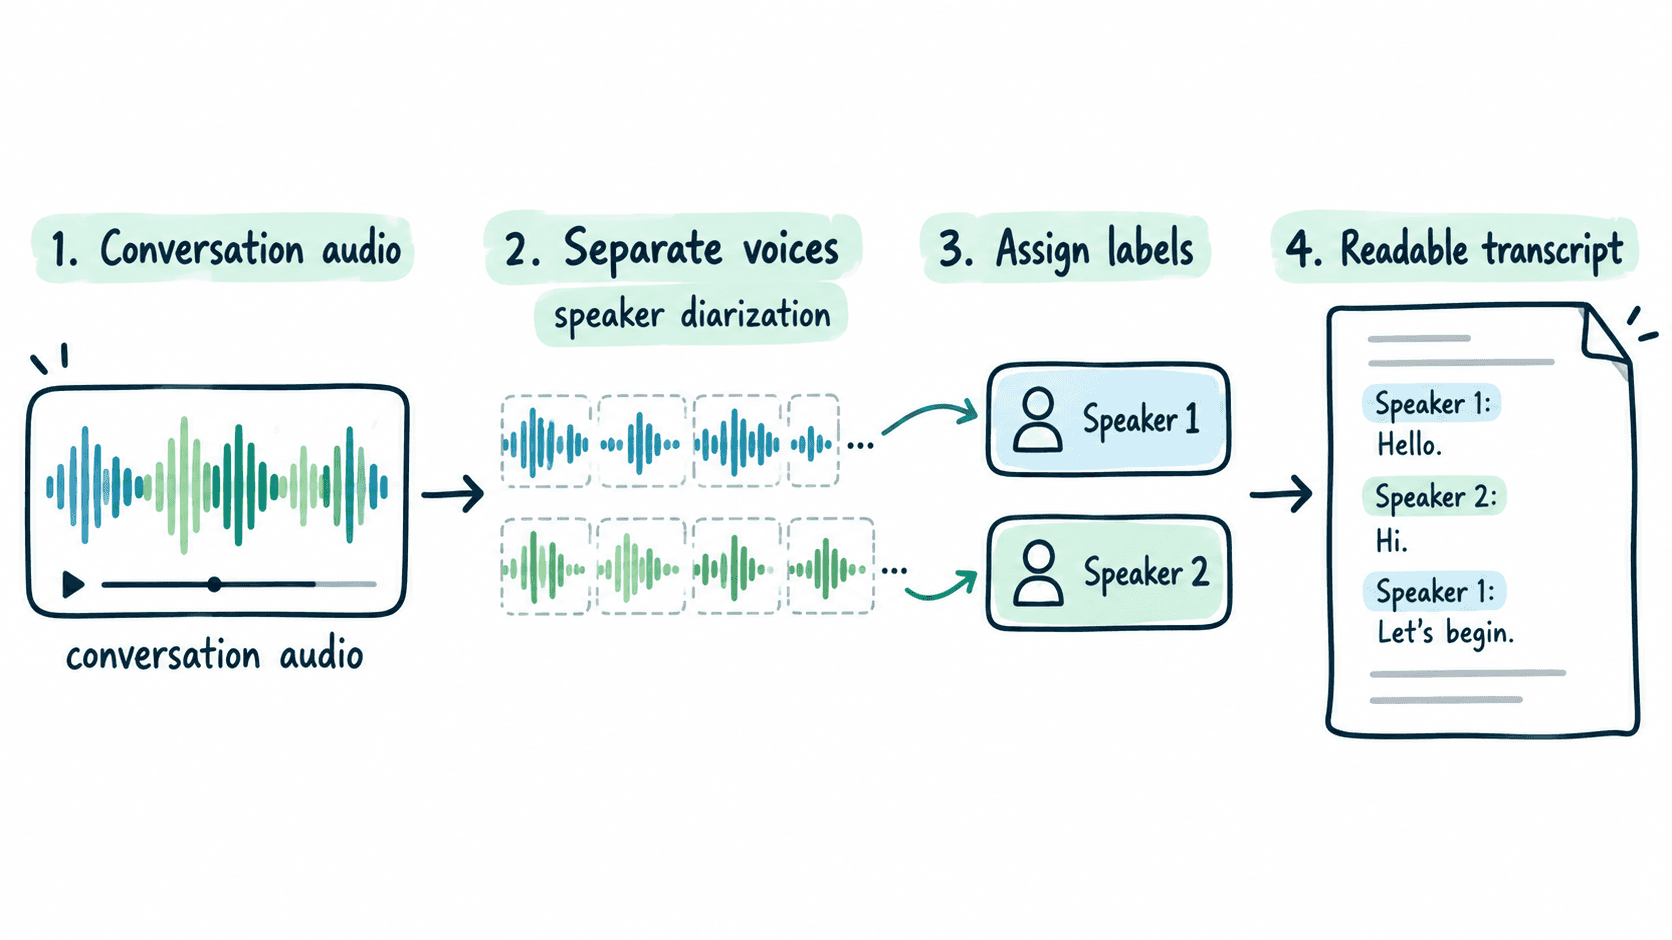
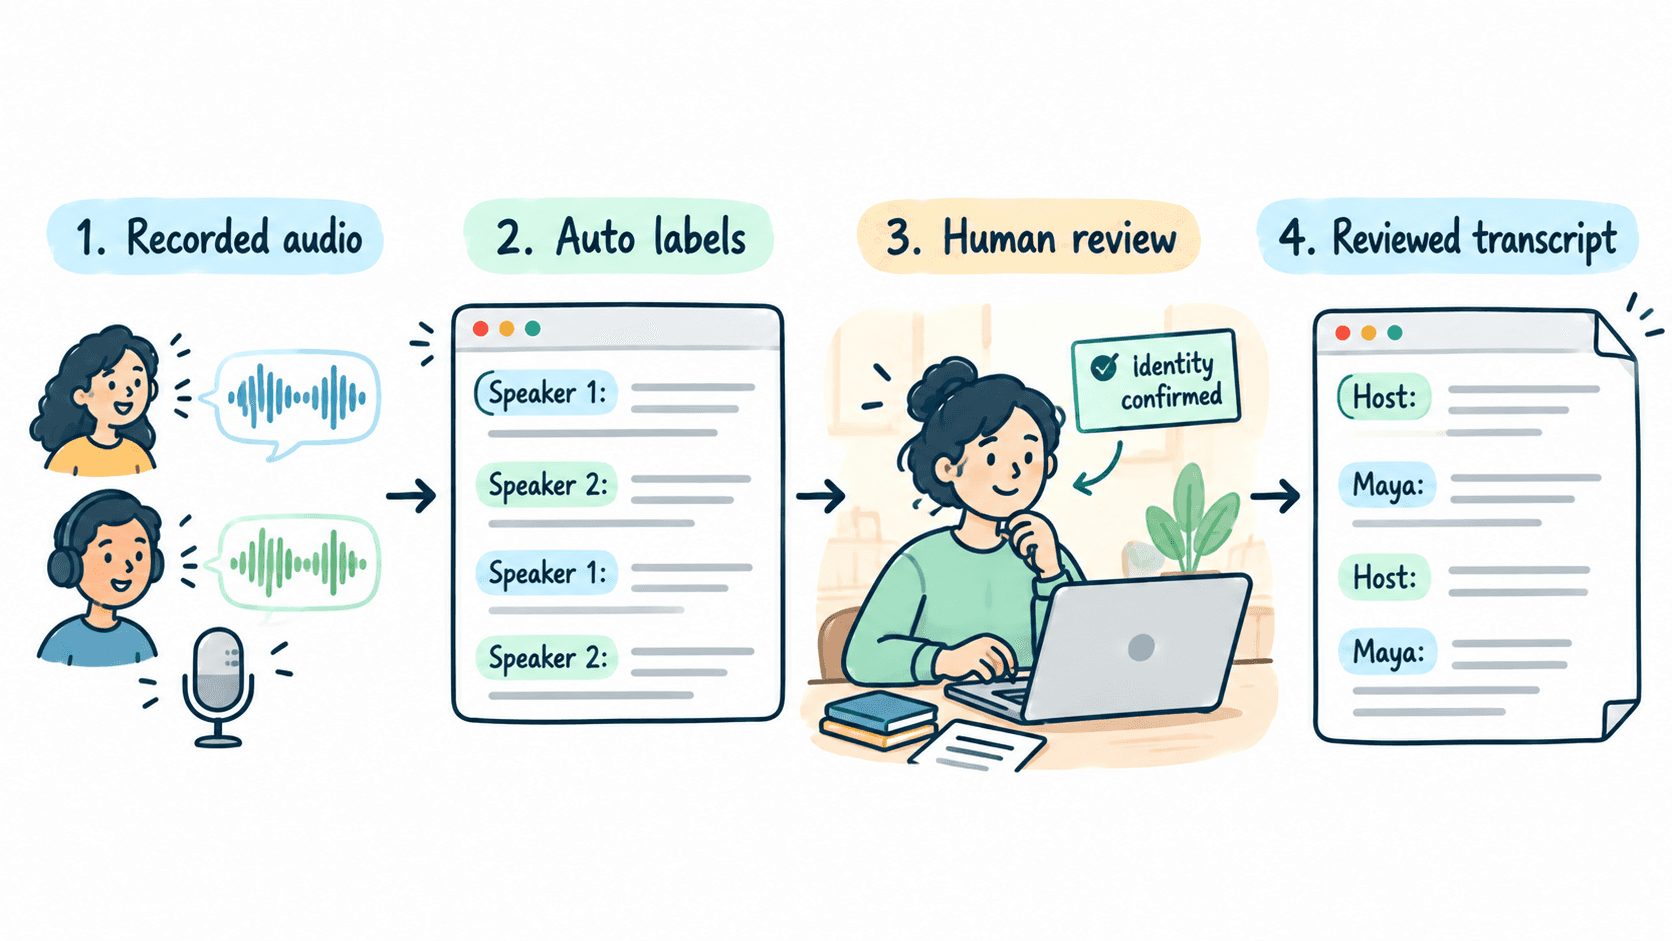
स्वचालित ट्रांसक्रिप्शन में, सिस्टम पहले ऑडियो को अलग-अलग आवाज़ों में विभाजित कर सकता है। इस प्रक्रिया को आमतौर पर स्पीकर डायराइजेशन कहा जाता है। इसके बाद ट्रांसक्रिप्ट उन वॉयस सेगमेंट्स पर स्पीकर 1 और स्पीकर 2 जैसे लेबल लगा सकती है।
डायराइजेशन एक संरचनात्मक प्रश्न का उत्तर देता है: ऑडियो के कौन-से हिस्से एक ही वक्ता से आते प्रतीत होते हैं? वहीं लेबल एक प्रस्तुति से जुड़े प्रश्न का उत्तर देता है: ट्रांसक्रिप्ट में उस वक्ता की पहचान कैसे की जानी चाहिए?
यह अंतर बाद में काम आता है। कोई सिस्टम दो अलग-अलग आवाज़ों का सही पता लगा सकता है और फिर भी उन्हें सामान्य लेबल दे सकता है। इसके बाद मानवीय समीक्षा के माध्यम से उन सामान्य लेबलों को नामों या भूमिकाओं से बदला जा सकता है जब पहचान ज्ञात हो जाए। स्पीकर लेबल रिकॉर्डिंग में आवाज़ों की पहचान करते हैं; वहीं एक वॉयस लाइब्रेरी जनरेट किए गए ऑडियो के लिए एक सिंथेटिक वॉयस चुनने में मदद करती है।
प्रमुख स्पीकर लेबल प्रारूप
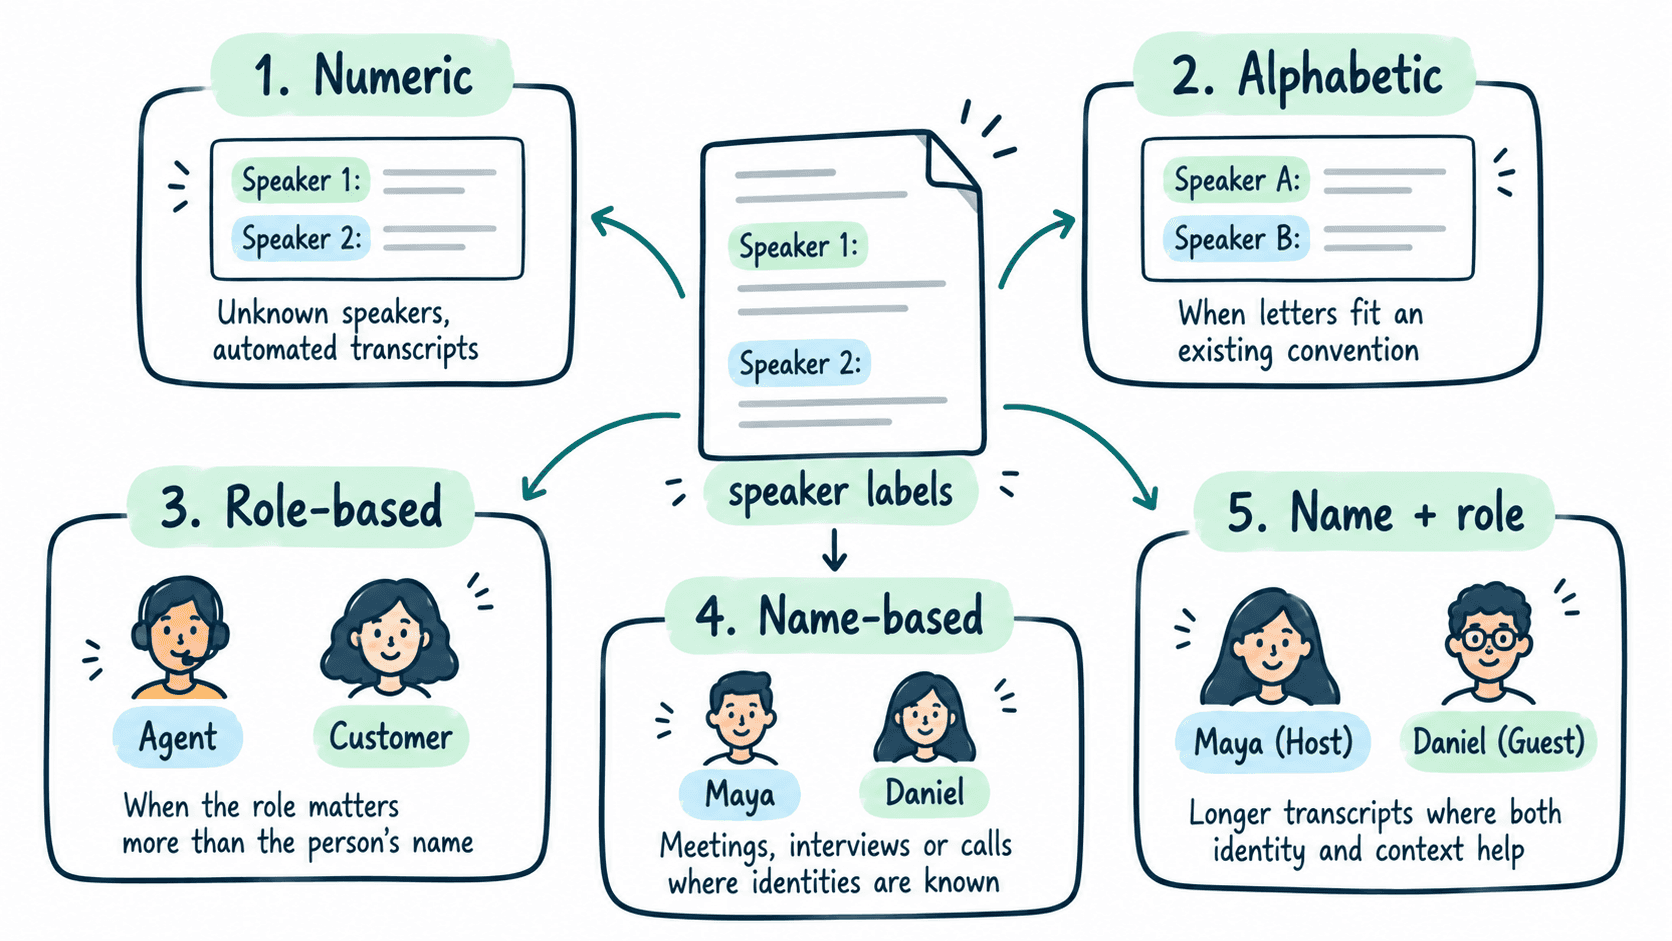
कोई भी एक लेबल प्रारूप हर ट्रांसक्रिप्ट के लिए उपयुक्त नहीं होता। काम का सवाल यह नहीं है कि "कौन सा लेबल सही है?" बल्कि यह है कि "कौन सा लेबल अनावश्यक जटिलता जोड़े बिना पाठक को पर्याप्त संदर्भ देता है?"
प्रारूप | उदाहरण | सर्वश्रेष्ठ उपयोग |
|---|---|---|
सामान्य संख्यात्मक | स्पीकर 1, स्पीकर 2 | अज्ञात वक्ता, स्वचालित ट्रांसक्रिप्ट, प्रारंभिक समीक्षा |
सामान्य वर्णमाला | स्पीकर A, स्पीकर B | जब अक्षर किसी मौजूदा संपादकीय या कानूनी परंपरा के अनुकूल हों |
भूमिका-आधारित | होस्ट, गेस्ट, एजेंट, कस्टमर | जब व्यक्ति के नाम से अधिक उसकी भूमिका मायने रखती हो |
नाम-आधारित | माया, डैनियल | मीटिंग्स, इंटरव्यू, पॉडकास्ट या कॉल जहाँ पहचान ज्ञात हो |
नाम + भूमिका | माया (होस्ट), डैनियल (गेस्ट) | लंबी ट्रांसक्रिप्ट जहाँ पहचान और संदर्भ दोनों मददगार होते हैं |
1. सामान्य लेबल: स्पीकर 1, स्पीकर 2
जब वक्ताओं की पहचान न हो, तो सामान्य लेबल सबसे सुरक्षित शुरुआती बिंदु होते हैं। ये स्वचालित ट्रांसक्रिप्ट में विशेष रूप से आम हैं क्योंकि सिस्टम यह जाने बिना भी आवाज़ों में अंतर कर सकता है कि प्रत्येक आवाज़ किसकी है।
स्पीकर 1: मैंने आज सुबह अपडेट की गई फ़ाइल भेज दी है। |
इसका लाभ निष्पक्षता है। ट्रांसक्रिप्ट किसी ऐसे नाम या भूमिका का अनुमान नहीं लगाती जिसे वह सत्यापित नहीं कर सकती। कमी यह है कि कई प्रतिभागियों वाली लंबी बातचीत में स्पीकर 1 और स्पीकर 2 को याद रखना कठिन हो जाता है।
2. भूमिका-आधारित लेबल: एजेंट, कस्टमर, होस्ट, गेस्ट
भूमिका-आधारित लेबल तब अच्छा काम करते हैं जब वक्ताओं के बीच का संबंध उनकी पहचान से अधिक उपयोगी होता है।
एजेंट: क्या आप खाते पर दर्ज ईमेल पते की पुष्टि कर सकते हैं? |
सैकड़ों कॉलों की समीक्षा करने वाले एक सपोर्ट मैनेजर के लिए यह अधिक मायने रख सकता है कि एजेंट ने क्या कहा और कस्टमर ने क्या कहा। कर्मचारी का नाम गौण हो सकता है। इसी तरह, पॉडकास्ट पाठक प्रत्येक व्यक्ति का नाम जानने से पहले भी होस्ट और गेस्ट के अंतर को समझना पसंद कर सकता है। AI फ़ोन ऑटोमेशन में, भूमिका-आधारित लेबल समीक्षकों को कॉलर की बातों को AI एजेंट के जवाबों से अलग पहचानने में भी मदद कर सकते हैं।
3. नाम-आधारित लेबल: प्रिया, उमर, एलेना
मानव पाठक के लिए नाम आमतौर पर सबसे आसान लेबल होते हैं क्योंकि वे मानसिक अनुवाद के झंझट को खत्म करते हैं। आपको हर बार बातचीत के उस तक पहुँचने पर यह याद रखने की ज़रूरत नहीं होती कि स्पीकर 3 प्रिया है।
प्रिया: क्या हमें लॉन्च को गुरुवार तक टाल देना चाहिए? |
नामों का उपयोग तब करें जब पहचान ज्ञात हो और उन्हें शामिल करना उचित हो। यदि ट्रांसक्रिप्ट को अज्ञात (एनोनिमाइज़्ड) रखा गया है, गोपनीय है, या पहचान से पहले समीक्षा की जा रही है, तो सामान्य लेबल बेहतर हो सकते हैं।
4. नाम और भूमिका एक साथ
लंबे साक्षात्कार, सुनवाई, शोध सत्र और पैनल चर्चाओं में कभी-कभी पहचान और भूमिका को संयोजित करने से लाभ होता है।
माया (साक्षात्कारकर्ता): आपने सबसे पहले इस समस्या पर कब ध्यान दिया? |
यह अधिक विवरणात्मक होता है, लेकिन देखने में भारी भी लगता है। यदि प्रत्येक पंक्ति एक लंबे लेबल से शुरू होती है, तो ट्रांसक्रिप्ट बहुत भरी-भरी लग सकती है। इस अतिरिक्त संदर्भ का उपयोग केवल तभी करें जब पाठक को वास्तव में इसकी आवश्यकता हो।
आप सही प्रारूप कैसे चुनते हैं?
पाठक को ध्यान में रखकर शुरुआत करें। एक स्पीकर लेबल केवल तभी उपयोगी होता है जब वह ट्रांसक्रिप्ट का उपयोग करने वाले व्यक्ति को कम प्रयास में बातचीत को समझने में मदद करे।
यदि पहचान अज्ञात है, तो स्पीकर 1 और स्पीकर 2 जैसे निष्पक्ष लेबलों का उपयोग करें।
यदि भूमिकाएँ स्थिर और अर्थपूर्ण हैं, तो एजेंट और कस्टमर या होस्ट और गेस्ट जैसे लेबलों का उपयोग करें।
यदि पहचान ज्ञात है और उसे दिखाना उचित है, तो नामों का उपयोग करें।
यदि पहचान और भूमिका दोनों मायने रखते हैं, तो उन्हें संयोजित करें, लेकिन लेबल को छोटा रखें।
यदि ट्रांसक्रिप्ट में पहचान की रक्षा करना आवश्यक है, तो नामों के बजाय सुसंगत छद्म नामों (स्यूडोनिम) या निष्पक्ष लेबलों का उपयोग करें।
महत्वपूर्ण बात निरंतरता (कंसिस्टेंसी) है। एक बार जब किसी आवाज़ को स्पीकर 1 सौंप दिया गया है, तो पूरी ट्रांसक्रिप्ट में स्पीकर 1 को उसी आवाज़ के लिए संदर्भित किया जाना चाहिए।
एक ही बातचीत में अलग-अलग लेबलों का उपयोग किया जा सकता है
लेबल का प्रारूप ट्रांसक्रिप्ट के उपयोग के तरीके को बदल देता है, भले ही बोले गए शब्द वही रहें।
प्रारंभिक ट्रांसक्रिप्शन | प्रकाशित साक्षात्कार |
स्पीकर 1: प्रोजेक्ट की शुरुआत कैसे हुई? | साक्षात्कारकर्ता: प्रोजेक्ट की शुरुआत कैसे हुई? |
पहला संस्करण तब उपयोगी होता है जब किसी ने आवाज़ों की पहचान न की हो। दूसरा संस्करण उस पाठक के लिए बेहतर है जिसे अंतिम साक्षात्कार को समझना है। दोनों में से कोई भी ऑडियो को नहीं बदलता। लेबल केवल संदर्भ को बदलते हैं।
उपयोग के आधार पर स्पीकर लेबल के उदाहरण
अलग-अलग बातचीत में लेबलिंग की अलग-अलग समस्याएँ आती हैं। यहाँ कुछ सामान्य पैटर्न दिए गए हैं।
उपयोग का मामला | उपयोगी लेबल | यह क्यों काम करता है |
|---|---|---|
पॉडकास्ट | होस्ट / गेस्ट | जब एक होस्ट और एक गेस्ट हो तो यह सरल रहता है। यदि एपिसोड में कई गेस्ट या बार-बार आने वाले होस्ट हों तो नामों का उपयोग करें। |
कस्टमर सपोर्ट | एजेंट / कस्टमर | QA समीक्षा को तेज़ बनाता है क्योंकि बातचीत का प्रत्येक पक्ष तुरंत दिखाई देता है। |
टीम मीटिंग | नाम | आमतौर पर तब सबसे आसान होता है जब प्रतिभागी ज्ञात हों और ट्रांसक्रिप्ट आंतरिक रूप से साझा की जाती हो। |
साक्षात्कार (इंटरव्यू) | साक्षात्कारकर्ता / साक्षात्कारदाता या नाम | आमने-सामने के साक्षात्कारों के लिए भूमिका लेबल स्पष्ट होते हैं। पैनल या कई साक्षात्कारकर्ताओं के लिए नाम बेहतर होते हैं। |
फोकस समूह | मॉडरेटर / प्रतिभागी 1 / प्रतिभागी 2 | तब उपयोगी जब प्रतिभागियों की गोपनीयता मायने रखती हो और नाम प्रकट नहीं होने चाहिए। |
मल्टी-स्पीकर रिकॉर्डिंग | स्पीकर 1 / स्पीकर 2 / स्पीकर 3 | एक व्यावहारिक प्रारंभिक चरण जब पहचान की पुष्टि अभी तक न हुई हो। |
वे गलतियाँ जो स्पीकर लेबल को अविश्वसनीय बनाती हैं
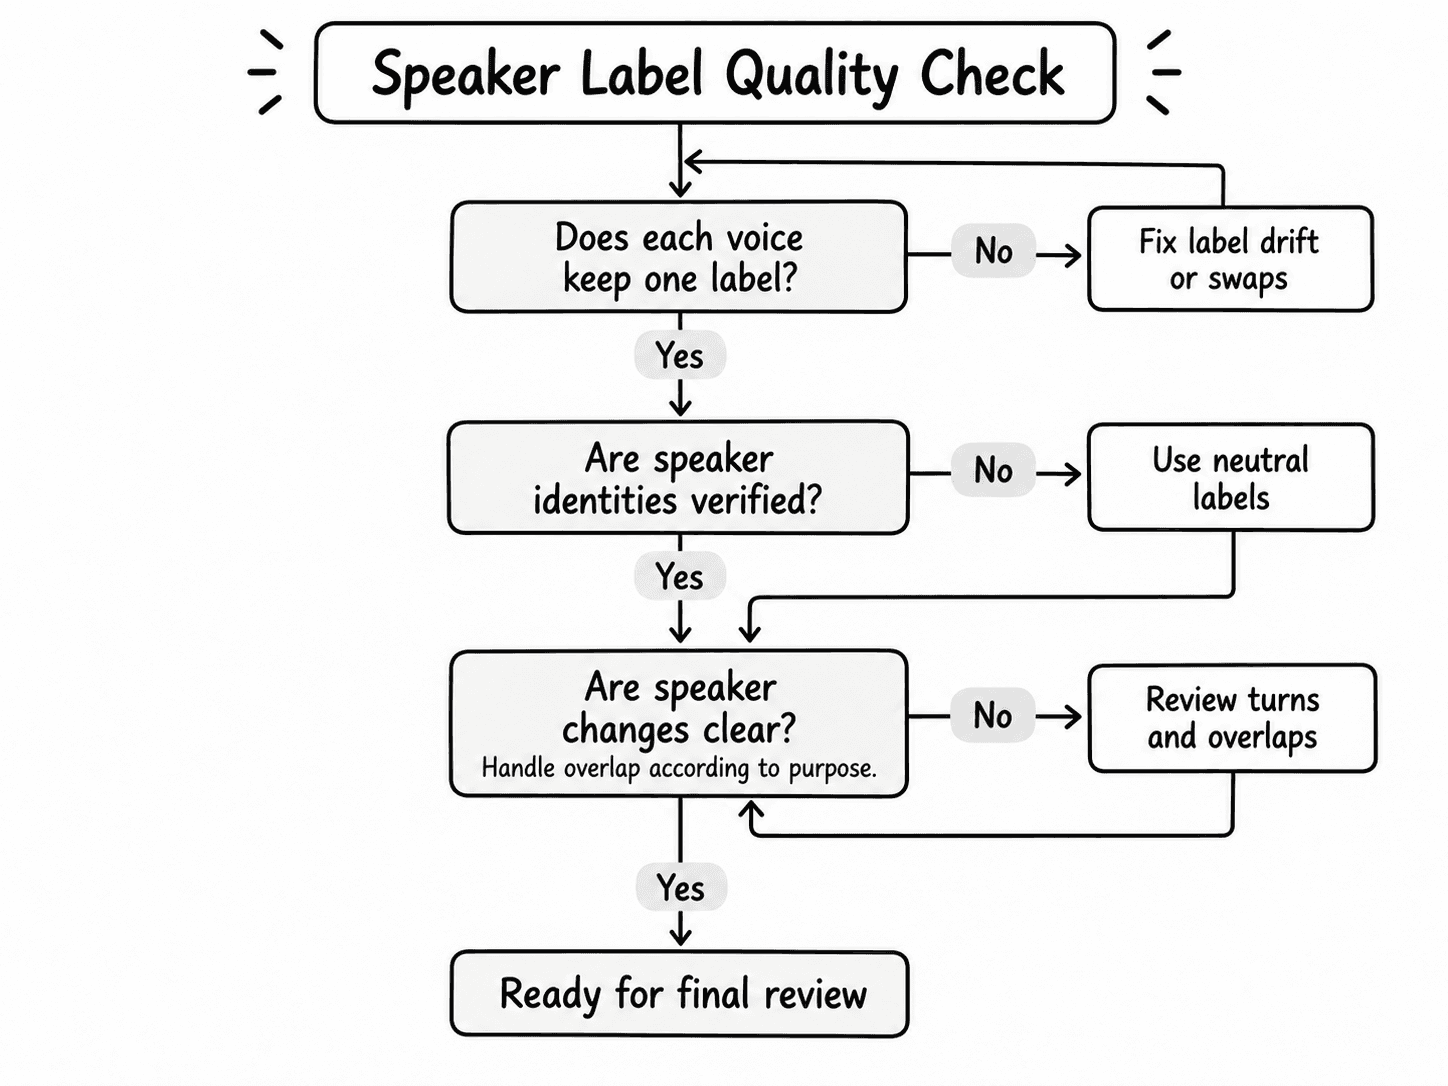
स्पीकर-लेबल से जुड़ी अधिकांश समस्याएँ फ़ॉर्मेटिंग की नहीं होती हैं। वे निरंतरता (कंसिस्टेंसी) की समस्याएँ होती हैं। कोई ट्रांसक्रिप्ट बिल्कुल सही लेबल प्रारूप का उपयोग कर सकती है और फिर भी यदि वे लेबल डगमगाते हैं, तो उस पर भरोसा करना मुश्किल हो जाता है।
गलती 1: एक ही व्यक्ति के लिए लेबल बदलना
भ्रमित करने वाला संस्करण
स्पीकर 1: मैं तीन बजे शामिल हो सकता हूँ। |
यदि एलेक्स और स्पीकर 1 एक ही व्यक्ति हैं, तो ट्रांसक्रिप्ट एक वक्ता को दो वक्ता के रूप में दिखाती है। एक लेबल चुनें और पूरी फ़ाइल में उसी का उपयोग करें।
गलती 2: बीच में ही वक्ताओं की अदला-बदली करना
यह अधिक गंभीर है। यदि किसी बिंदु के बाद स्पीकर 1 और स्पीकर 2 आपस में बदल जाते हैं, तो शब्द तो सही रहते हैं लेकिन उनका श्रेय गलत हो जाता है। साक्षात्कारों, शोध कॉलों, अनुपालन समीक्षा या ग्राहक सहायता में, यह रिकॉर्ड का अर्थ बदल सकता है।
लंबी रिकॉर्डिंग में यह जोखिम विशेष रूप से अधिक होता है क्योंकि मिलती-जुलती आवाज़ें, रुकावटें, पृष्ठभूमि का शोर या ओवरलैपिंग बातचीत वक्ताओं की सीमाओं को बनाए रखना कठिन बना सकती है।
गलती 3: बातचीत से पहचान का अनुमान लगाना
ट्रांसक्रिप्ट को किसी सुराग को तथ्य में नहीं बदलना चाहिए। यदि कोई वक्ता कहता है, "रीना को शामिल होने के लिए कहो," तो यह साबित नहीं होता कि वह वक्ता रीना नहीं है। यदि पहचान सत्यापित नहीं हुई है, तो एक आत्मविश्वासी अनुमान की तुलना में एक निष्पक्ष लेबल सुरक्षित होता है।
गलती 4: बहुत लंबे लेबलों का उपयोग करना
तकनीकी रूप से विवरणात्मक, देखने में थकाऊ
सीनियर कस्टमर सक्सेस मैनेजर - वेस्ट रीजन: मैं आपके लिए इसकी जाँच कर सकता हूँ। |
लेबलों को संदर्भ प्रदान करना चाहिए, न कि संवाद के साथ प्रतिस्पर्धा करनी चाहिए। "एजेंट" और "कस्टमर" पाठक की ज़रूरत की हर बात को व्यक्त कर सकते हैं।
गलती 5: ओवरलैप को एक स्पष्ट स्पीकर स्विच की तरह मानना
वास्तविक बातचीत अव्यवस्थित होती है। लोग बीच में टोकते हैं, हँसते हैं, किसी अन्य के वाक्य के दौरान "हाँ" कहते हैं, या एक ही समय में बोलना शुरू कर देते हैं। हर क्षण को साफ-सुथरी बारी-बारी की बातचीत में बदलने से वह ओवरलैप छिप सकता है।
सही तरीका ट्रांसक्रिप्ट के उद्देश्य पर निर्भर करता है। एक पठनीय मीटिंग ट्रांसक्रिप्ट मामूली ओवरलैप को सरल बना सकती है। किसी शोध, कानूनी या विस्तृत बातचीत की ट्रांसक्रिप्ट में इसे अधिक स्पष्ट रूप से संरक्षित करने की आवश्यकता हो सकती है।
गलती 6: वक्ता बदलने पर लेबल छोड़ देना
कई आवाज़ों वाला एक लंबा पैराग्राफ पाठक को बातचीत को मैन्युअल रूप से समझने पर मजबूर करता है। वक्ता का प्रत्येक स्पष्ट बदलाव ट्रांसक्रिप्ट में दिखाई देना चाहिए।
एक अच्छी स्पीकर-लेबल्ड ट्रांसक्रिप्ट कैसी दिखती है?
एक अच्छी ट्रांसक्रिप्ट पाठक को लेबलों के बारे में बहुत अधिक सोचने पर मजबूर नहीं करती। यही इसका मुख्य बिंदु है। लेबलों को चुपचाप दिशा-निर्देश प्रदान करना चाहिए जबकि बातचीत मुख्य केंद्र बनी रहे।
प्रत्येक वक्ता का एक स्थिर पहचानकर्ता होता है।
शुरुआत से अंत तक एक ही फ़ॉर्मेटिंग का उपयोग किया जाता है।
वक्ता के बदलावों को आसानी से देखा जा सकता है।
नामों और भूमिकाओं का उपयोग केवल तभी किया जाता है जब वे ज्ञात और उपयोगी हों।
अनिश्चित पहचानों को तथ्यों के रूप में प्रस्तुत नहीं किया जाता है।
ओवरलैपिंग या अस्पष्ट बातचीत को ट्रांसक्रिप्ट के उद्देश्य के अनुसार संभाला जाता है।
पहले और बाद में: लेबल पठनीयता को क्यों बदलते हैं

स्पीकर लेबलों के बिना | स्पीकर लेबलों के साथ |
क्या हम अभी भी कल मिल रहे हैं? हाँ, लेकिन इसे दस बजे कर लेते हैं। दस बजे ठीक रहेगा। मैं इनवाइट अपडेट कर दूँगा। | मीना: क्या हम अभी भी कल मिल रहे हैं? |
दूसरे संस्करण में अधिक बातचीत नहीं है। इसमें अधिक संरचना है। वही संरचना ट्रांसक्रिप्ट को उपयोगी बनाती है।
स्वचालित स्पीकर लेबलों को भी संदर्भ की आवश्यकता होती है
स्वचालित ट्रांसक्रिप्शन स्पीकर लेबलिंग को बहुत तेज़ बना सकता है, विशेष रूप से लंबी रिकॉर्डिंग के लिए। लेकिन स्पीकर 1 जैसा कोई सामान्य लेबल किसी सत्यापित पहचान के समान नहीं होता है।
यह एक उपयोगी कार्यप्रवाह बनाता है: पहले ट्रांसक्रिप्शन सिस्टम को आवाज़ों को अलग और लेबल करने दें, फिर जहाँ आवश्यक हो वहाँ मानवीय संदर्भ जोड़ें। एक समीक्षक स्पीकर 1 का नाम बदलकर 'होस्ट' कर सकता है, स्पीकर 2 को एक पुष्ट नाम से बदल सकता है, या उस खंड को ठीक कर सकता है जहाँ दो आवाज़ें गलती से विलीन हो गई थीं।
समीक्षा की मात्रा इस बात पर निर्भर करती है कि ट्रांसक्रिप्ट का उपयोग किस लिए किया जाएगा। एक खोजने योग्य आंतरिक मीटिंग नोट कुछ अनिश्चित लेबलों को सहन कर सकता है। एक प्रकाशित साक्षात्कार, शोध ट्रांसक्रिप्ट, अनुपालन रिकॉर्ड, या कस्टमर एस्केलेशन के लिए अधिक गहन सत्यापन की आवश्यकता हो सकती है।
एक त्वरित स्पीकर-लेबल चेकलिस्ट
किसी ट्रांसक्रिप्ट को पूर्ण मानने से पहले, केवल लेबलों के लिए उसे एक बार ध्यान से देखें। कुछ क्षणों के लिए शब्दों को नज़रअंदाज़ करें और पूछें:
☐ क्या प्रत्येक वक्ता का लेबल पूरी ट्रांसक्रिप्ट में एक जैसा रहता है?
☐ क्या लेबल ट्रांसक्रिप्ट के उद्देश्य से मेल खाते हैं?
☐ क्या कोई नाम या भूमिका सत्यापित जानकारी के बजाय मान्यताओं पर आधारित है?
☐ क्या वक्ता का बदलाव स्पष्ट रूप से दिखाई दे रहा है?
☐ क्या लेबल इतने छोटे हैं कि उन्हें जल्दी से पढ़ा जा सके?
☐ क्या रुकावटों या ओवरलैपिंग बातचीत को विशेष ध्यान देने की आवश्यकता है?
स्पीकर लेबल छोटे होते हैं, लेकिन वे बहुत सारा संदर्भ रखते हैं
शब्द किसी बातचीत की केवल एक परत होते हैं। पाठक को यह भी जानने की ज़रूरत होती है कि कौन बोल रहा है, वक्ता कब बदलता है, और क्या किसी पंक्ति से जुड़ी पहचान पर भरोसा किया जा सकता है।
यही कारण है कि अच्छी स्पीकर लेबलिंग "स्पीकर 1" और किसी व्यक्ति के नाम के बीच चयन करने के बारे में कम है, बल्कि उपयोग के मामले से मेल खाने वाले प्रारूप को चुनने और उसे लगातार सही ढंग से लागू करने के बारे में अधिक है।
जब लेबल पृष्ठभूमि में विलीन हो जाते हैं और बातचीत को समझना आसान हो जाता है, तब वे अपना काम सही ढंग से कर रहे होते हैं।
मल्टी-स्पीकर ट्रांसक्रिप्शन को आसान बनाना चाहते हैं? स्वचालित स्पीकर डायराइजेशन के साथ स्पीच-टू-टेक्स्ट के लिए Smallest.ai Pulse को एक्सप्लोर करें, या अपने एप्लिकेशन में स्पीकर-लेबल्ड ट्रांसक्रिप्ट जोड़ने के लिए API के साथ निर्माण शुरू करें।
अक्सर पूछे जाने वाले प्रश्न
एक ट्रांसक्रिप्ट में स्पीकर लेबल का उद्देश्य क्या होता है?
क्या स्पीकर लेबल और स्पीकर डायराइजेशन (diarization) एक ही हैं?
क्या ट्रांसक्रिप्ट में नामों का उपयोग किया जाना चाहिए या वक्ता 1 और वक्ता 2 का?
क्या AI ट्रांसक्रिप्शन स्वचालित रूप से वक्ताओं की पहचान कर सकता है?
एक ट्रांसक्रिप्ट में ओवरलैपिंग स्पीच (एक साथ बोली जाने वाली आवाज़ों) को कैसे संभाला जाना चाहिए?

![यह ब्लॉग /blog पेज के शीर्ष पर प्रदर्शित किया जाएगा। एक समय में केवल एक ही ब्लॉग को प्रदर्शित किया जा सकता है। यदि कई ब्लॉग प्रदर्शित किए जाते हैं, तो सूची में केवल पहला प्रदर्शित ब्लॉग ही दिखाई देगा। Python में ऑडियो को टेक्स्ट में ट्रांसक्राइब करें, जिसमें साफ प्रीप्रोसेसिंग, API कॉल, डायराइजेशन, चंकिंग और प्रोडक्शन रीट्राय/कॉस्ट पैटर्न शामिल हैं जिन्हें आप आत्मविश्वास के साथ शिप कर सकते हैं। पेज का मेटा डेटा खाली। पायथन में ऑडियो को टेक्स्ट में कैसे ट्रांसक्राइब करें: डेवलपर्स के लिए एक चरण-दर-चरण API गाइड। Python में ऑडियो को टेक्स्ट में ट्रांसक्राइब करें, जिसमें साफ प्रीप्रोसेसिंग, API कॉल, डायराइजेशन, चंकिंग और प्रोडक्शन रीट्राय/कॉस्ट पैटर्न शामिल हैं जिन्हें आप आत्मविश्वास के साथ शिप कर सकते हैं। how-to-transcribe-audio-to-text-in-python-a-step-by-step-api-guide-for-developers smallest.ai/blog/how-to-transcribe-audio-to-text-in-python-a-step-by-step-api-guide-for-developers खाली खाली पृथ्वी भारद्वाज खाली। ऑडियो को टेक्स्ट में ट्रांसक्राइब करना तब तक एक हल की गई समस्या लगती है जब तक आप इसे शिप करने की कोशिश नहीं करते। अलग-अलग फ़ाइल प्रकार, अजीब सैंपल रेट्स, बैकग्राउंड का शोर, लहजे (accents), और कई वक्ताओं की बातचीत एक "त्वरित स्क्रिप्ट" को एक वास्तविक इंजीनियरिंग प्रयास में बदल देती है। इसके बाद "यह मेरे मशीन पर काम करता है" से लेकर Python कोड तक का व्यावहारिक रास्ता है जो विश्वसनीयता की समस्याओं के बिना वास्तविक दुनिया के ऑडियो को संभाल सकता है। यदि आप मीटिंग नोट्स, एक वॉयस-ड्रिवेन सपोर्ट बॉट, या एक ऑडियो इंडेक्सिंग पाइपलाइन बना रहे हैं, तो वही बुनियादी बातें बार-बार सामने आती हैं। आपके पास काम करने वाला Python कोड, इस बात की स्पष्ट समझ कि कौन से नॉब्स वास्तव में सटीकता को प्रभावित करते हैं, और प्रोटोटाइप से प्रोडक्शन तक का एक वास्तविक मैप होगा। ये अनुभाग क्रम में बने हैं, इसलिए आप इसे एक मेनू के बजाय एक अनुक्रम के रूप में मान सकते हैं। Python ऑडियो ट्रांसक्रिप्शन कैसे काम करता है: बुनियादी वर्कफ़्लो। कोड लिखना शुरू करने से पहले, पूर्ण ट्रांसक्रिप्शन प्रवाह को समझना मददगार होता है। एक स्पीच-टू-टेक्स्ट पाइपलाइन केवल "ऑडियो अपलोड करें और टेक्स्ट वापस पाएं" नहीं है। एक वास्तविक एप्लिकेशन में, आपको ऑडियो तैयार करना होगा, सही अनुरोध भेजना होगा, संरचित (structured) आउटपुट प्राप्त करना होगा, और उस आउटपुट को अपने उत्पाद या वर्कफ़्लो के लिए उपयोगी बनाना होगा। यहाँ मूल वर्कफ़्लो दिया गया है जिसका अधिकांश Python ऑडियो ट्रांसक्रिप्शन सिस्टम पालन करते हैं: ऑडियो फ़ाइल तैयार करें या होस्ट करें। उस ऑडियो स्रोत से शुरू करें जिसे आप ट्रांसक्राइब करना चाहते हैं। यह उपयोगकर्ता अपलोड की गई स्थानीय फ़ाइल, आपके CRM से कॉल रिकॉर्डिंग, मीटिंग रिकॉर्डिंग, पॉडकास्ट एपिसोड, या होस्ट की गई फ़ाइल URL हो सकती है। यदि फ़ाइल पहले से ही सुरक्षित रूप से होस्ट की गई है, तो आप URL सीधे ट्रांसक्रिप्शन API पर भेज सकते हैं। यदि यह स्थानीय रूप से संग्रहीत है, तो आप Python से रॉ ऑडियो फ़ाइल अपलोड कर सकते हैं। आवश्यकतानुसार ऑडियो प्रारूप को सामान्य (Normalize) करें। ऑडियो फ़ाइलें अक्सर विभिन्न प्रारूपों, बिटरेट्स, सैंपल रेट्स और चैनल लेआउट में आती हैं। उन्हें API पर भेजने से पहले, यदि आवश्यक हो तो फ़ाइल को सामान्य करें। एक सामान्य सुरक्षित प्रारूप मोनो, 16 kHz, 16-बिट WAV है, विशेष रूप से तब जब आप विभिन्न रिकॉर्डिंग्स में अनुमानित ट्रांसक्रिप्शन गुणवत्ता चाहते हैं। यह चरण असमर्थित प्रारूपों, स्टीरियो चैनल भ्रम, या शोर वाले रूपांतरणों के कारण होने वाली समस्याओं को कम करने में मदद करता है। फ़ाइल या URL को ट्रांसक्रिप्शन API पर भेजें। ऑडियो तैयार होने के बाद, आपका Python स्क्रिप्ट इसे स्पीच-टू-टेक्स्ट API पर भेजता है। एक स्थानीय फ़ाइल के लिए, इसका आम तौर पर मतलब ऑडियो बाइट्स को पढ़ना और उन्हें एक POST अनुरोध में भेजना है। होस्ट किए गए ऑडियो के लिए, आप JSON पेलोड में सार्वजनिक या हस्ताक्षरित (signed) URL भेजते हैं। दोनों मामलों में, आपके अनुरोध में प्रमाणीकरण (authentication) शामिल होना चाहिए, जो आमतौर पर एक पर्यावरण चर (environment variable) में संग्रहीत API कुंजी के माध्यम से होता है। भाषा, डायराइजेशन, टाइमस्टैम्प और फ़ॉर्मेटिंग विकल्प पास करें। अधिकांश ट्रांसक्रिप्शन API आपको यह नियंत्रित करने देते हैं कि आउटपुट कैसे जनरेट होना चाहिए। उदाहरण के लिए, आप en जैसी भाषा कोड पास कर सकते हैं, बहु-वक्ता बातचीत के लिए स्पीकर डायराइजेशन सक्षम कर सकते हैं, शब्द-स्तरीय टाइमस्टैम्प का अनुरोध कर सकते हैं, या स्वचालित भाषा पहचान की अनुमति दे सकते हैं। ये विकल्प महत्वपूर्ण हैं क्योंकि वे प्रभावित करते हैं कि अंतिम ट्रांसक्रिप्ट खोज, कैप्शन, एनालिटिक्स, QA, या डाउनस्ट्रीम ऑटोमेशन के लिए कितनी उपयोगी होगी। संरचित JSON प्राप्त करें। एक अच्छा स्पीच-टू-टेक्स्ट API केवल प्लेन टेक्स्ट ही नहीं लौटाता है। यह आमतौर पर संरचित JSON लौटाता है जिसमें पूर्ण ट्रांसक्रिप्ट, शब्द-स्तरीय समय, खोजी गई भाषा, आत्मविश्वास स्कोर (confidence scores) और डायराइजेशन सक्षम होने पर स्पीकर की जानकारी शामिल होती है। यही संरचना एक ट्रांसक्रिप्ट को एक साधारण टेक्स्ट ब्लॉक से उस डेटा में बदल देती है जिसके साथ आपका एप्लिकेशन काम कर सकता है। ट्रांसक्रिप्ट, वर्ड टाइमस्टैम्प, स्पीकर लेबल और कॉन्फिडेंस मेटाडेटा निकालें। प्रतिक्रिया प्राप्त करने के बाद, Python में JSON को पार्स करें। डिस्प्ले के लिए पूरा ट्रांसक्रिप्ट, ऑडियो या वीडियो के साथ टेक्स्ट सिंक करने के लिए वर्ड टाइमस्टैम्प, बातचीत के लिए स्पीकर लेबल और गुणवत्ता जांच के लिए कॉन्फिडेंस स्कोर निकालें। उदाहरण के लिए, कम-आत्मविश्वास वाले शब्दों को मानवीय समीक्षा के लिए फ़्लैग किया जा सकता है, इससे पहले कि ट्रांसक्रिप्ट को ग्राहक-सामना करने वाले या अनुपालन-संवेदनशील वर्कफ़्लो में धकेला जाए। ट्रांसक्रिप्ट को स्टोर या पोस्ट-प्रोसेस करें। अंत में, ट्रांसक्रिप्ट और मेटाडेटा को अपने डेटाबेस, ऑब्जेक्ट स्टोरेज, CRM, QA प्लेटफॉर्म, BI टूल या सर्च इंडेक्स में स्टोर करें। आप पोस्ट-प्रोसेसिंग चरण भी चला सकते हैं जैसे विराम चिह्न सफाई, संपादन (redaction), संक्षेपीकरण (summarization), कीवर्ड निष्कर्षण, स्पीकर फ़ॉर्मेटिंग, या विषय टैगिंग। यही वह जगह है जहाँ ट्रांसक्रिप्शन कच्चे टेक्स्ट से परे उपयोगी हो जाता है: यह खोजने योग्य कॉल आर्काइव, मीटिंग सारांश, सहायता QA, कैप्शन, अनुपालन समीक्षा, या वॉयस एनालिटिक्स को शक्ति प्रदान कर सकता है। एक साधारण Python ट्रांसक्रिप्शन वर्कफ़्लो आमतौर पर इस तरह दिखता है: 1. ऑडियो तैयार करें या होस्ट करें: audio_path = "preprocessed_audio.wav" 2. ऑडियो को ट्रांसक्रिप्शन API पर भेजें: response = transcribe_audio(audio_path) 3. संरचित फ़ील्ड निकालें: transcript = response.get("transcription", "") words = response.get("words", []) utterances = response.get("utterances", []) language = response.get("language", "unknown") 4. परिणाम संग्रहीत या पोस्ट-प्रोसेस करें: print("Transcript:", transcript) print("Detected language:", language) print("Word count:", len(words)) print("Speaker turns:", len(utterances)) यह वर्कफ़्लो वास्तविक कार्यान्वयन में जाने से पहले आपको एक स्पष्ट मानसिक मॉडल देता है। API स्तर पर वास्तव में 'ऑडियो को टेक्स्ट में ट्रांसक्राइब करें' का क्या अर्थ है? इससे पहले कि आप Python लिखें, यह स्पष्ट करने में मदद मिलती है कि जब आप "ट्रांसक्राइब" पर क्लिक करते हैं तो स्पीच-टू-टेक्स्ट API क्या कर रहा होता है। आप किसी ब्लैक बॉक्स में फ़ाइल मेल नहीं कर रहे हैं और एक पैराग्राफ वापस नहीं पा रहे हैं। सेवा आमतौर पर ऑडियो को एक ध्वनिक मॉडल (sound to phonemes), एक भाषा मॉडल (phonemes to likely words in context), और फिर एक पोस्ट-प्रोसेसिंग परत के माध्यम से चलाती है जो विराम चिह्न, कैपिटलाइजेशन और कभी-कभी स्पीकर लेबल के साथ चीजों को साफ करती है। वे परतें भी हैं जहां गुणवत्ता अंतराल तेजी से दिखाई देते हैं। एक मॉडल जो साफ, स्टूडियो अंग्रेजी पर बहुत अच्छा दिखता है, वह अक्सर कॉल-सेंटर ऑडियो, भारी पृष्ठभूमि शोर, या बातचीत जो बीच में भाषाएं बदलती हैं, पर बिखर जाता है। इसीलिए API का चुनाव उतना ही मायने रखता है जितना कि आपका Python रैपर। यदि आप अंतर्निहित यांत्रिकी के बारे में अधिक जानना चाहते हैं, तो स्पीच रिकग्निशन Python गाइड विस्तार से बताता है कि आधुनिक रिकग्निशन सिस्टम व्यवहार में कैसे व्यवहार करते हैं। एक आधुनिक स्पीच-टू-टेक्स्ट API की आंतरिक पाइपलाइन, कच्चे ऑडियो से संरचित ट्रांसक्रिप्ट तक। अपना Python वातावरण सेट करना। एक नए वर्चुअल वातावरण का उपयोग करें। ऑडियो टूलिंग डिपेंडेंसी क्लैश के लिए कुख्यात है, और पैकेजों को अलग करना आपको अपने पाइपलाइन के बजाय अपनी मशीन को डीबग करने से बचाता है। अपने वातावरण को तैयार करने के लिए इन कमांड्स को चलाएं: python -m venv stt-env # macOS / Linux source stt-env/bin/activate # Windows stt-env\Scripts\activate pip install requests python-dotenv pydub अपनी API कुंजी को कोड में डालने के बजाय `.env` फ़ाइल में रखें। यह बुनियादी स्वच्छता है, और जब आप स्थानीय परीक्षण से उत्पादन में जाते हैं तो यह कुंजी रोटेशन को दर्द रहित भी बनाता है। `.env` में `SMALLEST_API_KEY=your_api_key_here` जोड़ें, फिर नीचे दिए गए स्निपेट के साथ इसे लोड करें। SMALLEST_API_KEY=your_api_key_here from dotenv import load_dotenv load_dotenv() ऑडियो प्रीप्रोसेसिंग: वह चरण जिसे अधिकांश ट्यूटोरियल छोड़ देते हैं। बहुत सारे ट्रांसक्रिप्शन वॉकथ्रू एक प्राचीन WAV से शुरू होते हैं और नाटक करते हैं कि यह सामान्य है। ऐसा नहीं है। फ़ोन रिकॉर्डिंग अक्सर 8 kHz पर आती हैं, जो 16 kHz की उम्मीद करने वाले मॉडल के लिए एक खराब मेल है। वीडियो MP4 या MKV के रूप में दिखाई देता है जिसके अंदर ऑडियो छुपा होता है। ज़ूम निर्यात में प्रति स्पीकर अलग मोनो ट्रैक शामिल हो सकते हैं, जो यह बदलता है कि आपको मॉडल में ऑडियो कैसे फीड करना चाहिए। `pydub` बिना किसी परेशानी के अधिकांश कष्टप्रद प्रारूप कार्य को कवर करता है। यहाँ एक छोटा प्रीप्रोसेसिंग फ़ंक्शन है जो ऑडियो को उस आकार में परिवर्तित करता है जिसे अधिकांश API पसंद करते हैं: from pydub import AudioSegment def preprocess_audio(input_path: str, output_path: str) -> str: """ Convert an audio file to mono, 16 kHz, 16-bit PCM WAV. This format is commonly preferred for speech-to-text pipelines. """ audio = AudioSegment.from_file(input_path) audio = audio.set_channels(1) audio = audio.set_frame_rate(16000) audio = audio.set_sample_width(2) audio.export(output_path, format="wav") return output_path if __name__ == "__main__": preprocess_audio("input_audio.mp3", "preprocessed_audio.wav") व्यवहार में, API को कॉल करने से पहले इस सब के माध्यम से सब कुछ चलाएं। अकेले रीसैंपलिंग से बहुत फर्क पड़ सकता है, खासकर जब मूल रिकॉर्डिंग टेलीफोनी-ग्रेड की हो। जैसा कि मोज़िला के कॉमन वॉयस दस्तावेज़ में उल्लेख किया गया है, 16 kHz मोनो WAV कई ओपन-सोर्स और वाणिज्यिक स्पीच मॉडल में मानक इनपुट प्रारूप है। ट्रांसक्रिप्शन API पर भेजने से पहले ऑडियो को प्रीप्रोसेस करना सटीकता में काफी सुधार करता है। Python में अपना पहला ट्रांसक्रिप्शन API कॉल करना। एक बार जब आपके पास एक साफ ऑडियो फ़ाइल हो, तो API कॉल सीधी होती है। नीचे दिया गया उदाहरण Smallest.ai के Pulse का उपयोग करता है, जो एक स्पीच-टू-टेक्स्ट API है जिसका उद्देश्य कम-विलंबता, उच्च-सटीकता ट्रांसक्रिप्शन है, जिसमें रीयल-टाइम परिदृश्यों के लिए स्ट्रीमिंग समर्थन है। import os import requests from dotenv import load_dotenv load_dotenv() def transcribe_audio(file_path: str) -> dict: """ Send a local audio file to Smallest.ai Pulse STT and return the transcription response as JSON. """ api_key = os.getenv("SMALLEST_API_KEY") if not api_key: raise ValueError("Missing SMALLEST_API_KEY in environment variables.") url = "https://api.smallest.ai/waves/v1/pulse/get_text" params = { "language": "en", "word_timestamps": "true", "diarize": "false", } headers = { "Authorization": f"Bearer {api_key}", "Content-Type": "audio/wav", } with open(file_path, "rb") as audio_file: response = requests.post( url, headers=headers, params=params, data=audio_file, यहाँ दो विवरण दिखने से कहीं अधिक मायने रखते हैं। `raise_for_status` HTTP विफलताओं को अपवादों (exceptions) में बदल देता है, इसलिए आप त्रुटियों से स्पष्ट रूप से निपटते हैं बजाय इसके कि चुपचाप एक खाली स्ट्रिंग प्रिंट करें और इसे "पूर्ण" कहें। और word_timestamps=true आपको शब्द-स्तरीय समय देता है, जिसकी आपको उसी क्षण आवश्यकता होगी जब आपको वीडियो में टेक्स्ट सिंक करना हो, खोज हिट को हाइलाइट करना हो, या किसी भी प्रकार का उपयोगी ऑडियो इंडेक्स बनाना हो। यदि आप एक समृद्ध पाइपलाइन बना रहे हैं, तो स्पीच-टू-टेक्स्ट डेवलपर गाइड स्ट्रीमिंग और रीयल-टाइम पैटर्न पर आगे बढ़ता है। एक होस्ट किए गए ऑडियो URL को ट्रांसक्राइब करना। import os import requests from dotenv import load_dotenv load_dotenv() def transcribe_audio_url(audio_url: str) -> dict: """ Send a hosted audio URL to Smallest.ai Pulse STT and return the transcription response as JSON. """ api_key = os.getenv("SMALLEST_API_KEY") if not api_key: raise ValueError("Missing SMALLEST_API_KEY in environment variables.") url = "https://api.smallest.ai/waves/v1/pulse/get_text" params = { "language": "en", "word_timestamps": "true", "diarize": "true", } headers = { "Authorization": f"Bearer {api_key}", "Content-Type": "application/json", } payload = { "url": audio_url, } response = requests.post( url, API प्रतिक्रिया को संभालना और संरचित डेटा निकालना। एक ट्रांसक्रिप्शन प्रतिक्रिया आमतौर पर एकल ट्रांसक्रिप्ट फ़ील्ड से अधिक होती है। अच्छे API संरचना लौटाते हैं: शब्द समय, आत्मविश्वास स्कोर, खोजी गई भाषा, और कभी-कभी वक्ता मेटाडेटा। यहाँ एक विशिष्ट प्रतिक्रिया आकार और उपयोगी भागों को बाहर निकालने का एक सरल तरीका है: def parse_transcript(response: dict) -> None: """ Print the transcript, word-level timestamps, confidence scores, and detected language. """ full_text = response.get("transcription", "") print(f"Transcript: {full_text}") words = response.get("words", []) for word in words: text = word.get("word", "") start = word.get("start") end = word.get("end") confidence = word.get("confidence") start_text = f"{start:.2f}s" if isinstance(start, (int, float)) else "?" end_text = f"{end:.2f}s" if isinstance(end, (int, float)) else "?" confidence_text = ( f"{confidence:.2f}" if isinstance(confidence, (int, float)) else "?" ) print(f"[{start_text} - {end_text}] {text} (confidence: {confidence_text})") language = response.get("language", "unknown") print(f"Detected language: {language}") आत्मविश्वास स्कोर को एक रूटिंग सिग्नल के रूप में मानें, न कि सामान्य ज्ञान के रूप में। जब कोई शब्द ~0.7 से नीचे गिरता है, तो मॉडल आपको बता रहा होता है कि वह अनुमान लगा रहा है, अक्सर शोर, किसी अपरिचित संज्ञा (proper noun), या ओवरलैपिंग भाषण के कारण। उत्पादन में, कम-विश्वास वाले स्पैन डाउनस्ट्रीम सिस्टम में अनिश्चितता को लीक करने देने के बजाय मानवीय समीक्षा को ट्रिगर करने के लिए एक अच्छी जगह हैं। एक ट्रांसक्रिप्शन API प्रतिक्रिया की शारीरिक रचना: ट्रांसक्रिप्ट, शब्द-स्तरीय टाइमस्टैम्प और आत्मविश्वास स्कोर। स्पीकर डायराइजेशन: यह जानना कि किसने क्या कहा। एकल-स्पीकर ऑडियो आसान मोड है। मीटिंग, पॉडकास्ट और सपोर्ट कॉल वे जगहें हैं जहाँ चीजें दिलचस्प हो जाती हैं, क्योंकि "क्या कहा गया था" पर्याप्त नहीं है, आपको "किसने कहा" की आवश्यकता है। यह डायराइजेशन है, और आप आमतौर पर अपने अनुरोध मापदंडों में `diarize: True` के साथ इसे चालू करते हैं। जब डायराइजेशन सक्षम होता है, तो Pulse शब्द-स्तरीय और उच्चारण-स्तरीय आउटपुट में स्पीकर लेबल जोड़ता है, ताकि आप ट्रांसक्रिप्ट को एक बातचीत के रूप में फिर से बना सकें। def format_diarized_transcript(response: dict) -> str: """ Format diarized utterances into a readable speaker-by-speaker transcript. """ utterances = response.get("utterances", []) lines = [] for utterance in utterances: speaker = utterance.get("speaker", "unknown_speaker") text = utterance.get("text", "").strip() start = utterance.get("start", 0) if not text: continue lines.append(f"[{start:.1f}s] {speaker}: {text}") return "\n".join(lines) एक पेंच है: जब लोग एक-दूसरे के ऊपर बात करते हैं तो डायराइजेशन खराब हो जाता है। कॉल-सेंटर ऑडियो में, रुकावटें आम हैं, और सबसे साफ समाधान अक्सर अपस्ट्रीम होता है (जब आपके पास अलग चैनल हों, फिर ट्रांसक्राइब करें) बजाय इसके कि मॉडल से क्रॉस-टॉक को पूरी तरह से सुलझाने की उम्मीद की जाए। स्पीकर डायराइजेशन पाइपलाइन्स गाइड बहु-वक्ता रणनीतियों पर अधिक गहराई से बात करती है। लंबी ऑडियो फ़ाइलें और चंकिंग रणनीतियाँ संभालना। ट्रांसक्रिप्शन API आमतौर पर फ़ाइल आकार या अवधि पर सीमाएं लगाते हैं। भले ही आपका ऐसा न करे, एक एकल अनुरोध के माध्यम से 90 मिनट की रिकॉर्डिंग को धक्का देना मुसीबत को बुलावा देना है: एक टाइमआउट और आप वापस शून्य पर आ जाते हैं। पाइपलाइन को लचीला रखने के लिए लंबी ऑडियो को छोटे टुकड़ों में बांटना (chunking) मानक तरीका है। लंबी ऑडियो फ़ाइलों के लिए एक मजबूत चंकिंग रणनीति: `pydub` के `make_chunks` विधि का उपयोग करके ऑडियो को 30-60 सेकंड के खंडों में विभाजित करें। सीमाओं पर शब्दों को कटने से बचाने के लिए टुकड़ों के बीच 1-2 सेकंड का ओवरलैप जोड़ें। प्रत्येक टुकड़े को स्वतंत्र रूप से ट्रांसक्राइब करें और क्रम में परिणाम एकत्र करें। एक सरल स्ट्रिंग संरेखण (alignment) जांच का उपयोग करके ओवरलैप क्षेत्र में डुप्लिकेट शब्दों को हटाकर ट्रांसक्रिप्ट को मर्ज करें। मूल फ़ाइल में अपनी प्रारंभ स्थिति के अनुसार प्रत्येक टुकड़े के शब्द टाइमस्टैम्प को ऑफसेट करके वैश्विक टाइमस्टैम्प को सुरक्षित रखें। from pydub import AudioSegment def split_audio_with_overlap( input_path: str, output_dir: str, chunk_length_ms: int = 60_000, overlap_ms: int = 2_000, ) -> list[str]: """ Split long audio into overlapping chunks. Default: 60-second chunks with 2-second overlap. """ audio = AudioSegment.from_file(input_path) chunk_paths = [] start = 0 chunk_index = 0 while start < len(audio): end = min(start + chunk_length_ms, len(audio)) chunk = audio[start:end] chunk_path = f"{output_dir}/chunk_{chunk_index:04d}.wav" chunk.export(chunk_path, format="wav") chunk_paths.append(chunk_path) if end == len(audio): break start = end - overlap_ms chunk_index += 1 return chunk_paths वह ओवरलैप "ज्यादातर काम करता है" और एक ऐसे सिस्टम के बीच का अंतर है जो सीमाओं पर अनुमानित रूप से व्यवहार करता है। इसके बिना, सीमा पर आने वाले शब्द कट जाते हैं और या तो गायब हो जाते हैं या विकृत होकर वापस आते हैं। एक सेकंड का ओवरलैप मुश्किल से प्रसंस्करण लागत को बदलता है, लेकिन यह किनारे के मामलों की एक पूरी श्रेणी को समाप्त कर देता है। यदि आप लहजे, कोड-स्विचिंग, या बहुभाषी ऑडियो से निपट रहे हैं, तो बहुभाषी ऑडियो के लिए स्पीच-टू-टेक्स्ट गाइड अतिरिक्त नुकसानों को रेखांकित करता है। ओवरलैपिंग सेगमेंट के साथ लंबी ऑडियो को चंक करना स्प्लिट पॉइंट पर वर्ड-बाउंड्री त्रुटियों को रोकता है। उत्पादन विचार: त्रुटि हैंडलिंग, पुन: प्रयास (retries), और लागत नियंत्रण। लैपटॉप स्क्रिप्ट एक डेमो है; उत्पादन वह जगह है जहाँ गन्दी चीजें दिखाई देती हैं। दर सीमाएं (Rate limits) लागू होती हैं, नेटवर्क बंद हो जाते हैं, और उपयोगकर्ता उन प्रारूपों में ऑडियो अपलोड करते हैं जिनकी आपने योजना नहीं बनाई थी (या रिकॉर्डिंग जो होनी चाहिए उससे कहीं अधिक लंबी हैं)। यदि आप उन तीनों के लिए पहले से योजना बनाते हैं, तो बाकी ज्यादातर इंजीनियरिंग है। दर सीमाओं और क्षणिक विफलताओं के लिए, घातीय बैकऑफ़ (exponential backoff) का उपयोग करें। `tenacity` इसे साफ रखता है: `@retry(wait=wait_exponential(multiplier=1, min=2, max=30), stop=stop_after_attempt(5))`। उस डेकोरेटर को अपने API कॉल पर रखें और आप अपनी खुद की पुन: प्रयास स्थिति मशीन लिखे बिना अधिकांश अल्पकालिक मुद्दों से पार पा लेंगे। pip install tenacity import os import requests from dotenv import load_dotenv from tenacity import retry, stop_after_attempt, wait_exponential load_dotenv() @retry( wait=wait_exponential(multiplier=1, min=2, max=30), stop=stop_after_attempt(5), ) def transcribe_with_retries(file_path: str) -> dict: """ Transcribe audio with retries for transient API or network failures. """ api_key = os.getenv("SMALLEST_API_KEY") if not api_key: raise ValueError("Missing SMALLEST_API_KEY in environment variables.") url = "https://api.smallest.ai/waves/v1/pulse/get_text" params = { "language": "en", "word_timestamps": "true", "diarize": "false", } headers = { "Authorization": f"Bearer {api_key}", "Content-Type": "audio/wav", } with open(file_path, "rb") as audio_file: लागत उत्पादन का दूसरा आश्चर्य है। अधिकांश ट्रांसक्रिप्शन API प्रति मिनट बिल करते हैं, जिसका अर्थ है कि "बस इसे चलाएं" तेजी से महंगा हो सकता है। दो आदतें खर्च को अनुमानित रखती हैं: अपलोड करने से पहले अवधि की जांच करें (और ऐप लेयर पर अपने कैप से ऊपर की किसी भी चीज़ को अस्वीकार करें), और परिणाम कैश करें ताकि एक ही फ़ाइल को दो बार ट्रांसक्राइब न किया जाए। ऑडियो का एक कंटेंट हैश एक व्यावहारिक कैश कुंजी बनाता है। यदि आप बड़े पैमाने पर निर्माण कर रहे हैं, तो स्पीच-टू-टेक्स्ट गाइड उच्च-थ्रूपुट आर्किटेक्चर, एसिंक वर्कर्स, कतारों और उन पैटर्नों में प्रवेश करता है जो लंबे समय तक चलने वाले पाइपलाइनों को स्थिर रखते हैं। ट्रांसक्रिप्शन सटीकता के बारे में अधिकांश डेवलपर्स क्या गलत समझते हैं। एक 5% WER तब तक छोटा लगता है जब तक आप इसका अनुवाद नहीं करते: लगभग हर 20 शब्दों में से 1 गलत है। 500 शब्दों की मीटिंग सारांश में, यह लगभग 25 त्रुटियां हैं। अत्याधुनिक मॉडल भी साफ बेंचमार्क स्थितियों की तुलना में शोर वाले, सहज संवादात्मक भाषण पर सार्थक रूप से उच्च शब्द त्रुटि दर दिखाते हैं (कभी-कभी 20% से अधिक) यही कारण है कि अपने स्वयं के ऑडियो पर परीक्षण करना गैर-परक्राम्य है। इसलिए बेंचमार्क ऐसे करें जैसे आपका कोई मतलब हो। अपने API का परीक्षण उस ऑडियो पर करें जो आपके उत्पाद से मेल खाता हो, न कि साफ डेमो क्लिप पर। वास्तविक वातावरण से 10-15 मिनट कैप्चर करें, सटीकता मापें, और उसके बाद ही प्रतिबद्ध हों। डोमेन शब्दावली वह जगह है जहाँ सामान्य मॉडल सबसे अधिक लड़खड़ाते हैं, चिकित्सा शब्द, उत्पाद के नाम, आंतरिक संक्षिप्त शब्द। यदि आपका प्रदाता कस्टम शब्दावली या डोमेन अनुकूलन प्रदान करता है, तो इसका उपयोग तब करें जब विशेष शब्दावली काम का हिस्सा हो। सारांश और अगले कदम। Python में एक भरोसेमंद ऑडियो-टू-टेक्स्ट पाइपलाइन आमतौर पर चार विषयों पर निर्भर करती है: API द्वारा देखे जाने से पहले ऑडियो को सामान्य करें, प्रतिक्रिया को संरचित डेटा के रूप में मानें (एकल स्ट्रिंग नहीं), ओवरलैप के साथ लंबी रिकॉर्डिंग को चंक करें, और पुन: प्रयास और त्रुटि हैंडलिंग को प्रथम-श्रेणी की सुविधाओं के रूप में बनाएं। यहाँ दिए गए स्निपेट जानबूझकर छोटे रखे गए हैं ताकि आप उन्हें बिना दोबारा लिखे अपने खुद के स्टैक में डाल सकें। जैसे-जैसे उपयोग बढ़ेगा, आप संभवतः एसिंक प्रोसेसिंग, एक जॉब कतार और परिणामों के लिए टिकाऊ स्टोरेज जोड़ेंगे, लेकिन कोर फ्लो नहीं बदलता है। यदि आप स्पीच-टू-टेक्स्ट प्रदाताओं की तुलना कर रहे हैं, तो Smallest.ai का Pulse उन डेवलपर्स के लिए बनाया गया है जो विलंबता, ट्रांसक्रिप्शन गुणवत्ता और एक ऐसे API की परवाह करते हैं जो सफाई से एकीकृत होता है। यह स्ट्रीमिंग ट्रांसक्रिप्शन, स्पीकर डायराइजेशन, वर्ड-स्तरीय टाइमस्टैम्प और आउट ऑफ द बॉक्स बहुभाषी ऑडियो का समर्थन करता है, जो ऊपर दिए गए उत्पादन पैटर्नों के साथ संरेखित होता है। आज ही Python में ऑडियो ट्रांसक्राइब करना शुरू करने के लिए Pulse और Waves API का अन्वेषण करें। Python में उत्पादन के लिए तैयार ट्रांसक्रिप्शन पाइपलाइन के चार स्तंभ। गशवर्क टीम: इसे अनदेखा करें। Python में ऑडियो ट्रांसक्रिप्शन बनाएं। आज ही स्पीच-टू-टेक्स्ट वर्कफ़्लो का परीक्षण शुरू करें। निर्माण शुरू करें https://app.smallest.ai/ FAQ पंक्ति केवल तभी दिखाई देगी जब FAQ उत्तर सेट होगा। कृपया सुनिश्चित करें कि प्रश्न और उत्तर दोनों सेट हैं। FAQ अनुभाग की दृश्यता FAQ प्रश्न 1 के सेट होने से जुड़ी है।](https://framerusercontent.com/images/5h0IzsaRLohS5uAxf7C2xhgJnOI.png?width=1456&height=816)