STT, अनुवाद, और TTS APIs के साथ एक AI डबिंग पाइपलाइन कैसे बनाएं
STT, अनुवाद, और TTS API के लिए AI डबिंग पाइपलाइन आर्किटेक्चर, जिसमें टाइमस्टैम्प, डायरैजेशन (diarization), लंबाई की जांच, QA हैंडऑफ़, और वॉइस क्लोनिंग सेटअप शामिल हैं।
डेवलपर्स, कंटेंट प्लेटफॉर्म और मीडिया कंपनियां APIs का उपयोग करके अपने खुद के डबिंग स्टैक तैयार कर रही हैं: स्पीच-टू-टेक्स्ट, ट्रांसलेशन और टेक्स्ट-टू-स्पीच को ऐसे वर्कफ़्लो में जोड़ा जा रहा है, जिसके लिए पांच साल पहले एक प्रोडक्शन टीम बुक करनी पड़ती।
इसके बाद व्यावहारिक आर्किटेक्चर आता है: वास्तविक दुनिया के कठिन मामलों में पाइपलाइन के टूटे बिना आप कच्चे ऑडियो इनटेक से सिंथेसाइज़्ड वॉयस आउटपुट तक कैसे पहुँचते हैं। चाहे आप सिंगल-लैंग्वेज प्रोटोटाइप भेज रहे हों या बहुभाषी प्रोडक्शन सिस्टम, प्रत्येक चरण में आपके द्वारा किए गए समझौते अंतिम ऑडियो में दिखाई देते हैं। यहाँ लक्ष्य इस बात का एक कामकाजी मानसिक मॉडल प्रदान करना है कि ये तीनों APIs कैसे जुड़ते हैं, वे कहाँ विफल होते हैं, और उन विफलताओं को रोकने के लिए क्या उपाय किए जाने चाहिए ताकि वे अंतिम उत्पाद में न दिखें।
वास्तव में एक AI डबिंग पाइपलाइन क्या करती है
AI डबिंग एक भाषा में बोली जाने वाली बात को दूसरी भाषा में सिंथेसाइज़्ड स्पीच के साथ स्वचालित रूप से बदलने की प्रक्रिया है। यह सरल परिभाषा सच है, लेकिन यह इसके कठिन हिस्सों को छिपा देती है: वक्ता की पहचान को बनाए रखना, भावनात्मक इरादे को बरकरार रखना, समय की सीमाओं को पूरा करना ताकि डब लंबा न खिंचे, और उस स्पष्ट "रोबोट जैसी रीडिंग" की गति से बचना। वर्कफ़्लो तीन मुख्य चरणों में टूटता है: स्पीच-टू-टेक्स्ट के माध्यम से ट्रांसक्रिप्शन, ट्रांसक्रिप्ट का अनुवाद, और अंतिम ऑडियो उत्पन्न करने के लिए टेक्स्ट-टू-स्पीच सिंथेसिस। प्रत्येक चरण के अपने विफल होने के तरीके हैं, और पाइपलाइन में उन्हें गुणा करने की आदत होती है।
आर्थिक कारण एक महत्वपूर्ण वजह हैं जिसके कारण टीमें इसे प्रोग्रामेटिक रूप से बनाती हैं। AI-आधारित पाइपलाइनें पारंपरिक स्टूडियो डबिंग लागतों के एक अंश पर चलती हैं, जिससे उन टीमों के लिए भी स्केलेबल बहुभाषी उत्पादन वास्तविक बन जाता है जो पहले इसे वहन नहीं कर सकती थीं। अमेज़ॅन और यूट्यूब दोनों ने अपने प्लेटफॉर्म पर AI डबिंग क्षमताओं का विस्तार किया है, जो दर्शाता है कि तीन-चरणीय पाइपलाइन पैटर्न पहले से ही उत्पादन वातावरण में बड़े पैमाने पर काम कर रहा है।
चरण 1: स्पीच-टू-टेक्स्ट ट्रांसक्रिप्शन
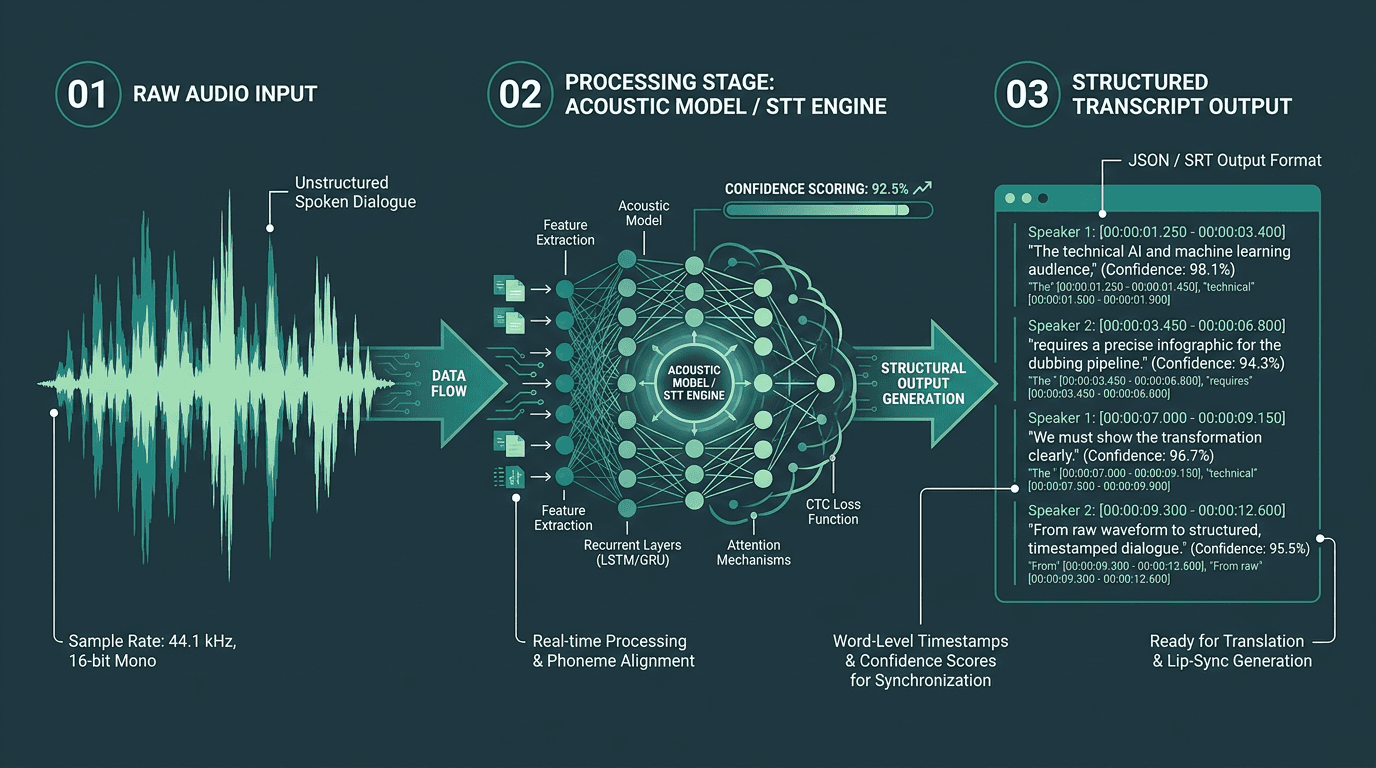
डाउनस्ट्रीम डबिंग प्रक्रियाओं का समर्थन करने के लिए STT आउटपुट में सटीक टाइमस्टैम्प और स्पीकर लेबल शामिल होने चाहिए।
यदि आपकी पाइपलाइन टूटने वाली है, तो आमतौर पर इसकी शुरुआत यहीं से होती है। 5% शब्द त्रुटि दर सुनने में सहने योग्य लगती है जब तक कि आप इसे प्रभाव में अनुवादित नहीं करते: दो मिनट के सेगमेंट में, आपके अनुवाद इंजन को लगभग 15 से 20 बिगड़े हुए शब्द सौंपे जा रहे होते हैं। अनुवाद मॉडल वही करेगा जो उसे करने के लिए बनाया गया है (कुछ धाराप्रवाह प्रस्तुत करना) और TTS परत उस धाराप्रवाह गलती को पूरे विश्वास के साथ पढ़ेगी। खराब इनपुट, पॉलिश किया हुआ खराब आउटपुट।
एक प्रोडक्शन STT परत को केवल सादे टेक्स्ट से अधिक वापस करना होता है। आपको शब्द-स्तरीय टाइमस्टैम्प (सेगमेंट-स्तरीय पर्याप्त नहीं है), आवाज़ों को अलग करने के लिए स्पीकर डायराइजेशन, और आत्मविश्वास स्कोर की आवश्यकता होती है ताकि आप कम-विश्वास वाले क्षेत्रों को समीक्षा के लिए भेज सकें, बजाय इसके कि आप यह दिखावा करें कि वे ठीक हैं। यदि आप मल्टी-स्पीकर कंटेंट के साथ काम कर रहे हैं, तो अपने आर्किटेक्चर को लॉक करने से पहले स्पीकर डायराइजेशन पाइपलाइनों के बारे में स्पष्ट हो लें।
स्मॉलेस्ट.एआई (Smallest.ai) की पायथन में स्पीच रिकॉग्निशन गाइड STT को पायथन वर्कफ़्लो में जोड़ने के कार्यान्वयन विवरणों में जाती है। API पक्ष पर, स्मॉलेस्ट.एआई का पल्स (Pulse) कम-विलंबता, उच्च-सटीकता ट्रांसक्रिप्शन के लिए डिज़ाइन किया गया है जिसमें डबिंग वर्कफ़्लो के लिए आवश्यक संरचित आउटपुट होता है। आप जिस भी STT API का मूल्यांकन कर रहे हैं, उसे अपने वास्तविक कंटेंट डोमेन पर बेंचमार्क करें। पॉडकास्ट ऑडियो पर ट्यून किए गए मॉडल फिल्म संवाद, लहजे वाली बोली, या ओवरलैपिंग बातचीत पर अलग तरह से व्यवहार करते हैं, और वे अंतर डाउनस्ट्रीम में तेजी से दिखाई देते हैं।
चरण 2: अनुवाद और वे समस्याएँ जिनके बारे में कोई आपको चेतावनी नहीं देता
अनुवाद वह जगह है जहाँ बहुत सी इंजीनियरिंग टीमें हैरान रह जाती हैं। न्यूरल मशीन ट्रांसलेशन API को ट्रांसक्रिप्ट भेजना और लक्षित-भाषा का टेक्स्ट प्राप्त करना आसान हिस्सा है। ऐसा आउटपुट प्राप्त करना जो अर्थ के प्रति वफादार रहे, सांस्कृतिक रूप से सटीक बैठे, और फिर भी मूल बोली जाने वाली टाइमिंग में फिट हो, वह जगह है जहाँ असली काम शुरू होता है।
LLM-आधारित अनुवाद अभी भी कुछ भाषा युग्मों के लिए भाषा भ्रम और सांस्कृतिक मतिभ्रम (हलुसिनेशन) का सामना करता है, यही कारण है कि पेशेवर पाइपलाइनें अनुवाद आउटपुट को ड्राफ्ट टेक्स्ट के रूप में मानती हैं जिसके लिए QA की आवश्यकता होती है, न कि तैयार कॉपी के रूप में। अनूदित संवाद अक्सर भाषा युग्मों के बीच लंबाई में काफी बदल जाते हैं। पेशेवर डबिंग के एक बड़े पैमाने के अध्ययन में पाया गया कि कई अंग्रेजी-से-स्पेनिश और अंग्रेजी-से-जर्मन डब लाइनें स्रोत से 10% से अधिक भिन्न होती हैं, यही कारण है कि सिंथेसिस से पहले टाइमिंग की जांच महत्वपूर्ण होती है।
उत्पादन डबिंग पाइपलाइन के लिए अनुवाद परत की आवश्यकताएं:
सेगमेंट-जागरूक अनुवाद: सेगमेंट दर सेगमेंट अनुवाद करें, न कि एक एकल दस्तावेज़ के रूप में, ताकि वाक्य की सीमाएं आपके टाइमस्टैम्प के साथ संरेखित रहें।
लंबाई सामान्यीकरण (नॉर्मलाइजेशन): या तो संक्षिप्त आउटपुट के लिए प्रॉम्प्ट करें या एक पोस्ट-प्रोसेसिंग चेक जोड़ें जो अनूदित सेगमेंट की लंबाई की तुलना मूल अवधि से करे।
सांस्कृतिक अनुकूलन फ़्लैग: मुहावरों, संज्ञाओं और सांस्कृतिक रूप से विशिष्ट संदर्भों को नियमित रूप से मानवीय निर्णय की आवश्यकता होती है। यह मानने के बजाय कि मॉडल इसे सही समझता है, फ़्लैगिंग की व्यवस्था बनाएं।
औपचारिकता और टोन का संरक्षण: यदि कोई चरित्र अंग्रेजी में अनौपचारिक है, तो वे लक्षित भाषा में औपचारिक रूप से बाहर नहीं आने चाहिए। अनुवाद चरण में शैली का संदर्भ पास करें।
शब्दावली (ग्लॉसरी) लागू करना: ब्रांडेड कंटेंट या तकनीकी सामग्री के लिए, मुख्य शब्दों को लॉक करने के लिए ग्लॉसरी/शब्दावली सुविधाओं का उपयोग करें।
उत्पादन में, अनुवाद आउटपुट को ड्राफ्ट टेक्स्ट के रूप में मानें जो QA से होकर गुजरता है, न कि समाप्त कॉपी के रूप में जिसे आप सीधे सिंथेसिस के लिए भेज सकते हैं।
चरण 3: टेक्स्ट-टू-स्पीच सिंथेसिस
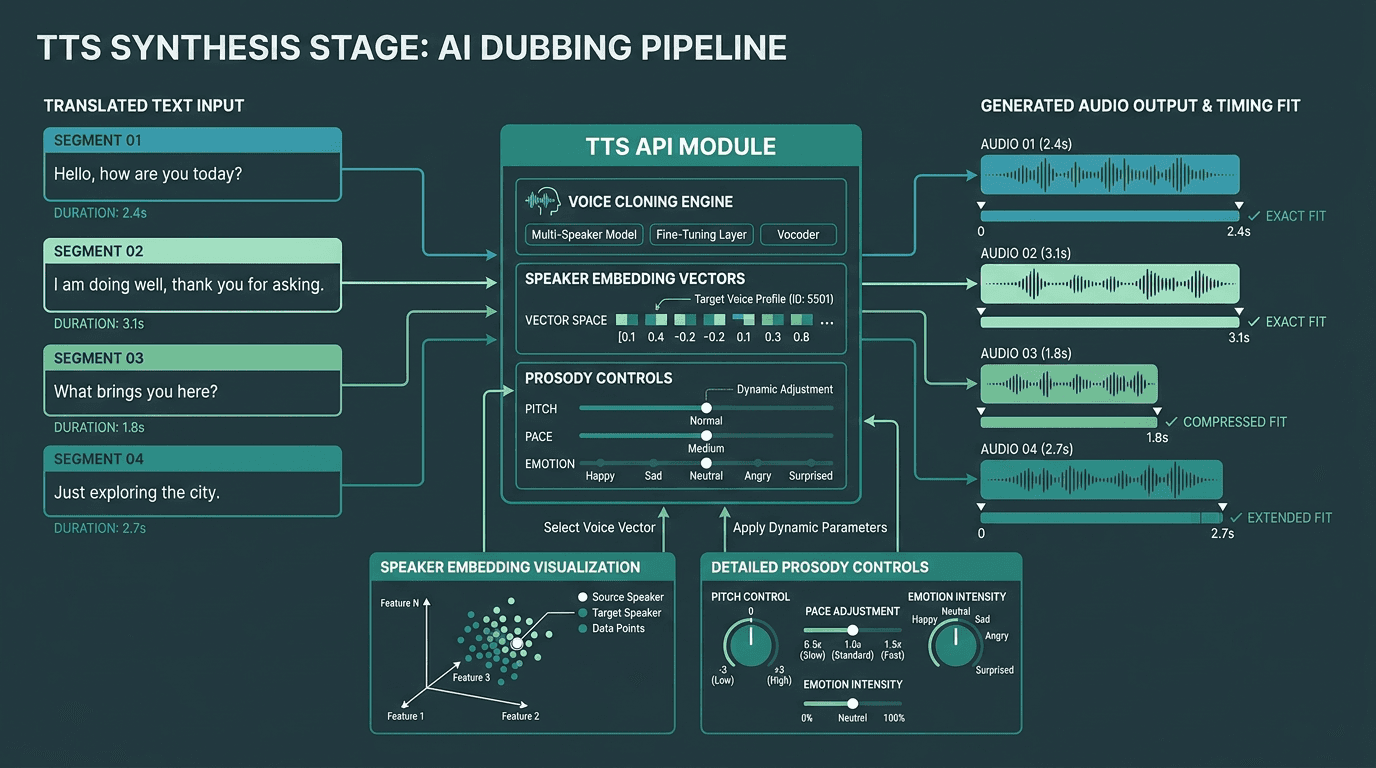
TTS सिंथेसिस को मूल ऑडियो से आवाज की विशेषताओं और समय की सीमाओं दोनों से मेल खाना चाहिए।
यह वह क्षण है जब आपका डब या तो मानव के रूप में पास हो जाता है या तुरंत अपनी पोल खोल देता है। TTS परत अनूदित सेगमेंट के साथ-साथ स्रोत टाइमस्टैम्प से प्राप्त लक्षित अवधि लेती है, फिर उसे ऐसी स्पीच सिंथेसाइज़ करनी होती है जो उस विंडो में फिट हो, फिर भी मूल वक्ता की तरह लगे, और फिर भी सही भावनात्मक इरादा व्यक्त करे।
वॉयस क्लोनिंग एक बुनियादी पाइपलाइन और ऐसी चीज के बीच की रेखा है जिसे आप पेशेवर रूप से भेज सकते हैं। प्रति वक्ता एक सामान्य सिंथेटिक आवाज़ असाइन करने के बजाय, आप स्रोत ऑडियो से मूल वक्ता को क्लोन करते हैं और उस वॉयस मॉडल का उपयोग करके अनूदित लाइनों को सिंथेसाइज़ करते हैं। अच्छी तरह से किए जाने पर, ऑडियो उसी व्यक्ति के रूप में लगता है, बस दूसरी भाषा बोल रहा होता है। कार्यान्वयन-केंद्रित वॉकथ्रू के लिए, पायथन में यथार्थवादी टेक्स्ट-टू-स्पीच बनाना API एकीकरण पैटर्न और उत्पादन सेटअप विचारों को कवर करता है।
इस चरण में भावनात्मक निष्ठा अभी भी एक कठिन समस्या बनी हुई है। सिंथेसाइज़्ड आवाज़ें अक्सर मूल प्रदर्शन के अभिव्यंजक दायरे को संकुचित कर देती हैं, एक सपाट टोन और गायब भावनात्मक सूक्ष्मता दो सबसे आम शिकायतें हैं जो उत्पादन फीडबैक में लगातार सामने आती हैं। यदि भावनात्मक सटीकता एक आवश्यकता है, तो मानव जैसी AI आवाज़ों के लिए गाइड प्रोसोडी, भावना मॉडलिंग और TTS API में क्या मूल्यांकन करना है, इस पर विस्तार से चर्चा करती है।
स्मॉलेस्ट.एआई का लाइटनिंग (Lightning) TTS API इसी डबिंग उपयोग के मामले को लक्षित करता है: कम-विलंबता सिंथेसिस, वॉयस क्लोनिंग समर्थन और अधिक अभिव्यंजक आउटपुट। यदि आपको रीयल-टाइम या निकट-रीयल-टाइम डबिंग की आवश्यकता है, तो स्ट्रीमिंग TTS स्पष्टीकरण पढ़ें। स्ट्रीमिंग सिंथेसिस आपके पाइपलाइन को संरचित करने के तरीके को बदल देता है।
तीनों चरणों को जोड़ना: पाइपलाइन आर्किटेक्चर
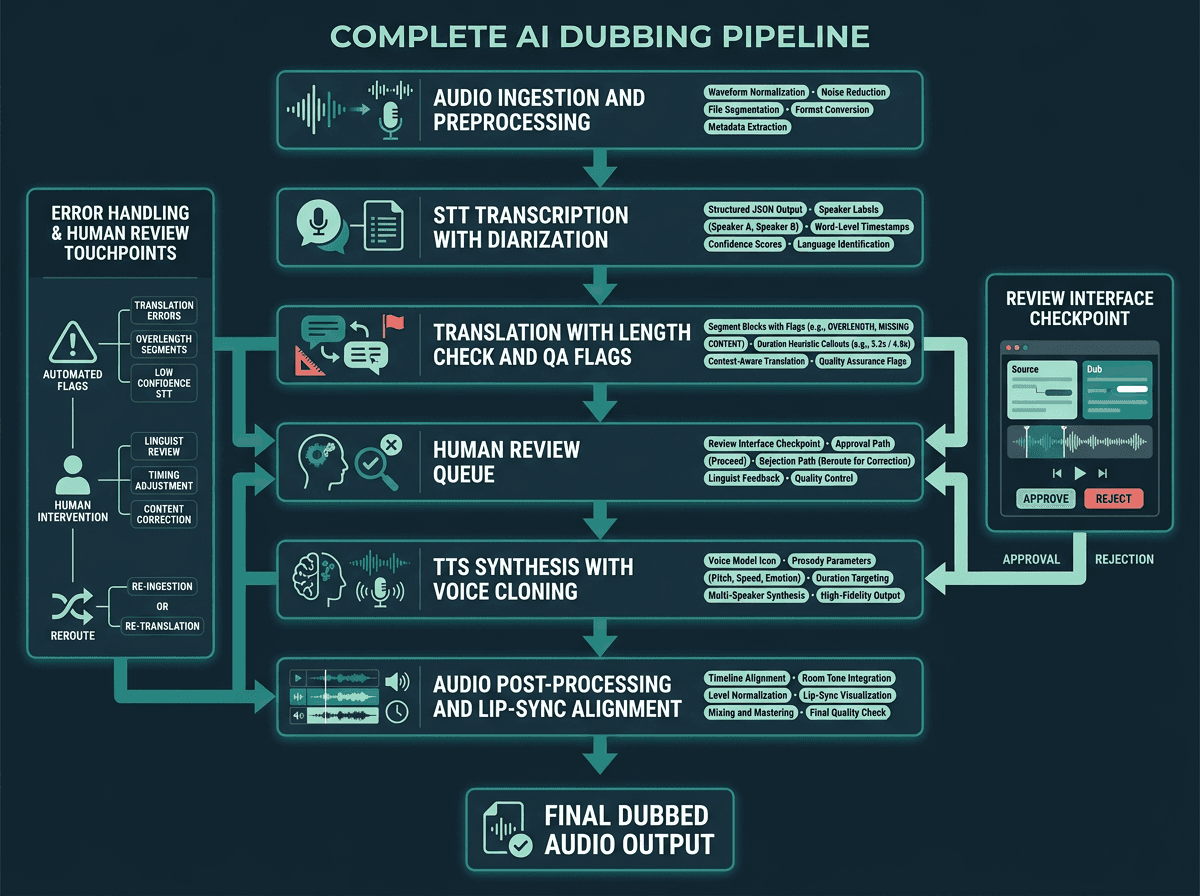
एक उत्पादन AI डबिंग पाइपलाइन में तीन मुख्य API चरणों के साथ प्रीप्रोसेसिंग, QA चेकपॉइंट और पोस्ट-प्रोसेसिंग शामिल हैं।
व्यवहार में, ये APIs केवल आसानी से "शृंखलाबद्ध" नहीं होते हैं। उत्पादन पाइपलाइनें STT को प्रीप्रोसेसिंग के साथ लपेटती हैं, अनुवाद और सिंथेसिस के बीच चेकपॉइंट रखती हैं, और TTS के बाद पोस्ट-प्रोसेसिंग जोड़ती हैं। एक विशिष्ट उत्पादन-ग्रेड आर्किटेक्चर इस तरह दिखता है:
क्रम में पाइपलाइन चरण:
ऑडियो प्रीप्रोसेसिंग: STT API को कॉल करने से पहले स्तरों को सामान्य करें, पृष्ठभूमि के शोर को कम करें, और लंबी फ़ाइलों को प्रबंधनीय खंडों में विभाजित करें। यह ट्रांसक्रिप्शन त्रुटियों को भौतिक रूप से कम कर सकता है।
डायराइजेशन के साथ STT: शब्द-स्तरीय टाइमस्टैम्प और स्पीकर लेबल के साथ ट्रांसक्राइब करें। सेगमेंट ID, स्पीकर ID, प्रारंभ समय, समाप्ति समय और टेक्स्ट के साथ संरचित JSON संग्रहीत करें।
लंबाई जांच के साथ अनुवाद: सेगमेंट का स्वतंत्र रूप से अनुवाद करें। अनुवाद के बाद, लक्षित भाषा के लिए कैरेक्टर-प्रति-सेकंड ह्यूरिस्टिक का उपयोग करके बोली जाने वाली अवधि का अनुमान लगाएं। उन सेगमेंट को फ़्लैग करें जहाँ अनुमान मूल अवधि से 15% से अधिक बढ़ जाता है।
मानव समीक्षा कतार: फ़्लैग किए गए सेगमेंट को एक समीक्षा इंटरफ़ेस पर भेजें। पेशेवर आउटपुट के लिए, यह चेकपॉइंट सिस्टम का हिस्सा है, न कि बाद का विचार। लक्ष्य सिंथेसिस से पहले सांस्कृतिक त्रुटियों और समय की समस्याओं को पकड़ना है।
वॉयस क्लोनिंग के साथ TTS सिंथेसिस: प्रत्येक स्वीकृत सेगमेंट को क्लोन किए गए वॉयस मॉडल, लक्षित अवधि और किसी भी प्रोसोडी/भावना मापदंडों के साथ TTS API पर भेजें। यदि API इसका समर्थन करता है, तो सटीक अवधि पर ऑडियो का अनुरोध करें।
ऑडियो पोस्ट-प्रोसेसिंग: सिंथेसाइज़्ड सेगमेंट को मूल वीडियो टाइमलाइन के साथ संरेखित करें, रूम टोन या पृष्ठभूमि ऑडियो का मिलान करें, और आउटपुट स्तरों को स्रोत के अनुसार सामान्य करें।
AI डबिंग पाइपलाइन के लिए API वर्कफ़्लो
एक बैच AI डबिंग कार्य के लिए एक सरलीकृत डेटा प्रवाह:
प्रसंस्करण सेवा पर स्रोत ऑडियो/वीडियो अपलोड करें।
STT API (जैसे, पल्स) को कॉल करें और इस तरह का संरचित आउटपुट प्राप्त करें:
टाइमस्टैम्प वाले सेगमेंट को अनुवाद API पर भेजें।
मूल सेगमेंट अवधि के विरुद्ध लंबाई/समय सत्यापन चलाएं।
स्वीकृत अनूदित सेगमेंट को अवधि और वॉयस क्लोन निर्देशों के साथ TTS API (जैसे, लाइटनिंग) पर भेजें:
अंतिम आउटपुट के लिए उत्पन्न ऑडियो सेगमेंट को वापस मूल वीडियो टाइमलाइन में जोड़ें।
उत्पादन पाइपलाइनें वास्तव में कहाँ टूटती हैं
अधिकांश ट्यूटोरियल "अनुक्रम में तीन APIs को कॉल करने" पर ही रुक जाते हैं। वास्तविक समस्याएं बाद में दिखाई देती हैं: विफलता के ऐसे तरीके जो केवल गड़बड़ कंटेंट के साथ या जब आप बड़े पैमाने पर प्रसंस्करण कर रहे होते हैं, तब दिखाई देते हैं।
उत्पादन में टाइमस्टैम्प बहाव (ड्रिफ्ट) सबसे आम समस्या है। STT APIs आपके द्वारा भेजे जाने वाले ऑडियो से टाइमस्टैम्प उत्पन्न करते हैं; यदि आपने उस ऑडियो को प्रीप्रोसेस किया है (चुप्पी को छोटा किया है, स्तरों को सामान्य किया है), तो वे टाइमस्टैम्प मूल वीडियो टाइमलाइन के सापेक्ष खिसक सकते हैं। या तो प्रीप्रोसेस्ड और मूल टाइमस्टैम्प के बीच मैपिंग को सुरक्षित रखें, या मूल ऑडियो पर STT चलाएं और पोस्ट-प्रोसेसिंग में बाद में शोर से निपटें।
जब वक्ता गैर-सन्निहित टुकड़ों में फिर से दिखाई देते हैं, तो सेगमेंट में वक्ता की निरंतरता बिखर जाती है। डायराइजेशन लेबल आम तौर पर एक दिए गए ऑडियो विंडो के लिए स्थानीय होते हैं। यदि आप एक लंबे वीडियो को 30-सेकंड के टुकड़ों में काटते हैं, तो टुकड़ा 1 में "स्पीकर A" टुकड़ा 3 में "स्पीकर B" बन सकता है। वॉयस क्लोन असाइन करने से पहले टुकड़ों में स्पीकर एम्बेडिंग का मिलान करने वाला एक समाधान चरण जोड़ें।
भाषा युग्म की गुणवत्ता में भिन्नता वास्तविक है, और इसे कम आंकना आसान है। एक पाइपलाइन जो अंग्रेजी-से-स्पेनिश के लिए ठोस है, अंग्रेजी-से-थाई या अंग्रेजी-से-अरबी के लिए तेजी से खराब हो सकती है, जहां संरचना और समय अलग-अलग व्यवहार करते हैं। प्रत्येक भाषा युग्म के लिए पूरी पाइपलाइन का शुरू से अंत तक सत्यापन करें जिसे आप समर्थन देने की योजना बना रहे हैं, न कि केवल उसी का जिसका आपने पहला प्रोटोटाइप बनाया है। भाषाओं में विकल्पों के व्यापक स्कैन के लिए, सर्वश्रेष्ठ AI डबिंग प्लेटफॉर्म का अवलोकन एक उपयोगी संदर्भ है।
उन्नत विचार: लिप-सिंक, विलंबता और आवाज की निरंतरता
लिप-सिंक संरेखण AI डबिंग में सीमांत समस्या है। NVIDIA का LipSync NIM और कंटेंट लोकलाइजेशन ब्लूप्रिंट दिखाते हैं कि कैसे AI वीडियो स्थानीयकरण वर्कफ़्लो लिप मूवमेंट्स को अनूदित या सिंथेसाइज़्ड ऑडियो के साथ सिंक्रोनाइज़ कर सकते हैं। अधिकांश API-आधारित प्रणालियों में, सच्चे लिप-सिंक का अर्थ एक वीडियो प्रोसेसिंग परत जोड़ना है जो या तो नए ऑडियो के अनुसार मुंह की गतिविधियों को समायोजित करती है या मूल फोनेम टाइमिंग का पालन करने के लिए TTS को बाधित करती है। यह महंगा कंप्यूट और अतिरिक्त जटिलता है, यही कारण है कि कई उत्पादन डिप्लॉयमेंट फ्रेम-परफेक्ट मैचिंग के बजाय अनुमानित लिप-सिंक से समझौता कर लेते हैं।
यदि आप लाइव डबिंग या रीयल-टाइम अनुवाद को लक्षित कर रहे हैं, तो आर्किटेक्चर प्रकार में बदल जाता है, डिग्री में नहीं। बैच की धारणाएं लागू होना बंद हो जाती हैं। आपको स्ट्रीमिंग STT, आंशिक वाक्यों पर काम करने वाले अनुवाद, और स्ट्रीमिंग TTS की आवश्यकता होती है जो पूरे सेगमेंट के आने से पहले बोलना शुरू कर सके। स्मॉलेस्ट.एआई का हाइड्रा (Hydra - स्पीच-टू-स्पीच) इन रीयल-टाइम पथों के लिए बनाया गया है, जो न्यूनतम मध्यवर्ती विलंबता के साथ STT-से-TTS मार्ग को संभालता है। यदि आपको शीर्ष पर संवादात्मक बातचीत की परत की भी आवश्यकता है, तो AI वॉयस एजेंट आर्किटेक्चर लेख बताता है कि स्पीच पाइपलाइन को पूर्ण एजेंट सिस्टम में कैसे विस्तारित किया जाए।
मुख्य निष्कर्ष और अगले कदम
एक AI डबिंग पाइपलाइन का एक सीधा आकार होता है: STT टाइमस्टैम्प के साथ भाषण को कैप्चर करता है, अनुवाद भाषाओं में अर्थ को ले जाता है, और TTS उस अर्थ को एक क्लोन की गई आवाज़ में प्रस्तुत करता है। आउटपुट की गुणवत्ता किसी एकल API विकल्प के बारे में कम और उनके बीच के जोड़ों के बारे में अधिक है: टाइमस्टैम्प, वक्ता की पहचान, और सेगमेंट की लंबाई की सीमाएं वे स्थान हैं जहां उत्पादन प्रणालियां जीतती या हारती हैं।
इस गाइड से क्या सीखें:
उत्पादन STT परत के लिए शब्द-स्तरीय टाइमस्टैम्प और स्पीकर डायराइजेशन आवश्यकताएं हैं।
अनुवाद की लंबाई का सामान्यीकरण ही वह चीज़ है जो सिंथेसाइज़्ड ऑडियो को टाइमलाइन से बहकने से बचाती है।
TTS चरण में वॉयस क्लोनिंग ही वह चीज़ है जो मूल वक्ता की पहचान को बनाए रखती है।
अनुवाद की गुणवत्ता के लिए मानवीय समीक्षा चेकपॉइंट महत्वपूर्ण हैं, विशेष रूप से नए भाषा युग्मों पर।
प्रत्येक भाषा युग्म का स्वतंत्र रूप से परीक्षण करें; प्रदर्शन स्वचालित रूप से भाषा परिवारों में स्थानांतरित नहीं होता है।
यदि आप निर्माण के लिए तैयार हैं, तो वॉयस-क्लोन वाले TTS के लिए लाइटनिंग, ट्रांसक्रिप्शन के लिए पल्स, और रीयल-टाइम स्पीच-टू-स्पीच वर्कफ़्लो के लिए हाइड्रा का परीक्षण करने के लिए स्मॉलेस्ट.एआई के वेव्स (Waves) API के साथ शुरुआत करें। डेवलपर्स सीधे app.smallest.ai पर निर्माण शुरू कर सकते हैं। यदि आप उत्पादन मीडिया या एंटरप्राइज वर्कफ़्लो के लिए AI डबिंग का मूल्यांकन कर रहे हैं, तो विलंबता, पैमाने और तैनाती आवश्यकताओं पर चर्चा करने के लिए एक डेमो बुक करें।
अक्सर पूछे जाने वाले प्रश्न
एक सोलो डेवलपर (अकेले काम करने वाले डेवलपर) के लिए न्यूनतम व्यावहारिक (minimum viable) एआई डबिंग पाइपलाइन क्या है?
मैं एआई डबिंग पाइपलाइन में कई वक्ताओं (स्पीकर्स) को कैसे संभालूँ?
मानव डबिंग की तुलना में एआई डबिंग कितनी सटीक है?
क्या मैं रीयल-टाइम या लाइव कंटेंट के लिए एआई डबिंग का उपयोग कर सकता हूँ?
डबिंग के मामलों के लिए विशेष रूप से टीटीएस (TTS) एपीआई में मुझे क्या देखना चाहिए?