एआई डबिंग पाइपलाइन्स: अनुवाद, टाइमिंग और टीटीएस के साथ वीडियो ऑडियो का स्थानीयकरण
एआई डबिंग पाइपलाइनों को समझें: बिना स्टूडियो वर्कफ़्लो के वीडियो ऑडियो को स्थानीयकृत करने के लिए ट्रांसक्रिप्शन, अनुवाद, टाइमिंग अलाइनमेंट और टीटीएस आपस में कैसे फिट होते हैं।
डबिंग एआई अब कोई लैब एक्सपेरिमेंट नहीं रह गया है। जिस काम के लिए पहले एक स्टूडियो, वॉइस एक्टर्स की एक टीम और हफ्तों के पोस्ट-प्रोडक्शन की ज़रूरत होती थी, उसे अब एक सॉफ्टवेयर पाइपलाइन के रूप में बदला जा सकता है जो कुछ ही मिनटों में रन हो जाती है। यह बदलाव क्रिएटर्स, ई-लर्निंग प्लेटफॉर्म और मीडिया टीमों की मांग का नतीजा है, जिन्हें अपने प्रोडक्शन बजट को फिर से शुरू से तैयार किए बिना दर्जनों भाषाओं में कंटेंट डिलीवर करने की आवश्यकता होती है।
आगे जो बताया गया है वह यह है कि डबिंग पाइपलाइन व्यावहारिक रूप से कैसे काम करती है, उस पल से जब ऑडियो एक ट्रांसक्रिप्शन इंजन तक पहुंचता है से लेकर उस पल तक जब एक सिंथेसाइज्ड ट्रैक को वापस एक तैयार एडिट में मिक्स किया जाता है। मुख्य ध्यान आर्किटेक्चर, उन फेलियर पॉइंट्स पर है जिन्हें टीमें अक्सर भूल जाती हैं, और उन विकल्पों पर है जो किसी ऐसी चीज़ के बीच अंतर करते हैं जो ब्रॉडकास्ट के योग्य हो और जो किसी आईवीआर (IVR) मेनू जैसी लगती हो। यदि आप एक पाइपलाइन का निर्माण कर रहे हैं या किसी वेंडर की जांच कर रहे हैं, तो इससे आपको इस बात का ठोस अंदाजा होना चाहिए कि प्रत्येक चरण के लिए क्या आवश्यक है और वास्तविक इंजीनियरिंग समस्याएं कहाँ सामने आती हैं।
सॉफ्टवेयर के संदर्भ में वास्तव में डबिंग का क्या अर्थ है
डबिंग, पारंपरिक रूप से, पोस्ट-प्रोडक्शन रिप्लेसमेंट है: आप मूल डायलॉग को एक नए ट्रैक से बदलते हैं, जो आमतौर पर दूसरी भाषा में होता है। एक सॉफ्टवेयर पाइपलाइन में, उद्देश्य वही रहता है, लेकिन मेहनत लोगों से हटकर सिस्टम पर आ जाती है। बूथ में अभिनेताओं के बजाय, आप आम तौर पर तीन तकनीकों को जोड़ते हैं: सोर्स को कैप्चर करने के लिए स्पीच-टू-टेक्स्ट, लक्षित भाषा की स्क्रिप्ट तैयार करने के लिए मशीन ट्रांसलेशन, और उस स्क्रिप्ट को वापस ऑडियो में सिंथेसाइज करने के लिए टेक्स्ट-टू-स्पीच।
इस शब्द के बारे में थोड़ा सख्त होना ज़रूरी है क्योंकि "डबिंग" का इस्तेमाल कई आस-पास के कामों को शामिल करने के लिए किया जाने लगता है। सबटाइटल्स डबिंग नहीं हैं। डायलॉग को बदले बिना फुटेज के ऊपर डाली गई वॉयस-ओवर भी डबिंग नहीं है। उचित डबिंग डायलॉग ट्रैक को सिंथेसाइज्ड स्पीच से बदल देती है जो टाइमिंग, इमोशनल रजिस्टर और (आदर्श रूप से) स्पीकर की वोकल आइडेंटिटी का सम्मान करती है। लोकलाइजेशन इससे भी व्यापक है, जिसमें भाषा, संस्कृति और बाजार की अपेक्षाओं के लिए कंटेंट का अनुकूलन शामिल है। एक ऐसी पाइपलाइन जो शब्दों का अनुवाद तो करती है लेकिन मुहावरों, गति (पेसिंग) और रजिस्टर की अनदेखी करती है, वह तकनीकी रूप से तो "काम" कर सकती है, लेकिन फिर भी वह दर्शकों को प्रभावित करने में विफल रहेगी।
चरण एक: ट्रांसक्रिप्शन और अपस्ट्रीम सटीकता ही सब कुछ क्यों है
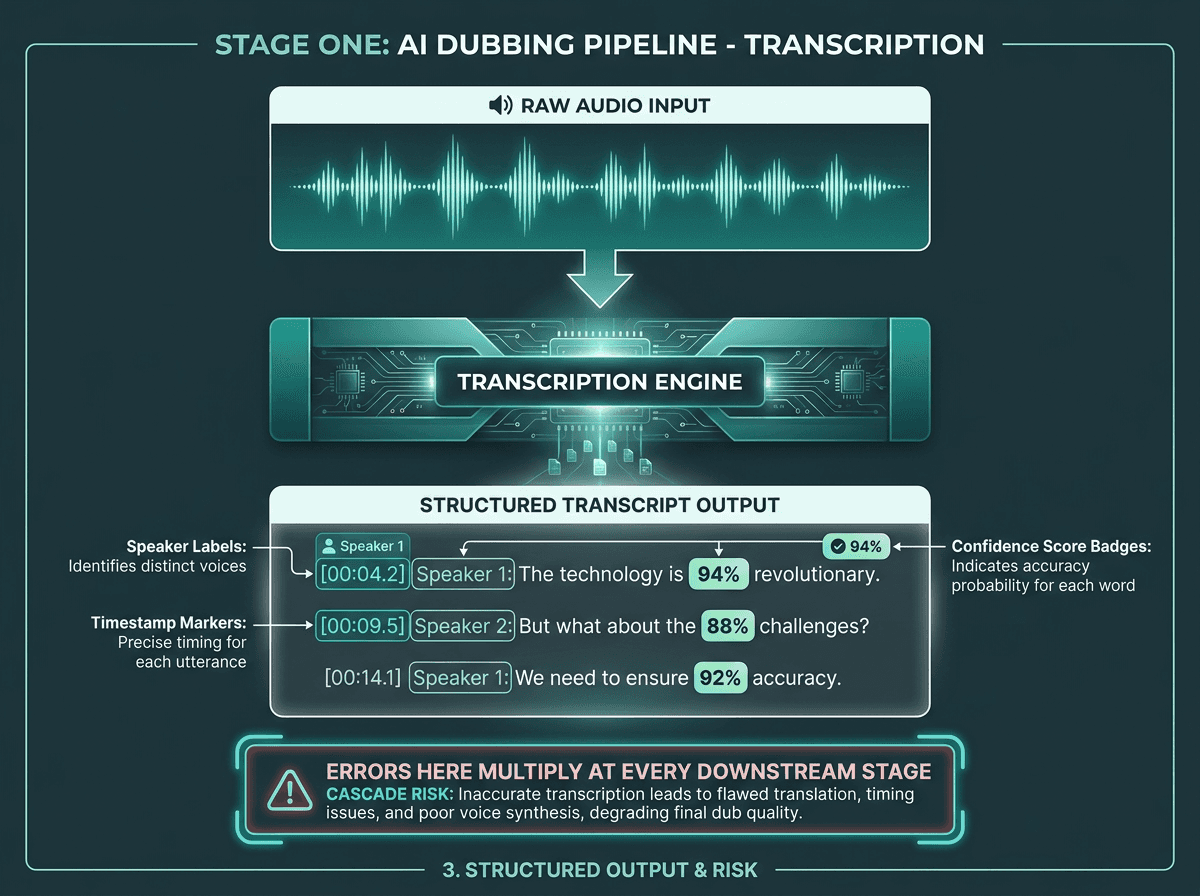
चरण 1 पर ट्रांसक्रिप्शन की सटीकता प्रत्येक डाउनस्ट्रीम चरण के लिए गुणवत्ता की सीमा तय करती है।
ट्रांसक्रिप्शन की गलतियाँ केवल वहीं तक सीमित नहीं रहतीं; वे बाकी की पूरी पाइपलाइन में फैलती चली जाती हैं, यही वजह है कि अपस्ट्रीम सटीकता समग्र गुणवत्ता पर आपके पास मौजूद सबसे बड़ा लीवर है। यह कोई छोटी बात नहीं है। यदि स्पीच-टू-टेक्स्ट सिस्टम किसी मुख्य शब्द को गलत सुनता है, तो अनुवाद मॉडल पूरी ईमानदारी से गलत चीज़ का अनुवाद करता है, टीटीएस (TTS) इंजन पूरे आत्मविश्वास के साथ उसे बोलता है, और आपको एक ऐसा डब किया हुआ ट्रैक मिलता है जो इस तरह से गलत होता है जिसे पकड़ना मुश्किल हो सकता है यदि समीक्षक केवल अंतिम आउटपुट सुनते हैं। जब तक कोई इसे सुनता है, तब तक त्रुटि पहले ही कई गुना बढ़ चुकी होती है और चमका दी गई होती है।
एक बार जब आप सिंगल-स्पीकर क्लिप्स से आगे बढ़ते हैं, तो केवल ट्रांसक्रिप्शन ही काफी नहीं रह जाता। पैनल चर्चाओं, साक्षात्कारों और वृत्तचित्रों (डॉक्युमेंट्री) को स्पीकर डायराइजेशन पाइपलाइनों की आवश्यकता होती है ताकि अनुवाद शुरू होने से पहले सिस्टम को पता चल सके कि किसने क्या कहा। डायराइजेशन के बिना, अनुवाद को केवल टेक्स्ट का एक बिना अंतर वाला ढेर दिखाई देता है, और टीटीएस के पास अलग-अलग वक्ताओं को अलग-अलग आवाज़ें आवंटित करने का कोई विश्वसनीय तरीका नहीं होता है। इसका परिणाम अनुमानित है: एक सिंथेटिक आवाज़ सब कुछ एक ही एकालाप (मोनोलॉग) की तरह पढ़ रही होती है।
एक प्रोडक्शन ट्रांसक्रिप्शन लेयर को आमतौर पर "कागज पर लिखे शब्दों" से अधिक की आवश्यकता होती है। आपको वर्ड-लेवल टाइमस्टैम्प (न केवल सेंटेंस-लेवल), स्पीकर लेबल, विराम चिह्न अनुमान (पंक्चुएशन इन्फरेंस), और डोमेन शब्दावली के लिए एक योजना की आवश्यकता होती है। एक कार्डियोलॉजी कोर्स एक सामान्य उद्देश्य वाले मॉडल की परीक्षा उस तरह से लेगा जिस तरह से सामान्य बातचीत नहीं लेगी। पेशेवर उपयोग के लिए, डोमेन अनुकूलन (अडैप्टेशन) या कस्टम वोकैबुलरी सपोर्ट होना केवल एक अतिरिक्त सुविधा नहीं है; यह ट्रांसक्रिप्शन इंजन के काम का एक अनिवार्य हिस्सा है।
चरण दो: अनुवाद जो अर्थ को सुरक्षित रखता है, न कि केवल शब्दों को
मशीन अनुवाद कुछ साल पहले की तुलना में काफी बेहतर है, लेकिन "सही" और "बोले जाने योग्य" के बीच अभी भी एक बड़ा अंतर है। लिखित दस्तावेजों के लिए ट्यून किए गए मॉडल अक्सर ऐसे टेक्स्ट का निर्माण करते हैं जो जोर से बोलने पर अजीब लगते हैं, खासकर जब इसे टीटीएस के माध्यम से प्रोसेस किया जाता है। बातचीत संकुचनों (कॉन्ट्रैक्शंस), छूटे हुए शब्दों, लय और सांस पर निर्भर करती है। यदि आपका अनुवाद आउटपुट ऐसा लगता है जिसे आप कानूनी विभाग (लीगल) में फाइल करेंगे, तो सिंथेसाइज्ड डब भी वैसा ही लगेगा।
तीन अनुवाद चुनौतियाँ जो विशेष रूप से डबिंग पाइपलाइनों के लिए हैं:
आइसोक्रोनी (Isochrony): अनुवादित टेक्स्ट को मूल लाइन के समान ही समय सीमा में समाप्त होना चाहिए। स्पेनिश और जर्मन अक्सर अंग्रेजी की तुलना में लंबे समय तक चलते हैं। यदि अनुवाद 40% लंबा निकलता है, तो आप या तो टीटीएस को इसे तेजी से पढ़ने के लिए मजबूर करते हैं या फिर आप अगले वक्ता के समय में प्रवेश कर जाते हैं।
रजिस्टर मैचिंग: अनुवाद के बाद एक अनौपचारिक वक्ता को अनौपचारिक ही लगना चाहिए। यदि डब अचानक औपचारिक रजिस्टर में बदल जाता है, तो ऑडियो ऑन-स्क्रीन बॉडी लैंग्वेज के विपरीत हो जाता है।
मुहावरेदार सटीकता: शाब्दिक मुहावरा अनुवाद निरर्थक अर्थ उत्पन्न करने का एक पक्का तरीका है। "इट्स रेनिंग कैट्स एंड डॉग्स" का अधिकांश भाषाओं में सीधा अनुवाद नहीं होता है, और शब्द-दर-शब्द अनुवाद दर्शकों को भ्रमित करेगा।
कम बोली जाने वाली भाषाएं इसे उन तरीकों से कठिन बनाती हैं जो सामान्य अंग्रेजी-स्पेनिश डेमो में दिखाई नहीं देते हैं। कम संसाधन वाली भाषाओं का अनुवाद (Low-resource language translation) अभी भी एक सक्रिय शोध विषय है क्योंकि कई मॉडल अंग्रेजी-स्पेनिश या अंग्रेजी-फ्रेंच जैसे उच्च-संसाधन वाले जोड़ों पर भारी रूप से प्रशिक्षित होते हैं। जब प्रशिक्षण डेटा कम होता है, तो अनुवाद की गुणवत्ता गिर जाती है, और पाइपलाइन अपस्ट्रीम ट्रांसक्रिप्शन के शोर के प्रति कम सहनशील हो जाती है। यदि आप दक्षिण एशियाई, अफ्रीकी या दक्षिण-पूर्व एशियाई बाजारों के लिए निर्माण कर रहे हैं, तो आपको उच्च-संसाधन बेंचमार्क के सामान्य होने की उम्मीद करने के बजाय उन विशिष्ट भाषा जोड़ों पर गुणवत्ता का ऑडिट करने की आवश्यकता है।
चरण तीन: वॉयस सिंथेसिस और टाइमिंग की समस्या
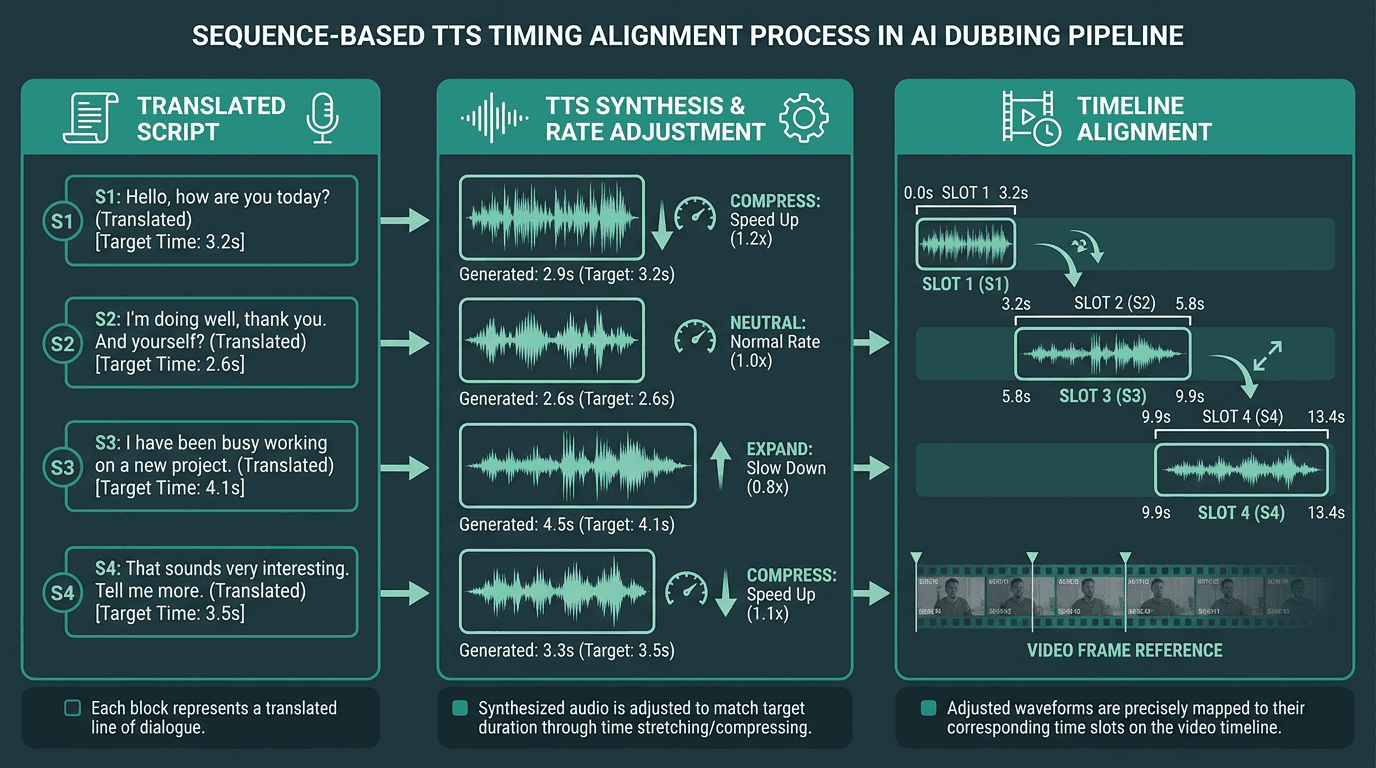
सिंथेसाइज्ड ऑडियो को मूल वक्ता की टाइमिंग विंडो के साथ संरेखित (अलाइन) किया जाना चाहिए, न कि केवल उत्पन्न करके सीधे डाल दिया जाना चाहिए।
टेक्स्ट-टू-स्पीच वह जगह है जहाँ एक डबिंग पाइपलाइन या तो विश्वसनीय लगती है या तुरंत खुद को उजागर कर देती है। अनुवादित टेक्स्ट को ऑडियो में बदलना आसान काम है। वास्तविक काम ऐसा ऑडियो तैयार करना है जो मूल टाइमिंग के अनुकूल हो, वक्ता के भावनात्मक इरादे को ट्रैक करे, और "सिस्टम वॉयस" के बजाय मानव की तरह लगे। प्रोडक्शन-ग्रेड टेक्स्ट-टू-स्पीच वॉयस ट्रांसलेशन नियंत्रण पर निर्भर करता है: बोलने की दर (रेट), प्रोसोडी (लहजा), और ठहराव, न कि केवल फोनिम्स पर।
टाइमिंग वह बाधा है जो डबिंग टीटीएस को एक साधारण एपीआई कॉल के बजाय एक इंजीनियरिंग समस्या बनाती है। प्रत्येक सिंथेसाइज्ड खंड को मूल उच्चारण द्वारा परिभाषित ब्रैकेट में फिट होना चाहिए। यदि मूल लाइन को बोलने में 3.2 सेकंड लगे, तो अनुवादित लाइन को भी लगभग उसी 3.2 सेकंड में रहना होगा। आप टीटीएस की बोलने की दर को समायोजित करके, अनुवाद चरण के दौरान अनुवाद को संपीड़ित (कंप्रेस) करके, या कुछ विचलन की अनुमति देकर और बाद में इसे ठीक करके वहां तक पहुंच सकते हैं। प्रोडक्शन में, अधिकांश पाइपलाइनों में इन तीनों का मिश्रण होता है, क्योंकि कोई भी एक तरीका हर सेगमेंट को स्पष्ट रूप से कवर नहीं करता है।
वॉयस क्लोनिंग आउटपुट के अहसास को बदल देती है, विशेष रूप से जाने-माने वक्ताओं के लिए। प्रति भाषा एक सामान्य आवाज़ देने के बजाय, एक क्लोनिंग-सक्षम पाइपलाइन वक्ता की वोकल विशेषताओं को मॉडल कर सकती है और अनुवाद को ऐसी आवाज़ में सिंथेसाइज कर सकती है जो मूल जैसी लगती है। अच्छी तरह से किए जाने पर, यह सभी भाषाओं में पहचान को बनाए रखता है, जो तब मायने रखता है जब दर्शक पहले से ही किसी व्यक्ति को एक विशेष आवाज़ से जोड़ते हैं। प्रति वक्ता आपके पास कितना साफ सोर्स ऑडियो है, इसके आधार पर लागत और गुणवत्ता में बड़ा उतार-चढ़ाव होता है।
विजुअल डबिंग: जब केवल ऑडियो ही काफी न हो
कुछ सिस्टम केवल ऑडियो रिप्लेसमेंट से आगे बढ़कर विजुअल डबिंग की ओर जाते हैं, जहाँ मॉडल टारगेट भाषा के फोनिम्स से बेहतर मेल खाने के लिए ऑन-स्क्रीन लिप मूवमेंट को समायोजित करते हैं। यह महत्वपूर्ण है क्योंकि विभिन्न भाषाएं चेहरे के अलग-अलग आकार बनाती हैं। चेहरे पर "हेलो" और "होला" एक जैसे नहीं दिखते। जब मुंह की हलचल और ऑडियो आपस में मेल नहीं खाते, तो दर्शक इस पर ध्यान देते हैं, और एक बार जब वे इस पर ध्यान देते हैं, तो पूरा प्रोडक्शन कम विश्वसनीय लगने लगता है।
विजुअल डबिंग मुफ़्त नहीं है: यह कंप्यूट-हैवी है और पाइपलाइन को काफी जटिल बनाती है। ई-लर्निंग, पॉडकास्ट-टू-वीडियो और नरेटेड एक्सप्लेनर्स के लिए, आप अक्सर इसे छोड़ सकते हैं क्योंकि वक्ता कैमरे पर नहीं होता है या उसका मुंह स्पष्ट रूप से दिखाई नहीं देता है। स्क्रिप्टेड ड्रामा, डॉक्यूमेंट्री इंटरव्यू और किसी भी ऐसे फॉर्मेट के लिए जहां चेहरा फ्रेम में पूरी तरह दिखाई देता है, पेशेवर परिणाम पाने के लिए विजुअल डबिंग "अच्छी सुविधा" से "अनिवार्य" हो जाती है।
बिल्डिंग बनाम बाइंग: पाइपलाइन आर्किटेक्चर के निर्णय में वास्तव में क्या शामिल है
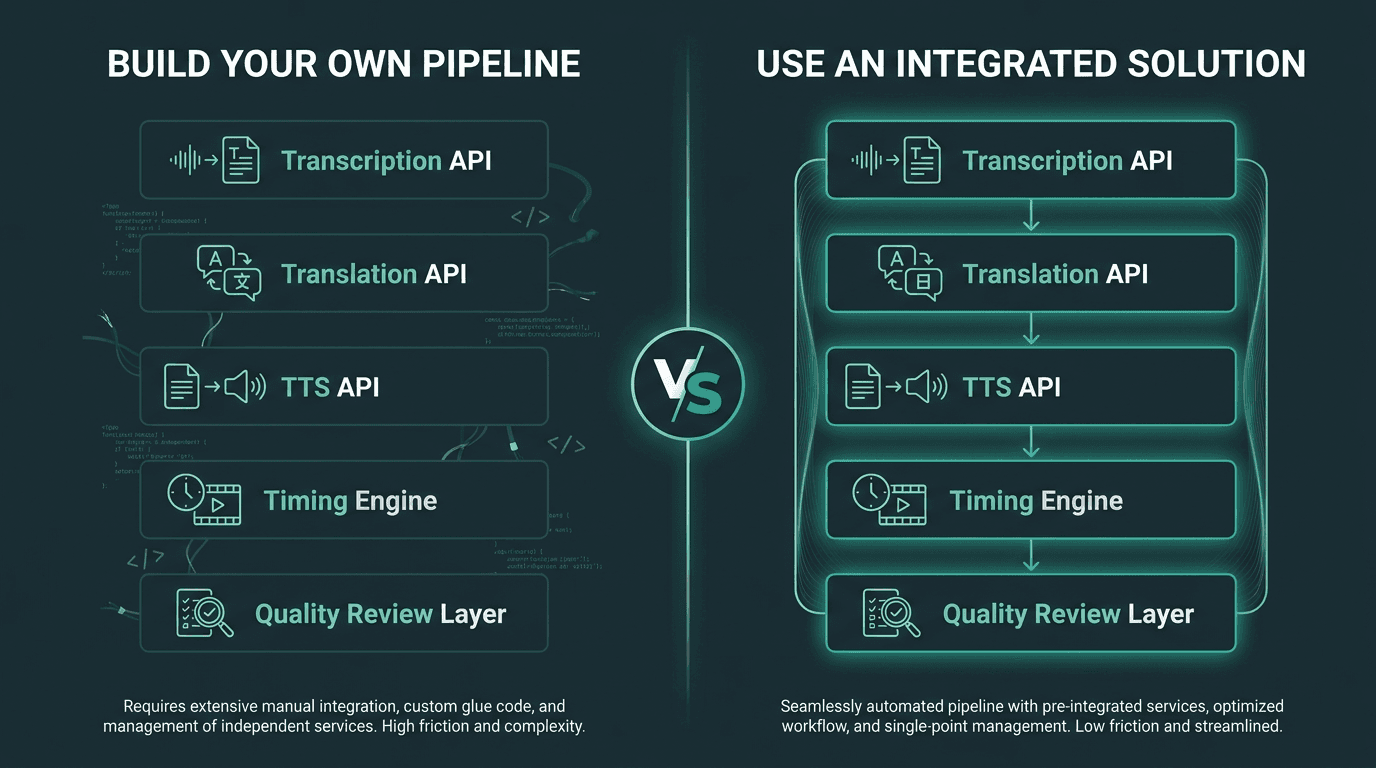
एक कस्टम पाइपलाइन बनाने से नियंत्रण मिलता है; एकीकृत समाधान गति और कम रखरखाव ओवरहेड के लिए लचीलेपन का सौदा करते हैं।
टीमें अक्सर इस बात को कम आंकती हैं कि "हमारे पास तीन एपीआई हैं" और "हमारे पास एक पाइपलाइन है" के बीच कितना काम होता है। प्रत्येक चरण थोड़ा अलग प्रारूप (डायलैक्ट) बोलता है। ट्रांसक्रिप्शन इंजन टाइमस्टैम्प वाला JSON रिटर्न करते हैं। ट्रांसलेशन एपीआई को प्लेन टेक्स्ट चाहिए होता है। टीटीएस इंजन टेक्स्ट लेते हैं, कभी-कभी प्रोसोडी मार्कअप के साथ। ग्लू कोड (फॉर्मेट कन्वर्जन, रिट्राइज़, सेगमेंटिंग, एरर हैंडलिंग और फाइनल ऑडियो असेंबली) कोई आकर्षक काम नहीं है, यही वजह है कि इसे अक्सर कम डिज़ाइन किया जाता है।
एआई डबिंग पारंपरिक स्टूडियो डबिंग की तुलना में लागत को काफी कम कर सकती है, जहां प्रति मिनट की लागत काफी हो सकती है। वह अंतर केवल तभी कायम रहता है जब पाइपलाइन भरोसेमंद हो। यदि किसी कस्टम बिल्ड को 30% फ़ाइलों पर मानवीय हस्तक्षेप की आवश्यकता होती है, तो आपने लागत को हटाया नहीं है; आपने इसे वॉयस टैलेंट से हटाकर इंजीनियरिंग समय पर शिफ्ट कर दिया है। बनाने या खरीदने (build-vs-buy) का निर्णय आपकी टीम की क्षमता और उस कंटेंट वॉल्यूम की ईमानदार समझ पर आधारित होना चाहिए जो इस निवेश को तर्कसंगत बनाता है।
यदि आप सर्वश्रेष्ठ एआई डबिंग प्लेटफॉर्म का मूल्यांकन कर रहे हैं, तो आर्किटेक्चर के प्रश्न बिल्कुल ठोस हैं। क्या आपको एपीआई मिलते हैं, या आप केवल एक यूआई (UI) तक सीमित हैं? क्या आप ट्रांसक्रिप्शन में कस्टम वोकैबुलरी जोड़ सकते हैं? क्या टीटीएस लेयर वॉयस क्लोनिंग प्रदान करती है या केवल प्रीसेट आवाजें देती है? और वह सवाल जो आमतौर पर यह तय करता है कि आउटपुट पेशेवर लगता है या नहीं: प्लेटफ़ॉर्म टाइमिंग अलाइनमेंट के बारे में क्या करता है, जहाँ कई ऑफ-द-शेल्फ समाधान चुपचाप समझौता कर लेते हैं।
क्वालिटी कंट्रोल (QC): वह लेयर जिसे अधिकांश पाइपलाइनें छोड़ देती हैं
ऑटोमेशन से गति मिलती है, आत्म-सुधार नहीं। एक प्रोडक्शन पाइपलाइन को कम से कम तीन चौकियों (चेकपॉइंट्स) की आवश्यकता होती है: अनुवाद से पहले ट्रांसक्रिप्ट की समीक्षा, सिंथेसिस से पहले अनुवाद की समीक्षा, और सिंथेसिस के बाद ऑडियो समीक्षा। पहले दो को आंशिक रूप से कॉन्फिडेंस स्कोर और बैक-ट्रांसलेशन चेक के साथ छांटा जा सकता है। तीसरे के लिए अभी भी इंसानी सुनने का फायदा मिलता है, भले ही वह सैंपलिंग पर आधारित हो, क्योंकि कटे हुए शब्द, अजीब लहजा (प्रोसोडी), और टाइमिंग का भटकना जैसी समस्याओं को कोड में विश्वसनीय रूप से चिह्नित करना मुश्किल होता है।
जैसे-जैसे एआई डबिंग टूल्स का बाजार बढ़ रहा है, इसके साथ ही अधिक क्यूसी (QC) टूलिंग भी सामने आ रही है। इसमें ऑटोमेटेड लिप-सिंक स्कोरिंग, सिंथेसाइज्ड ऑडियो के लिए एमओएस (मीन ओपिनियन स्कोर) का आकलन, और अनुवाद गुणवत्ता आकलन मॉडल शामिल हैं जो उन हिस्सों को उजागर करते हैं जिनके गलत होने की संभावना है। इसमें से कोई भी मानवीय समीक्षा की जगह नहीं लेता है, लेकिन यह टीमों को वहां ध्यान केंद्रित करने में मदद करके अर्थशास्त्र को बदल देता है जहां इसके सफल होने की सबसे अधिक संभावना होती है।
एक डबिंग पाइपलाइन को बड़े पैमाने पर ले जाने (स्केलिंग) के बारे में अधिकांश टीमें क्या गलतियाँ करती हैं
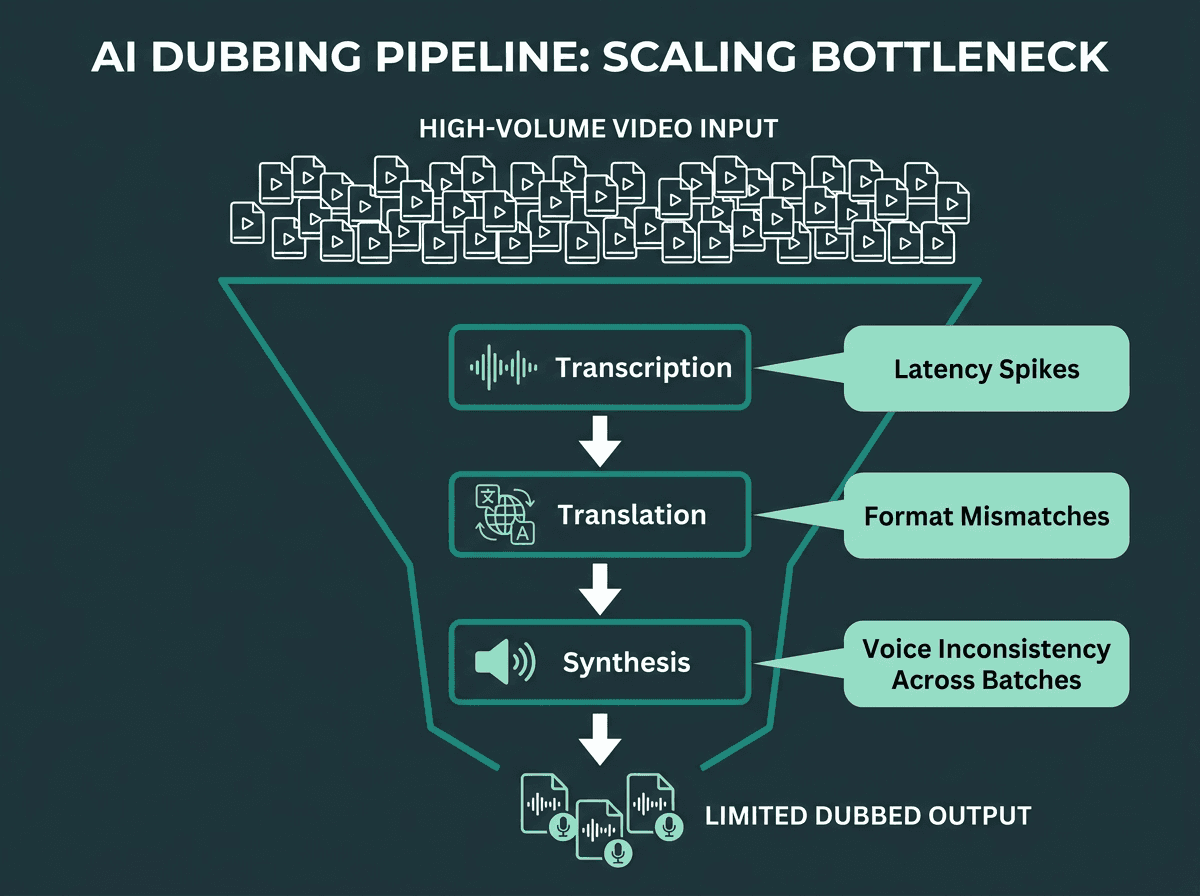
एक डबिंग पाइपलाइन को स्केल करने से वे बाधाएं सामने आती हैं जो कम मात्रा में अदृश्य होती हैं।
मांग, तकनीक की परिपक्वता और प्लेटफॉर्म सपोर्ट का संगम एआई डबिंग को वीडियो वर्कफ्लो के लिए डिफॉल्ट टूलकिट में धकेल रहा है। एक बार जब आप वॉल्यूम बढ़ाते हैं, तो दो समस्याएं तेजी से सामने आती हैं। पहली है आवाज की निरंतरता: यदि आप कई हफ्तों में 20-एपिसोड की सीरीज़ को डब कर रहे हैं, तो बार-बार आने वाले वक्ताओं की आवाज़ हर एपिसोड में एक जैसी होनी चाहिए। कई टीटीएस एपीआई सेशंस के दौरान इसकी गारंटी नहीं देंगे जब तक कि आप वॉयस आईडी को स्पष्ट रूप से प्रबंधित न करें। दूसरी समस्या लेटेंसी (कम देरी) की है: 10 मिनट के वीडियो को 8 मिनट में प्रोसेस करना बैच के लिए तो ठीक है, लेकिन लाइव इवेंट डबिंग जैसे रीयल-टाइम के करीब वाले उपयोग के मामलों के लिए यह बिल्कुल भी सही नहीं है।
स्केल आपको भाषा-विशिष्ट विशेष मामलों (एज केसेस) का सामना करने के लिए भी मजबूर करता है जो छोटे परीक्षणों में छूट सकते हैं। टेक्स्ट नॉर्मलाइजेशन अलग-अलग भाषाओं में भिन्न होता है। विभिन्न स्थानों पर संख्याएं, तारीखें और संक्षिप्ताक्षर (एब्रीविएशन) अलग-अलग तरीके से बोले जाते हैं, और जो सिस्टम अंग्रेजी को सही ढंग से सामान्य (नॉर्मलाइज़) करता है, वह अक्सर जापानी या अरबी में समान पैटर्न को गलत पढ़ेगा जब तक कि आप स्पष्ट नियम नहीं जोड़ते। यह टीटीएस का बग नहीं है; यह एक इंटीग्रेशन की जिम्मेदारी है जो पाइपलाइन के मालिक की होती है।
विभिन्न उपयोग के मामलों के लिए व्यावहारिक शुरुआती बिंदु
विभिन्न प्रकार के कंटेंट पाइपलाइन के विभिन्न हिस्सों पर दबाव डालते हैं। आप क्या डब कर रहे हैं, इसके आधार पर इंजीनियरिंग प्रयास आमतौर पर कहाँ सबसे अधिक मायने रखते हैं, यहाँ दिया गया है:
ई-लर्निंग और कॉर्पोरेट ट्रेनिंग: टाइमिंग का लचीलापन आमतौर पर अधिक होता है क्योंकि वक्ता शायद ही कभी कैमरे पर होता है। अपना प्रयास ट्रांसक्रिप्शन की सटीकता और अनुवाद की गुणवत्ता पर लगाएं। वॉयस क्लोनिंग अच्छी है, लेकिन अनिवार्य नहीं है। प्रति भाषा एक मजबूत टीटीएस आवाज अक्सर पर्याप्त होती है।
यूट्यूब और सोशल वीडियो: टाइमिंग अधिक मायने रखती है क्योंकि संपादन, कट्स और बी-रोल अक्सर मूल ऑडियो के साथ चलते हैं। अलाइनमेंट लेयर पर वास्तविक काम करें। शॉर्ट-फॉर्म के लिए, हर सेकंड को पूरी तरह से डब करने के बजाय केवल वहीं वीडियो में वॉयस ओवर जोड़ना अधिक सरल हो सकता है जहां इसकी आवश्यकता है।
स्क्रिप्टेड ड्रामा और डॉक्यूमेंट्री: विजुअल डबिंग की अक्सर आवश्यकता होती है। सोर्स ऑडियो से वॉयस क्लोनिंग प्रामाणिकता में मदद करती है। पूरी पाइपलाइन में मानवीय समीक्षा की योजना बनाएं।
पॉडकास्ट-टू-वीडियो कनवर्टर: ट्रांसक्रिप्शन सटीकता इसका आधार है, क्योंकि दर्शकों के पास गलत सुनने की भरपाई करने के लिए कोई विजुअल संदर्भ नहीं होता है। स्थानीय टेक्स्ट-टू-स्पीच एआई आवाजें बनाना जो होस्ट के लहजे से मेल खाती हों, लक्षित भाषा में दर्शकों को बनाए रखने में सुधार कर सकती हैं।
आपकी डबिंग एआई पाइपलाइन के लिए अगले कदम
एक डबिंग पाइपलाइन आमतौर पर अपने सबसे कम ध्यान दिए गए चरण में विफल होती है। व्यवहार में, ट्रांसक्रिप्शन डाउनस्ट्रीम की हर चीज़ के लिए गुणवत्ता की सीमा तय करता है। अनुवाद को बोले जाने वाले संवादों के लिए ट्यून किया जाना चाहिए, न कि लिखित गद्य के लिए। टीटीएस को संरेखण (अलाइनमेंट) और टाइमिंग को हल करना होगा, न कि केवल समझने योग्य ऑडियो उत्पन्न करना। और क्यूसी को वर्कफ्लो में शुरुआत में ही डिज़ाइन किया जाना चाहिए, क्योंकि लॉन्च के बाद इसे फिर से फिट करना आमतौर पर शेड्यूल और बजट को बिगाड़ देता है।
भरोसेमंद टीमें प्रत्येक चरण को अपने स्वयं के इंजीनियरिंग क्षेत्र के रूप में मानती हैं, जिसके अपने फेलियर मोड होते हैं, न कि ब्लैक बॉक्स के एक सेट के रूप में जिसे गुणवत्ता गिरने पर वे बदल सकें। वे पाइपलाइन को शुरू से अंत तक सुसज्जित करते हैं, प्रत्येक चेकपॉइंट पर नमूनों की समीक्षा करते हैं, और उन विशेष मामलों के लिए डिज़ाइन करते हैं जो केवल तब दिखाई देते हैं जब आप वास्तविक वॉल्यूम चला रहे होते हैं।
यदि आप एक डबिंग पाइपलाइन बना रहे हैं और आपको एक ऐसी टीटीएस लेयर की आवश्यकता है जो प्रोडक्शन स्केल पर टाइमिंग की बाधाओं, वॉयस क्लोनिंग और लो-लेटेंसी सिंथेसिस को संभाल सके, तो Smallest.ai की Lightning API इसी के लिए डिज़ाइन की गई है। लाइटनिंग को लो-लेटेंसी टीटीएस, वॉयस क्लोनिंग और प्राकृतिक लहजे के लिए बनाया गया है, जो इसे उन प्रोडक्शन डबिंग वर्कफ़्लो के लिए बेहद अनुकूल बनाता है जहाँ समय और आवाज़ की गुणवत्ता मायने रखती है। ट्रांसक्रिप्शन के लिए इसे पल्स (Pulse) के साथ जोड़ने के लिए हमारी कीमतें देखें और तीन अलग-अलग वेंडर्स के साथ तालमेल बिठाए बिना प्रोडक्शन के लिए तैयार पाइपलाइन के मुख्य चरणों को कवर करें।
अक्सर पूछे जाने वाले प्रश्न
डबिंग एआई पाइपलाइन क्या है, और यह सबटाइटलिंग से कैसे अलग है?
उपयोगी डबिंग आउटपुट के लिए ट्रांसक्रिप्शन कितना सटीक होना चाहिए?
क्या एआई डबिंग लक्षित भाषा में मूल वक्ता की आवाज़ को बनाए रख सकती है?
एआई डबिंग पाइपलाइन किन भाषाओं का समर्थन करती है, और क्या भाषा के आधार पर गुणवत्ता में भिन्नता होती है?
स्टूडियो डबिंग की तुलना में एआई (AI) डबिंग में कितना समय लगता है?