टीटीएस (TTS) और एसटीटी (STT) के साथ वॉयस बॉट कैसे बनाएं

STT और TTS APIs के साथ एक वॉयस बॉट बनाएं: रियल-टाइम आर्किटेक्चर, स्ट्रीमिंग पायथन लूप, लेटेंसी बजट टिप्स, और सामान्य गलतियां जो प्रोडक्शन को बाधित करती हैं।
वॉयस बॉट ग्राहक सहायता, शेड्यूलिंग और आंतरिक वर्कफ़्लो के लिए एक सामान्य इंटरफ़ेस बनते जा रहे हैं। अब असली सवाल यह है कि एक ऐसा वॉयस बॉट कैसे बनाया जाए जो धीमे और कृत्रिम के बजाय त्वरित महसूस हो।
यह वॉकथ्रू शुरू से अंत तक चलता है: वे आर्किटेक्चर विकल्प जो मायने रखते हैं, स्पीच-टू-टेक्स्ट (STT) और टेक्स्ट-टू-स्पीच (TTS) एपीआई के साथ व्यावहारिक एकीकरण, और विफलता के वे मोड जो अक्सर पहली बार निर्माण करने वालों को हैरान कर देते हैं। मैं यह मानकर चल रहा हूँ कि आप एपीआई और बेसिक पायथन के साथ काम करने में सहज हैं, लेकिन आपको अभी तक रीयल-टाइम ऑडियो स्ट्रीम से नहीं जूझना पड़ा है।
वॉयस बॉट वास्तव में पर्दे के पीछे क्या करता है
ब्रांडिंग को अनदेखा करें और यांत्रिकी हमेशा एक जैसी होती है: सुनें (STT), सोचें (LLM या एक लॉजिक लेयर), बोलें (TTS)। ऑडियो आता है, टेक्स्ट एक रीजनिंग लेयर तक पहुँचता है, और उत्तर सिंथेसाइज़्ड स्पीच के रूप में वापस आता है। यह लूप वैचारिक रूप से सरल है, लेकिन यह तेजी से कठिन हो जाता है क्योंकि हर सीमा पर विलंबता (लेटेंसी) बढ़ती जाती है।
वॉयस इंटरैक्शन टेक्स्ट इंटरफेस की तुलना में देरी को बहुत कम सहन करते हैं। पाइपलाइन का प्रत्येक चरण (भाषण पहचान, तर्क, भाषण संश्लेषण, और नेटवर्क ट्रांजिट) विलंबता जोड़ता है जिसे उपयोगकर्ता वास्तविक समय की बातचीत में देख सकते हैं।
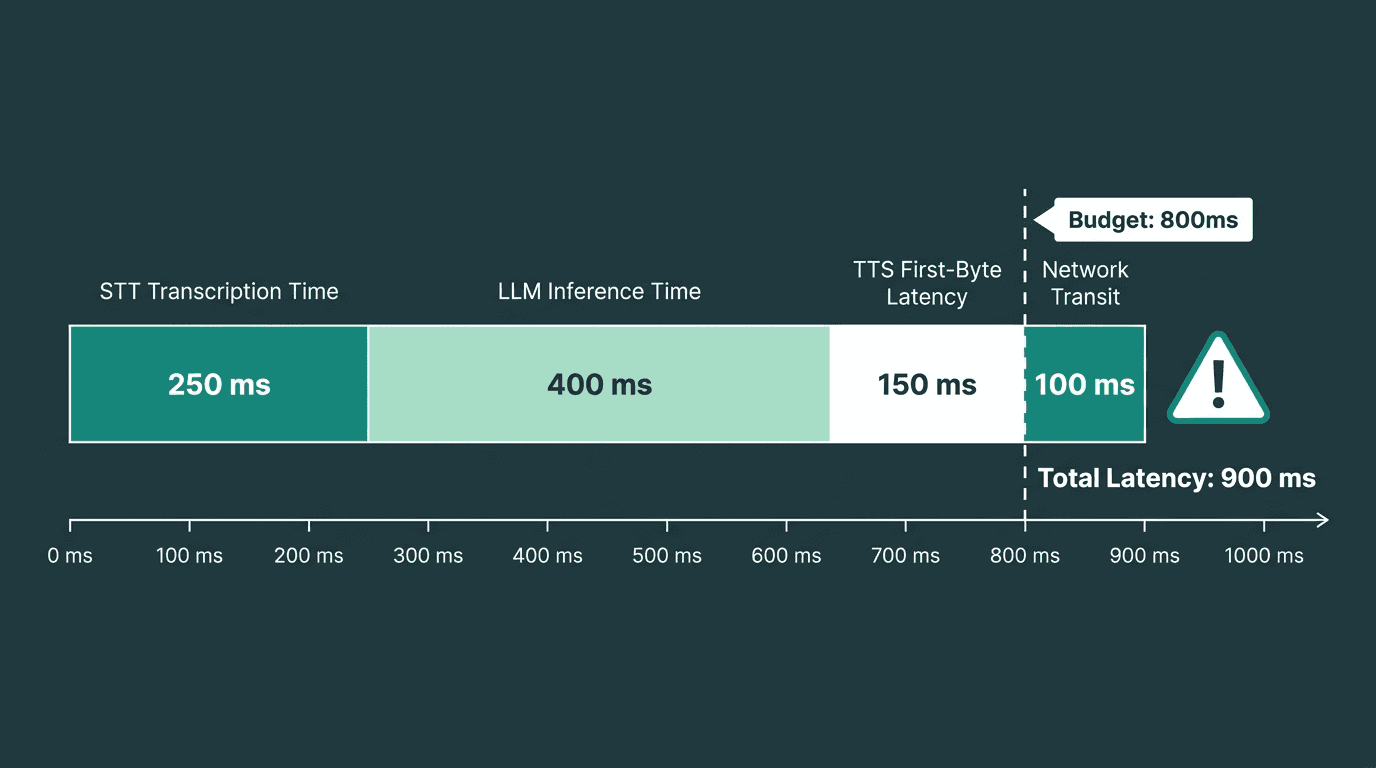
सुनने-सोचने-बोलने के लूप का प्रत्येक चरण आपके 800 मिलीसेकंड के संवादात्मक बजट के खिलाफ विलंबता को बढ़ाता है।
कोड की एक पंक्ति लिखने से पहले अपना स्टैक चुनना
इससे पहले कि आप कोड को छुएं, तीन विकल्प आपके अधिकांश परिणाम को तय कर देते हैं: आने वाले ऑडियो को लेने वाला STT इंजन, वापस बोलने वाला TTS इंजन, और बीच का "दिमाग" जो यह तय करता है कि क्या कहना है। STT और TTS को एक ही इकोसिस्टम में रखना केवल सुविधा की बात नहीं है। इसका मतलब आमतौर पर कम प्रमाणीकरण (auth) और बिलिंग की सिरदर्दी, कम संस्करण-बेमेल की समस्याएं, और ऐसे हैंडऑफ़ हैं जो एक साथ काम करने के लिए ट्यून किए गए हैं, जो अक्सर कम एंड-टू-एंड विलंबता के रूप में दिखाई देते हैं।
STT इंजन चुनना
वॉयस बॉट्स के लिए, चेकलिस्ट ऑफ़लाइन ट्रांसक्रिप्शन की तुलना में भिन्न होती है। आपको सच्चे स्ट्रीमिंग (न कि "फ़ाइल अपलोड करें और प्रतीक्षा करें"), बार्ज-इन का समर्थन करने के लिए शब्द-स्तरीय टाइमस्टैम्प, आपके उपयोगकर्ताओं से मेल खाने वाले भाषा कवरेज, और एक रीयल-टाइम फैक्टर (RTF) की आवश्यकता होती है जो 1.0 से नीचे रहे। RTF वह सीधा मीट्रिक है जो आपको बताता है कि पहचानकर्ता लाइव स्पीच के साथ तालमेल रख सकता है या नहीं; एक बार जब यह 1.0 से ऊपर चला जाता है, तो बैकलॉग बढ़ जाता है और बातचीत खिंचने लगती है। Smallest.ai का Pulse संवादात्मक वर्कलोड के लिए डिज़ाइन किया गया है, जो प्रोडक्शन वॉयस अनुप्रयोगों के लिए स्पीकर और भावना का पता लगाने जैसी सुविधाओं के साथ-साथ कम-विलंबता वाली स्ट्रीमिंग ट्रांसक्रिप्शन प्रदान करता है।
TTS इंजन चुनना
TTS गुणवत्ता मायने रखती है, लेकिन वॉयस बॉट में, पहले-बाइट की विलंबता ही सबसे महत्वपूर्ण संख्या है। यदि बॉट पहले शब्दांश से पहले दो सेकंड के लिए चुप रहता है, तो यह टूटा हुआ महसूस होता है, चाहे आवाज शुरू होने के बाद कितनी भी जीवंत क्यों न हो। स्ट्रीमिंग आउटपुट (सिंथेसिस पूरा होने से पहले ऑडियो के टुकड़े), सुसंगत व्यक्तित्व के लिए वॉयस क्लोनिंग, और जब आपको जोर देने और गति देने की आवश्यकता हो तो SSML या प्रोसोडी नियंत्रणों की तलाश करें। Smallest.ai का Lightning API इसी वास्तविकता के इर्द-गिर्द बनाया गया है: sub-100 ms प्रथम-बाइट विलंबता, स्ट्रीमिंग आउटपुट और वॉयस क्लोनिंग। Lightning और संबंधित भाषण सेवाओं तक पहुंच Waves API के माध्यम से चलती है, जो आपको STT और TTS दोनों कॉल के लिए एक एकल समापन बिंदु (endpoint) देती है।
दिमाग चुनना: LLM, नियम, या दोनों
हर वॉयस बॉट के लिए एक पूर्ण लार्ज लैंग्वेज मॉडल अनिवार्य नहीं है। यदि आप एक IVR को बदल रहे हैं जो कॉल करने वालों को विभागों में रूट करता है, तो एक नियतात्मक नियम (deterministic rules) इंजन आमतौर पर बेहतर फिट बैठता है: तेज़, सस्ता और ऑडिट करने में आसान। यदि आप एक द्वारपाल (concierge) जैसी शैली का बॉट बना रहे हैं जिसे उलझे हुए, अप्रत्याशित प्रश्नों को संभालना है, तो आप एक LLM चाहेंगे। Smallest.ai का Electron एक कॉम्पैक्ट भाषा मॉडल है जिसे रीयल-टाइम संवादात्मक अनुप्रयोगों के लिए डिज़ाइन किया गया है। इसका उपयोग उन वॉयस एजेंटों के लिए रीजनिंग लेयर के रूप में किया जा सकता है जहां कम विलंबता प्राथमिकता है, जबकि टीमें अपनी आवश्यकता के अनुसार किसी अन्य संगत भाषा मॉडल को भी एकीकृत कर सकती हैं। यदि आप ऑर्केस्ट्रेशन लेयर खुद नहीं बनाना चाहते हैं, तो Atoms एक प्रबंधित एजेंट प्लेटफॉर्म है जो वायरिंग का ख्याल रखता है।
आर्किटेक्चर ब्लूप्रिंट: एक ऐसा वॉयस बॉट कैसे बनाएं जो रीयल-टाइम महसूस हो
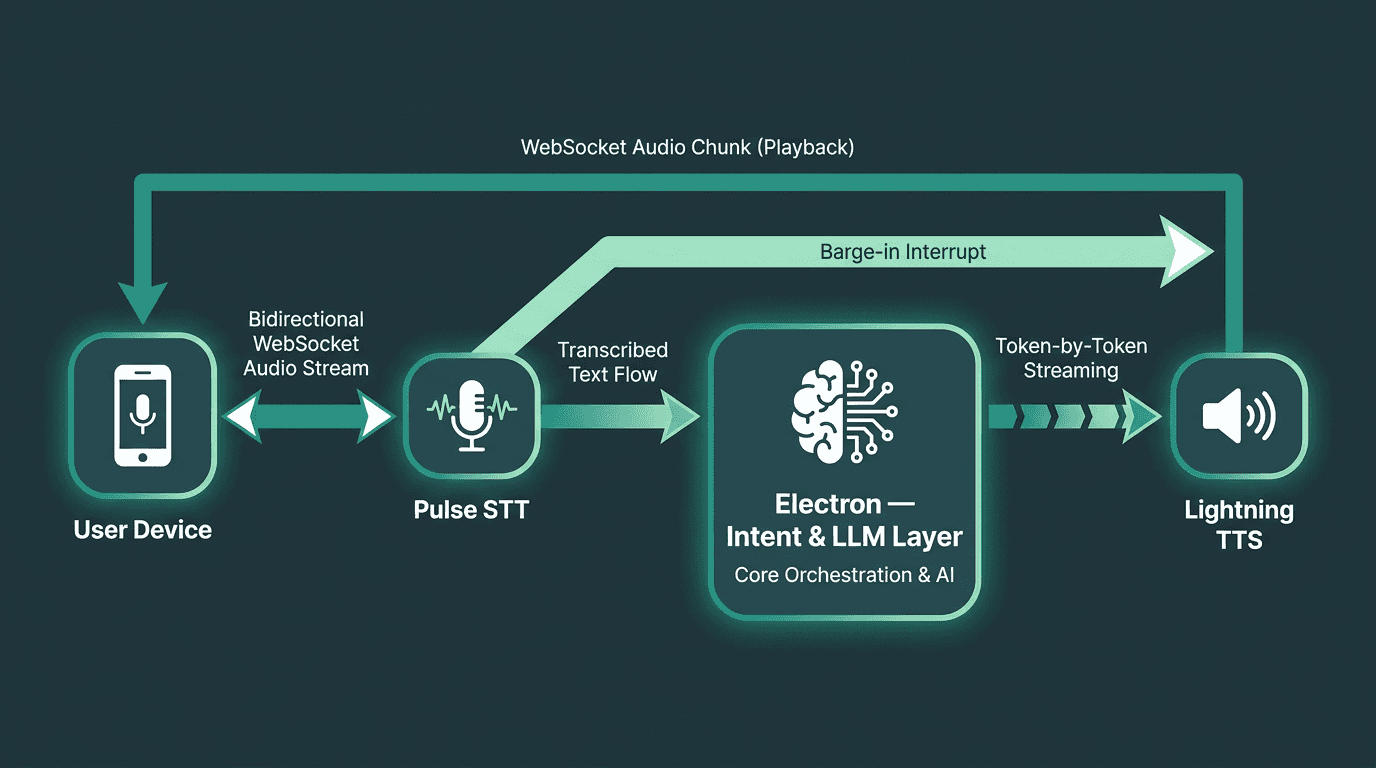
फुल-डुप्लेक्स वेबसॉकेट आर्किटेक्चर: एक ऐसे वॉयस बॉट की नींव जो वास्तव में रीयल-टाइम महसूस होता है।
संदर्भ आर्किटेक्चर कागज पर साफ दिखता है: क्लाइंट से एक वेबसॉकेट ऑडियो स्ट्रीम STT (Pulse) तक पहुँचती है, ट्रांसक्रिप्ट एक इंटेंट लेयर या LLM (Electron या आपकी पसंद का मॉडल) में प्रवाहित होती है, और प्रतिक्रिया TTS (Lightning) में स्ट्रीम होती है, जो क्लाइंट को ऑडियो चंक्स वापस भेजती है। वहां जो शब्द मायने रखता है वह है "स्ट्रीम"। हाफ-डुप्लेक्स अनुरोध/प्रतिक्रिया, जहां आप एक पूर्ण ऑडियो क्लिप अपलोड करते हैं और कुछ भी करने से पहले एक पूर्ण ट्रांसक्रिप्ट की प्रतीक्षा करते हैं, डेमो के लिए ठीक है। उत्पादों को वेबसॉकेट्स या gRPC पर फुल-डुप्लेक्स स्ट्रीमिंग की आवश्यकता होती है ताकि पहला ऑडियो फ्रेम आते ही काम शुरू हो जाए।
बार्ज-इन वह जगह है जहां बहुत सारे वॉयस बॉट खुद को उजागर कर देते हैं। जब उपयोगकर्ता बॉट के बोलते समय बात करना शुरू करता है, तो सिस्टम को आवाज की गतिविधि का पता लगाना होता है, इन-फ़्लाइट TTS स्ट्रीम को रद्द करना होता है, और वापस सुनने मोड में आना होता है। इसका मतलब है कि प्लेबैक के दौरान भी पृष्ठभूमि में STT चलता रहता है, और आपके ऑर्केस्ट्रेटर को एक साफ कैंसिलेशन पाथ की आवश्यकता होती है। बार्ज-इन को छोड़ दें और बॉट लोगों के ऊपर बात करेगा, जो कि "यह नकली लगता है" की ओर ले जाने वाला सबसे तेज़ रास्ता है।
कोर लूप का निर्माण: एक व्यावहारिक वॉकथ्रू
नीचे दिया गया उदाहरण एक एसिंक इवेंट लूप के साथ पायथन का उपयोग करता है, क्योंकि वह मॉडल इस बात से मेल खाता है कि रीयल-टाइम वॉयस सिस्टम कैसे व्यवहार करते हैं: एक साथ लगातार कुछ चीजें हो रही हैं। ऑडियो कैप्चर STT को फीड करता है, ट्रांसक्रिप्ट LLM को फीड करते हैं, और LLM आउटपुट TTS को फीड करता है, बिना प्रत्येक चरण को पिछले चरण के पूरा होने का इंतजार करने के लिए मजबूर किए।
ऑडियो को कैप्चर करना और STT पर स्ट्रीम करना
Pulse के लिए एक वेबसॉकेट कनेक्शन खोलकर शुरू करें और रिकॉर्ड करते समय माइक्रोफ़ोन चंक्स को पुश करें। दो सेटिंग्स यहाँ अधिकांश विलंबता का काम करती हैं: चंक साइज (16 ms से 32 ms फ्रेम प्रतिक्रियाशीलता और पैकेट ओवरहेड के बीच सामान्य समझौता हैं) और नमूना दर (16 kHz भाषण पहचान के लिए सामान्य आधारभूत रेखा है)। ऑडियो आने पर Pulse आंशिक ट्रांसक्रिप्ट स्ट्रीम करेगा, जो आपको जल्दी ही इंटेंट का पता लगाना शुरू करने की अनुमति देता है, फिर उच्चारण के अंत का पता चलने पर एक अंतिम ट्रांसक्रिप्ट उत्सर्जित करता है।
वॉयस एक्टिविटी डिटेक्शन (VAD) और एंडपॉइंटिंग से बॉट यह तय करता है कि उपयोगकर्ता की बात पूरी हो गई है। उनके बिना, या तो आप लोगों की बात को बीच में ही काट देते हैं या आप एक ऐसे टाइमआउट पर बैठ जाते हैं जो बॉट को धीमा महसूस कराता है। कई STT इंजन एंडपॉइंटिंग को आंतरिक रूप से संभालते हैं, लेकिन फिर भी आपको पर्यावरण के अनुसार साइलेंस थ्रेसहोल्ड को ट्यून करने की आवश्यकता होती है: एक कॉल सेंटर बॉट एक वॉयस असिस्टेंट की तुलना में अधिक चुस्त टर्न-टेकिंग की उम्मीद करता है जहां उपयोगकर्ता सोचने के लिए रुकते हैं।
ट्रांसक्रिप्ट को प्रोसेस करना और रिस्पॉन्स जेनरेट करना
जब अंतिम रूप दिया गया ट्रांसक्रिप्ट प्राप्त हो, तो इसे अपने LLM या Electron पर भेजें और उत्तर बनाना शुरू करें। विलंबता की वह तरकीब जिसे अधिकांश पहली बार लागू करने वाले छोड़ देते हैं, सरल है: TTS कॉल करने से पहले मॉडल द्वारा पूरी प्रतिक्रिया समाप्त करने की प्रतीक्षा न करें। जैसे ही टोकन आते हैं, उन्हें TTS अनुरोध में स्ट्रीम करें ताकि पहला वाक्य सिंथेसाइज़ हो सके जब मॉडल अभी दूसरा वाक्य बना रहा हो। व्यवहार में, टोकन के उत्पन्न होते ही उन्हें स्ट्रीम करने से भाषण संश्लेषण शुरू करने से पहले पूरी प्रतिक्रिया की प्रतीक्षा करने की तुलना में कथित विलंबता काफी कम हो सकती है।
प्रतिक्रिया को भाषण के रूप में वापस स्ट्रीम करना
Lightning के स्ट्रीमिंग TTS एंडपॉइंट में टेक्स्ट चंक्स डालें और लौटे ऑडियो बाइट्स को सीधे अपने आउटपुट पाथ पर रूट करें, चाहे वह ब्राउज़र ऑडियो संदर्भ हो, WebRTC ट्रैक हो, या टेलीफोनी SIP ट्रंक हो। वास्तविक समय के वितरण के लिए, Opus आमतौर पर सही डिफॉल्ट होता है: यह कम-विलंबता स्ट्रीमिंग के लिए बनाया गया है, पैकेट के नुकसान को सहन करता है, और 16 kbps से 32 kbps पर अच्छा लगता है। PCM स्थानीय परीक्षण और डाउनस्ट्रीम प्रोसेसिंग के लिए आसान है; MP3 एनकोडर विलंबता जोड़ता है जो लाइव बातचीत में जमा हो जाती है। यदि आप इस स्टैक पर अधिक कार्यान्वयन विवरण चाहते हैं, तो कुशल एआई वॉयस बॉट बनाने पर Smallest.ai की पोस्ट इन हिस्सों के बारे में बताती है।
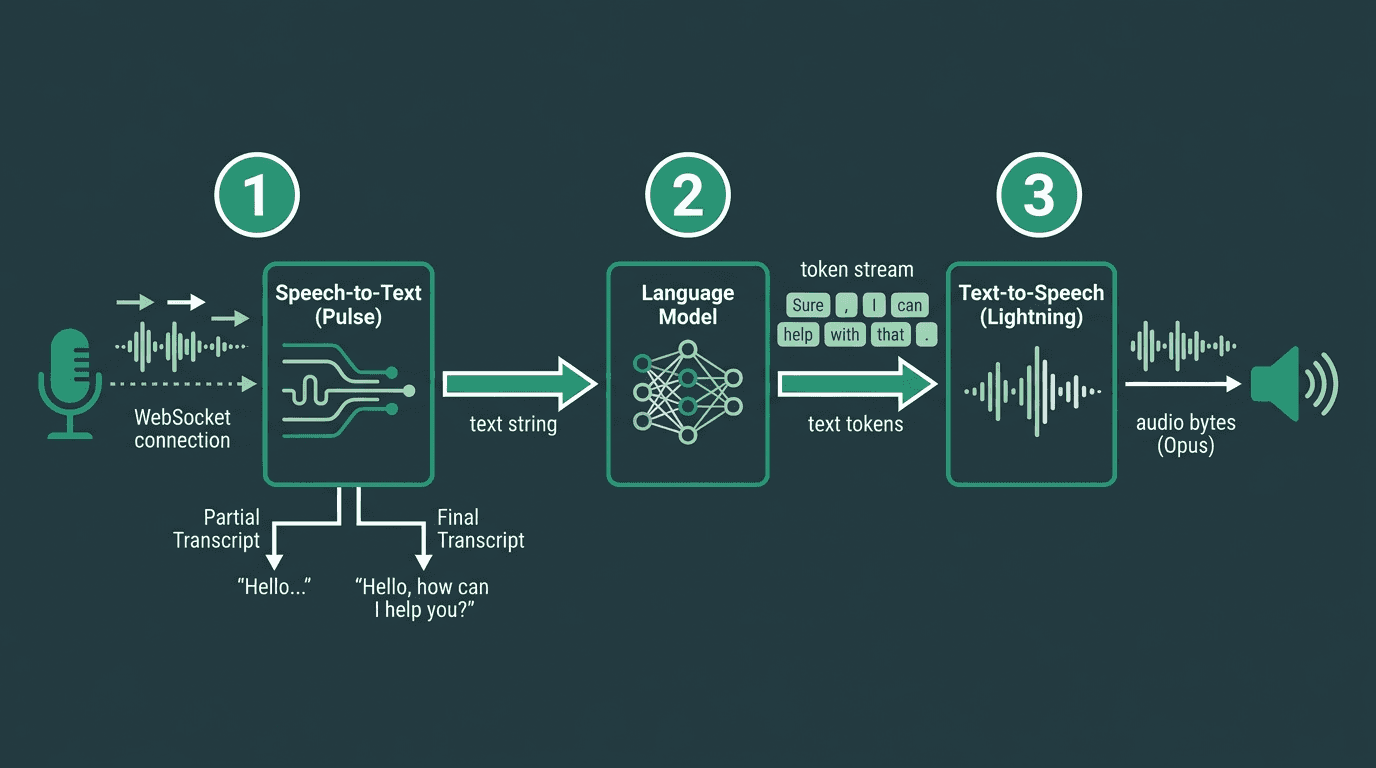
तीनों चरणों में टोकन-स्तरीय स्ट्रीमिंग बैचिंग की तुलना में कथित विलंबता को 40-60% तक कम कर देती है।
वे गलतियाँ जो चुपचाप वॉयस बॉट प्रोजेक्ट्स को खत्म कर देती हैं
ये चार गलतियाँ लगातार असफल वॉयस बॉट परिनियोजन के विश्लेषण में सामने आती हैं:
एक चैटबॉट का निर्माण करना जिसमें माइक्रोफ़ोन लगा हो। मौन सीमाएँ (silence thresholds), प्रतिध्वनि रद्दीकरण (echo cancellation), और परिवेशी शोर से निपटना वैकल्पिक "अच्छी चीजें" नहीं हैं। यदि बॉट एक प्राकृतिक ठहराव और मोड़ के अंत के बीच अंतर नहीं बता सकता है, या यदि वह अपने स्वयं के TTS आउटपुट को उपयोगकर्ता इनपुट के रूप में सुनता है, तो यह एक शांत डेमो रूम के बाहर बिखर जाएगा।
स्ट्रीमिंग के बजाय बैचिंग करना। यदि आप LLM को कॉल करने से पहले एक पूर्ण STT ट्रांसक्रिप्ट की प्रतीक्षा करते हैं, फिर TTS को कॉल करने से पहले पूर्ण LLM प्रतिक्रिया की प्रतीक्षा करते हैं, तो आपने तीन चरणों को एक क्रमिक पाइपलाइन में बदल दिया है। इसी तरह आपकी प्रतिक्रिया का समय 3 से 5 सेकंड का हो जाता है जिससे ऐसा महसूस होता है कि सिस्टम फ्रीज हो गया है। STT स्ट्रीम करें, मॉडल स्ट्रीम करें, TTS स्ट्रीम करें।
वास्तविक ऑडियो समवर्तीता (concurrency) का लोड परीक्षण किए बिना लॉन्च करना। एक साथ 50 कॉल्स संभालने वाला बॉट 50 रीयल-टाइम ऑडियो स्ट्रीम चला रहा होता है, जिनमें से प्रत्येक का अपना वेबसॉकेट, VAD स्थिति और LLM संदर्भ होता है। यह 50 समवर्ती टेक्स्ट एपीआई कॉल की तुलना में एक अलग समस्या है। शिप करने से पहले यथार्थवादी समवर्तीता पर परीक्षण करें।
हर परिदृश्य के लिए एक आवाज को हार्डकोड करना। लोग टोन और संदर्भ के आधार पर अलग-अलग प्रतिक्रिया देते हैं। एक ऋण वसूली बॉट और एक स्वास्थ्य सेवा शेड्यूलिंग बॉट एक ही एजेंट की तरह नहीं लगने चाहिए। Smallest.ai के माध्यम से वॉयस क्लोनिंग आपको एक पूर्ण वॉयस एक्टर डेटासेट रिकॉर्ड किए बिना ब्रांडेड या भूमिका-विशिष्ट आवाज़ें बनाने की अनुमति देती है।
MVP से परे जाना: वे विशेषताएं जो डेमो को उत्पादों से अलग करती हैं
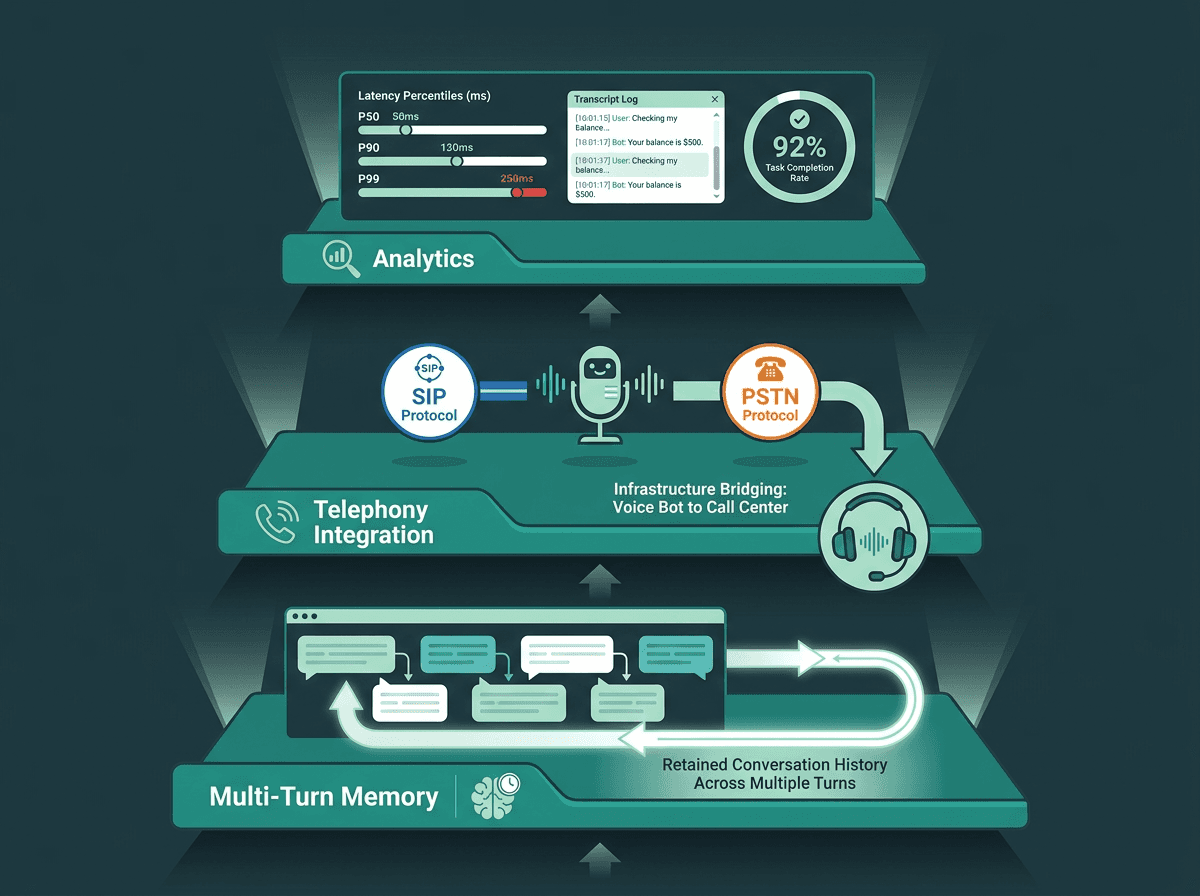
तीन क्षमता परतें जो एक कार्यशील वॉयस बॉट डेमो को प्रोडक्शन-रेडी उत्पाद से अलग करती हैं।
मल्टी-टर्न मेमोरी पहली गायब विशेषता है जिससे उपयोगकर्ता परेशान होते हैं। जब बॉट यह भूल जाता है कि 30 सेकंड पहले क्या कहा गया था, तो लोगों को खुद को दोहराना पड़ता है, और विश्वास एक छोटे से विलंबता स्पाइक की तुलना में अधिक तेजी से गायब हो जाता है। प्रत्येक LLM कॉल में पिछले N टर्न को शामिल करें, और लंबे सत्रों के लिए सारांश का उपयोग करें ताकि टोकन काउंट अत्यधिक न बढ़े।
यदि आप कॉल सेंटर में परिनियोजन कर रहे हैं, तो SIP/PSTN एकीकरण वैकल्पिक नहीं है। यही वह जगह भी है जहां काम कठिन हो जाता है: DTMF, स्थानान्तरण, होल्ड म्यूजिक, और अनुपालन रिकॉर्डिंग सभी एक साथ दिखाई देते हैं। Smallest.ai का Atoms प्लेटफॉर्म इसमें से बहुत कुछ को संक्षिप्त कर देता है, जिससे टेलीफोनी बुनियादी ढांचे को नए सिरे से बनाए बिना वॉयस एजेंट को तैनात करना यथार्थवादी हो जाता है।
एनालिटिक्स ही हैं जो "यह काम करता है" को "यह मज़बूती से काम करता है" में बदलते हैं। प्रत्येक ट्रांसक्रिप्ट को लॉग करें, P50, P90 और P99 पर विलंबता को मापें (औसत उन स्पाइक्स को छुपाता है जो उपयोगकर्ताओं को याद रहते हैं), और कार्य-पूर्णता दर को मार्गदर्शक मीट्रिक के रूप में मानें। 200 ms औसत विलंबता लेकिन 40 प्रतिशत पूर्णता दर वाला बॉट सफल नहीं है। विलंबता आपको बताती है कि सिस्टम कैसा प्रदर्शन करता है; पूर्णता आपको बताती है कि क्या यह उपयोग करने योग्य है।
पांच अलग-अलग विक्रेताओं को एक साथ जोड़े बिना वॉयस बॉट्स बनाएं
वास्तविक समय के वॉयस एप्लिकेशन केवल भाषण पहचान या भाषण संश्लेषण पर निर्भर नहीं करते हैं। कम विलंबता, स्ट्रीमिंग इंफ्रास्ट्रक्चर, ऑर्केस्ट्रेशन और बातचीत प्रबंधन सभी को एक साथ काम करने की आवश्यकता होती है। Smallest.ai STT, TTS, संवादात्मक मॉडल और वॉयस-एजेंट टूलिंग को एक एकल प्लेटफॉर्म में लाता है, जिससे टीमों को प्रोटोटाइप से प्रोडक्शन तक तेज़ी से बढ़ने में मदद मिलती है।
Smallest.ai को एकीकरण ओवरहेड को कम करने के लिए एक एकीकृत वॉयस एआई प्लेटफॉर्म के रूप में डिज़ाइन किया गया है। Pulse स्पीच-टू-टेक्स्ट प्रदान करता है, Lightning टेक्स्ट-टू-स्पीच को शक्ति देता है, Electron संवादात्मक तर्क को संभालता है, और Atoms एक सामान्य प्लेटफॉर्म के माध्यम से प्रोडक्शन वॉयस एजेंटों का समर्थन करता है। स्पीच-टू-स्पीच उपयोग के मामलों के लिए, Hydra एक मूल भाषण मॉडल प्रदान करता है जिसे रीयल-टाइम इंटरैक्शन के लिए डिज़ाइन किया गया है।
चाहे आप ग्राहक सहायता बॉट बना रहे हों, शेड्यूलिंग सहायक, या आंतरिक वॉयस वर्कफ़्लो, अगला कदम वास्तविक प्रोडक्शन ट्रैफ़िक के साथ अपने आर्किटेक्चर को सत्यापित करना है। यदि आप प्रोडक्शन परिनियोजन के लिए एक एकीकृत वॉयस एआई प्लेटफॉर्म का मूल्यांकन कर रहे हैं, तो यह देखने के लिए एक डेमो बुक करें कि Smallest.ai आपके वॉयस बॉट आर्किटेक्चर और परिनियोजन आवश्यकताओं के साथ कैसे फिट बैठता है। `
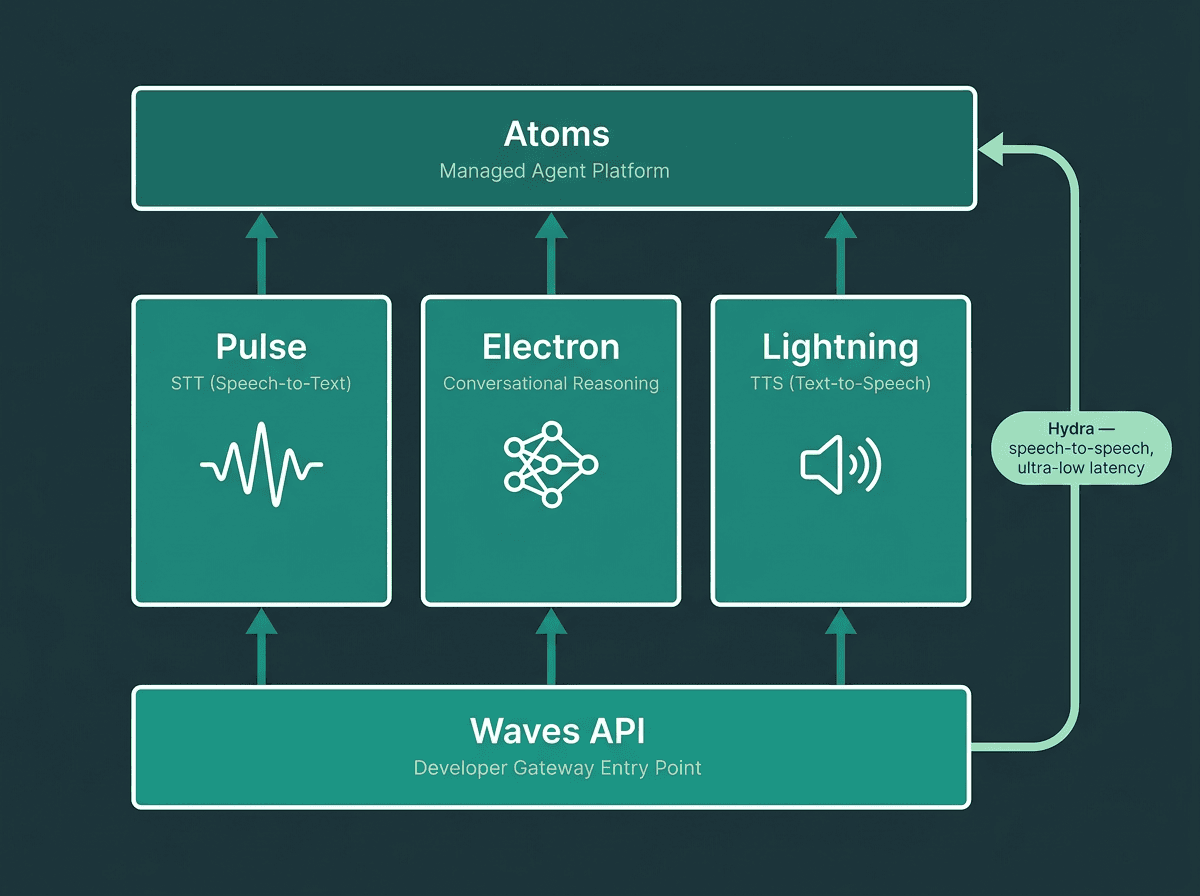
Smallest.ai का एकीकृत स्टैक एक एकल एपीआई गेटवे के माध्यम से हर वॉयस बॉट परत — STT, रीजनिंग, TTS, और ऑर्केस्ट्रेशन — को कवर करता है।
अक्सर पूछे जाने वाले प्रश्न
टीटीएस (TTS) और एसटीटी (STT) एपीआई के साथ एक बुनियादी वॉयस बॉट बनाने में कितना समय लगता है?
वॉयस बॉट बनाने के लिए कौन सी प्रोग्रामिंग भाषाएं सबसे अच्छी तरह काम करती हैं?
एक रियल-टाइम वॉयस बॉट में मैं लेटेंसी (देरी) को कैसे कम करूँ?
क्या मैं Smallest.ai का उपयोग करके अपने वॉयस बॉट के लिए एक कस्टम वॉइस क्लोन कर सकता हूँ?
एक वॉइस बॉट और एक वॉइस असिस्टेंट में क्या अंतर है?