Grok Voice 3.0: सुविधाएँ, कीमतें, बेंचमार्क और विकल्प

Grok Voice 3.0 के फीचर्स, API मूल्य निर्धारण, लेटेंसी और बेंचमार्क देखें। इसकी रियल-टाइम स्पीच क्षमताओं की तुलना Smallest.ai Hydra और अन्य विकल्पों से करें।
डिलीवरी का पता बदलने के लिए ग्राहक सहायता (customer support) पर कॉल करने की कल्पना करें।
आप समस्या समझाते हैं। AI सहायक जवाब देना शुरू करता है, लेकिन बीच में ही आपको अहसास होता है कि उसने पता गलत समझ लिया है। आप उसे सुधारने के लिए बीच में टोकते हैं।
एक अच्छे वॉइस असिस्टेंट को रुकना चाहिए, सुधार को सुनना चाहिए और स्वाभाविक रूप से बात आगे बढ़ानी चाहिए।
वहीं खराब तरीके से डिज़ाइन किया गया असिस्टेंट अपना मूल जवाब पूरा कर सकता है, आपके टोकने को नज़रअंदाज़ कर सकता है या आपसे सब कुछ दोहराने के लिए कह सकता है।
यह उन समस्याओं में से एक है जिन्हें हल करने के लिए Grok Voice 3.0 को डिज़ाइन किया गया है।
14 अक्टूबर, 2026 को जारी किया गया Grok Voice 3.0, xAI द्वारा विकसित एक रीयल-टाइम स्पीच-टू-स्पीच मॉडल है। Grok Voice Agent API के माध्यम से उपलब्ध, यह रीयल-टाइम वॉइस एप्लिकेशन के लिए बोले जाने वाले संवाद, संवादात्मक तर्क (conversational reasoning), रुकावट प्रबंधन (interruption handling) और टूल कॉलिंग को जोड़ता है।
यह मॉडल 86.9 के Artificial Analysis Speech-to-Speech Index स्कोर और $0.08 प्रति मिनट के प्रकाशित API मूल्य के साथ आता है।
लेकिन एक मजबूत बेंचमार्क स्कोर अपने आप किसी वॉइस मॉडल को हर एप्लिकेशन के लिए सही विकल्प नहीं बना देता।
डेवलपर्स को यह भी समझने की ज़रूरत है कि यह रुकावटों को कैसे संभालता है, यह कितनी जल्दी प्रतिक्रिया देता है, फ़ंक्शन कॉल के दौरान क्या होता है, और इसका आर्किटेक्चर उनके मौजूदा बुनियादी ढांचे में कैसे फिट बैठता है।
यह मार्गदर्शिका Grok Voice 3.0 की विशेषताओं, मूल्य निर्धारण, बेंचमार्क और सीमाओं के बारे में बताती है। यह मॉडल की तुलना Smallest.ai Hydra और अन्य रीयल-टाइम वॉइस AI विकल्पों से भी करती है।
Grok Voice 3.0 क्या है?
Grok Voice 3.0 एक स्पीच-टू-स्पीच AI मॉडल है जो रीयल-टाइम में बोले जाने वाले संवादों को संचालित करता है।
पारंपरिक वॉइस असिस्टेंट अक्सर तीन अलग-अलग घटकों को जोड़ते हैं, जैसा कि एक सामान्य STT, LLM, और TTS आर्किटेक्चर में दिखाया गया है:
1. स्पीच-टू-टेक्स्ट (STT): आने वाले ऑडियो को लिखित शब्दों में परिवर्तित करता है।
2. लैंग्वेज मॉडल: शब्दों की व्याख्या करता है और तय करता है कि क्या प्रतिक्रिया देनी है।
3. टेक्स्ट-टू-स्पीच (TTS): प्रतिक्रिया को बोले जाने वाले ऑडियो में परिवर्तित करता है।
यह तरीका काम तो करता है, लेकिन डेवलपर्स को कई प्रणालियों के बीच समन्वय स्थापित करना पड़ता है।
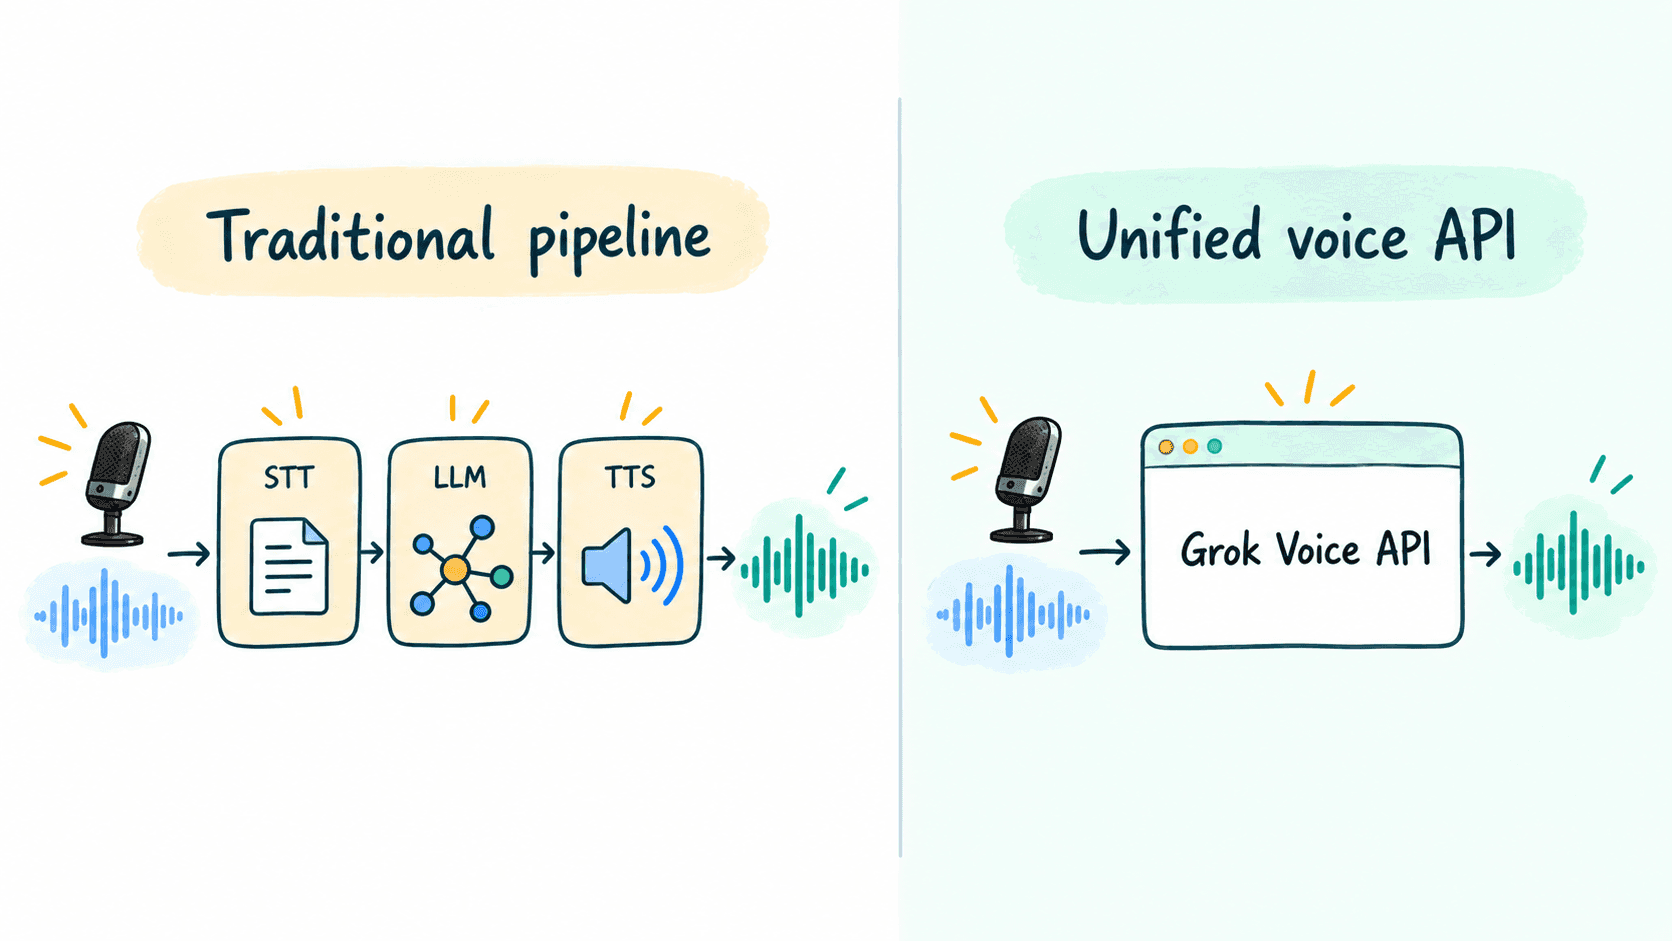
प्रत्येक घटक की अपनी प्रसंस्करण (processing), स्ट्रीमिंग और एरर-हैंडलिंग आवश्यकताएं होती हैं।
Grok Voice 3.0 xAI के Voice Agent API के माध्यम से एक स्पीच-टू-स्पीच इंटरफ़ेस प्रदान करता है। डेवलपर्स एक रीयल-टाइम सत्र में ऑडियो स्ट्रीम करते हैं और अलग से STT, LLM, और TTS पाइपलाइन को जोड़े बिना ही जनरेट की गई स्पीच प्राप्त करते हैं।
API टेक्स्ट इवेंट्स, कॉन्फ़िगर करने योग्य आवाज़ों, टर्न डिटेक्शन और बाहरी टूल्स का भी समर्थन करता है।
Grok Voice 2.0 की तुलना में क्या बदलाव आया है?
Grok Voice 3.0, Voice Agent API के माध्यम से उपलब्ध नवीनतम मॉडल के रूप में Grok Voice 2.0 की जगह लेता है।
महत्वपूर्ण बदलाव डेवलपर इंटरफ़ेस के बजाय मापे गए संवादात्मक प्रदर्शन में हैं।
मीट्रिक | Grok Voice 2.0 | Grok Voice 3.0 |
|---|---|---|
स्पीच-टू-स्पीच इंडेक्स | 81.3 | 86.9 |
स्पीच रीज़निंग | 97.2% | 98.5% |
फुल डुप्लेक्स बेंच | 95.1% | 97.0% |
टास्क सफलता दर | 94.6% | 94.8% |
पहले ऑडियो तक का समय (Time to first audio) | 0.70 सेकंड | 0.81 सेकंड |
ये परिणाम कई गुणवत्ता मापों में बेहतर प्रदर्शन दिखाते हैं, हालांकि पहले ऑडियो तक का समय पिछले संस्करण की तुलना में थोड़ा धीमा है।
grok-voice-latest का उपयोग करने वाले डेवलपर्स को अपने मौजूदा एकीकरण को बदले बिना स्वचालित रूप से Grok Voice 3.0 प्राप्त होता है। xAI ने grok-voice-2.0 को अप्रचलित (deprecated) भी कर दिया है, इसलिए उस संस्करण पर निर्भर एप्लिकेशन को grok-voice-3.0 या grok-voice-latest पर माइग्रेट करना चाहिए। API अपरिवर्तित रहता है, और दोनों संस्करणों की प्रकाशित दरें समान रहती हैं।
Grok Voice 3.0 रीयल-टाइम बातचीत को कैसे संभालता है?
मॉडल की क्षमताओं को समझने के लिए, विचार करें कि एक सामान्य टेलीफोन बातचीत के दौरान क्या होता है।
कोई भी व्यक्ति आगे क्या कहना है यह तय करने से पहले हर वाक्य के समाप्त होने का इंतजार नहीं करता है।
वे विराम (pauses) सुनते हैं, रुकावटों को पहचानते हैं, और कभी-कभी बोलते समय अपनी बात की दिशा बदल देते हैं।
वॉइस AI को भी इसी तरह के संवादात्मक व्यवहारों को प्रबंधित करने की आवश्यकता होती है।
1. फुल-डुप्लेक्स स्पीच-टू-स्पीच संवाद
फुल-डुप्लेक्स संचार बातचीत के दौरान ऑडियो को दोनों दिशाओं में स्थानांतरित करने की अनुमति देता है।
व्यावहारिक रूप से कहें तो, जब सहायक बोलकर प्रतिक्रिया दे रहा हो, तब भी उपयोगकर्ता बोल सकता है।
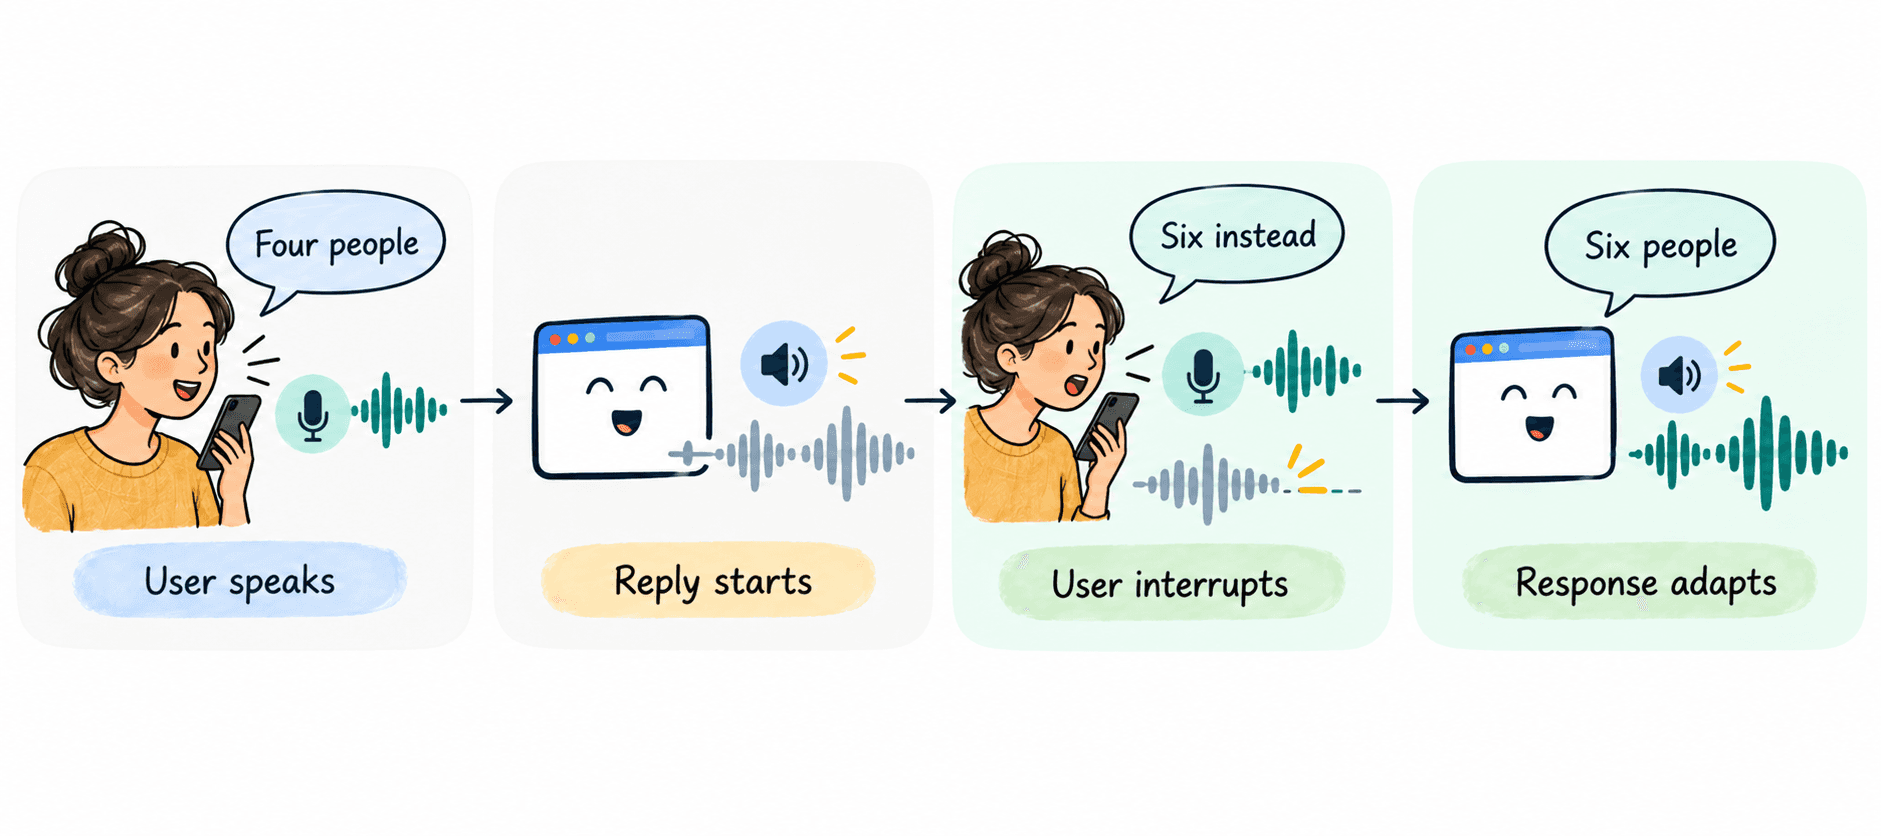
इस बातचीत पर विचार करें:
उपयोगकर्ता: "कल शाम के लिए चार लोगों की टेबल बुक करें।"
सहायक: "मैं आपके लिए चार लोगों की टेबल ढूंढने में मदद कर सकता हूँ..."
उपयोगकर्ता: "असल में, इसे छह लोग कर दीजिए।"
सहायक: "ज़रूर, मैं छह लोगों के लिए टेबल देखता हूँ।"
महत्वपूर्ण व्यवहार केवल दूसरे वाक्य को पहचानना नहीं है। सहायक को सक्रिय बातचीत को उसी अनुसार समायोजित भी करना चाहिए।
Grok Voice 3.0 अपने रीयल-टाइम API के माध्यम से रुकावट-जागरूक (interruption-aware) बातचीत का समर्थन करता है। विराम, बारी लेने (turn-taking) और रुकावटों पर इसके प्रदर्शन का मूल्यांकन Full Duplex Bench के माध्यम से किया जाता है।
2. कम-विलंबता वाली मौखिक प्रतिक्रियाएं (Low-latency spoken responses)
लेटेंसी (विलंबता) उपयोगकर्ता के बोलने और सहायक द्वारा प्रतिक्रिया देने के बीच का विलंब है।
वॉइस एप्लिकेशन में, एक छोटा सा ठहराव भी बातचीत के स्वाभाविक अनुभव को प्रभावित कर सकता है।
Artificial Analysis अपने Big Bench Audio मूल्यांकन पर Grok Voice 3.0 के लिए पहले ऑडियो तक का औसत समय 0.81 सेकंड बताता है। यह मापता है कि मॉडल अपना पहला ऑडियो आउटपुट कितनी तेज़ी से उत्पन्न करता है, न कि एप्लिकेशन उपयोगकर्ता द्वारा अनुभव किया गया पूर्ण वॉइस-टू-वॉइस प्रतिक्रिया समय।
यह एक महत्वपूर्ण माप है, लेकिन इसे संदर्भ की आवश्यकता है।
पहले ऑडियो तक का समय यह मापता है कि बेंचमार्क में पहला जनरेटेड ऑडियो कब उपलब्ध होता है। यह ज़रूरी नहीं कि प्रतिक्रिया समाप्त होने या कार्य पूरा होने के लिए आवश्यक कुल समय हो।
एक एप्लिकेशन नेटवर्क ट्रांसपोर्ट, ऑडियो बफरिंग, डेटाबेस क्वेरी और बाहरी टूल्स के माध्यम से अतिरिक्त देरी ला सकता है।
डेवलपर्स के लिए, उपयोगी प्रश्न केवल यह नहीं है कि मॉडल कितनी तेज़ी से बोलना शुरू करता है।
बल्कि यह है कि वास्तविक परिस्थितियों में संपूर्ण एप्लिकेशन कितनी तेज़ी से प्रतिक्रिया देता है।
3. स्वचालित टर्न डिटेक्शन और रुकावट प्रबंधन
वॉइस AI का एक कठिन हिस्सा यह तय करना है कि उपयोगकर्ता ने बोलना समाप्त कर लिया है या नहीं।
कल्पना कीजिए कि कोई कह रहा है:
"मैं अपनी बुकिंग बदलना चाहता हूँ..."
वे थोड़ा रुकते हैं।
"...अगले गुरुवार के लिए।"
यदि सहायक उस ठहराव के दौरान ही प्रतिक्रिया दे देता है, तो बातचीत अजीब हो जाती है।
Grok Voice बोलने की गतिविधि की पहचान करने और बातचीत के मोड़ों (turns) को निर्धारित करने के लिए सर्वर-साइड वॉइस एक्टिविटी डिटेक्शन (VAD) का उपयोग करता है।
server_vad सक्षम होने पर, डेवलपर्स स्वचालित टर्न डिटेक्शन और स्वाभाविक बार्ज-इन (बीच में बोलने का) व्यवहार का उपयोग कर सकते हैं।
हालाँकि, एप्लिकेशन को अभी भी ऑडियो प्लेबैक को प्रबंधित करने और यह सुनिश्चित करने की आवश्यकता होती है कि पुरानी प्रतिक्रिया का ऑडियो नई प्रतिक्रिया के साथ ओवरलैप न हो।
4. फ़ंक्शन कॉलिंग और बाहरी एकीकरण (External integrations)
एक उपयोगी वॉइस एजेंट को केवल सवालों के जवाब देने से कहीं अधिक करने की आवश्यकता होती है।
उसे ऑर्डर चेक करने, खाते की जानकारी प्राप्त करने, नॉलेज बेस खोजने, या आरक्षण (reservation) अपडेट करने की आवश्यकता हो सकती है।
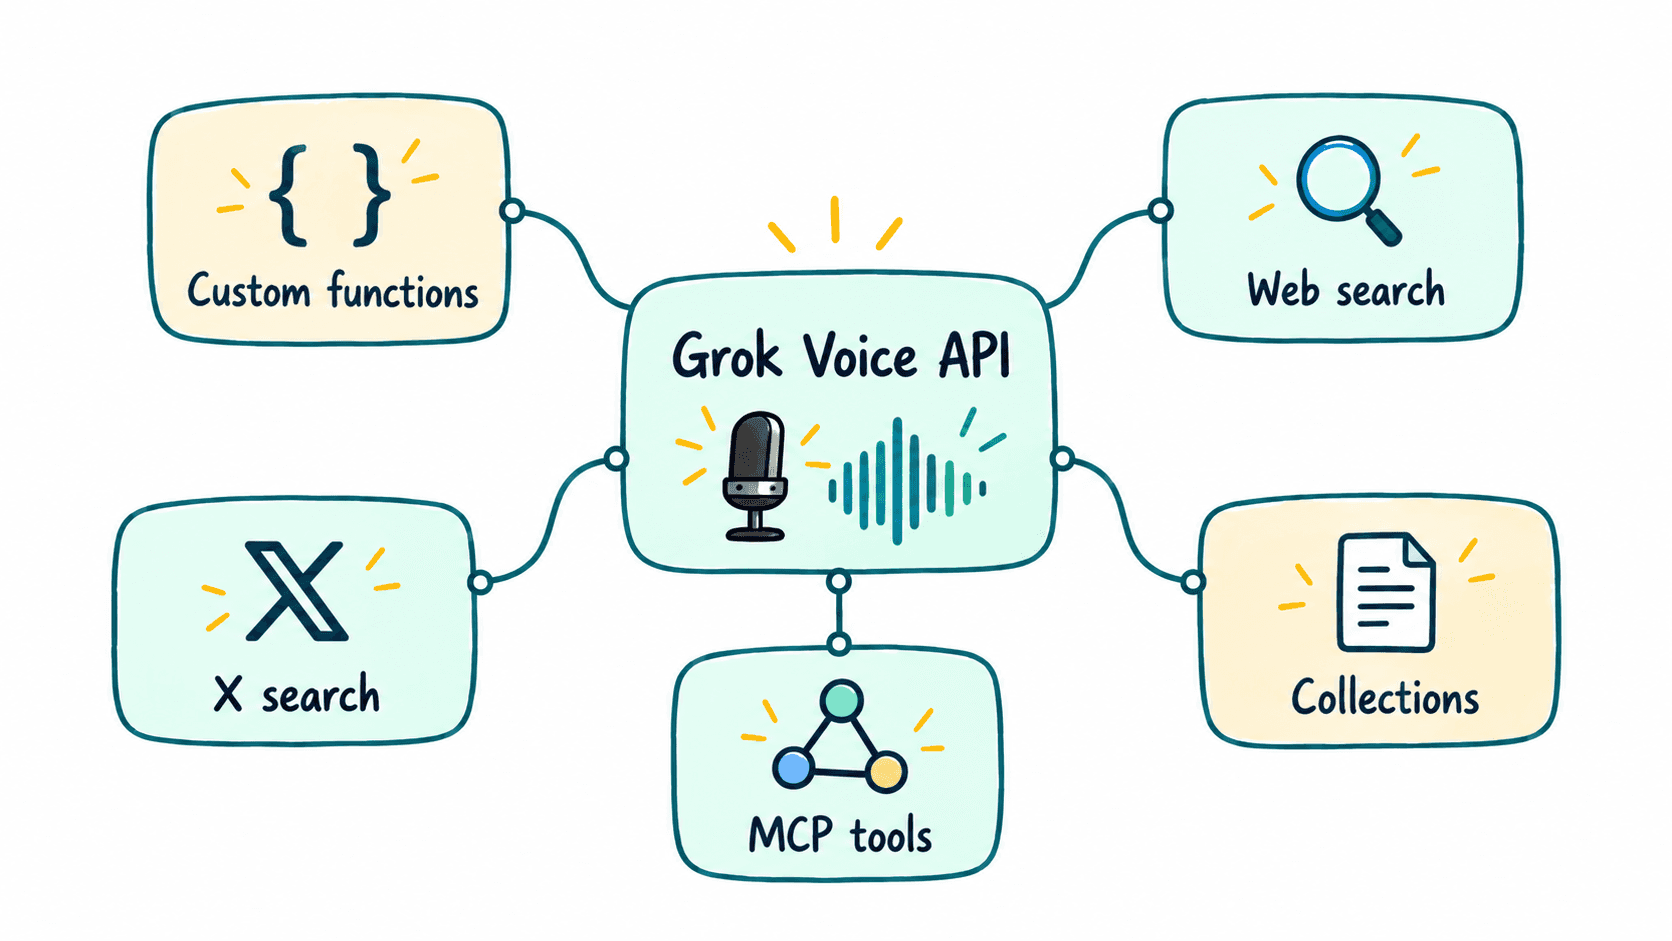
Grok Voice 3.0 कई टूल प्रकारों का समर्थन करता है:
कस्टम फ़ंक्शंस: सहायक को एप्लिकेशन-विशिष्ट परिचालनों से जोड़ते हैं।
वेब सर्च: वर्तमान जानकारी प्राप्त करने के लिए।
X सर्च: X से प्रासंगिक जानकारी खोजने के लिए।
कलेक्शन्स सर्च: अपलोड किए गए दस्तावेज़ों से जानकारी प्राप्त करने के लिए।
रिमोट MCP टूल्स: मॉडल संदर्भ प्रोटोकॉल (Model Context Protocol) सर्वर के माध्यम से बाहरी टूल्स से जुड़ने के लिए।
उदाहरण के लिए, कोई ग्राहक पूछ सकता है:
"मेरा पैकेज कहाँ है?"
एजेंट यह पहचान सकता है कि प्रश्न के लिए ऑर्डर की जानकारी की आवश्यकता है, उपयुक्त फ़ंक्शन को कॉल कर सकता है, परिणाम प्राप्त कर सकता है, और बातचीत जारी रख सकता है।
एप्लिकेशन को अभी भी प्राधिकरण (authorization) को संभालना होगा, कस्टम फ़ंक्शंस को सुरक्षित रूप से निष्पादित करना होगा, और मॉडल को टूल परिणाम वापस लौटाना होगा।
5. बहुभाषी बातचीत और आवाज़ अनुकूलन (Voice customization)
Grok का Speech-to-Speech API अंग्रेजी, हिंदी, फ्रेंच, जर्मन, जापानी और स्पेनिश सहित 20 से अधिक भाषाओं के समर्थन का दस्तावेजीकरण करता है।
API आने वाली भाषा का पता लगा सकता है और उसी भाषा में प्रतिक्रिया दे सकता है। डेवलपर्स भाषा संकेत (language hints) भी कॉन्फ़िगर कर सकते हैं।
स्पीच आउटपुट के लिए, API इन-बिल्ट आवाज़ों, स्पीच-स्पीड नियंत्रण और उच्चारण प्रतिस्थापन (pronunciation replacements) का समर्थन करता है।
कस्टम वॉइस क्लोनिंग xAI की Custom Voices सुविधा के माध्यम से भी समर्थित है। अक्टूबर 2026 तक, कस्टम वॉइस निर्माण इलिनोइस को छोड़कर संयुक्त राज्य अमेरिका में उपलब्ध है। डेवलपर्स स्पीच-टू-स्पीच और टेक्स्ट-टू-स्पीच दोनों API में क्लोन की गई आवाज़ का उपयोग कर सकते हैं, जबकि API के माध्यम से कस्टम आवाज़ निर्माण केवल एंटरप्राइज़ खातों तक ही सीमित है।
ये क्षमताएं अंतर्राष्ट्रीय ग्राहक सहायता, यात्रा सहायकों और उन अनुप्रयोगों के लिए उपयोगी हैं जहाँ उच्चारण और स्थानीयकृत बोली मायने रखती है।
Grok Voice 3.0 API: डेवलपर अनुभव कैसा दिखता है?
Grok Voice 3.0 को रीयल-टाइम Voice Agent API के माध्यम से एक्सेस किया जाता है।
मूल सेटअप में एक सत्र खोलना, एजेंट को कॉन्फ़िगर करना, ऑडियो स्ट्रीम करना, और प्रतिक्रियाओं को संसाधित करना शामिल है।
एक सामान्य वर्कफ़्लो इस प्रकार दिखता है:
माइक्रोफ़ोन → रीयल-टाइम WebSocket → Grok Voice 3.0 → जनरेट किया गया ऑडियो → स्पीकर
जब किसी बाहरी क्रिया की आवश्यकता होती है, तो एप्लिकेशन फ़ंक्शन कॉल को संभालता है और परिणाम को सत्र में लौटाता है।
मूल कॉन्फ़िगरेशन
सेटिंग | उद्देश्य |
|---|---|
grok-voice-3.0 | मॉडल का चयन करता है |
grok-voice-latest | वर्तमान मॉडल उपनाम (alias) का उपयोग करता है |
session.update | सक्रिय सत्र को कॉन्फ़िगर करता है |
instructions | एजेंट के व्यवहार को परिभाषित करता है |
voice | आउटपुट आवाज़ का चयन करता है |
server_vad | स्वचालित टर्न डिटेक्शन को सक्षम करता है |
tools | उपलब्ध टूल्स और फ़ंक्शंस को पंजीकृत करता है |
डेवलपर्स xAI के प्लेग्राउंड का उपयोग करके मॉडल का परीक्षण कर सकते हैं या इसे API के माध्यम से कस्टम एप्लिकेशन में एकीकृत कर सकते हैं।
प्रोडक्शन अनुप्रयोगों के लिए, अल्पकालिक टोकन (ephemeral tokens) स्थायी API कुंजी को उजागर किए बिना ब्राउज़र और मोबाइल क्लाइंट को कनेक्ट करने का एक तरीका प्रदान करते हैं।
API विभिन्न ऑडियो प्रारूपों और टेलीफोनी एकीकरणों का भी समर्थन करता है।
यह टीमों को लचीलापन देता है, लेकिन उन्हें अभी भी आसपास के एप्लिकेशन लॉजिक, प्रमाणीकरण (authentication), प्लेबैक हैंडलिंग, एरर रिकवरी और मॉनिटरिंग को लागू करने की आवश्यकता होती है।
Grok Voice 3.0 मूल्य निर्धारण: API की लागत कितनी है?
Grok Voice 3.0 Voice Agent API के माध्यम से Grok Voice 2.0 की समान प्रकाशित कीमत पर उपलब्ध है।
उपयोग | प्रकाशित मूल्य |
|---|---|
स्पीच-टू-स्पीच ऑडियो | $0.08 प्रति मिनट |
बिल योग्य ऑडियो का एक घंटा | $4.80 |
बिल योग्य टेक्स्ट-इनपुट इवेंट | $0.004 प्रति संदेश |
हेडलाइन ऑडियो मूल्य सीधा है। वास्तविक बिल इस बात पर निर्भर करता है कि सत्र कैसे कॉन्फ़िगर किया गया है।
बिलिंग कैसे काम करती है
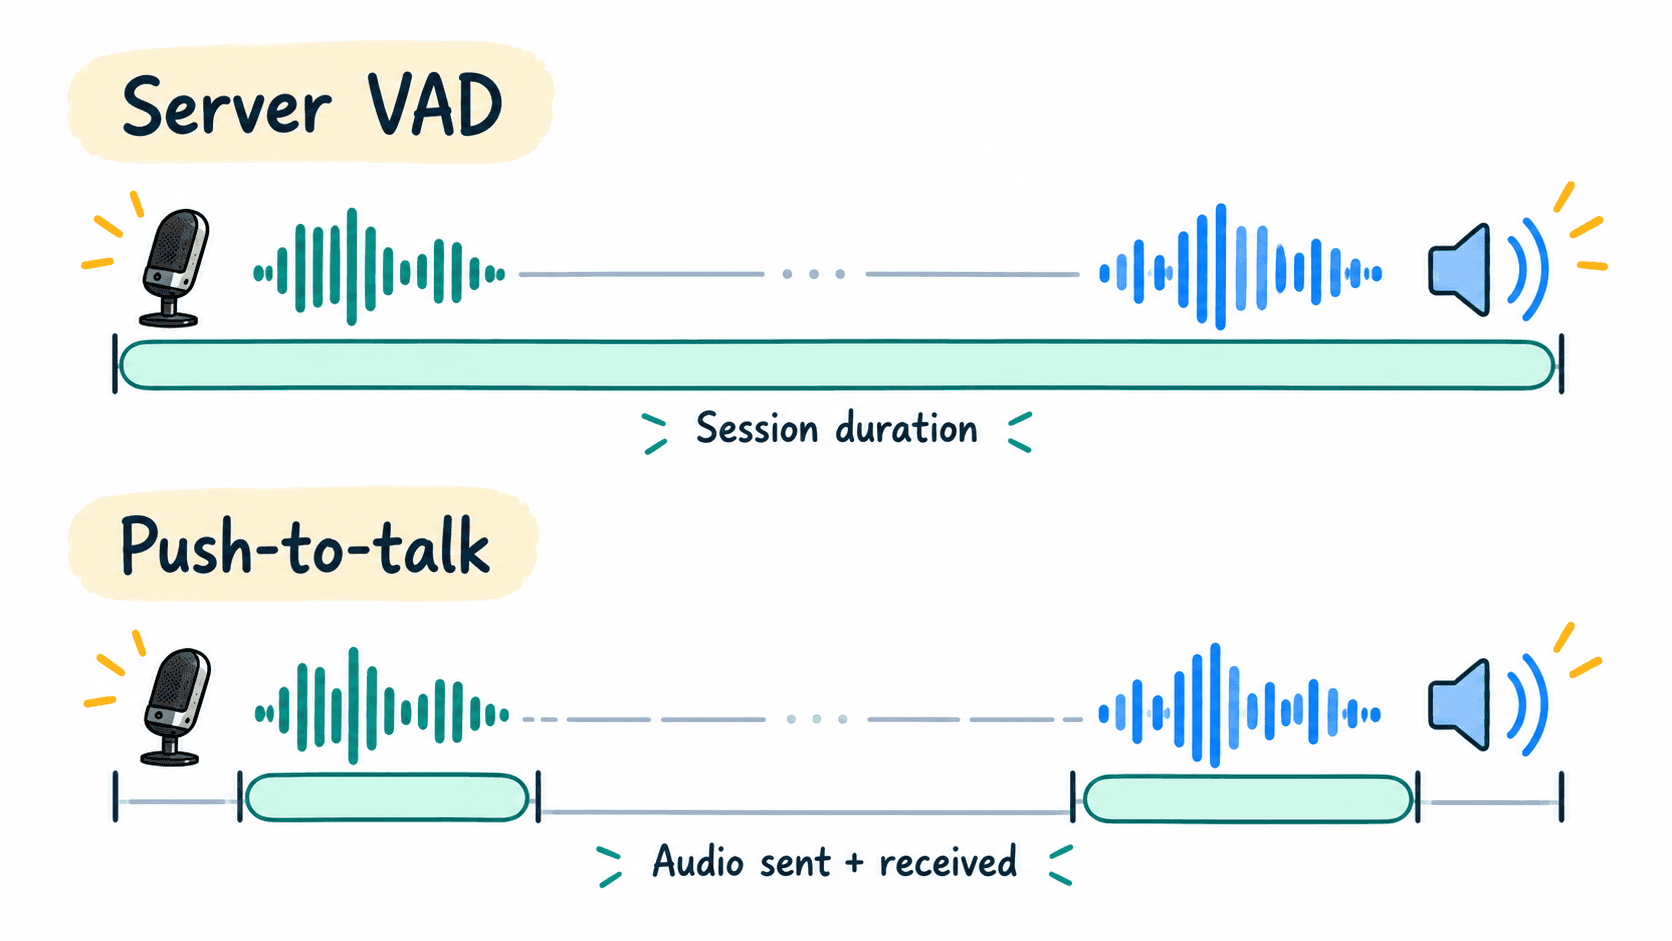
डिफ़ॉल्ट सर्वर-साइड VAD कॉन्फ़िगरेशन के साथ, ऑडियो उपयोग का बिल सत्र की अवधि के अनुसार लिया जाता है।
पुश-टू-टॉक सत्रों के लिए, बिलिंग भेजे गए और प्राप्त किए गए ऑडियो पर आधारित होती है।
API प्रत्येक बिल योग्य conversation.item.create टेक्स्ट-इनपुट इवेंट के लिए $0.004 का शुल्क भी लेता है। हालाँकि, सर्वर द्वारा अनुरोधित फ़ंक्शन-कॉल आउटपुट संदेशों और ऑडियो युक्त संदेशों को इस अलग टेक्स्ट-इनपुट शुल्क से बाहर रखा गया है। एक response.create इवेंट पर कोई टेक्स्ट-इनपुट शुल्क नहीं लगता है, हालांकि जनरेट किया गया ऑडियो ऑडियो बिलिंग के अधीन रहता है।
यह अंतर इसलिए महत्वपूर्ण है क्योंकि एक ग्राहक सहायता कॉल में ठहराव, बाहरी अनुरोध और कई बातचीत के मोड़ शामिल हो सकते हैं।
डेवलपर्स को हर कॉल को लगातार सक्रिय बातचीत मानने के बजाय अपेक्षित सत्र अवधि, टेक्स्ट इवेंट्स और वास्तविक एप्लिकेशन ट्रैफ़िक का उपयोग करके लागत का अनुमान लगाना चाहिए।
टेलीफोनी, बैकएंड सेवाओं, मॉनिटरिंग और बाहरी व्यावसायिक API जैसे बुनियादी ढांचे के खर्चों पर भी विचार करें।
Grok Voice 3.0 बेंचमार्क: परिणाम वास्तव में क्या दिखाते हैं?
एक वॉइस मॉडल प्रदर्शन (डेमो) में प्रभावशाली लग सकता है और फिर भी वास्तविक ग्राहक बातचीत के दौरान संघर्ष कर सकता है।
एक उपयोगी बेंचमार्क को केवल उच्चारण या ऑडियो गुणवत्ता से अधिक परीक्षण करने की आवश्यकता होती है।
उसे यह देखना चाहिए कि क्या मॉडल बोले गए प्रश्नों को समझता है, कार्यों को पूरा करता है, रुकावटों को पहचानता है, और संवादात्मक प्रवाह को बनाए रखता है।
Artificial Analysis कई अलग-अलग मापों का उपयोग करके इन क्षमताओं का मूल्यांकन करता है।
स्पीच-टू-स्पीच इंडेक्स
Grok Voice 3.0 को Artificial Analysis Speech-to-Speech Index पर 86.9 का समग्र स्कोर प्राप्त हुआ।
यह सूचकांक स्पीच रीज़निंग, एजेंटिक प्रदर्शन, संवादात्मक प्राथमिकता और कार्य सफलता को जोड़ता है।
यह एकल विलंबता या वाक्-पहचान मीट्रिक की तुलना में व्यापक मूल्यांकन प्रदान करता है।
अक्टूबर 2026 के परिणामों में, पूर्ण परिणामों वाले मूल्यांकन किए गए मॉडलों में Grok Voice 3.0 समग्र सूचकांक में सबसे आगे है।
फुल डुप्लेक्स बेंच
Grok Voice 3.0 ने Full Duplex Bench पर 97.0% स्कोर किया।
यह बेंचमार्क संवादात्मक गतिशीलता का मूल्यांकन करता है, जिसमें ठहराव, रुकावटें, बारी लेना और संक्षिप्त पावती (acknowledgments) शामिल हैं।
ये ऐसे व्यवहार हैं जो यह निर्धारित करते हैं कि लाइव बातचीत के दौरान AI सहायक कितना उत्तरदायी महसूस होता है।
एक उच्च स्कोर बेंचमार्क की परीक्षण स्थितियों पर मजबूत प्रदर्शन का सुझाव देता है। इसका मतलब यह नहीं है कि वास्तविक दुनिया की हर रुकावट को सही ढंग से संभाला जाएगा।
स्पीच रीज़निंग और कार्य पूर्णता
Grok Voice 3.0 ने Big Bench Audio स्पीच रीज़निंग मूल्यांकन पर 98.5% स्कोर दर्ज किया।
इसकी Speech Agent Arena कार्य सफलता दर 94.8% थी।
ये मेट्रिक्स अलग-अलग चीजों का मूल्यांकन करते हैं।
स्पीच रीज़निंग ऑडियो के रूप में प्रस्तुत तर्क प्रश्नों का उत्तर देने की क्षमता को मापती है।
कार्य सफलता उन योग्य वार्तालापों के अनुपात को मापती है जिनमें मॉडल कार्य को पूरा करने वाले सही टूल कॉल करता है। यह मूल्यांकन किए गए परिदृश्यों पर प्रदर्शन को दर्शाता है, न कि प्रोडक्शन ग्राहक वार्तालापों में सफल परिणामों की गारंटी देता है।
किसी भी माप को उत्पादन में सफलता की गारंटी वाली दर के रूप में नहीं समझा जाना चाहिए।
बेंचमार्क तुलनाओं को संदर्भ की आवश्यकता क्यों है
समान मॉडल नेटवर्क, ऑडियो गुणवत्ता, टूल वर्कलोड, सिस्टम निर्देशों और क्लाइंट कार्यान्वयन के आधार पर अलग-अलग प्रदर्शन कर सकता है।
यहाँ तक कि लेटेंसी का अर्थ भी भिन्न हो सकता है।
पहले ऑडियो तक का समय, वॉइस-टू-वॉइस प्रतिक्रिया समय, और टूल-कॉल पूर्णता समय एक बातचीत के विभिन्न चरणों को मापते हैं।
यह तब विशेष रूप से महत्वपूर्ण हो जाता है जब Grok Voice 3.0 की तुलना Smallest.ai Hydra जैसे विकल्पों से की जाती है।
Grok Voice 3.0 बनाम Smallest.ai Hydra: रीयल-टाइम वॉइस AI के लिए कौन सा बेहतर है?
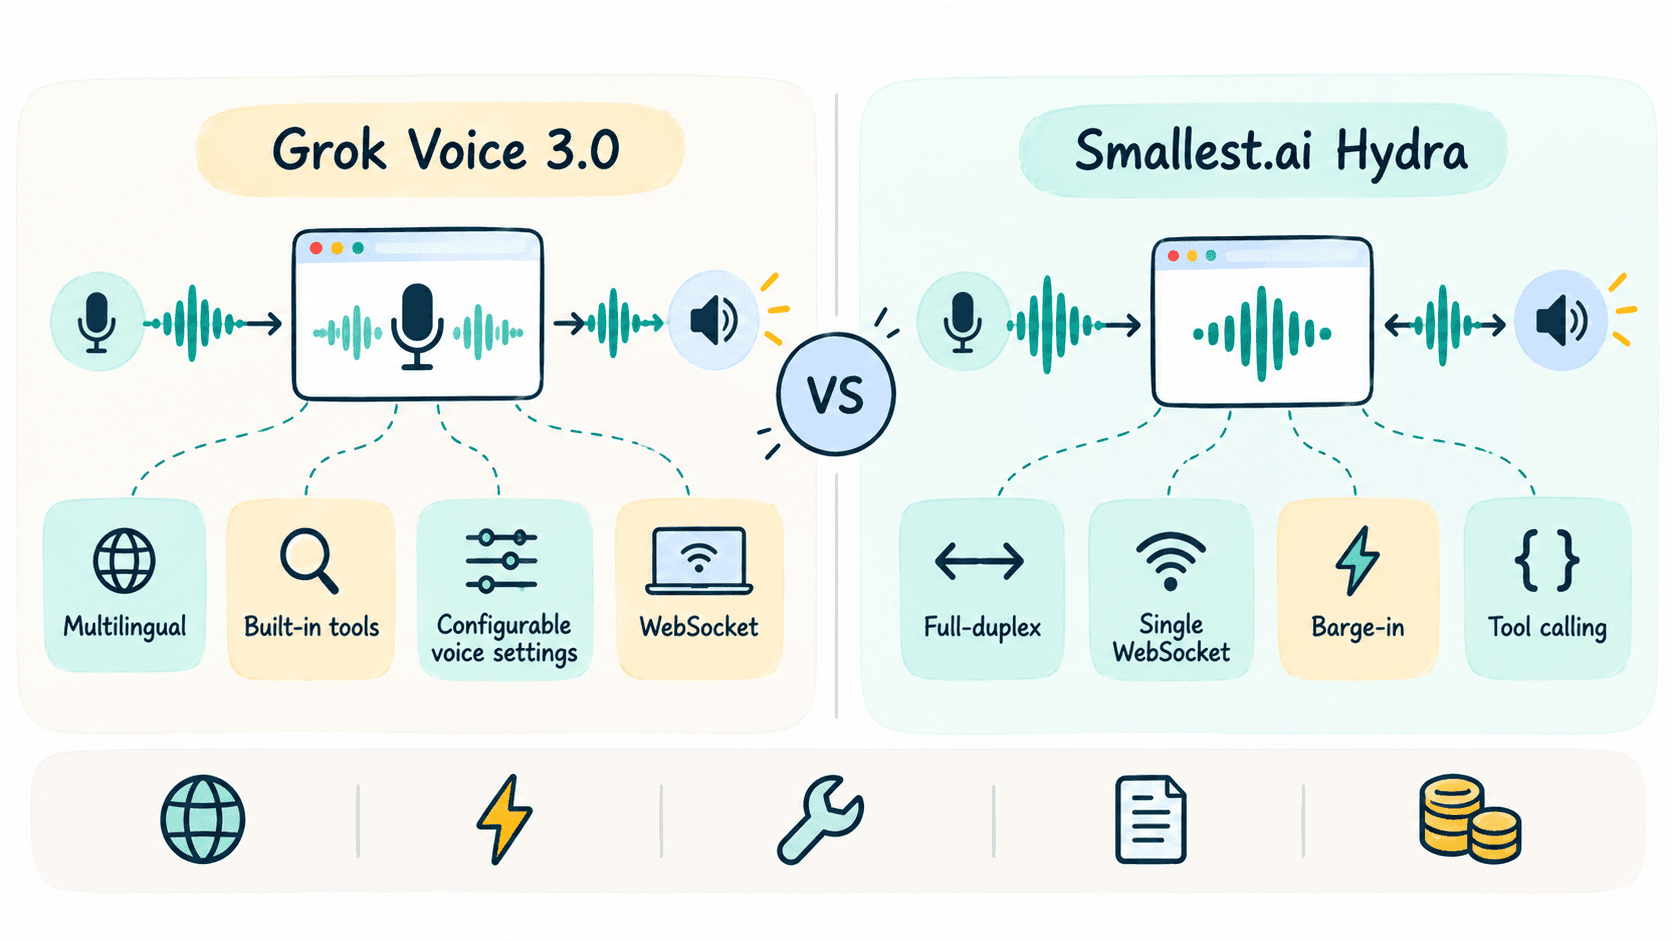
Grok Voice 3.0 और Smallest.ai Hydra एक समान समस्या का समाधान करते हैं: डेवलपर्स को रीयल-टाइम एप्लिकेशन बनाने में सक्षम बनाना जो बोली गई इनपुट को समझते हैं और स्पीच में प्रतिक्रिया देते हैं।
हालाँकि, उनकी प्रलेखित क्षमताएं और डेवलपर इंटरफ़ेस भिन्न हैं।
Hydra Smallest.ai का मूल (native) फुल-डुप्लेक्स स्पीच-टू-स्पीच मॉडल है। इसे एकल WebSocket कनेक्शन के इर्द-गिर्द डिज़ाइन किया गया है जो आने वाले माइक्रोफ़ोन ऑडियो और बाहर जाने वाले संश्लेषित भाषण को ले जाता है।
मॉडल स्पीच-टू-स्पीच सत्र के भीतर टर्न सीमाओं, रुकावटों और टूल-कॉल निर्माण का प्रबंधन करता है।
आर्किटेक्चर और ऑडियो प्रोसेसिंग
Hydra का आर्किटेक्चर उन डेवलपर्स के लिए विशेष रूप से प्रासंगिक है जो अलग-अलग स्पीच रिकॉग्निशन, रीज़निंग और स्पीच सिंथेसिस सेवाओं के समन्वय से बचना चाहते हैं।
ऑडियो एक WebSocket कनेक्शन के माध्यम से प्रवेश करता है, और उत्पन्न ऑडियो उसी सत्र के माध्यम से वापस स्ट्रीम होता है।
Hydra के प्रलेखित कार्यान्वयन को वाक् बातचीत के लिए एक अलग STT-से-LLM-से-TTS श्रृंखला की आवश्यकता नहीं होती है।
Grok Voice 3.0 इसी तरह एक रीयल-टाइम स्पीच-टू-स्पीच API प्रदर्शित करता है, लेकिन आंतरिक प्रसंस्करण विवरण इसके सार्वजनिक API इंटरफ़ेस द्वारा पूरी तरह से स्पष्ट नहीं किए गए हैं।
उस कारण से, दोनों की तुलना ऐसे करना जैसे कि वे समान आंतरिक मॉडल आर्किटेक्चर का उपयोग करते हैं, भ्रामक होगा।
रुकावट प्रबंधन (Interruption handling)
दोनों मॉडल संवादात्मक रुकावट प्रबंधन का समर्थन करते हैं।
Grok Voice 3.0 स्वचालित टर्न-टेकिंग और बार्ज-इन का समर्थन करने के लिए कॉन्फ़िगर करने योग्य सर्वर-साइड वॉइस एक्टिविटी डिटेक्शन का उपयोग करता है।
Hydra अपने स्पीच-टू-स्पीच सत्र के भीतर मूल रूप से बार्ज-इन को संभालता है। जब उपयोगकर्ता बीच में टोकता है, तो सर्वर प्रगति पर मौजूद प्रतिक्रिया को रद्द कर देता है।
Hydra क्लाइंट को अभी भी बाधित प्रतिक्रिया से बफ़र किए गए ऑडियो को त्यागने की आवश्यकता होती है ताकि पुराना भाषण स्थानीय रूप से बजना जारी न रहे।
व्यावहारिक अंतर प्रलेखित इवेंट-हैंडलिंग और नियंत्रण इंटरफेस में है, न कि इस सिद्ध दावे में कि एक मॉडल हमेशा तेजी से बीच में टोकने पर प्रतिक्रिया देता है।
फ़ंक्शन कॉलिंग
दोनों प्रणालियाँ बाहरी कार्यों को ट्रिगर कर सकती हैं।
Grok Voice 3.0 खोज, दस्तावेज़ पुनर्प्राप्ति और MCP टूल्स के लिए इन-बिल्ट एकीकरण के साथ-साथ कस्टम फ़ंक्शन प्रदान करता है।
Hydra JSON-स्कीमा-आधारित फ़ंक्शन कॉलिंग का समर्थन करता है। मॉडल टूल-कॉल तर्क प्रस्तुत करता है, और परिणाम लौटाने से पहले डेवलपर का एप्लिकेशन अनुरोधित फ़ंक्शन को निष्पादित करता है।
कस्टम व्यावसायिक वर्कफ़्लो बनाने वाले डेवलपर्स के लिए, दोनों दृष्टिकोण ग्राहक रिकॉर्ड देखने और ऑर्डर की जानकारी प्राप्त करने जैसे कार्यों का समर्थन कर सकते हैं।
डेवलपर अनुभव
Grok Voice कॉन्फ़िगरेशन विकल्पों, ऑडियो प्रारूपों, इन-बिल्ट टूल्स और बहुभाषी क्षमताओं का एक विस्तृत सेट प्रदान करता है।
Hydra स्वचालित रुकावट व्यवहार और फ़ंक्शन कॉलिंग के साथ एकल ऑडियो-टू-ऑडियो WebSocket इंटरफ़ेस पर ज़ोर देता है।
Smallest.ai एजेंट प्रीसेट, टूल निष्पादन और लाइव इवेंट निरीक्षण के साथ एक संदर्भ ब्राउज़र क्लाइंट भी प्रदान करता है।
जिन टीमों को ट्रांसक्रिप्ट या अलग से नियंत्रित लैंग्वेज मॉडल की आवश्यकता होती है, वे Hydra के स्थान पर Smallest.ai के मॉड्यूलर Pulse, Electron, और Lightning घटकों का उपयोग कर सकती हैं।
Grok Voice 3.0 बनाम Hydra: सुविधाओं की तुलना
सुविधा | Grok Voice 3.0 | Smallest.ai Hydra |
|---|---|---|
मॉडल श्रेणी | रीयल-टाइम स्पीच-टू-स्पीच | मूल फुल-डुप्लेक्स स्पीच-टू-स्पीच |
स्ट्रीमिंग | WebSocket-आधारित | ऑडियो इन और आउट के लिए सिंगल WebSocket |
फुल-डुप्लेक्स संवाद | समर्थित | समर्थित |
रुकावट प्रबंधन | सर्वर VAD और बार्ज-इन समर्थन | प्रतिक्रिया रद्दीकरण के साथ मूल बार्ज-इन |
फ़ंक्शन कॉलिंग | कस्टम फ़ंक्शंस और इन-बिल्ट टूल्स | JSON-स्कीमा कस्टम टूल कॉलिंग |
भाषा समर्थन | 20+ प्रलेखित भाषाएं | वर्तमान Hydra रिलीज़ में अंग्रेजी |
आउटपुट आवाज़ें | इन-बिल्ट और समर्थित कस्टम आवाज़ें | Hydra v1.1 में 10 आवाज़ें |
ऑडियो ट्रांसपोर्ट | एकाधिक प्रलेखित कोडेक्स और ट्रांसपोर्ट्स | JSON WebSocket फ्रेम्स में PCM16 ऑडियो |
ट्रांसक्रिप्ट एक्सेस | कॉन्फ़िगर होने पर इनपुट ट्रांसक्रिप्शन इवेंट्स का समर्थन करता है | मूल ट्रांसक्रिप्ट स्ट्रीम उत्सर्जित नहीं करता; Pulse STT का उपयोग करके ऑडियो को अलग से ट्रांसक्राइब किया जा सकता है |
प्रकाशित API मूल्य | ऑडियो के लिए $0.08/मिनट | मूल्य निर्धारण के लिए Smallest.ai से संपर्क करें |
प्रकाशित बेंचमार्क | Artificial Analysis Speech-to-Speech Index | Smallest.ai AIEWF S2S मूल्यांकन |
Hydra बेंचमार्क में कैसा प्रदर्शन करता है?
Smallest.ai का Hydra मॉडल कार्ड 30 मोड़ों के 10 रनों का उपयोग करते हुए अपने AIEWF स्पीच-टू-स्पीच मूल्यांकन से परिणाम रिपोर्ट करता है।
प्रकाशित परिणामों में शामिल हैं:
Hydra माप | रिपोर्ट किया गया परिणाम |
|---|---|
बिना टूल्स के मीडियन वॉइस-टू-वॉइस लेटेंसी | 864 ms |
टूल्स के साथ मीन वॉइस-टू-वॉइस लेटेंसी | 1,624 ms |
टास्क पास दर | 95.9% |
Smallest.ai के प्रकाशित AIEWF मूल्यांकन में, Hydra ने 864 ms की गैर-टूल वॉइस-टू-वॉइस मीडियन लेटेंसी दर्ज की, जो नौ मूल्यांकित मॉडलों में सबसे तेज़ परिणाम के लिए Ultravox के साथ बराबरी पर रही। Hydra ने 1,624 ms पर सबसे कम औसत टूल वॉइस-टू-वॉइस लेटेंसी भी हासिल की, जबकि इसकी 95.9% टास्क पास दर रिपोर्ट किए गए पास-रेट परिणामों वाले आठ मॉडलों में तीसरे स्थान पर रही।
ये माप प्रलेखित परीक्षण वातावरण में Hydra के प्रदर्शन के उपयोगी संकेतक हैं।
हालाँकि, उनकी सीधे Grok Voice 3.0 के 0.81-सेकंड के पहले ऑडियो तक के समय या इसके Artificial Analysis बेंचमार्क स्कोर से तुलना नहीं की जा सकती है।
डेटासेट, मॉडल संस्करण और विलंबता की परिभाषाएं भिन्न हैं।
एक मान्य आमने-सामने की तुलना के लिए दोनों मॉडलों को समान ऑडियो वर्कलोड, नेटवर्क स्थितियों, टूल कॉल और मूल्यांकन पद्धति पर परीक्षण करने की आवश्यकता होगी।
डेवलपर्स को Grok Voice 3.0 या Hydra कब चुनना चाहिए?
प्रत्येक रीयल-टाइम वॉइस एप्लिकेशन के लिए कोई एक सही उत्तर नहीं है।
चुनाव इस बात पर निर्भर करता है कि डेवलपर्स क्या बनाना चाहते हैं और उन्हें किन क्षमताओं को नियंत्रित करने की आवश्यकता है।
Grok Voice 3.0 तब चुनें जब:
आपके एप्लिकेशन को मॉडल की प्रलेखित बहुभाषी क्षमताओं की आवश्यकता हो।
आपको इन-बिल्ट खोज और दस्तावेज़ पुनर्प्राप्ति टूल्स की आवश्यकता हो।
आप कॉन्फ़िगर करने योग्य ऑडियो प्रारूपों के साथ स्पीच-टू-स्पीच संवाद चाहते हैं।
आप मजबूत प्रकाशित Artificial Analysis परिणामों वाले मॉडल का मूल्यांकन करना चाहते हैं।
आप पहले से ही xAI Voice Agent API के साथ निर्माण कर रहे हैं।
Smallest.ai Hydra पर तब विचार करें जब:
आप एक अंग्रेजी-भाषा, ऑडियो-फ़र्स्ट संवादात्मक एप्लिकेशन बना रहे हैं।
मूल बार्ज-इन और रुकावट प्रबंधन अनुभव के केंद्र में हैं।
आप एकल स्पीच-टू-स्पीच WebSocket इंटरफ़ेस पसंद करते हैं।
आपको लाइव बातचीत के दौरान कस्टम फ़ंक्शन कॉलिंग की आवश्यकता है।
आप Smallest.ai के अन्य स्पीच और वॉइस-एजेंट घटकों के साथ मॉडल का मूल्यांकन करना चाहते हैं।
उन डेवलपर्स के लिए जिन्हें स्पष्ट ट्रांसक्रिप्ट प्रोसेसिंग, एक कस्टम रीज़निंग लेयर, या Hydra के प्रलेखित समर्थन से परे बहुभाषी कार्यक्षमता की आवश्यकता है, Smallest.ai का मॉड्यूलर वॉइस स्टैक अकेले Hydra की तुलना में अधिक उपयुक्त विकल्प हो सकता है।
Grok Voice 3.0 की सीमाएं
मजबूत बेंचमार्क प्रदर्शन रीयल-टाइम वॉइस एप्लिकेशन में शामिल इंजीनियरिंग चुनौतियों को समाप्त नहीं करता है।
प्रोडक्शन परिनियोजन (deployment) से पहले कई सीमाओं पर ध्यान देने की आवश्यकता है।
लेटेंसी अभी भी एप्लिकेशन पर निर्भर करती है
एक मॉडल तेज़ी से भाषण देना शुरू कर सकता है जबकि एक एप्लिकेशन को ऑडियो प्रोसेसिंग, नेटवर्क ट्रांसमिशन, बाहरी टूल्स या प्लेबैक से देरी का सामना करना पड़ सकता है।
डेवलपर्स को केवल मॉडल-स्तरीय परिणामों पर भरोसा करने के बजाय संपूर्ण इंटरैक्शन को मापना चाहिए।
टूल कॉल्स को एप्लिकेशन लॉजिक की आवश्यकता होती है
फ़ंक्शन कॉलिंग एक एजेंट को किसी क्रिया का अनुरोध करने की अनुमति देती है, लेकिन यह स्वचालित रूप से उस क्रिया को सुरक्षित या सफल नहीं बनाती है।
प्रोडक्शन कार्यान्वयन को अभी भी संवेदनशील संचालन से पहले अनुमतियों, इनपुट सत्यापन (validation), त्रुटि प्रबंधन और पुष्टि की आवश्यकता होती है।
स्पीच पहचान और तर्क अभी भी विफल हो सकते हैं
उच्चारण, पृष्ठभूमि का शोर, एक साथ बोलने वाले लोग, असामान्य नाम और अस्पष्ट अनुरोध संवादात्मक सटीकता को प्रभावित कर सकते हैं।
उच्च बेंचमार्क स्कोर को प्रतिनिधि उपयोगकर्ताओं और प्रोडक्शन ऑडियो के साथ परीक्षण का विकल्प नहीं होना चाहिए।
मूल्य निर्धारण उपयोग के पैटर्न पर निर्भर करता है
सत्र-आधारित बिलिंग परिचालन लागत के लिए शांति (silence) के समय को भी प्रासंगिक बना सकती है।
लंबी बातचीत वाले अनुप्रयोगों को सत्र की अवधि, टेक्स्ट इवेंट्स, समवर्तीता (concurrency), और बुनियादी ढांचे के खर्चों की निगरानी करनी चाहिए।
बेंचमार्क प्रोडक्शन विश्वसनीयता स्थापित नहीं करते हैं
एक बेंचमार्क विशेष परिस्थितियों में कार्यों के एक परिभाषित सेट को मापता है।
यह स्वतंत्र रूप से अपटाइम, पीक समवर्तीता के तहत प्रदर्शन, या हर ग्राहक-सहायता वर्कफ़्लो में सफलता स्थापित नहीं करता है।
टीमों को अपने स्वयं के वॉइस एजेंट मूल्यांकन के हिस्से के रूप में विश्वसनीयता और रिकवरी व्यवहार का परीक्षण करना चाहिए।
सर्वश्रेष्ठ Grok Voice 3.0 के विकल्प
रीयल-टाइम स्पीच-टू-स्पीच AI के बढ़ते बाज़ार में Grok Voice 3.0 एक विकल्प है।
सबसे मजबूत विकल्प इस बात पर निर्भर करता है कि क्या कोई टीम कम-विलंबता वाले इंटरैक्शन, भाषा समर्थन, टूल एकीकरण, या आर्किटेक्चरल लचीलेपन को प्राथमिकता देती है।
1. Smallest.ai Hydra
Hydra फुल-डुप्लेक्स, अंग्रेजी भाषा के वॉइस एप्लिकेशन बनाने वाले डेवलपर्स के लिए एक सीधा विकल्प है।
इसकी प्रलेखित क्षमताओं में मूल बार्ज-इन, स्ट्रीमिंग स्पीच प्रतिक्रियाएं, JSON-स्कीमा टूल कॉलिंग और एकल WebSocket इंटरफ़ेस शामिल हैं।
यह फोन सहायकों, कियोस्क और इंटरैक्टिव प्रणालियों के लिए विशेष रूप से प्रासंगिक है जहाँ तेज़, स्वाभाविक टर्न-टेकिंग मायने रखती है।
अलग स्पीच पहचान और संश्लेषण घटकों की आवश्यकता वाले अनुप्रयोगों के लिए, Smallest.ai Pulse STT, Lightning TTS और Electron भी प्रदान करता है।
2. OpenAI Realtime और Live मॉडल
OpenAI उन अनुप्रयोगों के लिए रीयल-टाइम वॉइस मॉडल प्रदान करता है जिन्हें मौखिक संवाद और संवादात्मक तर्क की आवश्यकता होती है।
ये मॉडल OpenAI के डेवलपर इकोसिस्टम के साथ पहले से काम कर रही टीमों के लिए प्रासंगिक विकल्प हैं।
उपयुक्त मॉडल और कॉन्फ़िगरेशन एप्लिकेशन के तर्क, आवाज़, विलंबता और लागत आवश्यकताओं पर निर्भर करते हैं।
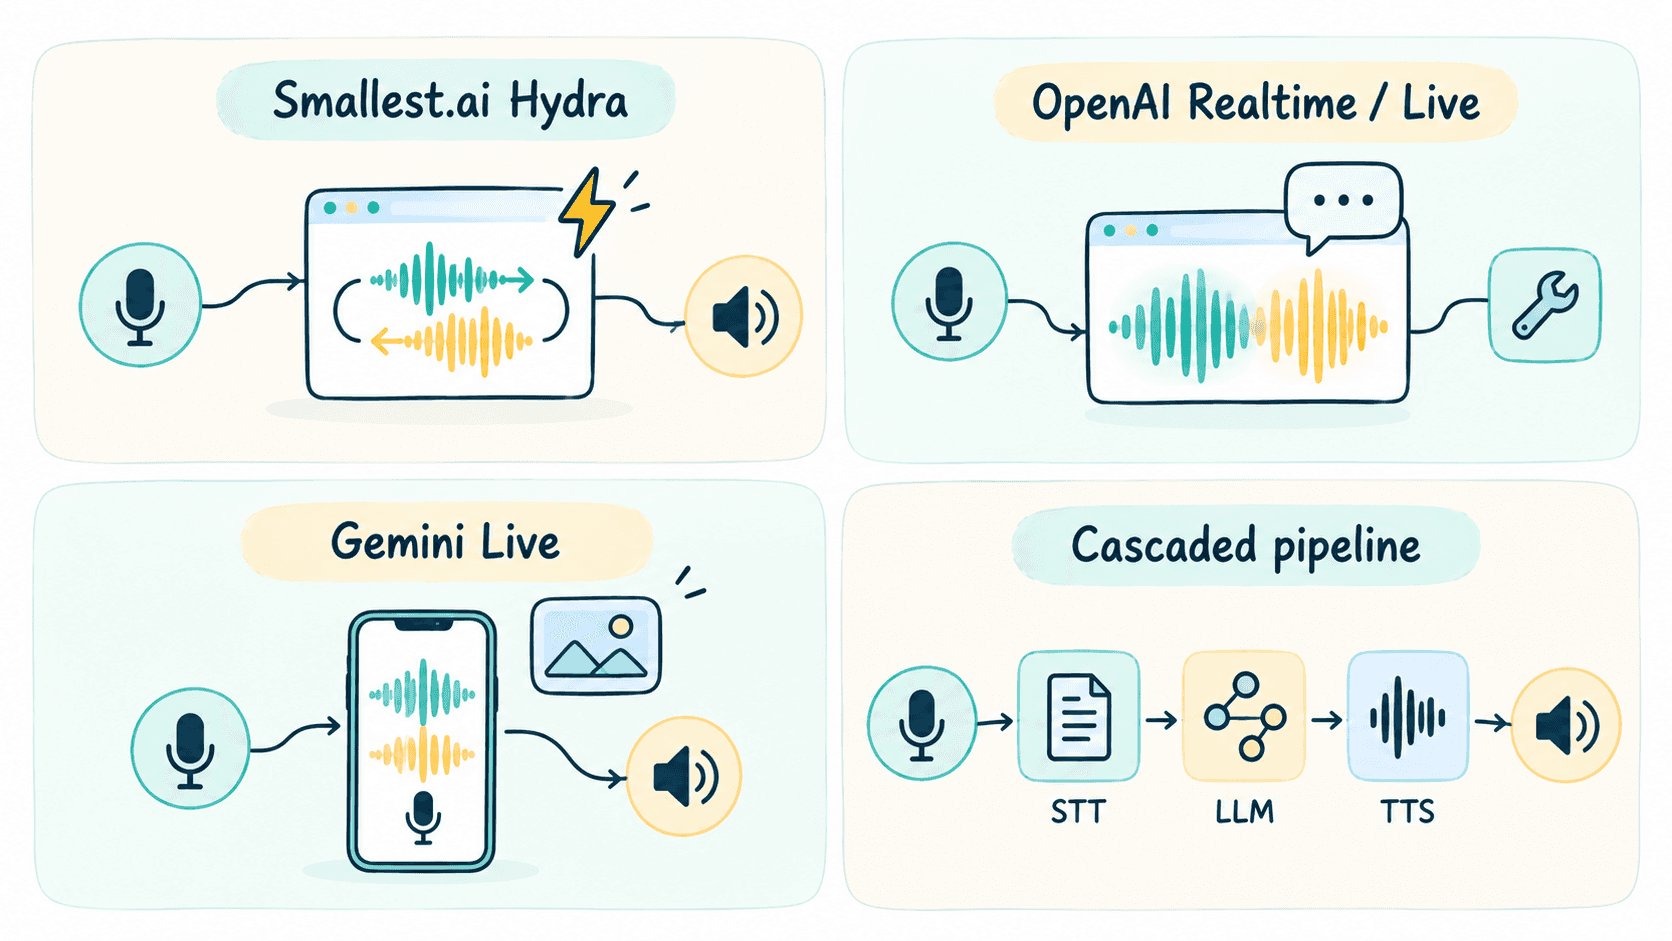
3. Google Gemini Live
Google का Gemini Live API WebSockets के माध्यम से रीयल-टाइम, द्विदिशीय (bidirectional) वॉइस इंटरैक्शन का समर्थन करता है। यह अनुप्रयोगों को संवादात्मक संदर्भ बनाए रखते हुए ऑडियो स्ट्रीम करने और मौखिक प्रतिक्रियाएं प्राप्त करने की अनुमति देता है।
Gemini 3.8 Live परिवार में कम-विलंबता वाली बातचीत और विस्तारित तर्क के लिए अभिप्रेत कॉन्फ़िगरेशन शामिल हैं।
Gemini Live उन डेवलपर्स के लिए प्रासंगिक है जो Google के AI पारिस्थितिकी तंत्र के भीतर काम कर रहे हैं या ऐसे एप्लिकेशन बना रहे हैं जिन्हें रीयल-टाइम मल्टीमॉडल इंटरैक्शन की आवश्यकता होती है। प्रदर्शन, क्षमताएं और मूल्य निर्धारण चयनित मॉडल और कॉन्फ़िगरेशन पर निर्भर करते हैं।
4. कैस्केडेड वॉइस-एजेंट प्लेटफ़ॉर्म (Cascaded voice-agent platforms)
कुछ अनुप्रयोगों को वाक् पहचान, तर्क और वाक् संश्लेषण को अलग-अलग घटकों के रूप में रखने से लाभ होता है।
यह स्वतंत्र रूप से मॉडलों को बदलने, ट्रांसक्रिप्ट का निरीक्षण करने, कस्टम व्यावसायिक तर्क लागू करने, या टेक्स्ट-आधारित नियंत्रण लागू करने में आसान बनाता है।
इसका नुकसान घटकों के बीच अतिरिक्त समन्वय की आवश्यकता है।
कॉन्फ़िगर करने योग्य वॉइस-एजेंट सिस्टम सहित कैस्केडेड आर्किटेक्चर का उपयोग करने वाले प्लेटफ़ॉर्म इसलिए कुछ एंटरप्राइज़ वर्कफ़्लो के लिए बेहतर अनुकूल हो सकते हैं।
परिनियोजन से पहले रीयल-टाइम वॉइस मॉडल का मूल्यांकन कैसे करें
Grok Voice 3.0, Hydra, या किसी अन्य स्पीच-टू-स्पीच API की तुलना करते समय, ऐसे परीक्षण का उपयोग करें जो आपके वास्तविक एप्लिकेशन जैसा दिखता हो।
उदाहरण के लिए, ग्राहक-सहायता मूल्यांकन में एक ऐसा कॉलर शामिल हो सकता है जो पता बदलता है, सहायक को बीच में टोकता है, असंबंधित प्रश्न पूछता है, और फिर मूल कार्य पर वापस लौटता है।
पांच चीजों को मापें:
1. प्रतिक्रिया विलंबता (Response latency): सार्थक उत्तर सुनने से पहले उपयोगकर्ता को कितना समय इंतजार करना पड़ता है?
2. रुकावट प्रबंधन: क्या सहायक बोलना बंद कर देता है और सुधारों पर प्रतिक्रिया देता है?
3. टूल विश्वसनीयता: क्या यह सही जानकारी का उपयोग करके आवश्यक कार्यों को पूरा कर सकता है?
4. संवादात्मक सटीकता: क्या यह कई मोड़ों पर संदर्भ बनाए रखता है?
5. परिचालन लागत: बाहरी सेवाओं सहित एक पूर्ण इंटरैक्शन की लागत क्या है?
प्रत्येक उम्मीदवार मॉडल पर समान परिदृश्य चलाएं।
शोरगुल वाले ऑडियो, लंबे ठहराव, एक साथ बोले जाने वाले भाषण और विफल टूल प्रतिक्रियाओं को शामिल करें।
एक मॉडल जो आदर्श परिस्थितियों में अच्छा प्रदर्शन करता है, वह लाइव एप्लिकेशन में अलग तरह से व्यवहार कर सकता है।
सबसे उपयोगी परिणाम आवश्यक रूप से उच्चतम बेंचमार्क स्कोर नहीं है।
बल्कि वह मॉडल है जो स्वीकार्य विलंबता और लागत बजट के भीतर आपके आवश्यक कार्यों को लगातार पूरा करता है।
अंतिम विचार: क्या Grok Voice 3.0 पर विचार करना उचित है?
Grok Voice 3.0 रीयल-टाइम संवादात्मक AI में एक महत्वपूर्ण कदम का प्रतिनिधित्व करता है।
इसके अक्टूबर 2026 के बेंचमार्क परिणाम मजबूत स्पीच रीज़निंग, कार्य पूर्णता और संवादात्मक गतिशीलता प्रदर्शित करते हैं। यह मॉडल डेवलपर्स को $0.08 प्रति मिनट की प्रकाशित दर पर बहुभाषी समर्थन, फ़ंक्शन कॉलिंग और एक रीयल-टाइम स्पीच-टू-स्पीच API भी प्रदान करता है।
लेकिन एक वॉइस मॉडल चुनने में उच्चतम स्कोरिंग विकल्प का चयन करने से कहीं अधिक शामिल है।
कई डेवलपर्स के लिए, आर्किटेक्चर, रुकावट प्रबंधन, टूलिंग, वास्तविक कार्यभार के तहत लेटेंसी और परिचालन आवश्यकताएं भी उतनी ही मायने रखती हैं।
Smallest.ai Hydra सिंगल WebSocket, मूल रुकावट प्रबंधन और कस्टम टूल समर्थन के साथ रीयल-टाइम स्पीच-टू-स्पीच इंटरैक्शन के लिए एक अन्य दृष्टिकोण प्रदान करता है।
सबसे अच्छा विकल्प आपके द्वारा बनाए जा रहे एप्लिकेशन और आपके द्वारा अपने स्वयं के परीक्षणों में पुनरुत्पादित किए जा सकने वाले प्रदर्शन पर निर्भर करता है।
क्या आप रीयल-टाइम वॉइस एप्लिकेशन बना रहे हैं?
Hydra और Smallest.ai वॉइस AI प्लेटफ़ॉर्म का पता लगाने के लिए Smallest.ai के साथ निर्माण शुरू करें।
एंटरप्राइज़ वर्कफ़्लो के लिए वॉइस AI का मूल्यांकन कर रहे हैं?
अपनी विलंबता, एकीकरण, परिनियोजन और स्केलिंग आवश्यकताओं पर चर्चा करने के लिए Smallest.ai के साथ एक डेमो बुक करें।
अक्सर पूछे जाने वाले प्रश्न
ग्रॉक वॉयस 3.0 (Grok Voice 3.0) क्या है?
Grok Voice 3.0 की कीमत कितनी है?
क्या Grok Voice 3.0 फुल-डुप्लेक्स बातचीत का समर्थन करता है?
Grok Voice 3.0 और Smallest.ai Hydra में क्या अंतर है?
क्या Smallest.ai Hydra प्रोडक्शन वॉयस एप्लिकेशन्स के लिए उपयुक्त है?