वॉइस असिस्टेंट को डिजाइन करना: एसटीटी (STT), एलएलएम (LLM), टीटीएस (TTS), टूल्स और लेटेंसी बजट
एसटीटी, एलएलएम इन्फरेंस, टीटीएस स्ट्रीमिंग, और पूरे पाइपलाइन में लेटेंसी बजट आवंटन की इस तकनीकी गाइड के साथ बेहतर वॉयस असिस्टेंट बनाएं।
अनुमान लगाया गया था कि उपभोक्ता 2024 तक 8.4 बिलियन से अधिक वॉयस असिस्टेंट डिवाइसों के साथ इंटरैक्ट करेंगे, जो यह रेखांकित करता है कि मुख्यधारा के वॉयस इंटरफेस कितने लोकप्रिय हो चुके हैं। अलग से, वैश्विक एआई सहायक सॉफ्टवेयर बाजार का अनुमान 2024 में 8.46 बिलियन अमेरिकी डॉलर लगाया गया था और इसके 2033 तक 35.72 बिलियन अमेरिकी डॉलर तक पहुंचने की उम्मीद है।
फिर भी इंजीनियरिंग का अधिकांश प्रयास जो एक वॉयस असिस्टेंट को स्वाभाविक महसूस कराता है, वह एक संकीर्ण पाइपलाइन में होता है जिसे अधिकांश डेवलपर्स एक ब्लैक बॉक्स की तरह मानते हैं। यह लेख उस पाइपलाइन को खोलकर समझाता है।
चाहे आप ग्राहकों के लिए वॉयस बॉट बना रहे हों, इन-कार असिस्टेंट बना रहे हों, या उद्यम वर्कफ़्लो के लिए रीयल-टाइम एजेंट बना रहे हों, वही तीन घटक आपके उत्पाद की गुणवत्ता को नियंत्रित करते हैं: स्पीच-टू-टेक्स्ट (STT), वैकल्पिक टूल कॉल्स के साथ एक लार्ज लैंग्वेज मॉडल (LLM), और टेक्स्ट-टू-स्पीच (TTS)। आप उन्हें एक साथ कैसे जोड़ते हैं और अपने लेटेंसी बजट को कहाँ आवंटित करते हैं, यह निर्धारित करता है कि आपका वॉयस असिस्टेंट एक बातचीत जैसा लगता है या एक फोन ट्री की तरह। हम प्रत्येक घटक की जांच करेंगे, यह समझाएंगे कि पूरी पाइपलाइन में लेटेंसी को कैसे आवंटित किया जाए, और प्रत्येक चरण में लिए जाने वाले व्यावहारिक निर्णयों की रूपरेखा तैयार करेंगे।
तीन-चरण वाली वॉयस असिस्टेंट पाइपलाइन
जब कोई उपयोगकर्ता वॉयस असिस्टेंट से कुछ कहता है, तो प्रतिक्रिया सुनने से पहले ऑडियो तीन क्रमिक प्रसंस्करण चरणों से होकर गुजरता है। प्रत्येक चरण लेटेंसी जोड़ता है, और प्रत्येक चरण ऐसी त्रुटियों को पेश कर सकता है जो आगे चलकर बढ़ती जाती हैं। किसी एक घटक को अलग से अनुकूलित करने की तुलना में पूरी पाइपलाइन को समग्र रूप से समझना अधिक उपयोगी है।
पहला चरण STT है: रॉ ऑडियो को टेक्स्ट में ट्रांसक्राइब किया जाता है। दूसरा चरण LLM इन्फरेंस है: टेक्स्ट को एक भाषा मॉडल द्वारा संसाधित किया जाता है जो प्रतिक्रिया उत्पन्न करता है, कभी-कभी बाहरी टूल या एपीआई को कॉल करने के बाद। तीसरा चरण TTS है: टेक्स्ट प्रतिक्रिया को वापस ऑडियो में परिवर्तित किया जाता है और उपयोगकर्ता को स्ट्रीम किया जाता है। भाषण समाप्त होने से लेकर पहले ऑडियो बाइट तक का कुल राउंड-ट्रिप समय वह है जिसे अधिकांश टीमें 'टाइम टू फर्स्ट ऑडियो' (TTFA) कहती हैं, और संवादात्मक अनुभव के लिए यह सबसे महत्वपूर्ण लेटेंसी मीट्रिक है। शोध लगातार दिखाते हैं कि मनुष्य बातचीत में 300-500ms से अधिक की देरी को अस्वाभाविक मानते हैं।
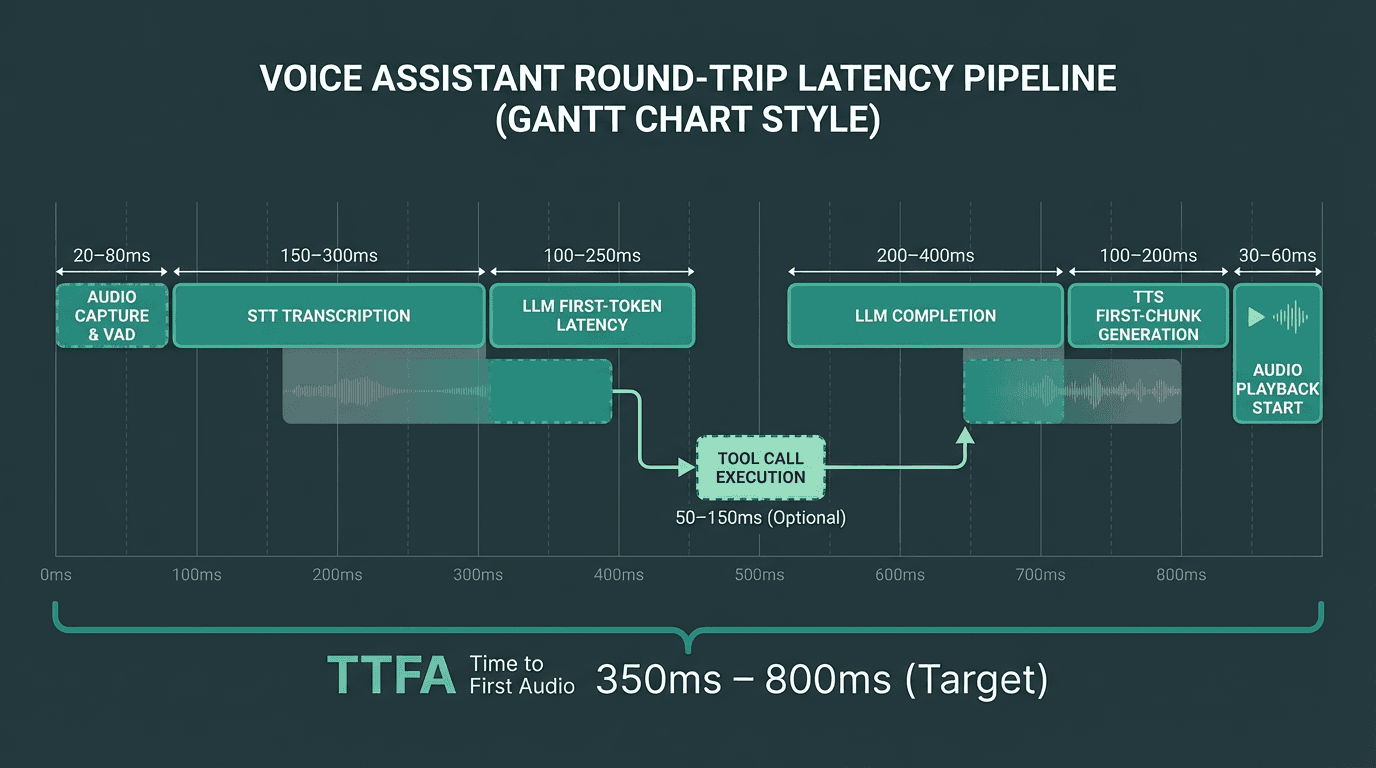
इस टाइमलाइन का हर मिलीसेकंड एक डिज़ाइन निर्णय है। चरणों के बीच स्ट्रीमिंग ओवरलैप से ही सबसे बड़ा लाभ मिलता है।
स्पीच-टू-टेक्स्ट: आपकी पाइपलाइन का मुख्य द्वार
STT गुणवत्ता बाद के सभी चरणों की सीमा तय करती है। 5-8% से अधिक शब्द त्रुटि दर (WER) वाला ट्रांसक्रिप्ट एक अच्छे प्रॉम्प्ट वाले LLM को भी भ्रमित कर देगा, और कोई भी प्रॉम्प्ट इंजीनियरिंग खराब ट्रांसक्रिप्शन को ठीक नहीं कर सकती है। वर्तमान विकल्पों की विस्तृत तुलना के लिए, 2026 में सटीकता, लेटेंसी और रीयल-टाइम प्रदर्शन को कवर करने वाली सर्वश्रेष्ठ स्पीच-टू-टेक्स्ट एआई की यह मार्गदर्शिका देखें।
STT लेयर पर सबसे अधिक मायने रखने वाले दो आर्किटेक्चरल विकल्प स्ट्रीमिंग बनाम बैच ट्रांसक्रिप्शन, और एंडपॉइंट डिटेक्शन हैं। स्ट्रीमिंग STT उपयोगकर्ता के बोलना समाप्त करने से पहले ही LLM को आंशिक ट्रांसक्रिप्ट भेज देता है, जिससे TTFA में से 200-400ms की बचत हो सकती है। एंडपॉइंट डिटेक्शन (जिसे वॉयस एक्टिविटी डिटेक्शन या VAD भी कहा जाता है) यह निर्धारित करता है कि उपयोगकर्ता ने बोलना कब बंद कर दिया है और LLM कॉल को ट्रिगर करता है। आक्रामक VAD लेटेंसी को कम करता है लेकिन इसके कारण असिस्टेंट उपयोगकर्ताओं को वाक्य के बीच में ही बाधित कर देता है। रूढ़िवादी VAD सुस्त महसूस होता है। अधिकांश प्रोडक्शन सिस्टम उपयोग के मामले के आधार पर VAD साइलेंस थ्रेशोल्ड को 300ms और 600ms के बीच ट्यून करते हैं।
एक चीज़ जिसे टीमें अक्सर कम आंकती हैं, वह है ध्वनिक वातावरण (acoustic environment)। एक मॉडल जो शांत स्टूडियो में 95% सटीकता प्राप्त करता है, वह पृष्ठभूमि के शोर वाले कॉल सेंटर में गिरकर 85% तक आ सकता है। अपने STT विकल्प को हमेशा अपने वास्तविक परिनियोजन वातावरण के ऑडियो नमूनों के साथ बेंचमार्क करें, न कि साफ स्टूडियो रिकॉर्डिंग्स के साथ।
LLM इन्फरेंस और टूल कॉल्स: जहाँ बुद्धिमत्ता बसती है
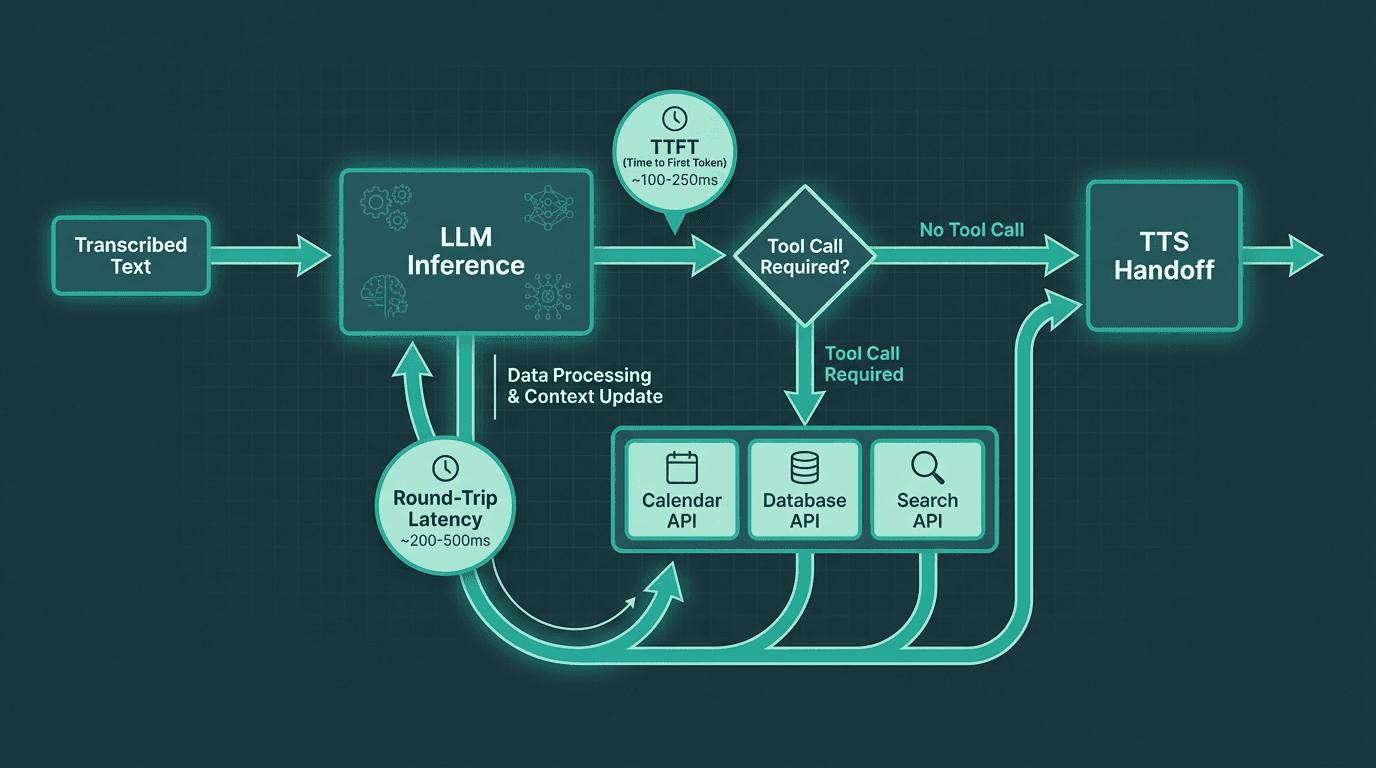
टूल कॉल्स LLM चरण के भीतर एक दूसरा राउंड-ट्रिप जोड़ते हैं। लेटेंसी के लिए अनावश्यक टूल कॉल्स को कम करना महत्वपूर्ण है।
LLM चरण वह जगह है जहाँ अधिकांश लेटेंसी बजट समाप्त हो जाता है, और जहाँ अधिकांश आर्किटेक्चरल गलतियाँ होती हैं। ट्रैक करने के लिए दो अलग-अलग लेटेंसी नंबर हैं: टाइम टू फर्स्ट टोकन (TTFT) और कुल जनरेशन समय। वॉयस के लिए, TTFT सबसे अधिक मायने रखता है क्योंकि पहला वाक्य पूरा होते ही TTS ऑडियो स्ट्रीमिंग शुरू कर सकता है। यदि आपका LLM अपना पहला टोकन बनाने में 800ms लेता है, तो वह देरी उपयोगकर्ता को पूरी तरह से दिखाई देगी, भले ही आपका TTS कितना भी तेज़ क्यों न हो।
टूल कॉल्स एक दूसरा राउंड-ट्रिप शुरू करते हैं। जब LLM यह निर्णय लेता है कि उसे एक बाहरी API को कॉल करने की आवश्यकता है (इन्वेंट्री की जांच करना, कैलेंडर देखना, डेटाबेस से पूछताछ करना), तो वह कॉल वापस आने तक पाइपलाइन रुक जाती है। वॉयस के संदर्भ में, प्रत्येक टूल कॉल जो 200ms+ की लेटेंसी जोड़ती है, उसका उचित कारण होना आवश्यक है। इसे कम करने की सामान्य रणनीतियों में बातचीत शुरू होने से पहले संभावित संदर्भ को प्री-फेच करना, बार-बार आने वाले टूल परिणामों को कैश करना और हर प्रश्न को एक बड़े सामान्य-उद्देश्यीय मॉडल में भेजने के बजाय टूल राउटिंग के लिए छोटे विशेष मॉडलों का उपयोग करना शामिल है।
वॉयस LLM के लिए प्रॉम्प्ट डिज़ाइन भी चैट से अलग होता है। वॉयस प्रतिक्रियाएं छोटी, अधिक प्रत्यक्ष और संरचित होनी चाहिए ताकि पहला वाक्य एक पूर्ण, बोलने योग्य इकाई हो। 'बिल्कुल! यहाँ ध्यान देने योग्य पाँच बातें हैं...' से शुरू होने वाली प्रतिक्रिया वॉयस के लिए खराब है क्योंकि TTS को बोलना शुरू करने से पहले एक प्राकृतिक वाक्य सीमा की प्रतीक्षा करनी पड़ती है। अपने प्रॉम्प्ट को उत्तर को पहले रखने (front-load) के लिए प्रशिक्षित करें।
टेक्स्ट-टू-स्पीच: वह आवाज़ जो आपके उपयोगकर्ता वास्तव में सुनते हैं
टेक्स्ट-टू-स्पीच तकनीक कुछ ही वर्षों में रोबोटिक कॉनकैटेनेटिव सिंथेसिस से न्यूरल वेवफॉर्म जनरेशन की ओर बढ़ गई है। जो शुरू में एक सहायक तकनीक थी, वह अब करोड़ों दैनिक इंटरैक्शन के लिए प्राथमिक इंटरफ़ेस लेयर है। गुणवत्ता का स्तर तदनुसार बढ़ गया है: उपयोगकर्ता अब अप्राकृतिक लहजे, अजीब ठहराव और गलत जगह पर दिए गए जोर को उन तरीकों से पकड़ लेते हैं जो वे पांच साल पहले नहीं कर पाते थे।
वॉयस असिस्टेंट के लिए, महत्वपूर्ण TTS मीट्रिक अलग से ऑडियो गुणवत्ता नहीं है, बल्कि टाइम टू फर्स्ट ऑडियो चंक (time to first audio chunk) है। स्ट्रीमिंग TTS सिस्टम पूरी प्रतिक्रिया टेक्स्ट उपलब्ध होने से पहले ही ऑडियो उत्पन्न करना शुरू कर देते हैं, जिसमें वाक्य-स्तर या खंड-स्तर की चंकिंग का उपयोग किया जाता है। इसका मतलब है कि TTS इंजन को 'आपकी नियुक्ति गुरुवार को दोपहर 3 बजे के लिए पक्की हो गई है।' प्राप्त होता है और वह तुरंत सिंथेसिस शुरू कर देता है जबकि LLM अभी भी बाकी प्रतिक्रिया उत्पन्न कर रहा होता है। इसका व्यावहारिक परिणाम यह होता है कि उपयोगकर्ता बैच TTS की तुलना में 300-600ms पहले प्रतिक्रिया सुनना शुरू कर देते हैं।
आवाज़ का चयन और निरंतरता अधिकांश टीमों की उम्मीद से अधिक मायने रखती है। उपयोगकर्ता कुछ ही इंटरैक्शन के भीतर आवाज़ और ब्रांड के बीच एक मजबूत संबंध बना लेते हैं। सत्रों के बीच आवाज़ें बदलना, या ऐसी आवाज़ का उपयोग करना जो ब्रांड के टोन से मेल नहीं खाती, मानसिक उलझन पैदा करता है। उपलब्ध विकल्पों पर व्यापक नज़र डालने के लिए, वॉयस एजेंटों के लिए सबसे तेज़ TTS विकल्प का परिदृश्य काफी विस्तारित हुआ है, जिसमें प्रदाता स्वाभाविकता, लेटेंसी और अनुकूलन के बीच विभिन्न समझौते पेश कर रहे हैं।
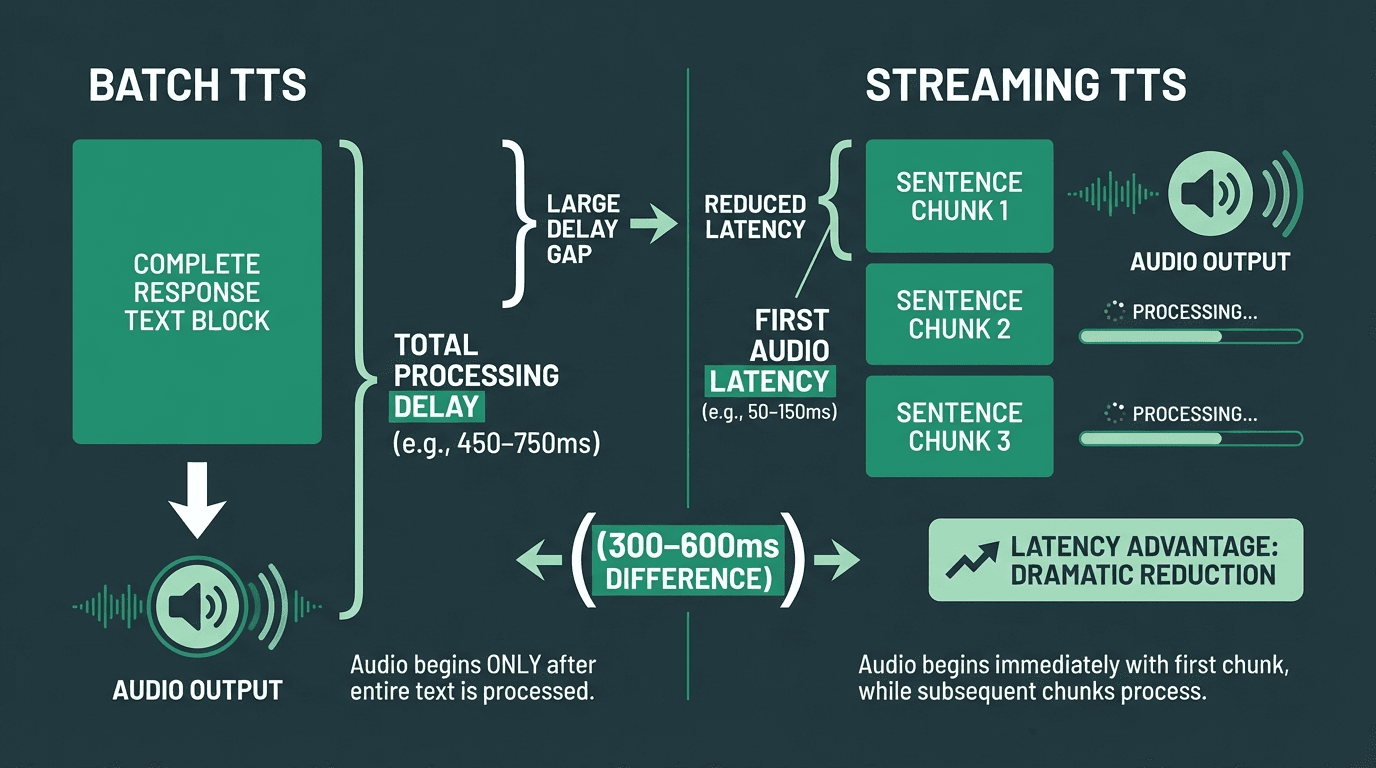
बैच सिंथेसिस की तुलना में स्ट्रीमिंग TTS कथित प्रतिक्रिया लेटेंसी को 300-600ms तक कम कर सकता है।
अपना लेटेंसी बजट बनाना
लेटेंसी बजट पाइपलाइन चरणों में समय का एक जानबूझकर किया गया आवंटन है, न कि बाद में किया जाने वाला माप। आप एक लक्षित TTFA सेट करते हैं (मान लें, फोन-आधारित असिस्टेंट के लिए 800ms), फिर यह निर्धारित करने के लिए पीछे की ओर काम करते हैं कि प्रत्येक चरण को कितना समय लेने की अनुमति है। यह प्रोडक्शन में लेटेंसी समस्याओं का पता लगाने के बजाय शुरू में ही आर्किटेक्चरल निर्णय लेने पर मजबूर करता है।
2026 में एक अच्छी तरह से अनुकूलित वॉयस असिस्टेंट के लिए एक व्यावहारिक बजट इस तरह दिख सकता है: VAD और ऑडियो कैप्चर (50ms), STT ट्रांसक्रिप्शन (150ms), LLM TTFT (400ms), TTS पहला चंक (150ms), नेटवर्क ओवरहेड (50ms)। यह कुल 800ms होता है। ध्यान दें कि LLM को सबसे बड़ा आवंटन मिलता है क्योंकि प्रतिक्रिया की गुणवत्ता का त्याग किए बिना इसे संपीड़ित करना सबसे कठिन होता है। यदि आपके LLM प्रदाता का TTFT लगातार 500ms से ऊपर है, तो आपको या तो एक तेज़ मॉडल की आवश्यकता है या भेजे जा रहे संदर्भ विंडो (context window) को कम करने की आवश्यकता है। संदर्भ के लिए, Smallest.ai का Lightning TTS 100ms से कम समय में पहला ऑडियो चंक प्रदान करता है, जिसका अर्थ है कि इसका उपयोग करने वाली टीमों के पास ऊपर दिए गए TTS आवंटन में 50ms का अतिरिक्त हेडरूम होता है। विशिष्ट अनुकूलन तकनीकों सहित वॉयस एआई में लेटेंसी की समस्या के गहन अध्ययन के लिए, वह संसाधन काफी गहराई में जाता है।
जब टूल कॉल्स शामिल होते हैं तो बजट काफी बदल जाता है। एक अकेला टूल कॉल जो 300ms लेता है, वह TTFA को 1100ms या उससे अधिक तक धकेल देता है। टूल-हैवी एजेंट बनाने वाली टीमें अक्सर टूल-कॉल टर्न के लिए अधिक लेटेंसी स्वीकार करती हैं और प्रतीक्षा के दौरान बातचीत के अनुभव को बनाए रखने के लिए फिलर ऑडियो ('मुझे आपके लिए इसकी जांच करने दीजिए...') का उपयोग करती हैं। यह इंजीनियरिंग जितना ही एक UX निर्णय भी है, और उपयोगकर्ता का विश्वास बनाए रखने में कम-लेटेंसी का महत्व को कम करके नहीं आंका जा सकता।
स्ट्रीमिंग आर्किटेक्चर: गैर-परक्राम्य डिज़ाइन पैटर्न
पाइपलाइन के हर घटक को स्ट्रीम करना चाहिए। STT को आंशिक ट्रांसक्रिप्ट उत्सर्जित करने चाहिए। LLM को टोकन स्ट्रीम करने चाहिए। TTS को आंशिक टेक्स्ट पर सिंथेसिस शुरू करना चाहिए। प्रत्येक चरण में स्ट्रीमिंग के बिना, लेटेंसीज आपस में जुड़कर बढ़ जाती हैं। स्ट्रीमिंग के साथ, चरण आपस में ओवरलैप हो सकते हैं, और उपयोगकर्ता तब भी ऑडियो सुनना शुरू कर देता है जब LLM अभी प्रतिक्रिया का अंतिम हिस्सा उत्पन्न कर रहा होता है।
व्यावहारिक चुनौती यह है कि स्ट्रीमिंग के लिए सावधानीपूर्वक स्टेट मैनेजमेंट (state management) की आवश्यकता होती है। अधिक ऑडियो आने पर आंशिक STT ट्रांसक्रिप्ट बदल सकते हैं (एक घटना जिसे 'ट्रांसक्रिप्ट अस्थिरता' कहा जाता है), जिसका अर्थ है कि आप LLM को बहुत जल्दी ट्रिगर नहीं कर सकते अन्यथा आप एक अधूरा या गलत प्रॉम्प्ट भेजने का जोखिम उठाते हैं। अधिकांश प्रोडक्शन सिस्टम LLM को ट्रिगर करने से पहले आंशिक ट्रांसक्रिप्ट पर एक आत्मविश्वास सीमा (confidence threshold) का उपयोग करते हैं, या वे एक छोटे साइलेंस विंडो की प्रतीक्षा करते हैं। इस डिज़ाइन पैटर्न के विस्तृत अध्ययन के लिए, रीयल-टाइम एजेंटों के लिए स्ट्रीमिंग आर्किटेक्चर कार्यान्वयन संबंधी विचारों को पूरी तरह से कवर करता है।
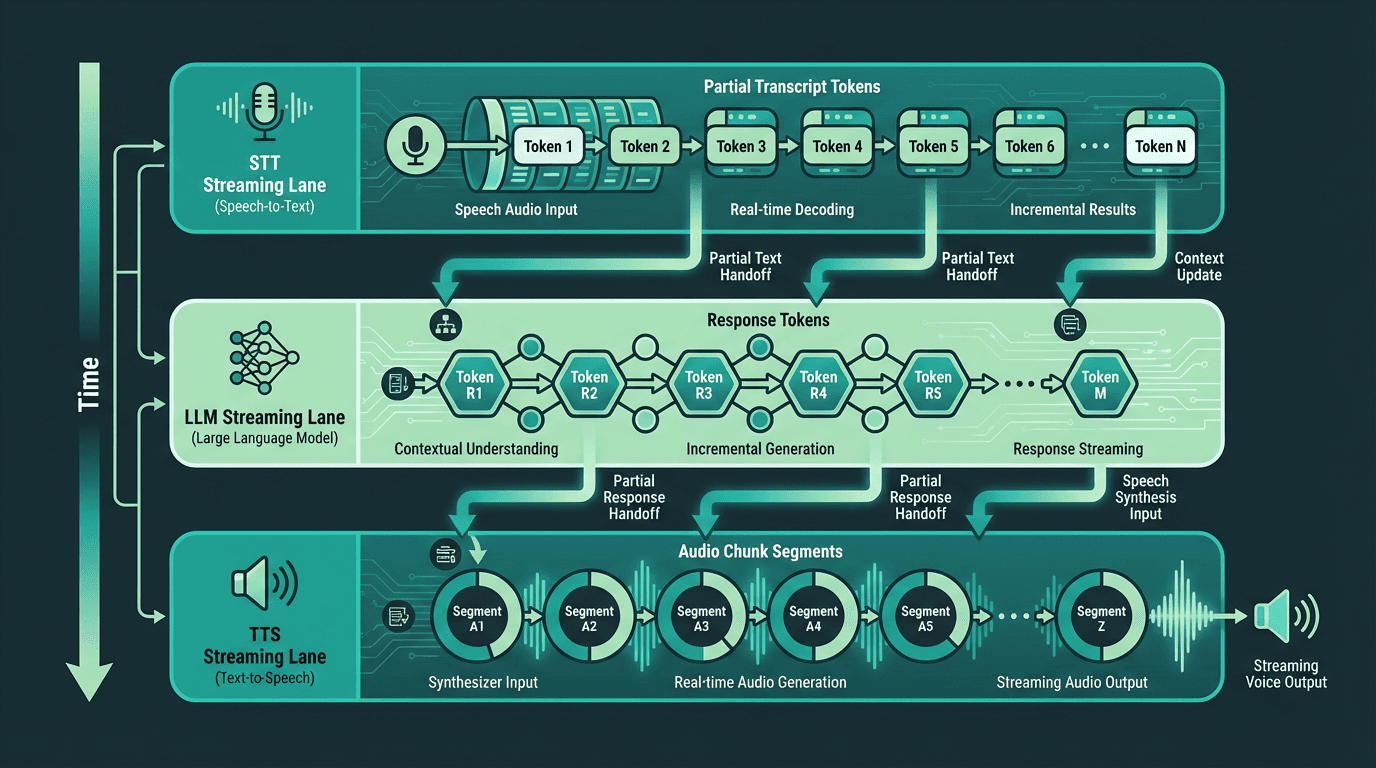
पूरी तरह से स्ट्रीमिंग पाइपलाइन में, तीनों चरण एक साथ चलते हैं, जिससे पहले ऑडियो तक का समय नाटकीय रूप से कम हो जाता है।
उन्नत विचार: व्यवधान संभालना, संदर्भ प्रबंधन और विशेष मामले
अधिकांश गाइड केवल आसान और सफल मार्ग तक ही सीमित रहते हैं। यहाँ वह दिया गया है जिसे वे अक्सर छोड़ देते हैं।
व्यवधान संभालना (जिसे बार्ज-इन भी कहा जाता है) उपयोगकर्ता की तब बोलने की क्षमता है जब असिस्टेंट बात कर रहा हो, जिससे असिस्टेंट रुक जाता है और नए इनपुट को प्रोसेस करता है। यह सुनने में सरल लगता है लेकिन इसके लिए इन-फ़्लाइट TTS सिंथेसिस को रद्द करने, ऑडियो बफर को फ्लश करने और नए उच्चारण को खोए बिना STT पाइपलाइन को पुनरारंभ करने की आवश्यकता होती है। जो सिस्टम बार्ज-इन को खराब तरीके से संभालते हैं, वे या तो उपयोगकर्ता के भाषण को काट देते हैं या नए इनपुट पर पुरानी प्रतिक्रिया बजाना जारी रखते हैं। दोनों ही खराब अनुभव देते हैं। इसके कार्यान्वयन के लिए ऑडियो प्लेबैक लेयर और VAD सिस्टम के बीच कड़े जुड़ाव की आवश्यकता होती है, एक ऐसा पैटर्न जिसे Atoms SDK आर्किटेक्चर गाइड में कवर किया गया है।
लॉन्ग कन्वर्सेशन में संदर्भ विंडो प्रबंधन (context window management) एक वास्तविक इंजीनियरिंग समस्या बन जाता है। हर टर्न संदर्भ में टोकन जोड़ता है, और LLM इन्फरेंस लागत और लेटेंसी दोनों संदर्भ की लंबाई के साथ बढ़ते हैं। प्रोडक्शन सिस्टम आमतौर पर तीन रणनीतियों में से एक का उपयोग करते हैं: स्लाइडिंग विंडो (सबसे पुराने टर्न को छोड़ना), संक्षेपण (पुराने टर्न को सारांश में संपीड़ित करना), या रिट्रीवल-ऑगमेंटेड कॉन्टेक्स्ट (टर्न को वेक्टर स्टोर में संग्रहीत करना और प्रति टर्न प्रासंगिक टर्न को पुनर्प्राप्त करना)। सही चुनाव आपके उपयोग के मामले की बातचीत की लंबाई के वितरण पर निर्भर करता है।
बहुभाषी समर्थन जटिलता की एक और परत जोड़ता है। STT मॉडलों की सटीकता विभिन्न भाषाओं में काफी भिन्न होती है, और कई TTS प्रदाता अंग्रेजी में उच्च गुणवत्ता वाली आवाजें प्रदान करते हैं लेकिन अन्य भाषाओं में गुणवत्ता स्पष्ट रूप से कम हो जाती है। यदि आप वैश्विक बाजारों के लिए निर्माण कर रहे हैं, तो प्रत्येक भाषा का स्वतंत्र रूप से बेंचमार्क करें। वॉयस सर्च और वॉयस-असिस्टेड इंटरैक्शन अब कई बाजारों में मुख्यधारा बन चुके हैं, जो बहुभाषी बेंचमार्किंग को एक अच्छी सुविधा के बजाय एक व्यावहारिक आवश्यकता बनाते हैं। हर जगह केवल अंग्रेजी जैसी गुणवत्ता मान लेना एक उत्पाद संबंधी गलती है। Smallest.ai के मॉडल 30 से अधिक भाषाओं में प्रोडक्शन-ग्रेड प्रदर्शन के लिए डिज़ाइन किए गए हैं।
सब कुछ एक साथ जोड़ना: व्यावहारिक आर्किटेक्चर निर्णय
प्रोटोटाइप से प्रोडक्शन की ओर बढ़ने वाली टीमों के लिए, वॉयस बॉट आर्किटेक्चर में महारत हासिल करना संसाधन Smallest.ai के Atoms SDK का उपयोग करके एक ठोस कार्यान्वयन का मार्गदर्शन करता है। व्यापक व्यावसायिक संदर्भ के लिए, एंटरप्राइज़ वॉयस एआई असिस्टेंट गाइड परिनियोजन पैटर्न, अनुपालन संबंधी विचारों और स्केलिंग रणनीतियों को कवर करता है।
निर्माण शुरू करने से पहले तय किए जाने वाले प्रमुख आर्किटेक्चरल निर्णय:
प्रत्येक चरण में स्ट्रीमिंग बनाम बैच: हर जगह स्ट्रीमिंग को डिफॉल्ट रखें, बैच का उपयोग केवल वहीं करें जहाँ सटीकता के लिए आवश्यक हो
VAD संवेदनशीलता: अपने लक्षित वातावरण से वास्तविक उपयोगकर्ता ऑडियो के खिलाफ साइलेंस थ्रेशोल्ड को ट्यून करें
LLM मॉडल का आकार बनाम लेटेंसी: अच्छे प्रॉम्प्ट वाले छोटे मॉडल अक्सर TTFA पर बड़े मॉडलों से बेहतर प्रदर्शन करते हैं
टूल कॉल रणनीति: जहाँ भी संभव हो टूल कॉल्स को प्री-फेच, कैश या समानांतर करें
TTS चंकिंग ग्रैन्युलैरिटी: वाक्य-स्तरीय चंकिंग लेटेंसी और लहजे की गुणवत्ता को संतुलित करती है
बार्ज-इन समर्थन: शुरुआत में ही निर्णय लें, क्योंकि यह पूरी ऑडियो प्रबंधन लेयर को प्रभावित करता है
संदर्भ प्रबंधन: बातचीत लंबी होकर समस्या पैदा करने से पहले ही एक रणनीति चुन लें
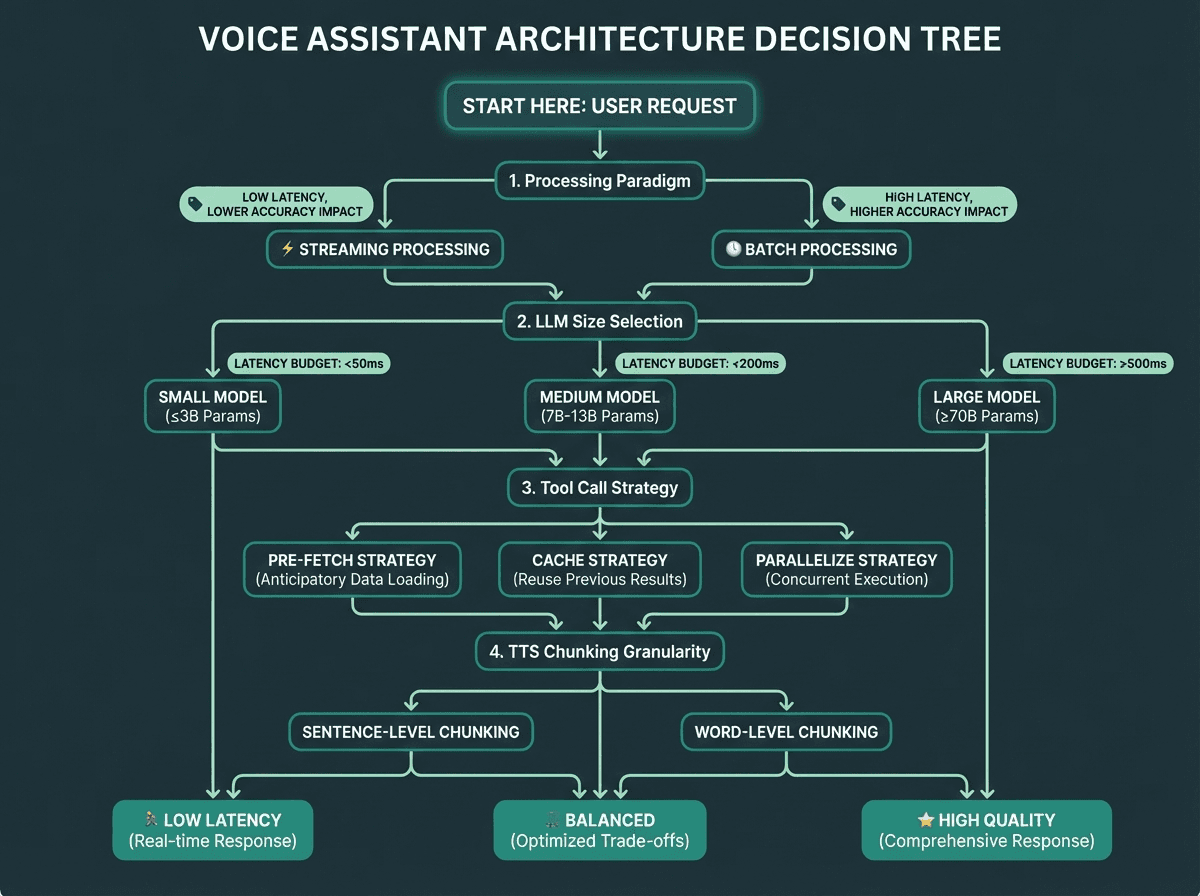
उत्पादन कोड लिखने से पहले अपने मूल आर्किटेक्चरल विकल्पों को लॉक करने के लिए इस निर्णय ट्री का उपयोग करें।
आपके वॉयस असिस्टेंट आर्किटेक्चर में लेटेंसी का समाधान
एक वॉयस असिस्टेंट केवल अपने सबसे धीमे चरण जितना ही अच्छा होता है। पाइपलाइन STT से LLM से TTS है, और प्रत्येक डिज़ाइन निर्णय उपयोगकर्ता के कथित प्रतीक्षा समय से मिलीसेकंड जोड़ता या घटाता है। हर चरण में स्ट्रीमिंग करना सबसे अधिक प्रभाव डालने वाला आर्किटेक्चरल विकल्प है जो आप चुन सकते हैं। आपका लेटेंसी बजट घटकों को चुनने से पहले निर्धारित किया जाना चाहिए, बाद में नहीं। और विशेष मामले (व्यवधान संभालना, संदर्भ प्रबंधन, बहुभाषी समर्थन) वे क्षेत्र हैं जहाँ प्रोडक्शन सिस्टम वास्तव में विफल होते हैं, इसलिए शुरू से ही उनके लिए योजना बनाएं।
वॉयस असिस्टेंट का क्षेत्र तेजी से आगे बढ़ रहा है, और सर्वश्रेष्ठ रीयल-टाइम सिस्टम की गुणवत्ता के साथ-साथ उपयोगकर्ताओं की उम्मीदें भी बढ़ रही हैं। पाइपलाइन को सही ढंग से तैयार करना पहला महत्वपूर्ण कदम है। आर्किटेक्चर थ्योरी और प्रोडक्शन कार्यान्वयन के बीच की दूरी काफी कम हो जाती है जब अंतर्निहित प्लेटफॉर्म को उसी स्ट्रीमिंग-फर्स्ट, लेटेंसी-मिनिमाइजिंग सिद्धांतों के आसपास बनाया जाता है जिसे यह लेख वर्णित करता है। Smallest.ai के Pulse STT, Lightning TTS, और Atoms SDK में से प्रत्येक को यहाँ उल्लिखित लेटेंसी लक्ष्यों को प्राप्त करने या उससे बेहतर करने के लिए डिज़ाइन किया गया है। यहाँ कवर किए गए विषयों के बारे में अधिक जानने के लिए, स्पीच एआई, रीयल-टाइम एजेंटों और डेवलपर टूल के निरंतर कवरेज के लिए हमारे ब्लॉग पर जाएं।
अक्सर पूछे जाने वाले प्रश्न
एक वॉयस असिस्टेंट के लिए पहला ऑडियो आने का आदर्श समय (TTFA) क्या है?
VAD (वॉयस एक्टिविटी डिटेक्शन) वॉयस असिस्टेंट की गुणवत्ता को कैसे प्रभावित करता है?
क्या मैं वास्तविक समय (रीयल-टाइम) के वॉयस असिस्टेंट में GPT-4 जैसे बड़े LLM का उपयोग कर सकता हूँ?
वॉइस असिस्टेंस के लिए स्ट्रीमिंग टीटीएस (TTS) और बैच टीटीएस (TTS) में क्या अंतर है?
लेटेंसी (विलंबता) को प्रभावित किए बिना मुझे एक वॉयस असिस्टेंट में टूल कॉल्स को कैसे संभालना चाहिए?