एक रियल-टाइम वॉयस एजेंट कैसे बनाएं

5 चरणों में रियल-टाइम वॉयस एजेंट बनाएं: Pulse और Lightning के साथ Smallest.ai Waves API का उपयोग करके लगभग 600ms TTFA प्राप्त करने के लिए STT, LLM टोकन और TTS ऑडियो स्ट्रीम करें।
एक रियल-टाइम वॉइस एजेंट बनाना अब सिर्फ "मजेदार प्रोटोटाइप" के चरण से काफी आगे निकल चुका है। 2025 और 2026 में, ये सिस्टम ग्राहक सहायता, स्वास्थ्य सेवा इनटेक, ई-कॉमर्स और लॉजिस्टिक्स में वास्तविक प्रोडक्शन ट्रैफ़िक संभाल रहे हैं। टूलिंग उन्नत हो चुकी है, APIs तेज़ हैं, और "पर्याप्त अच्छा" होने का मतलब अब केवल उत्तर देना भर नहीं है: प्राकृतिक बातचीत के प्रवाह को बनाए रखने के लिए इसे पर्याप्त रूप से तेज़ प्रतिक्रिया देनी होगी, जहां कई प्रोडक्शन सिस्टम सब-सेकंड एंड-टू-एंड रिस्पॉन्स टाइम का लक्ष्य रखते हैं और बिना अटके बीच में टोके जाने (इंटरप्शन्स) को संभालते हैं। यह ट्यूटोरियल उन डेवलपर्स के लिए है जो एक काम करने वाला रियल-टाइम वॉइस एजेंट शिप करना चाहते हैं, न कि ऐसा डेमो जो केवल आदर्श परिस्थितियों में ही काम करता हो।
पाँच चरण आपको एक पूर्ण, कार्यात्मक लूप तक ले जाते हैं: माइक्रोफ़ोन ऑडियो स्पीच-टू-टेक्स्ट में स्ट्रीम होता है, अंतिम ट्रांसक्रिप्ट भाषा मॉडल (LLM) में जाते हैं, और न्यूनतम विलंब के साथ प्रतिक्रिया सिंथेसाइज्ड स्पीच के रूप में वापस आती है। यहाँ सटीक निर्माण क्रम दिया गया है:
अपना प्रोजेक्ट परिवेश सेट करें
Pulse (STT) के साथ ऑडियो इनपुट कैप्चर और स्ट्रीम करें
ट्रांसक्रिप्ट को भाषा मॉडल से कनेक्ट करें
Lightning (TTS) के साथ LLM प्रतिक्रिया को वाक् (स्पीच) में बदलें
इंटरप्ट हैंडलिंग और टर्न-टेकिंग के साथ लूप को पूरा करें
शुरू करने से पहले आपको क्या चाहिए
कोड को छूने से पहले, बुनियादी चीज़ों को व्यवस्थित कर लें। टूलिंग: Python 3.9+, एक कोड एडिटर, और काम करने वाले माइक्रोफ़ोन के साथ एक टेस्ट सेटअप। आपको Lightning (TTS), Pulse (STT), और Electron के लिए Smallest.ai के Waves प्लेटफ़ॉर्म तक API एक्सेस की भी आवश्यकता होगी, साथ ही यदि आप किसी बाहरी भाषा मॉडल का उपयोग करना पसंद करते हैं तो कोई भी संगत LLM एंडपॉइंट। अपेक्षित ज्ञान: एसिंक Python, REST कॉल्स करना, और ऑडियो स्ट्रीम के साथ सामान्य सहजता। आपको DSP के गहन ज्ञान की आवश्यकता नहीं है, लेकिन एक व्यावहारिक विवरण को समझना मददगार होगा: ऑडियो बाइट्स की एक सतत स्ट्रीम के रूप में आता है, न कि साफ-सुथरी छोटी फ़ाइलों के रूप में। शुरुआत से ही इसे एक स्ट्रीम की तरह समझें, और आप बाद में "यह इतना धीमा क्यों है?" जैसी निराशाजनक डिबगिंग से बचेंगे।
एक रियल-टाइम वॉइस एजेंट वास्तव में कैसे काम करता है
लूप हमेशा एक जैसा होता है: स्पीच-टू-टेक्स्ट (STT) उपयोगकर्ता की आवाज़ को टेक्स्ट में बदलता है, एक भाषा मॉडल उस टेक्स्ट से प्रतिक्रिया उत्पन्न करता है, और टेक्स्ट-टू-स्पीच (TTS) प्रतिक्रिया को वापस ऑडियो में बदल देता है। कठिन हिस्सा यह है कि विलंबता (लेटेंसी) बहुत तेज़ी से बढ़ती है। यदि STT को 200ms की आवश्यकता है, LLM को पहला टोकन उत्पन्न करने में 400ms लगते हैं, और TTS को पहला ऑडियो उत्पन्न करने में 300ms लगते हैं, तो नेटवर्क राउंड ट्रिप्स को गिने बिना ही आप एक सेकंड के टाइम-टू-फर्स्ट-ऑडियो (TTFA) के करीब पहुंच जाते हैं।
व्यावहारिक समाधान यह है कि हर चीज़ को स्ट्रीमिंग-फर्स्ट बनाया जाए। पूरी रिकॉर्डिंग की प्रतीक्षा करने के बजाय ऑडियो को STT में स्ट्रीम करें। पूरी प्रतिक्रिया की प्रतीक्षा करने के बजाय LLM से टोकन उत्पन्न होते ही उन्हें स्ट्रीम करें। फिर उन टोकन्स को अंत तक पूरा उत्तर रोक कर रखने के बजाय वाक्य-आकार के टुकड़ों (chunks) में TTS में भेजें। यह वही आर्किटेक्चर है जिसका वर्णन स्ट्रीमिंग-फर्स्ट वॉइस एजेंट डिज़ाइन में किया गया है। Smallest.ai के घटक इस पर सटीक बैठते हैं: Pulse स्ट्रीमिंग STT को संभालता है, Electron LLM लेयर को कवर करता है, और Lightning (Waves API के माध्यम से) लो-लेटेंसी TTS को संभालता है।
चरण 1: अपना प्रोजेक्ट परिवेश सेट करें
एक साफ़ वर्चुअल एनवायरनमेंट से शुरुआत करें और ऑडियो इनपुट, WebSockets, HTTP स्ट्रीमिंग, और एनवायरनमेंट कॉन्फ़िगरेशन के लिए आवश्यक निर्भरताएँ (dependencies) इंस्टॉल करें। अपने टर्मिनल से, चलाएँ:
python -m venv venv
source venv/bin/activate
# Windows: venv\Scripts\activate
pip install pyaudio websockets httpx python-dotenv smallest-sdk
इसके बाद, अपने प्रोजेक्ट रूट में एक .env फ़ाइल बनाएँ और अपनी Waves API कुंजी जोड़ें:
WAVES_API_KEY=your_key_here
अपनी सोर्स फ़ाइलों के अंदर सीधे API कुंजियों को हार्डकोड न करें। python-dotenv का उपयोग करके उन्हें रनटाइम पर लोड करें। यह क्रेडेंशियल्स को वर्शन कंट्रोल से बाहर रखता है और बाद में कुंजी बदलना बहुत आसान बनाता है।
चरण 2: Pulse के साथ ऑडियो इनपुट कैप्चर और स्ट्रीम करें
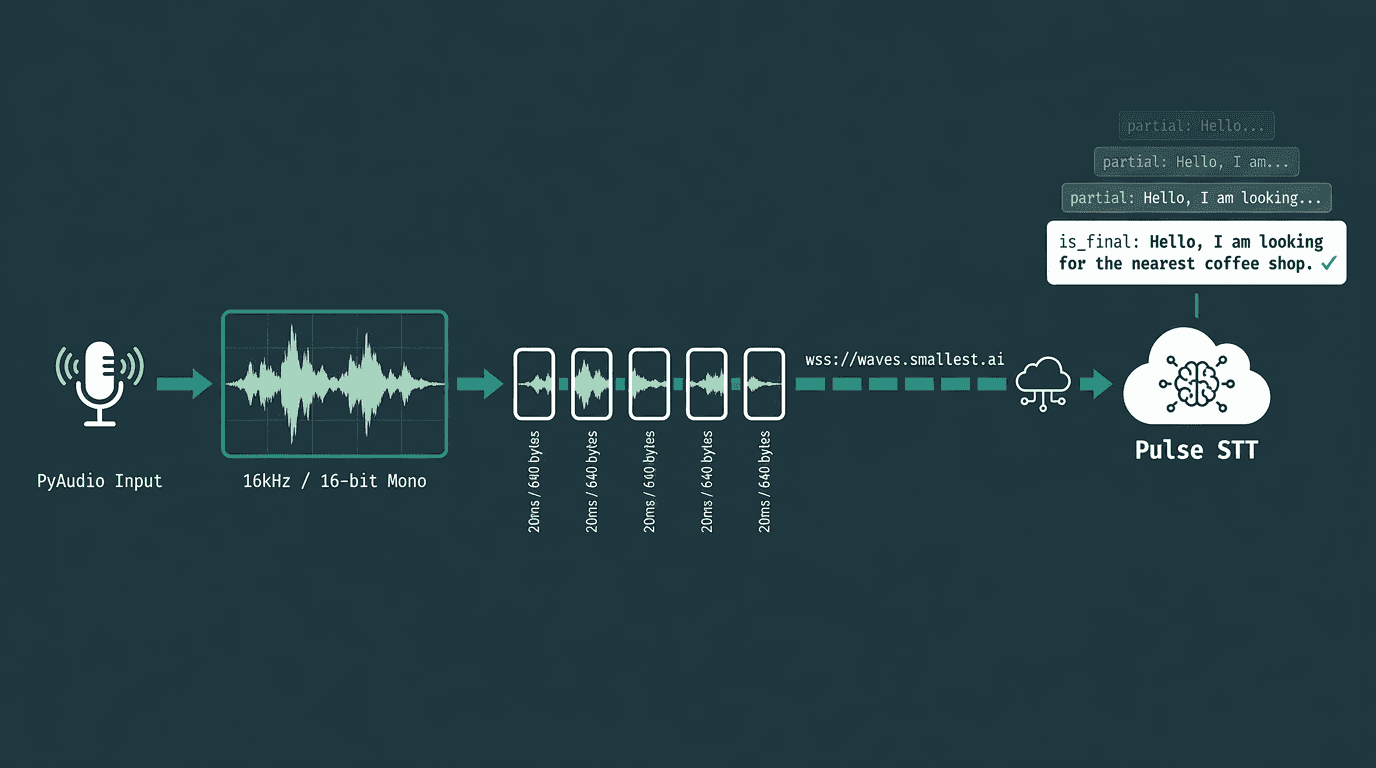
WebSocket पर 20ms ऑडियो फ्रेम्स: सही चंकिंग साइज़ बफ़रिंग विलंब को न्यूनतम रखता है
माइक्रोफ़ोन स्ट्रीम खोलने के लिए PyAudio का उपयोग करें, फिर आने वाले ऑडियो को 20ms के फ़्रेमों में काटें। 16kHz, 16-बिट मोनो पर, यह प्रति फ्रेम 640 बाइट्स बनता है। यह आकार जानबूझकर चुना गया है: इससे छोटा करने पर आप अधिक WebSocket ओवरहेड वहन करेंगे; इससे बड़ा करने पर STT द्वारा कुछ भी उपयोगी करने से पहले बफ़रिंग विलंब जुड़ने लगेगा। प्रत्येक फ्रेम को Smallest.ai के Pulse STT एंडपॉइंट पर एकल पर्सिस्टेंट WebSocket के ज़रिये भेजें ताकि ट्रांसक्रिप्शन लाइव स्पीच के साथ तालमेल बिठा सके।
import pyaudio
import asyncio
import websockets
import json
import os
from dotenv import load_dotenv
load_dotenv()
API_KEY = os.getenv('WAVES_API_KEY')
CHUNK = 640 # 20ms at 16kHz
FORMAT = pyaudio.paInt16
CHANNELS = 1
RATE = 16000
async def stream_audio_to_pulse(on_final_transcript):
p = pyaudio.PyAudio()
stream = p.open(format=FORMAT, channels=CHANNELS, rate=RATE, input=True, frames_per_buffer=CHUNK)
uri = 'wss://waves.smallest.ai/v1/stt/stream'
async with websockets.connect(
uri, extra_headers={'Authorization': f'Bearer {API_KEY}'}
) as ws:
async def send_audio():
while True:
data = stream.read(CHUNK, exception_on_overflow=False)
await ws.send(data)
async def receive_transcripts():
async for message in ws:
result = json.loads(message)
if result.get('is_final'):
await on_final_transcript(result['transcript'])
await asyncio.gather(send_audio(), receive_transcripts())
`is_final` फ़्लैग पर ध्यान से नज़र रखें। जब उपयोगकर्ता बात कर रहा होता है, तब Pulse आंशिक (पार्शियल) ट्रांसक्रिप्ट स्ट्रीम करेगा, और फिर बोलने की समाप्ति का पता चलने पर एक अंतिम ट्रांसक्रिप्ट मार्क करेगा। LLM को केवल अंतिम ट्रांसक्रिप्ट पर ही ट्रिगर करें। यदि आप आंशिक ट्रांसक्रिप्ट पर ट्रिगर करते हैं, तो आप LLM पर ओवरलैपिंग अनुरोधों की बाढ़ ला देंगे और अंत में ऐसा एजेंट मिलेगा जो अपनी ही बात के ऊपर बोलने लगेगा और संदर्भ खो देगा।
चरण 3: ट्रांसक्रिप्ट को भाषा मॉडल से कनेक्ट करें
एक बार आपके पास अंतिम ट्रांसक्रिप्ट आ जाए, तो इसे Electron (या किसी भी संगत LLM एंडपॉइंट) पर एक सिस्टम प्रॉम्प्ट के साथ भेजें जो एजेंट की भूमिका और दायरे को निर्धारित करता हो। यहाँ सबसे बड़ा लेटेंसी लाभ सरल है: पूरी प्रतिक्रिया की प्रतीक्षा करने के बजाय प्रतिक्रिया को टोकन-दर-टोकन स्ट्रीम करें। स्ट्रीमिंग चालू होने पर, आप पहला टोकन प्राप्त होते ही शब्दों को TTS की ओर भेजना शुरू कर सकते हैं।
import httpx
SYSTEM_PROMPT = "You are a concise support agent. Answer in 1-2 sentences."
async def stream_llm_response(transcript, on_token):
async with httpx.AsyncClient() as client:
async with client.stream(
"POST",
"https://waves.smallest.ai/v1/chat/completions",
headers={"Authorization": f"Bearer {API_KEY}"},
json={
"model": "electron",
"messages": [
{"role": "system", "content": SYSTEM_PROMPT},
{"role": "user", "content": transcript}
],
"stream": True
}
) as response:
async for line in response.aiter_lines():
if line.startswith("data: "):
chunk = json.loads(line[6:])
token = chunk["choices"][0]["delta"].get("content", "")
if token:
await on_token(token)
सिस्टम प्रॉम्प्ट को संक्षिप्त रखें। हर अतिरिक्त टोकन की लागत प्रत्येक टर्न पर चुकानी पड़ती है। 500-टोकन के प्रॉम्प्ट से 50-टोकन के प्रॉम्प्ट पर जाने से बड़े पैमाने पर पहले-टोकन की लेटेंसी में 100ms+ तक की आसानी से कमी आ सकती है।
चरण 4: Lightning के साथ LLM प्रतिक्रिया को वाक् में बदलें
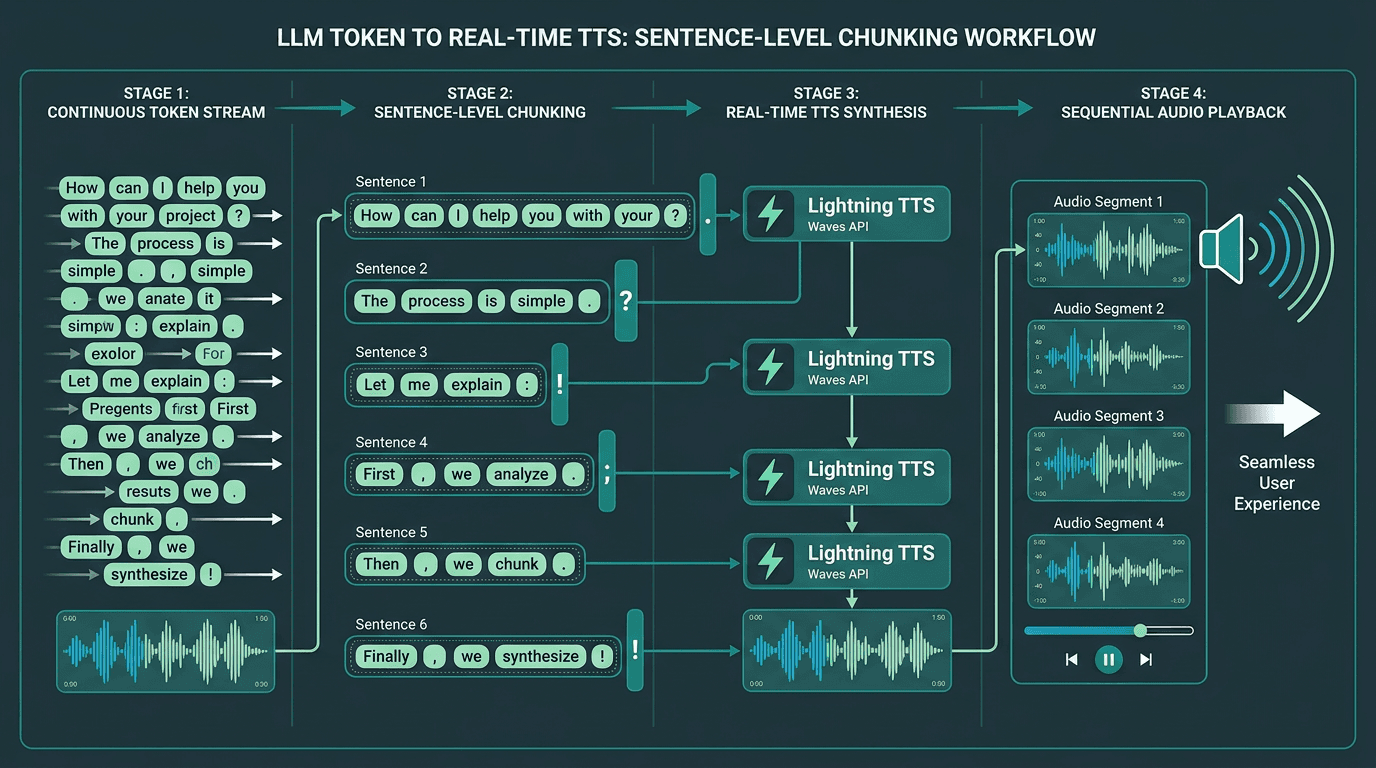
वाक्य-पूर्ण टुकड़े शब्द-दर-शब्द या पूर्ण-प्रतिक्रिया दृष्टिकोणों की तुलना में स्वाभाविकता और विलंबता को बेहतर ढंग से संतुलित करते हैं
LLM के स्ट्रीम किए गए टोकन्स को Smallest.ai के Lightning TTS (Waves API के माध्यम से) पर वाक्य-पूर्ण टुकड़ों में भेजें, न कि एक बार में एक शब्द। शब्द-दर-शब्द सिंथेसिस अक्सर अस्वाभाविक लगती है क्योंकि मॉडल के पास आवाज़ के उतार-चढ़ाव (prosody) को आकार देने के लिए पर्याप्त संदर्भ नहीं होता है। पूरी प्रतिक्रिया की प्रतीक्षा करना दूसरे छोर पर चला जाता है और अंतिम ऑडियो उच्च गुणवत्ता का होने पर भी एजेंट धीमा महसूस होता है। विराम चिह्न आपको एक साफ़, कम-प्रयास वाला चंकिंग सिग्नल देते हैं: पूर्ण विराम (periods), प्रश्नवाचक चिह्न, और विस्मयादिबोधक चिह्न।
async def tokens_to_speech(token_queue, audio_output_stream):
buffer = ''
async for token in token_queue:
buffer += token
if buffer.endswith(('.', '?', '!')):
await synthesize_and_play(buffer.strip(), audio_output_stream)
buffer = ''
if buffer.strip(): # flush any remaining tokens
await synthesize_and_play(buffer.strip(), audio_output_stream)
async def synthesize_and_play(text, audio_output_stream):
async with httpx.AsyncClient() as client:
async with client.stream(
'POST',
'https://waves.smallest.ai/v1/tts/stream',
headers={'Authorization': f'Bearer {API_KEY}'},
json={'text': text, 'voice': 'default', 'format': 'pcm_16000'}
) as response:
async for chunk in response.aiter_bytes(4096):
audio_output_stream.write(chunk)
चरण 5: इंटरप्ट हैंडलिंग और टर्न-टेकिंग के साथ लूप को पूरा करें
बार्ज-इन (उपयोगकर्ता द्वारा वाक्य के बीच में टोकने की क्षमता) एक प्रोडक्शन वॉइस एजेंट और एक पॉलिश्ड डेमो के बीच का अंतर है। इसके बिना, एजेंट लोगों के ऊपर बोलता है, सुधारों को नज़रअंदाज़ करता है, और आपकी लेटेंसी संख्या अच्छी होने पर भी रोबोटिक लगता है। सबसे सरल पैटर्न यह है कि जब एजेंट बोल रहा हो तब भी माइक्रोफ़ोन की निगरानी जारी रखी जाए। जब आप नए भाषण का पता लगाते हैं, तो TTS प्लेबैक बंद कर दें और ताज़ा ऑडियो को सीधे Pulse में वापस रूट करें।
कई उत्पादों के लिए, एक हल्का एनर्जी-थ्रेशोल्ड VAD पर्याप्त होता है। webrtcvad एक सामान्य विकल्प है क्योंकि यह भारी CPU लागत के बिना फ्रेम-स्तरीय भाषण पहचान प्रदान करता है। जब TTS प्लेबैक शुरू हो तो agent_speaking = True सेट करें और प्लेबैक समाप्त होने पर इसे वापस False कर दें। यदि agent_speaking के True रहने के दौरान VAD सक्रिय होता है, तो एक interrupt_event उत्पन्न करें जिसे आपका TTS कोरूटीन प्रत्येक ऑडियो चंक लिखने से पहले जांचता है। प्रोडक्शन ट्यूनिंग (गलत ट्रिगर्स बनाम जवाबदेही) पर अधिक जानकारी के लिए वॉइस एक्टिविटी डिटेक्शन प्रोडक्शन गाइड देखें। Smallest.ai के घटक इस पर सटीक बैठते हैं: Pulse स्ट्रीमिंग STT संभालता है, Electron LLM लेयर को कवर करता है, और Lightning (Waves API के माध्यम से) कम-विलंबता वाले TTS को संभालता है।
विलंबता बेंचमार्क: प्रत्येक चरण पर क्या अपेक्षा करें
स्टैक / दृष्टिकोण | STT पहला-टोकन (ms) | LLM पहला-टोकन (ms) | TTS पहला-ऑडियो (ms) | अनुमानित TTFA (ms) | स्ट्रीमिंग | इसके लिए अनुकूलित |
|---|---|---|---|---|---|---|
Smallest.ai (Waves API के माध्यम से Pulse + Electron + Lightning) | 80-150 | 150-300 | 80-180 | 310-630 | हाँ (सभी चरण) | एंड-टू-एंड विलंबता, एकीकृत API |
स्ट्रीमिंग STT + तृतीय-पक्ष LLM + स्ट्रीमिंग TTS | 100-200 | 200-500 | 150-300 | 450-1000 | हाँ (सभी चरण) | लचीलापन, मॉडल चयन |
स्ट्रीमिंग STT + तृतीय-पक्ष LLM + गैर-स्ट्रीमिंग TTS | 100-200 | 200-500 | 800-2000 | 1100-2700 | आंशिक | गति पर सरलता |
गैर-स्ट्रीमिंग बेसलाइन (बैच STT + पूर्ण LLM + बैच TTS) | 500-1500 | 400-1200 | 1000-3000 | 1900-5700 | नहीं | सरलता, विलंबता नहीं |
प्रोडक्शन-ग्रेड एजेंट के लिए, 600ms से कम का एंड-टू-एंड TTFA एक ठोस लक्ष्य है। संवादात्मक टर्न-टेकिंग शोध से पता चलता है कि प्रतिक्रियाएँ स्वाभाविक तब लगती हैं जब वे लगभग 200-500ms की सीमा में आती हैं (लेविंसन और टोरेइरा, स्पीच कम्युनिकेशन, 2015)। आप केवल प्रत्येक हैंडऑफ़ को स्ट्रीम करके ही उस बजट के करीब पहुँच सकते हैं। तालिका में गैर-स्ट्रीमिंग बेसलाइन इस नुकसान को स्पष्ट करती है: बैच STT, पूर्ण-समाप्ति LLM, और बैच TTS केवल देरी नहीं जोड़ते हैं, वे इसे तब तक बढ़ाते हैं जब तक कि अनुभव अपरिहार्य रूप से धीमा न लगने लगे।
सामान्य गलतियाँ और उनसे कैसे बचें

इनमें से प्रत्येक गलती विलंबता को बढ़ाती है या बातचीत के प्रवाह को तोड़ती है
पाँच गलतियाँ जो प्रोडक्शन में रियल-टाइम वॉइस एजेंटों को लगातार बाधित करती हैं:
TTS को कॉल करने से पहले पूर्ण LLM प्रतिक्रिया की प्रतीक्षा करना। सबसे आम लेटेंसी ट्रैप। इसके बजाय टोकन्स को स्ट्रीम करें और वाक्य सीमाओं पर चंक करें।
Pulse को बहुत बड़े ऑडियो चंक्स भेजना। एक बार जब आप ~100ms प्रति चंक से आगे निकल जाते हैं, तो आप पाइपलाइन में बफ़रिंग विलंब जोड़ रहे होते हैं। 20ms फ़्रेम पर टिके रहें।
कोई इंटरप्ट हैंडलिंग न होना। यदि उपयोगकर्ता बीच में नहीं बोल सकते हैं, तो तेज़ होने पर भी एजेंट अधूरा और खराब लगेगा। शुरुआत से ही VAD-आधारित बार्ज-इन बनाएँ।
API कुंजियों को हार्डकोड करना या WebSocket पुनः कनेक्शन को न संभालना। `.env` फ़ाइलों का उपयोग करें और एक्सपोनेंशियल बैकऑफ़ रीकनेक्ट लॉजिक जोड़ें। WebSockets ड्रॉप होते हैं; आपके एजेंट को शांत रूप से रिकवर होना चाहिए।
अत्यधिक लंबे सिस्टम प्रॉम्प्ट। प्रॉम्प्ट टोकन्स को प्रत्येक टर्न पर प्रोसेस किया जाता है। 50-टोकन प्रॉम्प्ट की तुलना में 500-टोकन प्रॉम्प्ट बड़े पैमाने पर पहले-टोकन लेटेंसी में 100ms+ जोड़ सकता है।
यह समस्या क्या हल करती है और Smallest.ai कहाँ उपयुक्त बैठता है
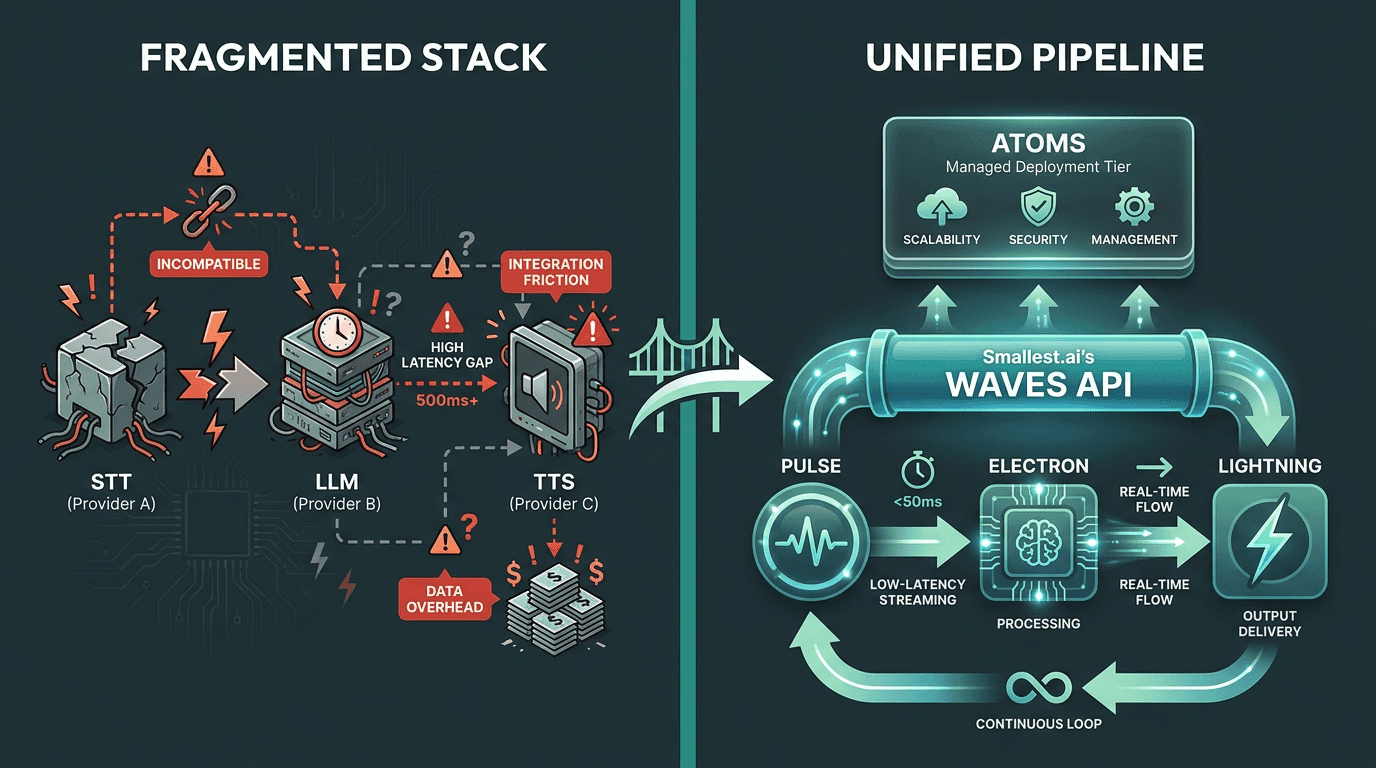
खंडित स्टैक विलंबता को बढ़ाते हैं; एक उद्देश्य-निर्मित एकीकृत पाइपलाइन कमियों को समाप्त करती है
रियल-टाइम वॉइस एजेंट का कठिन हिस्सा शायद ही कभी अलग से STT, LLM, या TTS होता है। कठिन हिस्सा उन्हें जोड़ना है। जब आप कई विलंबता-संवेदनशील सेवाओं को एक साथ जोड़ते हैं, तो आप बेमेल ऑडियो प्रारूपों को ठीक करने, अलग-अलग ऑथेंटिकेशन पैटर्न्स को संभालने, विक्रेताओं के बीच रूटिंग ओवरहेड झेलने, और फिर (देर से) यह पता लगाने में लग जाते हैं कि एक प्रदाता की "स्ट्रीमिंग" दूसरे के साथ ठीक से काम नहीं करती है। अधिकांश मल्टी-प्रोवाइडर स्टैक कभी भी एक सुसंगत रियल-टाइम सिस्टम की तरह व्यवहार करने के लिए डिज़ाइन नहीं किए गए थे।
Smallest.ai का Waves API, Pulse, Lightning, और Electron उसी एकल पाइपलाइन के रूप में चलने के लिए बनाए गए हैं: एक ऑथेंटिकेशन लेयर, सुसंगत स्ट्रीमिंग व्यवहार, और जब आप लूप को एक ही स्टैक के भीतर रखते हैं तो कम इंटर-सर्विस विलंबता। यदि आप बुनियादी व्यवस्था (plumbing) को छोड़ना पसंद करते हैं, तो Atoms, Smallest.ai का वॉइस और टेक्स्ट एजेंट प्लेटफ़ॉर्म है जो उसी बुनियादी ढाँचे के शीर्ष पर एक प्रबंधित एजेंट लेयर जोड़ता है जिसे आपने अभी मैन्युअल रूप से जोड़ा है। कस्टम निर्माण का नियंत्रण चुनें या प्रबंधित परिनियोजन (डिप्लॉयमेंट) की गति, दोनों ही मामलों में, अंतर्निहित लूप एक जैसा रहता है। अपना पहला एजेंट चलाने के लिए Waves API और डेवलपर दस्तावेज़ से शुरुआत करें।
आगे क्या बनाएँ
इस बिंदु पर आपके पास पूर्ण रियल-टाइम लूप काम कर रहा है: माइक्रोफ़ोन ऑडियो Pulse में स्ट्रीम होता है, अंतिम ट्रांसक्रिप्ट Electron में जाते हैं, टोकन वापस स्ट्रीम होते हैं और Lightning के लिए वाक्यों में विभाजित होते हैं, और VAD-आधारित बार्ज-इन बातचीत को एकतरफा भाषण बनने से रोकता है। यहाँ से, अगले पुनरावृत्ति (iterations) वे हैं जो एक कार्यात्मक एजेंट को उपयोग के लिए तैयार एजेंट में बदलते हैं। Smallest.ai के वॉइस क्लोनिंग API के साथ डिफ़ॉल्ट आवाज़ को ब्रांडेड आवाज़ से बदलें। इनबाउंड या आउटबाउंड कॉलिंग के लिए WebRTC के माध्यम से इसी पाइपलाइन को फ़ोन नंबर पर ले जाएँ। टेलीफ़ोनी तक विस्तार करने से पहले, एजेंट को पहले प्रोडक्शन के लिए तैयार करना उचित है। टेलीफ़ोनी और प्रोडक्शन को मजबूत करने की इन-हाउस क्षमता के बिना टीमें बाहरी टीम को भी शामिल कर सकती हैं, जैसे कि Relinns, जो AI वॉइस एजेंट विकास सेवाएँ प्रदान करती है। एक ठोस कंटेनर डिप्लॉयमेंट सेटअप आपके परिवेश को डेवलपमेंट और प्रोडक्शन में सुसंगत रखता है, और कॉल की मात्रा बढ़ने पर हॉरिजॉन्टल स्केलिंग को आसान बनाता है। यदि आपके पास स्पीच-टू-स्पीच उपयोग का मामला है जिसमें बीच में टेक्स्ट की आवश्यकता नहीं है, तो Hydra विशिष्ट अनुप्रयोगों के लिए कम-विलंबता वाला मार्ग प्रदान करता है। और यदि आप किसी विशेष वर्कफ़्लो की ओर बढ़ रहे हैं, तो मल्टी-एजेंट वॉइस डैशबोर्ड ट्यूटोरियल और ई-कॉमर्स के लिए AI वॉइस एजेंट गाइड दिखाते हैं कि टीमें इस नींव को प्रोडक्शन डिप्लॉयमेंट में कैसे विस्तारित करती हैं। यदि आप एक काम करने वाले प्रोटोटाइप से प्रोडक्शन वॉइस एजेंट पर जाने के लिए तैयार हैं, तो यह देखने के लिए कि Smallest.ai आपके आर्किटेक्चर और डिप्लॉयमेंट आवश्यकताओं में कैसे फिट बैठता है, एक डेमो बुक करें।
अक्सर पूछे जाने वाले प्रश्न
किस लेटेंसी (विलंबता) लक्ष्य से एक रियल-टाइम वॉयस एजेंट स्वाभाविक महसूस होता है?
क्या मैं अलग-अलग एसटीटी (STT) और टीटीएस (TTS) वेंडर्स के साथ झंझट किए बिना वेव्स एपीआई (Waves API) पर वॉयस एजेंट बना सकता हूँ?
जब एजेंट बोल रहा हो और उपयोगकर्ता बात करना शुरू कर दे, तो व्यवधान कैसे काम करना चाहिए?
रीयल-टाइम वॉयस एजेंटों के लिए कौन सी भाषाएं और फ्रेमवर्क सबसे उपयुक्त हैं?
क्या मैं एजेंट को किसी सामान्य आवाज़ के बजाय एक कस्टमाइज़्ड या क्लोन की गई आवाज़ दे सकता हूँ?