बेंचमार्क
स्पीच-टू-टेक्स्ट (ASR) लीडरबोर्ड
Deepgram, AssemblyAI, ElevenLabs और अन्य की तुलना में Smallest Pulse के लिए वर्ड एरर रेट (WER) और स्ट्रीमिंग लेटेंसी, पूर्ण कार्यप्रणाली और पुनरुत्पादित किए जा सकने वाले स्क्रिप्ट के साथ।
अंतिम बार अपडेट किया गया
16 अक्टूबर 2026
अनुभाग 01
विलंबता की तुलना
एक साझा मिलीसेकंड स्केल पर प्लॉट किया गया है ताकि वास्तविक स्प्रेड दिखाई दे। औसत उन कॉल्स को छुपा देते हैं जो टूटे हुए लगते हैं, इसलिए जहां भी परसेंटाइल मौजूद होते हैं, वे दिखाई देते हैं।
स्पीच-टू-टेक्स्ट, पहले ट्रांसक्रिप्ट तक का समय
सबसे तेज़ पहले के क्रम में व्यवस्थित किया गया। ठोस मार्कर एक बिंदु माप है, कैप्सूल P50 से P90 तक की अवधि है।

स्पीचमैटिक्स फ्लो केवल 1-सेकंड से कम का आंकड़ा प्रकाशित करता है, जो ईमानदारी से प्लॉट करने के लिए बहुत मोटा है।
150 मिलीसेकंड से कम
150 से 300 एमएस (ms)
300 मिलीसेकंड से अधिक
सबसे छोटा मापा गया
स्पेको
हमारे अपने आंकड़े असहमत हैं। आंतरिक स्रोत पल्स के पहले ट्रांसक्रिप्ट के समय को 64 ms और 70 ms दोनों बताते हैं, और डीपग्राम नोवा 3 को 71 ms और 100 ms दोनों बताते हैं। लाइटनिंग हमारे तुलनात्मक पृष्ठों पर एंड-टू-एंड 100 ms और दस्तावेज़ों में पहले बाइट का समय ~200 ms दिखाई देता है, और एंड-टू-एंड इसके अपने पहले बाइट से तेज़ नहीं हो सकता। हमारे लिए रूढ़िवादी आंकड़ा और प्रतिस्पर्धियों के लिए अनुकूल आंकड़ा तब तक प्लॉट किया गया है जब तक कि एक सिंगल रन इसे हल नहीं कर देता।
प्रतिशतक (परसेंटाइल) क्यों, माध्य (मीन) क्यों नहीं
एक वॉयस एजेंट का मूल्यांकन उसके सबसे खराब प्रदर्शन के आधार पर किया जाता है। 200 ms औसत और 2 सेकंड P99 वाला मॉडल, 300 ms औसत और 400 ms P99 वाले मॉडल की तुलना में अधिक बार खराब महसूस होता है, और केवल औसत मान आपको यह नहीं बता सकता कि आपके पास कौन सा मॉडल है। जहाँ हमारे पास प्रतिशतक (percentiles) उपलब्ध हैं, हम उन्हें प्रकाशित करते हैं और जहाँ नहीं हैं, वहाँ अंतर को चिह्नित करते हैं।
स्पीच-टू-टेक्स्ट, पहले ट्रांसक्रिप्ट तक का समय
अनुभाग 02
हम बेंचमार्क कैसे करते हैं
पैरामीटर पहले ही स्पष्ट रूप से बता दिए गए हैं, न कि किसी खुलासे के पीछे छिपाए गए हैं। सार्वजनिक बेंचमार्क को ओवरफिट और प्रभावित किया जा सकता है, जो कि आपकी कार्यप्रणाली को दिखाने का एक तर्क है, न कि किसी एक संख्या के पीछे छिपने का।
डेटासेट
ईएसबी (ESB) सुइट, 9 डेटासेट, अंग्रेजी। बहुभाषी के लिए फ्लर्स (FLEURS), 26 भाषाएं। खराब रिकॉर्डिंग स्थितियों के लिए वाइल्डएएसआर (WildASR)। आंतरिक अंग्रेजी और हिंदी विरूपण (perturbation) सुइट्स। इमर्जेंटटीटीएस (EmergentTTS), 1,645-नमूनों के सार्वजनिक सेट से लिए गए 1,088 नमूने। एआईईडब्ल्यूएफ (AIEWF), 30 टर्न के 10 रनों में 300 कार्य। साथ ही 44 वास्तविक हिंदी-अंग्रेजी संग्रह कॉल।
सटीकता मीट्रिक
Whisper नॉर्मलाइज़र के तहत शब्द त्रुटि दर (Word error rate), साथ में वर्ण त्रुटि दर (character error rate) भी दी गई है। यह विकल्प महत्वपूर्ण है: एक तीसरे पक्ष के बोर्ड ने पल्स को 8.0% पर रिपोर्ट किया, जहां इनवर्स टेक्स्ट नॉर्मलाइज़ेशन ने शब्दों में लिखे गए नंबरों को त्रुटियों के रूप में गिना, जबकि अन्यथा यह 5.1% था। नंबरों से भरपूर कॉल ऑडियो पर नॉर्मलाइज़र उत्तर को बदल देता है।
विलंबता मीट्रिक
पहले ट्रांसक्रिप्ट का समय भाषण के समाप्त होने से लेकर पूरे ट्रांसक्रिप्ट तक चलता है। पहले बाइट का समय प्राप्त पहला ऑडियो बाइट होता है। वॉयस-टू-वॉयस का मतलब उपयोगकर्ता के भाषण के समाप्त होने से लेकर एजेंट के ऑडियो शुरू होने तक का समय है। इसे P50, P90, P95 और P99 के रूप में रिपोर्ट किया जाता है, जहाँ भी रन ने उन्हें उत्पन्न किया है।
ग्राउंड ट्रुथ (वास्तविक तथ्य)
कॉल बेंचमार्क के लिए मैन्युअल मानव ट्रांसक्रिप्शन। सार्वजनिक डेटासेट अपने स्वयं के प्रकाशित संदर्भों का उपयोग करते हैं, जिनमें कोई संशोधन नहीं किया गया है।
हार्डवेयर
सिंगल L40S, 48 GB पर थ्रूपुट। 16 kHz linear16 पर स्ट्रीमिंग परीक्षण। प्रतिस्पर्धी मॉडल उनके सार्वजनिक प्रोडक्शन API के माध्यम से कॉल किए गए हैं, न कि सेल्फ-होस्टेड।
रीफ़्रेश करने की आवृत्ति
त्रैमासिक रूप से, और तुरंत जैसे ही तुलना सेट में कोई भी मॉडल नया संस्करण शिप करता है। प्रत्येक तालिका की अपनी माप तिथि होती है।
इसे फिर से बनाएं
मूल्यांकन वॉकथ्रू और स्क्रिप्ट सार्वजनिक हैं, और नीचे दिए गए प्रत्येक परिणाम को आपके अपने ऑडियो के साथ फिर से जनरेट किया जा सकता है।
अनुभाग 03
भाषण-से-पाठ (स्पीच-टू-टेक्स्ट)
साफ़ बेंचमार्क ऑडियो और वास्तविक कॉल रिकॉर्डिंग पर समान मॉडल देखने के लिए व्यवस्था (regimes) बदलें।
स्पष्ट बेंचमार्क
असली कॉल ऑडियो
डोमेन के अनुसार ESB सुइट शब्द त्रुटि दर। कम होना बेहतर है, हरा रंग प्रत्येक पंक्ति में सबसे अच्छे मॉडल को दर्शाता है।
डोमेन
ऑडियोबुक, स्पष्ट
ऑडियोबुक, शोरगुल वाली
क्राउडसोर्स्ड
संसद
टेड टॉक्स (TED talks)
पॉडकास्ट
वित्तीय
अर्निंग्स कॉल्स
बैठकें
कुल मिलाकर
डेटासेट
लिब्रीस्पीच क्लीन
लिब्रीस्पीच अदर
कॉमन वॉयस
वॉक्सपॉपुली
टेड-लियम (TED-LIUM)
गीगास्पीच
एसपीजीआईस्पीच (SPGISpeech)
कमाई22
एएमआई
सकल
पल्स
2.46
5.31
10.89
7.16
४.०७
10.43
2.86
12.25
10.58
7.33

असेंबलीएआई
1.65
2.86
6.73
7.28
२.९५
9.12
1.74
11.52
14.60
6.49

डीपग्राम
3.20
6.60
14.22
9.55
3.59
10.05
२.९९
15.79
17.04
9.23
इलेवनलैब्स
1.97
४.४५
9.83
7.91
3.16
9.66
4.40
12.20
12.23
7.31
स्मालेस्ट (Smallest) की पल्स (Pulse) उपलब्धि। पल्स ने संसदीय भाषण और बैठकों में जीत हासिल की है, जो कि दो सबसे कठिन मल्टी-स्पीकर स्थितियां हैं। यह भी ध्यान दें कि पल्स यहां कुल मिलाकर 7.33 पर स्ट्रीम होता है, जबकि 5.42% की मुख्य सुर्खी प्री-रिकॉर्डेड पथ पर पल्स प्रो (Pro) की है। ये अलग-अलग मॉडल हैं। हालांकि असेंबली एआई (Assembly AI) 9 में से 7 डोमेन और कुल योग में आगे है, और इलेवनलैब्स स्क्राइब (ElevenLabs Scribe) कुल मिलाकर पल्स से 0.02 आगे है।
भाषा के आधार पर FLEURS स्ट्रीमिंग वर्ड एरर रेट (WER), डीपग्राम नोवा 3 के मुकाबले पल्स
भाषा
इतालवी
स्पैनिश
अंग्रेज़ी
पुर्तगाली
हिंदी
जर्मन
फ़्रेंच
मराठी
गुजराती
पल्स
4.41
5.99
6.03
8.32
8.30
9.50
10.71
15.68
20.05
डीपग्राम नोवा 3
6.99
7.55
11.21
11.46
15.46
10.15
12.07
समर्थित नहीं है
समर्थित नहीं है
अनुपात
1.6x
1.3x
1.9 गुना
1.4x
1.19
1.1x
1.1x
मराठी और गुजराती में कोई डीपग्राम (Deepgram) कॉलम नहीं है क्योंकि मॉडल उनके अंतर्गत नहीं आता है। कवरेज अपने आप में एक परिणाम है।
सबसे छोटा मापा गया
वाइल्डएएसआर (WildASR) मजबूती, खराब रिकॉर्डिंग स्थितियों में वर्ड एरर रेट (शब्द त्रुटि दर)
स्थिति
स्पष्ट ऑडियो
लहजे वाली आवाज़
फ़ोन कोडेक
पृष्ठभूमि का शोर
गूँज
दूर-क्षेत्र का माइक
क्लिपिंग
कुल मिलाकर
पल्स
5.98
5.82
7.19
8.90
9.06
13.38
14.03
9.63
असेंबलीएआई
3.33
2.80
3.45
४.०४
23.50
26.07
6.59
12.52
डीपग्राम
11.62
7.31
9.13
15.04
२७.२७
62.99
४३.३५
28.17
इलेवनलैब्स
4.24
4.01
4.98
6.30
6.48
7.38
11.20
6.74
ElevenLabs Scribe समग्र रूप से यहाँ सबसे मजबूत मॉडल है। सबसे महत्वपूर्ण निष्कर्ष विफलता के तौर-तरीकों (failure modes) के बारे में है: AssemblyAI साफ ऑडियो पर सबसे सटीक है, फिर भी दूर-दराज की आवाज़ों (far-field) पर यह गिरकर 26.07 और गूँज (reverberation) पर 23.50 तक पहुँच जाता है, जबकि Deepgram दूर-दराज की आवाज़ों पर 62.99 तक पहुँच जाता है। Pulse अधिकांश एकल स्थितियों में पीछे रह जाता है, लेकिन यह कभी भी पूरी तरह से विफल नहीं होता है, और यही बात सबसे महत्वपूर्ण होती है जब आप इस बात को नियंत्रित नहीं कर सकते कि आपके कॉल करने वालों की आवाज़ कैसे रिकॉर्ड की जा रही है।
सबसे छोटा मापा गया
पल्स (Pulse): 21 स्ट्रीमिंग भाषाएं, 26 प्री-रिकॉर्डेड।
पल्स प्रो (Pulse Pro): केवल अंग्रेजी, केवल HTTP, स्ट्रीमिंग वर्कर रोडमैप पर है। 1x L40S पर थ्रूपुट 250-300 गुना वास्तविक समय (real time) है।
मूल्य निर्धारण: हमारी अपनी सामग्री रीयल-टाइम पल्स के लिए प्रति मिनट $0.003, $0.004, $0.005 और $0.008 का उद्धरण देती है। मिलान होने तक यहाँ प्रकाशित नहीं किया जाएगा।
तृतीय-पक्ष परिणाम: Cekura
Cekura ने 18 अन्य स्ट्रीमिंग स्पीच-टू-टेक्स्ट मॉडलों के मुकाबले Smallest Pulse का परीक्षण किया, जिसे आखिरी बार 16 सितंबर, 2026 को अपडेट किया गया था। वास्तविक फोन कॉल ऑडियो (Ocular डेटासेट) पर Pulse 3.46% वर्ड एरर रेट के साथ 19 में से तीसरे स्थान पर है। स्पष्ट क्लिप्स (Pipecat डेटासेट) पर यह 3.66% के साथ 19 में से 15वें स्थान पर आता है। P50 पर पहले टेक्स्ट का समय 1.06 सेकंड है, जो 17 में से 5वां है, और 1,000 क्लिप्स में कोई भी विफल अनुरोध नहीं रहा। इसे Cekura द्वारा मापा गया था, Smallest द्वारा नहीं।
खंड 04
सार्वजनिक बेंचमार्क बनाम आपका वास्तविक ऑडियो
FLEURS पर हमारी हिंदी शब्द त्रुटि दर (word error rate) 8.30% है और वास्तविक कलेक्शन कॉल्स पर 29.1% है। दोनों मापे गए हैं। दोनों में से कोई भी गलत नहीं है।
एक ही मॉडल, एक ही भाषा, दो प्रकार के ऑडियो
शब्द त्रुटि दर (वर्ड एरर रेट)। जितना कम हो उतना बेहतर है।

रीड-स्पीच बेंचमार्क अच्छी परिस्थितियों में रिकॉर्ड किए गए साफ, स्क्रिप्टेड ऑडियो को मापते हैं। प्रोडक्शन कॉल कोड-स्विच्ड, शोरगुल वाली, सहज और टेलीफोनी कोडेक्स द्वारा कंप्रेस्ड होती हैं। हमारे लिए यह अंतर लगभग 3.5× है और सर्वम (Sarvam) के लिए भी 3.5× है, इसलिए यह किसी एक मॉडल के बजाय ऑडियो की विशेषता है।
हम दोनों को प्रकाशित करते हैं क्योंकि एक अकेला नंबर आपको गुमराह कर सकता है। कोई भी वेंडर जो भी आंकड़ा देता है, वह शायद आसान वाला होता है, और एकमात्र नंबर जो आपके प्रोडक्शन की सटीकता का अनुमान लगाता है, वह वह है जिसे आप अपनी खुद की रिकॉर्डिंग पर मापते हैं।
अनुभाग 05
वास्तविक हिंदी-अंग्रेज़ी कॉल ऑडियो
मैन्युअल रूप से तैयार किए गए मानव ट्रांसक्रिप्ट के मुकाबले स्कोर किए गए, 44 वास्तविक कलेक्शन कॉल्स पर पांच प्रदाता। हम छह में से दो श्रेणियों में जीतते हैं। अन्य चार को बिना किसी बदलाव के प्रकाशित किया गया है।
हरा रंग श्रेणी के विजेता को दर्शाता है। रिकॉल स्कोर 0 से 1 तक होते हैं, जितना अधिक हो उतना बेहतर है। जुलाई 2026।
डेटासेट
सबसे छोटा एआई
पल्स
डीपग्राम
नोवा 3
सर्वम एआई
सारस
इलेवनलैब्स
स्क्राइब, मुख्य शब्द
इलेवनलैब्स
मुंशी, मानक
डब्ल्यूईआर
0.291
0.325
0.376
0.460
0.554
ऋण की शर्तें
0.872
०.९१९
0.910
0.902
0.815
भुगतान करने का वादा
0.557
0.509
०.५०२
0.432
0.381
संख्याएँ
0.387
0.282
0.381
0.410
0.389
राशि
0.334
0.280
0.330
०.३४९
0.313
तारीखें
०.५३१
0.510
0.522
0.611
0.485
इससे क्या सीखें
पल्स सबसे सटीक और सबसे सुसंगत ट्रांसक्रिप्ट देता है। लोन से जुड़ी शब्दावली पर डीपग्राम सबसे मजबूत है। इलेवनलैब्स कीटर्म्स वित्तीय संस्थाओं को सबसे अच्छे से कैप्चर करता है लेकिन उनके आसपास ध्यान देने योग्य रूप से खराब ट्रांसक्रिप्ट तैयार करता है। मानक इलेवनलैब्स की तुलना में हमेशा कीटर्म्स को चुनें; यह समान गति और लागत पर हर मीट्रिक में जीतता है।
उद्योग-व्यापी अंतर
सभी पांच प्रदाताओं के मामले में, राशियों और नंबरों को सटीक रूप से याद रखने (रिकॉल) की दर कम रही और कोई भी 0.35 के स्तर को पार नहीं कर पाया। यह किसी एक उत्पाद की कमी होने के बजाय पूरी श्रेणी के लिए एक अनसुलझी समस्या है, और इसका मतलब यह है कि आप चाहे कोई भी एपीआई (API) चुनें, किसी भी राशि-महत्वपूर्ण वर्कफ़्लो के लिए एक सत्यापन चरण (वेरिफिकेशन स्टेप) की आवश्यकता होगी।
दायरा और सीमाएँ। 44 रिकॉर्डिंग, जुलाई 2026, एक ही डोमेन से हिंदी-अंग्रेजी संग्रह और ऋण-सर्विसिंग कॉल। ग्राउंड ट्रुथ मैनुअल मानव ट्रांसक्रिप्शन है। डेटासेट में कोई शोर-स्थिति (noise-condition) लेबल और कोई भाषा-मिश्रण विश्लेषण शामिल नहीं है, इसलिए यहाँ दी गई कोई भी जानकारी विशिष्ट शोर के स्तर या कोड-स्विचिंग अनुपात के बारे में निष्कर्ष का समर्थन नहीं करती है। n=44 पर, आस-पास के मॉडलों के बीच छोटे अंतर महत्वपूर्ण नहीं हो सकते हैं।
स्रोत डेटा और आगे पढ़ने के लिए सामग्री
खंड 06
एंटिटी-स्तरीय रिकॉल
शब्द त्रुटि दर (वर्ड एरर रेट) हर शब्द को एक समान मानती है। कलेक्शन कॉल में, दस छूटे हुए निरर्थक शब्दों की तुलना में एक छूटा हुआ रुपये का आंकड़ा अधिक मायने रखता है। कोई भी सार्वजनिक लीडरबोर्ड इसे नहीं मापता है, इसलिए हमने इसे परिभाषित किया है।
ऋण की शर्तें
क्या मॉडल ने ऋण शब्दावली जैसे कि ईएमआई (EMI), कार्यकाल और ब्याज को शामिल किया।
भुगतान करने का वादा
क्या इसमें प्रतिबद्धता वाले वाक्यांश जैसे कि "मैं इस तारीख तक भुगतान कर दूँगा" (I will pay by) या "आज ट्रांसफर कर दूँगा" (will transfer today) कैप्चर हुए?
संख्याएँ
क्या इसने बोले गए संख्यात्मक मानों को सही ढंग से ट्रांसक्राइब किया।
धनराशि
क्या इसने बोले गए रुपये के आंकड़ों को कैप्चर किया।
स्कोरिंग
सभी का स्कोर 0 से 1 के बीच रहा और 44 रिकॉर्डिंग्स का औसत निकाला गया। ये सबसे छोटे-परिभाषित (Smallest-defined) मेट्रिक्स हैं। बाहरी टीम द्वारा इन्हें दोबारा तैयार करने से पहले, टर्म लिस्ट और मैचिंग लॉजिक को अभी प्रकाशित किया जाना बाकी है।
भुगतान-का-वादा वापस लेना (प्रॉमिस-टू-पे रिकॉल)
0 से 1 के पूरे पैमाने पर जितना अधिक हो उतना बेहतर है ताकि अंतरालों का वास्तविक आकार दिखाई दे सके।
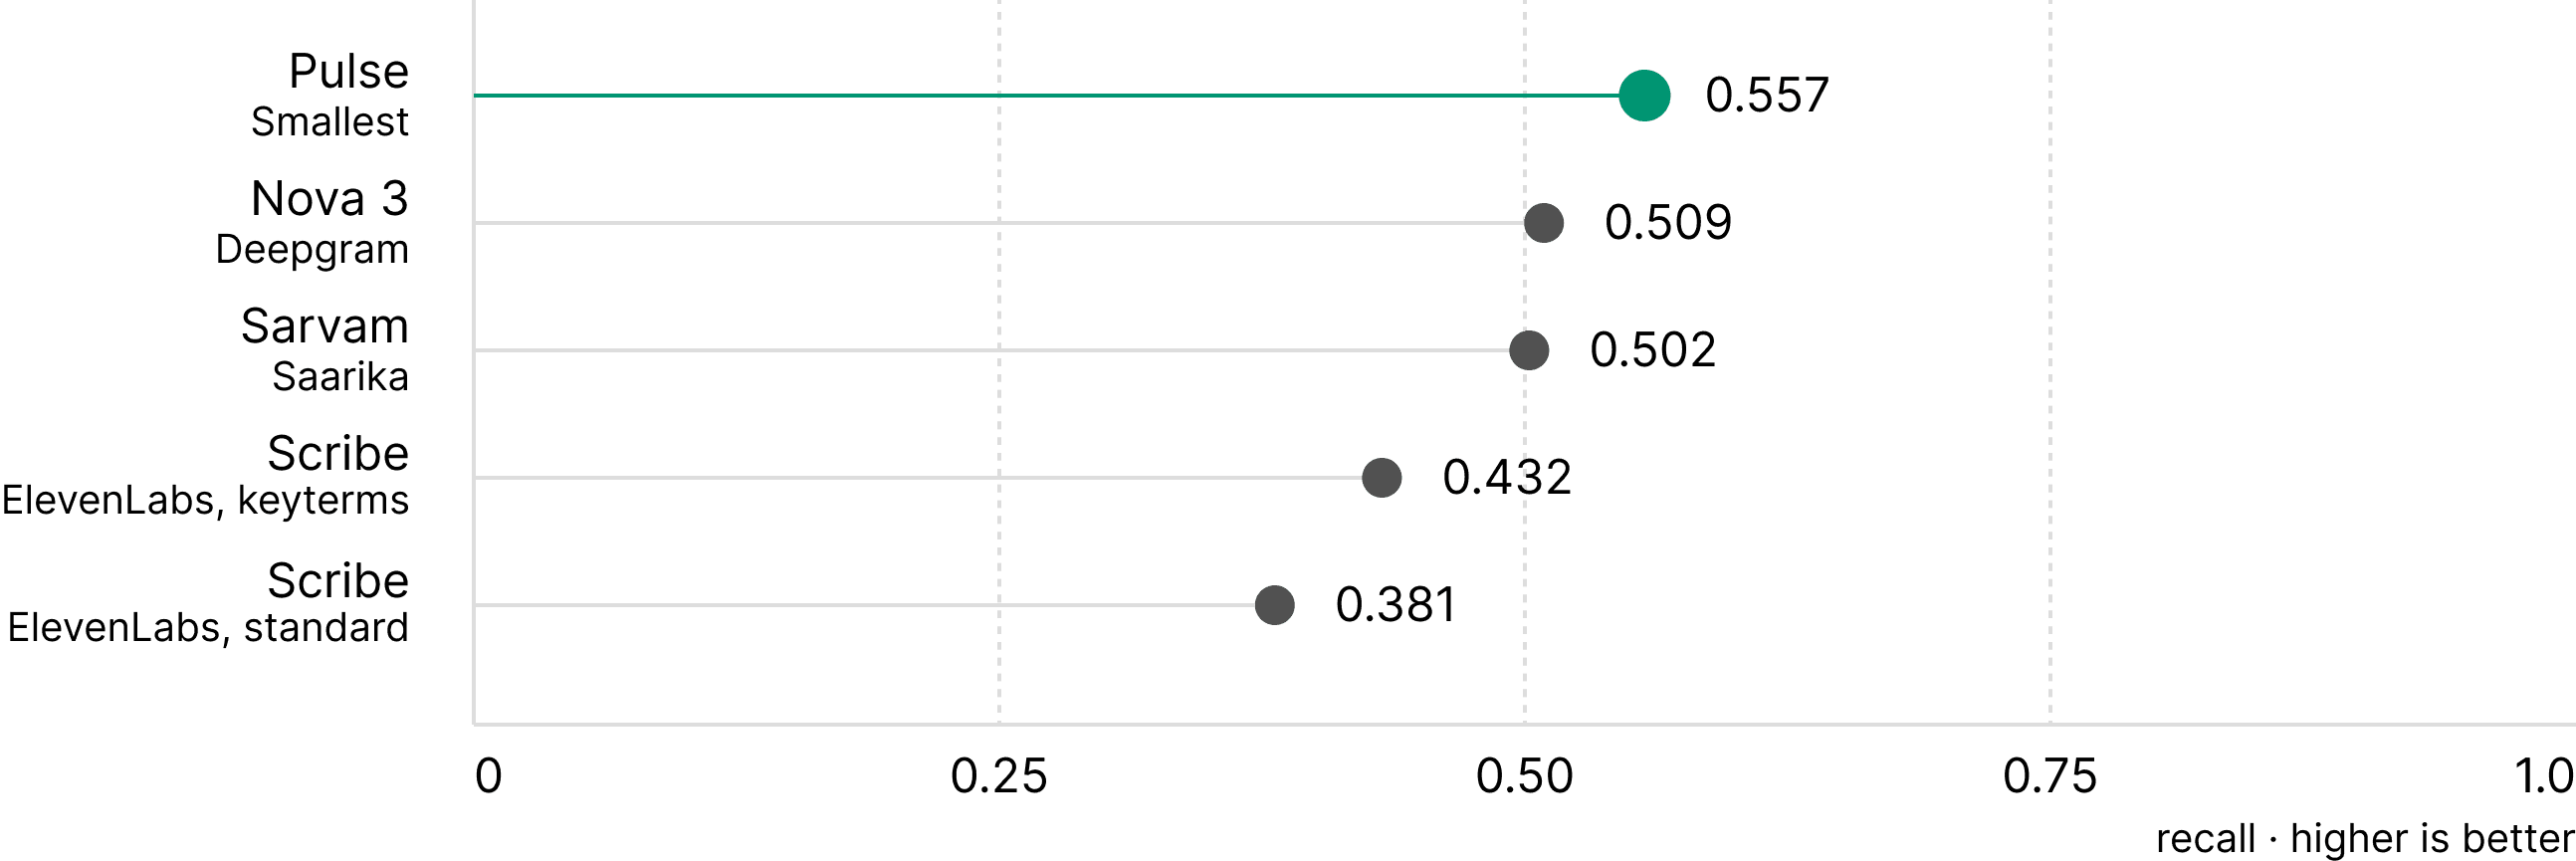
धनराशि वापसी
टूटी हुई रेखा (डैश वाली रेखा) 0.35 को दर्शाती है। कोई भी प्रदाता इसे पार नहीं कर पाता है।

अनुभाग 07
अक्सर पूछे जाने वाले प्रश्न
वर्ड एरर रेट (Word Error Rate) क्या है?
स्पीच-टू-टेक्स्ट लेटेंसी को कैसे मापा जाता है?
आपकी दोनों हिंदी संख्याओं में इतना अंतर क्यों है?
शोरगुल वाले कॉल ऑडियो के लिए मुझे कौन सा मॉडल इस्तेमाल करना चाहिए?
क्या आप हिंदी और कोड-स्विचिंग (भाषाओं के मिश्रण) का समर्थन करते हैं?
क्या ये संख्याएँ स्वतंत्र हैं?