आवाज में मानव-स्तर की रीयल-टाइम बुद्धिमत्ता को अनलॉक करना
अतुल्यकालिक इनपुट, आउटपुट तंत्र और निरंतर अव्यक्त सोच के माध्यम से
प्रस्तावना: आवाज वास्तविक है, पाठ नहीं
आवाज एक भौतिक संकेत (सिग्नल) है। यह वास्तविक दुनिया में हवा के माध्यम से प्रसारित होने वाली दबाव तरंगों के रूप में मौजूद है, जिसे कान द्वारा ग्रहण किया जाता है और तंत्रिका गतिविधि में परिवर्तित किया जाता है। यह निरंतर, एनालॉग और मौलिक रूप से सामयिक (टेम्पोरल) है: प्रत्येक शब्दांश, प्रत्येक ठहराव, पिच में प्रत्येक बदलाव अपने साथ अर्थ रखता है जो इस बात से अविभाज्य है कि वह कब घटित होता है। आवाज वह माध्यम है जिससे मनुष्य संवाद करने, बातचीत करने, सिखाने और तर्क करने के लिए विकसित हुआ है। यह बुद्धिमत्ता के लिए सबसे पुराना और सबसे प्राकृतिक इंटरफ़ेस है।
इसके विपरीत, पाठ (टेक्स्ट) भौतिक दुनिया में मौजूद नहीं है। पाठ एक मानवीय आविष्कार है, एक पृथक प्रतीकात्मक एन्कोडिंग प्रणाली है जिसे समय और स्थान के पार भाषण को संरक्षित करने के लिए बनाया गया है। गंभीर रूप से, पाठ का उपभोग दृष्टि के माध्यम से होता है, न कि श्रवण के माध्यम से। जब आप एक वाक्य पढ़ते हैं, तो आपकी आँखें किसी सतह पर प्रतीकों को स्कैन करती हैं; आपका विजुअल कॉर्टेक्स आकृतियों और पैटर्नों को प्रोसेस करता है। पाठ का कोई समय डोमेन नहीं होता है। पृष्ठ पर लिखे शब्द "हैलो" को बोलने में वैसे 400 मिलीसेकंड नहीं लगते जैसे बोले गए शब्द को लगते हैं। इसमें कोई लहजा (प्रोसॉडी), कोई जोर या कोई भावनात्मक रंग नहीं होता है। यह एक अमूर्तता (एब्स्ट्रैक्शन) है, जो आवाज जैसे समृद्ध, निरंतर, अस्थायी रूप से स्थापित संकेत का एक नुकसानदेह संपीड़न (लॉसी कम्प्रेशन) है।
सभी वास्तविक भौतिक संकेत निरंतर होते हैं और उनका एक अंतर्निहित समय डोमेन होता है। ध्वनि, प्रकाश, स्पर्श, प्रोप्रियोसेप्शन: ये वे संकेत हैं जिनके माध्यम से जैविक बुद्धिमत्ता दुनिया के साथ जुड़ती है। मानव-स्तरीय संवादात्मक बुद्धिमत्ता की आकांक्षा रखने वाली किसी भी प्रणाली को आवाज को उसी रूप में देखना चाहिए जो यह वास्तव में है: एक वास्तविक, निरंतर, सामयिक संकेत। इसे आवाज को पाठ में संक्षिप्त नहीं करना चाहिए, पाठ को प्रोसेस नहीं करना चाहिए और फिर पाठ को वापस आवाज में विस्तारित नहीं करना चाहिए। वह पाइपलाइन उन्हीं गुणों (निरंतरता, सामयिकता, भाषा-इतर समृद्धि) को खारिज कर देती है जो आवाज को वह माध्यम बनाते हैं जो वह है।
हालाँकि, स्पीच-टू-स्पीच मॉडल बनाने के लिए केवल मध्यवर्ती परतों को जोड़कर पाठ को हटा देना ही पर्याप्त नहीं है। हमें यह सोचना होगा कि मानव मस्तिष्क कैसे काम करता है और एक ऐसी वास्तुकला (आर्किटेक्चर) का निर्माण करना होगा जो मनुष्यों की तरह व्यवहार करने में सक्षम हो जब वे बातचीत करते हैं, यानी ट्यूरिंग टेस्ट पास करना [Turing, 1950]।
यह शोध प्रबंध आवाज आर्किटेक्चर के एक नए वर्ग के लिए एक सकारात्मक मामला प्रस्तुत करता है, जो वास्तविक समय की बोली जाने वाली बातचीत में वास्तविक रूप से ट्यूरिंग टेस्ट पास करने वाले वॉयस एजेंटों के निर्माण के मार्ग के रूप में संपीड़ित गुप्त प्रतिनिधित्व (कंप्रेस्ड लेटेंट रिप्रेजेंटेशन) पर काम करने वाले अतुल्यकालिक विश्व मॉडल (असिंक्रोनस वर्ल्ड मॉडल्स) हैं। हम यह जांच कर शुरू करते हैं कि मनुष्य आवाज को कैसे प्रोसेस करते हैं, तीन समवर्ती क्षमताओं (सुनना, सोचना और बोलना, समवर्ती कार्रवाई के साथ) की पहचान करते हैं जो प्राकृतिक बातचीत को परिभाषित करती हैं। फिर हम हाइड्रा (Hydra) प्रस्तुत करते हैं, जो इन क्षमताओं को दोहराने के लिए पहले सिद्धांतों से डिज़ाइन किया गया एक आर्किटेक्चर है। अंत में, हम यह पता लगाते हैं कि यह प्रतिमान कुशल, अनुकूली बुद्धिमत्ता के भविष्य की ओर कैसे इशारा करता है।
हमारा दृष्टिकोण हर जगह संरचना और पैमाना (स्ट्रक्चर एंड स्केल) है, न कि केवल पैमाना: वॉयस इंटेलिजेंस के लिए उस पैमाने की आवश्यकता होती है जो कच्चे ऑडियो पर स्व-पर्यवेक्षित शिक्षण प्रदान करता है, लेकिन साथ ही उस संरचना की भी आवश्यकता होती है जिसे संज्ञानात्मक विज्ञान ने दिखाया है कि मनुष्य वास्तव में उपयोग करते हैं। एक आर्किटेक्चर जो केवल पैमाने के लिए प्रतिबद्ध है, वह बातचीत के बारे में पहले से जो ज्ञात है उसे पुनः प्राप्त करने के लिए एक स्केलिंग टैक्स का भुगतान करता है; एक आर्किटेक्चर जो सीधे संरचना का निर्माण करता है वह कई गुना छोटा हो सकता है।
इस दावे का वैज्ञानिक आधार कि मानव बातचीत में कई कम्प्यूटेशनल स्तरों पर संरचना होती है, एक सहवर्ती पत्र [Smallest AI Research, 2026] में विस्तार से विकसित किया गया है, जो व्यवहारिक, इलेक्ट्रोफिजियोलॉजिकल, इंट्राक्रैनियल और कम्प्यूटेशनल अध्ययनों से संज्ञानात्मक-विज्ञान और तंत्रिका विज्ञान के साक्ष्यों की समीक्षा करता है। वर्तमान पत्र उस साक्ष्य को पृष्ठभूमि के रूप में लेता है और वॉयस एआई के लिए आर्किटेक्चरल परिणामों पर ध्यान केंद्रित करता है।
संबंधित कार्य: नेटिव वॉयस आर्किटेक्चर की ओर विकास
पाइपलाइन ऑर्केस्ट्रेशन। वॉयस एजेंटों के लिए सबसे व्यापक दृष्टिकोण अलग-अलग, स्वतंत्र रूप से प्रशिक्षित मॉडलों को एक अनुक्रमिक पाइपलाइन में संयोजित करता है। व्हिस्पर [Radford et al., 2022] जैसी स्वचालित भाषण पहचान (एएसर) प्रणाली आने वाले ऑडियो को पाठ में ट्रांसक्राइब करती है। GPT-4 [OpenAI, 2023] या LLaMA [Touvron et al., 2023] जैसा एक बड़ा भाषा मॉडल ट्रांसक्रिप्ट को प्रोसेस करता है और एक टेक्स्ट प्रतिक्रिया उत्पन्न करता है। एक टेक्स्ट-टू-स्पीच इंजन प्रतिक्रिया पाठ से ऑडियो को संश्लेषित (सिंथेसाइज) करता है। एक वॉयस एक्टिविटी डिटेक्शन मॉड्यूल यह निर्धारित करता है कि उपयोगकर्ता ने कब बोलना बंद कर दिया है ताकि पाइपलाइन प्रोसेसिंग शुरू कर सके। इस प्रतिमान में इंजीनियरिंग प्रयास विलंबता (लेटेंसी) को कम करने पर केंद्रित है: स्ट्रीमिंग एएसआर, सट्टा डिकोडिंग और स्ट्रीमिंग टीटीएस [Ren et al., 2020]। इन अनुकूलनों को चाहे कितनी भी आक्रामक तरीके से लागू किया जाए, आर्किटेक्चर सख्त अनुक्रमिक निर्भरता लागू करता है जो विलंबता पर एक कठिन सीमा लगाती है और एएसआर-टू-टेक्स्ट सीमा पर भाषा-इतर जानकारी को नष्ट कर देती है।
फ्यूज्ड स्पीच-टू-स्पीच मॉडल। वॉयस आर्किटेक्चर की दूसरी पीढ़ी पाइपलाइन को एक एकल मॉडल में जोड़कर सूचना के नुकसान को संबोधित करने का प्रयास करती है। AudioPaLM [Rubenstein et al., 2023], SpeechGPT [Zhang et al., 2023], और Spirit-LM [Nguyen et al., 2024] जैसे दृष्टिकोण टर्मिनल परतों को हटाते हैं और साझा मध्यवर्ती प्रतिनिधित्वों के माध्यम से स्पीच एनकोडर और डिकोडर को जोड़ते हैं, जिससे चरणों के बीच भावनात्मक और लहजे संबंधी जानकारी के हस्तांतरण को सक्षम किया जा सके। यह संलयन भाषा-इतर निष्ठा में सुधार करता है, लेकिन मौलिक प्रसंस्करण मॉडल सिंक्रोनस और अनुक्रमिक बना रहता है। सिस्टम अभी भी उपयोगकर्ता के बोलना समाप्त करने की प्रतीक्षा करता है, संपूर्ण कथन को प्रोसेस करता है और फिर एक संपूर्ण प्रतिक्रिया उत्पन्न करता है। बातचीत का पैटर्न अभी भी टर्न-आधारित है और सिस्टम तब भी बहरा रहता है जब वह सोच रहा होता है या बोल रहा होता है।
साझा विरासत: ऑनलाइन दुनिया में ऑफलाइन मॉडल। दोनों पीढ़ियों की एक सामान्य वंशावली है: वे पाठ के ऑफ़लाइन, बैच प्रसंस्करण के लिए डिज़ाइन किए गए मॉडलों से उत्पन्न हुए हैं [Vaswani et al., 2017, Brown et al., 2020]। बड़े भाषा मॉडलों को बिना किसी समय आयाम के स्थिर कॉर्पोरा पर प्रशिक्षित किया गया था। भाषण पहचान मॉडल को पूर्ण कथनों को ट्रांसक्राइब करने के लिए प्रशिक्षित किया गया था। भाषण संश्लेषण मॉडल को पूर्ण वाक्यों को प्रस्तुत करने के लिए प्रशिक्षित किया गया था। जब इन मॉडलों को वास्तविक समय में आवाज बातचीत के लिए पुनरुद्देशित किया जाता है, तो उनसे एक ऐसे प्रतिमान में काम करने के लिए कहा जा रहा होता है जो मौलिक रूप से उस प्रतिमान से अलग है जिसके लिए उन्हें डिज़ाइन किया गया था। अगली पीढ़ी को प्रेरित करने वाली अंतर्दृष्टि यह नहीं है कि ये प्रणालियाँ विफल हैं (उन्होंने व्यावसायिक रूप से उपयोगी उत्पाद तैयार किए हैं और अत्याधुनिक स्तर को उन्नत किया है) बल्कि यह कि मानव बातचीत में विशिष्ट गुण होते हैं जिनके लिए मौलिक रूप से भिन्न वास्तुकला आधार की आवश्यकता होती है।
उभरता हुआ विश्व-मॉडल प्रतिमान। वॉयस एआई के समानांतर, व्यापक मशीन लर्निंग समुदाय ने तेजी से विश्व मॉडलों की शक्ति को मान्यता दी है: ऐसी प्रणालियाँ जो अपने पर्यावरण के संपीड़ित आंतरिक प्रतिनिधित्व को बनाए रखती हैं और कच्चे संवेदी डेटा के बजाय उन प्रतिनिधित्वों पर तर्क करती हैं। सुदृढ़ीकरण सीखने (रिएनफोर्समेंट लर्निंग) के लिए विश्व मॉडल पर हा और श्मिटहुबर [2018] के मूलभूत कार्य से लेकर हाफनर एट अल [2020, 2023] के ड्रीमर आर्किटेक्चर और विश्व मॉडल पर आधारित स्वायत्त मशीन इंटेलिजेंस के लिए लेकन के दृष्टिकोण [LeCun, 2022] तक, पैटर्न सुसंगत है: वे प्रणालियाँ जो गुप्त प्रतिनिधित्व (लेटेंट रिप्रेजेंटेशन) पर तर्क करती हैं, वे कच्चे अवलोकनों पर काम करने वाली प्रणालियों की तुलना में बेहतर सामान्यीकरण, दक्षता और अनुकूलन क्षमता प्राप्त करती हैं। हाइड्रा इस प्रतिमान को आवाज तक विस्तारित करता है।
मानव बातचीत को क्या मानव बनाता है
एक ऐसा वॉयस एजेंट बनाने के लिए जो ट्यूरिंग टेस्ट पास करे, हमें यह सटीक रूप से समझना होगा कि उसे किस चीज को दोहराने की आवश्यकता है। मानव संवादात्मक आवाज प्रसंस्करण तीन समवर्ती क्षमताओं द्वारा परिभाषित किया जाता है जो एक साथ और स्वतंत्र रूप से संचालित होती हैं - सुनते हुए सोचना, सुनते हुए कार्य करना और सुनते हुए बोलना [Pickering and Garrod, 2004, Levinson, 2016]। साथ मिलकर, वे तरल, प्रतिक्रियाशील, भावनात्मक रूप से अनुकूल अनुभव पैदा करते हैं जिसे हम प्राकृतिक बातचीत के रूप में पहचानते हैं। इन क्षमताओं के लिए संज्ञानात्मक-विज्ञान के साक्ष्य, इस व्यापक दावे के साथ कि मानव बातचीत को उप-शब्दांश इकाइयों से लेकर वक्ता की मानसिक स्थितियों तक सात कम्प्यूटेशनल स्तरों पर असतत संरचनाओं के आसपास व्यवस्थित किया जाता है, सहवर्ती पत्र [Smallest AI Research, 2026] में समीक्षा की गई है।
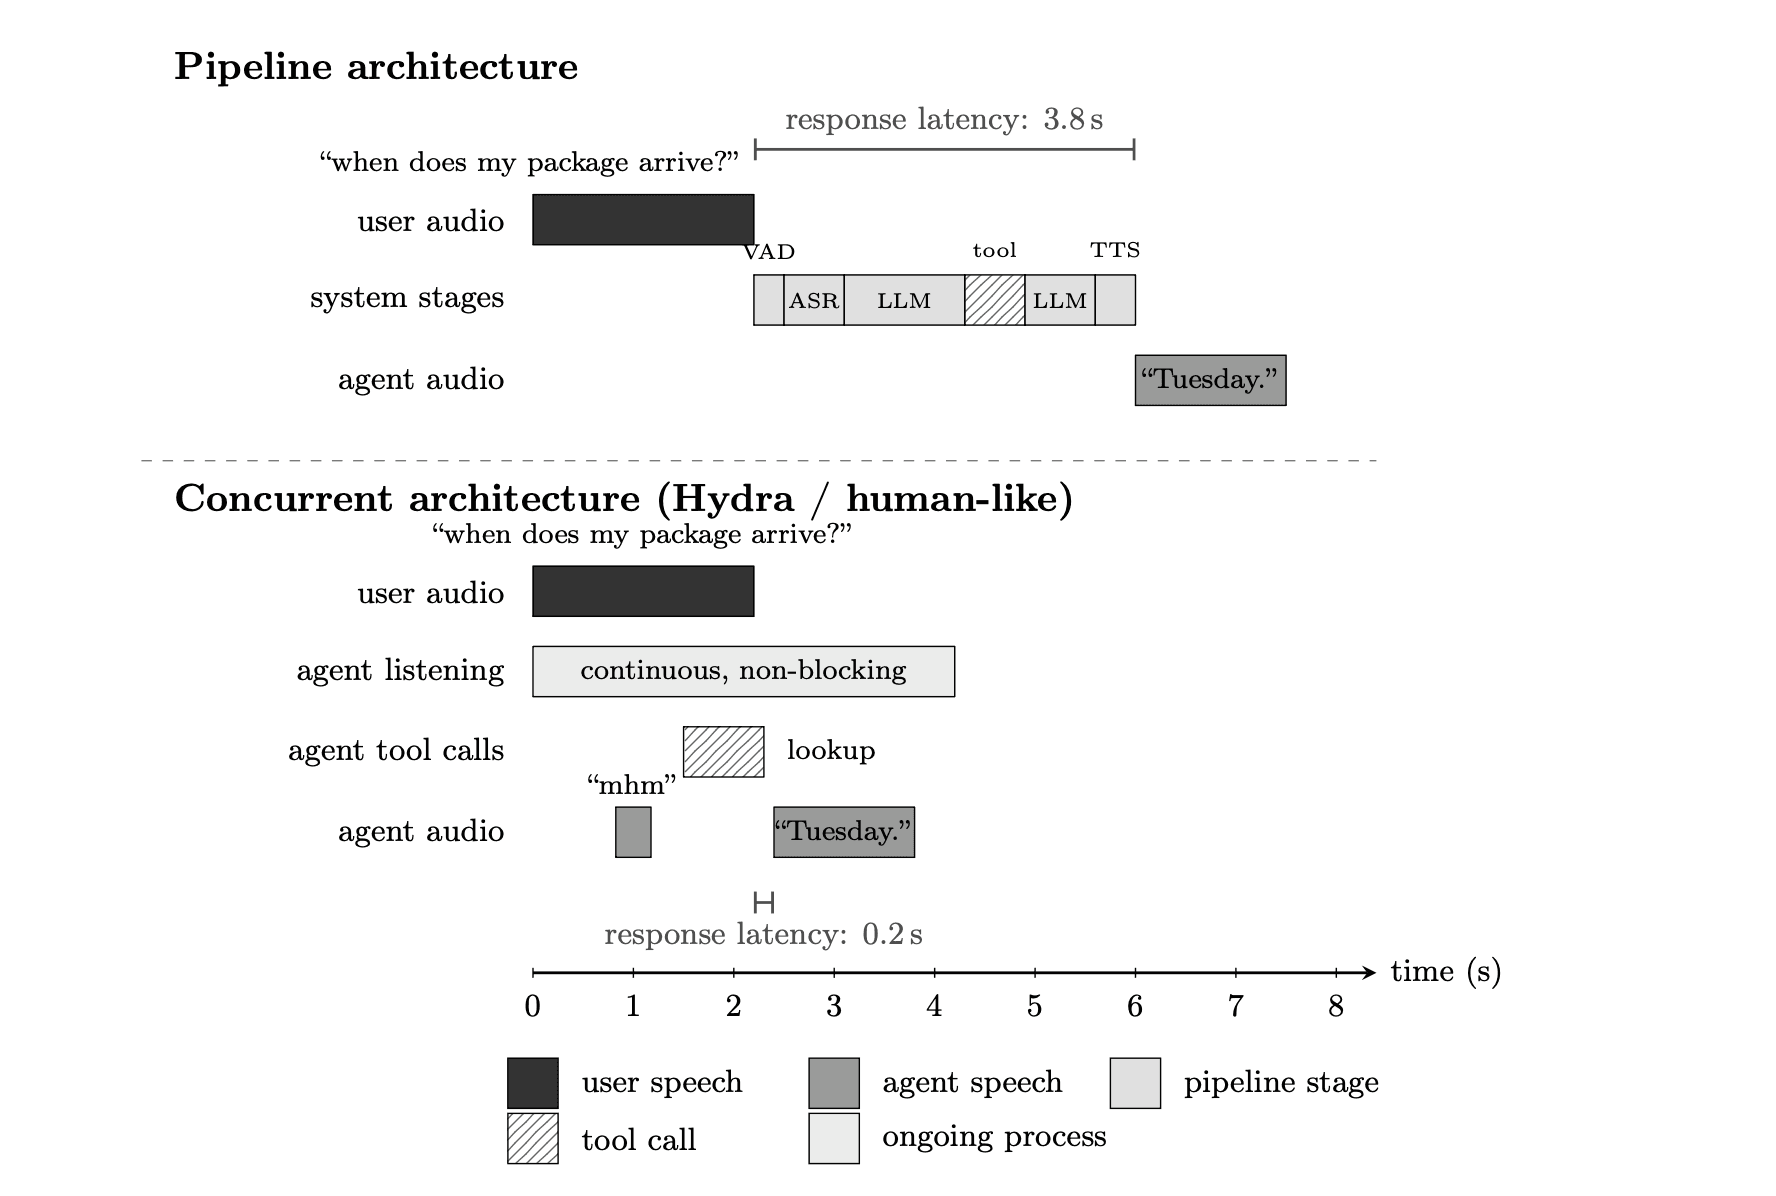
चित्र 1: एक ही उपयोगकर्ता क्वेरी पर पाइपलाइन आर्किटेक्चर बनाम समवर्ती (कन्करेंट) आर्किटेक्चर। दोनों पैनल एक ही समय अक्ष और एक ही आदान-प्रदान को साझा करते हैं: उपयोगकर्ता एक पैकेज-ट्रैकिंग प्रश्न पूछता है और एजेंट प्रतिक्रिया देता है। शीर्ष पैनल: एक पाइपलाइन आर्किटेक्चर चरणों के एक सख्त अनुक्रम (आवाज-गतिविधि पहचान, स्वचालित भाषण पहचान, भाषा-मॉडल अनुमान, टूल कॉल, भाषा-मॉडल जनरेशन, टेक्स्ट-टू-स्पीच) के रूप में आदान-प्रदान को प्रोसेस करता है, जिनमें से प्रत्येक पिछले के पूरा होने की प्रतीक्षा करता है।
एजेंट का उत्तर उपयोगकर्ता का प्रश्न समाप्त होने के 3.8 सेकंड बाद शुरू होता है। निचला पैनल: समवर्ती आर्किटेक्चर एक साझा गुप्त स्थिति (लेटेंट स्टेट) पर गैर-अवरोधक प्रक्रियाओं के एक सेट के रूप में काम करता है। सुनना लगातार चलता रहता है; कथन के बीच में एक बैकचैनल (“मंहम”) उत्पन्न होता है; उपयोगकर्ता के बोलना समाप्त करने से पहले ही टूल कॉल सक्रिय हो जाती है, क्योंकि गुप्त स्थिति पर अनुमान ने संदर्भ और इरादे को पहले ही पहचान लिया है; उत्तर उपयोगकर्ता के अंतिम शब्द के लगभग 200 मिलीसेकंड बाद शुरू होता है।
प्रतिक्रिया शुरू होने का कुल समय 0.2 सेकंड है, जो कि कई गुना तेज है, और बातचीत का पैटर्न संरचनात्मक रूप से मानव बातचीत के बराबर है। आर्किटेक्चरल गुण जो निचले पैनल को संभव बनाते हैं (समवर्ती निष्पादन, साझा गुप्त स्थिति, द्विदिश अनुमान) धारा 4 में विकसित किए गए हैं और चित्र 2 में चित्रित किए गए हैं।
सुनते हुए सोचना। एक मानव श्रोता भाषण के आते ही प्रसंस्करण, व्याख्या और प्रतिक्रियाओं को तैयार करना शुरू कर देता है, न कि वक्ता के समाप्त करने के बाद [Pickering and Garrod, 2004]। समझ एक निरंतर, स्ट्रीमिंग प्रक्रिया है जो श्रवण इनपुट के समानांतर चलती है। जब तक कोई वक्ता वाक्य के अंत तक पहुँचता है, तब तक श्रोता पहले से ही उसके प्रक्षेप पथ का अनुमान लगा चुका होता है, निष्कर्ष निकाल चुका होता है, और अक्सर प्रतिक्रिया तैयार कर चुका होता है। यह समवर्ती अनुभूति ही उप-सेकंड प्रतिक्रिया विलंबता को सक्षम बनाती है जो प्राकृतिक बातचीत की विशेषता है। एक आर्किटेक्चर जो सुनते समय सोचने का समर्थन करता है, उसे अपनी तर्क प्रक्रिया को अपनी इनपुट प्रक्रिया से पूरी तरह से अलग करना होगा।
सुनते हुए कार्य करना। मनुष्य लगातार सुनते हुए भी नियमित रूप से कार्य करते हैं (चीजें खोजना, नोट्स लेना, गणना करना) [Salvucci and Taatgen, 2008]। कॉलर का खाता नंबर प्राप्त करने वाला एक ग्राहक सहायता एजेंट पहले कुछ अंक सुनते ही सिस्टम को खोजना शुरू कर देता है, कॉलर के भाषण पर अपना ध्यान रोके बिना। एक आर्किटेक्चर जो सुनते हुए कार्य करने का समर्थन करता है, उसे अपनी सुनने या तर्क करने की प्रक्रियाओं को निलंबित किए बिना बाहरी उपकरणों को कॉल करना और उनके परिणामों को प्रोसेस करना चाहिए। टूल कॉल गैर-अवरोधक होने चाहिए।
सुनते हुए बोलना: फुल-डुप्लेक्स संचार। मानव बातचीत फुल-डुप्लेक्स है: भाषण उत्पादन और स्वागत एक साथ होता है [Levinson, 2016, Sacks et al., 1974]। बैकचैनलिंग, "मंहम," "सही," "हाँ," का निरंतर प्रवाह वक्ता को बाधित किए बिना जुड़ाव का संकेत देता है। ओवरलैपिंग भाषण, रुकावटें और सहयोगी वाक्य पूरा करना बातचीत की सामान्य विशेषताएं हैं। इनपुट और आउटपुट एक-दूसरे पर गेटेड नहीं होते हैं; वे अतुल्यकालिक होते हैं। प्रत्येक वर्तमान वॉयस आर्किटेक्चर हाफ-डुप्लेक्स मोड में काम करता है, और केवल यही ट्यूरिंग टेस्ट में विफल होने के लिए पर्याप्त है, क्योंकि हाफ-डुप्लेक्स बातचीत तुरंत गैर-मानव के रूप में पहचानी जा सकती है।
हाइड्रा: विश्व मॉडलों के माध्यम से अतुल्यकालिक वॉयस इंटेलिजेंस
हाइड्रा स्मॉलेस्ट एआई (Smallest AI) में विकसित एक आर्किटेक्चर है जो डिज़ाइन द्वारा इन तीनों आवश्यकताओं को पूरा करता है। यह मौजूदा दृष्टिकोणों का अनुकूलन नहीं है बल्कि एक नई नींव है, जिसे इस अंतर्दृष्टि के आधार पर शुरू से बनाया गया है कि वॉयस इंटेलिजेंस को संपीड़ित प्रतिनिधित्वों पर अतुल्यकालिक, समवर्ती प्रसंस्करण की आवश्यकता होती है।
चित्र 2 हाइड्रा के आर्किटेक्चर को दर्शाता है।
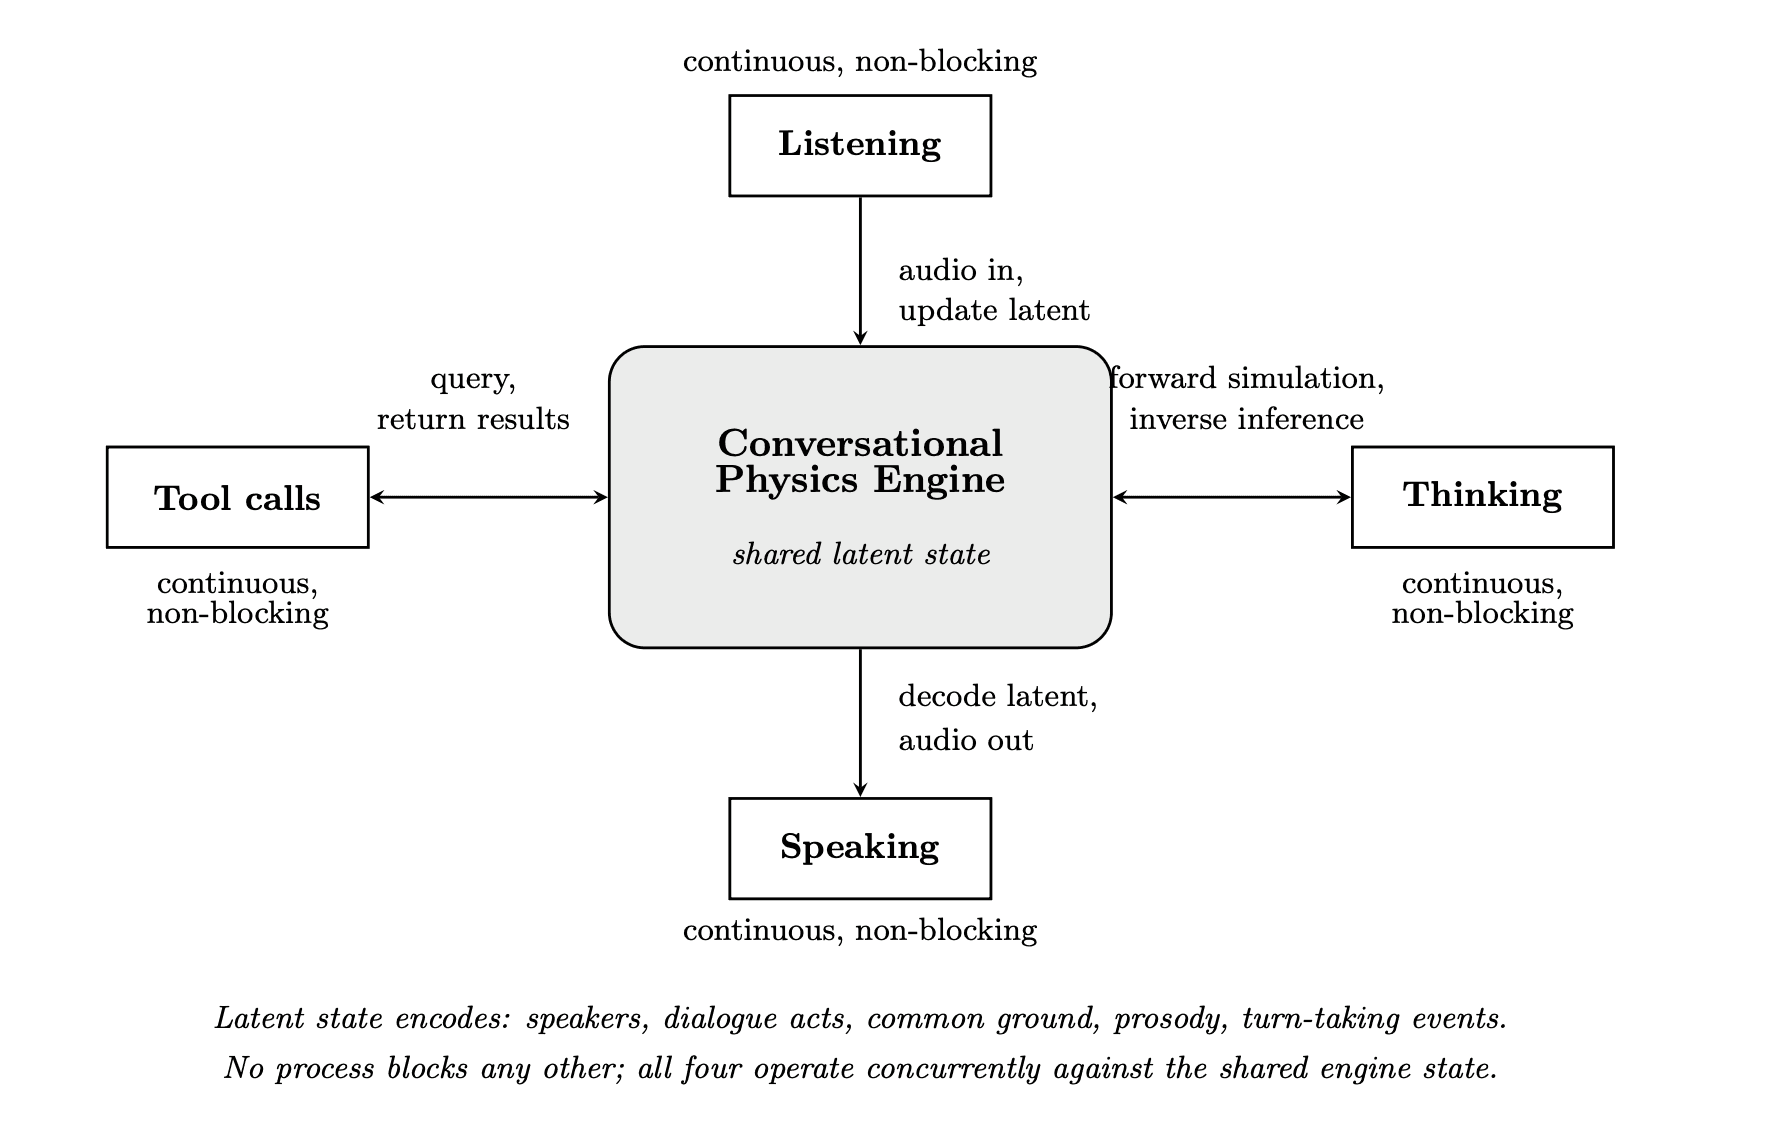
चित्र 2: हाइड्रा का अतुल्यकालिक (असिंक्रोनस) आर्किटेक्चर, जो एक संवादात्मक भौतिकी इंजन के आसपास व्यवस्थित है। केंद्रीय घटक एक संरचित गुप्त स्थिति (लेटेंट स्टेट) है जो बातचीत को एक भौतिक दृश्य के रूप में प्रस्तुत करती है: कौन बोल रहा है, क्या कहा गया था, प्रत्येक वक्ता क्या मानता है, साझा आधार में क्या है, कौन से संवाद कार्य खेल में हैं, और बातचीत वर्तमान में टर्न-टेकिंग चक्र में कहाँ स्थित है।
यह सादृश्य गेम फिजिक्स इंजनों से है, जो वस्तुओं, वेगों और बलों की विश्व स्थिति को बनाए रखते हैं और रेंडरर या इनपुट हैंडलर जो कुछ भी कर रहा है उसके बावजूद लगातार फॉरवर्ड सिमुलेशन चलाते हैं; यहाँ इंजन एक संवादात्मक विश्व स्थिति बनाए रखता है और लगातार भविष्य कहनेवाला सिमुलेशन चलाता है, चाहे सुनने, बोलने या टूल-कॉलिंग सबसिस्टम कुछ भी कर रहे हों। चार प्रक्रियाएं (सुनना, सोचना, बोलना, टूल कॉल) स्वतंत्र, एक साथ निष्पादित होने वाले लूप के रूप में काम करती हैं जो अच्छी तरह से परिभाषित इंटरफेस के माध्यम से साझा इंजन स्थिति से पढ़ती और लिखती हैं। उनके बीच कोई पाइपलाइन क्रम नहीं है और कोई भी किसी अन्य को अवरुद्ध नहीं करता है।
संज्ञानात्मक-विज्ञान के साक्ष्य कि मानव संवादात्मक तर्क बिल्कुल इस प्रकार के संरचित, द्विदिश, जनरेटिव इंजन के रूप में काम करते हैं, की समीक्षा सहवर्ती पत्र में की गई है।
अतुल्यकालिक प्रक्रिया आर्किटेक्चर। हाइड्रा का मुख्य नवाचार आर्किटेक्चरल है: सुनना, सोचना, बोलना और टूल-कॉलिंग स्वतंत्र, एक साथ निष्पादित होने वाली प्रक्रियाओं के रूप में काम करते हैं जो साझा गुप्त स्थिति के माध्यम से संवाद करते हैं। कोई पाइपलाइन नहीं है, कोई अनुक्रमिक निर्भरता नहीं है, और कोई टर्न-आधारित इंटरैक्शन मॉडल नहीं है। सुनने की प्रक्रिया लगातार ऑडियो को ग्रहण करती है और साझा गुप्त स्थिति को अपडेट करती है। सोचने की प्रक्रिया उस स्थिति पर लगातार तर्क करती है, चाहे सुनना सक्रिय हो या न हो। बोलने की प्रक्रिया तर्क की स्थिति से आउटपुट ऑडियो उत्पन्न करती है, चाहे नया इनपुट आ रहा हो या न हो। टूल-कॉलिंग प्रक्रियाएं पृष्ठभूमि में निष्पादित होती हैं और किसी अन्य प्रक्रिया को अवरुद्ध किए बिना परिणामों को वापस साझा स्थिति में भेजती हैं। यह अतुल्यकालिक डिज़ाइन सीधे मानव बातचीत के तीन गुणों को दर्शाता है। सिस्टम सुनते हुए सोचता है क्योंकि सोचना और सुनना स्वतंत्र प्रक्रियाएं हैं। यह सुनते हुए कार्य करता है क्योंकि टूल कॉल गैर-अवरोधक होते हैं। यह सुनते हुए बोलता है क्योंकि भाषण उत्पादन और स्वागत अलग-अलग होते हैं। परिणाम एक ऐसी प्रणाली है जिसकी संवादात्मक गतिशीलता पहली बार संरचनात्मक रूप से मानव संवादी के समान है।
लेटेंट-स्पेस वर्ल्ड मॉडल। हाइड्रा, अपने मूल में, आवाज के लिए एक विश्व मॉडल है। जैसे ही निरंतर ऑडियो इनपुट आता है, हाइड्रा इसे एक सघन गुप्त स्थान (लेटेंट स्पेस) में संपीड़ित करता है जो भाषण संकेत की पूरी समृद्धि को सुरक्षित रखता है: न केवल शाब्दिक सामग्री, बल्कि लहजा, भावना, झिझक के पैटर्न, बोलने की दर, जोर और सूक्ष्म समय। यह गुप्त प्रतिनिधित्व संवादात्मक दुनिया का सिस्टम का आंतरिक मॉडल है: संवाद में जो कुछ भी हो रहा है उसका एक निरंतर अद्यतन, संपीड़ित प्रतिनिधित्व। फिर एक ऑटोरोग्रेसिव मॉडल इस गुप्त स्थान पर काम करता है, बातचीत की अगली स्थितियों की भविष्यवाणी करता है और उत्पन्न करता है। चूँकि इंटेलिजेंस परत उच्च-आयामी असतत टोकन के बजाय कॉम्पैक्ट गुप्त प्रतिनिधित्वों पर तर्क करती है, हाइड्रा असाधारण पैरामीटर दक्षता प्राप्त करता है। संवादात्मक क्षमता का वही स्तर जिसके लिए टोकन-आधारित भाषा मॉडल में सैकड़ों अरबों मापदंडों की आवश्यकता होगी, एक लेटेंट-स्पेस विश्व मॉडल में प्राप्त किया जा सकता है जो सौ से एक हजार गुना छोटा है। यह कोई मामूली दक्षता लाभ नहीं है; यह एक आर्किटेक्चरल बदलाव है जो वॉयस एआई के अर्थशास्त्र और परिनियोजन परिदृश्य को पूरी तरह से बदल देता है।
गुप्त स्थान सच्ची आवाज की समझ को क्यों सक्षम बनाता है। गुप्त प्रतिनिधित्वों पर काम करने का विकल्प केवल एक दक्षता अनुकूलन नहीं है: यह वास्तविक आवाज की समझ की कुंजी है। जब आवाज को पाठ में ट्रांसक्राइब किया जाता है, तो ट्रांसक्रिप्शन भाषण संकेत द्वारा ले जाई जाने वाली अधिकांश जानकारी को छोड़ देता है। समान शब्दों वाले लेकिन अलग-अलग लहजे, समय और भावनात्मक स्वर वाले दो कथन एक ही ट्रांसक्रिप्ट तैयार करेंगे। एक टेक्स्ट-आधारित मॉडल सचमुच उनके बीच अंतर नहीं बता सकता। एक लेटेंट-स्पेस विश्व मॉडल इस जानकारी को सुरक्षित रखता है क्योंकि गुप्त प्रतिनिधित्व सीधे कच्चे ऑडियो से प्राप्त होता है, न कि किसी टेक्स्ट मध्यस्थ से। मॉडल एक ऐसे प्रतिनिधित्व पर तर्क करता है जो यह कैप्चर करता है कि क्या कहा गया था, इसे कैसे कहा गया था, और यह कब कहा गया था: संपूर्ण संचार कार्य, न कि केवल उसकी पाठ्य छाया। गुप्त स्थान असंरचित नहीं है; यह एक सीखा हुआ संपीड़न है जो बातचीत की श्रेणीबद्ध संरचना (ध्वन्यात्मक इकाइयाँ, लहजे की श्रेणियां, संवाद कार्य, टर्न-टेकिंग घटनाएं, साझा-आधार स्थिति) को सुरक्षित रखता है जिसे संज्ञानात्मक विज्ञान ने कम्प्यूटेशनल स्तर पर स्वतंत्र रूप से पहचाना है [Smallest AI Research, 2026]।
बुद्धिमत्ता के दो दृष्टिकोण: सब कुछ सहेजें या संपीड़ित करें और अनुकूलित करें
मुख्य डिज़ाइन प्रश्न संरचना और पैमाने (स्ट्रक्चर एंड स्केल) के बीच का संबंध है। आधुनिक बड़े भाषा मॉडल एक उत्तर का प्रतिनिधित्व करते हैं: पैमाने के लिए प्रतिबद्ध होना, मापदंडों में सब कुछ संग्रहीत करना, और विश्वास करना कि दुनिया की संरचना पर्याप्त डेटा और पर्याप्त कंप्यूट की एक आकस्मिक संपत्ति के रूप में पुनर्प्राप्त हो जाएगी। हाइड्रा एक अलग उत्तर का प्रतिनिधित्व करता है: दोनों के लिए प्रतिबद्ध होना। संरचना का सीधे निर्माण करें, पैमाने का उपयोग वहाँ करें जहाँ यह अपनी उपयोगिता साबित करता है (अनुभवात्मक परत, गुप्त संपीड़न, भविष्य कहनेवाला गतिशीलता), और संरचना को वह काम करने दें जो केवल पैमाना कुशलता से नहीं कर सकता। यह संरचना और पैमाना है, न कि केवल पैमाना, और यही वह डिज़ाइन सिद्धांत है जिस पर हाइड्रा का निर्माण किया गया है।
चित्र 3 वर्तमान विकल्पों के सापेक्ष संरचना-और-पैमाने के डिज़ाइन स्पेस में हाइड्रा की स्थिति दिखाता है।
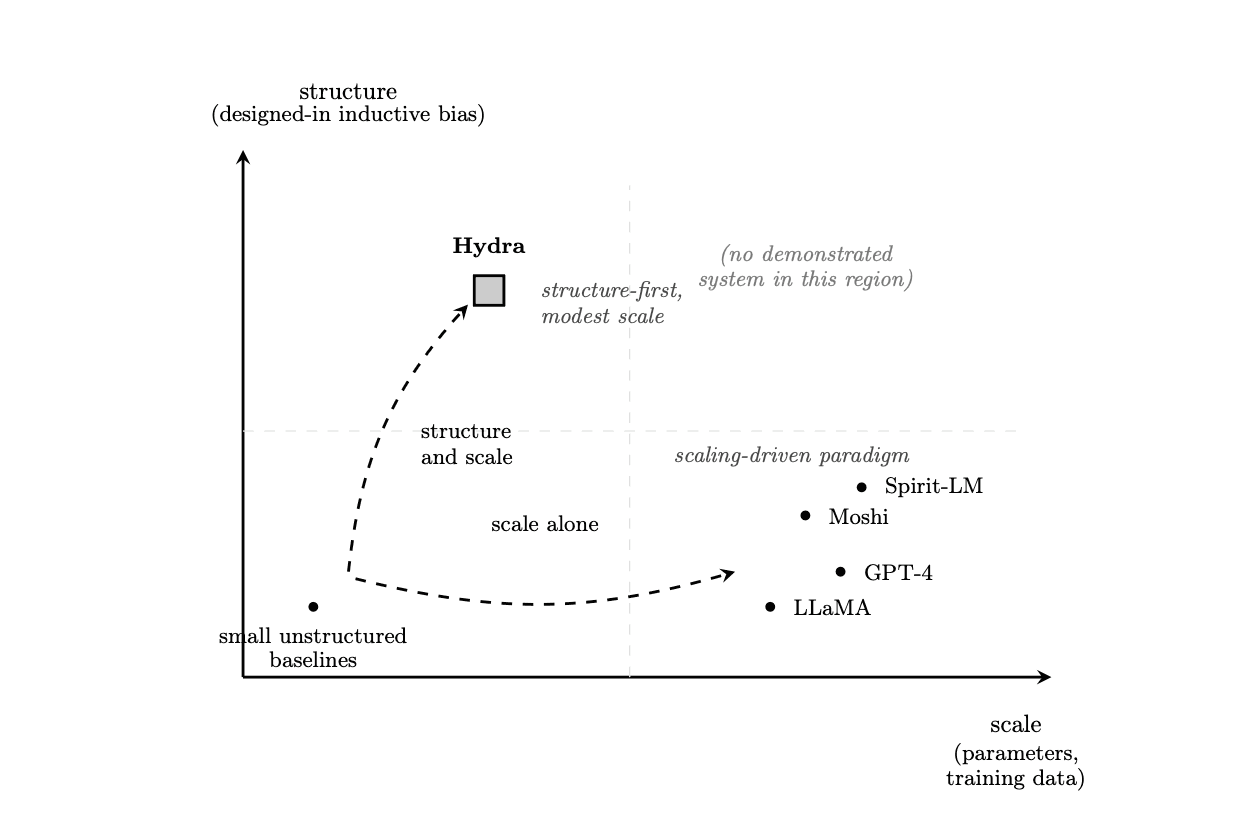
चित्र 3: आवाज और संवादात्मक एआई प्रणालियों के लिए संरचना-और-पैमाना डिज़ाइन स्थान। क्षैतिज अक्ष पैमाने (पैरामीटर संख्या, प्रशिक्षण-डेटा मात्रा) का प्रतिनिधित्व करता है; ऊर्ध्वाधर अक्ष डिज़ाइन-इन संरचनात्मक प्रेरक पूर्वाग्रह की डिग्री का प्रतिनिधित्व करता है (जिस हद तक सिस्टम का आर्किटेक्चर उन प्रतिनिधित्वों के प्रति प्रतिबद्ध है जो संज्ञानात्मक विज्ञान मानव संवादात्मक तर्क को देता है)। समकालीन फाउंडेशन मॉडल नीचे-दाएं चतुर्थांश, बड़े पैमाने, कम डिज़ाइन-इन संरचना पर कब्जा करते हैं, जिसमें जो भी संवादात्मक संरचना मौजूद है उसे प्रशिक्षण की एक आकस्मिक संपत्ति के रूप में पुनर्प्राप्त करने के लिए छोड़ दिया जाता है। हाइड्रा ऊपरी-बाएँ क्षेत्र पर कब्जा करता है: चित्र 2 का संवादात्मक भौतिकी इंजन डिज़ाइन द्वारा संरचनात्मक रूप से प्रतिबद्ध है, और पैमाना वहाँ केंद्रित है जहाँ यह अपनी उपयोगिता साबित करता है (अनुभवात्मक परत, गुप्त संपीड़न, भविष्य कहनेवाला गतिशीलता) न कि पूरे सिस्टम में फैला हुआ है। खंडित तीर एक ही शुरुआती बिंदु से दो डिज़ाइन पथों को दिखाते हैं। यह वह स्थिति है जिसे संरचना और पैमाना कहा गया है, न कि केवल पैमाना: पैमाने की अस्वीकृति नहीं बल्कि एक दावा कि संरचना को इसके साथ होना चाहिए।
दृष्टिकोण एक: मॉडल में सब कुछ संग्रहीत करना। पहला दृष्टिकोण, जिसे समकालीन बड़े भाषा मॉडलों [OpenAI, 2023, Touvron et al., 2023, Vaswani et al., 2017, Brown et al., 2020] द्वारा उदाहरण दिया गया है, वास्तविक दुनिया के टोकन पर प्रशिक्षण देना और मॉडल के मापदंडों में यथासंभव अधिक जानकारी संग्रहीत करना है। मॉडल याद रखता है कि दुनिया में क्या हुआ है (तथ्य, पैटर्न, प्रक्रियाएं, संबंध) और इन सभी को अपने वजन (weights) में एनकोड करता है। इस दृष्टिकोण का लाभ व्यापकता है: पर्याप्त रूप से बड़े डेटासेट पर प्रशिक्षित एक पर्याप्त रूप से बड़ा मॉडल विषयों की एक असाधारण श्रृंखला के बारे में प्रश्नों के उत्तर दे सकता है। जब पूछा जाता है, उदाहरण के लिए, कि आईफोन के सटीक आयाम क्या हैं, तो एक एलएलएम शायद एक सटीक उत्तर दे सकता है यदि यह जानकारी प्रशिक्षण डेटा में मौजूद थी। नुकसान मौलिक है: दुनिया हर सेकंड नई जानकारी उत्पन्न करती है, और कोई भी निश्चित आकार का पैरामीटर स्थान इसके साथ तालमेल नहीं रख सकता है। यदि आप मॉडल परतों में सभी जानकारी संग्रहीत करना जारी रखते हैं, तो अंततः आपके पास जगह समाप्त हो जाएगी। अधिक ज्ञान को समायोजित करने के लिए मॉडल को स्केल करने से प्रत्येक अनुमान की कम्प्यूटेशनल लागत भी बढ़ जाती है, भले ही संग्रहीत ज्ञान का विशाल बहुमत वर्तमान कार्य के लिए अप्रासंगिक हो।
दृष्टिकोण दो: संपीड़ित करें और याद रखें जो महत्वपूर्ण है। दूसरा दृष्टिकोण, जिसे हाइड्रा अपनाता है, उसमें शामिल है (ए) जानकारी को संपीड़ित करना और केवल उसी पर तर्क करना जो दुनिया की स्थिति की भविष्यवाणी करने और वर्तमान कार्यों के वितरण को अधिक कुशलता से करने के लिए आवश्यक है; और (बी) केवल वही याद रखना जो वर्तमान कार्यों के लिए प्रासंगिक है और बाकी सब चीजों के लिए दीर्घकालिक स्मृति पर भरोसा करना। इसके साथ, संपूर्ण दुनिया को याद रखने के बजाय, मॉडल उन संपीड़ित प्रतिनिधित्वों का निर्माण करना सीखता है जो इसके इनपुट डोमेन की आवश्यक संरचना और गतिशीलता को कैप्चर करते हैं। यह तर्क करने, अनुमान लगाने, भविष्यवाणी करने के तर्क को संग्रहीत करता है, न कि दुनिया के बारे में तथ्यों की समग्रता को। यह मानव मस्तिष्क की बारीकी से नकल करता है। एक सॉफ्टवेयर इंजीनियर को शायद हाइड्रोजन और ऑक्सीजन के लिए प्रतिक्रिया की दर याद नहीं होगी; हालाँकि, यह देखते हुए कि एक सॉफ्टवेयर इंजीनियर एसटीईएम (STEM) पृष्ठभूमि से आता है, वह प्रेरित होने पर, स्कूल की सही रसायन विज्ञान पाठ्यपुस्तक का संदर्भ ले सकेगा और प्रश्न का उत्तर दे सकेगा। एक अन्य उदाहरण है जब आईफोन के सटीक आयामों जैसे कि ऊंचाई, चौड़ाई और लंबाई के बारे में पूछा जाता है: अधिकांश मनुष्य उत्तर देने में सक्षम नहीं होंगे, हालांकि वे प्रेरित होने पर, एक मापने वाला टेप ला सकते हैं और पता लगा सकते हैं। इन तथ्यों को मस्तिष्क के अंदर संग्रहीत करना अक्षम और मनुष्य की दैनिक दिनचर्या के लिए अनावश्यक है। बुद्धिमत्ता के दोनों दृष्टिकोणों के वैध फायदे हैं, और कोई भी दोनों दिशाओं में ट्रेडऑफ़ पर बहस कर सकता है। हालाँकि, दीर्घकालिक रूप से जो स्केलेबल और मानव बुद्धिमत्ता के करीब है वह स्पष्ट है: आपको संपीड़ित प्रतिनिधित्वों पर प्रशिक्षित करना होगा और आपको केवल वही याद रखना होगा जो प्रासंगिक है, क्योंकि हर बीतते सेकंड के साथ दुनिया में असीमित जानकारी उत्पन्न हो रही है और आप सब कुछ याद नहीं रख सकते। यह अधिक सामान्य स्थिति का एक विशिष्ट उदाहरण है जिसका सहवर्ती पत्र [Smallest AI Research, 2026] में बचाव किया गया है: संरचना और पैमाना, न कि केवल पैमाना। फिर सबसे कठिन चुनौती उत्तर देना है: क्या याद रखना है और क्या भूलना है?
स्मृति से बुद्धिमत्ता का पृथक्करण। यह अंतर्दृष्टि स्वाभाविक रूप से एक सिद्धांत की ओर ले जाती है जिसे हम स्मृति से बुद्धिमत्ता का पृथक्करण कहते हैं। हाइड्रा की बुद्धिमत्ता परतें तर्क के लिए समर्पित हैं: कैसे विचार करना है, कैसे निष्कर्ष निकालना है, बातचीत कैसे संचालित करनी है, यह कैसे पहचानना है कि बाहरी जानकारी की आवश्यकता कब है, और इसे कैसे पुनः प्राप्त करना है। तथ्यात्मक ज्ञान एक बाहरी मेमोरी सिस्टम (पुनर्प्राप्ति-संवर्धित डेटाबेस, टूल एपीआई, डोमेन-विशिष्ट ज्ञान आधार) में रहता है जिसे मॉडल सीखे गए टूल-कॉलिंग व्यवहार के माध्यम से एक्सेस करता है। बुद्धिमत्ता जानती है कि कैसे सोचना है; स्मृति जानती है कि किस बारे में सोचना है। यह अलगाव ही कॉम्पैक्ट, कुशल मॉडलों को न केवल संभव बल्कि आर्किटेक्चरल रूप से इष्टतम बनाता है।
अनुमान-समय अनुकूलन और विशेषज्ञता का मार्ग
स्मृति से बुद्धिमत्ता का पृथक्करण एक स्वाभाविक प्रश्न उठाता है: परिनियोजन के दौरान हाइड्रा कैसे सीखता और अनुकूलित होता है? यहीं पर हाइड्रा के सबसे विशिष्ट गुणों में से एक उभरता है।
गुप्त तत्वों (लेटेंट्स) पर समय-श्रृंखला हानि (टाइम-सीरीज़ लॉस)। चूंकि हाइड्रा संपीड़ित गुप्त प्रतिनिधित्वों पर एक विश्व मॉडल के रूप में काम करता है, इसका मुख्य कार्य भविष्यवाणी करना है: दी गई वर्तमान गुप्त स्थिति को देखते हुए, संवादात्मक दुनिया की अगली स्थिति की भविष्यवाणी करना। लेटेंट्स अनिवार्य रूप से दुनिया का एक भविष्य कहनेवाला दृष्टिकोण हैं, बातचीत में आगे क्या होगा इसका एक संपीड़ित पूर्वानुमान। जब भविष्यवाणी गलत होती है, जब वास्तविक अगली स्थिति अनुमानित स्थिति से अलग हो जाती है, तो हाइड्रा विसंगति को मापने और ठीक करने के लिए गुप्त स्थान पर एक समय-श्रृंखला हानि फ़ंक्शन लागू कर सकता है। यह पारंपरिक भाषा मॉडल में उपयोग किए जाने वाले टोकन-स्तरीय क्रॉस-एन्ट्रॉपी लॉस से मौलिक रूप से भिन्न सीखने का संकेत है। गुप्त तत्वों पर एक समय-श्रृंखला हानि बातचीत की सामयिक गतिशीलता (विषयों का उतार-चढ़ाव, भावनात्मक स्थितियों का विकास, टर्न-टेकिंग की लय) को अमूर्तता के स्तर पर कैप्चर करती है जो टोकन-स्तरीय भविष्यवाणी की तुलना में समृद्ध और अधिक कॉम्पैक्ट दोनों है। यह हाइड्रा को वास्तविक समय की बातचीत की संरचना से इस तरह सीखने में सक्षम बनाता है जो टेक्स्ट-आधारित मॉडल आर्किटेक्चरल रूप से नहीं कर सकते।
अनुमान-समय अधिगम (इन्फ्रेंस-टाइम लर्निंग)। गुप्त तत्वों पर समय-श्रृंखला हानि अनुमान-समय सीखने का द्वार खोलती है: वास्तविक समय में, परिनियोजन के दौरान अनुकूलन और सुधार करने की क्षमता। जैसे ही हाइड्रा वास्तविक बातचीत को प्रोसेस करता है, दुनिया के उसके भविष्य कहने वाले मॉडल का लगातार वास्तविकता के खिलाफ परीक्षण किया जाता है। जब भविष्यवाणियां विफल हो जाती हैं, तो सिस्टम भविष्य की भविष्यवाणियों को बेहतर बनाने के लिए अपने आंतरिक वजन को समायोजित करता है। यह वही बुनियादी तंत्र है जिसके माध्यम से मनुष्य बातचीत से सीखते हैं; हम अपेक्षाएँ बनाते हैं, परिणामों का निरीक्षण करते हैं, और तदनुसार दुनिया के अपने मॉडल को अपडेट करते हैं [Clark, 2013]। हालांकि अनुमान-समय अधिगम पूरी तरह से हल नहीं हुआ है, हमने शुरुआती परिणाम देखे हैं जो उत्साहजनक हैं, और हमारा दृढ़ विश्वास है कि भविष्य गुप्त प्रतिनिधित्वों पर समय-श्रृंखला हानि कार्यों में निहित है। यह तंत्र बुद्धिमत्ता को स्मृति से वास्तविक रूप से अलग करने में सक्षम बनाता है: बुद्धिमत्ता परतें भविष्यवाणी करना और तर्क करना सीखती हैं, जबकि मेमोरी सिस्टम विशिष्ट भविष्यवाणियों के लिए आवश्यक तथ्य और संदर्भ प्रदान करता है। अनुमान-समय अधिगम हाइड्रा को वर्तमान कार्य के लिए जो महत्वपूर्ण है उसे याद रखने और जो नहीं है उसे जाने देने की अनुमति देता है।
कृत्रिम विशेष बुद्धिमत्ता (आर्टिफिशियल स्पेशल इंटेलिजेंस)। अतुल्यकालिक आर्किटेक्चर, गुप्त-स्थान तर्क, बुद्धिमत्ता-स्मृति पृथक्करण, और अनुमान-समय अधिगम का संयोजन एक नई क्षमता की ओर ले जाता है जिसे हम कृत्रिम विशेष बुद्धिमत्ता (ASI) कहते हैं। विशेष बुद्धिमत्ता से हमारा तात्पर्य उन मॉडलों से नहीं है जो किसी संकीर्ण डोमेन के लिए ठीक से ट्यून की गई विशिष्ट, स्थिर प्रणालियाँ हैं। हमारा तात्पर्य उन मॉडलों से है जिनमें वास्तविक समय में त्वरित विशेषज्ञता प्राप्त करने की क्षमता है, और जिनके लिए विशेषज्ञता अत्यधिक कुशल है। यह कुशल बुद्धिमत्ता है, ठीक उसी तरह जैसे मानव बुद्धिमत्ता कुशल है। एक ठोस उदाहरण पर विचार करें: एक वित्तीय उद्यम में ग्राहक सहायता के लिए तैनात एक वॉयस एजेंट। एजेंट सामान्य प्रयोजन तर्क क्षमताओं और डोमेन-प्रासंगिक टूल और ज्ञान आधारों तक पहुंच के साथ आता है। जैसे ही यह वास्तविक बातचीत को प्रोसेस करता है, यह तेजी से सीखता है कि कौन से पैटर्न, तथ्य और टूल-कॉलिंग रणनीतियाँ इसके ऑपरेटिंग डोमेन के लिए सबसे अधिक प्रासंगिक हैं। कम संख्या में बातचीत चक्रों के भीतर, मॉडल एक विशेषज्ञ बन जाता है, इसलिए नहीं कि किसी ने इसे फाइन-ट्यून किया है, बल्कि इसलिए कि इसने उपयोग के माध्यम से खुद को विशेषज्ञ बनाना सीख लिया है। अप्रासंगिक जानकारी को कम प्राथमिकता दी जाती है। मॉडल अपने विशेष कार्य में कुशल हो जाता है। यही वह समझ है जिसमें छोटे मॉडल शक्तिशाली बन जाते हैं। एक कॉम्पैक्ट तर्क कोर जो किसी भी परिनियोजन संदर्भ में जल्दी और कुशलता से अनुकूलित हो सकता है, एक विशाल मॉडल की तुलना में आर्किटेक्चरल रूप से बेहतर है जो अपनी क्षमता को हर डोमेन में कम कर देता है। क्षमता का माप कुल पैरामीटर गणना नहीं बल्कि तर्क कोर की दक्षता और अनुकूलनशीलता है [Lake et al., 2017]।
हाइड्रा, आवाज का भविष्य
अब हम इस बात की पूरी तस्वीर पेश कर सकते हैं कि कैसे हाइड्रा का आर्किटेक्चर वॉयस एआई में, और अधिक व्यापक रूप से, स्वयं बुद्धिमत्ता में एक नए युग की ओर इशारा करता है।
आवाज मानव बुद्धिमत्ता का मूल तौर-तरीका (नेटिव मोडैलिटी) है: एक वास्तविक, निरंतर, अस्थायी रूप से स्थापित भौतिक संकेत। वॉयस एआई के वर्तमान दृष्टिकोण, पाइपलाइन ऑर्केस्ट्रेशन और फ्यूज्ड स्पीच-टू-स्पीच मॉडल दोनों, आवाज को टेक्स्ट प्रोसेसिंग के चारों ओर एक आवरण के रूप में मानते हैं, जो अपनी टेक्स्ट-केंद्रित विरासत के अनुक्रमिक, टर्न-आधारित, हाफ-डुप्लेक्स बाधाओं को विरासत में प्राप्त करते हैं। ये प्रणालियाँ मूल्यवान रही हैं और इस क्षेत्र को उन्नत किया है, लेकिन वे मानव बातचीत की समवर्ती, अतुल्यकालिक, फुल-डुप्लेक्स प्रकृति को दोहरा नहीं सकती हैं।
हाइड्रा एक मौलिक रूप से भिन्न आधार प्रदान करता है। आवाज को मूल तौर-तरीके के रूप में मानकर, इसे एक गुप्त स्थान में संपीड़ित करके, और एक अतुल्यकालिक आर्किटेक्चर के साथ उन संपीड़ित प्रतिनिधित्वों पर तर्क करके जहां सुनना, सोचना, बोलना और कार्य करना सभी स्वतंत्र प्रक्रियाएं हैं, हाइड्रा पहली बार संवादात्मक गतिशीलता प्राप्त करता है जो संरचनात्मक रूप से मानव बातचीत के बराबर है।
हाइड्रा के मूल में स्थित लेटेंट-स्पेस विश्व मॉडल टोकन-आधारित मॉडलों की तुलना में सौ से एक हजार गुना अधिक पैरामीटर दक्षता लाभ सक्षम बनाता है, जिससे वास्तविक समय वॉयस इंटेलिजेंस को एज हार्डवेयर और उपभोक्ता जीपीयू पर तैनात करना संभव हो जाता है। बुद्धिमत्ता का स्मृति से पृथक्करण का अर्थ है कि मॉडल की क्षमताएं उसके मेमोरी सिस्टम के साथ बढ़ती हैं, न कि उसकी पैरामीटर गणना के साथ। और गुप्त तत्वों पर समय-श्रृंखला हानि के माध्यम से अनुमान-समय अधिगम तीव्र, कुशल विशेषज्ञता को सक्षम बनाता है, जो कृत्रिम विशेष बुद्धिमत्ता की नींव है।
यद्यपि गुप्त प्रतिनिधित्वों पर अनुमान-समय अधिगम अनुसंधान का एक सक्रिय क्षेत्र है, और अनुकूलन की गतिशीलता, सीखे गए प्रतिनिधित्वों की स्थिरता, और अनुमान समय पर क्या सीखा जा सकता है बनाम प्रशिक्षण के दौरान क्या सीखा जाना चाहिए की सीमाओं के बारे में कई खुले प्रश्न बने हुए हैं, हमने शुरुआती परिणाम देखे हैं जो इस दिशा को मान्य करते हैं, और हमारा दृढ़ विश्वास है कि यह कुशल बुद्धिमत्ता का भविष्य है: कॉम्पैक्ट तर्क कोर जो सोचना सीखते हैं, जो जानने की आवश्यकता है उसे एक्सेस करते हैं, और वास्तविक समय में कार्य के अनुकूल बनते हैं। वास्तविक समय की आवाज में ट्यूरिंग टेस्ट पास करने का मार्ग कभी बड़े मॉडलों या कभी तेज पाइपलाइनों से होकर नहीं गुजरता है। यह उन आर्किटेक्चरों से होकर गुजरता है जो दर्शाते हैं कि बुद्धिमत्ता वास्तव में कैसे काम करती है: समवर्ती, अतुल्यकालिक, अस्थायी रूप से स्थापित, और सही संरचनात्मक नींव पर निर्मित। यह संरचना और पैमाना है, न कि केवल पैमाना; यही हाइड्रा है, और वॉयस एआई इसी दिशा में जा रहा है।
भविष्य की दिशाएं
कृत्रिम विशेष बुद्धिमत्ता को बेंचमार्क करना। पारंपरिक बेंचमार्क निश्चित कार्यों पर स्थिर क्षमताओं को मापते हैं। कृत्रिम विशेष बुद्धिमत्ता के लिए नए मूल्यांकन पद्धतियों की आवश्यकता होती है जो अनुकूलन गति को मापती हैं: मॉडल कितनी जल्दी एक नए डोमेन में विशेषज्ञता हासिल करता है, N वास्तविक बातचीत के बाद प्रदर्शन में कितना सुधार होता है, यह डोमेन बहाव को कितनी शालीनता से संभालता है, और यह अप्रासंगिक जानकारी को कितनी कुशलता से भूल जाता है। प्रगति पर नज़र रखने और आर्किटेक्चरल निर्णय लेने के लिए इन बेंचमार्कों को विकसित करना महत्वपूर्ण है।
मेमोरी आर्किटेक्चर और टूल एकीकरण। बुद्धिमत्ता-स्मृति अलगाव के लिए परिष्कृत मेमोरी आर्किटेक्चर की आवश्यकता होती है जो कुशल पुनर्प्राप्ति, प्रतिकूल प्रश्नों के तहत शालीन गिरावट, और अनुमान-समय सीखने की गतिशीलता के साथ कड़े एकीकरण का समर्थन करते हैं। पुनर्प्राप्ति रणनीतियों, मेमोरी इंडेक्सिंग, अपडेट तंत्र और मेमोरी-तर्क इंटरफ़ेस में अनुसंधान कोर मॉडल आर्किटेक्चर में प्रगति का एक अनिवार्य साथी है।
एक ट्यूरिंग टेस्ट मूल्यांकन प्रोटोकॉल। इस क्षेत्र को विशेष रूप से वास्तविक समय की आवाज बातचीत के लिए डिज़ाइन किए गए एक कठोर मूल्यांकन प्रोटोकॉल की आवश्यकता है। मौजूदा ट्यूरिंग टेस्ट फॉर्मूलेशन टेक्स्ट-आधारित संवाद [Turing, 1950] को लक्षित करते हैं और उन सामयिक, लहजे संबंधी और भाषा-इतर आयामों को कैप्चर नहीं करते हैं जो आवाज के लिए केंद्रीय हैं। एक आवाज-विशिष्ट प्रोटोकॉल को सामग्री की गुणवत्ता के साथ-साथ प्रतिक्रिया समय, भावनात्मक उपयुक्तता, रुकावट से निपटने, बैकचैनलिंग व्यवहार और टर्न गतिशीलता की स्वाभाविकता का मूल्यांकन करना चाहिए।
एंड-टू-एंड व्यावसायिक प्रक्रिया स्वचालन को मापना। अंततः, वॉयस एआई का व्यावहारिक परीक्षण यह है कि क्या यह एंड-टू-एंड व्यावसायिक प्रक्रियाओं को पूरी तरह से स्वचालित कर सकता है जिन्हें वर्तमान में मानव एजेंटों द्वारा आवाज पर संभाला जाता है। ग्राहक सहायता, बिक्री, शेड्यूलिंग, ट्राइएज, ऑनबोर्डिंग, अनुपालन: ये ऐसे डोमेन हैं जहां एक वॉयस एजेंट को न केवल स्वाभाविक रूप से बातचीत करनी चाहिए बल्कि टूल कॉल, सिस्टम इंटीग्रेशन, डिसीजन ट्री और नियामक बाधाओं से जुड़े जटिल वर्कफ़्लो को भी निष्पादित करना चाहिए। यह मापना कि क्या एआई बिना किसी मानवीय हस्तक्षेप के, पहले संपर्क से लेकर समाधान तक इन प्रक्रियाओं को पूरी तरह से स्वचालित कर सकता है, इस थीसिस में वर्णित क्षमताओं के लिए निश्चित वास्तविक दुनिया का बेंचमार्क है।
संदर्भ
Brown, T. B., et al. (2020). Language models are few-shot learners. Advances in Neural Information Processing Systems, 33.
Clark, A. (2013). Whatever next? Predictive brains, situated agents, and the future of cognitive science. Behavioral and Brain Sciences, 36(3), 181–204.
Ha, D., and Schmidhuber, J. (2018). World models. Advances in Neural Information Processing Systems, 31. arXiv:1803.10122.
Hafner, D., Lillicrap, T., Ba, J., and Norouzi, M. (2020). Dream to control: Learning behaviors by latent imagination. International Conference on Learning Representations 2020.
Hafner, D., et al. (2023). Mastering diverse domains through world models. arXiv:2301.04104.
Lake, B. M., Ullman, T. D., Tenenbaum, J. B., and Gershman, S. J. (2017). Building machines that learn and think like people. Behavioral and Brain Sciences, 40, e253.
LeCun, Y. (2022). A path towards autonomous machine intelligence. OpenReview preprint.
Levinson, S. C. (2016). Turn-taking in human communication: Origins and implications for language processing. Trends in Cognitive Sciences, 20(1), 6–14.
Nguyen, T. A., et al. (2024). Spirit-LM: Interleaved spoken and written language model. arXiv:2402.05755.
OpenAI. (2023). GPT-4 technical report. arXiv:2303.08774.
Pickering, M. J., and Garrod, S. (2004). Toward a mechanistic psychology of dialogue. Behavioral and Brain Sciences, 27(2), 169–190.
Radford, A., Kim, J. W., Xu, T., Brockman, G., McLeavey, C., and Sutskever, I. (2022). Robust speech recognition via large-scale weak supervision. arXiv:2212.04356.
Ren, Y., et al. (2020). FastSpeech 2: Fast and high-quality end-to-end text to speech. arXiv:2006.04558.
Rubenstein, P. K., et al. (2023). AudioPaLM: A large language model that can speak and listen. arXiv:2306.12925.
Sacks, H., Schegloff, E. A., and Jefferson, G. (1974). A simplest systematics for the organization of turn-taking for conversation. Language, 50(4), 696–735.
Salvucci, D. D., and Taatgen, N. A. (2008). Threaded cognition: An integrated theory of concurrent multitasking. Psychological Review, 115(1), 101–130.
Smallest AI Research (2026). The conversation engine: A position on symbolic world models for spoken dialogue. Companion paper.
Touvron, H., et al. (2023). LLaMA: Open and efficient foundation language models. arXiv:2302.13971.
Turing, A. M. (1950). Computing machinery and intelligence. Mind, 59(236), 433–460.
Vaswani, A., et al. (2017). Attention is all you need. Advances in Neural Information Processing Systems, 30.
Zhang, D., et al. (2023). SpeechGPT: Empowering large language models with intrinsic cross-modal conversational abilities. arXiv:2305.11000.