नित्यानंद माथुर¹ *, श्याम मार्जित² *, अभ्रा चौधरी³,⁴, अंजन दत्ता⁴
¹ स्मॉलेस्ट एआई, ² भारतीय विज्ञान संस्थान, ³ एक्सेटर विश्वविद्यालय, ⁴ सरे विश्वविद्यालय
¹nityanand@smallest.ai, ²marjitshyam@gmail.com, ³ac1151@exeter.ac.uk, ⁴anjan.dutta@surrey.ac.uk
परियोजना पृष्ठ: https://clipdrawx.github.io/
*बराबर योगदान।
CLIP टेक्स्ट प्रॉम्प्ट के साथ जिन विज़ुअल कॉन्सेप्ट्स को जोड़ता है, उन्हें समझने के उद्देश्य से, हम दिखाते हैं कि CLIP के लेटेंट स्पेस को पूरी तरह से सीधी रेखाओं और वृत्तों जैसे सरल ज्यामितीय प्रिमिटिव्स पर लीनियर ट्रांसफॉर्मेशन्स के रूप में विज़ुअलाइज़ किया जा सकता है। हालाँकि मौजूदा दृष्टिकोण ऑप्टिमाइज़ेशन-के-माध्यम-से-स्केच-सिंथेसिस द्वारा इसे प्राप्त करते हैं, लेकिन वे ऐसा उच्च क्रम के बेज़ियर कर्व्स के स्पेस पर करते हैं, जो संरचनाओं के एक बहुत बड़े समूह को प्रदर्शित करते हैं जिसमें वे विकसित हो सकते हैं, क्योंकि उनमें से अधिकांश सार्थक स्केच बनाने के लिए गैर-जरूरी हैं। हम CLIPDraw++ प्रस्तुत करते हैं, एक ऐसा एल्गोरिदम जो केवल सीधी रेखाओं और वृत्तों जैसे सरल प्रिमिटिव आकृतियों का उपयोग करके, CLIP टेक्स्ट एम्बेडिंग्स के लिए काफी बेहतर विज़ुअलाइज़ेशन प्रदान करता है। यह संभावित आउटपुट के सेट को इन प्रिमिटिव्स पर लीनियर ट्रांसफॉर्मेशन्स तक सीमित करता है, जिससे स्वाभाविक रूप से एक सरल गणितीय रूप प्रदर्शित होता है। CLIPDraw++ की सिंथेसिस प्रक्रिया को एंड-टू-एंड ट्रैक किया जा सकता है, जिसमें प्रत्येक विज़ुअल कॉन्सेप्ट को विशेष रूप से प्रिमिटिव्स के रूप में व्यक्त किया जाता है।
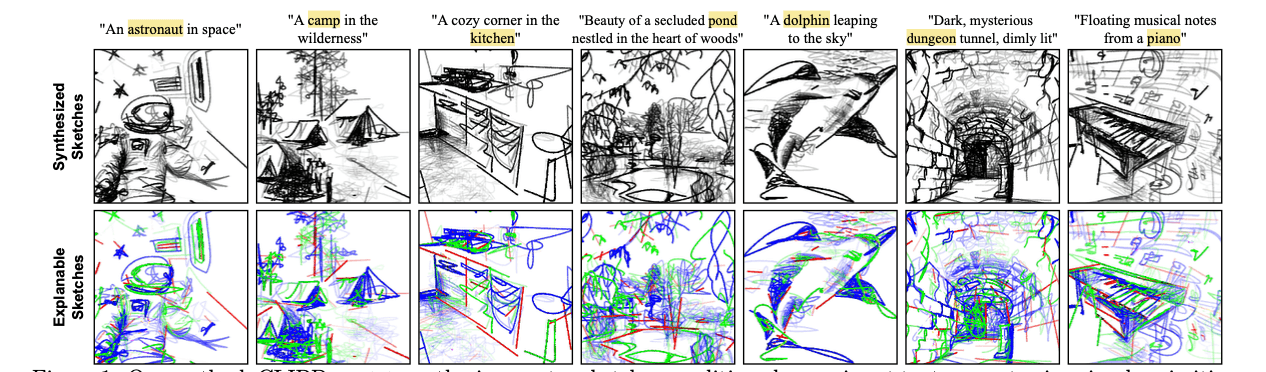
चित्र 1. हमारी पद्धति, CLIPDraw++ शब्दों पर ध्यान केंद्रित करते हुए वृत्त, सीधी रेखाएं और अर्ध-वृत्त जैसे सरल बुनियादी आकृतियों का उपयोग करके एक इनपुट टेक्स्ट प्रॉम्प्ट के आधार पर वेक्टर रेखाचित्रों (स्केच) को संश्लेषित करती है। अधिक परिणाम संदर्भ (Supp.) में हैं।
1. परिचय
रेखाचित्र (स्केच) और मौखिक विवरण जैसे सरलीकृत निरूपण विचारों को संप्रेषित करने के लिए शक्तिशाली माध्यम हैं, जो विषय के मूल सार पर ध्यान केंद्रित करते हैं। जहाँ भाषा अमूर्त अर्थों को व्यक्त करती है, वहीं रेखाचित्र दृश्य विशिष्टताओं को दर्शाते हैं। उदाहरण के लिए, एक डिजाइनर डिजाइन योजनाओं की समीक्षाओं के दौरान स्पष्टता के लिए ग्राहक के विचारों को रेखांकित कर सकता है, और इस प्रक्रिया को स्वचालित करने से श्रम लागत को कम किया जा सकता है।
इस टेक्स्ट-टू-स्केच जनरेशन कार्य के महत्व को समझते हुए, कई शोध पहलों ने CLIP मॉडल [24] और परिवर्तनकारी प्रसार (डिफ्यूजन) मॉडल [25] का उपयोग करके टेक्स्ट-कंडीशन्ड स्केच जनरेशन की खोज की है। CLIPDraw [5] पूर्व-प्रशिक्षित CLIP टेक्स्ट-इमेज एनकोडर का उपयोग करके टेक्स्ट से चित्र बनाता है, जबकि VectorFusion [11] व्यापक डेटासेट पर निर्भर किए बिना, वेक्टर ग्राफिक्स के लिए टेक्स्ट-गाइडेड मॉडल को अनुकूलित करता है। इस प्रकार ऐसे मॉडल कला और डिजाइन [7, 11] में बढ़ती भूमिका पा रहे हैं, जो अक्सर कई कार्यों [12, 26] में मानव प्रदर्शन को पीछे छोड़ देते हैं। हालांकि, अंतर्निहित एल्गोरिदम की जटिलता उनके प्रदर्शन के साथ बढ़ती जाती है, जिससे वे कम पारदर्शी और इसलिए कम नियंत्रणीय बन जाते हैं।
इस उद्देश्य के लिए, हमारा लक्ष्य विशेष रूप से गणितीय रूप से सुगम बुनियादी आकृतियों (प्रिमिटिव्स) के संदर्भ में स्केच संश्लेषण की समस्या को ढालना है। हमारे एल्गोरिदम के परमाणु सीधे रेखाओं, वृत्तों और अर्ध-वृत्तों जैसी बुनियादी ज्यामितीय आकृतियों से बने होते हैं, जिसमें संश्लेषण प्रक्रिया को इन बुनियादी आकृतियों पर रैखिक परिवर्तन (लीनियर ट्रांसफॉर्मेशन) के रूप में पूरी तरह से संक्षेपित किया जा सकता है। इस तरह के निर्माण का लाभ दोहरा है - (1) अनुकूलित किए जाने वाले मापदंडों की संख्या नाटकीय रूप से कम हो जाती है, और (2) संश्लेषण प्रक्रिया के प्रत्येक चरण को स्पष्ट रूप से ट्रैक किया जा सकता है और एक बंद रूप रैखिक अभिव्यक्ति के माध्यम से व्यक्त किया जा सकता है। हमारा दृष्टिकोण संश्लेषण-के-माध्यम से-अनुकूलन (synthesis-through-optimization) पर आधारित है, जो प्राकृतिक भाषा टेक्स्ट प्रॉम्प्ट के अनुरूप CLIP [24] के प्रतिनिधित्व स्थान में एन्कोड की गई अवधारणाओं को वेक्टर स्ट्रोक्स का उपयोग करके विज़ुअलाइज़ करता है। ऐसे वेक्टर स्ट्रोक, जैसा कि CLIPDraw [5] द्वारा बल दिया गया है, पिक्सेल छवियों की तुलना में स्पष्ट ब्रेकडाउन और सरल घटक विशेषता को सक्षम करते हैं। हालांकि प्रसार जैसे उन्नत मॉडल उच्च गुणवत्ता वाले पिक्सेल स्केच [25] उत्पन्न कर सकते हैं, उनकी पिक्सेल जटिलता अंतर्निहित तर्क को अस्पष्ट कर सकती है। हालांकि, वेक्टरीकृत स्ट्रोक का उपयोग करना, विशेष रूप से जब बुनियादी आकृतियों तक सीमित हो, स्पष्टता को बढ़ाता है और उन चरणों की बेहतर समझ प्रदान करता है जो एक मॉडल स्केच को संश्लेषित करने के लिए उठाता है, साथ ही अत्याधुनिक परिणाम प्राप्त करने के लिए आवश्यक मापदंडों की संख्या को भी महत्वपूर्ण रूप से कम करता है।
इस शोध पत्र में, हम CLIPDraw++ प्रस्तुत करते हैं, जो एक ऐसा एल्गोरिदम है जो टेक्स्ट विवरणों के आधार पर उच्च गुणवत्ता वाले वेक्टर रेखाचित्रों को संश्लेषित कर सकता है। यह न केवल रेखाचित्रों को संश्लेषित करता है बल्कि प्रारंभिक ज्यामितीय बुनियादी आकृतियों, जैसे सीधी रेखाओं, वृत्तों और आधे-वृत्तों से अंतिम आउटपुट तक प्रत्येक वेक्टर स्ट्रोक के विकास को भी ट्रैक करता है। एक पूर्व-प्रशिक्षित टेक्स्ट-टू-इमेज डिफ्यूजन मॉडल [25] से क्रॉस-अटेंशन मैप्स का लाभ उठाते हुए, हम एक अंतर करने योग्य रेखापुंज (डिफ्रेंशिएबल रास्टराइज़र) [15] का उपयोग करके उनके मापदंडों को ट्यून करके, बुनियादी आकृतियों के एक सेट के रूप में एक प्रारंभिक स्केच कैनवास को परिभाषित करते हैं। न्यूनतमता और एक सरल गणितीय रूप सुनिश्चित करने के लिए, हमने बेज़ियर वक्रों की तुलना में अधिक कठोर ज्यामिति के साथ विशिष्ट प्रारंभिक आकृतियों का पालन करने के लिए बुनियादी आकृतियों को विवश किया है। हमारा CLIPDraw++, जो CLIPDraw [5] पर आधारित है, स्ट्रोक्स के लिए पूर्वनिर्धारित बुनियादी आकृतियों का उपयोग करके खुद को अलग करता है, सरलता पर जोर देता है, जबकि CLIPDraw जटिल, मनमाने ढंग से आकार के बेज़ियर वक्रों के साथ स्ट्रोक को इनिशियलाइज़ करता है, जो आकृतियों के एक अत्यधिक बड़े सेट को प्रदर्शित करते हैं जिसमें वे बदल सकते हैं, लेकिन सार्थक स्केच बनाने के लिए वे आवश्यक नहीं हैं। हमारी विधि इन सरल बुनियादी आकृतियों को रैखिक रूप से संबंधित स्केच स्ट्रोक में परिवर्तित करती है, न कि CLIPDraw द्वारा निर्मित अधिक अमूर्त और समझने में कठिन रेखाचित्रों की तरह। हमारा CLIPDraw++ मौजूदा तरीकों की तुलना में प्रदर्शन और मेमोरी उपयोग दोनों के संदर्भ में अधिक कुशल तरीके से बेहतर रेखाचित्रों को संश्लेषित करता है। यह सुधार कम बुनियादी आकृतियों के उपयोग के कारण है, जिनमें से प्रत्येक में कैनवास पर रणनीतिक रूप से वितरित कम नियंत्रण बिंदु होते हैं। प्रचलित जनरेटिव मॉडल [19] के विपरीत, जिसमें व्यापक पैरामीटर प्रशिक्षण की मांग करने वाले डिफ्यूजन मॉडल [25] शामिल हैं, हमारा CLIPDraw++ अनुकूलन के माध्यम से रेखाचित्रों को संश्लेषित करता है और बिना किसी विशिष्ट प्रशिक्षण के काम करता है। इसके बजाय, एक पूर्व-प्रशिक्षित CLIP मॉडल का उपयोग इनपुट टेक्स्ट प्रॉम्प्ट और संश्लेषित स्केच के बीच समानता को अधिकतम करने के लिए एक मीट्रिक के रूप में किया जाता है।
संक्षेप में, हम निम्नलिखित योगदान करते हैं:
सरल ज्यामितीय बुनियादी आकृतियों पर रैखिक परिवर्तनों को सीखने के एक अच्छी तरह से समझे गए गणितीय ढांचे के संदर्भ में अनुकूलन के माध्यम से स्केच संश्लेषण की समस्या को प्रस्तुत करना।
बुनियादी आकृतियों का उपयोग करके स्केच कैनवास इनिशियलाइजेशन दृष्टिकोण का प्रस्ताव करना। पूर्व-प्रशिक्षित डिफ्यूजन मॉडल के क्रॉस-अटेंशन मैप का लाभ उठाकर, हम आवश्यकता के आधार पर इन बुनियादी आकृतियों को कैनवास पर रणनीतिक रूप से वितरित करते हैं। इसके अलावा, इन बुनियादी आकृतियों को कम अस्पष्टता (ओपेसिटी) के साथ इनिशियलाइज़ करके, मॉडल केवल टेक्स्ट प्रॉम्प्ट से संबंधित बुनियादी आकृतियों को ही निखारता है।
हमारे अनुकूलन को "नियमित" (रेगुलराइज़) करने के लिए एक अभिनव तकनीक के रूप में प्रिमिटिव-लेवल ड्रॉपआउट (बुनियादी-स्तर पर विलोपन)। ऐसा करके, हम प्रभावी रूप से अति-अनुकूलन को कम करते हैं, शोर वाले स्ट्रोक को कम करते हैं, और संश्लेषित रेखाचित्रों की समग्र गुणवत्ता को बढ़ाते हैं।
व्यापक गुणात्मक और मात्रात्मक प्रयोग मौजूदा तरीकों को पीछे छोड़ते हुए प्रदर्शन प्रदान करने में हमारे नए घटकों की उपयोगिता को प्रदर्शित करते हैं, जबकि एक महत्वपूर्ण रूप से सरल और पैरामीटर-कुशल संश्लेषण योजना प्रदर्शित करते हैं।
2. संबंधित कार्य
स्केच जनरेशन (रेखाचित्र निर्माण): मुक्त-हस्त रेखाचित्र (फ्री-हैंड स्केच) मानव दृश्य धारणा के अतिसूक्ष्मवाद का लाभ उठाते हुए अमूर्त विचारों को संप्रेषित करते हैं। उनका उद्देश्य संरचनात्मक [3] और शब्दार्थीय (सिमेंटिक) [31] दोनों व्याख्याओं के आधार पर अमूर्त निरूपण करना है। मानव चित्रकला की नकल करने के उद्देश्य से डिजिटल स्केचिंग विधियाँ व्यापक स्तर के निरूपणों को कवर करती हैं, जिनमें इनपुट छवि के एज मैप [4, 14, 16, 17, 29] पर आधारित विधियों से लेकर अमूर्तता के उच्च स्तर [2, 5, 8] में प्रवेश करने वाली विधियाँ शामिल हैं, जिन्हें आमतौर पर वेक्टर प्रारूप में दर्शाया जाता है। वेक्टर स्केच निर्माण के क्षेत्र में, CLIPasso [31] और CLIPascene [30] जैसी पहलें एक छवि इनपुट पर निर्भर हैं; इस बीच, CLIPDraw [5], VectorFusion [11] और DiffSketcher [32] जैसे दृष्टिकोण पाठ-आधारित सशर्त इनपुट के साथ जुड़ते हैं, जो अन्य बिना शर्त पद्धतियों से अलग खड़े हैं। विशेष रूप से, CLIPDraw [5] अनुकूलन-आधारित स्केच संश्लेषण को नियोजित करता है, जबकि VectorFusion [11] और DiffSketcher [32] दोनों प्रसार-आधारित दृष्टिकोणों को अपनाते हैं, जिसमें VectorFusion गुप्त स्थान (लेटेंट स्पेस) में अनुकूलन करने पर ध्यान केंद्रित करता है, जिससे यह DiffSketcher की तुलना में अधिक हल्का और कुशल बनता है जो छवि स्थान में अपना अनुकूलन करता है। इस पेपर में, हम टेक्स्ट-कंडीशन्ड स्केच संश्लेषण का पता लगाते हैं। मौजूदा दृष्टिकोणों से अलग, हम दिखाते हैं कि जटिल रेखाचित्रों को सरल ज्यामितीय बुनियादी आकृतियों पर सरल रैखिक परिवर्तनों के रूप में संश्लेषित किया जा सकता है, जिसमें हमारी नवीनता हमारे निर्माण के अतिसूक्ष्मवाद में निहित है।
अनुकूलन के माध्यम से संश्लेषण: छवियों को उत्पन्न करने के लिए सीधे एक नेटवर्क को प्रशिक्षित करने के बजाय, एक्टिवेशन मैक्सिमाइजेशन नामक एक अलग रणनीति मूल्यांकन [21] के दौरान लक्ष्य से मेल खाने के लिए एक यादृच्छिक छवि को अनुकूलित करती है। CLIPDraw [5] संश्लेषित छवि और एक निर्दिष्ट विवरण के बीच असमानता को कम करने के लिए एक CLIP भाषा-छवि एनकोडर [6, 24] का उपयोग करके इस दृष्टिकोण को आगे बढ़ाता है, जो बारीक विवरणों के बजाय व्यापक विशेषताओं पर ध्यान केंद्रित करता है। यद्यपि अनुकूलन के माध्यम से संश्लेषण का परिणाम अक्सर अस्वाभाविक या भ्रामक छवियों [20] के रूप में होता है, 'प्राकृतिक छवि प्राथमिकता' (नेचुरल इमेज प्रायर) को नियोजित करना प्रामाणिकता [21, 22] को बनाए रख सकता है, जिसमें अक्सर GANs का प्रतिबंधात्मक और कम्प्यूटेशनल रूप से गहन उपयोग शामिल होता है। इस पेपर में, हम ज्यामितीय परिवर्तनों के माध्यम से वस्तुओं और दृश्यों के रेखाचित्रों को संश्लेषित करने के लिए CLIPDraw की क्षमताओं का विस्तार करते हैं, जो CLIPDraw के दृष्टिकोण से भिन्न है, जो विश्लेषण करने में कठिन, मनमाने आकार के बेज़ियर वक्रों के साथ बनाए गए जटिल और अमूर्त रेखाचित्रों का उपयोग करता है।
वेक्टर ग्राफिक्स: हम [15] द्वारा शुरू किए गए वेक्टर ग्राफिक्स के लिए डिफ्रेंशिएबल रेंडरर का लाभ उठाते हैं, जो हाल की प्रगति के कारण अब केवल वेक्टर-विशिष्ट डेटासेट तक सीमित नहीं है। CLIP [24] के आगमन ने, जो बेहतर विज़ुअल टेक्स्ट एम्बेडिंग को बढ़ावा देता है, CLIPDraw [5], CLIP-CLOP [18], और CLIPascene [30] सहित मजबूत स्केच संश्लेषण तकनीकों के विकास को प्रेरित किया है। हाल ही में पेश किया गया VectorFusion [11] एक डिफ्रेंशिएबल रेंडरर को एक डिफ्यूजन मॉडल के साथ एकीकृत करता है, जो आइकोनोग्राफी और पिक्सेल आर्ट जैसे वेक्टर ग्राफिक्स कृतियों के उत्पादन में सहायता करता है।
रेखाचित्रों के लिए सरलीकृत निरूपण: तंत्रिका स्केच निरूपण को पारदर्शी और सरलीकृत बनाने पर वर्तमान स्केच अनुसंधान महत्वपूर्ण रूप से सीमित है, जो मुख्य रूप से स्ट्रोक-स्तरीय अमूर्तता [1] और स्ट्रोक स्थान उलटाव [23] के माध्यम से मानव रेखाचित्रों की व्याख्या करने पर केंद्रित है। हालांकि, जैसे-जैसे जनरेटिव एआई का सामग्री निर्माण में उपयोग बढ़ रहा है, रेखाचित्रों [5, 30, 31] के लिए ऐसे मॉडलों में अंतर्निहित अमूर्तता को तोड़ना और भी महत्वपूर्ण हो जाता है। हम एक ऐसा दृष्टिकोण प्रस्तुत करते हैं जो न केवल गणितीय रूप से सरल बुनियादी आकृतियों के संदर्भ में रेखाचित्रों को संश्लेषित करता है, बल्कि CLIP [24] जैसे फाउंडेशन मॉडलों के प्रतिनिधित्व स्थान में मानव-समझने योग्य अंतर्दृष्टि भी प्रदान करता है।
3. CLIPDraw++
इस कार्य में, हमारा लक्ष्य रेखाचित्रों को रैखिक रूप से रूपांतरित बुनियादी आकृतियों के संग्रह के रूप में व्यक्त करके उन्हें संश्लेषित करना है, जिन्हें इनपुट टेक्स्ट के आधार पर ट्रैक करने योग्य तरीके से प्रारंभिक कैनवास से अंतिम स्केच में स्ट्रोक के सेट के रूप में विकसित किया जा सकता है। हम एक कैनवास को सीधी रेखाओं, वृत्तों और आधे-वृत्तों जैसी बुनियादी आकृतियों से भरकर शुरू करते हैं, जिसका विवरण धारा 3.2 में दिया गया है। फिर हम धारा 3.3 में उल्लिखित स्केच संश्लेषण प्रक्रिया के दौरान उनकी प्रगति को ट्रैक करते हैं, जो धारा 3.4 में निर्दिष्ट प्रशिक्षण मानदंडों द्वारा निर्देशित होती है। प्रस्तावित दृष्टिकोण का एक उदाहरण चित्र 2 में प्रदान किया गया है।
3.1. बुनियादी आकृतियों से स्केच संश्लेषण
C = p1 ⊕ p2... ⊕ pn के रूप में बुनियादी आकृतियों {p1, p2, ..., pn} के एक सेट से बने एक प्रारंभिक कैनवास C को देखते हुए, हम गुणात्मक रूप से दिखाते हैं कि किसी भी शब्दार्थपूर्ण सार्थक स्केच Y को C पर एक परिवर्तन f (·) के रूप में बनाया जा सकता है जैसे कि S = f(C) = f1(p1) ⊕ f2(p2)... ⊕ fn(pn), जहाँ f1, f2, ..., fn बुनियादी आकृतियों पर रैखिक परिवर्तन हैं, और ⊕ एक एकल कैनवास में बुनियादी आकृतियों की संरचना को दर्शाता है। दूसरे शब्दों में, कोई भी बुनियादी आकृति p ∈ C लक्ष्य स्केच के रूप में एक अवधारणा y ∈ Y को y = F · p के रूप में मैप करती है, जहाँ F रैखिक परिवर्तन को एन्कोड करने वाला एक मैट्रिक्स है। इस प्रकार सीखने की समस्या F के सर्वोत्तम अनुमान F˜ को खोजने की बन जाती है ताकि p को Y में कुछ लक्ष्य अवधारणा को चित्रित करने के लिए उचित रूप से रूपांतरित किया जा सके। इस प्रकार, एक प्रारंभिक कैनवास और एक लक्ष्य स्केच को देखते हुए, लक्ष्य में सभी उप-अवधारणाओं yi ∈ Y के तहत, निम्नलिखित उद्देश्य को अनुकूलित करने की आवश्यकता है:
min F l(CF , Y) = arg min i,F ∑ j ||yi − F˜ · pj || (1)
जहाँ F = {F˜ 1, F˜2, ..., F˜n} क्रमशः C से {p1, p2, ..., pn} पर लागू रैखिक परिवर्तनों का एक सेट है ताकि लक्ष्य स्केच Y का अनुमान प्राप्त किया जा सके, और CF कैनवास C पर लागू परिवर्तनों के सेट F के तहत प्राप्त स्केच को दर्शाता है।
हालांकि, लक्ष्य अवधारणा स्केच Y उपलब्ध नहीं है, क्योंकि मुख्य उद्देश्य इसे एक पाठ्य विवरण से संश्लेषित करना है। इसलिए हम एक विज़न-लैंग्वेज मॉडल चुनते हैं, विशेष रूप से, CLIP [24], और इसके गुप्त निरूपण (लेटेंट रिप्रेजेंटेशन) का उपयोग लक्ष्य स्केच के लिए एक प्रॉक्सी के रूप में करते हैं। CLIP का प्रतिनिधित्व स्थान एकीकृत है, यानी, प्राकृतिक भाषा के वाक्यों और उनके संबंधित दृश्य समकक्षों का एक ही एम्बेडिंग है। इसलिए, एक स्केच जो टेक्स्ट प्रॉम्प्ट के माध्यम से व्यक्त किए गए समान शब्दार्थ को कैप्चर करता है, उसका CLIP के प्रतिनिधित्व स्थान में समान एम्बेडिंग होना चाहिए। इस प्रकार हम CLIP टेक्स्ट और स्केच एम्बेडिंग्स को क्रमशः ग्राउंड-ट्रुथ अवधारणा Y स्केच और संश्लेषित स्केच CF के लिए प्रॉक्सी प्रतिनिधित्व के रूप में कार्य कराते हैं और निम्नलिखित उद्देश्य को अनुकूलित करते हैं जो समीकरण (1) के समतुल्य है:
min F l(CF , xt) = arg min F ||T (xt) − I [∑ i F˜i · pi]|| (2)
इस प्रकार समीकरण (2) के निर्माण में, टेक्स्ट प्रॉम्प्ट xt ग्राउंड ट्रुथ Y के लिए एक प्रॉक्सी के रूप में कार्य करता है। फ़ंक्शन I और T क्रमशः CLIP के छवि और टेक्स्ट एनकोडर को दर्शाते हैं।
3.2. बुनियादी आकृति-आधारित कैनवास इनिशियलाइजेशन
हम पाठ्य इनपुट से प्राप्त आवश्यक लैंडमार्क बिंदुओं की पहचान करके स्केच कैनवास को इनिशियलाइज़ करते हैं। इसके बाद, इन लैंडमार्क को सीधी रेखाओं, वृत्तों और आधे-वृत्तों जैसी बुनियादी आकृतियों का उपयोग करके भरा जाता है।
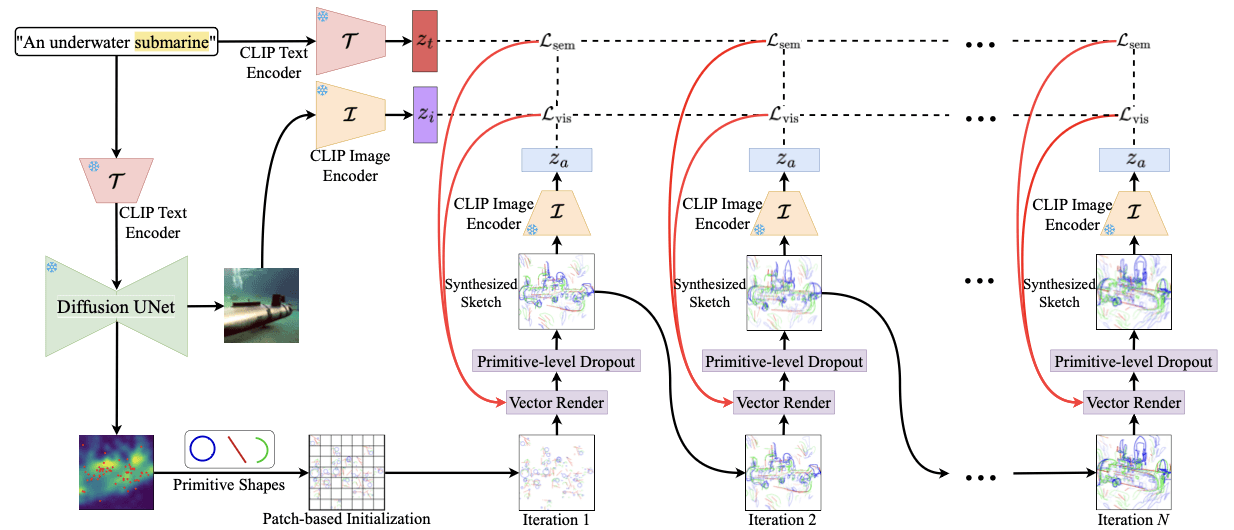
चित्र 2. CLIPDraw++ में रणनीतिक कैनवास इनिशियलाइजेशन शामिल है, जो प्रसार-आधारित क्रॉस-अटेंशन मैप्स और बुनियादी आकृतियों की पैच-वार व्यवस्था के साथ-साथ एक प्रिमिटिव-लेवल ड्रॉपआउट (PLD) का उपयोग करता है। प्रस्तावित मॉडल, समानता को अधिकतम करने के लिए CLIP मॉडल से पूर्व-प्रशिक्षित छवि (I) और टेक्स्ट (T) एनकोडर के उपयोग के साथ, एआई-संचालित स्केच संश्लेषण के क्षेत्र में खुद को एक कुशल और उपयोगकर्ता-अनुकूल उपकरण के रूप में स्थापित करता है। क्रॉस-अटेंशन मैप बनाने के लिए हाइलाइट किए गए शब्द का उपयोग किया जाता है।
अटेंशन मैप्स का उपयोग करके लैंडमार्क की पहचान करना: CLIPDraw++ बुनियादी आकृतियों का उपयोग करके एक कैनवास को इनिशियलाइज़ करता है, जिसके लिए टेक्स्ट इनपुट के आधार पर उस कैनवास पर महत्वपूर्ण लैंडमार्क की पहचान करने की आवश्यकता होती है। इसके लिए, हम लेटेंट डिफ्यूजन मॉडल [25] से UNet आर्किटेक्चर से प्राप्त एक अभिन्न अंग के रूप में DAAM [28] जनरेटेड टोकन वार क्रॉस-अटेंशन तंत्र को नियोजित करते हैं। विशेष रूप से, हम ऊपरी और निचले दोनों नमूना ब्लॉकों से अलग-अलग ध्यान देने योग्य विशेषताओं (अटेंशन फीचर्स) को कैप्चर करते हैं, और उन्हें एक एकीकृत अटेंशन मैप में विलय कर देते हैं। इस मिश्रित अटेंशन मैप को फिर संभाव्य वितरण मानचित्र (प्रोबेबिलिस्टिक डिस्ट्रीब्यूशन मैप) बनाने के लिए सॉफ्टमैक्स फ़ंक्शन का उपयोग करके सामान्यीकृत किया जाता है। यह वितरण मानचित्र k स्थितियों के चयन के हमारे अगले कार्य के लिए आधार के रूप में कार्य करता है। इस अटेंशन-व्युत्पन्न वितरण मानचित्र के भीतर प्रत्येक बिंदु के परिमाण को चयन प्रक्रिया का मार्गदर्शन करने के लिए एक भार पैरामीटर (वेट पैरामीटर) के रूप में लाभ उठाया जाता है। यह सुनिश्चित करता है कि पदों का चयन अंतर्निहित अटेंशन-आधारित विशेषताओं की प्रमुखता और महत्व से प्रभावित हो। शब्दार्थीय चित्रण (सिमेंटिक डिपिक्शन) की ओर अभिसरण में सुधार करने के लिए, हम लक्ष्य छवि के प्रमुख क्षेत्रों (यहाँ पैच) के आधार पर बुनियादी आकृतियों या प्रारंभिक स्ट्रोक को रखते हैं।
पैच-आधारित इनिशियलाइजेशन: समान स्ट्रोक प्रकारों [5, 31] के लिए बिंदु-आधारित (पॉइंट-आधारित) इनिशियलाइजेशन प्रभावी है, लेकिन अटेंशन मैप पर एक विशिष्ट बिंदु के लिए सही बुनियादी आकृति का निर्धारण करना कठिन हो सकता है। इसके अतिरिक्त, एक ही स्थान पर विभिन्न बुनियादी आकृतियों को रखना समस्याग्रस्त है क्योंकि इससे उच्च बिंदु घनत्व के कारण अव्यवस्था हो सकती है, जिससे असमान बुनियादी आकृति वितरण और गंदे स्केच बन सकते हैं। इसे संबोधित करने के लिए, हमारा CLIPDraw++ निश्चित श्रेणियों या 'पैच' में बुनियादी आकृतियों का परिचय देता है, जो सटीक अटेंशन मैप स्थानों के बजाय उसके भीतर के सभी बिंदुओं का प्रतिनिधित्व करते हैं। यह एक 224 × 224 कैनवास को 32 × 32 के पैच में विभाजित करता है। प्रत्येक पैच को बुनियादी आकृतियों का मिश्रण प्राप्त होता है: सीधी रेखाएं, वृत्त, और अर्ध-वृत्त, जो अटेंशन मैप स्थानीय मैक्सिमा के आसपास समान आकृति वितरण को बढ़ावा देते हैं। बिंदु-आधारित इनिशियलाइजेशन पर पैच-आधारित के लाभों पर धारा 4.3 में चर्चा की गई है और चित्र 7 में चित्रित किया गया है।
बुनियादी आकृतियों के साथ स्केच कैनवास को इनिशियलाइज़ करना: हम एक कैनवास में दिखाई देने वाले n स्ट्रोक {s1, . . . , sn} के एक सेट के रूप में एक स्केच को परिभाषित करते हैं। इन स्ट्रोक की उत्पत्ति और विकास को स्पष्ट करने के लिए, हम अपने कैनवास को बुनियादी आकृतियों, जैसे सीधी रेखाओं, वृत्तों और अर्धवृत्तों के साथ इनिशियलाइज़ करते हैं। प्रत्येक बुनियादी आकृति को दो-आयामी आकृति का उपयोग करके बनाया जाता है जो दो से चार नियंत्रण बिंदुओं का उपयोग करती है, जिसे si = {p j i } c j=1 = {(xi , yi) j}c j=1 और एक अस्पष्टता (ओपेसिटी) विशेषता αi के रूप में दर्शाया जाता है; जहाँ c ∈ {2, 3, 4} नियंत्रण बिंदुओं की संख्या को दर्शाता है। उदाहरण के लिए, सीधी रेखा में 2 नियंत्रण बिंदु होते हैं, जबकि अर्ध-वृत्त और वृत्त में 3 और 4 होते हैं। हम प्रत्येक नियंत्रण बिंदु की स्थिति और स्ट्रोक की अस्पष्टता को अनुकूलन प्रक्रिया में शामिल करते हैं और एक पाठ्य विवरण से स्केच के संश्लेषण का मार्गदर्शन करने के लिए CLIP में शब्दार्थ संबंधी ज्ञान का उपयोग करते हैं। स्ट्रोक के मापदंडों को एक डिफ्रेंशिएबल रास्टराइज़र R को खिलाया जाता है, जो रास्टर स्केच S = R((s1, α1), . . . ,(sn, αn)) = R(({p j 1 } c j=1, α1), . . . ,({p j 1 } c j=1, αn)) बनाता है।
3.3. स्केच संश्लेषण को अनुकूलित करना
अवांछित स्ट्रोक एक स्केच में शोर पैदा कर सकते हैं, जिससे स्वचालित स्केच निर्माण के लिए अनावश्यक स्ट्रोक को हटाना महत्वपूर्ण हो जाता है। यह खंड मौजूदा मशीन लर्निंग तकनीकों और मानव स्केचिंग प्रथाओं से प्रेरणा लेते हुए, शोर वाले स्ट्रोक को समाप्त करने की प्रक्रियाओं को रेखांकित करता है।
प्रिमिटिव-लेवल ड्रॉपआउट (बुनियादी-स्तर पर विलोपन): ड्रॉपआउट [27] तंत्रिका नेटवर्क (न्यूरल नेटवर्क) के लिए एक नियमितीकरण तकनीक है जहाँ प्रशिक्षण के दौरान न्यूरॉन्स के यादृच्छिक उपसमुच्चय को अस्थायी रूप से निष्क्रिय कर दिया जाता है। यह प्रक्रिया फीचर डिटेक्टरों के सह-अनुकूलन को रोककर और अधिक मजबूत नेटवर्क प्रतिनिधित्व को बढ़ावा देकर ओवरफिटिंग को कम करती है। मजबूत प्रतिनिधित्व सीखने में ड्रॉपआउट की सफलता से प्रेरित होकर, हम अपने CLIPDraw++ मॉडल में प्रिमिटिव-लेवल ड्रॉपआउट (PLD) का प्रस्ताव करते हैं। यह तकनीक प्रत्येक स्केच प्रिमिटिव (बुनियादी आकृति) के उपयोग को अनुकूलित करने और अनावश्यक शोर में योगदान देने वाले किसी भी प्रिमिटिव को हटाने पर केंद्रित है। हमारे दृष्टिकोण के पीछे अंतर्ज्ञान यह है कि उपलब्ध प्रिमिटिव्स की संख्या को सीमित करना मॉडल को पाठों में वर्णित शब्दार्थों को कैप्चर करने के लिए प्रत्येक का कुशलतापूर्वक उपयोग करने के लिए मजबूर करता है, जिससे शोर वाले स्ट्रोक में उनकी बर्बादी से बचा जा सकता है। प्रत्येक पुनरावृत्ति (इटरेशन) के लिए प्रिमिटिव्स के यादृच्छिक छोटे उपसमुच्चयों का चयन करके, मॉडल को सार्थक स्केच प्रतिनिधित्व के लिए सभी इटरेशन में हर प्रिमिटिव का उपयोग करने के लिए प्रोत्साहित किया जाता है, जिससे अनावश्यक शोर पैदा करने में उनके उपयोग को कम किया जा सके।
अनुकूलन प्रक्रिया के प्रत्येक चरण में, प्रिमिटिव्स की एक विशिष्ट संख्या, जिसे P द्वारा दर्शाया जाता है और एक संभाव्यता वितरण के माध्यम से निर्धारित किया जाता है, जानबूझकर हटा दी जाती है, जिसके बाद एक ढाल कदम (ग्रेडिएंट स्टेप) उठाया जाता है। औपचारिक रूप से, मूल प्रिमिटिव्स C का एक यादृच्छिक उपसमुच्चय प्रत्येक इटरेशन में एक कम किया गया कैनवास C˜ बनाने के लिए निम्नानुसार चुना जाता है:
d ∼ Bernoulli(1 − P); C˜ = C · d T
जहाँ d बर्नौली यादृच्छिक चर का एक n-आयामी पंक्ति वेक्टर है, जिनमें से प्रत्येक तत्व 1 संभाव्यता (1 − P) के साथ है, और अन्यथा 0 है। d को C से गुणा करने से वे प्रिमिटिव छिप (मास्क आउट) जाते हैं जिनके सूचकांक d के उन तत्वों के अनुरूप होते हैं जो 0 हैं, जबकि अन्य को बरकरार रखा जाता है। इसके बाद, इन P प्रिमिटिव्स को इटरेशन के समापन पर अनुकूलन लूप में फिर से पेश किया जाता है, और अगले इटरेशन में P प्रिमिटिव्स के एक अन्य यादृच्छिक उपसमुच्चय को हटा दिया जाता है। CLIPDraw++ में प्रिमिटिव्स को पेश करने, बाहर करने और फिर से पेश करने का चक्रव्यूह दृष्टिकोण एक संतुलित अनुकूलन प्रदान करता है, जिससे यह सुनिश्चित होता है कि स्केच स्ट्रोक से अत्यधिक न भरें बल्कि फिर भी महत्वपूर्ण तत्वों को बनाए रखें। व्यापकता के नुकसान के बिना¹, सरलीकृत परिदृश्य पर विचार करें जहाँ बुनियादी आकृतियों n की संख्या लक्ष्य अवधारणाओं y ∈ Y की संख्या के बराबर है, और निम्नलिखित लागू होता है:
∀ y ∈ Y, ∃ p ∈ C, f ∈ F | y = f(p) (3)
दूसरे शब्दों में, लक्ष्य पाठ Y में प्रत्येक अवधारणा को एक निश्चित बुनियादी आकृति के परिवर्तन के रूप में विशिष्ट रूप से दर्शाया जा सकता है, यानी, F के तहत C और Y के बीच एक-से-एक मैपिंग मौजूद है। अब, प्रिमिटिव सेट में η अतिरिक्त प्रिमिटिव्स जोड़ने पर विचार करें ताकि C अब {p1, p2, ..., pn, pn+1, ..., pn+η} बन जाए। हालांकि, दिया गया आधार यह बताता है कि Y उत्पन्न करना केवल {p1, p2, ..., pn} का उपयोग करके ही प्राप्त करने योग्य था। इसलिए अतिरिक्त प्रिमिटिव्स {pn+1, ..., pn+η} का विकास अनुकूलन उद्देश्य से विवश नहीं है, जिससे कैनवास के आसपास बिना किसी स्पष्ट अर्थ के शोर वाले स्ट्रोक के रूप में उनके पड़े रहने की संभावना बनी रहती है। पर्याप्तता सुनिश्चित करने के लिए, यानी, समीकरण (3) में शर्त, हम हमेशा किसी निश्चित पाठ संकेत को विज़ुअलाइज़ करने के लिए आवश्यक प्रिमिटिव्स की संख्या को अधिक आंकते हैं, ताकि यह सुनिश्चित हो सके कि संश्लेषित स्केच आवश्यक विवरणों के साथ पूर्ण है। हालांकि, जैसा कि औपचारिक रूप से तर्क दिया गया है, यह अधिक आकलन कैनवास को भरने वाले कुछ शोर वाले स्ट्रोक के लिए जगह छोड़ सकता है। प्रिमिटिव-लेवल ड्रॉपआउट यह सुनिश्चित करता है कि प्रत्येक इटरेशन में यादृच्छिक रूप से η (अनुमानित शोर दर के समानुपाती) प्रिमिटिव्स को हटाकर ऐसा न हो, जिससे शेष सभी प्रिमिटिव्स कुछ सार्थक प्रतिनिधित्व करने में योगदान देने के लिए मजबूर हों। इस PLD दृष्टिकोण के अनुभवजन्य लाभों पर धारा 4.3 में चर्चा की गई है और इसे चित्र 5 में देखा जा सकता है।
¹ सामान्य तौर पर, प्रत्येक अवधारणा को कई प्रिमिटिव्स द्वारा चित्रित किया जाएगा, लेकिन इस औपचारिकता का केंद्रीय दावा अभी भी लागू रहेगा।
कम अस्पष्टता के साथ बुनियादी आकृतियों को इनिशियलाइज़ करना: पारंपरिक स्केचिंग में, कलाकार अक्सर एक हल्की रूपरेखा या फीके लेआउट के साथ शुरुआत करते हैं, जो कलाकृति के लिए एक आधार के रूप में कार्य करता है। यह प्रारंभिक चरण व्यापक संरचना और रचना को निर्धारित करता है। जैसे-जैसे कलाकृति आगे बढ़ती है, कलाकार स्ट्रोक को गहरा करते हैं, विशेष रूप से महत्वपूर्ण तत्वों को प्रमुख बनाने के लिए उन पर ध्यान केंद्रित करते हैं, जिससे यह सुनिश्चित होता है कि प्रत्येक स्ट्रोक समग्र टुकड़े में मूल्य जोड़ता है। डिजिटल क्षेत्र के साथ समानता दर्शाते हुए, CLIPDraw++ में, हमने एक समान कार्यप्रणाली तैयार की है। यहाँ, बुनियादी आकृतियों का इनिशियलाइजेशन कम अस्पष्टता मान से शुरू होता है, जिसे α के रूप में दर्शाया गया है। इसकी तुलना कलाकारों द्वारा बनाए गए फीके लेआउट से की जा सकती है। जैसे ही सिस्टम प्रासंगिकता और महत्व के आधार पर अपनी अनुकूलन प्रक्रिया शुरू करता है, कुछ बुनियादी आकृतियों की अस्पष्टता धीरे-धीरे बढ़ जाती है। यह कलाकार की उस पद्धति को दर्शाता है जिसमें वे उन स्ट्रोक्स को बार-बार गहरा करते हैं जिन्हें स्केच की अखंडता के लिए महत्वपूर्ण माना जाता है। औपचारिक रूप से, प्रत्येक बैकवर्ड पास में, हम एक प्रिमिटिव p की अस्पष्टता मान को αp ← ∇I(Ltotal); αp > K के रूप में अपडेट करते हैं, जहाँ Ltotal समीकरण (4) से CLIPDraw++ का अनुकूलन मानदंड है और K एक अनुभवजन्य स्थिरांक है। यदि असमानता पूरी होती है तो हम कैनवास में p को बनाए रखते हैं और अन्यथा इसे छोड़ देते हैं। संक्षेप में, CLIPDraw++ कलाकारों द्वारा अपनाए जाने वाले विचारशील और क्रमिक दृष्टिकोण को दोहराने का प्रयास करता है, जो मानव कलात्मकता की बारीकियों को मशीन अनुकूलन की सटीकता के साथ मिलाता है। कम अस्पष्टता के साथ स्ट्रोक को इनिशियलाइज़ करने के लाभ पर धारा 3.2 में चर्चा की गई है और संदर्भ (Supp.) के चित्र 7 में प्रदर्शित किया गया है।
3.4. प्रशिक्षण मानदंड
हमारे प्रशिक्षण मानदंड इनपुट टेक्स्ट प्रॉम्प्ट और संश्लेषित रेखाचित्रों के बीच संरेखण (अलाइनमेंट) का मूल्यांकन करते हैं, जिसमें उनके संवर्धित (ऑगमेंटेड) संस्करण भी शामिल हैं। समानता को मापने के लिए, हम CLIP मॉडल [24] से पूर्व-प्रशिक्षित टेक्स्ट और इमेज एनकोडर को नियोजित करते हैं। प्राकृतिक छवियों (यहाँ रेखाचित्रों) और पाठों दोनों से जानकारी को एन्कोड करने की CLIP की क्षमता, अतिरिक्त प्रशिक्षण की आवश्यकता को समाप्त करती है। किसी दिए गए टेक्स्ट और संश्लेषित स्केच के संरेखण को मापने के लिए हम कोसाइन समानता को sim(x, y) = x·y / ||x||·||y|| के रूप में उपयोग करते हैं।
सिमेंटिक लॉस (शब्दार्थ संबंधी हानि): हमारा प्राथमिक उद्देश्य टेक्स्ट प्रॉम्प्ट और संश्लेषित रेखाचित्रों के बीच शब्दार्थ संबंधी समानता को बढ़ाना है। टेक्स्ट प्रॉम्प्ट P और संश्लेषित स्केच S के रास्टराइज्ड संस्करण के बीच शब्दार्थ संबंधी अनुरूपता को मापने के लिए, हम शब्दार्थ हानि फ़ंक्शन, Lsem पेश करते हैं, जिसे शब्दार्थ सुसंगतता सुनिश्चित करने और दो तौर-तरीकों के बीच विसंगतियों को पकड़ने के लिए डिज़ाइन किया गया है।
Lsem = − ∑ M i=0 sim (T (P), I (Tf (S)))
जहाँ Tf यादृच्छिक एफ़िन परिवर्तनों को इंगित करता है, और M संवर्द्धन के माध्यम से उत्पादित रूपांतरित विविधताओं की संख्या को दर्शाता है।
विजुअल लॉस (दृश्य हानि): जबकि शब्दार्थ हानि उच्च-स्तरीय शब्दार्थ संकेतों पर ध्यान केंद्रित करती है, यह महत्वपूर्ण निम्न-स्तरीय स्थानिक विशेषताओं जैसे कि मुद्रा (पोज़) और संरचना की अनदेखी कर सकती है। इसलिए, शब्दार्थ हानि के पूरक के लिए, हम एक मानदंड Lvis पेश करते हैं जो डिफ्यूजन UNet द्वारा उत्पन्न छवि और उसी इनपुट टेक्स्ट के लिए हमारे मॉडल द्वारा संश्लेषित स्केच के बीच ज्यामितीय अनुरूपता को मापता है, जिसकी गणना निम्नानुसार की जाती है:
Lvis = − ∑ M i=0 sim (I (I0), I(Tf (S)))
जहाँ I0 फ्रोजन UNet द्वारा उत्पन्न अंतिम छवि को दर्शाता है।
टोटल लॉस (कुल हानि): कुल हानि, Ltotal ऊपर बताई गई दो हानि फ़ंक्शनों (शब्दार्थ हानि Lsem और दृश्य हानि Lvis) का योग है, जिनमें से प्रत्येक को उनके संबंधित गुणांकों, λsem और λvis द्वारा भारित किया गया है। ये दो हानि फ़ंक्शन हमारी स्केच संश्लेषण प्रक्रिया को संतुलित करते हैं: शब्दार्थ हानि वेक्टर रेखाचित्रों को पाठ्य संकेतों के साथ संरेखित करती है, जबकि दृश्य हानि निम्न-स्तरीय स्थानिक विशेषताओं और अवधारणात्मक सुसंगतता को बनाए रखती है। यह संयोजन शब्दार्थ निष्ठा और ज्यामितीय सटीकता के बीच जटिल संबंध को प्रभावी ढंग से कैप्चर करता है।
Ltotal = λsemLsem + λvisLvis (4)
4. प्रयोग
इस खंड में, हम वृत्तों, सीधी रेखाओं और अर्ध-वृत्तों जैसी रैखिक रूप से रूपांतरित बुनियादी आकृतियों से रेखाचित्रों को संश्लेषित करने के लिए CLIPDraw++ का उपयोग करते हैं। हम संबंधित तरीकों के साथ CLIPDraw++ की तुलना भी करते हैं और इसके घटकों का मूल्यांकन करने के लिए एब्लेशन अध्ययन करते हैं। अधिक परिणाम संदर्भ (Supp.) में हैं।
4.1. बुनियादी आकृतियों से स्केच जनरेशन
जैसा कि चित्र 3 में दिखाया गया है, हमारा CLIPDraw++ मॉडल ऐसे रेखाचित्रों को संश्लेषित करने की क्षमता प्रदान करता है जिनके स्ट्रोक रैखिक रूप से रूपांतरित बुनियादी आकृतियाँ हैं जैसे वृत्त (ऊपर से दूसरी पंक्ति), सीधी रेखाएं (तीसरी पंक्ति), और आधे वृत्त (चौथी पंक्ति)। इन व्यक्तिगत स्ट्रोक को अनुकूलन प्रक्रिया के क्रमिक इटरेशन में उनके विकास के माध्यम से ट्रैक किया जा सकता है। विशेष रूप से, मॉडल सहजता से संश्लेषित स्केच के विभिन्न हिस्सों को उपयुक्त बुनियादी आकृतियों के साथ प्रदर्शित करता है। उदाहरण के लिए, चित्र 3 में संश्लेषित मोटरसाइकिल के चेसिस और हैंडलबार को सीधी रेखाओं के साथ रेंडर किया गया है, जबकि पहियों को वृत्तों और अर्धवृत्तों का उपयोग करके चित्रित किया गया है।
हमारा मॉडल आकृति या दृश्य विकास की गतिशीलता को कुशलतापूर्वक कैप्चर करता है, जो स्वतंत्रता की डिग्री के आधार पर लचीलेपन के विभिन्न स्तरों को प्रदर्शित करता है, जो एक आकृति में नियंत्रण बिंदुओं की संख्या से जुड़ा होता है। खेत के उदाहरण में (संदर्भ Supp. चित्र 1 (b) देखें), यह घर की छत और दीवारों जैसी सरल संरचनाओं को सीधी रेखाएं सौंपता है, जबकि घास और फसलों जैसे अधिक जटिल तत्वों को अर्ध-वृत्तों से बनाया जाता है, जिससे अधिक लचीलापन मिलता है। पेड़ों जैसी और भी जटिल संरचनाओं को वृत्तों का उपयोग करके रेंडर किया गया है, जो कि सबसे लचीली आकृति है, जो जटिलता के विभिन्न स्तरों के लिए विभिन्न बुनियादी आकृतियों का उपयोग करने में मॉडल के कौशल को दर्शाती है। आकृतियों का यह रणनीतिक उपयोग विस्तृत, सूक्ष्म रेखाचित्र बनाने की मॉडल की क्षमता को बढ़ाता है। प्रिमिटिव लेवल ट्रैकिंग और समग्र स्केच लेवल ट्रैकिंग के साथ स्केच जनरेशन के अतिरिक्त उदाहरण क्रमशः चित्र 1 और संदर्भ (Supp.) के चित्र 2-5 में दिखाए गए हैं।
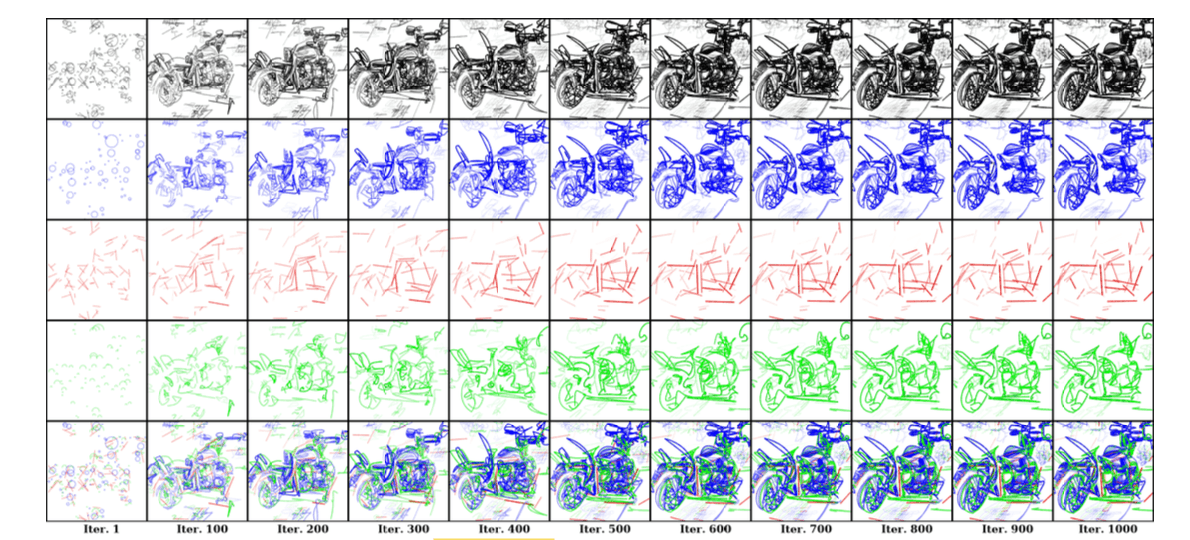
चित्र 3. टेक्स्ट प्रॉम्प्ट "A standing motorcycle" के लिए, हमारा CLIPDraw++ अनुकूलन के दौरान प्रत्येक बुनियादी आकृति के विकास को ट्रैक करता है: पहली पंक्ति एक ब्लैक-एंड-व्हाइट संश्लेषित स्केच दिखाती है, अगली तीन पंक्तियाँ वृत्तों, सीधी रेखाओं और अर्ध-वृत्तों के विकास को प्रदर्शित करती हैं, और अंतिम पंक्ति इन तीनों पंक्तियों की रचनाओं को जोड़ती है। यहाँ क्रॉस-अटेंशन मैप बनाने के लिए "motorcycle" का उपयोग किया गया है।
4.2. तुलना
हमारे CLIPDraw++ मॉडल की तुलना पांच संबंधित तरीकों से की जाती है: CLIPDraw [5], जो CLIP-गाइडेड रेखाचित्रों के लिए बेज़ियर वक्रों को अनुकूलित करता है; CLIPasso [31], जो बेज़ियर वक्रों के साथ रेखाचित्रों को सरल बनाता है; CLIPascene [30], जो CLIP एम्बेडिंग्स से दृश्य रेखाचित्र उत्पन्न करता है; VectorFusion [11], जो वेक्टर रेखाचित्रों के लिए एक डिफ्यूजन मॉडल का उपयोग करता है; और SVGDreamer [33], जो स्ट्रोक-आधारित प्रसार दृष्टिकोण के माध्यम से स्पष्ट रेखाचित्र बनाता है। निष्पक्ष तुलना के लिए सभी मॉडलों का परीक्षण उनकी मूल सेटिंग्स के साथ किया जाता है।
तालिका 1 में, हम कोसाइन समानता (CS) [10], पीक सिग्नल-टू-नॉइज़ रेशियो (PSNR) [9], CLIP-T स्कोर [24], BLIP स्कोर [13], और भ्रम स्कोर (Conf.) [32] सहित मौजूदा साहित्य [5, 33] के बाद विभिन्न मूल्यांकन मेट्रिक्स का उपयोग करके अपने दृष्टिकोण को मान्य करने के लिए मात्रात्मक प्रयोग प्रस्तुत करते हैं। हमारे CLIPDraw++ ने CS, CLIP-T, और BLIP मेट्रिक्स में अन्य सभी तरीकों को महत्वपूर्ण रूप से पीछे छोड़ दिया है, और PSNR और Conf में दूसरा सर्वश्रेष्ठ स्थान प्राप्त किया है, जो इसकी प्रभावशीलता को प्रदर्शित करता है। CS, CLIP-T, और BLIP में उच्च स्कोर इंगित करते हैं कि CLIPDraw++ टेक्स्ट प्रॉम्प्ट के साथ निकटता से संरेखित रेखाचित्र उत्पन्न करता है। यद्यपि SVGDreamer छवि स्थान में सीधे अनुकूलित अपने स्ट्रोक-आधारित प्रसार दृष्टिकोण के कारण थोड़ा अधिक PSNR और भ्रम स्कोर प्राप्त करता है, हमारी विधि अधिक कुशल है और व्यापक अनुकूलन के बिना यथार्थवादी रेखाचित्र प्राप्त करती है। इसके अलावा, हमारा उच्च PSNR कम सुपरसैचुरेशन को इंगित करता है, और भ्रम स्कोर हमारे उत्पन्न रेखाचित्रों के यथार्थवाद को रेखांकित करता है।
तालिका 1. मौजूदा तरीकों के साथ मात्रात्मक तुलना।
विधि / मीट्रिक | CS ↑ | PSNR ↑ | CLIP-T ↑ | BLIP ↑ | Conf. ↑ |
|---|---|---|---|---|---|
CLIPDraw [5] | 0.2578 | 28.1740 | 0.3114 | 0.2611 | 0.49 |
CLIPasso [31] | 0.2250 | 27.5000 | 0.2850 | 0.2783 | 0.45 |
VectorFusion [11] | 0.2283 | 28.3277 | 0.2949 | 0.3894 | 0.44 |
CLIPascene [30] | 0.2000 | 27.0231 | 0.2746 | 0.2551 | 0.42 |
SVGDreamer [33] | 0.2688 | 28.7384 | 0.3132 | 0.4102 | 0.61 |
CLIPDraw++ (हमारा) | 0.2763 | 28.6417 | 0.3365 | 0.4222 | 0.58 |
जैसा कि चित्र 4 में दिखाया गया है, हमारा CLIPDraw++ ऐसे रेखाचित्र बनाता है जो CLIPDraw की तुलना में काफ़ी साफ़ और शब्दार्थ रूप से अधिक निकट (जैसा कि CLIP-T स्कोर द्वारा इंगित किया गया है) हैं, संभवतः प्रिमिटिव-लेवल ड्रॉपआउट के हमारे तरीके के उपयोग और कम अस्पष्टता पर प्रिमिटिव्स के इनिशियलाइजेशन के कारण। CLIPasso की तुलना में, जो बेज़ियर वक्रों का उपयोग करके रेखाचित्रों को सरल बनाता है लेकिन अक्सर बारीक विवरण खो देता है, CLIPDraw++ बिना किसी अत्यधिक स्मूथिंग के स्पष्टता और विवरण दोनों को बनाए रखता है। VectorFusion के विपरीत, जो वेक्टर रेखाचित्रों के लिए एक डिफ्यूजन मॉडल का उपयोग करता है लेकिन अमूर्त और कम सुसंगत निरूपणों के साथ संघर्ष करता है, हमारी विधि अधिक सटीक और शब्दार्थ रूप से समृद्ध आउटपुट सुनिश्चित करती है। CLIPascene, हालांकि दृश्य-स्तरीय रेखाचित्र उत्पन्न करने में सक्षम है, अक्सर प्रिमिटिव प्लेसमेंट के कम प्रभावी नियंत्रण के कारण अव्यवस्था पैदा करता है, जबकि CLIPDraw++ संरचित प्रिमिटिव इनिशियलाइजेशन के माध्यम से स्पष्टता बनाए रखता है। यद्यपि SVGDreamer स्ट्रोक-आधारित प्रसार दृष्टिकोण के माध्यम से विज़ुअली स्पष्ट रेखाचित्र उत्पन्न करता है, इसका अनुकूलन समय काफी लंबा है, और इसमें कभी-कभी शब्दार्थीय सटीकता की कमी होती है। इसके विपरीत, CLIPDraw++ लगातार सटीक विवरणों और शब्दार्थों के साथ साफ रेखाचित्र प्रदान करता है। हमारे रेखाचित्रों में कम शोर का कारण कम किए गए नियंत्रण बिंदु, बुनियादी आकृतियों के लिए सीखने योग्य अस्पष्टता और बुनियादी-स्तर पर विलोपन (प्रिमिटिव-लेवल ड्रॉपआउट) है, जिससे मैन्युअल हस्तक्षेप और पैरामीटर समायोजन की आवश्यकता कम हो जाती है।
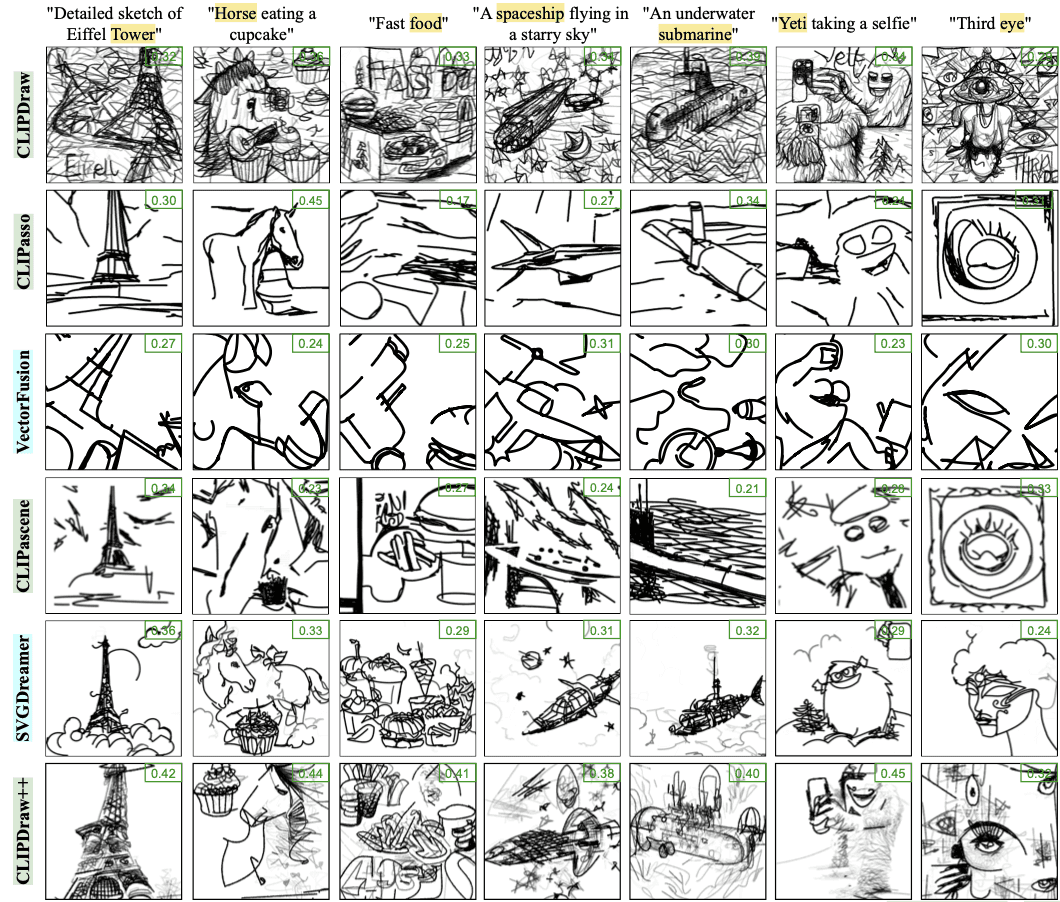
चित्र 4. हमारे CLIPDraw++ के साथ CLIP आधारित दृष्टिकोण CLIPDraw, CLIPasso, CLIPascene, और प्रसार आधारित दृष्टिकोण VectorFusion, SVGDreamer के बीच मात्रात्मक माप के साथ गुणात्मक तुलना। प्रत्येक छवि के ऊपरी-दाएँ कोने में हरे रंग की संख्याएँ टेक्स्ट प्रॉम्प्ट के संबंध में CLIP-T स्कोर को दर्शाती हैं। क्रॉस-अटेंशन मैप बनाने के लिए हाइलाइट किए गए शब्दों का उपयोग किया जाता है।
दिखाए गए उदाहरण:
"कपकेक खाता हुआ घोड़ा"
"फास्ट फूड"
"तारों भरे आसमान में उड़ता हुआ एक अंतरिक्ष यान"
"पानी के नीचे एक पनडुब्बी"
"सेल्फी लेता हुआ येती"
"तीसरी आँख"
"एफिल टॉवर का विस्तृत रेखाचित्र"
4.3. मॉडल एब्लेशन
इस खंड में, हम अपने मॉडल के चुनिंदा एब्लेशन अध्ययन प्रस्तुत करते हैं। अतिरिक्त एब्लेशन परिणाम संदर्भ (Supp.) की धारा 3 में हैं।
CLIP-आधारित बनाम डिफ्यूजन-आधारित इनिशियलाइजेशन: CLIPDraw++ में अनुकूलन की नॉनकॉन्वेक्स प्रकृति इस बात के प्रति संवेदनशील है कि बुनियादी आकृतियों को कैसे इनिशियलाइज़ किया जाता है। हम दो तरीकों की खोज करते हैं: एक CLIP अटेंशन मैप (चित्र 6 (a)) का उपयोग करके और दूसरा लेटेंट डिफ्यूजन मॉडल के अटेंशन मैप (चित्र 6 (c)) पर आधारित। इन मानचित्रों (चित्र 6 (b) और चित्र 6 (d)) में स्थानीय मैक्सिमा प्रमुख लैंडमार्क बिंदुओं की पहचान करते हैं। हमारे निष्कर्षों से पता चलता है कि CLIP अटेंशन मैप में सटीकता की कमी है, जो अप्रासंगिक क्षेत्रों पर ध्यान केंद्रित करता है, जबकि डिफ्यूजन मॉडल का अटेंशन अधिक स्थानीयकृत और विस्तृत जानकारी प्रदान करता है। यही सटीकता कारण है कि हम रेखाचित्रों को इनिशियलाइज़ करने के लिए प्रसार-आधारित (डिफ्यूजन-आधारित) अटेंशन मैप को प्राथमिकता देते हैं।
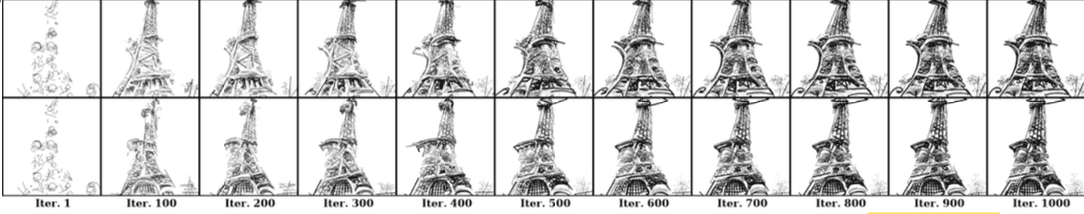
चित्र 5. टेक्स्ट प्रॉम्प्ट "Detailed sketch of Eiffel Tower" के लिए प्रिमिटिव-लेवल ड्रॉपआउट (PLD) की प्रभावशीलता। ऊपरी पंक्ति के रेखाचित्र PLD के बिना संश्लेषित किए गए हैं, जबकि निचली पंक्ति के रेखाचित्र PLD के साथ संश्लेषित किए गए हैं।
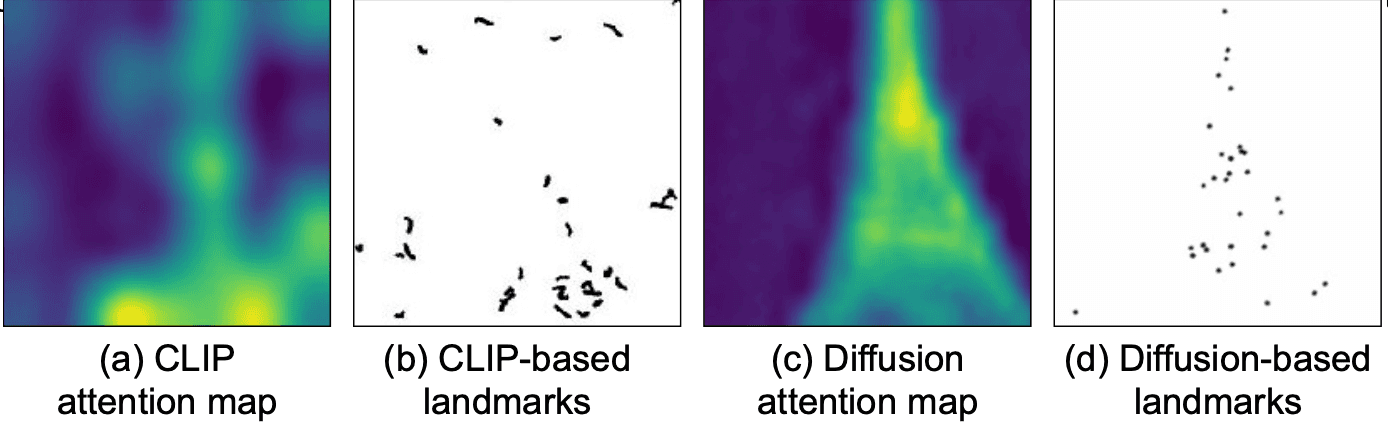
चित्र 6. CLIP और डिफ्यूजन अटेंशन मैप्स और इनिशियलाइजेशन।
(a) CLIP अटेंशन मैप
(b) CLIP-आधारित लैंडमार्क
(c) डिफ्यूजन अटेंशन मैप
(d) डिफ्यूजन-आधारित लैंडमार्क
पैच-आधारित इनिशियलाइजेशन: CLIPDraw++ में, हम स्ट्रोक इनिशियलाइजेशन के लिए पैच-आधारित दृष्टिकोण का उपयोग करते हैं, प्रिमिटिव्स को सीधे अटेंशन मैप पर लैंडमार्क बिंदुओं के बजाय पैच के भीतर रखते हैं। यह विधि बिंदु-आधारित इनिशियलाइजेशन की विशिष्ट अव्यवस्था और गंदगी को रोकती है। जैसा कि चित्र 7 में दिखाया गया है, पैच-आधारित इनिशियलाइजेशन (चित्र 7 (d)) के साथ बनाए गए रेखाचित्र बिंदु-आधारित इनिशियलाइजेशन (चित्र 7 (b)) की तुलना में अधिक स्पष्ट और सुसंगत हैं। अटेंशन स्थानीय मैक्सिमा (पैच आकार के आधार पर) की एक निर्धारित सीमा के भीतर प्रिमिटिव्स को वितरित करना अत्यधिक बाधाओं से बचाता है और स्पष्टता बनाए रखने में मदद करता है। यह ऑप्टिमाइज़र को कैनवास का एक स्पष्ट दृश्य देता है, जिससे प्रिमिटिव्स को अधिक प्रभावी ढंग से बनाए रखने, विकसित करने या हटाने में मदद मिलती है, जिसके परिणामस्वरूप साफ रेखाचित्र बनते हैं।
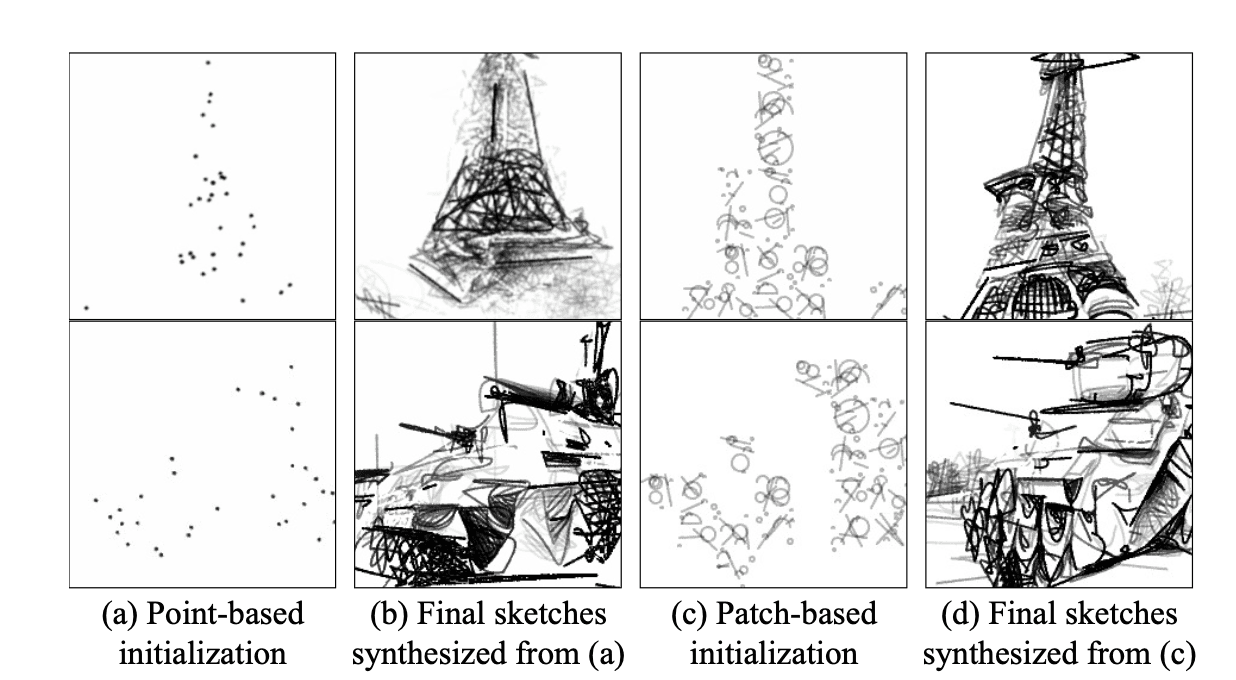
चित्र 7. बिंदु-आधारित और पैच-आधारित इनिशियलाइजेशन के लिए 'एफिल टॉवर' और 'टैंक' के परिणामों की तुलना।
(a) बिंदु-आधारित इनिशियलाइजेशन
(b) (a) से संश्लेषित अंतिम रेखाचित्र
(c) पैच-आधारित इनिशियलाइजेशन
(d) (c) से संश्लेषित अंतिम रेखाचित्र
प्रिमिटिव-लेवल ड्रॉपआउट (बुनियादी-स्तर पर विलोपन): प्रिमिटिव-लेवल ड्रॉपआउट यह सुनिश्चित करके बुनियादी आकृतियों के उपयोग को बढ़ाता है कि प्रत्येक एक विशिष्ट अवधारणा को एन्कोड करता है, जिससे कोई अर्थ न जोड़ने वाले शोर वाले स्ट्रोक कम हो जाते हैं। PLD प्रासंगिक स्ट्रोक की शीघ्र पहचान करके अभिसरण (कन्वर्जेंस) को भी गति देता है। जैसा कि चित्र 5 में दिखाया गया है, PLD (निचली पंक्ति) के साथ रेखाचित्र अधिक साफ और यथार्थवादी हैं, जबकि PLD के बिना (ऊपरी पंक्ति) अधिक शोर वाले हैं। PLD की प्रभावशीलता का और अधिक आकलन करने के लिए, हमने अनुकूलन के दौरान धीरे-धीरे नए स्ट्रोक जोड़ने की रणनीति के साथ इसकी तुलना की। चित्र 8 में, एब्लेशन से पता चलता है कि PLD दृश्य गुणवत्ता और CLIP-T स्कोर दोनों में इस दृष्टिकोण से बेहतर प्रदर्शन करता है। हमें संदेह है कि अचानक नए प्रिमिटिव्स जोड़ने से हानि परिदृश्य (लॉस लैंडस्केप) की सुगमता बाधित होती है, जिससे अनुकूलन कठिन हो जाता है और परिणामस्वरूप अधिक शोर वाले रेखाचित्र बनते हैं। अधिक परिणाम संदर्भ (Supp.) की धारा 3.1 और चित्र 6 में हैं।
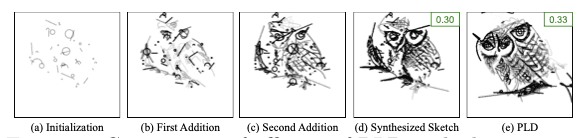
चित्र 8. आवश्यकतानुसार क्रमिक रूप से अतिरिक्त प्रिमिटिव्स जोड़ने की रणनीति के साथ PLD की प्रभावकारिता की तुलना।
(a) इनिशियलाइजेशन
(b) पहला जुड़ाव
(c) दूसरा जुड़ाव
(d) संश्लेषित स्केच (0.30)
(e) PLD (0.33)
5. निष्कर्ष
हमने सीधी रेखाओं, वृत्तों और अर्धवृत्तों जैसी सरल ज्यामितीय बुनियादी आकृतियों का उपयोग करके अनुकूलन के माध्यम से स्केच संश्लेषण के लिए एक मॉडल, CLIPDraw++ पेश किया। हमारा मॉडल इन बुनियादी आकृतियों पर सरल रैखिक परिवर्तनों के माध्यम से अत्यधिक अभिव्यंजक रेखाचित्र बनाता है, जिसमें साफ रेखाचित्रों को संश्लेषित करने के लिए रणनीतिक स्केच कैनवास इनिशियलाइजेशन और कम शोर वाले रेखाचित्रों के उत्पादन के लिए प्रिमिटिव-लेवल ड्रॉपआउट (PLD) जैसी तकनीकों को शामिल किया गया है, जो सामूहिक रूप से मॉडल की दक्षता और आउटपुट गुणवत्ता को बढ़ाते हैं। व्यापक प्रयोग और एब्लेशन अध्ययन मौजूदा तरीकों पर मॉडल की श्रेष्ठता को रेखांकित करते हैं, जो सौंदर्य की दृष्टि से आकर्षक और शब्दार्थ रूप से समृद्ध रेखाचित्र बनाने की इसकी क्षमता को प्रदर्शित करते हैं। CLIPDraw++ सहज डिजाइन सिद्धांतों के साथ उन्नत अनुकूलन को मिलाकर एआई-संचालित कला निर्माण में उत्कृष्टता प्राप्त करता है।
संदर्भ
[1] स्टीफन अलानाइज़, मैसिमिलियानो मैनसिनी, अंजन दत्ता, डिएगो मार्कोस, और ज़ेनेप अकाटा। सरल बुनियादी आकृतियों के माध्यम से रेखाचित्रों को अमूर्त करना। ECCV में, 2022.
[2] अंकन कुमार भुनिया, सलमान खान, हिशाम चोलक्कल, राव मुहम्मद अनवर, फहद शाहबाज़ खान, जोर्मा लाकसोनेन, और माइकल फेल्सबर्ग। DoodleFormer: ट्रांसफॉर्मर्स के साथ रचनात्मक स्केच ड्राइंग। ECCV में, 2022.
[3] कैरोलिन चान, फ्रेडो डूरंड, और फिलिप इसोला। ज्यामिति और शब्दार्थ को व्यक्त करने वाले रेखाचित्र उत्पन्न करना सीखना। CVPR में, 2022.
[4] शू-यू चेन, वानचाओ सु, लिन गाओ, शिहोंग शिया, और होंगबो फू। Deepfacedrawing: रेखाचित्रों से चेहरे की छवियों का गहरा निर्माण। ACM ट्रांस. ग्राफ., 2020.
[5] केविन फ्रैंस, लिसा सोरोस, और ओलाफ विटकोव्स्की। CLIPDraw: भाषा-छवि एनकोडर के माध्यम से टेक्स्ट-टू-ड्राइंग संश्लेषण की खोज। NeurIPS में, 2022.
[6] फेडेरिको गैलाटोलो, मारियो सिमिनो, और गिग्लियोला वैग्लिनी। CLIP-निर्देशित जनरेटिव लेटेंट स्पेस सर्च के माध्यम से कैप्शन से चित्र बनाना और इसके विपरीत। ICIPVE में, 2021.
[7] ज़े गाओ, सिहुआंग मैन, और अंकी वांग। एआई कला और डिजाइन निर्माण उद्योग: व्यक्तिगत उत्पादन से मानव-मशीन सहजीवन में परिवर्तन। WAC में, 2022.
[8] डेविड हा और डगलस एक। स्केच चित्रों का एक तंत्रिका प्रतिनिधित्व (न्यूरल रिप्रेजेंटेशन)। ICLR में, 2018.
[9] एलेन होरे और जेमेल ज़िउ। छवि गुणवत्ता मेट्रिक्स: Psnr बनाम ssim। ICPR में, 2010.
[10] कायी हुआंग, काय्यू सन, एन्ज़े झी, झेंगगुओ ली, और सिहुई लियू। T2i-compbench: ओपन-वर्ल्ड कंपोजिशनल टेक्स्ट-टू-इमेज जनरेशन के लिए एक व्यापक बेंचमार्क। NeurIPS, 36, 2023.
[11] अजय जैन, एम्बर झी, और पीटर अब्बील। VectorFusion: पिक्सेल-आधारित डिफ्यूजन मॉडल को अमूर्त करके टेक्स्ट-टू-एसवीजी। CVPR में, 2023.
[12] जॉन जम्पर, रिचर्ड इवांस, अलेक्जेंडर प्रित्जेल, टिम ग्रीन, माइकल फिगुरनोव, ओलाफ रोनेबर्गर, कैथरीन तुन्यासुवुनाकुल, रस बेट्स, ऑगस्टिन ज़िडेक, अन्ना पोटापेंको, एलेक्स ब्रिजलैंड, क्लेमेंस मेयर, साइमन ए. ए. कोहल, एंड्रयू जे. बैलार्ड, एंड्रयू कोवी, बर्नार्डिनो रोमेरा-परेडेस, स्टैनिस्लाव निकोलोव, रिशुब जैन, जोनास एडलर, ट्रेवर बैक, स्टिग पीटरसन, डेविड रीमन, एलेन क्लैंसी, मिशाल जिलिंस्की, मार्टिन स्टीनइगर, मिशालिना पचोलस्का, तमस बर्गहैमर, सेबस्टियन बोडेनस्टीन, डेविड सिल्वर, ओरिओल विन्याल्स, एंड्रयू डब्ल्यू सीनियर, कोरे कावुककुओग्लू, पुशमीत कोहली, और डेमिस हसाबिस। AlphaFold के साथ अत्यधिक सटीक प्रोटीन संरचना की भविष्यवाणी। नेचर, 2021.
[13] जुनन ली, डोंगक्सू ली, कैमिंग श्योंग, और स्टीवन होई। Blip: एकीकृत विज़न-लैंग्वेज समझ और पीढ़ी के लिए बूटस्ट्रैपिंग भाषा-छवि पूर्व-प्रशिक्षण। ICML में, 2022.
[14] मेंगटियन ली, झे लिन, राडोमिर मेक, एरसिन युमेर, और देवा रामनन। Photo-Sketching: छवियों से समोच्च चित्र निकालना। WACV में, 2019.
[15] त्ज़ु-माओ ली, मिशाल लुकाक, घरबी मिकेल, और जोनाथन रैगन-केली। संपादन और सीखने के लिए डिफ्रेंशिएबल वेक्टर ग्राफिक्स रास्टराइजेशन। SIGGRAPH एशिया में, 2020.
[16] यी ली, यी-झे सोंग, टिमोथी एम. हॉस्पेडल्स, और शाओगांग गोंग। विकृत स्ट्रोक मॉडल के साथ मुक्त-हस्त स्केच संश्लेषण। IJCV, 2017.
[17] रुनताओ लियू, कियान यू, और स्टेला यू। अनुपयोगी स्केच से फोटो संश्लेषण। ECCV में, 2020.
[18] पियोत्र मिरोव्स्की, डायलन बनारसे, माटुश मालिनोव्स्की, साइमन ओसिंडरो, और क्रिस्टांथा फर्नांडो। CLIPCLOP: CLIP-निर्देशित कोलाज और फोटोमोंटाज। ICCC में, 2022.
[19] रयान मर्डोक। द बिग स्लीप: BigGANxCLIP.ipynb, 2021.
[20] अनह गुयेन, जेसन योसिंस्की, और जेफ क्लून। गहरे तंत्रिका नेटवर्क आसानी से मूर्ख बन जाते हैं: अपरिचित छवियों के लिए उच्च आत्मविश्वास की भविष्यवाणियां। CVPR में, 2015.
[21] अनह गुयेन, एलेक्सी डोसोवित्स्की, जेसन योसिंस्की, थॉमस ब्रोक्स, और जेफ क्लून। गहरे जनरेटर नेटवर्क के माध्यम से तंत्रिका नेटवर्क में न्यूरॉन्स के लिए पसंदीदा इनपुट का संश्लेषण। NIPS में, 2016.
[22] अनह गुयेन, जेफ क्लून, योशुआ बेंगियो, एलेक्सी डोसोवित्स्की, और जेसन योसिंस्की। प्लग एंड प्ले जनरेटिव नेटवर्क: लेटेंट स्पेस में छवियों की सशर्त पुनरावृत्ति पीढ़ी। CVPR में, 2017.
[23] झियू क्यू, यूलिया ग्रीडित्सकाया, के ली, काय्यू पांग, ताओ शियांग, और यी-झे सोंग। SketchXAI: मानव रेखाचित्रों के लिए व्याख्यात्मकता पर एक पहली नज़र। CVPR में, 2023.
[24] एलेक रेडफोर्ड, जोंग वूक किम, क्रिस हेलेसी, आदित्य रमेश, गेब्रियल गोह, सांधिनी अग्रवाल, गिरीश शास्त्री, अमांडा आस्केल, पामेला मिश्किन, जैक क्लार्क, आदि। प्राकृतिक भाषा पर्यवेक्षण से हस्तांतरणीय दृश्य मॉडल सीखना। ICML में, 2021.
[25] रॉबिन रोमबाक, एंड्रियास ब्लैटमैन, डोमिनिक लोरेंज, पैट्रिक एसेर, और ब्योर्न ओमर। लेटेंट डिफ्यूजन मॉडल के साथ उच्च-रिज़ॉल्यूशन छवि संश्लेषण। CVPR में, 2022.
[26] डेविड सिल्वर, अजा हुआंग, क्रिस जे. मैडिसन, आर्थर गुएज़, लॉरेंट सिफ्रे, जॉर्ज वैन डेन ड्रिएशे, जूलियन श्रिटविज़र, इओनिस एंटोनोग्लू, वेद पन्नीरसेल्वम, मार्क लैंक्टोट, सैंडर डिएलमैन, डोमिनिक ग्रेवे, जॉन न्हाम, नल कालचब्रेनर, इल्या सुतस्केवर, टिमोथी लिलिक्रैप, मेडेलीन लीच, कोरे कावुककुओग्लू, थोर ग्रेपेल, और डेमिस हसाबिस। गहरे तंत्रिका नेटवर्क और ट्री सर्च के साथ गो (Go) के खेल में महारत हासिल करना। नेचर, 2016.
[27] नीतीश श्रीवास्तव, जेफ्री हिंटन, एलेक्स क्रिझेव्स्की, इल्या सुतस्केवर, और रुस्लान सालखुतदीनोव। ड्रॉपआउट: तंत्रिका नेटवर्क को ओवरफिटिंग से बचाने का एक सरल तरीका। JMLR, 2014.
[28] राफेल तांग, अक्षत पांडे, झियिंग जियांग, गेफेई यांग, करुण कुमार, जिमी लिन, और फरहान तुरे। व्हाट द डैअम (daam): क्रॉस अटेंशन का उपयोग करके स्थिर प्रसार की व्याख्या करना। arXiv प्रीप्रिंट arXiv:2210.04885, 2022.
[29] झेंगयान टोंग, जुआनहोंग चेन, बिंगबिंग नी, और शियाओहांग वांग। वेक्टर फ्लो और ग्रेस्केल द्वारा निर्देशित ड्राइंग प्रक्रिया के साथ स्केच जनरेशन। AAAI में, 2020.
[30] येल विंकर, युवल अललुफ, डैनियल कोहेन-ओर, और एरियल शमीर। CLIPascene: विभिन्न प्रकारों और अमूर्तता के स्तरों के साथ दृश्य स्केचिंग। arXiv में, 2022.
[31] येल विंकर, एहसान पजौहेशगर, जेसिका वाई. बो, रोमन क्रिश्चियन बाचमन, अमित हैम बरमानो, डैनियल कोहेन-ओर, अमीर ज़मीर, और एरियल शमीर। CLIPasso: शब्दार्थ-जागरूक ऑब्जेक्ट स्केचिंग। SIGGRAPH में, 2022.
[32] शीमिंग शिंग, चुआंग वांग, हैताओ झोउ, जिंग झांग, कियान यू, और डोंगक्सू। Diffsketcher: लेटेंट डिफ्यूजन मॉडल के माध्यम से टेक्स्ट निर्देशित वेक्टर स्केच संश्लेषण। NeurIPS में, 2023.
[33] शिमिंग शिंग, हैताओ झोउ, चुआंग वांग, जिंग झांग, डोंगक्सू, और कियान यू। Svgdreamer: डिफ्यूजन मॉडल के साथ टेक्स्ट गाइडेड एसवीजी जनरेशन। CVPR में, 2024.