उत्पादन (प्रडक्शन) में स्ट्रीमिंग स्पीच-टू-टेक्स्ट: ड्रॉपआउट, रिकनेक्ट और डुप्लिकेट को संभालना
स्ट्रीमिंग स्पीच-टू-टेक्स्ट की विश्वसनीयता के लिए एक व्यावहारिक गाइड, जिसमें ड्रॉपआउट्स, रिकनेक्ट लॉजिक, डुप्लिकेट सेगमेंट्स और ट्रांसक्रिप्ट स्कोरिंग शामिल हैं।
प्रवाहित (Streaming) भाषण से पाठ (speech to text) उन तकनीकों में से एक है जो तब तक सीधी लगती है जब तक आप इसे प्रोडक्शन में चलाने की कोशिश नहीं करते। डेमो काम करता है। विलंबता (latency) भी बढ़िया महसूस होती है। फिर आप इसे वास्तविक उपयोगकर्ताओं के लिए वास्तविक नेटवर्क पर तैनात (deploy) करते हैं, और अचानक आप छूटे हुए कनेक्शन, गलत क्रम में आने वाले आंशिक ट्रांसक्रिप्ट, एक ही शब्द का दो बार दिखाई देना, और यह जानने का कोई स्पष्ट तरीका न होना कि जो आउटपुट आपको मिल रहा है वह वास्तव में भरोसेमंद है या नहीं, जैसी समस्याओं से निपटने लगते हैं।
यह गाइड उन डेवलपर्स और एमएल इंजीनियरों के लिए लिखा गया है जो 'हेलो वर्ल्ड' चरण को पार कर चुके हैं और यह समझना चाहते हैं कि लाइव स्ट्रीमिंग ट्रांसक्रिप्शन सिस्टम में वास्तव में क्या गड़बड़ी होती है। अंत तक, आप यह जान जाएंगे कि ड्रॉपआउट इवेंट्स का निदान और प्रबंधन कैसे करें, रिकनेक्ट लॉजिक को कैसे लागू करें जो आपके ट्रांसक्रिप्ट को दूषित न करे, डुप्लिकेट खंडों को कैसे हटाए, और ऐसे स्कोरिंग तरीकों को कैसे लागू करें जो आपको बताएं कि दिया गया आउटपुट कार्रवाई करने योग्य है या नहीं।
ग्लोबल स्पीच और वॉयस रिकग्निशन बाजार का मूल्य 2025 में $19.09 बिलियन था और 2026 में इसके $23.70 बिलियन तक पहुंचने का अनुमान है (Fortune Business Insights, 2026), जिसका अर्थ है कि इसे सही करने का दबाव केवल बढ़ रहा है।
स्ट्रीमिंग ट्रांसक्रिप्शन वास्तव में कैसे काम करता है
समस्याओं को ठीक करने से पहले, आपको इस बात का सटीक मानसिक मॉडल होना चाहिए कि पृष्ठभूमि में क्या हो रहा है।
स्ट्रीमिंग ट्रांसक्रिप्शन कोई एकल अनुरोध और प्रतिक्रिया नहीं है। यह एक निरंतर द्विदिश (bidirectional) चैनल है जहां ऑडियो के टुकड़ों को एक रिकग्निशन इंजन को भेजा जाता है और आंशिक या अंतिम ट्रांसक्रिप्ट खंड एसिंक्रोनस रूप से वापस आते हैं। कई प्रोडक्शन स्ट्रीमिंग सिस्टम सामान्य नेटवर्क स्थितियों के तहत कुछ सौ मिलीसेकंड के भीतर आंशिक परिणाम दिखाते हैं, हालांकि सटीक विलंबता प्रदाता, मॉडल, नेटवर्क गुणवत्ता और ऑडियो चंकिंग रणनीति के आधार पर भिन्न होती है।
अधिकांश प्रोडक्शन कार्यान्वयन WebSocket कनेक्शन का उपयोग करते हैं क्योंकि वे बार-बार HTTP हैंडशेक के बिना एक स्थायी चैनल बनाए रखते हैं। ऑडियो को आम तौर पर PCM या Opus के रूप में एन्कोड किया जाता है और 20 से 100 मिलीसेकंड के फ्रेम में भेजा जाता है। रिकग्निशन इंजन एक आंतरिक ध्वनिक संदर्भ (acoustic context) विंडो बनाए रखता है, यही वजह है कि अचानक ड्रॉपआउट से केवल एक शब्द नहीं खोता। यह रीकनेक्शन के बाद ऑडियो के अगले कई सेकंड के संदर्भ को दूषित कर सकता है।
इंजन दो प्रकार के परिणाम लौटाता है: अंतरिम परिणाम (अस्थिर के रूप में चिह्नित, संशोधन के अधीन) और अंतिम परिणाम (प्रतिबद्ध, संशोधित नहीं)। डाउनस्ट्रीम लॉजिक के लिए यह अंतर अत्यधिक मायने रखता है। यदि आप ट्रांसक्रिप्ट को रीयल-टाइम डिस्प्ले या वॉयस एजेंट में फीड कर रहे हैं, तो अंतरिम परिणामों को अंतिम मानकर व्यवहार करने से झिलमिलाहट (flickering) और अविश्वसनीय अनुभव होगा। यदि आप अनुपालन (compliance) या खोज अनुक्रमण (search indexing) के लिए ट्रांसक्रिप्ट संग्रहीत कर रहे हैं, तो आपको केवल अंतिम परिणामों को ही सहेजना चाहिए।
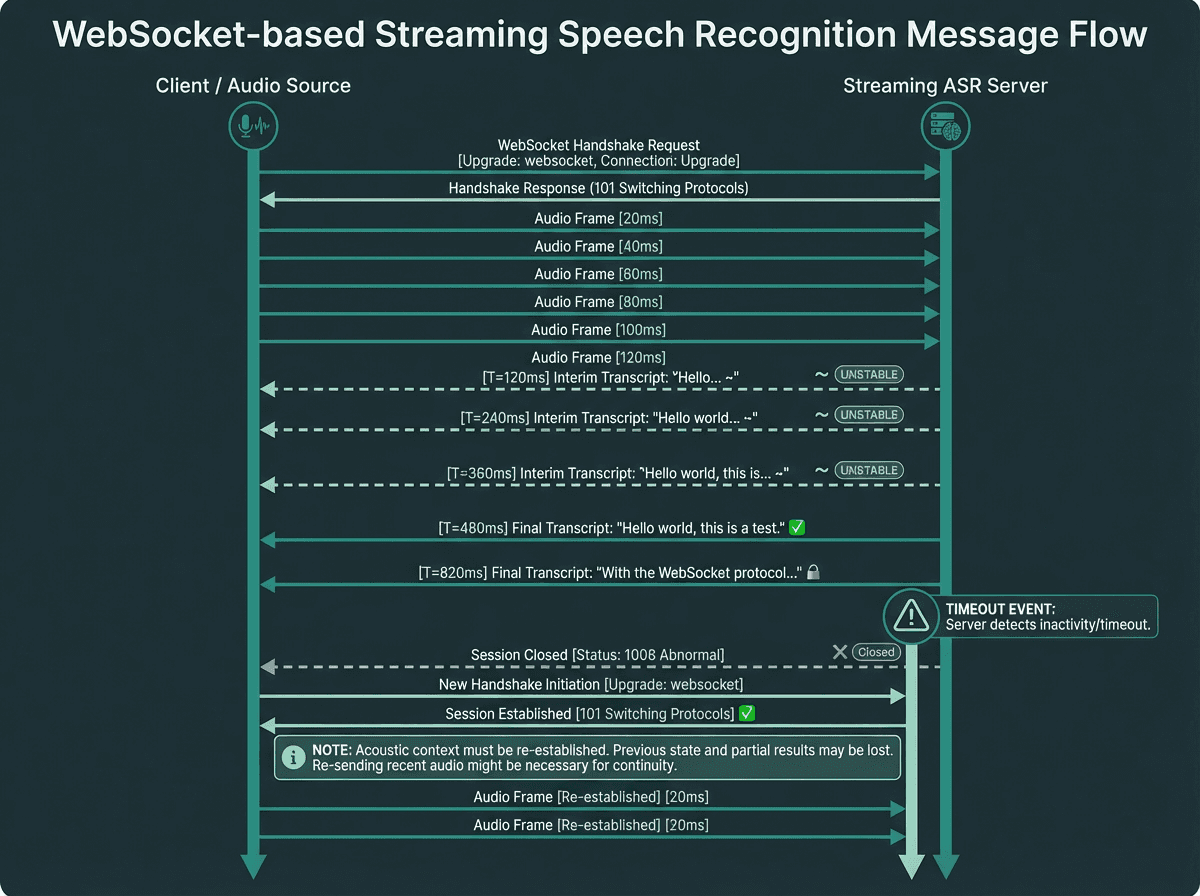
अंतरिम परिणाम अस्थिर अनुमान हैं; अंतिम परिणाम प्रतिबद्ध हैं। रिकनेक्ट लॉजिक को केवल कनेक्शन ही नहीं, बल्कि ध्वनिक संदर्भ को भी फिर से स्थापित करना चाहिए।
ड्रॉपआउट घटनाओं का निदान और प्रबंधन
ड्रॉपआउट कोई भी ऐसी घटना है जो रिकग्निशन इंजन में ऑडियो के निरंतर प्रवाह को बाधित करती है। इसके कारण दो श्रेणियों में विभाजित होते हैं: नेटवर्क-साइड और क्लाइंट-साइड। नेटवर्क-साइड ड्रॉपआउट में वेबसॉकेट डिस्कनेक्शन, कोडेक की छुपाने की सीमा (concealment threshold) से ऊपर पैकेट की हानि, और निष्क्रियता से सर्वर-साइड टाइमआउट शामिल हैं। क्लाइंट-साइड ड्रॉपआउट में माइक्रोफ़ोन अनुमति निरस्तीकरण, डिवाइस स्विचिंग (कॉल के बीच में उपयोगकर्ता द्वारा हेडफ़ोन प्लग करना), और मोबाइल पर बैकग्राउंड में एप्लिकेशन जाना शामिल है।
मापने के लिए सबसे महत्वपूर्ण चीज़ गैप की अवधि (gap duration) है। 500 मिलीसेकंड से कम के गैप को अक्सर ऑडियो बफरिंग के साथ रिकवर किया जा सकता है और इंजन इसे ब्रेक के रूप में भी दर्ज नहीं कर सकता है। 500 मिलीसेकंड से 2 सेकंड के बीच का गैप संभवतः ध्वनिक संदर्भ विंडो को दूषित कर देगा और पुन: कनेक्शन के बाद पहले वाक्य के लिए विकृत आउटपुट उत्पन्न करेगा। 2 सेकंड से अधिक के गैप को एक सत्र की समाप्ति (session termination) के रूप में माना जाना चाहिए, न कि एक ठहराव के रूप में।
व्यावहारिक ड्रॉपआउट हैंडलिंग चेकलिस्ट:
क्लोज़ कोड और कारण स्ट्रिंग के साथ सभी WebSocket क्लोज़ इवेंट्स को ट्रैक करें। कोड 1006 (असामान्य रूप से बंद होना) अस्थिर नेटवर्क स्थितियों में सबसे आम है।
कम से कम 2 सेकंड का क्लाइंट-साइड ऑडियो रिंग बफ़र बनाए रखें ताकि आप रीकनेक्शन के बाद छूटे हुए ऑडियो को फिर से चला सकें।
गैप शुरू होने और समाप्त होने के टाइमस्टैम्प को ट्रैक करें। इन्हें ट्रांसक्रिप्ट सेगमेंट के साथ लॉग करें ताकि आप पहचान सकें कि कौन से आउटपुट संदर्भ ब्रेक के बाद तैयार किए गए थे।
अपनी एप्लिकेशन लेयर को तुरंत एक ड्रॉपआउट इवेंट भेजें, रीकनेक्शन सफल होने की प्रतीक्षा न करें। इससे यूआई घटक चुपचाप खराब होने के बजाय 'कनेक्शन बाधित' स्थिति दिखा सकते हैं।
2 सेकंड से अधिक के गैप के लिए, ध्वनिक संदर्भ को पूरी तरह से छोड़ दें और एक नया सत्र शुरू करें। उसी सत्र को जारी रखने का प्रयास करने से साफ़ रीस्टार्ट की तुलना में बदतर आउटपुट मिलता है।
जानें कि Smallest.ai API स्तर पर स्ट्रीमिंग विश्वसनीयता को कैसे संभालता है
रिकनेक्ट लॉजिक जो आपके ट्रांसक्रिप्ट को दूषित नहीं करता
अधिकांश डेवलपर्स रीकनेक्ट लॉजिक को एक साधारण घातांकीय बैकऑफ़ (exponential backoff) लूप के रूप में लागू करते हैं: प्रतीक्षा करें, पुनः कनेक्ट करें, ऑडियो भेजना फिर से शुरू करें। यह कनेक्शन बनाए रखने के लिए काम करता है लेकिन यह एक सूक्ष्म समस्या पैदा करता है। जब आप पुन: कनेक्ट करते हैं और फिर से शुरू करते हैं, तो आपके पास ओवरलैपिंग या आसन्न ऑडियो वाले दो सत्र होते हैं। स्पष्ट सत्र सीमा ट्रैकिंग (session boundary tracking) के बिना, आपका ट्रांसक्रिप्ट असेंबली लॉजिक यह नहीं जान पाएगा कि एक सत्र कहाँ समाप्त होता है और अगला कहाँ से शुरू होता है।
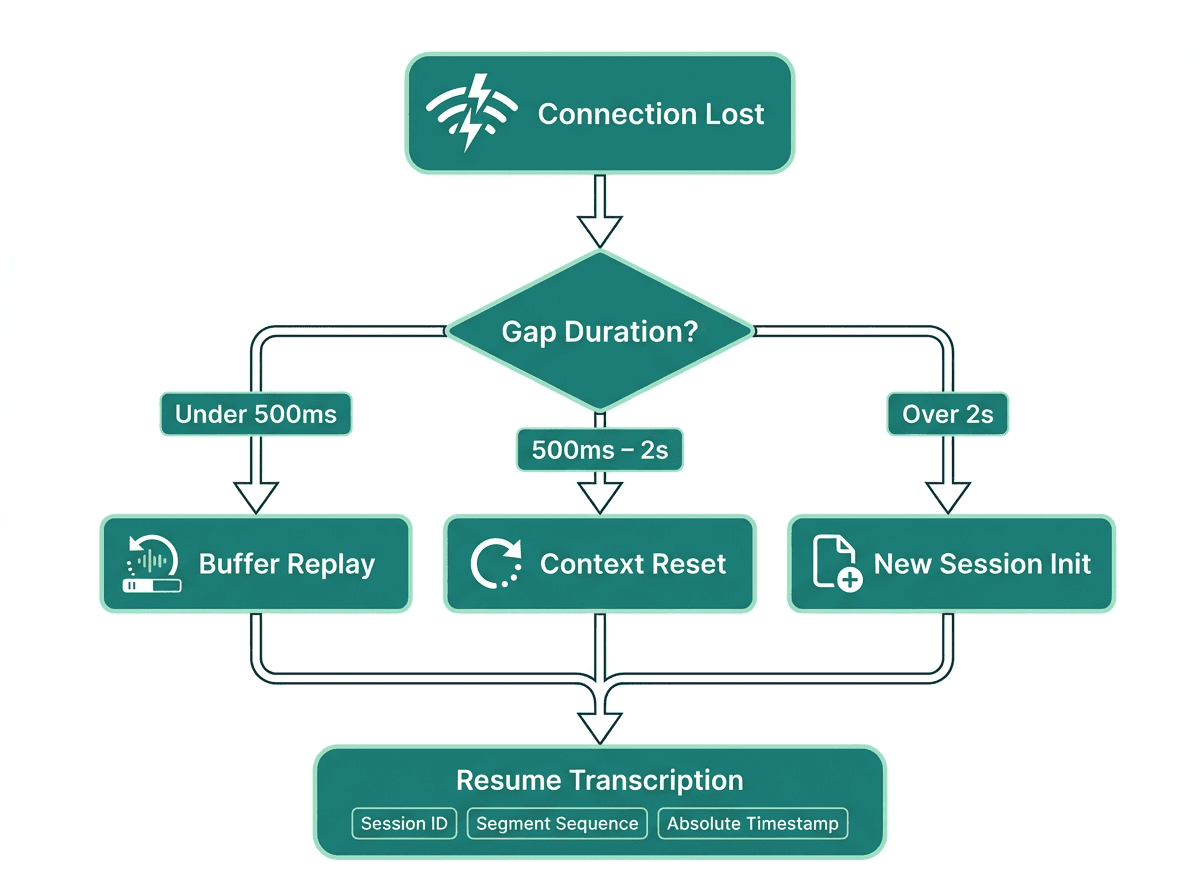
गैप की अवधि यह निर्धारित करती है कि बफ़र किए गए ऑडियो को फिर से चलाना है, संदर्भ को रीसेट करना है, या पूरी तरह से एक नया सत्र शुरू करना है।
इसका समाधान सत्र मेटाडेटा (session metadata) है। प्रत्येक ट्रांसक्रिप्ट सेगमेंट में एक सत्र आईडी, उस सत्र के भीतर एक सेगमेंट अनुक्रम संख्या (sequence number), और एक पूर्ण टाइमस्टैम्प होना चाहिए। जब आप अंतिम ट्रांसक्रिप्ट को असेंबल करते हैं, तो आप आगमन के क्रम के बजाय पूर्ण टाइमस्टैम्प के आधार पर सॉर्ट करते हैं। यह महत्वपूर्ण है क्योंकि नेटवर्क जिटर के कारण रीकनेक्ट किए गए सत्र के सेगमेंट पिछले सत्र के अंतिम सेगमेंट से पहले आ सकते हैं।
एक चीज़ जो अधिकांश गाइड छोड़ देते हैं: आपको ड्रॉपआउट से पहले 'अंतिम प्रतिबद्ध शब्द' (last committed word) को भी ट्रैक करना चाहिए। जब आप पुन: कनेक्ट करते हैं और इंजन परिणाम लौटाना शुरू करता है, तो नए सत्र के पहले कुछ शब्दों की तुलना पिछले सत्र के अंतिम पुष्टि किए गए शब्दों से करें। यदि ओवरलैप है, तो आपके पास एक डुप्लिकेट सेगमेंट है। यदि बोली जाने वाली सामग्री में कोई गैप है, तो आपके पास एक ड्रॉपआउट विरूपण (artifact) है जिसे आपके ट्रांसक्रिप्ट में चिह्नित किया जाना चाहिए, न कि चुपचाप छोड़ दिया जाना चाहिए।
डुप्लिकेट सेगमेंट को हटाना
स्ट्रीमिंग ट्रांसक्रिप्शन में डुप्लिकेट दो अलग-अलग स्रोतों से आते हैं, और उन्हें अलग-अलग समाधानों की आवश्यकता होती है। पहला स्रोत अंतरिम-से-अंतिम प्रचार (interim-to-final promotion) है: इंजन 'बैठक शुरू होगी' युक्त एक अंतरिम परिणाम जारी करता है, फिर 'बैठक तीन बजे शुरू होगी' युक्त एक अंतिम परिणाम जारी करता है। यदि आपका डिस्प्ले लॉजिक दोनों को जोड़ता है, तो उपयोगकर्ता को वाक्यांश दो बार दिखाई देता है। इसका समाधान सीधा है: अंतिम प्रतिबद्ध परिणाम स्थिति के लिए एक पॉइंटर बनाए रखें और अंतरिम परिणामों से केवल उस बिंदु के बाद का टेक्स्ट प्रदर्शित करें।
दूसरा स्रोत रिकनेक्ट ओवरलैप है। जब आप ड्रॉपआउट के बाद बफ़र किए गए ऑडियो को फिर से चलाते हैं, तो इंजन उस ऑडियो को फिर से ट्रांसक्राइब करेगा जिसे उसने पहले ही संसाधित कर लिया है। यह अलग-अलग टाइमस्टैम्प और सत्र आईडी के साथ सिमेंटिक रूप से समान सेगमेंट उत्पन्न करता है। सटीक स्ट्रिंग मिलान का उपयोग करने वाला एक साधारण डीडुप्लिकेशन दृष्टिकोण पुन: ट्रांसक्रिप्शन द्वारा पेश की गई किसी भी भिन्नता (विराम चिह्न अंतर, कैपिटलाइज़ेशन) पर विफल हो जाएगा। एक अधिक विश्वसनीय दृष्टिकोण स्लाइडिंग विंडो एडिट डिस्टेंस चेक का उपयोग करता है: यदि दो सेगमेंट अपने 85% से अधिक टोकन साझा करते हैं और उनके टाइमस्टैम्प ओवरलैप होते हैं, तो उन्हें डुप्लिकेट के रूप में मानें और उच्च विश्वसनीयता स्कोर वाले को रखें।
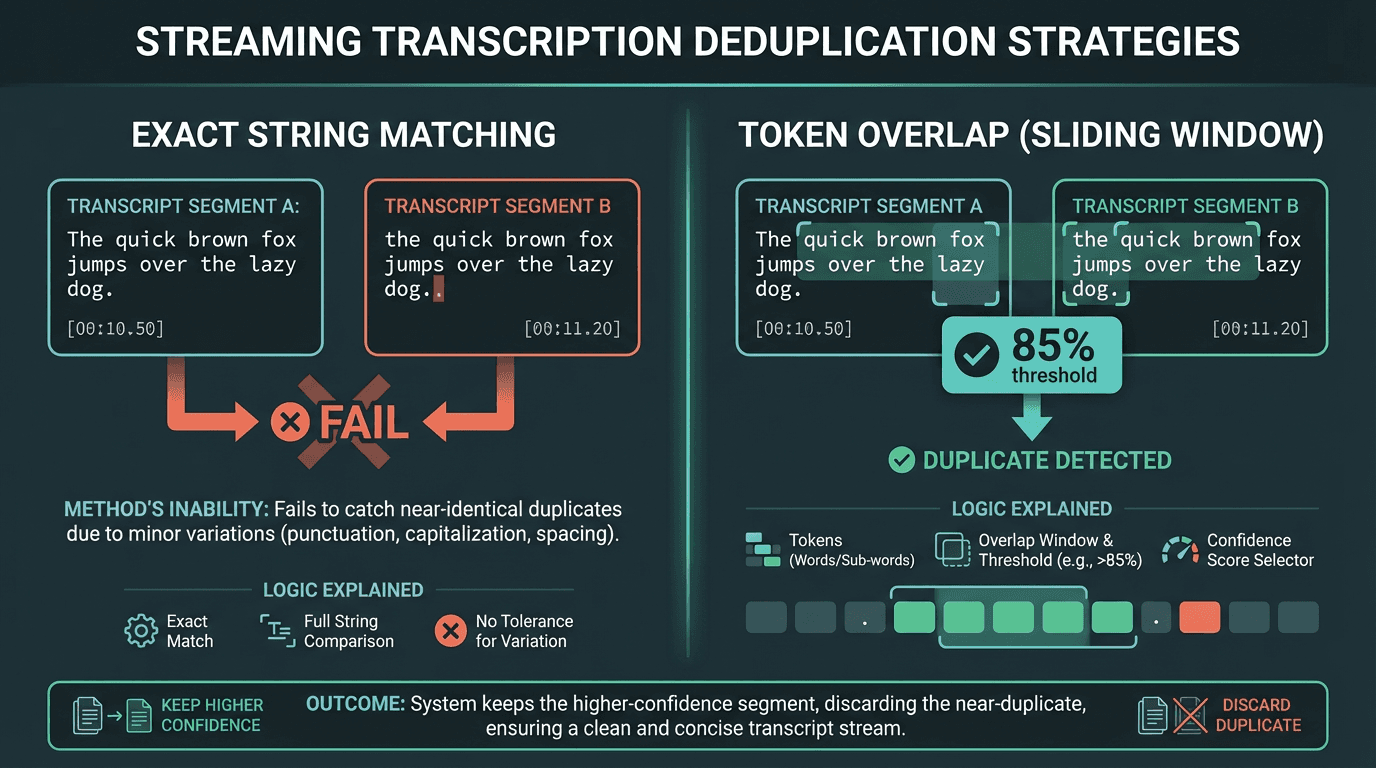
टोकन ओवरलैप डीडुप्लिकेशन उन मामूली ट्रांसक्रिप्शन विविधताओं को संभालता है जिन्हें सटीक स्ट्रिंग मिलान रीकनेक्ट रिप्ले के बाद छोड़ देता है।
ट्रांसक्रिप्ट आउटपुट को स्कोर करना: वास्तव में संख्याओं का क्या अर्थ है
ट्रांसक्रिप्शन सटीकता को मापने के लिए उद्योग मानक वर्ड एरर रेट (WER) है, जो प्रतिस्थापन, सम्मिलन या विलोपन के माध्यम से गलत तरीके से ट्रांसक्राइब किए गए शब्दों के प्रतिशत की गणना करता है। WER भाषण पहचान मूल्यांकन में मानक सटीकता मीट्रिक है, लेकिन क्या स्वीकार्य माना जाता है यह काफी हद तक उपयोग के मामले, ऑडियो गुणवत्ता, स्पीकर परिवर्तनशीलता और डोमेन शब्दावली पर निर्भर करता है।
इष्टतम स्थितियों में, आधुनिक प्रणालियाँ उच्च सटीकता प्राप्त कर सकती हैं, लेकिन पृष्ठभूमि के शोर, मजबूत लहजे या डोमेन-विशिष्ट शब्दावली के साथ यह काफी कम हो जाती है।
WER एक पोस्ट-हॉक मीट्रिक है। आप संदर्भ ट्रांसक्रिप्ट के बिना वास्तविक समय में इसकी गणना नहीं कर सकते। लाइव स्कोरिंग के लिए, अधिकांश प्रोडक्शन सिस्टम प्रति-शब्द विश्वसनीयता स्कोर (per-word confidence scores) पर भरोसा करते हैं जो रिकग्निशन इंजन प्रत्येक सेगमेंट के साथ लौटाता है। ये प्रत्येक पहचाने गए शब्द को सौंपे गए 0 और 1 के बीच की संभावनाएं हैं। एक सेगमेंट जहां सभी शब्द 0.85 से ऊपर स्कोर करते हैं, आम तौर पर विश्वसनीय होता है। 0.6 से नीचे के कई शब्दों वाले सेगमेंट को समीक्षा के लिए चिह्नित किया जाना चाहिए या डाउनस्ट्रीम सिस्टम से दूर रखा जाना चाहिए।
NIST रिच ट्रांसक्रिप्शन इवैल्यूएशन प्रोग्राम दशकों से स्पीच रिकग्निशन सिस्टम के लिए कड़े मूल्यांकन मानकों को परिभाषित कर रहा है, और यदि आप अनुपालन या कानूनी एप्लिकेशन के लिए स्कोरिंग लेयर बना रहे हैं तो उनके फ्रेमवर्क का अध्ययन करने लायक है। अधिकांश उत्पाद उपयोग के मामलों के लिए, एक सरल दृष्टिकोण काम करता है: माध्य शब्द विश्वसनीयता के रूप में सेगमेंट-स्तरीय गुणवत्ता स्कोर की गणना करें, एक सीमा लागू करें (आमतौर पर डिस्प्ले के लिए 0.75, स्टोरेज के लिए 0.85), और कम विश्वसनीयता वाले सेगमेंट को खारिज करने के बजाय मानव समीक्षा कतार में भेजें।
उन्नत विचार: ध्वनिक संदर्भ, भाषा मॉडल और विशेष मामले
यदि आप अभी भी बुनियादी ड्रॉपआउट हैंडलिंग पर काम कर रहे हैं तो इस अनुभाग को छोड़ दें। एक बार जब आपका रिकनेक्ट लॉजिक ठोस हो जाए तो इस पर वापस आएं।
आधुनिक स्ट्रीमिंग रिकग्निशन इंजन ध्वनिक मॉडल के शीर्ष पर एक भाषा मॉडल लेयर का उपयोग करते हैं। इसका मतलब है कि इंजन केवल ध्वनियों को फोनम से मेल नहीं खा रहा है। यह पूर्व संदर्भ के आधार पर संभावित शब्द अनुक्रमों की भविष्यवाणी भी कर रहा है। ड्रॉपआउट रिकवरी के लिए इसका एक गैर-स्पष्ट निहितार्थ है: भले ही आपका ऑडियो रिप्ले ध्वनिक रूप से परिपूर्ण हो, एक नया सत्र बिना किसी भाषा मॉडल संदर्भ के शुरू होता है। रीकनेक्शन के बाद पहले कुछ सेकंड में इंजन द्वारा डोमेन-विशिष्ट शब्दों को गलत सुनने की अधिक संभावना होगी क्योंकि इसने अभी तक बातचीत के विषय के बारे में संदर्भ नहीं बनाया है।
एक समाधान नए सत्र के प्रारंभ में कस्टम शब्दावली या संदर्भ संकेत (context hint) पास करना है। यदि आप जानते हैं कि बातचीत किसी विशिष्ट डोमेन (चिकित्सा, कानूनी, वित्तीय) के बारे में है, तो सत्र को प्रासंगिक शब्दावली के साथ तैयार करने से पोस्ट-रिकनेक्ट विंडो में सटीकता में काफी सुधार होता है। Mozilla Common Voice प्रोजेक्ट ने इस बात पर व्यापक शोध किया है कि विविध प्रशिक्षण डेटा विभिन्न लहजे और डोमेन में पहचान की सटीकता को कैसे प्रभावित करता है, और यदि आप मूल्यांकन कर रहे हैं कि दिया गया इंजन आपके विशिष्ट उपयोगकर्ता समूह को कितनी अच्छी तरह संभालता है, तो अंतर्निहित अकादमिक पेपर पढ़ने योग्य है।
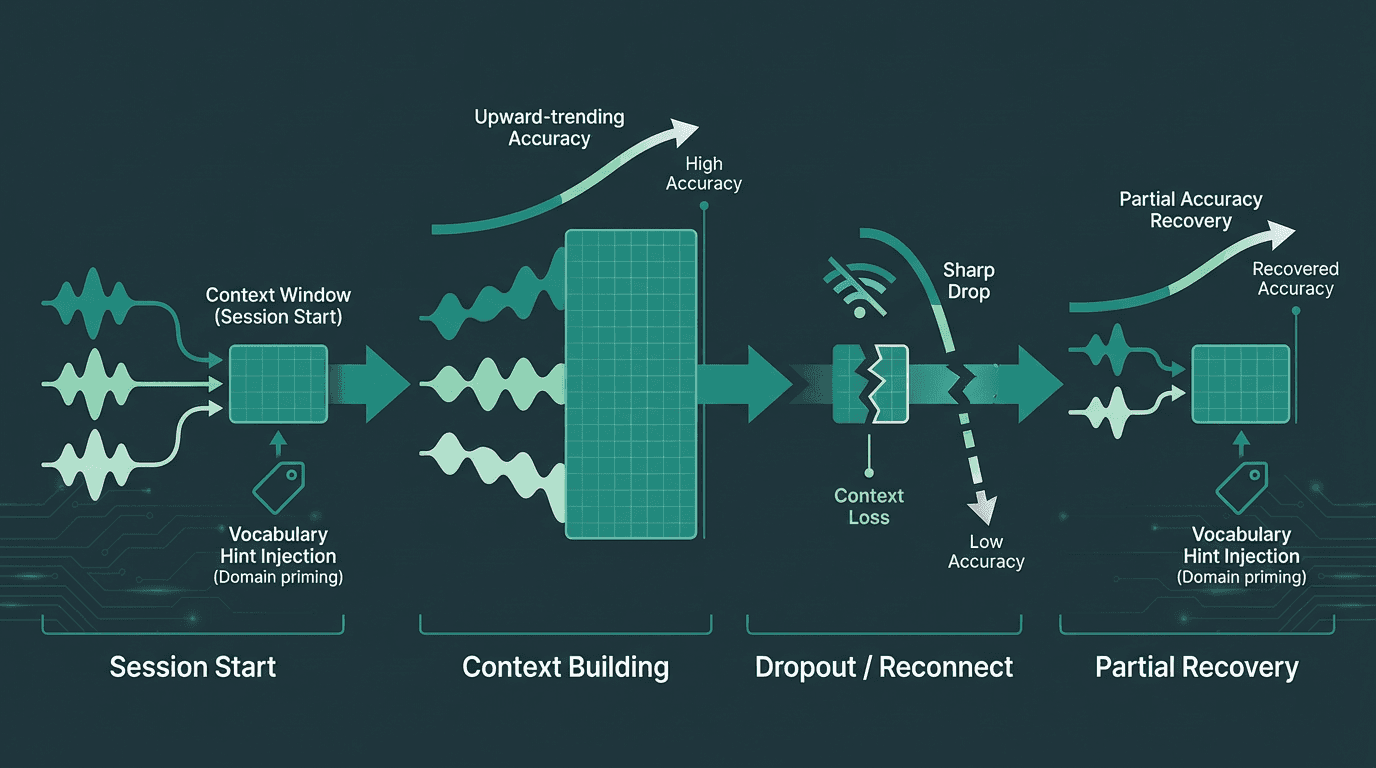
भाषा मॉडल का संदर्भ एक सत्र के दौरान बनता है। रीकनेक्ट इसे रीसेट कर देते हैं, जिससे सत्र की शुरुआत में शब्दावली संकेत सटीकता प्राप्ति का एक सार्थक साधन बन जाते हैं।
एक और विशेष मामला जिसे स्पष्ट रूप से संभाला जाना चाहिए: रीकनेक्ट विंडो के दौरान ओवरलैपिंग स्पीकर। यदि ड्रॉपआउट होने पर दो स्पीकर बात कर रहे हैं और आप बफ़र किए गए ऑडियो को फिर से चलाते हैं, तो प्री-ड्रॉपआउट सत्र के डायराइजेशन लेबल (diarization labels) आगे नहीं बढ़ेंगे। इंजन शुरुआत से स्पीकर लेबल को फिर से असाइन करेगा, जिससे संभावित रूप से शेष सत्र के लिए स्पीकर ए और स्पीकर बी आपस में बदल सकते हैं। यदि आपके एप्लिकेशन के लिए स्पीकर की पहचान मायने रखती है, तो अंतिम पुष्टि की गई डायराइजेशन स्थिति को संग्रहीत करें और रीकनेक्शन के बाद पहले कुछ स्पीकर-एट्रिब्यूटेड सेगमेंट के विरुद्ध इसे मान्य करें।
मुख्य निष्कर्ष और अगले कदम
उत्पादन में विश्वसनीय स्ट्रीमिंग ट्रांसक्रिप्शन एक इंजीनियरिंग अनुशासन है, न कि केवल एक एपीआई कॉल। मुख्य सिद्धांत: प्रत्येक ड्रॉपआउट को एक संभावित संदर्भ ब्रेक के रूप में मानें, बफ़र रिप्ले और सत्र रीस्टार्ट के बीच निर्णय लेने के लिए गैप की अवधि को ट्रैक करें, ट्रांसक्रिप्ट असेंबली के लिए सत्र मेटाडेटा और पूर्ण टाइमस्टैम्प का उपयोग करें, रीकनेक्ट कलाकृतियों के लिए टोकन ओवरलैप डीडुप्लिकेशन लागू करें, और डाउनस्ट्रीम सिस्टम में भेजने से पहले प्रति-शब्द विश्वसनीयता का उपयोग करके सेगमेंट स्तर पर आउटपुट को स्कोर करें।
उत्पादन में जाने से पहले त्वरित संदर्भ चेकलिस्ट:
कोड और कारण लॉगिंग के साथ वेबसॉकेट क्लोज़ इवेंट ट्रैकिंग
कम से कम 2 सेकंड का क्लाइंट-साइड ऑडियो रिंग बफ़र
प्रत्येक ट्रांसक्रिप्ट सेगमेंट पर सत्र आईडी और अनुक्रम संख्या
ट्रांसक्रिप्ट असेंबली के लिए पूर्ण टाइमस्टैम्प सॉर्टिंग
85% सीमा के साथ टोकन ओवरलैप डीडुप्लिकेशन
कम विश्वसनीयता वाले सेगमेंट के लिए रूटिंग लॉजिक के साथ प्रति-शब्द विश्वसनीयता स्कोरिंग
डोमेन-विशिष्ट उपयोग के मामलों के लिए सत्र आरंभीकरण पर शब्दावली संकेत प्रविष्टि
यदि स्पीकर की पहचान मायने रखती है तो रीकनेक्ट सीमाओं के पार डायराइजेशन स्थिति का बने रहना
विभिन्न प्रदाता इन समस्याओं के प्रति कैसे दृष्टिकोण अपनाते हैं, इसके व्यापक दृष्टिकोण के लिए, स्पीच-टू-टेक्स्ट ट्रांसक्रिप्शन सॉफ़्टवेयर की गाइड वर्तमान परिदृश्य को विस्तार से कवर करती है। और यदि आप प्रदाताओं के बीच स्पीच-टू-टेक्स्ट सटीकता का मूल्यांकन करने के चरण में हैं, तो इस गाइड में स्कोरिंग ढांचा आपको मार्केटिंग बेंचमार्क से परे तुलना के लिए एक ठोस आधार देता है।
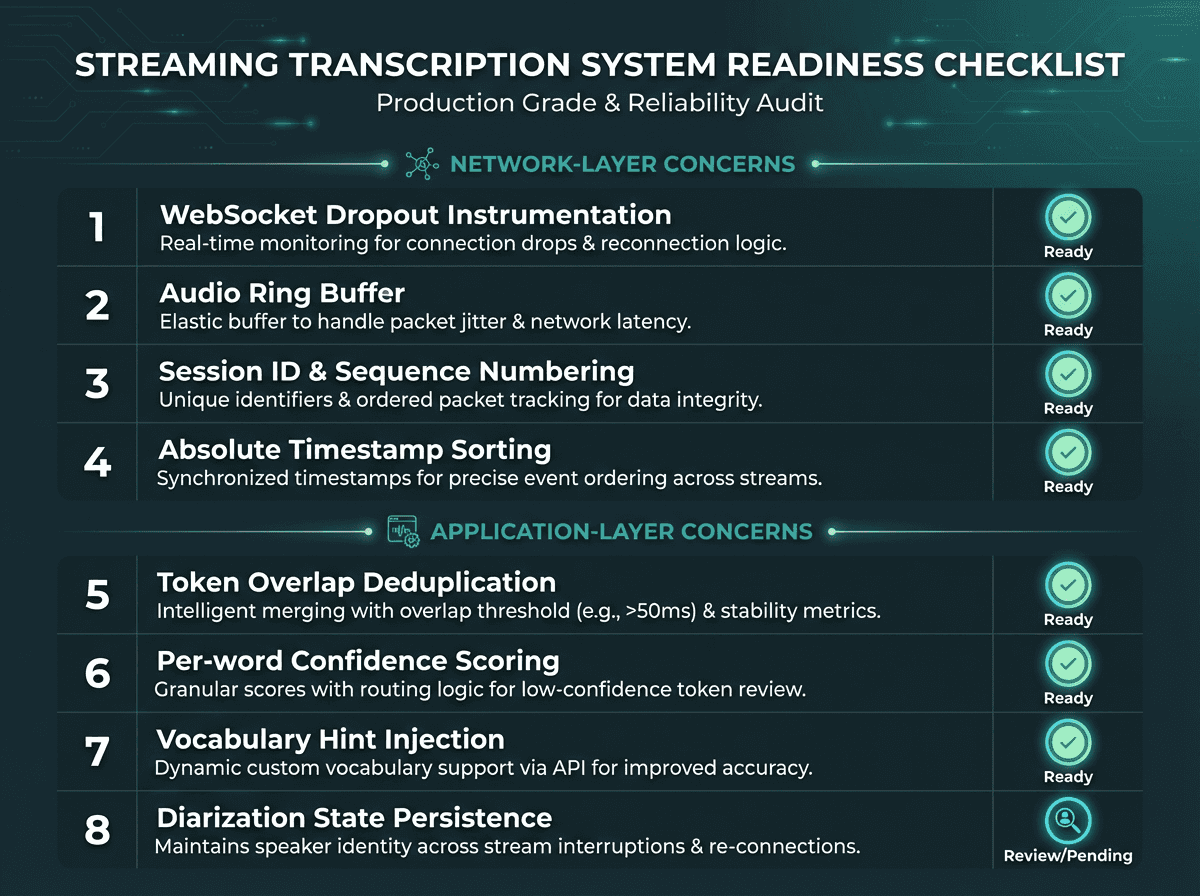
आठ चेकपॉइंट जो एक डेमो-गुणवत्ता वाले स्ट्रीमिंग ट्रांसक्रिप्शन एकीकरण को प्रोडक्शन-ग्रेड एकीकरण से अलग करते हैं।
इस गाइड में वर्णित समस्याएं, जैसे ध्वनिक संदर्भ को दूषित करने वाले ड्रॉपआउट, डुप्लिकेट सेगमेंट बनाने वाले रीकनेक्ट लॉजिक, बिना किसी स्पष्ट रूटिंग लॉजिक वाले विश्वसनीयता स्कोर, इन सभी की एक ही जड़ है: ये इंफ्रास्ट्रक्चर की समस्याएं हैं जिन्हें अकेले रिकग्निशन एपीआई हल नहीं कर सकता है। इन्हें जानबूझकर संभालने के लिए एप्लिकेशन लेयर का निर्माण किया जाना चाहिए। अधिकांश टीमों को इसका पता किसी प्रोडक्शन घटना के बाद ही चलता है, जो सीखने का एक महंगा तरीका है।
Smallest.ai को ठीक इसी तरह के प्रोडक्शन वातावरण के लिए बनाया गया है, जो 300ms से कम समय में पहला आंशिक परिणाम और प्रत्येक सेगमेंट पर प्रति-शब्द विश्वसनीयता स्कोर लौटाता है। स्ट्रीमिंग स्पीच-टू-टेक्स्ट इंजन डोमेन-विशिष्ट शब्दावली के लिए सत्र संदर्भ संकेतों का समर्थन करता है और इसे उस प्रकार के डेवलपर के लिए डिज़ाइन किया गया है जो पहले ही इसे पढ़ चुका है और जानता है कि क्या प्रश्न पूछना है। यदि आप एक वॉयस एजेंट, एक लाइव कैप्शनिंग सिस्टम, या एक रीयल-टाइम एनालिटिक्स पाइपलाइन बना रहे हैं और आपको ऐसे ट्रांसक्रिप्शन की आवश्यकता है जो नेटवर्क खराब होने पर भी काम करे, तो शुरुआत करने के लिए यही सही जगह है। विश्वसनीय वॉयस एआई सिस्टम बनाने के बारे में अधिक तकनीकी गाइड के लिए आप हमारे ब्लॉग को भी देख सकते हैं।
Smallest.ai के स्ट्रीमिंग स्पीच-टू-टेक्स्ट इंजन के साथ निर्माण शुरू करें
अक्सर पूछे जाने वाले प्रश्न
स्ट्रीमिंग स्पीच-टू-टेक्स्ट में अंतरिम परिणाम (interim result) और अंतिम परिणाम (final result) के बीच क्या अंतर है?
ड्रॉपआउट का कितना लंबा अंतराल होने पर पूरे सत्र को दोबारा शुरू करना पड़ता है?
वर्ड एरर रेट (Word Error Rate - WER) क्या है और अपनी स्ट्रीमिंग ट्रांसक्रिप्शन क्वालिटी का मूल्यांकन करने के लिए मैं इसका उपयोग कैसे करूँ?
दोबारा कनेक्ट होने के बाद मुझे बार-बार एक ही शब्द या वाक्यांश क्यों दिखाई देते हैं?
बैकग्राउंड का शोर स्ट्रीमिंग ट्रांसक्रिप्शन की सटीकता और स्कोरिंग को कैसे प्रभावित करता है?