न्यूरल टीटीएस (Neural TTS) क्या है? टेक्स्ट-टू-स्पीच एआई (AI) का गहन विश्लेषण
न्यूरल टेक्स्ट-टू-स्पीच तकनीक को गहराई से समझें। इसके आर्किटेक्चर, वॉयस क्लोनिंग और वास्तविक दुनिया पर इसके प्रभाव को जानें। पूरी तकनीकी गाइड प्राप्त करें।
न्यूरल टीटीएस (Neural TTS), जो न्यूरल टेक्स्ट-टू-स्पीच का संक्षिप्त रूप है, हर उस वॉयस असिस्टेंट, ऑडियोबुक नरेटर और संवादात्मक एआई के पीछे का इंजन है जो वास्तव में इंसानों जैसी आवाज देता है। शुरुआती सिंथेसाइज़र की सपाट, रोबोटिक और एकरस आवाज नहीं। यह कुछ मौलिक रूप से अलग है: गहरे न्यूरल नेटवर्क द्वारा बिल्कुल शुरुआत से तैयार की गई आवाज, जिसने वास्तविक मानव आवाजों की लय, टोन और बनावट को सीखा है।
यह लेख डेवलपर्स, उत्पाद निर्माताओं और उन सभी लोगों के लिए लिखा गया है जो यह समझना चाहते हैं कि वॉयस एआई आंतरिक रूप से कैसे काम करता है। इसे पढ़ने के बाद आप न्यूरल टीटीएस की कार्यप्रणाली को जान पाएंगे, यह पुरानी प्रणालियों से कैसे अलग है, एक अच्छे और बेहतरीन सिस्टम के बीच क्या अंतर है, और यह तकनीक किस दिशा में आगे बढ़ रही है। यदि आप इस क्षेत्र में नए हैं, तो इसकी गहराई में जाने से पहले यह समझना मददगार होगा कि टेक्स्ट-टू-स्पीच क्या है और यह कैसे काम करता है।
न्यूरल टीटीएस वास्तव में क्या है
भाषण संश्लेषण (स्पीच सिंथेसिस) किसी न किसी रूप में 1950 के दशक से अस्तित्व में है, लेकिन इतिहास के अधिकांश हिस्से में यह नियमों और रिकॉर्डिंग पर आधारित था। शुरुआती सिस्टम पूर्व-रिकॉर्डेड ऑडियो टुकड़ों को आपस में जोड़ते थे, जिसे 'क कॉनकैटिनेटिव सिंथेसिस' (concatenative synthesis) कहा जाता है। इसके परिणाम समझने योग्य तो थे लेकिन पूरी तरह से मैकेनिकल थे। आप हमेशा इसका अंतर बता सकते थे। भाषण संश्लेषण के विकिपीडिया के अवलोकन के अनुसार, डीप लर्निंग द्वारा मौलिक बदलाव लाए जाने से पहले यह क्षेत्र पैरामीट्रिक और फॉर्मांट-आधारित तरीकों की कई पीढ़ियों से गुजरा।
क्लिप्स से आवाज जोड़ने के बजाय, न्यूरल टीटीएस डीप न्यूरल नेटवर्क को हजारों घंटों की रिकॉर्ड की गई इंसानी आवाज पर प्रशिक्षित करता है। इससे यह भाषा की आवाज, जिसमें लय-सुर (prosody), जोर (emphasis) और प्राकृतिक ठहराव शामिल हैं, का एक आंतरिक मॉडल तैयार करता है। इसका परिणाम एक ऐसी आवाज होती है जो कॉनकैटिनेटिव तरीकों से तैयार की जाने वाली किसी भी आवाज की तुलना में कहीं अधिक अभिव्यंजक होती है। अब टीटीएस बाजार के राजस्व में न्यूरल और एआई-संचालित आवाजों की हिस्सेदारी सबसे अधिक है, जो यह दर्शाती है कि उद्योग नियम-आधारित संश्लेषण से पूरी तरह से अलग हो चुका है।
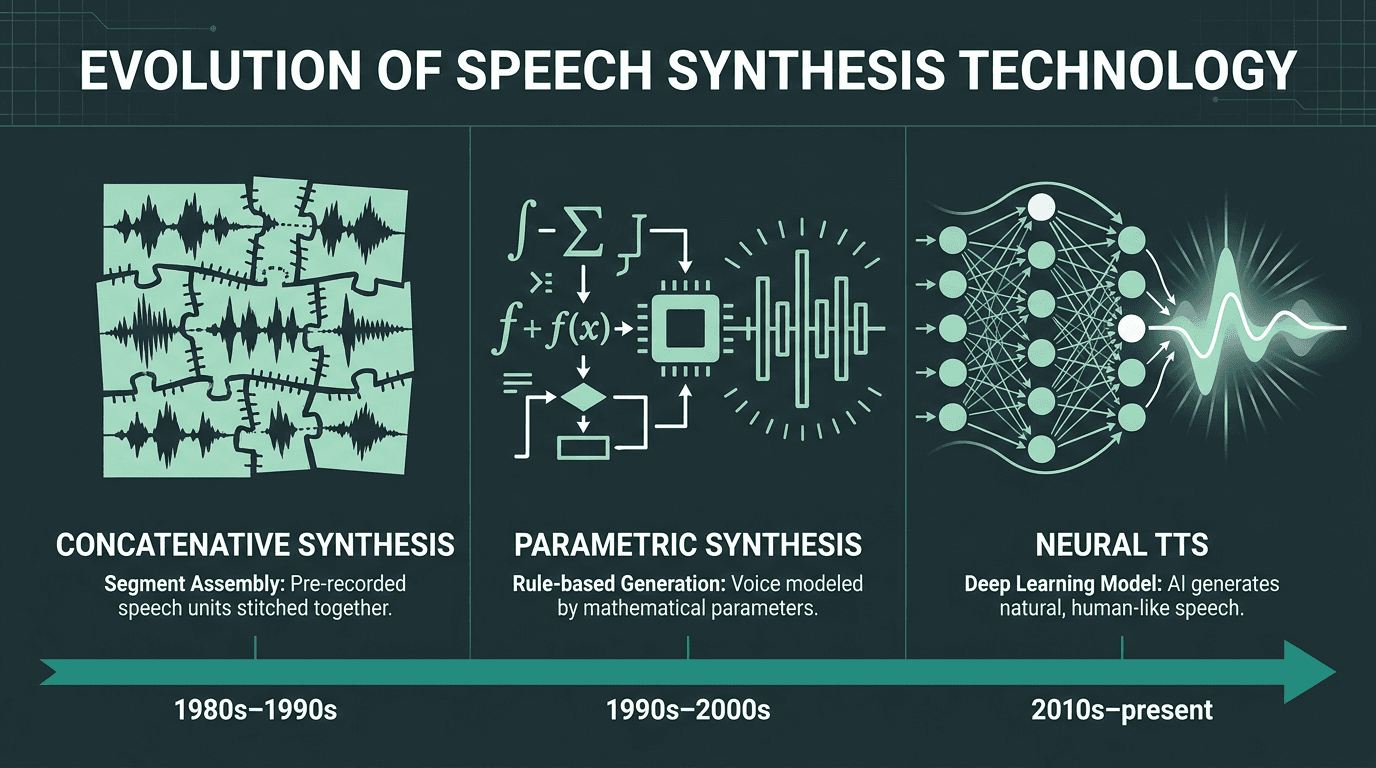
भाषण संश्लेषण तकनीक की तीन पीढ़ियां, नियम-आधारित जुड़ाव (concatenation) से लेकर न्यूरल जेनरेशन तक।
न्यूरल टीटीएस सिस्टम कैसे काम करता है: थ्री-स्टेज पाइपलाइन
ज्यादातर लोग मानते हैं कि न्यूरल टीटीएस एक एकल मॉडल है जो टेक्स्ट लेता है और ऑडियो बाहर निकालता है। व्यवहार में यह तीन अलग-अलग चरणों वाली एक पाइपलाइन है, जिनमें से प्रत्येक एक अलग समस्या का समाधान करता है। इस आर्किटेक्चर को समझना इसलिए महत्वपूर्ण है क्योंकि यह बताता है कि क्यों कुछ सिस्टम दूसरों की तुलना में तेज, अधिक अभिव्यंजक या अधिक अनुकूलन योग्य (customizable) होते हैं।
चरण 1: टेक्स्ट विश्लेषण (Text Analysis)। कोई भी ऑडियो जेनरेट होने से पहले, सिस्टम को यह समझना होता है कि वह क्या पढ़ रहा है। नेचुरल लैंग्वेज प्रोसेसिंग संक्षिप्ताक्षरों, संख्याओं, विराम चिह्नों और संदर्भ को संभालती है। "Dr." का अर्थ एक वाक्य में "डॉक्टर" हो सकता है और दूसरे में "ड्राइव"। टेक्स्ट विश्लेषण चरण इन अस्पष्टताओं को दूर करता है और इनपुट को एक फोनेम अनुक्रम (phoneme sequence) में बदल देता है, जो मूल रूप से टेक्स्ट का एक उच्चारण मानचित्र (pronunciation map) होता है।
चरण 2: एकॉस्टिक मॉडलिंग (Acoustic Modeling)। फोनेम अनुक्रम एकॉस्टिक मॉडल में जाता है, जो स्पेक्ट्रोग्राम का अनुमान लगाता है: एक प्रतिनिधित्व कि समय के साथ पिच, टोन और ऊर्जा कैसे बदलनी चाहिए। यहीं पर लय-सुर (prosody) का वास होता है, और यह काफी हद तक इस बात के लिए जिम्मेदार है कि आवाज स्वाभाविक लगती है या कृत्रिम। टैकोट्रॉन 2 (Tacotron 2) और फास्टस्पीच 2 (FastSpeech 2) जैसे मॉडल इसी चरण में काम करते हैं, जो आउटपुट की लय और माधुर्य को नियंत्रित करते हैं।
चरण 3: वोकोडर (The Vocoder)। स्पेक्ट्रोग्राम कोई ऑडियो नहीं है। एक वोकोडर इसे वास्तविक तरंग (waveform) में परिवर्तित करता है। 2016 में पेश किया गया वेवनेट (WaveNet), न्यूरल नेटवर्क का उपयोग करके सीधे रॉ ऑडियो वेवफॉर्म जेनरेट करने वाला पहला मॉडल था, जिसने उस समय अभूतपूर्व यथार्थवादी आवाज पेश की थी। हाईफाई-गैन (HiFi-GAN) और वेवग्लो (WaveGlow) जैसे आधुनिक वोकोडर्स ने इस प्रक्रिया को रीयल-टाइम अनुप्रयोगों के लिए काफी तेज बना दिया है।
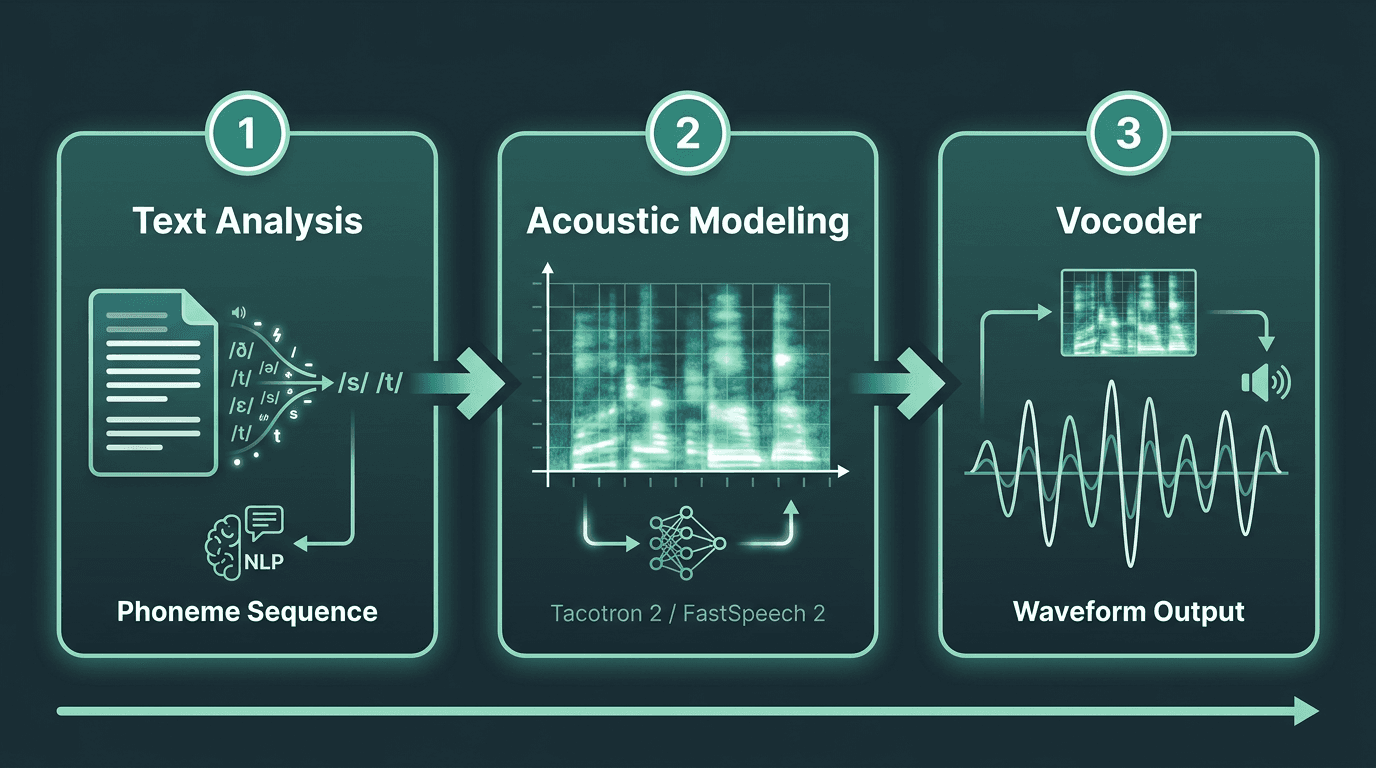
थ्री-स्टेज न्यूरल टीटीएस पाइपलाइन: टेक्स्ट विश्लेषण, एकॉस्टिक मॉडलिंग और वेवफॉर्म सिंथेसिस।
न्यूरल टीटीएस गुणवत्ता के बारे में ज्यादातर लोग क्या गलत समझते हैं
"न्यूरल टीटीएस" कोई एकल गुणवत्ता स्तर नहीं है। एक अच्छी तरह से प्रशिक्षित, कम-विलंबता (low-latency) वाले मॉडल और एक खराब अनुकूलित मॉडल के बीच का अंतर बहुत बड़ा होता है, और यह उन तरीकों से सामने आता है जो सीधे वास्तविक उत्पादों को प्रभावित करते हैं।
विलंबता (Latency) सबसे कम आंकी जाने वाली गुणवत्ता आयाम है। एक सिस्टम जो 800 मिलीसेकंड में सुंदर ऑडियो उत्पन्न करता है, वह लाइव फोन कॉल के लिए अनुपयोगी है। रीयल-टाइम वॉयस अनुप्रयोगों के लिए, 200 मिलीसेकंड से कम का पहला-ऑडियो-समय (time-to-first-audio) एक सामान्य आवश्यकता है, जिसके लिए ऐसे आर्किटेक्चरल विकल्पों की आवश्यकता होती है जो एक बेहतर एकॉस्टिक मॉडल को प्रशिक्षित करने से कहीं आगे जाते हैं। स्ट्रीमिंग सिंथेसिस, जहां पूरा वाक्य संसाधित होने से पहले टुकड़ों में ऑडियो जेनरेट और प्ले किया जाता है, अब एक मुख्य इंजीनियरिंग आवश्यकता बन गई है।
अभिव्यक्ति (Expressiveness) दूसरा बड़ा अंतर है। एक सीमित डेटासेट पर प्रशिक्षित न्यूरल टीटीएस मॉडल सामान्य घोषणात्मक वाक्यों में तो स्वाभाविक लग सकता है, लेकिन प्रश्नों, विस्मयादिबोधकों या भावनात्मक संवादों में बिखर जाएगा। प्रशिक्षण डेटा की व्यापकता और विविधता, इस बात के साथ मिलकर कि मॉडल बोलने की शैली के अनुकूल कैसे काम करता है, यह तय करती है कि कोई आवाज बातचीत को आगे बढ़ा सकती है या केवल एक पैराग्राफ पढ़ सकती है। ये दो आयाम, विलंबता और अभिव्यक्ति, वही हैं जहां उत्पादन-श्रेणी (production-grade) के सिस्टम अपनी उपयोगिता साबित करते हैं।
ये गुणवत्ता आयाम व्यापक क्षेत्र में कैसे फिट होते हैं, इसकी विस्तृत जानकारी के लिए, स्पीच टेक्नोलॉजी लैंडस्केप इस बारे में उपयोगी संदर्भ प्रदान करता है कि अन्य वॉयस एआई घटकों की तुलना में न्यूरल टीटीएस कहां स्थित है।
मुख्य आर्किटेक्चर जिन्होंने आधुनिक न्यूरल टीटीएस को आकार दिया
अकादमिक सर्वेक्षण "ए सर्वे ऑन न्यूरल स्पीच सिंथेसिस" (arXiv, 2021) इस बात का एक व्यापक तकनीकी संदर्भ है कि ये आर्किटेक्चर कैसे विकसित हुए। भले ही आप शोधकर्ता न हों, फिर भी कुछ मील के पत्थरों को जानना उपयोगी है।
आर्किटेक्चर जिन्होंने आधुनिक युग को परिभाषित किया:
वेवनेट (WaveNet - 2016): एक ऑटोरेग्रेसिव मॉडल जिसने डिलेटेड कॉज़ल कन्वोल्यूशन का उपयोग करके नमूने-दर-नमूने (sample by sample) ऑडियो जेनरेट किया। इसकी गुणवत्ता अभूतपूर्व थी, लेकिन बिना महत्वपूर्ण इंजीनियरिंग कार्य के वास्तविक समय (real-time) के उपयोग के लिए यह बहुत धीमा था।
टैकोट्रॉन 2 (Tacotron 2 - 2017): एक सीक्वेंस-टू-सीक्वेंस मॉडल जिसने एक आवर्तक (recurrent) एकॉस्टिक मॉडल को वेवनेट-शैली के वोकोडर के साथ जोड़ा, जिससे एंड-टू-एंड न्यूरल टीटीएस पाइपलाइनों के लिए मानक स्थापित हुआ।
फास्टस्पीच 2 (FastSpeech 2): एक नॉन-ऑटोरेग्रेसिव मॉडल जो क्रमिक रूप से नहीं बल्कि समानांतर में स्पेक्ट्रोग्राम जेनरेट करता है, जिससे गुणवत्ता बनाए रखते हुए अनुमान लगाने की गति (inference speed) में नाटकीय रूप से सुधार होता है।
वीआईटीएस (VITS): स्पेक्ट्रोग्राम चरण को पूरी तरह से छोड़ देता है, और मजबूत स्वाभाविकता स्कोर के साथ सीधे टेक्स्ट से वेवफॉर्म जेनरेट करता है।
डिफ्यूजन-आधारित मॉडल (Diffusion-based models): नवीनतम पीढ़ी, जो ऑडियो जेनरेट करने के लिए बार-बार शोर कम करने (iterative denoising) का उपयोग करती है। असाधारण गुणवत्ता, लेकिन वास्तविक समय की विलंबता लक्ष्यों को प्राप्त करने के लिए सावधानीपूर्वक अनुकूलन की आवश्यकता होती है।
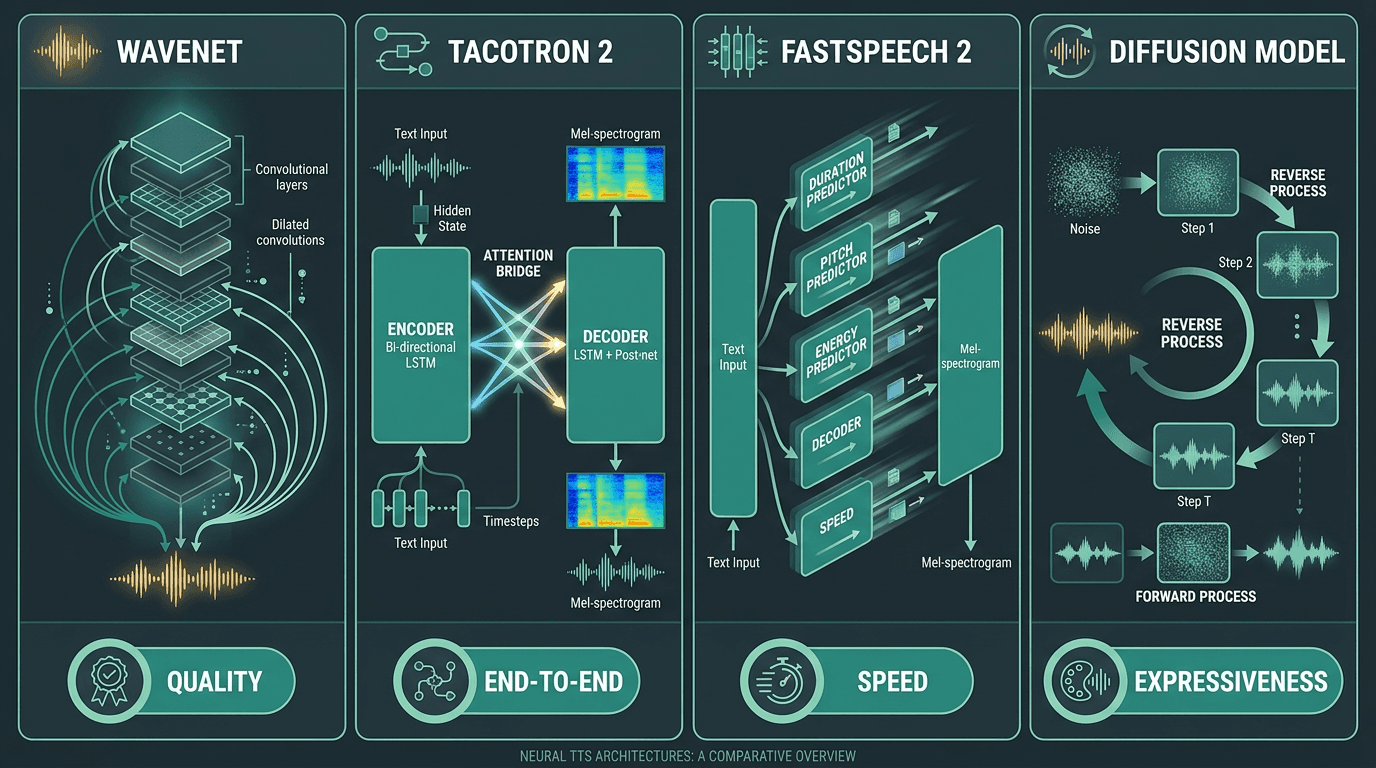
प्रमुख न्यूरल टीटीएस आर्किटेक्चर और वे समझौते (trade-offs) जिनके लिए प्रत्येक को अनुकूलित किया गया है।
न्यूरल टीटीएस का वास्तव में कहाँ उपयोग किया जा रहा है
एक्सेसिबिलिटी (सुलभता) सबसे पुराने उपयोग के मामलों में से एक है: स्क्रीन रीडर और दृष्टिबाधित लोगों के लिए उपकरण दशकों से टीटीएस पर निर्भर रहे हैं, लेकिन न्यूरल आवाजों ने इन उपकरणों को केवल कामचलाऊ बनाने के बजाय वास्तव में सुखद बना दिया है। ऑडियोबुक उत्पादन प्रयोगात्मक से मुख्यधारा में आ गया है, जिससे प्रकाशक पारंपरिक स्टूडियो लागतों के एक अंश में वर्णन (narration) तैयार कर रहे हैं। ई-लर्निंग प्लेटफॉर्म अब पाठ्यक्रम सामग्री का गतिशील रूप से वर्णन करते हैं। नेविगेशन और इन-कार प्रणालियों को कम-विलंबता वाले वॉयस आउटपुट की आवश्यकता होती है। ब्रांड वॉयस प्रोग्राम कंपनियों को अपनी पहचान में एक विशिष्ट सिंथेटिक आवाज शामिल करने की अनुमति देते हैं।
इस समय सबसे अधिक वृद्धि वाला अनुप्रयोग संवादात्मक एआई (conversational AI) है। ग्राहक सेवा, बिक्री और सहायता के लिए एआई वॉयस एजेंट रीयल-टाइम संवाद में विश्वसनीय लगने के लिए पूरी तरह से न्यूरल टीटीएस पर निर्भर करते हैं। एक वॉयस एजेंट जिसकी आवाज रोबोटिक लगती है, वह तुरंत उपयोगकर्ता का विश्वास खो देता है, भले ही अंतर्निहित भाषा मॉडल कितना भी सक्षम क्यों न हो। टीटीएस परत केवल एक विवरण नहीं है; यह उपयोगकर्ता का प्राथमिक इंटरफ़ेस है।
प्रमुख क्लाउड प्रदाताओं ने व्यापक स्पीच एपीआई पेशकशों के हिस्से के रूप में न्यूरल टीटीएस को सीधे अपने प्लेटफॉर्म में शामिल किया है, जो यह दर्शाता है कि यह तकनीक अनुसंधान से निकलकर बुनियादी ढांचे (infrastructure) में कितनी गहराई से शामिल हो चुकी है।
वॉयस क्लोनिंग और कस्टम वॉयस: उन्नत सीमा
मानक न्यूरल टीटीएस आपको पहले से बनी आवाजों की एक लाइब्रेरी देता है। वॉयस क्लोनिंग इसे और आगे ले जाती है। किसी लक्षित वक्ता का एक छोटा ऑडियो नमूना मिलने पर, एक क्लोनिंग सिस्टम उस नमूने पर एक स्पीकर एनकोडर को प्रशिक्षित या फाइन-ट्यून करके उस व्यक्ति की आवाज में नया भाषण उत्पन्न करता है, और फिर उस स्पीकर के एम्बेडिंग पर एकॉस्टिक मॉडल को अनुकूलित करता है।
ज़ीरो-शॉट वॉयस क्लोनिंग, जहां एक मॉडल बिना फाइन-ट्यूनिंग के केवल कुछ सेकंड के ऑडियो से आवाज क्लोन करता है, अब एक शोध डेमो के बजाय एक व्यावहारिक क्षमता है। एक प्लेटफॉर्म उपयोगकर्ताओं को एक ऐसी आवाज की पेशकश कर सकता है जो उनकी खुद की जैसी लगती हो। एक ब्रांड हजारों घंटों के ऑडियो रिकॉर्ड किए बिना हर ग्राहक संपर्क बिंदु पर एक सुसंगत आवाज तैनात कर सकता है। इसके वैयक्तिकरण (personalization) के प्रभाव महत्वपूर्ण हैं।
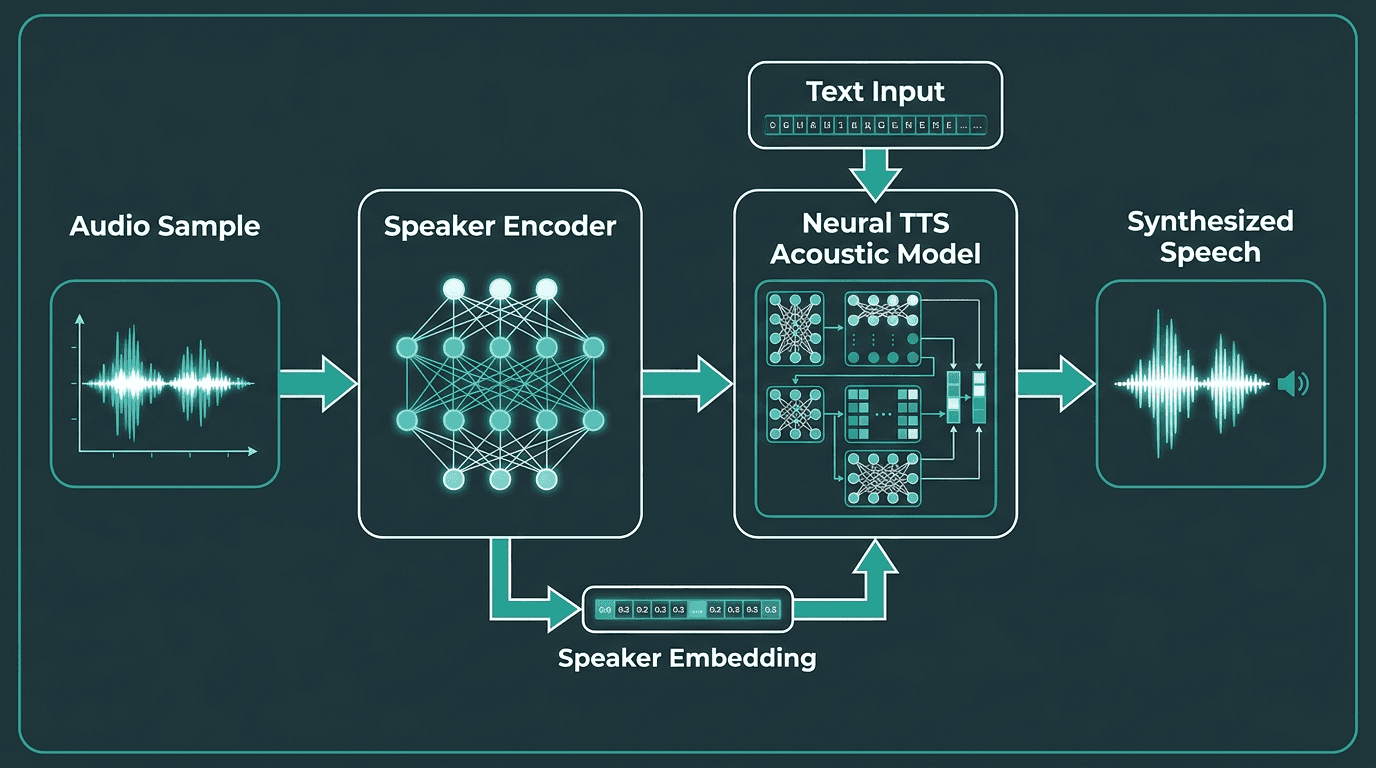
वॉयस क्लोनिंग कैसे काम करती है: एक स्पीकर एनकोडर आवाज की विशेषताओं को निकालता है जो टीटीएस मॉडल को अनुकूलित करती हैं।
न्यूरल टीटीएस का मूल्यांकन: मेट्रिक्स का वास्तव में क्या अर्थ है
मीन ओपिनियन स्कोर (MOS) सबसे अधिक उद्धृत मूल्यांकन मीट्रिक है: मानव श्रोता भाषण की स्वाभाविकता को 1-5 के पैमाने पर रेट करते हैं, और 4.0 से ऊपर के स्कोर को आम तौर पर उच्च स्वाभाविकता का प्रतिनिधित्व करने वाला माना जाता है, जो अक्सर नियंत्रित परिस्थितियों में मानव भाषण की गुणवत्ता के करीब पहुंच जाता है। समस्या यह है कि एमओएस को चलाना महंगा है, इसे दोहराना कठिन है, और यह विश्वसनीय रूप से यह अनुमान नहीं लगाता है कि कोई आवाज फोन ऑडियो या शोर वाले वातावरण जैसे विशिष्ट संदर्भों में कैसा प्रदर्शन करती है।
डाउनस्ट्रीम एएसआर सिस्टम का वर्ड एरर रेट (WER) सुस्पष्टता के लिए एक उपयोगी प्रतिनिधि है। यदि कोई स्पीच रिकॉग्नाइज़र सिंथेटिक ऑडियो को ट्रांसक्राइब करने में संघर्ष करता है, तो वास्तविक उपयोगकर्ता भी शायद ऐसा ही करेंगे। स्वचालित भाषण पहचान (ASR) को समझना यहाँ उपयोगी संदर्भ है, क्योंकि वॉयस पाइपलाइन डिज़ाइन में अक्सर टीटीएस और एएसआर का एक साथ मूल्यांकन किया जाता है। विलंबता-संवेदनशील अनुप्रयोगों के लिए, समय-से-पहला-ऑडियो और रीयल-टाइम फ़ैक्टर (ऑडियो अवधि के लिए जेनरेशन समय का अनुपात) वे मेट्रिक्स हैं जो वास्तव में यह निर्धारित करते हैं कि सिस्टम को शिप किया जाए या नहीं।
एक मीट्रिक जो बेंचमार्क में शायद ही कभी दिखाई देती है लेकिन व्यवहार में अत्यधिक मायने रखती है: कठिन परिस्थितियों (edge cases) में निरंतरता। संज्ञा शब्द, तकनीकी शब्दजाल, मिश्रित-भाषा इनपुट, असामान्य विराम चिह्न। एक मॉडल जो साफ अंग्रेजी वाक्यों पर 4.2 एमओएस स्कोर करता है, लेकिन आपके आधे उत्पाद नामों का गलत उच्चारण करता है, वह आपके उपयोग के मामले के लिए उत्पादन-तैयार नहीं है, चाहे बेंचमार्क कुछ भी कहे।
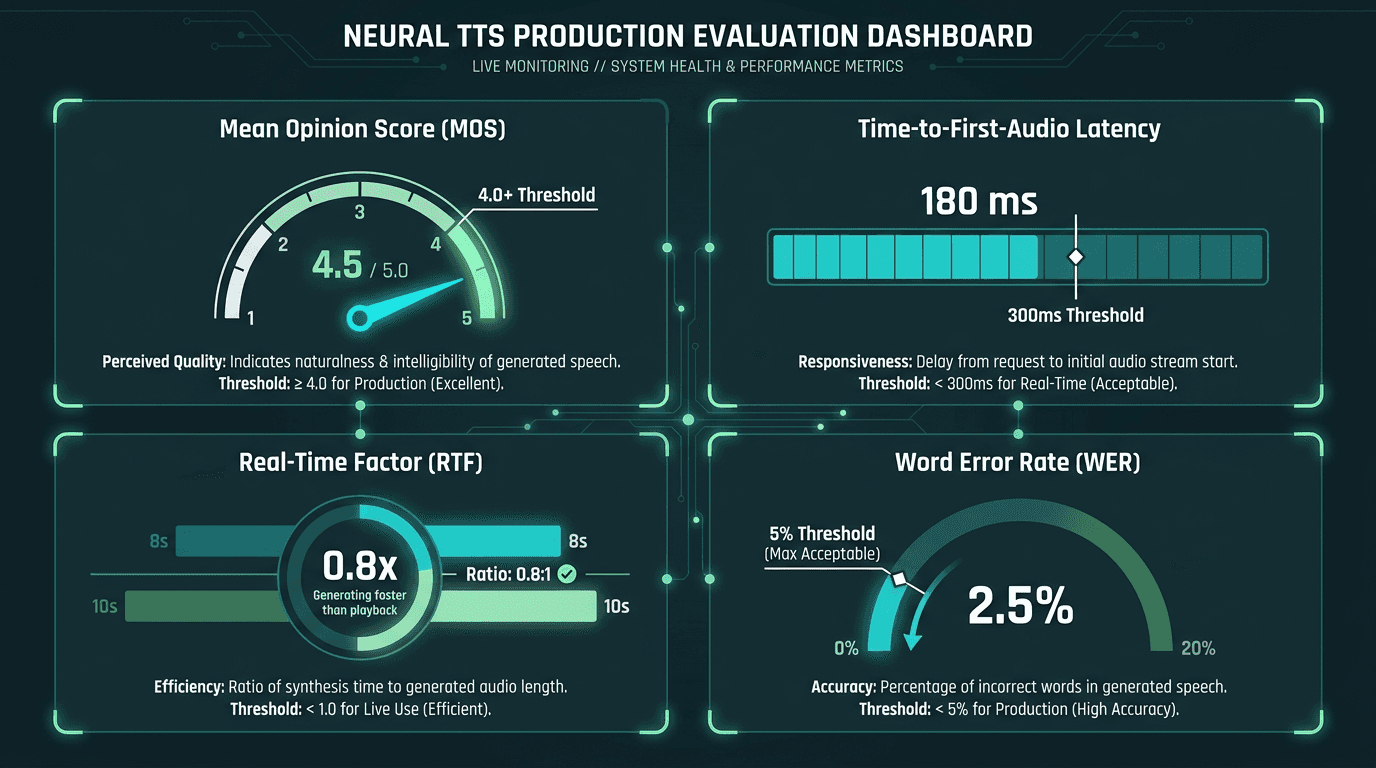
उत्पादन में न्यूरल टीटीएस प्रणालियों के मूल्यांकन के लिए प्रमुख मेट्रिक्स: गुणवत्ता, गति और सुस्पष्टता।
न्यूरल टीटीएस जिस समस्या का समाधान करता है, और आगे क्या होने वाला है
मूलभूत समस्या जिसे न्यूरल टीटीएस हल करता है, वह है सिंथेटिक भाषण की अस्वाभाविकता (uncanny valley)। दशकों तक, वॉयस इंटरफेस को भरोसे के बजाय केवल सहन किया जाता था क्योंकि आवाजें कुछ ऐसे तरीकों से अजीब लगती थीं जिन्हें व्यक्त करना कठिन था लेकिन अनदेखा करना असंभव था। न्यूरल टीटीएस ने नियमों के माध्यम से अनुमान लगाने के बजाय मानव भाषण से सीखकर उस अंतर को पाट दिया, जिससे ऐसा वॉयस आउटपुट उत्पन्न हुआ जिसके साथ लोग जुड़ते हैं, न कि केवल सहन करते हैं।
इसके बाद भाषा मॉडल और वॉयस लेयर के बीच अधिक घनिष्ठ एकीकरण होने वाला है। आज, अधिकांश वॉयस एआई सिस्टम पहले टेक्स्ट जेनरेट करते हैं और फिर उसे संश्लेषित करते हैं, जिससे विलंबता आती है और वह सुर-लय संबंधी जानकारी खो जाती है जो भाषा मॉडल के पास थी लेकिन उसने कभी साझा नहीं की। प्रणालियों की अगली पीढ़ी संश्लेषण चरण में भावना और इरादे का अनुमान लगाने के बजाय शुरुआत से ही उन्हें कोडित करेगी। आवाज पहचान (Voice recognition) और टीटीएस भी फुल-डुप्लेक्स प्रणालियों में परिवर्तित हो रहे हैं जहां एक ही मॉडल समझने और बोलने दोनों को संभालता है।
आज वॉयस उत्पाद बनाने वाले डेवलपर्स के लिए, व्यावहारिक प्रश्न यह नहीं है कि न्यूरल टीटीएस का उपयोग किया जाए या नहीं, बल्कि यह है कि कौन सा सिस्टम आपकी विलंबता, गुणवत्ता और अनुकूलन आवश्यकताओं के अनुकूल है। उच्च अभिव्यक्ति के साथ 200ms से कम की विलंबता की आवश्यकता वाले रीयल-टाइम संवादात्मक अनुप्रयोगों के लिए, Smallest.ai का Lightning TTS API विशेष रूप से उसी सीमा के लिए बनाया गया है। इसे वॉयस एजेंट पाइपलाइनों में स्ट्रीमिंग संश्लेषण के लिए अनुकूलित किया गया है और यह Smallest.ai के व्यापक वॉयस स्टैक के साथ जुड़ता है, जिसमें स्पीच-टू-टेक्स्ट के लिए पल्स (Pulse) और संवादात्मक एआई के लिए इलेक्ट्रॉन (Electron) शामिल हैं, जो आपको डिस्कनेक्टेड एपीआई के संग्रह के बजाय एक पूर्ण बुनियादी ढांचा प्रदान करता है।
मुख्य निष्कर्ष: न्यूरल टीटीएस जिस समस्या का समाधान करता है, और आगे क्या होने वाला है
न्यूरल टीटीएस ने सिंथेटिक भाषण की दशकों पुरानी सबसे बड़ी समस्या को हल कर दिया: इसने मशीन-जनित आवाजों को इतना स्वाभाविक बना दिया कि लोग वास्तव में उन पर भरोसा कर सकें और उनके साथ जुड़ सकें। टुकड़ों को आपस में जोड़ने या कड़े उच्चारण नियमों का पालन करने के बजाय, आधुनिक न्यूरल टीटीएस सिस्टम वास्तविक मानव भाषण से लय, टोन, ठहराव और जोर सीखते हैं।
आज वॉयस उत्पाद बनाने वाले डेवलपर्स के लिए चुनौती अब केवल यथार्थवादी आवाज उत्पन्न करना नहीं है। यह वास्तविक समय की बातचीत के लिए पर्याप्त तेजी से आवाज उत्पन्न करना है, जो प्राकृतिक संवाद के लिए पर्याप्त अभिव्यंजक हो, और उत्पादन उपयोग के लिए विश्वसनीय हो। यह विशेष रूप से एआई वॉयस एजेंटों, संपर्क केंद्रों, बिक्री कॉल, सहायता वर्कफ़्लो और किसी भी उत्पाद के लिए महत्वपूर्ण है जहां आवाज ही मुख्य उपयोगकर्ता इंटरफ़ेस है।
यहीं पर Smallest.ai का Lightning TTS API फिट बैठता है। लाइटनिंग को कम-विलंबता, स्ट्रीमिंग टेक्स्ट-टू-स्पीच के लिए बनाया गया है, जो टीमों को ऐसे वॉयस एजेंट बनाने में मदद करता है जो लाइव बातचीत में तेजी से प्रतिक्रिया देते हैं और स्वाभाविक लगते हैं। यह Smallest.ai के व्यापक वॉयस स्टैक के साथ भी काम करता है, जिसमें भाषण-से-पाठ (speech-to-text) के लिए पल्स (Pulse) शामिल है, जो डेवलपर्स को वास्तविक समय के वॉयस एआई के निर्माण के लिए एक अधिक संपूर्ण बुनियादी ढांचा प्रदान करता है।
यदि आप एक ऐसा वॉयस उत्पाद बना रहे हैं जहाँ विलंबता, अभिव्यक्ति और विश्वसनीयता मायने रखती है, तो Smallest.ai आज़माएं और अपने स्वयं के वर्कफ़्लो में लाइटनिंग टीटीएस का परीक्षण शुरू करें।
अक्सर पूछे जाने वाले प्रश्न
न्यूरल टीटीएस (TTS) और स्टैंडर्ड टीटीएस (TTS) में क्या अंतर है?
वास्तविक समय (रियल-टाइम) में उपयोग के लिए एक न्यूरल टीटीएस (TTS) सिस्टम को कितना तेज़ होना चाहिए?
क्या न्यूरल टीटीएस (TTS) कई भाषाओं का समर्थन कर सकता है?
वॉइस क्लोनिंग क्या है और यह मानक न्यूरल टीटीएस (TTS) से कैसे भिन्न है?
मैं अपने एप्लिकेशन के लिए सही न्यूरल टीटीएस (TTS) एपीआई (API) कैसे चुनूं?