स्वचालित वाक् पहचान (ASR) के लिए एक व्यावहारिक मार्गदर्शिका: यह कैसे काम करता है, आधुनिक ASR बेहतर प्रदर्शन क्यों करता है, और बेंचमार्क सटीकता से परे किन चीजों का मूल्यांकन किया जाना चाहिए।
एक कस्टमर आपके सपोर्ट लाइन पर कॉल करता है। एक सेकंड के कुछ ही हिस्से में, उनकी आवाज़ को टेक्स्ट में बदल दिया जाता है, वक्ता (स्पीकर) के आधार पर अलग किया जाता है, एक राउटिंग सिस्टम में भेजा जाता है, और बातचीत में अगले कदम को ट्रिगर करने के लिए उपयोग किया जाता है। कोई भी इंसान टाइप नहीं कर रहा है। कोई भी मैन्युअल रूप से कॉल को टैग नहीं कर रहा है। वह पहली परत ऑटोमैटिक स्पीच रिकॉग्निशन (ASR) है।
ऑटोमैटिक स्पीच रिकॉग्निशन, या ASR, वह तकनीक है जो बोली जाने वाली भाषा को टेक्स्ट में बदलती है। यह लाइव कैप्शन, मीटिंग ट्रांसक्रिप्ट, वॉयस एजेंट, कॉल एनालिटिक्स, डिक्टेशन टूल और सर्च करने योग्य ऑडियो आर्काइव्स को संचालित करती है। लोग इसके बारे में सोचे बिना हर दिन इसका उपयोग करते हैं, जब तक कि उन्हें इसके साथ कुछ बनाना न पड़े। फिर यह असलियत बन जाती है, बहुत जल्दी।
हालांकि “स्पीच-टू-टेक्स्ट” सीधा दिखाई देता है, लेकिन व्यावहारिक रूप से इसे लागू करना जटिल है।
डेमो ऑडियो भ्रामक हो सकता है। प्रोडक्शन में, ऑडियो में आम तौर पर रुकावटें, नैरोबैंड कोडेक्स, बैकग्राउंड का शोर, विविध लहजे (एक्सेन्ट) और अपरिचित शब्द शामिल होते हैं। एक ट्रांसक्रिप्ट जो डेमो में अच्छा प्रदर्शन करती है, हो सकता है कि वह कॉन्टैक्ट सेंटर्स, बहुभाषी बातचीत, या वॉयस एजेंट्स जैसे वास्तविक दुनिया के परिदृश्यों में सफल न हो।
कई संसाधन केवल परिभाषाओं और बुनियादी मैट्रिक्स पर ध्यान केंद्रित करते हैं, इन चुनौतियों को नजरअंदाज कर देते हैं। यदि आप एक डेवलपर, प्रोडक्ट मैनेजर, फाउंडर या खरीदार के रूप में ASR का मूल्यांकन कर रहे हैं, तो गहरी समझ होना आवश्यक है:
ASR वास्तव में पर्दे के पीछे क्या करता है
आधुनिक सिस्टम पुराने सिस्टम की तुलना में बेहतर काम क्यों करते हैं
कौन से मैट्रिक्स मायने रखते हैं और कौन से अपने आप में भ्रामक हैं
आपका उपयोग मामला (यूज़ केस) कैसे बदलता है कि एक "अच्छा" सिस्टम कैसा दिखता है
इस गाइड का उद्देश्य उस स्पष्टता को प्रदान करना है।
ASR क्या है?
ASR वह अंतर्निहित तकनीक है जो आवाज़ को टेक्स्ट में बदलती है।
जब लोग स्पीच-टू-टेक्स्ट कहते हैं, तो वे आम तौर पर प्रोडक्ट की क्षमता के बारे में बात कर रहे होते हैं। जब वे ASR कहते हैं, तो वे इसके पीछे की तकनीक का उल्लेख कर रहे होते हैं। अधिकांश व्यावहारिक बातचीत में, इन शब्दों का उपयोग एक-दूसरे के स्थान पर किया जाता है, लेकिन इनमें एक उपयोगी अंतर है:
ASR = रिकॉग्निशन इंजन
स्पीच-टू-टेक्स्ट = उस इंजन द्वारा संचालित फीचर या प्रोडक्ट अनुभव
वॉयस रिकॉग्निशन = यह पहचानना कि कौन बोल रहा है
NLP = ASR द्वारा टेक्स्ट तैयार करने के बाद यह समझना कि उस टेक्स्ट का क्या अर्थ है
यह अंतर इसलिए मायने रखता है क्योंकि टीमें अक्सर गलत परत पर ध्यान केंद्रित करती हैं। केवल स्पीच-टू-टेक्स्ट का अनुरोध करने के बजाय, यह आकलन करना महत्वपूर्ण है कि क्या ASR परत गति, सटीकता और मजबूती के लिए आवश्यकताओं को पूरा करती है। अंतर्निहित तंत्र के बारे में अधिक जानकारी के लिए, हमारी गाइड देखें कि वॉयस रिकॉग्निशन कैसे काम करता है।
ASR अब कुछ साल पहले की तुलना में अधिक क्यों मायने रखता है?
ASR दशकों से अस्तित्व में है। जबकि इसका मौलिक लक्ष्य वही बना हुआ है, जो बदला है वह है इसकी गुणवत्ता और विविध वातावरणों के अनुकूल होने की क्षमता।
पुराने सिस्टम नियंत्रित सेटिंग्स में सबसे अच्छा काम करते थे: साफ आवाज़, सीमित शब्दावली, अनुमानित वाक्यांश। जबकि आधुनिक ASR संभाल सकता है:
सावधानीपूर्वक पढ़े गए भाषण के बजाय सहज बातचीत
लहजे (एक्सेन्ट्स) और कोड-स्विचिंग (भाषा बदलना)
एक साथ बोलने वाले कई वक्ता
शोर-शराबे वाला वातावरण
टेलीफोनी ऑडियो
रीयल-टाइम स्ट्रीमिंग
इस विकास ने ASR को एक छोटे फीचर से बदलकर कोर इंफ्रास्ट्रक्चर बना दिया है। यह ऑटोमेशन, एआई वॉयस एजेंट्स, अनुपालन समीक्षा, सुलभता, खोज, सारांश और एनालिटिक्स का समर्थन करता है।
उन प्रोडक्ट्स के लिए जो बड़े पैमाने पर बोली जाने वाली भाषा को प्रोसेस करते हैं, ASR आवश्यक है और एक रणनीतिक सिस्टम विकल्प है।
ऑटोमैटिक स्पीच रिकॉग्निशन कैसे काम करता है?
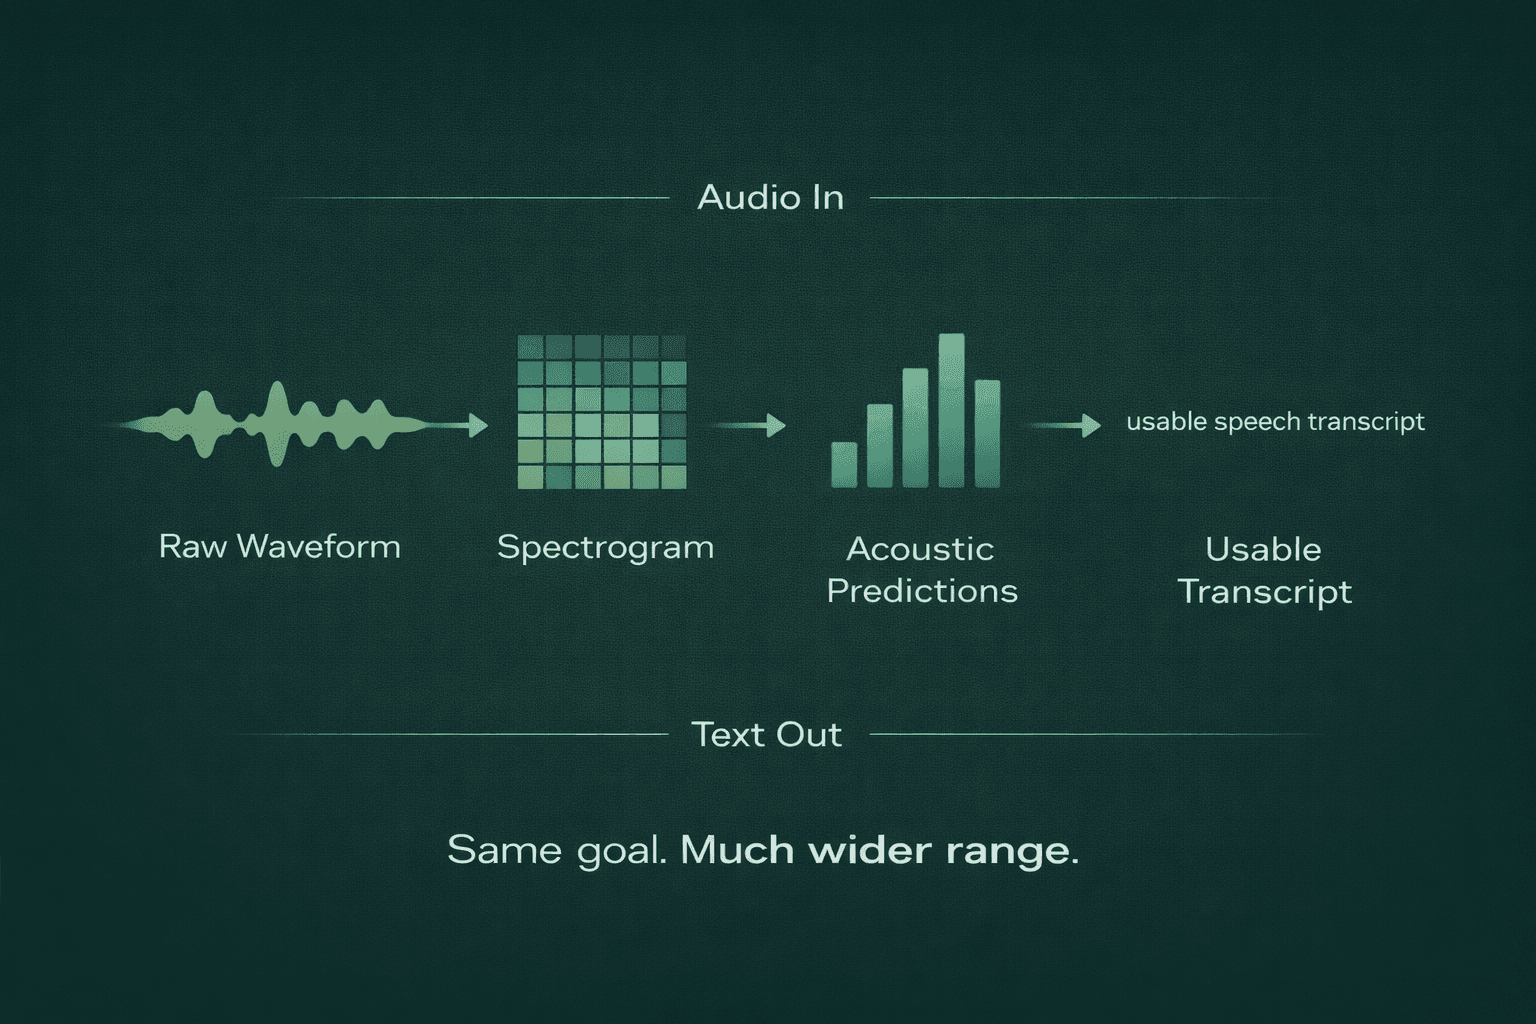
व्यापक स्तर पर, ASR बोले गए शब्दों के क्रम का अनुमान लगाने के लिए एक ऑडियो सिग्नल को प्रोसेस करता है। इस प्रक्रिया में प्रत्येक चरण जटिल है।
1. सिस्टम रॉ वेवफॉर्म से शुरू होता है
ऑडियो एक वेवफॉर्म के रूप में आता है: समय के साथ बदलता हुआ सिग्नल। मशीनें सीधे रॉ वेवफॉर्म को प्रोसेस कर सकती हैं, लेकिन कई ASR सिस्टम पहले उन्हें एक ऐसे रूप में बदलते हैं जिससे स्पीच पैटर्न का पता लगाना आसान हो जाता है।
एक सामान्य रूप स्पेक्ट्रोग्राम है, जो अक्सर मेल स्पेक्ट्रोग्राम (mel spectrogram) होता है।
इसे एक नक्शे के रूप में सोचें कि समय के साथ आवृत्तियों (फ्रीक्वेंसी) में ऊर्जा कैसे वितरित होती है। केवल आयाम (एम्प्लीट्यूड) देखने के बजाय, मॉडल को यह देखने को मिलता है कि भाषण की आवाज़ कैसे विकसित होती है। स्वर, व्यंजन, रुकना और सांस की आवाज़ें सभी अलग-अलग निशान छोड़ती हैं।
यह अंतर महत्वपूर्ण है क्योंकि भाषण समय के साथ बदलने वाली एक ध्वनिक (अकॉस्टिक) घटना है, न कि केवल अक्षरों का एक क्रम। शब्दों को सटीक रूप से पुनः प्राप्त करने के लिए मॉडल को ध्वनि में पैटर्न की पहचान करनी चाहिए।
2. मॉडल छोटी स्पीच यूनिट्स का अनुमान लगाता है
एक बार जब ऑडियो को एक उपयोगी रूप में प्रस्तुत कर दिया जाता है, तो मॉडल समय के साथ संभावित भाषाई इकाइयों का अनुमान लगाना शुरू कर देता है।
सिस्टम के आधार पर, वे इकाइयाँ हो सकती हैं:
स्वनिम (Phonemes): बुनियादी ध्वनि इकाइयाँ जैसे /p/, /b/, /aa/
अक्षर (Characters): व्यक्तिगत अक्षर या प्रतीक
उप-शब्द (Subwords): पूरे शब्दों से छोटे लेकिन अक्षरों से बड़े हिस्से
वर्ड पीस या टोकन: आधुनिक न्यूरल सिस्टम में उपयोग किए जाने वाले सामान्य हिस्से
स्वनिम अक्षरों से भिन्न होते हैं; वे ध्वनियों का प्रतिनिधित्व करते हैं। उदाहरण के लिए, अंग्रेज़ी के शब्द "cat" और "kite" पहले अक्षर के बाद अलग-अलग अक्षरों से शुरू होते हैं, लेकिन दोनों एक ही /k/ ध्वनि से शुरू होते हैं, जिसे मॉडल पहचानना सीखता है।
इस चरण को अक्सर अकॉस्टिक मॉडलिंग कहा जाता है, क्योंकि सिस्टम ध्वनिक पैटर्न को संभावित स्पीच यूनिट्स से मैप कर रहा होता है।
3. डिकोडिंग कच्चे अनुमानों को वास्तविक टेक्स्ट में बदलती है
कई सरलीकृत व्याख्याएँ इस चरण को विस्तार से नहीं समझाती हैं।
मॉडल एक वाक्य नहीं सुनता है और तुरंत अंतिम ट्रांसक्रिप्ट को "जान" नहीं जाता है। यह समय के साथ संभावनाएं उत्पन्न करता है। डिकोडिंग उन संभावनाओं को सबसे संभावित टेक्स्ट क्रम में बदल देती है।
डिकोडिंग आवश्यक है क्योंकि कच्चे ऑडियो साक्ष्य अक्सर अस्पष्ट और जटिल होते हैं।
एक छोटी सी आवाज़ कई शब्दों से मैप हो सकती है। बैकग्राउंड का शोर किसी शब्दांश को विकृत कर सकता है। तेज़ भाषण शब्दों के बीच की सीमाओं को धुंधला कर सकता है। डिकोडर उस क्रम को चुनता है जो ध्वनि और भाषा के पैटर्न दोनों में सबसे अच्छी तरह फिट बैठता है जो सिस्टम ने सीखे हैं।
यहीं पर लैंग्वेज मॉडलिंग भी मायने रखती है।
जब वाक्यांशों के बीच ध्वनिक साक्ष्य अस्पष्ट होते हैं, तो सिस्टम सबसे प्रशंसनीय विकल्प निर्धारित करने के लिए संदर्भ (कॉन्टेक्स्ट) पर निर्भर करता है। उदाहरण के लिए, अंग्रेज़ी के "recognize speech" और "wreck a nice beach" सुनने में समान लग सकते हैं, लेकिन संदर्भ सिस्टम को सही वाक्यांश चुनने में मदद करता है।
4. वास्तविक उपयोग के लिए ट्रांसक्रिप्ट को रिफाइन किया जाता है
एक कच्चा ट्रांसक्रिप्ट हमेशा अपने आप में उपयोगी नहीं होता है। कई प्रोडक्शन सिस्टम आउटपुट को उपयोगी बनाने के लिए परतें जोड़ते हैं:
विराम चिह्न (Punctuation)
कैपिटलाइजेशन (Capitalization)
टाइमस्टैम्प (Timestamps)
वक्ता के लेबल (Speaker labels)
खंड सीमाएँ (Segment boundaries)
आत्मविश्वास संकेत (Confidence signals)
भाषा की पहचान (Language identification)
इन संवर्द्धनों को अक्सर वैकल्पिक माना जाता है, लेकिन व्यावहारिक उपयोग के लिए ये आवश्यक हैं।
टाइमस्टैम्प के बिना एक ट्रांसक्रिप्ट का ऑडिट करना कठिन होता है। स्पीकर लेबल के बिना कॉल ट्रांसक्रिप्ट क्यूए (QA) और कोचिंग के लिए कमजोर होती है। बिना सेगमेंटेशन के ट्रांसक्रिप्ट का उपयोग सारांश या खोज के लिए करना कठिन होता है।
रिकॉग्निशन की सटीकता और ट्रांसक्रिप्ट की उपयोगिता दोनों ही महत्वपूर्ण हैं।
पुराना ASR स्टैक बनाम आधुनिक ASR स्टैक
कई लेख इस विषय का उल्लेख करते हैं लेकिन इसे विस्तार से नहीं समझाते हैं।
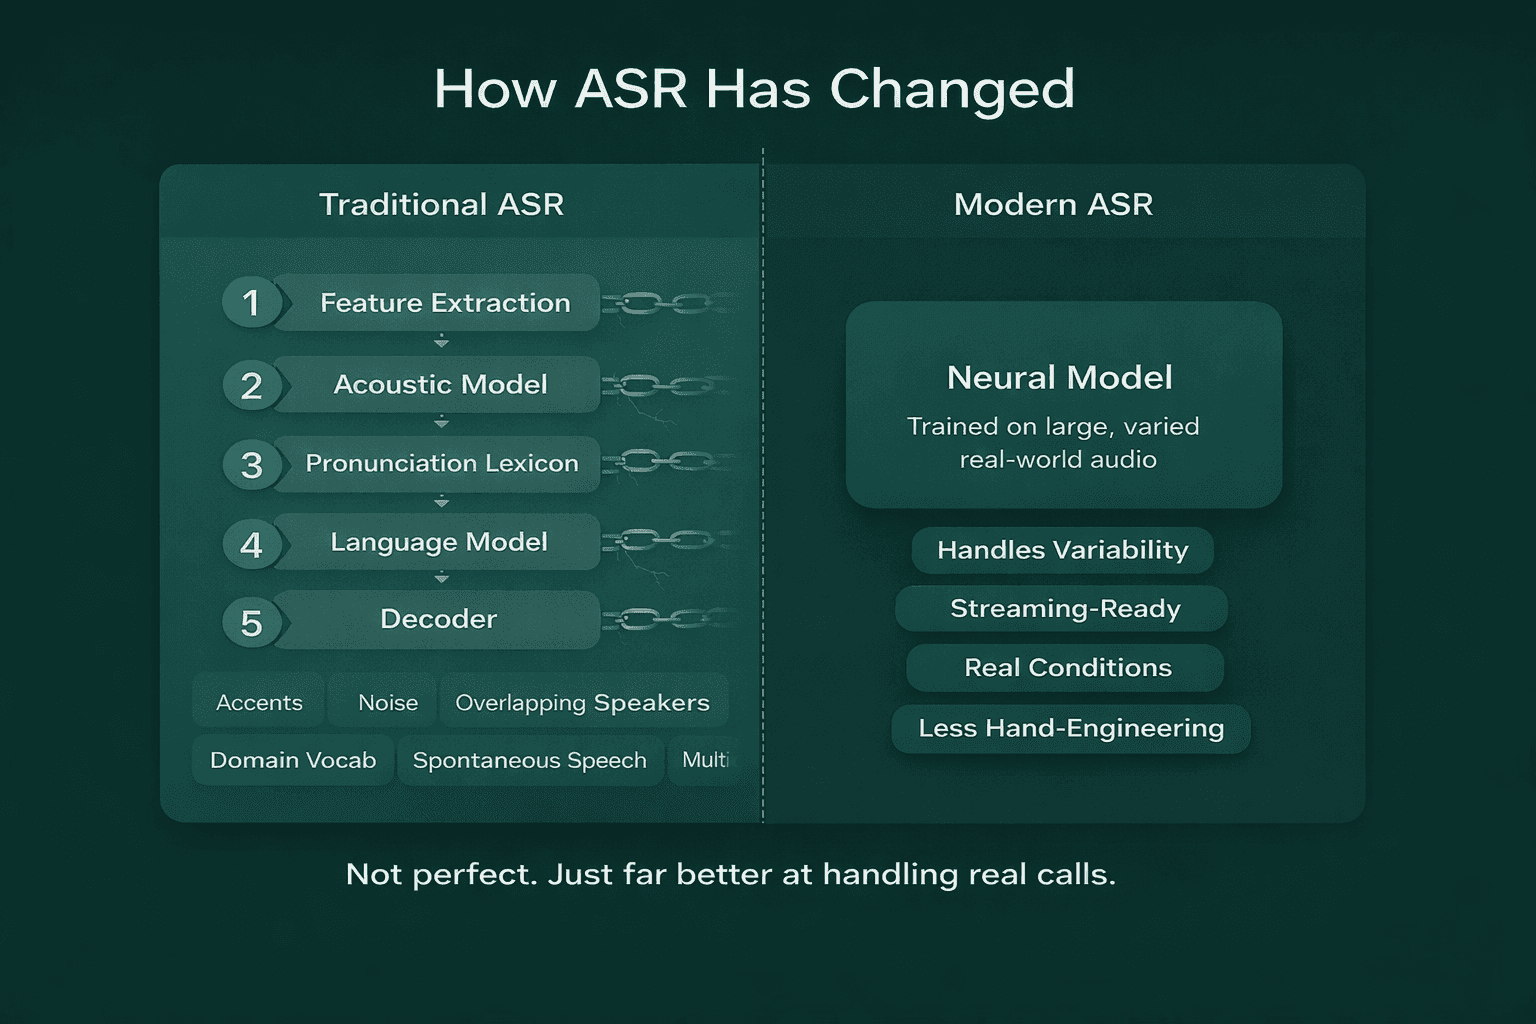
पारंपरिक ASR: विशेष घटकों की एक पाइपलाइन
पुराने ASR सिस्टम आमतौर पर हाइब्रिड सिस्टम होते थे। उन्होंने कई अलग-अलग हिस्सों को एक साथ जोड़ा था:
एक फीचर एक्सट्रैक्शन चरण
एक अकॉस्टिक मॉडल
एक उच्चारण लेक्सिकॉन
एक लैंग्वेज मॉडल
एक डिकोडर
एक सामान्य कॉम्बिनेशन HMM-GMM था:
हिडन मार्कोव मॉडल्स (HMMs) ने समय के साथ स्पीच स्टेट्स के क्रम को मॉडल किया
गॉसियन मिक्सचर मॉडल्स (GMMs) ने मॉडल किया कि उन स्टेट्स के लिए ध्वनिक विशेषताएं कैसे वितरित की गईं
हालाँकि गणित को समझना आवश्यक नहीं है, लेकिन यह ध्यान रखना महत्वपूर्ण है कि ये सिस्टम मॉड्यूलर और ट्यून करने योग्य थे, लेकिन नाजुक भी थे। वे उच्चारण, समय और भाषा की संरचना के बारे में हस्तनिर्मित घटकों और मान्यताओं पर निर्भर थे।
इस दृष्टिकोण ने सिस्टम को उपयोगी और व्याख्या योग्य बना दिया, लेकिन साथ ही कमजोर भी बना दिया।
जब बातचीत अव्यवस्थित हो जाती थी, तो उन्हें अधिक संघर्ष करना पड़ता था:
मजबूत लहजे (एक्सेन्ट्स)
सहज बातचीत
शोर-शराबे वाला ऑडियो
एक साथ बोलने वाले वक्ता
डोमेन-विशिष्ट शब्दावली
बहुभाषी स्विचिंग
आधुनिक ASR: बड़े रीयल-वर्ल्ड डेटा पर प्रशिक्षित न्यूरल सिस्टम
आधुनिक ASR गहरे न्यूरल मॉडल और तेजी से एंड-टू-एंड या नियर-एंड-टू-एंड आर्किटेक्चर की ओर बढ़ गया है।
कई अलग-अलग घटकों को मैन्युअली अनुकूलित करने के बजाय, नए सिस्टम सीधे डेटा से ऑडियो से टेक्स्ट मैपिंग का अधिक हिस्सा सीखते हैं। आर्किटेक्चर के आधार पर, वे उपयोग कर सकते हैं:
CTC-आधारित मॉडल
अटेंशन-आधारित एनकोडर-डिकोडर सिस्टम
RNN-T स्टाइल स्ट्रीमिंग मॉडल
ट्रांसफार्मर-आधारित आर्किटेक्चर
अलग डिकोडिंग परतों के साथ हाइब्रिड न्यूरल सिस्टम
मुख्य बात संक्षिप्त रूपों को रटने के बजाय ASR सिस्टम में व्यावहारिक परिवर्तनों को समझना है।
आधुनिक ASR बेहतर हो गया क्योंकि:
<111">
मॉडल्स ने बहुत बड़े और अधिक विविध ऑडियो कॉर्पोरा से सीखा
न्यूरल रिप्रेजेंटेशन ने पुरानी हस्तनिर्मित मान्यताओं की तुलना में परिवर्तनशीलता को बेहतर ढंग से संभाला
सिस्टम को वास्तविक दुनिया की स्थितियों के करीब प्रशिक्षित किया गया था
स्ट्रीमिंग और कम-विलंबता (लो-लेटेंसी) निष्कर्ष के लिए आर्किटेक्चर में सुधार हुआ
नतीजतन, आधुनिक सिस्टम पिछली पीढ़ियों की तुलना में वास्तविक कस्टमर कॉल्स, वॉयस एजेंट्स, लाइव मीटिंग्स और बहुभाषी भाषण को अधिक प्रभावी ढंग से संभालते हैं।
हालांकि सही नहीं हैं, वे एक महत्वपूर्ण सुधार का प्रतिनिधित्व करते हैं।
एक सरल तुलना
पारंपरिक हाइब्रिड ASR | अलग अकॉस्टिक, लेक्सिकॉन, लैंग्वेज और डिकोडिंग घटक | व्याख्या करने योग्य, कॉन्फ़िगर करने योग्य, भागों में तर्क करना आसान | अधिक मैन्युअल ट्यूनिंग, अव्यवस्थित वास्तविक दुनिया के ऑडियो के प्रति कम मजबूत |
आधुनिक न्यूरल ASR | न्यूरल मॉडल का उपयोग करके बड़े डेटासेट से ऑडियो-टू-टेक्स्ट मैपिंग सीखता है | बेहतर सामान्यीकरण, मजबूत वास्तविक दुनिया की सटीकता, बेहतर स्ट्रीमिंग विकल्प | डेटा-भूखा, परिनियोजन-संवेदनशील, डीबग करना अधिक कठिन हो सकता है |
"अच्छा ASR" का वास्तव में क्या अर्थ है
कई टीमें मान लेती हैं कि ASR गुणवत्ता सटीकता से निर्धारित होती है, लेकिन ऐसा नहीं है।
मुख्य सवाल यह नहीं है कि किस मॉडल में बेंचमार्क पर सबसे कम WER है, बल्कि यह है कि कौन सा सिस्टम आपके ऑडियो, लेटेंसी आवश्यकताओं और वर्कफ़्लो के लिए सबसे अच्छा प्रदर्शन करता है।
यह एक अधिक चुनौतीपूर्ण लेकिन अंततः अधिक मूल्यवान प्रश्न है।
सटीकता मायने रखती है, लेकिन संदर्भ के साथ
सबसे आम सटीकता मीट्रिक वर्ड एरर रेट, या WER है।
WER यह गिनता है कि अनुमानित ट्रांसक्रिप्ट को संदर्भ ट्रांसक्रिप्ट में बदलने के लिए कितने संपादनों की आवश्यकता है:
प्रतिस्थापन (Substitutions)
विलोपन (Deletions)
सम्मिलन (Insertions)
फिर यह उसे संदर्भ शब्दों की कुल संख्या से विभाजित करता है।
कम WER बेहतर है। लेकिन WER की सीमाएं हैं।
कॉल सारांश के लिए, मामूली विराम चिह्न अंतर स्वीकार्य हो सकते हैं। मेडिकल डिक्टेशन में, एक एकल गलत शब्द भी गंभीर हो सकता है। लाइव एजेंट टर्न-टेकिंग के लिए, थोड़ा कम सटीक लेकिन तेज़ स्ट्रीम धीमी, अधिक सटीक ट्रांसक्रिप्ट की तुलना में बेहतर उपयोगकर्ता अनुभव प्रदान कर सकती है।
WER एक उपयोगी लेकिन अपूर्ण मीट्रिक है।
कुछ भाषाओं और एज केसेस में CER मायने रखता है
कैरेक्टर एरर रेट, या CER, शब्द स्तर के बजाय अक्षर स्तर पर त्रुटि को मापता है।
यह तब मददगार हो जाता है जब:
शब्द सीमाएं कम विश्वसनीय होती हैं
आप वर्तनी (स्पेलिंग) की सटीकता की परवाह करते हैं
आप उन भाषाओं का मूल्यांकन कर रहे हैं जहां शब्द विभाजन अलग तरह से व्यवहार करता है
नाम, आईडी, या कोड बहुत मायने रखते हैं
WER कई मूल्यांकनों में मानक बना हुआ है, लेकिन CER उन मुद्दों की पहचान कर सकता है जिन्हें WER अनदेखा कर सकता है।
लेटेंसी कई टीमों की अपेक्षा से अधिक मायने रखती है
यदि आपकी ट्रांसक्रिप्ट उपयोगकर्ता के आगे बढ़ने के बाद दिखाई देती है, तो मॉडल "सटीक" हो सकता है और फिर भी उत्पाद विफल हो सकता है।
के लिए रीयल-टाइम ट्रांसक्रिप्शन, इस पर ध्यान दें:
पहले टोकन या पहले परिणाम का समय
स्ट्रीमिंग स्थिरता
P95 लेटेंसी, न कि केवल औसत लेटेंसी
संवादात्मक प्रणालियों में टर्न-टेकिंग गुणवत्ता
यह वॉयस एजेंटों और लाइव कैप्शनिंग के लिए महत्वपूर्ण है, जहां उपयोगकर्ता तुरंत देरी को नोटिस करते हैं। कुछ सौ मिलीसेकंड की देरी भी बातचीत को अस्वाभाविक या इंटरफेस को कम प्रभावी बना सकती है।
डायराइजेशन और मेटाडेटा मामूली सटीकता लाभों से अधिक मायने रख सकते हैं
कई व्यावसायिक वर्कफ़्लो में, ट्रांसक्रिप्ट अंतिम उत्पाद नहीं है। यह दूसरे सिस्टम का इनपुट है।
इसका मतलब है कि ये कच्चे रिकॉग्निशन जितने ही मायने रख सकते हैं:
स्पीकर डायराइजेशन (Speaker diarization)
टाइमस्टैम्प (Timestamps)
आत्मविश्वास संकेत (Confidence signals)
सेगमेंटेशन गुणवत्ता (Segmentation quality)
भाषा का पता लगाना (Language detection)
स्थिर स्ट्रीमिंग व्यवहार (Stable streaming behavior)
थोड़े अधिक WER वाला लेकिन विश्वसनीय स्पीकर लेबल वाला मॉडल कॉल सेंटर QA के लिए उस मॉडल की तुलना में अधिक उपयोगी हो सकता है जो साफ-टेक्स्ट बेंचमार्क पर संकीर्ण रूप से जीतता है।
इस कारण से, केवल हेडलाइन सटीकता पर ASR का मूल्यांकन करना अक्सर अपर्याप्त होता है।
वास्तविक दुनिया के उदाहरण जो यह बदलते हैं कि आप क्या अनुकूलित करते हैं
यह वह जगह है जहां सैद्धांतिक विचार अक्सर व्यावहारिक परिनियोजन (डेप्लॉयमेंट) से भिन्न होते हैं।
1. ओवरलैप और शोर के साथ कस्टमर सपोर्ट कॉल्स
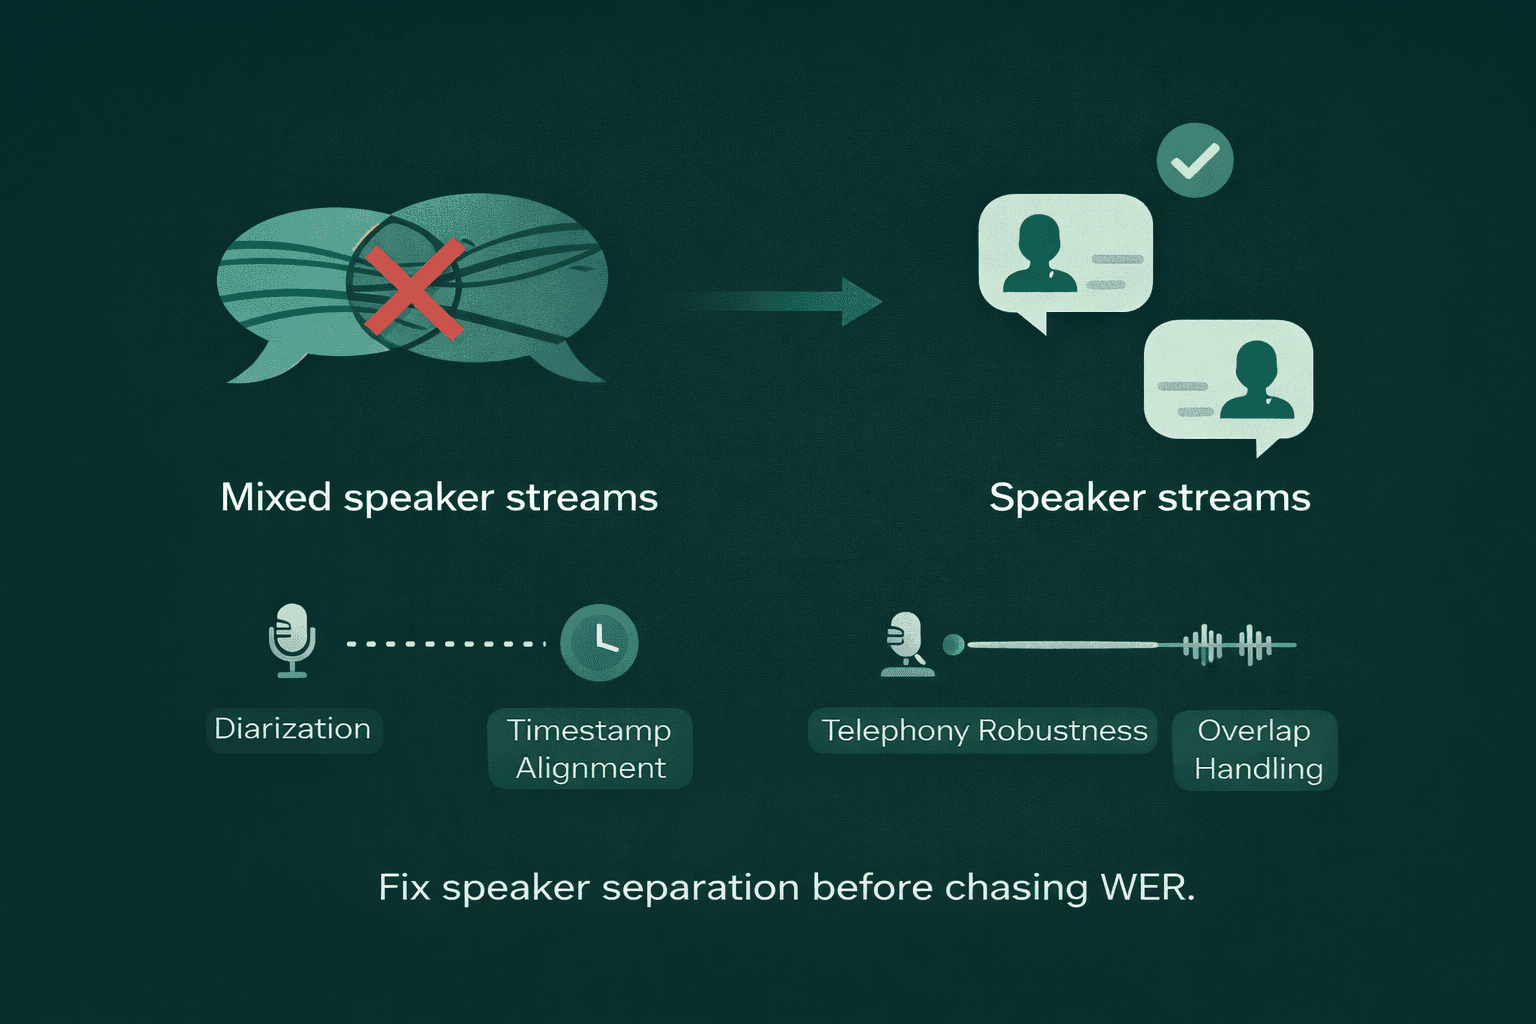
सपोर्ट कॉल्स में, दो लोग एक-दूसरे के ऊपर बात करते हैं। लाइनें चरमराती हैं। कोई स्पीकर पर है। कोई अन्य व्यक्ति बैकग्राउंड बकवास वाले कमरे में है। वास्तविक व्यावसायिक प्रश्न अक्सर केवल "कौन से शब्द बोले गए?" नहीं होता है। यह होता है "ग्राहक ने क्या कहा, और एजेंट ने क्या कहा?"
उस वातावरण में, स्पीकर डायराइजेशन WER से थोड़ा सा कम करने से अधिक मायने रख सकता है।
यदि आपकी ट्रांसक्रिप्ट थोड़ी साफ है लेकिन दोनों वक्ताओं को एक स्ट्रीम में मिला देती है, तो आपकी क्यूए टीम, अनुपालन उपकरण और कोचिंग वर्कफ़्लो सभी कमजोर हो जाते हैं। ट्रांसक्रिप्ट का उपयोग करना कठिन हो जाता है।
किस चीज़ के लिए अनुकूलित (ऑप्टिमाइज़) करें:
डायराइजेशन गुणवत्ता
टाइमस्टैम्प संरेखण
टेलीफोनी मजबूती
ओवरलैप किए गए भाषण पर प्रदर्शन
ये कारक अक्सर कच्चे टेक्स्ट की सटीकता से अधिक महत्वपूर्ण होते हैं।
2. वॉयस एजेंट प्रतिक्रिया गति पर जीते या मरते हैं
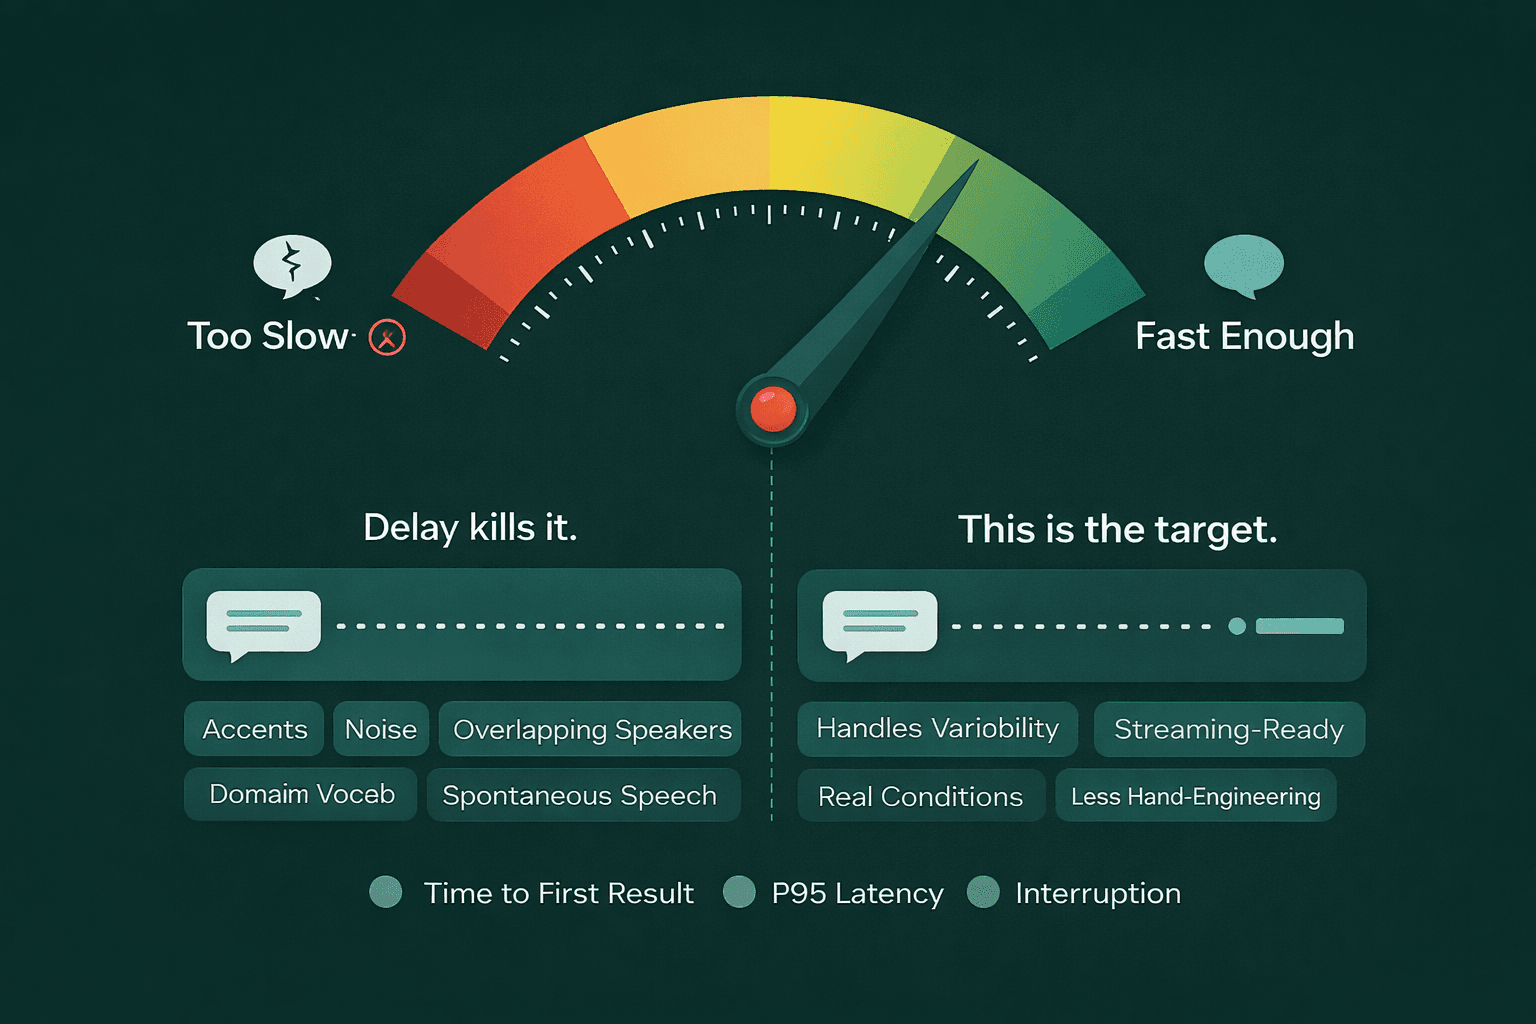
यदि आप एक वॉयस एजेंट बना रहे हैं, तो उपयोगकर्ता आपकी ट्रांसक्रिप्ट को ग्रेड नहीं दे रहा है। वे बातचीत को महसूस कर रहे हैं।
जो चीज़ अनुभव को सबसे पहले तोड़ती है वह अक्सर रिकॉग्निशन की सटीकता नहीं होती है। वह देरी होती है।
एक वॉयस एजेंट को यह जानना आवश्यक है कि उपयोगकर्ता ने कब बोलना शुरू किया, वे क्या कह रहे हैं, क्या उन्होंने बात पूरी कर ली है, और सिस्टम को कब प्रतिक्रिया देनी चाहिए। इसका मतलब है कि रिकॉग्निशन परत को तेजी से और लगातार स्ट्रीम करना चाहिए।
इस सेटअप में, एक प्रमुख मीट्रिक केवल अंतिम ट्रांसक्रिप्ट की गुणवत्ता नहीं है। यह वह गति है जिस पर पहला उपयोगी आंशिक परिणाम दिखाई देता है, और वे स्ट्रीमिंग अपडेट कितने स्थिर हैं।
किस चीज़ के लिए अनुकूलित करें:
पहले परिणाम का समय
लोड के तहत P95 लेटेंसी
रुकावट हैंडलिंग
सहज अंतरिम (इंटरिम) ट्रांसक्रिप्ट
काफी देरी के साथ दी गई अत्यधिक सटीक ट्रांसक्रिप्ट के परिणामस्वरूप अभी भी बातचीत का खराब अनुभव होता है।
3. टेलीफोनी ऑडियो "खराब ऑडियो" नहीं है। यह अलग ऑडियो है
कई टीमें साफ WAV फाइलों पर बेंचमार्क करती हैं और फिर फोन कॉल्स पर तैनात करती हैं। यह अपने आप को मूर्ख बनाने के सबसे तेज़ तरीकों में से एक है।
टेलीफोनी ऑडियो अक्सर होता है:
नैरोबैंड, जैसे 8 kHz
कंप्रेस्ड
μ-law एनकोडेड
नुकसानदेह (Lossy) उन तरीकों से जो यह बदलते हैं कि मॉडल क्या सुनता है
यह टेलीफोनी ऑडियो को अनुपयोगी नहीं बनाता है; यह केवल स्टूडियो-गुणवत्ता वाले ऑडियो से भिन्न होता है।
मूल ऑडियो पर परीक्षण करना लेकिन टेलीफोनी ऑडियो पर तैनात करना ऐसे बेंचमार्क की ओर ले जाता है जो वास्तविक दुनिया के प्रदर्शन को प्रतिबिंबित नहीं करते हैं।
किस चीज़ के लिए अनुकूलित करें:
कोडेक-मैच मूल्यांकन
परीक्षण सेट में फोन-कॉल ऑडियो नमूने
कंप्रेशन आर्टिफैक्ट्स के प्रति मजबूती
वास्तविक कॉल डेटा पर डोमेन शब्दावली
यह सबसे आम मूल्यांकन गलतियों में से एक है जो टीमें करती हैं।
सामान्य ASR उपयोग के मामले (यूज़ केसेस)
ASR अब वर्कफ़्लो की एक विस्तृत श्रृंखला में एम्बेडेड है, लेकिन उपयोग के मामले के अनुसार अनुकूलन लक्ष्य बदल जाता है।
मीटिंग ट्रांसक्रिप्शन: प्राथमिकता आमतौर पर पठनीय टेक्स्ट, विराम चिह्न, टाइमस्टैम्प, स्पीकर लेबल और बहु-वक्ता बातचीत पर मजबूत सटीकता है।
कॉन्टैक्ट सेंटर एनालिटिक्स: आपको टेलीफोनी ऑडियो पर विश्वसनीय प्रदर्शन, अच्छा डायराइजेशन, डोमेन शब्द और क्यूए, अनुपालन, सारांश और राउटिंग के लिए उपयोगी ट्रांसक्रिप्ट की आवश्यकता है।
वॉयस एजेंट्स: स्ट्रीमिंग लेटेंसी महत्वपूर्ण हो जाती है। मॉडल को प्राकृतिक टर्न-टेकिंग का समर्थन करना होगा, न कि केवल अच्छी ऑफ़लाइन ट्रांसक्रिप्ट का।
मीडिया ट्रांसक्रिप्शन और सबटाइटल्स: सटीकता, विराम चिह्न, बहुभाषी हैंडलिंग, टाइमस्टैम्प और बैच दक्षता अल्ट्रा-फास्ट स्ट्रीमिंग की तुलना में अधिक मायने रखती है।
खोजने योग्य ऑडियो आर्काइव्स: आपको ऐसी ट्रांसक्रिप्ट की आवश्यकता है जो इंडेक्सिंग, खोज, टैगिंग और पुनर्प्राप्ति (रिट्रीवल) का समर्थन करने के लिए पर्याप्त रूप से संरचित हों।
सुलभता और लाइव कैप्शन: संतुलन रीयल-टाइम प्रतिक्रिया और स्थिर वृद्धिशील (इन्क्रीमेंटल) आउटपुट की ओर स्थानांतरित हो जाता है, जिसमें सटीकता अभी भी महत्वपूर्ण है लेकिन केवल यही नहीं।
ASR का उचित मूल्यांकन कैसे करें
यह वह हिस्सा है जो एक साफ वेंडर डेमो को गंभीर मूल्यांकन से अलग करता है। इस प्रक्रिया पर गहराई से नज़र डालने के लिए, हमारा गाइड देखें स्ट्रीमिंग स्पीच रिकॉग्निशन मॉडल का मूल्यांकन करना।
1. एक प्रतिनिधि परीक्षण सेट बनाएं
उस ऑडियो पर मूल्यांकन न करें जिसे इकट्ठा करना सबसे आसान हो।
उस ऑडियो का उपयोग करें जो वास्तविकता को दर्शाता है:
वह लहजा (एक्सेन्ट) जो आपके उपयोगकर्ताओं का वास्तव में है
बैकग्राउंड का शोर जिसकी आप वास्तव में अपेक्षा करते हैं
कोडेक जिन्हें आप वास्तव में तैनात करते हैं
डोमेन शब्दावली जिसकी आप वास्तव में परवाह करते हैं
भाषण शैलियाँ जो आपके उपयोगकर्ता वास्तव में उत्पन्न करते हैं
एक अवास्तविक डेटासेट आत्मविश्वास की झूठी भावना पैदा कर सकता है।
2. लगातार ट्रांसक्रिप्ट को सामान्य (नॉर्मलाइज़) करें
यदि एक ट्रांसक्रिप्ट में विराम चिह्न शामिल हैं और दूसरे में नहीं, या एक संकुचन (contractions) का विस्तार करता है और दूसरा उन्हें वैसे ही रखता है, तो आप मूल्यांकन को विकृत कर सकते हैं।
WER या CER की गणना करने से पहले, निर्णय लें:
केसिंग नियम
विराम चिह्न नियम
संख्या स्वरूपण (नंबर फ़ॉर्मेटिंग)
फिलर-वर्ड हैंडलिंग
संक्षिप्त नाम (एब्रिविएशन) हैंडलिंग
असंगत सामान्यीकरण अविश्वसनीय तुलनाओं की ओर ले जाता है।
3. परिणामों को विभाजित करें, केवल उनका औसत न निकालें
एक एकल औसत WER बहुत कुछ छिपा सकता है:
शायद अंग्रेज़ी अच्छा काम करती है, हिंदी-अंग्रेज़ी कोड-स्विचिंग नहीं
शायद साफ ऑडियो अच्छा काम करता है, टेलीफोनी नहीं
शायद छोटे भाषण अच्छे काम करते हैं, लंबी कॉल ख़राब हो जाती हैं
परिणामों को इनके द्वारा विभाजित करें:
भाषा
लहजा (एक्सेन्ट)
ऑडियो स्रोत
शोर का स्तर
उपयोग का मामला
बातचीत की लंबाई
इस स्तर पर विस्तृत विश्लेषण सबसे अधिक व्यावहारिक अंतर्दृष्टि प्रदान करता.
4. लेटेंसी को एक प्रोडक्शन टीम की तरह मापें, न कि एक मार्केटर की तरह
केवल सर्वोत्तम-मामले या औसत लेटेंसी पर निर्भर न रहें।
ट्रैक करें:
P50 लेटेंसी
P95 लेटेंसी
पहले परिणाम का समय
लंबे सत्रों में स्ट्रीमिंग स्थिरता
समानवर्ती (कन्करन्सी) के तहत प्रदर्शन
आउटलेर्स महत्वपूर्ण हैं क्योंकि उपयोगकर्ता सीधे उनके प्रभावों का अनुभव करते हैं।
5. डाउनस्ट्रीम उपयोगिता का मूल्यांकन करें, न कि केवल ट्रांसक्रिप्ट की गुणवत्ता का
पूछें:
क्या आपका सारांशकर्ता (समराइज़र) ट्रांसक्रिप्ट का अच्छी तरह से उपयोग कर सकता है?
क्या समीक्षा वर्कफ़्लो के लिए टाइमस्टैम्प पर्याप्त सटीक हैं?
क्या स्पीकर लेबल टिकते हैं?
क्या ट्रांसक्रिप्ट नाम, उत्पाद शब्द और संख्याएं सुरक्षित रखती है?
क्या सिस्टम मैन्युअल सफाई को कम करता है या सिर्फ काम को आगे खिसका देता है?
इष्टतम (ऑप्टिमल) ASR सिस्टम हमेशा वह नहीं होता है जिसमें उच्चतम बेंचमार्क स्कोर होता है, बल्कि वह होता है जो आपके वर्कफ़्लो में सबसे अच्छी तरह फिट बैठता है।
ASR सॉफ़्टवेयर में क्या देखें
चयन करते समय, एक व्यावहारिक चेकलिस्ट का उपयोग करें।
आपके वास्तविक ऑडियो पर सटीकता: सामान्य दावे नहीं। लीडरबोर्ड स्क्रीनशॉट नहीं। आपका ऑडियो।
यदि आपको लाइव इंटरैक्शन की आवश्यकता है तो स्ट्रीमिंग सपोर्ट: यदि आपका प्रोडक्ट इंटरैक्टिव है, तो रीयल-टाइम सपोर्ट आवश्यक है।
लोड के तहत कम लेटेंसी प्रदर्शन: केवल "आदर्श परिस्थितियों में तेज़" नहीं। तेज़ तब जब कई सत्र सक्रिय हों।
विशेषताएं जो डाउनस्ट्रीम काम को कम करती हैं: स्पीकर डायराइजेशन, टाइमस्टैम्प, सेगमेंटेशन, भाषा का पता लगाना और आत्मविश्वास मेटाडेटा की तलाश करें। ये विशेषताएं अक्सर टीमों की अपेक्षा से अधिक मायने रखती हैं।
परिनियोजन (डेप्लॉयमेंट) और सुरक्षा फिट: विशेष रूप से एंटरप्राइज़ या विनियमित डेटा के लिए, निजी परिनियोजन विकल्पों, अवधारण (रिटेंशन) नियंत्रण, एन्क्रिप्शन, ऑडिटेबिलिटी और एक्सेस नियंत्रण के बारे में पूछें।
मजबूती, न कि केवल बेंचमार्क गुणवत्ता: सिस्टम को वास्तविक दुनिया के ऑडियो के साथ विश्वसनीय रूप से प्रदर्शन करना चाहिए, न कि केवल नियंत्रित वातावरण में।
जहां Smallest AI फिट बैठता है
Smallest AI का प्राथमिक लाभ केवल स्पीच-टू-टेक्स्ट की पेशकश करना नहीं है, बल्कि रीयल-टाइम, प्रोडक्शन-ग्रेड वॉयस वर्कफ़्लो के लिए डिज़ाइन किया गया प्रोडक्ट प्रदान करना है।
यह तब सबसे अधिक मायने रखता है जब खरीदार परवाह करता है:
कम लेटेंसी
लाइव बातचीत
एआई वॉयस एजेंट्स
परिचालन (ऑपरेशनल) उपयोग, न कि केवल ऑफ़लाइन ट्रांसक्रिप्शन
उत्पादन परिनियोजन (प्रोडक्शन डेप्लॉयमेंट) गुणवत्ता
यह वह कोण है जिस पर ध्यान देने योग्य है। सामान्य ASR दावे नहीं। व्यावहारिक वॉयस इंफ्रास्ट्रक्चर मूल्य पर ध्यान केंद्रित करें। अंतर देखने के लिए हमारे स्पीच-टू-टेक्स्ट एपीआई का परीक्षण करें।
ASR बनाम स्पीच-टू-टेक्स्ट बनाम वॉयस रिकॉग्निशन
ASR | वह तकनीक जो बोली जाने वाली ऑडियो को टेक्स्ट में बदलती है | कस्टमर कॉल को ट्रांसक्राइब करना |
स्पीच-टू-टेक्स्ट | ASR के शीर्ष पर निर्मित उत्पाद सुविधा | लाइव कैप्शन या मीटिंग नोट्स |
वॉयस रिकॉग्निशन | यह पहचानना कि वक्ता कौन है | आवाज़ द्वारा उपयोगकर्ता की पहचान सत्यापित करना |
NLP | ट्रांसक्राइब किए गए टेक्स्ट को समझना और उस पर कार्रवाई करना | सारांश, राउटिंग, इरादा पहचान (इंटेंट डिटेक्शन) |
अधिकांश भ्रम इन शर्तों को मिलाने से उत्पन्न होता है। ASR ट्रांसक्राइब किए गए शब्द प्रदान करता है, जबकि अन्य प्रणालियाँ बाद की कार्रवाइयाँ निर्धारित करती हैं।
अंतिम विचार
ASR को अक्सर गलत तरीके से वर्णित किया जाता है या अत्यधिक सरल बनाया जाता है।
यह केवल "AI जो भाषण को टेक्स्ट में बदलता है" से कहीं अधिक है। सटीक होने के बावजूद, इस परिभाषा में व्यावहारिक समझ के लिए पर्याप्त विवरण का अभाव है।
ASR की एक उपयोगी समझ पाइपलाइन से शुरू होती है, फिर वास्तविक प्रश्नों पर जाती है: आप किस तरह के ऑडियो से निपट रहे हैं, आपका प्रोडक्ट कितनी लेटेंसी सहन कर सकता है, कौन से डाउनस्ट्रीम कार्य ट्रांसक्रिप्ट पर निर्भर करते हैं, और आपका सिस्टम टूटने से पहले वास्तविक दुनिया की कितनी गड़बड़ी को अवशोषित कर सकता है।
टीमों को ASR को एक नवीन सुविधा, एक चेकलिस्ट आइटम, या केवल एक बेंचमार्क प्रतियोगिता के बजाय एक महत्वपूर्ण सिस्टम घटक के रूप में देखना चाहिए।
गहन ASR मूल्यांकन के लिए, अपने स्वयं के ऑडियो के साथ सिस्टम का परीक्षण करें, कई मैट्रिक्स का आकलन करें, और अपनी विशिष्ट वर्कफ़्लो आवश्यकताओं के लिए अनुकूलित करें।
सरल शब्दों में ASR क्या है?
क्या एएसआर (ASR) और स्पीच टू टेक्स्ट (speech to text) एक ही हैं?
क्या एएसआर (ASR) वास्तविक समय (real time) में काम कर सकता है?
वर्ड एरर रेट (Word Error Rate) क्या है?
ASR में कम लेटेंसी (low latency) क्यों महत्वपूर्ण है?
डायरीकरण (diarization) क्या है?
क्या एएसआर (ASR) शोर-शराबे वाले वातावरण को संभाल सकता है?
मुझे अपने उत्पाद के लिए एएसआर (ASR) का मूल्यांकन कैसे करना चाहिए?