लॉन्ग-फॉर्म टीटीएस (Long-Form TTS): बड़े पैमाने पर लगातार एक समान आवाज़ कैसे जनरेट करें

लंबे प्रारूप वाले (long-form) टीटीएस के लिए एक प्रोडक्शन गाइड: सिमेंटिक चंकिंग, स्थिर उच्चारण, स्ट्रीमिंग मोड, ऑडियो असेंबली, पुनः प्रयास लॉजिक (retry logic), और स्केलेबल ऑर्केस्ट्रेशन।
लॉन्ग-फॉर्म टीटीएस (TTS) दस्तावेज़ संश्लेषण को एक सिस्टम समस्या में बदल देता है। एक आवाज़ जो बीस सेकंड के लिए आश्वस्त करने वाली लगती है, वह किसी अध्याय के आगे बढ़ने पर पेसिंग, उच्चारण, ऊर्जा, ठहराव, लाउडनेस या अनुरोधों के बीच एन्कोडिंग बदलने के कारण अपनी निरंतरता खो सकती है।
नीचे दी गई वर्कफ़्लो प्रक्रिया दस्तावेज़ की तैयारी से लेकर संश्लेषण, ऑडियो संयोजन, रिकवरी और स्केल तक आगे बढ़ती है। यह उन डेवलपर्स को लक्षित करती है जो ऑडियोबुक, एक्सेसिबिलिटी उत्पाद, शैक्षिक नैरेशन, प्रकाशन प्रणालियाँ और अन्य लॉन्ग-फॉर्म टेक्स्ट-टू-स्पीच एप्लिकेशन बना रहे हैं। अंत तक, आप एक ऐसी पाइपलाइन डिजाइन करने में सक्षम होने चाहिए जो भाषाई संदर्भ को सुरक्षित रखती है और साथ ही हर खंड को स्वतंत्र रूप से पुनरुत्पादित करने योग्य बनाए रखती है।
विषय-सूची:
लॉन्ग-फॉर्म टीटीएस एक अलग इंजीनियरिंग समस्या क्यों है: संदर्भ, भटकाव और अनुरोध सीमाएं।
चरण 1: दस्तावेज़ को सामान्य और खंडित करें: निर्धारक पाठ की तैयारी और सिमेंटिक टीटीएस चंकिंग।
चरण 2: आवाज़ और उच्चारण स्थिति को लॉक करें: स्थिर संश्लेषण सेटिंग्स और शब्दावली नियंत्रण।
चरण 3: एक निष्पादन और वितरण मोड चुनें: अनुक्रमिक, समानांतर, सिंक्रोनस, एसएसई (SSE), और वेबसॉकेट संश्लेषण।
चरण 4: निरंतर ऑडियो को असेंबल और सत्यापित करें: सीम हैंडलिंग, एन्कोडिंग, पुनः प्रयास (रिट्राई), और स्केलेबल आर्किटेक्चर।
उत्पादन चेकलिस्ट और सारांश: परिनियोजन (डिप्लॉयमेंट) जांच और संचालन सिद्धांत।
अनुशंसित यूआरएल (URL) स्लग: long-form-tts-consistent-speech-at-scale
लॉन्ग-फॉर्म टीटीएस एक अलग इंजीनियरिंग समस्या क्यों है
लघु संश्लेषण का मूल्यांकन स्थानीय स्तर पर किया जाता है: क्या वाक्य सुबोध और स्वाभाविक है? लॉन्ग-फॉर्म स्पीच का मूल्यांकन समय के साथ किया जाता है। श्रोता ध्यान देते हैं कि क्या कोई कथावाचक अपनी पहचान बनाए रखता है, क्या पैराग्राफ की शुरुआत में उचित जोर दिया गया है, और क्या कोई आवर्ती शब्द प्लेबैक के एक घंटे बाद भी वैसा ही सुनाई देता है।
आईएससीए (ISCA) आर्काइव में प्रकाशित शोध से पता चला है कि वाक्य दर वाक्य संश्लेषित भाषण का मूल्यांकन करना लॉन्ग-फॉर्म की गुणवत्ता को पूरी तरह से नहीं दर्शाता है, क्योंकि आसपास का संदर्भ यह बदल सकता है कि श्रोता उसी सामग्री को कैसे रेट करते हैं।
कुछ वाक्य और एक संपूर्ण दस्तावेज़ अलग-अलग व्यवहार क्यों करते हैं
चिंता | छोटा अनुरोध | लॉन्ग-फॉर्म पाइपलाइन |
|---|---|---|
संदर्भ | एक ही गद्यांश के भीतर समाहित | अनुरोध सीमाओं के पार जीवित रहना चाहिए |
उच्चारण | कुछ दोहराई गई इकाइयाँ | नाम और संक्षिप्त रूप अध्यायों में बार-बार आते हैं |
ऑडियो | एक एन्कोडेड परिणाम | कई खंडों के लिए सुसंगत संयोजन की आवश्यकता होती है |
रिकवरी | अनुरोध का पुनः प्रयास करें | केवल विफल या अस्वीकृत खंड का पुनः प्रयास करें |
गुणवत्ता नियंत्रण | मैन्युअल रूप से सुनना व्यावहारिक है | स्वचालित जांच और लक्षित समीक्षा की आवश्यकता होती है |
अधिकांश कार्यान्वयन कहाँ गलत होते हैं: वे दस्तावेज़ संश्लेषण को बार-बार होने वाले वाक्य संश्लेषण के रूप में मानते हैं। परिणामी ऑडियो व्यक्तिगत रूप से स्पष्ट हो सकता है लेकिन वैश्विक स्तर पर असंगत हो सकता है।
चरण 1: दस्तावेज़ को सामान्य और खंडित करें
एक निर्धारक सामान्यीकरण परत बनाएं
निकाले गए दस्तावेज़ पाठ को सीधे भाषण संश्लेषण एपीआई (API) पर न भेजें। यूनिकोड को सामान्य करें, आकस्मिक रिक्त स्थान को हटा दें, न बोले जाने वाले मार्कअप को हटा दें, टंकण विराम चिह्नों को हल करें, और शीर्षकों, सूचियों, उद्धरणों, फुटनोटों और कोड को वर्गीकृत करें। मूल पाठ और संस्करणित सामान्यीकृत प्रतिनिधित्व दोनों को सुरक्षित रखें ताकि उत्पन्न ऑडियो ऑडिट योग्य रहे।
सामान्यीकरण के निर्णय स्पष्ट होने चाहिए:
संदर्भ के अनुसार संख्याओं का विस्तार करें। स्ट्रिंग 1205 का अर्थ एक वर्ष, एक मात्रा, एक पहचानकर्ता, या बारह-सौ-पांच हो सकता है।
परिभाषित करें कि तिथियों, मुद्राओं, इकाइयों, यूआरएल, ईमेल पतों और गणितीय चिह्नों को कैसे बोला जाता है।
संश्लेषण से पहले संक्षिप्ताक्षरों को हल करें जब उनका विस्तार स्पष्ट हो।
भाषा टैग और वक्ता परिवर्तनों को गद्य में समतल करने के बजाय मेटाडेटा के रूप में रखें।
कैरेक्टर ऑफ़सेट रिकॉर्ड करें जो सामान्यीकृत पाठ को वापस स्रोत दस्तावेज़ से मैप करते हैं।
अर्थ के अनुसार चंक करें, कैरेक्टर काउंट के अनुसार नहीं
टीटीएस चंकिंग वाक्य और पैराग्राफ सीमाओं से शुरू होनी चाहिए। पूर्ण वाक्यों को तब तक एकत्रित करें जब तक कि एक कॉन्फ़िगर करने योग्य लक्ष्य प्राप्त न हो जाए, लेकिन पैराग्राफ, शीर्षक, दृश्य परिवर्तन, या संवाद सीमा पर समाप्त होने को प्राथमिकता दें। किसी संख्या, संक्षिप्त रूप, उद्धृत वाक्यांश, या उच्चारण टोकन के अंदर कभी भी विभाजित न करें।
व्यावहारिक एल्गोरिथ्म: संरचना को पार्स करें, वाक्यों का पता लगाएं, प्रत्येक उम्मीदवार की संश्लेषण लागत का अनुमान लगाएं, कॉन्फ़िगर किए गए लक्ष्य के अंतर्गत जोड़ें, फिर सबसे मजबूत नजदीकी अर्थ सीमा का चयन करें। चंक आईडी, स्रोत श्रेणी, पूर्ववर्ती संदर्भ, अनुगामी संदर्भ, और सामान्यीकृत पाठ का एक हैश संग्रहीत करें।
कोई सार्वभौमिक रूप से इष्टतम चंक आकार नहीं है। सही रेंज मॉडल के व्यवहार, एपीआई सीमाओं, विलंबता (लेटेंसी) लक्ष्यों, भाषा, पैराग्राफ संरचना, और क्या एप्लिकेशन को प्रगतिशील प्लेबैक की आवश्यकता है, इस पर निर्भर करती है। अलग-थलग नमूनों के बजाय संपूर्ण दस्तावेज़ों का उपयोग करके कई श्रेणियों का परीक्षण करें। एक अनुरोध के रूप में अत्यधिक बड़े ब्लॉक को भेजने से टाइमआउट का जोखिम बढ़ जाता है, पुनः प्रयास जटिल हो जाते हैं, अवलोकन क्षमता कम हो जाती है, और यह व्यावहारिक सेवा सीमाओं से अधिक हो सकता है।
चरण 2: आवाज़ और उच्चारण स्थिति को लॉक करें
प्रत्येक उत्पादन के लिए एक अपरिवर्तनीय संश्लेषण प्रोफ़ाइल बनाएं। इसमें आवाज़ या क्लोन पहचानकर्ता, मॉडल संस्करण, भाषा, गति, नमूना दर (सैंपल रेट), आउटपुट प्रारूप, चैनल लेआउट, उच्चारण संसाधन संस्करण, और प्रदाता द्वारा उजागर किए गए प्रत्येक प्रासंगिक पीढ़ी नियंत्रण को शामिल किया जाना चाहिए। प्रोफ़ाइल को हैश करें और उस हैश को प्रत्येक अनुरोध के साथ संलग्न करें।
एक सुसंगत एआई (AI) आवाज़ के लिए एक स्थायी आवाज़ पहचान की आवश्यकता होती है। प्रति चंक आवाज़ को फिर से न बनाएं या फिर से क्लोन न करें। लाइटनिंग मॉडल के साथ Smallest.ai के Waves API का उपयोग करते समय, चयनित आवाज़ और समर्थित संश्लेषण मापदंडों को दस्तावेज़ में स्थिर रखें। अनुरोधों का निर्माण करते समय वर्तमान आधिकारिक दस्तावेज़ीकरण से परामर्श करें, क्योंकि उपलब्ध फ़ील्ड एंडपॉइंट और मॉडल के अनुसार भिन्न होते हैं।
उच्चारण को उत्पादन डेटा के रूप में मानें
संश्लेषण से पहले नामित संस्थाओं, संक्षिप्ताक्षरों, संक्षिप्त रूपों, उत्पाद नामों, मापों और डोमेन शब्दावली को निकालें।
भाषा-विशिष्ट रूपों और केस-संवेदी अपवादों सहित प्रामाणिक बोले जाने वाले रूप बनाएं।
उच्चारण शब्दकोशों या लेक्सिकॉन का उपयोग करें जहां चयनित टेक्स्ट-टू-स्पीच एपीआई उनका समर्थन करता है।
अन्यथा, नियंत्रित पाठ प्रतिस्थापन लागू करें और परीक्षण करें कि वे दृश्य संरेखण या कैप्शन में बदलाव नहीं करते हैं।
शब्दकोश को संस्करणित करें। केवल बदले हुए प्रविष्टि से प्रभावित चंक्स को पुनर्जीवित करें।
संदर्भ अभी भी मायने रखता है। नासा (NASA) को आम तौर पर एक शब्द के रूप में बोला जाता है; एपीआई (API) को आमतौर पर अलग-अलग अक्षरों में पढ़ा जाता है। एक उपनाम व्यक्ति के अनुसार भिन्न हो सकता है, और एक संक्षिप्त रूप डोमेन के अनुसार अलग-अलग विस्तारित हो सकता है। महंगी एआई वॉयस जनरेशन से पहले एक इकाई समीक्षा चलाएं, विशेष रूप से चिकित्सा, कानूनी, वैज्ञानिक और बहुभाषी सामग्री के लिए। उत्पादों में आवाज़ की पहचान प्रबंधित करने वाली टीमें आवाज़ की पहचान को सुसंगत रखने के लिए एक प्रलेखित प्रक्रिया का भी उपयोग कर सकती हैं।
चरण 3: एक निष्पादन और वितरण मोड चुनें
निष्पादन मोड का चयन
मोड | उपयोग कब करें | परिचालन संबंधी चिंता |
|---|---|---|
सिंक्रोनस | एक सीमित चंक तैयार है और कॉलर प्रतीक्षा कर सकता है | टाइमआउट और प्रतिक्रिया का आकार |
एसएसई (SSE) | संपूर्ण पाठ पहले से ही उपलब्ध है लेकिन ऑडियो क्रमिक रूप से आना चाहिए | पुनः कनेक्ट करना और आंशिक-आउटपुट हैंडलिंग |
वेबसॉकेट (WebSocket) | पाठ किसी एजेंट, मॉडल या लाइव स्रोत से वृद्धिशील रूप से आता है | सत्र स्थिति, क्रम निर्धारण, और बैकप्रेशर |
ऑफ़लाइन दस्तावेज़ कार्यों के लिए सिंक्रोनस अनुरोध सीधे होते हैं। Smallest.ai उन मामलों के लिए एसएसई (SSE) स्ट्रीमिंग को प्रलेखित करता है जहां संपूर्ण पाठ पहले से ही ज्ञात है और वेबसॉकेट (WebSocket) स्ट्रीमिंग जब पाठ वृद्धिशील रूप से आता है। यह अंतर मायने रखता है: स्ट्रीमिंग टेक्स्ट-टू-स्पीच एक परिवहन पैटर्न नहीं है, और गलत पैटर्न चुनने से नैरेशन की गुणवत्ता में सुधार किए बिना बफरिंग या सत्र की जटिलता बढ़ जाती है।
अनुक्रमिक बनाम समानांतर संश्लेषण
अनुक्रमिक संश्लेषण क्रम निर्धारण को सरल बनाता है और स्थिति को सुरक्षित रख सकता है जब एक एपीआई स्पष्ट रूप से प्रासंगिक निरंतरता का समर्थन करता है, लेकिन कुल कार्य समय चंक संख्या के साथ रैखिक रूप से बढ़ता है। समानांतर संश्लेषण थ्रूपुट में सुधार करता है और धीमे अनुरोधों को अलग करता है, फिर भी यह दर-नियंत्रण दबाव को बढ़ाता है और क्रॉस-चंक प्रोसोडी अंतर को अधिक ध्यान देने योग्य बना सकता है क्योंकि चंक्स को स्वतंत्र रूप से संश्लेषित किया जाता है।
अनुशंसित उत्पादन समझौता: एक दस्तावेज़ के भीतर सीमित समानांतरता का उपयोग करें, सख्त आउटपुट ऑर्डरिंग बनाए रखें, और समर्थित संदर्भ को लगातार पास करें। रूढ़िवादी तरीके से शुरू करें, आसन्न-सीमा गुणवत्ता की तुलना करें, फिर समवर्ती (कन्करेंसी) को केवल तभी बढ़ाएं जब सुनने के परीक्षण और वेवफॉर्म मेट्रिक्स स्थिर रहें।
विकासकर्ताओं को लक्षित करने वाले किसी भी टीटीएस एपीआई (TTS API) के लिए, समवर्ती नियंत्रण ऑर्केस्ट्रेशन परत में होते हैं। एक कतार, प्रति-प्रदाता सीमक, जिटर के साथ घातीय बैकऑफ़, और दस्तावेज़ आईडी, चंक हैश, व संश्लेषण-प्रोफ़ाइल हैश पर आधारित इडेम्पोटेंसी का उपयोग करें।
चरण 4: निरंतर ऑडियो को असेंबल और सत्यापित करें
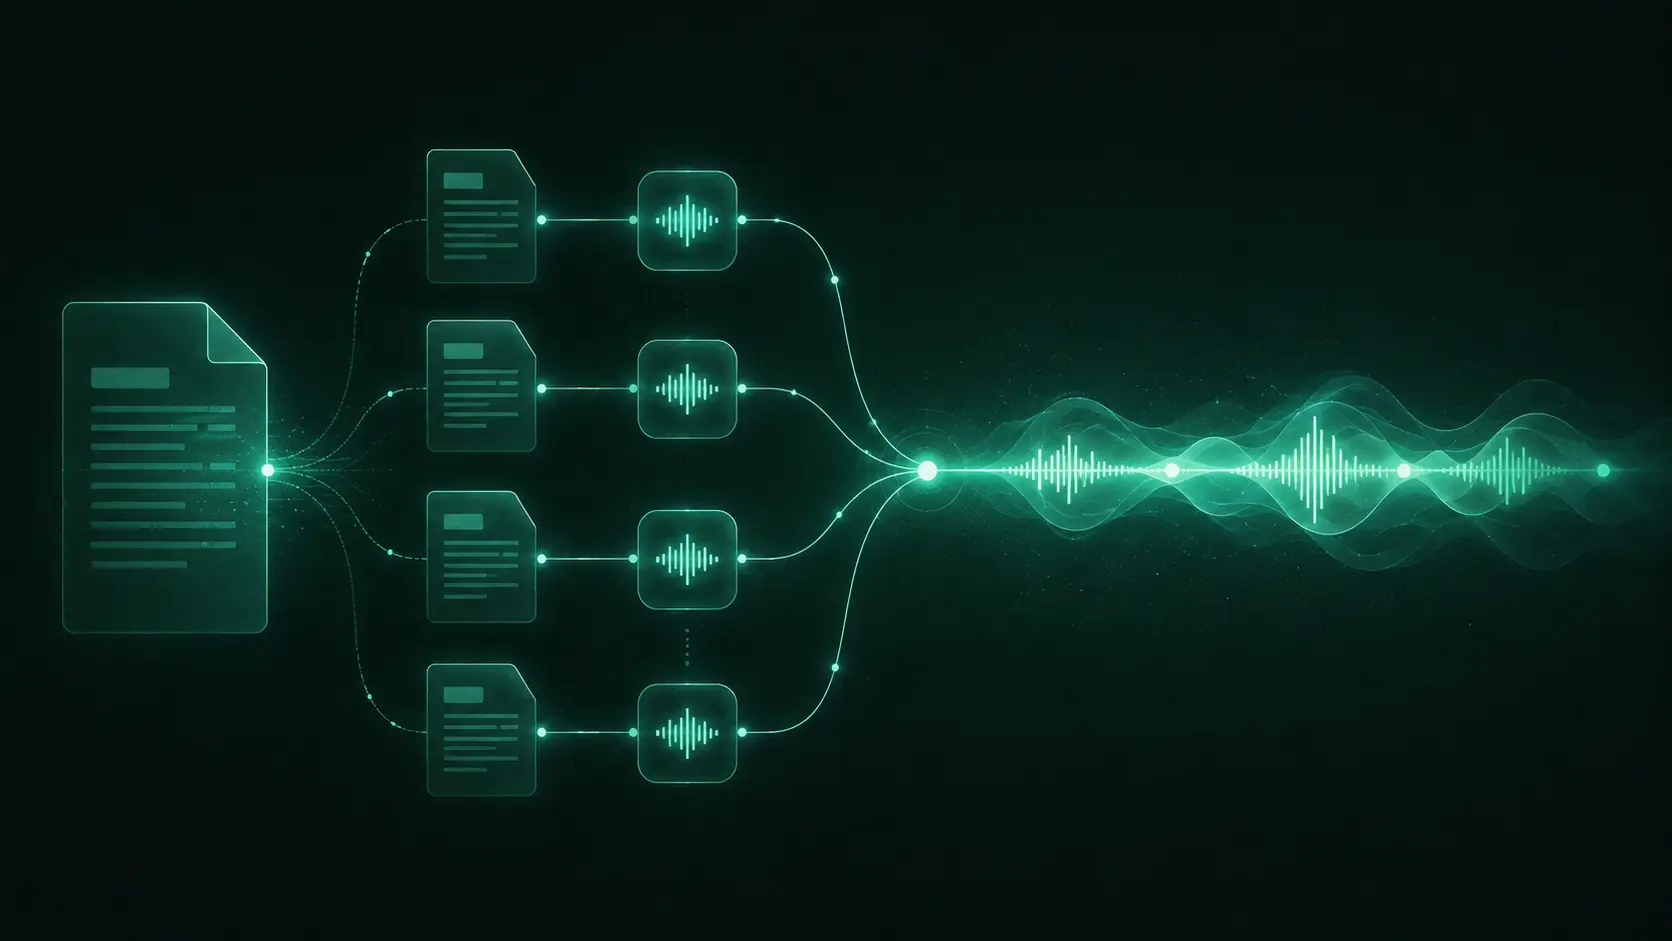
पहले संगत पीसीएम (PCM) को जोड़ें, संक्रमणों को सत्यापित करें, फिर अंतिम डिलीवरेबल को एन्कोड करें।
बिना सीम बनाए ऑडियो को जोड़ें
कॉन्कैटिनेशन से पहले प्रत्येक प्रतिक्रिया को एक सामान्य पीसीएम (PCM) प्रतिनिधित्व में डिकोड करें। नमूना दर, बिट गहराई, चैनल संख्या और फ्रेम संरेखण को सत्यापित करें। यह न मानें कि स्वतंत्र रूप से एन्कोडेड एमपी3 या कंटेनर फ़ाइलों को बाइट-कॉन्कैटिनेट करने से एक साफ, मानकों के अनुरूप परिणाम मिलेगा। खंडों को एक सामान्य पीसीएम प्रारूप में डिकोड करें, उन्हें असेंबल करें, और अंतिम प्रोग्राम को एक बार एन्कोड करें।
प्रत्येक सीमा पर:
अग्रणी और अनुगामी मौन को मापें, लेकिन जानबूझकर किए गए बयानबाजी के ठहराव को न हटाएं।
दस्तावेज़ की संरचना से ठहराव की अवधि डालें, जैसे कि वाक्य, पैराग्राफ, शीर्षक, या दृश्य विराम।
बहुत छोटे फ़ेड्स केवल तभी लागू करें जब वे क्लिक को रोकते हों। व्यापक क्रॉसफ़ेड्स व्यंजनों को धुंधला कर सकते हैं या रूम टोन की नकल कर सकते हैं।
पड़ोसी खंडों के खिलाफ पीक स्तर, डीसी (DC) ऑफ़सेट, लाउडनेस और विच्छिन्नता की जांच करें।
असेंबली के बाद एक कोडेक कॉन्फ़िगरेशन का उपयोग करके एक बार एन्कोड करें।
सामान्यीकरण का अर्थ यह नहीं है कि प्रत्येक चंक को स्वतंत्र रूप से समान लाउडनेस के लिए मजबूर किया जाए। प्रति-चंक लाभ परिवर्तन सीमाओं पर शोर और मुखर ऊर्जा को पंप करते हैं। चंक्स को मापें, आउटलेर्स को चिह्नित करें, प्रोग्राम को असेंबल करें, फिर नियंत्रित प्रोग्राम-स्तरीय सामान्यीकरण लागू करें। अभिलेखीय पीसीएम या एक दोषरहित मध्यवर्ती को बनाए रखें ताकि भविष्य के निर्यात कोडेक क्षति को संचित न करें।
रिकवरी और स्केल के लिए मेनिफेस्ट का उपयोग करें
एक स्केलेबल टेक्स्ट-टू-स्पीच सिस्टम प्रति दस्तावेज़ एक मेनिफेस्ट संग्रहीत करता है। प्रत्येक चंक रिकॉर्ड में स्रोत ऑफ़सेट, सामान्यीकृत पाठ हैश, संश्लेषण प्रोफ़ाइल, उच्चारण संस्करण, अनुरोध आईडी, प्रयास गणना, प्रदाता प्रतिक्रिया मेटाडेटा, ऑडियो चेकसम, अवधि, सत्यापन परिणाम और ऑब्जेक्ट-स्टोरेज स्थान शामिल होते हैं।
श्रमिक कतारबद्ध चंक्स का दावा करते हैं, भाषण संश्लेषण एपीआई को कॉल करते हैं, अपरिवर्तनीय आउटपुट अपलोड करते हैं, और स्थिति को ट्रांसेक्शनली अपडेट करते हैं। असेंबलर केवल तभी चलता है जब आवश्यक चंक्स सत्यापन पास कर लेते हैं। एक विफल चंक का स्वतंत्र रूप से पुनः प्रयास किया जाता है; एक बदला हुआ पैराग्राफ केवल अपने आश्रित चंक्स को अमान्य करता है। घटना विश्लेषण के लिए अनुरोध आईडी और प्रदाता त्रुटि निकायों को रखें।
संदर्भ आर्किटेक्चर: इंजेशन सेवा से नॉर्मलाइज़र से सिमेंटिक सेगमेंटर से ड्यूरेबल कतार से बाउंडेड सिंथेसिस वर्कर्स से ऑब्जेक्ट स्टोरेज से ऑडियो असेंबलर से ऑटोमेटेड क्यूसी (QC) से पब्लिशिंग। एक नियंत्रण डेटाबेस मैनिफ़ेस्ट और स्थिति संक्रमणों को संग्रहीत करता है, जबकि मेट्रिक्स प्रयासों, विलंबता, आउटपुट अवधि, सत्यापन विफलताओं और कतार की आयु को ट्रैक करते हैं।
दस्तावेज़-स्तरीय ऑर्केस्ट्रेशन को चंक-स्तरीय निष्पादन से अलग करके स्केल करें। टेनेंट या प्राथमिकता के आधार पर कतारों को विभाजित करें, कोटा लागू करें, समान चंक आउटपुट को केवल तभी कैश करें जब सभी संश्लेषण इनपुट मेल खाते हों, और स्थायी विफलताओं के लिए डेड-लेटर हैंडलिंग का उपयोग करें। प्रकाशन वर्कफ़्लो के लिए, देखें कि टीमें कैसे लिखित सामग्री को बड़े पैमाने पर लॉन्ग-फॉर्म ऑडियो में बदलती हैं।
उत्पादन चेकलिस्ट और सारांश
डेवलपर चेकलिस्ट:
पाठ को निर्धारक रूप से सामान्य करें और स्रोत मैपिंग को सुरक्षित रखें।
भाषाई सीमाओं पर विभाजित करें, मनमाने कैरेक्टर ऑफ़सेट पर नहीं।
आवाज़, मॉडल, भाषा, गति, उच्चारण, नमूना दर और प्रारूप सेटिंग्स को संस्करणित करें।
इडेम्पोटेंट पुनः प्रयास और अनुरोध ट्रैकिंग के साथ सीमित समवर्तीता का उपयोग करें।
सामान्य पीसीएम को असेंबल करें, ठहराव को जानबूझकर प्रबंधित करें, और एक बार एन्कोड करें।
सीम, अवधि, लाउडनेस, क्लिपिंग, गायब ऑडियो और उच्चारण-संवेदनशील चंक्स को सत्यापित करें।
मेनिफेस्ट संग्रहीत करें ताकि व्यक्तिगत चंक्स को सुरक्षित रूप से पुनर्जीवित किया जा सके।
पाठ की उपलब्धता और प्लेबैक आवश्यकताओं के आधार पर सिंक्रोनस, एसएसई (SSE), या वेबसॉकेट (WebSocket) वितरण चुनें।
विश्वसनीय लॉन्ग-फॉर्म टीटीएस कई नियंत्रित संश्लेषण ऑपरेशनों में स्थिति को सुरक्षित रखने से आता है। सिमेंटिक सेगमेंटेशन भाषा के संदर्भ की रक्षा करता है, अपरिवर्तनीय प्रोफाइल आवाज़ की पहचान की रक्षा करते हैं, उच्चारण डेटा आवर्ती शब्दावली की रक्षा करता है, और मेनिफेस्ट विफलता रिकवरी को किफायती बनाते हैं।
डेवलपर्स इस वर्कफ़्लो को Smallest.ai के टेक्स्ट-टू-स्पीच समाधान और इसके प्रलेखित सिंक्रोनस, एसएसई, और वेबसॉकेट टीटीएस एपीआई के साथ लागू कर सकते हैं। ऑर्केस्ट्रेशन, सत्यापन और ऑडियो असेंबली परतों को प्रदाता-जागरूक लेकिन स्वतंत्र रूप से परीक्षण योग्य रखें।
अक्सर पूछे जाने वाले प्रश्न
क्या मुझे एक ही टीटीएस (TTS) अनुरोध में पूरी किताब भेजनी चाहिए?
लंबी अवधि के टीटीएस (TTS) के लिए मुझे किस चंक साइज (chunk size) का उपयोग करना चाहिए?
क्या मैं सभी खंडों (chunks) को समानांतर रूप से संश्लेषित कर सकता हूँ?
मैं तकनीकी शब्दों का उच्चारण लगातार एक जैसा कैसे रखूँ?
मुझे सिंक्रोनस टीटीएस (TTS) के बजाय स्ट्रीमिंग का उपयोग कब करना चाहिए?


