2026 के सर्वश्रेष्ठ टीटीएस (TTS) मॉडल: गुणवत्ता, विलंबता और उत्पादन उपयुक्तता

वॉइस क्वालिटी, लेटेंसी (विलंबता), कीमत और वॉइस एजेंट्स, नरेशन व सपोर्ट ऑटोमेशन के लिए उनकी उपयुक्तता के आधार पर 2026 के बेहतरीन टीटीएस (TTS) मॉडल्स की तुलना करें।
2026 के सर्वश्रेष्ठ टीटीएस (TTS) मॉडल आवश्यक रूप से वे नहीं हैं जो किसी अलग डेमो में सबसे प्रभावशाली लगते हैं। वॉयस एजेंटों को तेज़ पहले ऑडियो, स्थिर स्ट्रीमिंग, पूर्वानुमेय समवर्तीता (concurrency) और नियंत्रणीय उच्चारण की आवश्यकता होती है। नरेशन (वर्णन) टीमों को लॉन्ग-फॉर्म निरंतरता और संपादन नियंत्रण की चिंता होती है। सहायता स्वचालन (सपोर्ट ऑटोमेशन) इन सभी के साथ अनुपालन, बहुभाषी कवरेज और अपटाइम आवश्यकताओं को जोड़ता है।
संक्षिप्त निर्णय: विलंबता-संवेदनशील (लेटेंसी-सेंसिटिव) वॉयस एजेंटों के लिए, Smallest.ai Lightning को रीयल-टाइम इंटरैक्शन के लिए डिज़ाइन किया गया है। ElevenLabs को आमतौर पर अभिव्यंजक वर्णन के लिए आंका जाता है, जबकि Deepgram, OpenAI, और Cartesia बुनियादी ढांचे और कार्यभार के आधार पर विभिन्न उत्पादन आवश्यकताओं के लिए उपयुक्त बैठते हैं।
2026 के अग्रणी टेक्स्ट टू स्पीच मॉडलों का मूल्यांकन कैसे किया गया
यह टीटीएस एपीआई तुलना होस्ट किए गए एआई स्पीच सिंथेसिस मॉडल और स्व-होस्ट किए गए न्यूरल टीटीएस मॉडल दोनों पर समान रूप से पांच मानदंडों को लागू करती है, हालांकि दोनों के बीच परिनियोजन (डिप्लॉयमेंट) जिम्मेदारियां भिन्न होती हैं।
मूल्यांकन मानदंड:
आवाज की गुणवत्ता और नियंत्रण: स्वाभाविकता, स्पष्टता, भावनात्मक रेंज, उच्चारण, गति, बहुभाषी व्यवहार और लंबे अंशों में स्थिरता।
विलंबता (लेटेंसी): समान क्षेत्र, कोडेक, कनेक्शन प्रकार और टेक्स्ट की लंबाई पर पहले ऑडियो का समय, चंक कैडेंस, संश्लेषण अवधि और रुकावट व्यवहार।
पैमाना और विश्वसनीयता: समवर्तीता सीमाएं, दर-सीमा व्यवहार, क्षेत्रीय रूटिंग, अवलोकन क्षमता (ऑब्जर्वेबिलिटी), पुनः प्रयास, सेवा स्थिति और सहायता वृद्धि।
मूल्य निर्धारण और अधिकार: वर्ण या समय-आधारित बिलिंग, प्रतिबद्ध-उपयोग की शर्तें, क्लोनिंग सहमति, जनरेटेड-ऑडियो अधिकार और पुनः प्रयासों या अप्रयुक्त आउटपुट के लिए लागत।
एकीकरण उपयुक्तता: स्ट्रीमिंग प्रोटोकॉल, एसडीके गुणवत्ता, टेलीफोनी कोडेक्स, कस्टम शब्दकोश, टाइमस्टैम्प, वॉयस क्लोनिंग और एजेंट ऑर्केस्ट्रेशन के साथ अनुकूलता।
सार्वजनिक टीटीएस बेंचमार्क वास्तविक संकेत देते हैं, लेकिन वे विनिमेय नहीं हैं। कोवल (Coval) के टीटीएस मूल्यांकन जैसे स्वतंत्र बेंचमार्क ने प्रदाताओं के बीच पहले ऑडियो के समय (time-to-first-audio) के प्रदर्शन में अंतर की सूचना दी है। हालाँकि, मॉडल संस्करण, क्षेत्र, बुनियादी ढांचे और परीक्षण पद्धति के आधार पर परिणाम काफी भिन्न होते हैं, इसलिए टीमों को अपनी उत्पादन स्थितियों के तहत विलंबता को सत्यापित करना चाहिए। आर्टिफिशियल एनालिसिस जैसे प्लेटफॉर्म से स्पीच क्वालिटी रैंकिंग उपयोगी दिशात्मक संकेत प्रदान करती है, लेकिन मॉडल, मूल्यांकन विधियों और डेटासेट के विकसित होने पर रैंकिंग बदल सकती है। कुछ मूल्यांकनों ने कोकोरो (Kokoro) जैसे ओपन-सोर्स मॉडल के लिए मजबूत अवधारणात्मक गुणवत्ता स्कोर की सूचना दी है, लेकिन टीमों को अपनी खुद की आवाज़, भाषाओं और लक्षित दर्शकों का उपयोग करके गुणवत्ता को सत्यापित करना चाहिए। विभिन्न संकेत (प्रॉम्प्ट), क्षेत्र, परिवहन, श्रोता और स्कोरिंग विधियां एकल संयुक्त रैंकिंग को असंभव बनाती हैं।
स्थायी कनेक्शन और उत्पादन में उपयोग किए जाने वाले सटीक कोडेक का उपयोग करके परिनियोजन क्षेत्र से बेंचमार्क करें। केवल प्रदाता की सर्वोत्तम प्रतिक्रिया के बजाय P50, P95 और P99 प्रथम-ऑडियो विलंबता को रिकॉर्ड करें।
होस्टेड टीटीएस विकल्पों की आमने-सामने तुलना
प्रदाता | गुणवत्ता प्रोफ़ाइल | विलंबता उपयुक्तता | स्केलिंग और एपीआई उपयुक्तता | मूल्य निर्धारण पर विचार | सर्वश्रेष्ठ उत्पादन उपयुक्तता |
|---|---|---|---|---|---|
Smallest.ai Lightning | संवादात्मक, कॉन्फ़िगर करने योग्य आवाजें और क्लोनिंग | कम विलंबता वाले टीटीएस और रीयल-टाइम इंटरैक्शन के लिए डिज़ाइन किया गया | एक व्यापक स्पीच और एजेंट स्टैक के भीतर स्ट्रीमिंग एपीआई | वर्तमान उपयोग और उद्यम (एंटरप्राइज) शर्तों की जांच करें | वॉयस एजेंट, सहायता कॉल, संवादात्मक एआई |
ElevenLabs | व्यापक वॉयस टूलिंग के साथ अभिव्यंजक भाषण | स्ट्रीमिंग विकल्प, लेकिन मॉडल-विशिष्ट TTFA का परीक्षण करें | परिपक्व होस्टेड प्लेटफॉर्म और व्यापक निर्माता वर्कफ़्लो | मॉडल, योजना और उपयोग भत्ते भिन्न हो सकते हैं | वर्णन, स्थानीयकरण, ब्रांडेड आवाज अनुभव |
Deepgram | भाषण बुनियादी ढांचे के साथ जोड़ा गया संवादात्मक संश्लेषण | रीयल-टाइम एपीआई पोजिशनिंग | एसटीटी (STT) और टीटीएस (TTS) विक्रेताओं को समेकित करने वाली टीमों के लिए उपयोगी | ऑडियो उपयोग और प्रतिबद्ध मात्रा का मूल्यांकन करें | संपर्क केंद्र और मौजूदा डीपग्राम स्टैक |
OpenAI | एक मल्टीमॉडल पारिस्थितिकी तंत्र के भीतर निर्देश-जागरूक भाषण | आर्किटेक्चर ट्यून होने पर इंटरैक्टिव सिस्टम के लिए उपयुक्त | एकीकृत मॉडल वर्कफ़्लो एप्लिकेशन एकीकरण को कम करते हैं | भाषा-मॉडल और ऑडियो लागत शामिल करें | मल्टीमॉडल सहायक और उत्पन्न संवाद |
Cartesia | अभिव्यंजक संवादात्मक आउटपुट | मजबूत सार्वजनिक विलंबता बेंचमार्क परिणाम | स्ट्रीमिंग-उन्मुख डेवलपर प्लेटफॉर्म | मॉडल और समवर्ती शर्तों की पुष्टि करें | उत्तरदायी एजेंट और इंटरैक्टिव चरित्र |
Smallest.ai Lightning: विलंबता-संवेदनशील वॉयस एजेंटों के लिए सर्वश्रेष्ठ
Smallest.ai रीयल-टाइम वॉयस अनुप्रयोगों के लिए स्पीच मॉडल और एजेंट इन्फ्रास्ट्रक्चर प्रदान करता है।
Smallest.ai, Lightning को रीयल-टाइम टेक्स्ट-टू-स्पीच एपीआई के रूप में स्थापित करता है, जिससे यह उन अनुप्रयोगों के लिए उपयुक्त हो जाता है जहां प्रतिक्रिया और संवादात्मक प्रवाह महत्वपूर्ण होते हैं। स्ट्रीमिंग टीटीएस पूर्ण प्रतिक्रिया मौजूद होने से पहले प्लेबैक शुरू कर सकता है, जिससे उपयोगकर्ता बोलने के बाद महसूस होने वाले सन्नाटे को कम कर देता है। वह अंतर टेलीफोनी, अपॉइंटमेंट शेड्यूलिंग, आउटबाउंड योग्यता और ग्राहक सहायता में गहराई से महसूस किया जाता है।
व्यापक स्टैक में भाषण पहचान के लिए Pulse, भाषण-से-भाषण के लिए Hydra, संवादात्मक भाषा प्रसंस्करण के लिए Electron, और आवाज और टेक्स्ट एजेंटों के लिए Atoms शामिल हैं। टीमें पूरे पाइपलाइन को माइग्रेट किए बिना Waves एपीआई के माध्यम से Lightning को अपना सकती हैं। यह प्रतिरूपकता (मॉड्यूलरिटी) इसे उन वॉयस एआई प्लेटफार्मों से अलग करती है जिन्हें एक विशिष्ट एजेंट रनटाइम की आवश्यकता होती है।
पेशेवर पहलू: रीयल-टाइम फोकस, वॉयस क्लोनिंग, स्ट्रीमिंग इंटीग्रेशन और संबंधित स्पीच घटक।
कमियां: टीमों को अपने कॉल मिक्स के विरुद्ध भाषा कवरेज, अभिव्यंजक सीमा, क्षेत्रीय प्रदर्शन और उद्यम क्षमता का स्वतंत्र रूप से मूल्यांकन करना चाहिए।
एक प्रतिनिधि लोड परीक्षण चलाएं, फिर परिणाम की तुलना कम-विलंबता वाले वॉयस एजेंटों के लिए उपयोग किए जाने वाले इंजीनियरिंग पैटर्न से करें। वर्तमान व्यावसायिक शर्तें Smallest.ai मूल्य निर्धारण पृष्ठ पर सूचीबद्ध हैं।
ElevenLabs: अभिव्यंजक वर्णन और आवाज वर्कफ़्लो के लिए सर्वश्रेष्ठ
ElevenLabs कई उपयोग स्तरों में भाषण जनरेशन और आवाज सुविधाओं को पैक करता है।
जब डिलीवरी शैली और आवाज का चयन कच्चे प्रतिक्रिया समय से अधिक मायने रखता है, तो ElevenLabs आगे निकल जाता है। इसका पारिस्थितिकी तंत्र ऑडियोबुक्स, मार्केटिंग नरेशन, स्थानीयकरण, गेम और ब्रांडेड सामग्री के लिए बहुत उपयुक्त है जो अभिव्यंजक भिन्नता से लाभान्वित होते हैं।
संवादात्मक परिनियोजन के लिए, चयनित सटीक ElevenLabs मॉडल का बेंचमार्क करें। एक नरेशन-उन्मुख मॉडल और एक तेज़ मॉडल की गुणवत्ता, लागत और विलंबता व्यवहार में महत्वपूर्ण अंतर हो सकता है।
परिचालन का नकारात्मक पहलू विकल्प की जटिलता है। टीमों को प्रत्येक कार्यभार के लिए मॉडल, आवाज, योजना भत्ता, समवर्तीता और गुणवत्ता सेटिंग्स का मिलान करना होगा। पुष्टि करें कि क्या खारिज किए गए जनरेशन और पुनः प्रयास उपयोग में गिने जाते हैं। जो खरीदार तेज या अलग तरीके से पैक की गई सेवा की तलाश में हैं, उन्हें सभी यथार्थवादी टेक्स्ट-टू-स्पीच प्रणालियों को समान मानने के बजाय वर्तमान ElevenLabs विकल्पों की तुलना करनी चाहिए।
Deepgram: समेकित भाषण बुनियादी ढांचे के लिए सर्वश्रेष्ठ
Deepgram अपनी स्थापित भाषण पहचान सेवाओं के साथ-साथ टेक्स्ट-टू-स्पीच भी प्रदान करता है।
Deepgram उन टीमों के लिए सबसे सम्मोहक है जो पहले से ही इसके स्पीच-टू-टेक्स्ट स्टैक को चला रही हैं। पहचान और संश्लेषण को समेकित करने से प्रमाणीकरण, विक्रेता प्रबंधन, अवलोकन क्षमता और उद्यम खरीद को सरल बनाया जा सकता है। यह परिचालन कमी पृथक आवाज प्राथमिकता में एक छोटे अंतर से अधिक महत्वपूर्ण हो सकती है।
इसका उत्पादन मामला संवादात्मक अनुप्रयोगों और संपर्क केंद्रों पर केंद्रित है। एक साथ आने वाली कॉल के तहत एंडपॉइंट स्थानों, समर्थित ऑडियो प्रारूपों, शब्दकोश नियंत्रणों, आवाज सूची और समवर्तीता का मूल्यांकन करें। Deepgram के स्पीच पोर्टफोलियो में STT और TTS दोनों शामिल हैं, जबकि AssemblyAI मुख्य रूप से भाषण पहचान से जुड़ा हुआ है और सीधा TTS विकल्प नहीं है।
परिनियोजन जांच:
संयुक्त STT, रीजनिंग, TTS और टेलीफोनी विलंब को मापें।
संक्षिप्त रूपों, खाता संख्याओं, पतों और डोमेन शब्दावली का परीक्षण करें।
दर सीमाओं और अपस्ट्रीम टाइमआउट के सुचारू संचालन का सत्यापन करें।
OpenAI: मल्टीमॉडल सहायकों के लिए सर्वश्रेष्ठ
OpenAI एक व्यापक मल्टीमॉडल मॉडल पारिस्थितिकी तंत्र के साथ भाषण क्षमताओं को एकीकृत करता.
OpenAI तब समझ में आता है जब भाषण एक ऐसे एप्लिकेशन के भीतर एक आउटपुट मोड होता है जो पहले से ही तर्क (रीजनिंग), टूल कॉल या संवाद जनरेशन के लिए इसके मॉडल का उपयोग कर रहा है। कम एकीकरण सीमाएं संदर्भ प्रबंधन और प्रोटोटाइप को सरल बनाती हैं। निर्देश-जागरूक डिलीवरी उन परिदृश्यों का भी समर्थन करती है जहां एप्लिकेशन तुरंत टोन या बोलने की शैली निर्दिष्ट करता है।
वह सुविधा लागत और प्रदर्शन विशेषता को जटिल बनाती है। टीमों को भाषा-मॉडल जनरेशन समय को संश्लेषण समय से अलग करना चाहिए, ऑडियो और टोकन शुल्कों को स्वतंत्र रूप से ट्रैक करना चाहिए, और यह निर्धारित करना चाहिए कि प्रत्यक्ष टीटीएस या रीयल-टाइम स्पीच आर्किटेक्चर इंटरैक्शन पैटर्न के लिए बेहतर अनुकूल है या नहीं। उच्च मात्रा में निश्चित वर्णन के लिए, एक समर्पित सिंथेसाइज़र सरल क्षमता योजना प्रदान करता है। मल्टीमॉडल सहायकों के लिए, एकीकृत वर्कफ़्लो आमतौर पर जीतता है।
Cartesia: उत्तरदायी संवादात्मक भाषण के लिए सर्वश्रेष्ठ
Cartesia रीयल-टाइम जनरेटिव वॉयस इंफ्रास्ट्रक्चर पर ध्यान केंद्रित करता है।
Cartesia एजेंटों, इंटरैक्टिव पात्रों और सहायकों के लिए मूल्यांकन करने योग्य है जहां त्वरित पहला ऑडियो और प्राकृतिक बारी-बारी से बोलना महत्वपूर्ण आवश्यकताएं हैं। कोवल के मई 2026 बेंचमार्क में इसका 188 ms P50 TTFA का Sonic-3 परिणाम एक सत्यापन योग्य बाहरी विलंबता संकेत है, हालांकि यह हर क्षेत्र से या उत्पादन समवर्तीता के तहत प्रदर्शन की भविष्यवाणी नहीं करता है।
इंजीनियरिंग मूल्यांकन चंक नियमितता, रुकावट की गति, उच्चारण नियंत्रण और बार-बार छोटे मोड़ों पर आवाज की निरंतरता पर केंद्रित होना चाहिए। पसंदीदा आवाज या क्षेत्र अनुपलब्ध होने पर फ़ॉलबैक व्यवहार की समीक्षा करें। कार्टेसिया रीयल-टाइम उपयोग के मामले में Smallest.ai के साथ कड़ी प्रतिस्पर्धा करता है, जबकि इस समूह में ElevenLabs अधिक नरेशन-उन्मुख तुलना बना हुआ है।
डेमो रैंकिंग की तुलना में उत्पादन तत्परता अधिक मायने रखती है
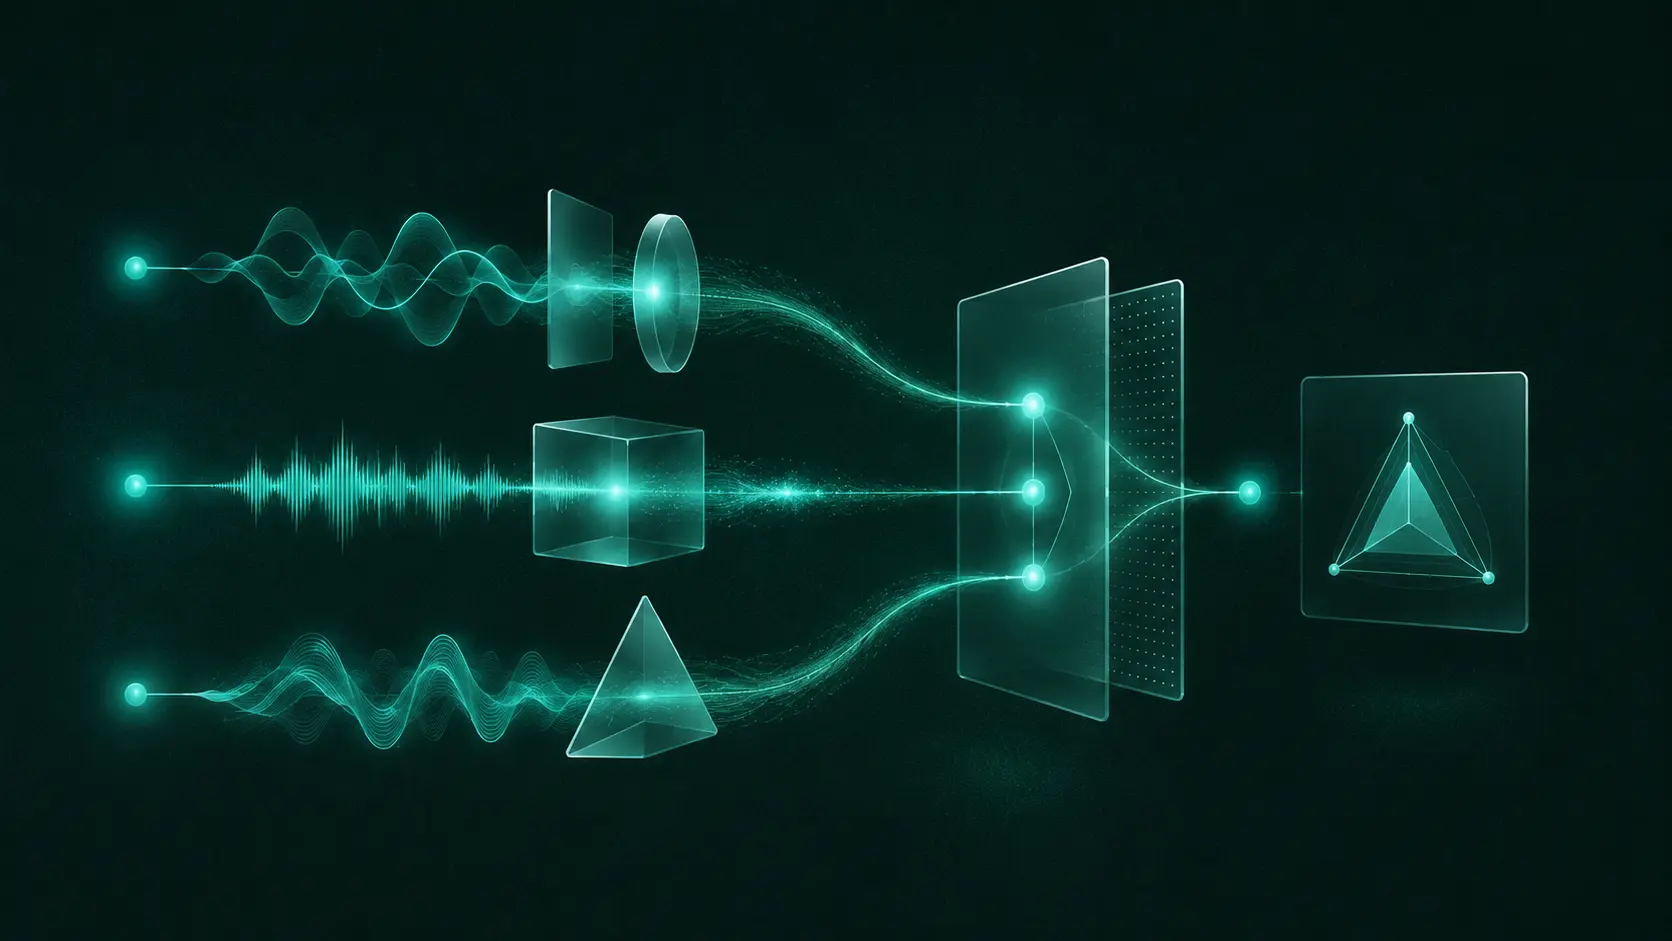
टीटीएस मॉडल विलंबता और विश्वसनीयता श्रृंखला का एक घटक है।
उत्पादन के लिए तैयार टीटीएस सेवा को सिर्फ एक अच्छी आवाज से अधिक की आवश्यकता होती है। संश्लेषण से पहले तिथियों, मुद्राओं, संक्षिप्त रूपों और पहचानकर्ताओं को सामान्य करें। कनेक्शन गर्म रखें, समझदार सीमाओं पर वाक्य के टुकड़ों को स्ट्रीम करें, और ध्यान देने योग्य देरी को जोड़े बिना नेटवर्क जिटर को अवशोषित करने के लिए पर्याप्त ऑडियो बफर करें। प्रदाता अनुरोध आईडी और समय अवधि को कैप्चर करें ताकि ऑपरेटर नेटवर्क, ऑर्केस्ट्रेशन या टेलीफोनी विलंब से मॉडल विलंबता में अंतर कर सकें।
कोकोरो (Kokoro) जैसे स्व-होस्ट किए गए मॉडलों के लिए, तुलना में GPU उपयोग, कोल्ड स्टार्ट, बैचिंग, ऑटोस्केलिंग, मॉडल लाइसेंसिंग, सुरक्षा पैचिंग और ऑन-कॉल स्वामित्व शामिल करें। होस्ट की गई एपीआई उस बोझ को काफी हद तक स्थानांतरित कर देती हैं लेकिन विक्रेता कोटा और नेटवर्क निर्भरता पेश करती हैं। मुफ़्त न्यूरल टीटीएस बनाम उत्पादन एपीआई का विश्लेषण एक उपयोगी परिनियोजन चेकलिस्ट प्रदान करता है।
मांग तेजी से बढ़ रही है। उद्योग अनुसंधान ग्राहक सहायता, पहुंच (एक्सेसिबिलिटी), सामग्री निर्माण और आवाज अनुप्रयोगों में अपनाने के विस्तार के साथ टेक्स्ट-टू-स्पीच बाजार में निरंतर वृद्धि का संकेत देता है।
2026 में सर्वश्रेष्ठ टीटीएस मॉडल पर निर्णय
उपयोग-मामले की सिफारिशें:
कम विलंबता वाले एजेंटों, सहायता स्वचालन और मॉड्यूलर रीयल-टाइम स्पीच स्टैक के लिए Smallest.ai Lightning चुनें।
अभिव्यंजक वर्णन, स्थानीयकरण और आवाज-गहन सामग्री वर्कफ़्लो के लिए ElevenLabs चुनें।
जब पहचान और संश्लेषण को समेकित करने से परिचालन ओवरहेड कम होता है, तब Deepgram चुनें।
उन मल्टीमॉडल उत्पादों के लिए OpenAI चुनें जहां भाषण, तर्क और उपकरण संदर्भ साझा करते हैं।
उन स्ट्रीमिंग संवादात्मक अनुभवों के लिए Cartesia चुनें जहां बेंचमार्क की गई प्रतिक्रिया एक प्रमुख मानदंड है।
जब डेटा नियंत्रण, ऑफ़लाइन संचालन, या बहुत अधिक स्थिर उपयोग बुनियादी ढांचे के स्वामित्व को सही ठहराता है, तब स्व-होस्टेड टीटीएस पर विचार करें।
वार्षिक अनुबंध पर हस्ताक्षर करने से पहले, वास्तविक संकेतों, लहजे (एक्सेंट), कोडेक्स और नेटवर्क पथों के साथ एक ब्लाइंड लिसनिंग टेस्ट और एक उत्पादन-आकार का लोड टेस्ट चलाएं। सर्वश्रेष्ठ एआई वॉयस मॉडल वे हैं जो एप्लिकेशन की विलंबता, विश्वसनीयता, अधिकारों और इकाई-अर्थशास्त्र के दायरे में रहते हुए अवधारणात्मक लक्ष्यों को प्राप्त करते हैं।
अक्सर पूछे जाने वाले प्रश्न
रीयल-टाइम वॉयस एजेंट के लिए सबसे अच्छा टीटीएस (TTS) मॉडल कौन सा है?
टीमों को टीटीएस (TTS) लेटेंसी को कैसे मापना चाहिए?
क्या ओपन-सोर्स टीटीएस (TTS) मॉडल होस्ट किए गए एपीआई (APIs) से सस्ते हैं?
कहानियों और विवरण (नरेशन) के लिए कौन सा मॉडल सबसे अच्छा है?
क्या एक ही प्रदाता को STT और TTS दोनों को संभालना चाहिए?