मानव जैसी आवाज़ वाली टेक्स्ट-टू-स्पीच: 2026 में गुणवत्ता, लेटेंसी और प्रदाता चयन
जानें कि 2026 में क्या चीज़ मानव आवाज़ वाली टेक्स्ट-टू-स्पीच को वास्तव में यथार्थवादी बनाती है। सर्वश्रेष्ठ AI आवाज़ खोजने के लिए न्यूरल TTS गुणवत्ता, विलंबता (लेटेंसी) और भावना नियंत्रण की तुलना करें।
मानव जैसी टेक्स्ट-टू-स्पीच तकनीक उस मुकाम पर पहुंच गई है जहां सुनने वालों के लिए कृत्रिम आवाजों को असली इंसानी आवाज से अलग करना मुश्किल हो सकता है, 2025 के एक अध्ययन में पाया गया है कि एआई वॉयस क्लोन ने सुनने वालों को मूर्ख बना दिया जिसकी दर असली इंसानी आवाजों के काफी करीब थी। नवीनतम एआई वॉयसओवर सिस्टम अब हंसी, आहें और प्राकृतिक ठहराव जैसी सूक्ष्म बारीकियों को पकड़ लेते हैं, जिससे संश्लेषित आवाज असली इंसानी रिकॉर्डिंग से लगभग पूरी तरह से अलग नहीं की जा सकती।
वॉयस एजेंटों, एक्सेसिबिलिटी टूल्स और एआई-संचालित कंटेंट निर्माण के तेजी से विस्तार के कारण वैश्विक टेक्स्ट-टू-स्पीच बाजार में निरंतर वृद्धि देखी गई है।
यह लेख उन डेवलपर्स, उत्पाद टीमों और वॉयस एआई प्रैक्टिशनर्स के लिए है जो यह समझना चाहते हैं कि वास्तव में यथार्थवादी एआई आवाजों को अतीत के रोबोटिक जैसी आवाजों वाले सिस्टम से क्या अलग करता है। अंत तक, आपको पता चल जाएगा कि कौन से तकनीकी कारक स्वाभाविकता को संचालित करते हैं, आवाज की गुणवत्ता का निष्पक्ष मूल्यांकन कैसे किया जाए, और Smallest.ai इस परिदृश्य में कहां फिट बैठता है।
एक आवाज को इंसानी जैसी क्या चीज बनाती है
अधिकांश लोग यह मान लेते हैं कि एक यथार्थवादी एआई आवाज केवल 'बेहतर ऑडियो गुणवत्ता' का मामला है। यह गलत नजरिया है। ऑडियो फिडेलिटी बुनियादी आवश्यकता है। वास्तविक अंतर प्रसादी (लहजा), भावनात्मक रेंज और प्रासंगिक अनुकूलन क्षमता हैं।
प्रसादी (prosody) से तात्पर्य लय, तनाव और स्वर-शैली के पैटर्न से है जो स्वयं शब्दों से परे अर्थ व्यक्त करते हैं। 'सच में?' जैसा वाक्य पूरी तरह से प्रसादी आकार के आधार पर अविश्वास, जिज्ञासा या व्यंग्य व्यक्त कर सकता है। शुरुआती कॉनकैटेनेटिव टीटीएस सिस्टम, जो पहले से रिकॉर्ड किए गए फोनेम खंडों को आपस में जोड़ते थे, इसे कभी भी अच्छी तरह से नहीं संभाल पाते थे क्योंकि उनमें संचारी मंशा के किसी मॉडल की कमी थी। इसके विपरीत, आधुनिक न्यूरल टीटीएस सिस्टम को हजारों घंटों के मानव भाषण पर प्रशिक्षित किया जाता है और वे इन पैटर्नों को सांख्यिकीय रूप से मॉडल करना सीखते हैं। इसका परिणाम ऐसा आउटपुट होता है जिसमें प्राकृतिक तनाव, उपयुक्त ठहराव और यहां तक कि वक्ता-विशिष्ट विशेषताएं भी शामिल होती हैं।
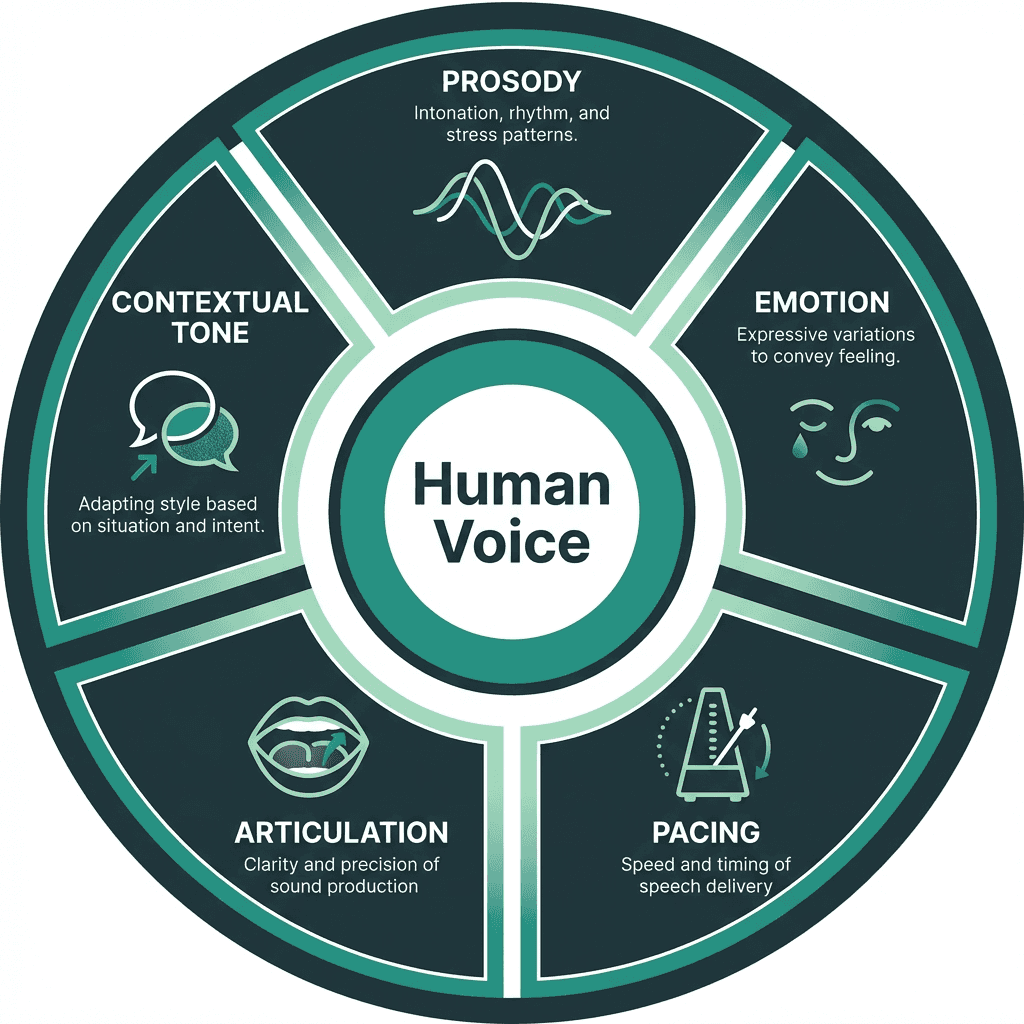
पांच आयाम जो यथार्थवादी एआई आवाजों को रोबोटिक जैसी आवाज के संश्लेषण से अलग करते हैं
यथार्थवादी आवाज संश्लेषण के पीछे का टेक्नोलॉजी स्टैक
न्यूरल टीटीएस आर्किटेक्चर कई पीढ़ियों के माध्यम से विकसित हुए हैं, और यह प्रगति महत्वपूर्ण है क्योंकि प्रत्येक पीढ़ी ने अपने पूर्ववर्ती की एक विशिष्ट विफलता मोड को संबोधित किया है।
पीढ़ी | आर्किटेक्चर प्रकार | मुख्य ताकत | मुख्य सीमा |
|---|---|---|---|
पहली पीढ़ी | कॉनकैटेनेटिव / नियम-आधारित | अनुमानित आउटपुट | रोबोटिक, कोई प्रसादी नियंत्रण नहीं |
दूसरी पीढ़ी | एचएमएम-आधारित सांख्यिकीय | अधिक सहज संक्रमण | सपाट प्रभाव, सीमित अभिव्यक्ति |
तीसरी पीढ़ी | न्यूरल (टैकोट्रॉन, फास्टस्पीच) | प्राकृतिक प्रसादी, वक्ता क्लोनिंग | उच्च कंप्यूट, विलंबता (लैटेंसी) संबंधी समस्याएं |
चौथी पीढ़ी | डिफ्यूजन / फ्लो-आधारित न्यूरल | अल्ट्रा-लो लेटेंसी, भावनात्मक रेंज | एज परिनियोजन के लिए अभी भी परिपक्व हो रहा है |
वर्तमान अत्याधुनिक प्रणालियां एक टेक्स्ट एनकोडर, एक प्रसादी प्रेडिक्टर और एक न्यूरल वोकोडर को जोड़ती हैं। वोकोडर वह जगह है जहां अधिकांश अवधारणात्मक गुणवत्ता हासिल या खोई जाती है। वेवनेट-शैली के वोकोडर असाधारण ऑडियो उत्पन्न करते हैं लेकिन वे कम्प्यूटेशनल रूप से महंगे होते हैं। हाल के फ्लो-आधारित और डिफ्यूजन वोकोडर इन्फरेंस लागत के एक अंश पर तुलनीय गुणवत्ता प्राप्त करते हैं, जो वॉयस एजेंटों जैसे वास्तविक समय के अनुप्रयोगों के लिए महत्वपूर्ण है। यदि आप वॉयस-सक्षम उत्पाद बना रहे हैं, तो मानव जैसी एआई आवाजों और भावनात्मक मॉडलिंग परत को समझना उतना ही महत्वपूर्ण है जितना कि वोकोडर को समझना।
आवाज की गुणवत्ता का मूल्यांकन: संख्याएं वास्तव में आपको क्या बताती हैं
संश्लेषित भाषण के लिए मानक बेंचमार्क एमओएस (मीन ओपिनियन स्कोर) है, जो मानव श्रोता के निर्णयों के आधार पर 1-5 पैमाने पर आउटपुट को रेट करता है। 4.0 से ऊपर के स्कोर को आम तौर पर 'प्राकृतिक-ध्वनि' माना जाता है, और शीर्ष न्यूरल टीटीएस सिस्टम अब नियमित रूप से मानक परीक्षण सेटों पर 4.2 से 4.5 के एमओएस स्कोर प्राप्त करते हैं। लेकिन एमओएस की एक ज्ञात कमजोरी है: यह एक पैनल में औसत धारणा को मापता है, न कि कठिन मामलों (edge cases) पर प्रदर्शन को। एक सिस्टम साफ, वर्णनात्मक वाक्यों पर 4.3 स्कोर कर सकता है और तकनीकी शब्दजाल, प्रश्नों या भावनात्मक रूप से आवेशित पाठ पर गिरकर 3.1 पर आ सकता है। एमओएस को एक शुरुआती बिंदु के रूप में मानें, अंतिम निर्णय नहीं।
ज्यादातर मूल्यांकन लोड के तहत होने वाली विलंबता (लैटेंसी) को नजरअंदाज कर देते हैं। हजारों समवर्ती सत्रों को संभालने वाले वॉयस एजेंट के लिए, प्रति वाक्य 800ms में सुंदर ऑडियो उत्पन्न करने वाला मॉडल वास्तविक समय के अनुप्रयोगों के लिए अव्यावहारिक हो सकता है। रियल-टाइम फैक्टर (RTF) यह मापता है कि कोई सिस्टम उस ऑडियो की अवधि के सापेक्ष कितनी तेजी से ऑडियो उत्पन्न करता है। 1.0 से नीचे का आरटीएफ का मतलब है कि सिस्टम भाषण को उसके बजने की तुलना में तेजी से उत्पन्न करता है, जो इंटरैक्टिव अनुप्रयोगों के लिए न्यूनतम पैमाना है।
उपयोग के मामले जहां वास्तविकता से समझौता नहीं किया जा सकता
हर एप्लिकेशन को उच्चतम संभव आवाज गुणवत्ता की आवश्यकता नहीं होती है। पुष्टिकरण संख्या को पढ़ने वाला एक साधारण आईवीआर सिस्टम ठीक-ठाक लेकिन साधारण संश्लेषण के साथ काम चला सकता है। हालांकि, अनुप्रयोगों की एक बढ़ती हुई श्रेणी है जहां आवाज की वास्तविकता सीधे उत्पाद की सफलता से जुड़ी हुई है। वॉयस एआई प्रयोगात्मक से प्रोडक्शन-क्रिटिकल चरण में आ गया है, जिसमें ग्राहक सहायता, एक्सेसिबिलिटी और कंटेंट वर्कफ़्लो में डेवलपर्स द्वारा इसे अपनाने की गति तेज हो रही है।
ऐसे अनुप्रयोग जहां मानव-स्तर की आवाज की गुणवत्ता मापने योग्य परिणाम देती है:
ग्राहक सहायता के लिए संवादात्मक वॉयस एजेंट: जब आवाज रोबोटिक लगती है तो उपयोगकर्ता कॉल छोड़ देते हैं। स्वाभाविकता सीधे स्वचालित सहायता प्रवाह में ग्राहक पलायन को कम करती है।
एआई साथी और मानसिक कल्याण ऐप्स: भावनात्मक प्रामाणिकता ही मुख्य उत्पाद है। एक सपाट, बेअसर आवाज पूरे मूल्य प्रस्ताव को कमजोर कर देती है।
ई-लर्निंग और ऑडियोबुक वाचन: कृत्रिम लगने वाले ऑडियो से श्रोता को तेजी से थकान होती है, जिससे काम पूरा होने की दर कम हो जाती है।
वास्तविक समय में भाषा डबिंग: प्रसादी को न केवल शब्दों, बल्कि स्रोत सामग्री के भावनात्मक स्तर से मेल खाना चाहिए।
पढ़ने में कठिनाई वाले उपयोगकर्ताओं के लिए एक्सेसिबिलिटी टूल्स: स्वाभाविकता दैनिक रूप से टीटीएस पर निर्भर रहने वाले उपयोगकर्ताओं के लिए समझ और जुड़ाव को बेहतर बनाती है।
इन प्रणालियों का निर्माण करने वाली टीमों के लिए, टीटीएस से जुड़े आर्किटेक्चरल निर्णयों को एआई वॉयस एजेंट आर्किटेक्चर, वॉयस मॉडल, उपयोग के मामले और सुरक्षा गार्डरेल्स पर गाइड में विस्तार से शामिल किया गया है।
ह्यूमन वॉयस टीटीएस प्रदाता का चयन कैसे करें
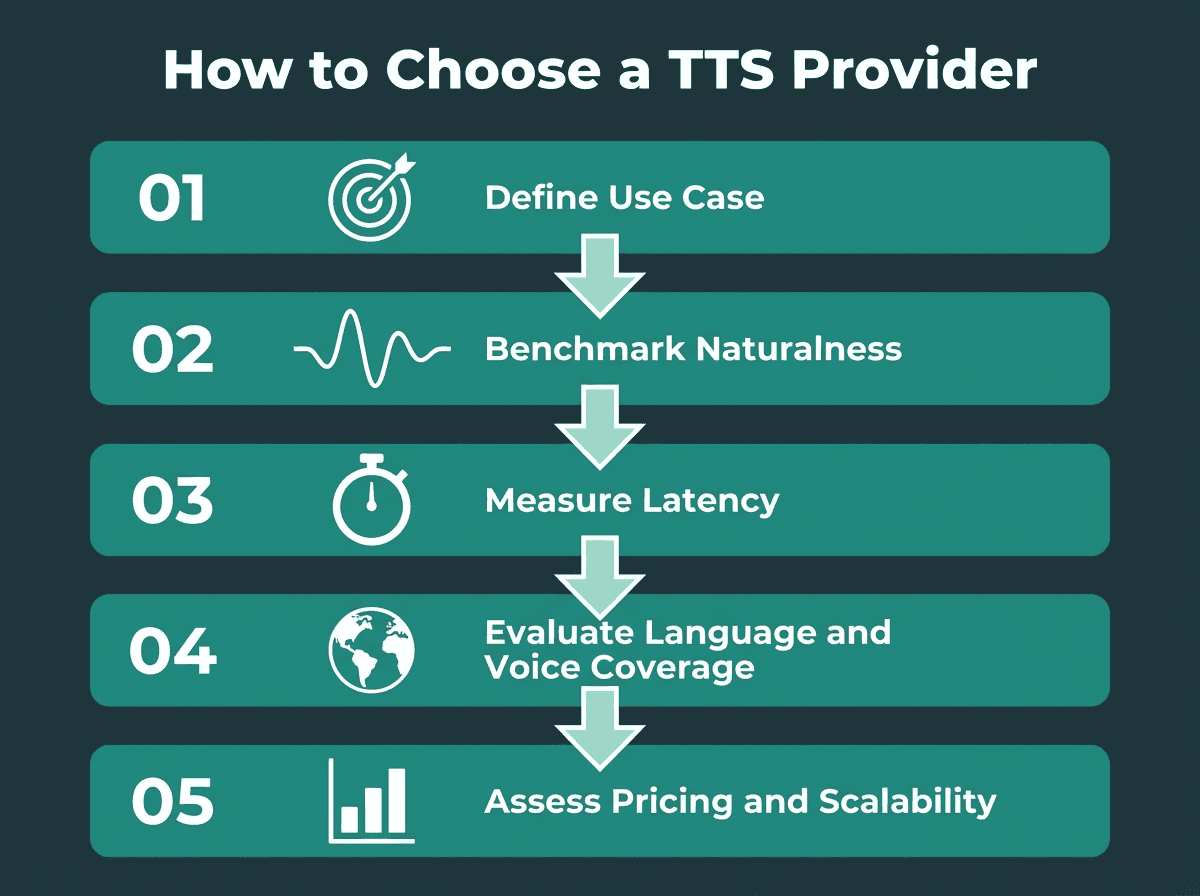
एक यथार्थवादी टीटीएस प्रदाता के मूल्यांकन और चयन के लिए पांच-चरणीय ढांचा
चयन मानदंड काफी हद तक आपके परिनियोजन (डिप्लॉयमेंट) संदर्भ पर निर्भर करते हैं। पायथन-आधारित वाचन पाइपलाइन बनाने वाले डेवलपर की आवश्यकताएं बड़े पैमाने पर वास्तविक समय के वॉयस एजेंट को तैनात करने वाली उत्पाद टीम से भिन्न होती हैं। नीचे दिया गया ढांचा दोनों परिदृश्यों पर लागू होता है, हालांकि प्रत्येक मानदंड को आपके द्वारा दिया जाने वाला महत्व काफी भिन्न होगा।
मानदंड | यह क्यों महत्वपूर्ण है | क्या परीक्षण करें |
|---|---|---|
आवाज की स्वाभाविकता | उपयोगकर्ता के विश्वास और जुड़ाव को सीधे प्रभावित करता है | एमओएस स्कोर, आपकी सामग्री के प्रकार पर ब्लाइंड लिसनिंग परीक्षण |
विलंबता (RTF) | वास्तविक समय और इंटरैक्टिव अनुप्रयोगों के लिए महत्वपूर्ण | समवर्ती लोड के तहत पहले ऑडियो-बाइट तक का समय |
भावनात्मक रेंज | एजेंटों, साथियों और कथा सामग्री के लिए आवश्यक | प्रश्नों, विस्मयादिबोधकों और भावनात्मक संकेतों के साथ परीक्षण करें |
भाषा और उच्चारण कवरेज | वैश्विक उत्पादों को बहु-भाषा निष्ठा की आवश्यकता होती है | मूल वक्ता मूल्यांकन, न कि केवल स्वचालित मेट्रिक्स |
एपीआई डिजाइन और एसडीके गुणवत्ता | डेवलपर की गति और एकीकरण लागत को प्रभावित करता है | दस्तावेज़ीकरण गुणवत्ता, एसडीके उपलब्धता, त्रुटि प्रबंधन |
मूल्य निर्धारण मॉडल | स्केलेबिलिटी की अर्थशास्त्र को निर्धारित करता है | प्रति-अक्षर बनाम प्रति-सेकंड बनाम फ्लैट दर; वॉल्यूम टियर |
एक मानदंड जो तुलनात्मक गाइडों में शायद ही कभी दिखाई देता है लेकिन व्यवहार में बहुत मायने रखता है: सिस्टम डोमेन-विशिष्ट शब्दावली को कैसे संभालता है? चिकित्सा, कानूनी और तकनीकी सामग्री ऐसे शब्दों से भरी होती है जिनका सामान्य-उद्देश्य वाले टीटीएस मॉडल गलत उच्चारण करते हैं। कुछ प्रदाता कस्टम उच्चारण शब्दकोशों या फोनेम-स्तरीय ओवरराइड की अनुमति देते हैं। यदि आपके उपयोग के मामले में विशिष्ट शब्दावली शामिल है, तो प्रदाता का चयन करने से पहले इसका स्पष्ट रूप से परीक्षण करें। कार्यान्वयन मार्गदर्शन की तलाश कर रहे डेवलपर्स पायथन में यथार्थवादी टेक्स्ट-टू-स्पीच का निर्माण से शुरुआत कर सकते हैं ताकि यह समझ सकें कि एपीआई विकल्प प्रोडक्शन कोड में कैसे परिवर्तित होते हैं।
उन्नत विचार: वॉयस क्लोनिंग, इमोशन कंट्रोल और बहुभाषी निष्ठा
वॉयस क्लोनिंग काफी परिपक्व हो चुकी है। जहां शुरुआती प्रणालियों को एक कामचलाऊ क्लोन बनाने के लिए घंटों के संदर्भ ऑडियो की आवश्यकता होती थी, वहीं वर्तमान दृष्टिकोण केवल कुछ सेकंड के ऑडियो से एक सुसंगत वक्ता पहचान उत्पन्न कर सकते हैं। हालांकि, गुणवत्ता की सीमा अभी भी संदर्भ रिकॉर्डिंग द्वारा निर्धारित होती है। एक शोरयुक्त, संपीड़ित (कंप्रेस्ड) संदर्भ एक शोरयुक्त, संपीड़ित क्लोन ही उत्पन्न करेगा, चाहे अंतर्निहित मॉडल कितना भी परिष्कृत क्यों न हो।
इमोशन कंट्रोल वह जगह है जहां इस समय सबसे दिलचस्प काम हो रहा है। कुछ प्रणालियां स्पष्ट भावना टैग (खुश, उदास, गुस्सा) प्रदर्शित करती हैं जो इन्फरेंस के समय प्रसादी को संशोधित करती हैं। अधिक परिष्कृत दृष्टिकोण भावनात्मक तीव्रता पर निरंतर नियंत्रण की अनुमति देते हैं, जिससे आप तटस्थ और 'बहुत उत्साहित' के बीच टॉगल करने के बजाय 'थोड़ा उत्साही' का चयन कर सकते हैं। यह विशेष रूप से ई-लर्निंग के लिए मायने रखता है, जहां एक कथावाचक को व्यस्त दिखना चाहिए लेकिन दिखावटी नहीं। मानव जैसी एआई आवाजों पर गाइड भावना-जागरूक संश्लेषण के पीछे के तकनीकी तंत्र को गहराई से कवर करता है।
विपणन सामग्री में बहुभाषी निष्ठा को अक्सर बढ़ा-चढ़ाकर पेश किया जाता है। 30 भाषाओं का समर्थन करने वाला सिस्टम जरूरी नहीं कि उन सभी में समान रूप से प्राकृतिक आउटपुट दे। अंग्रेजी और मंदारिन 4.3 एमओएस स्कोर कर सकते हैं जबकि कम संसाधनों वाली भाषा 3.4 स्कोर कर सकती है। वैश्विक परिनियोजन के लिए, हेडलाइन भाषा गणनाओं पर भरोसा करने के बजाय हमेशा अपनी विशिष्ट लक्षित भाषाओं पर मूल वक्ताओं द्वारा मूल्यांकन करवाएं। बहुभाषी गुणवत्ता में सुधार करने के लिए प्रतिस्पर्धी दबाव तेज होगा क्योंकि एआई वॉयस जनरेशन उद्योगों में एक मुख्य बुनियादी ढांचा परत बन जाएगी।
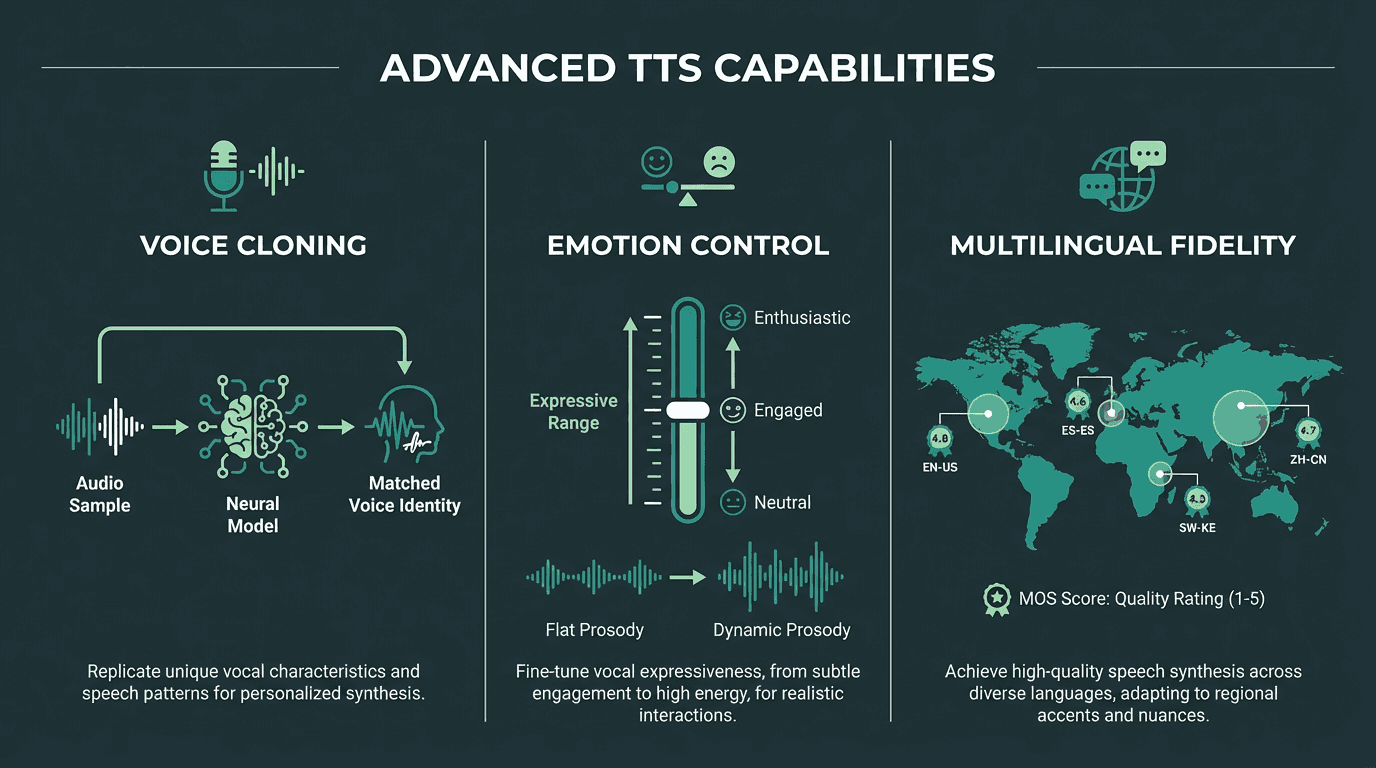
आधुनिक मानव आवाज टीटीएस के तीन उन्नत आयाम: क्लोनिंग, इमोशन कंट्रोल और बहुभाषी निष्ठा
Smallest.ai: प्रोडक्शन-ग्रेड वॉयस रियलिज्म के लिए निर्मित
Smallest.ai का निर्माण एक विशिष्ट विश्वास के इर्द-गिर्द किया गया था: 'प्रभावशाली डेमो' और 'उत्पादन के लिए तैयार वॉयस एआई' के बीच का अंतर मुख्य रूप से विलंबता और निरंतरता की समस्या है, न कि गुणवत्ता की समस्या। हालांकि कई प्लेटफॉर्म अब उच्च गुणवत्ता वाले न्यूरल टीटीएस की पेशकश करते हैं, वास्तविक समय की बाधाओं के तहत प्रदर्शन और बड़े पैमाने पर निरंतरता प्रमुख विभेदक बने हुए हैं। अधिकांश प्रणालियां नियंत्रित वातावरण में सुंदर ऑडियो उत्पन्न कर सकती हैं। विभिन्न प्रकार की सामग्रियों में, वास्तविक समय में, बड़े पैमाने पर इसे विश्वसनीय रूप से करने में बहुत कम सक्षम हैं।
Smallest.ai का लाइटनिंग स्पीच मॉडल उन प्रसादी समृद्धि का त्याग किए बिना अल्ट्रा-लो लेटेंसी संश्लेषण प्रदान करने के लिए डिज़ाइन किया गया है जो आवाजों को इंसानी जैसी बनाती हैं। वॉयस एजेंट बनाने वाली टीमों के लिए, कम आरटीएफ और उच्च स्वाभाविकता का संयोजन प्रतिक्रियाशीलता और गुणवत्ता के बीच सामान्य समझौते को कम करता है। बड़े पैमाने पर लागत का मूल्यांकन करने वाली टीमें यह समझने के लिए Smallest.ai मूल्य निर्धारण की समीक्षा कर सकती हैं कि मॉडल विभिन्न उपयोग मात्राओं में कैसे फिट बैठता है, और जो लोग प्रतिबद्ध होने से पहले प्रयोग करना चाहते हैं वे मुफ़्त एआई वॉयस जनरेटर संसाधन को एक व्यावहारिक शुरुआती बिंदु पाएंगे।
यह प्लेटफ़ॉर्म उन डेवलपर्स के लिए बनाया गया है जिन्हें प्रोडक्शन वॉयस उत्पादों को शिप करने के लिए गुणवत्ता मानदंड और परिचालन विश्वसनीयता दोनों की आवश्यकता होती है, जो विलंबता, स्वाभाविकता और मूल्य निर्धारण स्केलेबिलिटी की मुख्य चुनौतियों पर ध्यान केंद्रित करता है।
वॉयस एआई उत्पाद बनाने वाली अधिकांश टीमों के लिए मुख्य चुनौती एक ऐसा सिस्टम खोजना है जो उपयोगकर्ताओं की अपेक्षा के अनुरूप अवधारणात्मक गुणवत्ता और प्रोडक्शन की मांग के अनुसार परिचालन प्रदर्शन दोनों प्रदान करे। डेमो-गुणवत्ता वाला ऑडियो जो लोड के तहत खराब हो जाता है, या तेज संश्लेषण जो रोबोटिक लगता है, दोनों ही विफलता मोड हैं जो उपयोगकर्ता के विश्वास को कमजोर करते हैं। Smallest.ai का लाइटनिंग मॉडल उस अंतर को पाटने के लिए बनाया गया था, जो न्यूरल वॉयस क्वालिटी को कम-विलंबता वाले आर्किटेक्चर के साथ जोड़ता है जिसकी वास्तविक समय के वॉयस अनुप्रयोगों को आवश्यकता होती है। यदि आप एक वॉयस एजेंट, एक वाचन पाइपलाइन, या कोई ऐसा उत्पाद बना रहे हैं जहाँ मानव आवाज टेक्स्ट टू स्पीच गुणवत्ता उपयोगकर्ता अनुभव के केंद्र में है, तो Smallest.ai शुरुआत करने के लिए तार्किक स्थान है।
मुख्य बातें
उत्पादन के लिए तैयार टीटीएस को अन्य सभी चीज़ों से क्या अलग करता है:
टीटीएस में यथार्थवाद प्रसादी, भावनात्मक रेंज और प्रासंगिक अनुकूलन क्षमता द्वारा संचालित होता है, न कि केवल ऑडियो फिडेलिटी द्वारा।
न्यूरल आर्किटेक्चर ने काफी हद तक गुणवत्ता की समस्या को हल कर दिया है। लोड के तहत विलंबता और निरंतरता अब उत्पादन के अंतर को तय करती हैं।
एमओएस स्कोर उपयोगी हैं लेकिन अपूर्ण हैं। हमेशा अपनी विशिष्ट सामग्री प्रकार पर परीक्षण करें और वास्तविक समवर्ती लोड के तहत आरटीएफ को मापें।
वॉयस क्लोनिंग की गुणवत्ता संदर्भ ऑडियो गुणवत्ता द्वारा सीमित होती है। इमोशन कंट्रोल और बहुभाषी निष्ठा के लिए स्पष्ट परीक्षण की आवश्यकता होती है, न कि प्रदाता के दावों की।
प्रदाता का चयन उपयोग के मामले की आवश्यकताओं से संचालित होना चाहिए। वास्तविक समय के वॉयस एजेंटों की सीमाएं वाचन पाइपलाइनों से मौलिक रूप से भिन्न होती हैं।
Smallest.ai का लाइटनिंग मॉडल उस विलंबता-गुणवत्ता समझौते को संबोधित करता है जिसका सामना अधिकांश उत्पादन वॉयस एआई टीमों को करना पड़ता।
अक्सर पूछे जाने वाले प्रश्न
ह्यूमन वॉइस टेक्स्ट-टू-स्पीच क्या है और यह पुराने TTS सिस्टम से कैसे अलग है?
मैं यह कैसे मूल्यांकन करूँ कि कोई टीटीएस (TTS) सिस्टम वास्तव में यथार्थवादी है या नहीं?
क्या एआई वॉयस जनरेटर किसी भी आवाज या लहजे की सटीक नकल कर सकते हैं?
टेक्स्ट-टू-स्पीच और वॉयस एजेंट के बीच क्या अंतर है?
क्या बड़े पैमाने पर रियलिस्टिक एआई वॉयस सिंथेसिस (यथार्थवादी एआई आवाज संश्लेषण) को चलाना महंगा है?