गूगल का मल्टीमोडल एम्बेडिंग मॉडल: एक ही वेक्टर स्पेस में टेक्स्ट, इमेज, वीडियो, ऑडियो और पीडीएफ
गूगल का नया मल्टीमोडल एम्बेडिंग मॉडल टेक्स्ट, इमेज, वीडियो, ऑडियो और पीडीएफ को एक ही वेक्टर स्पेस में एकीकृत करता है - डेवलपर्स और इंजीनियरों को इसी की आवश्यकता है।
यदि आप हाल ही में एम्बेडिंग्स (embeddings) के साथ कुछ भी बना रहे हैं, तो आप इसके दर्द को जानते हैं। टेक्स्ट के लिए एक मॉडल। छवियों (images) के लिए दूसरी पाइपलाइन। ऑडियो को खोजने योग्य बनाने के लिए कुछ अजीब जुगाड़। और अगर कोई आपको पीडीएफ (PDF) भेजता है? तो बस भगवान ही मालिक है।
गूगल ने अभी-अभी एक ही मॉडल के साथ कहा है कि "हम इन सभी चीजों को संभाल लेंगे"।
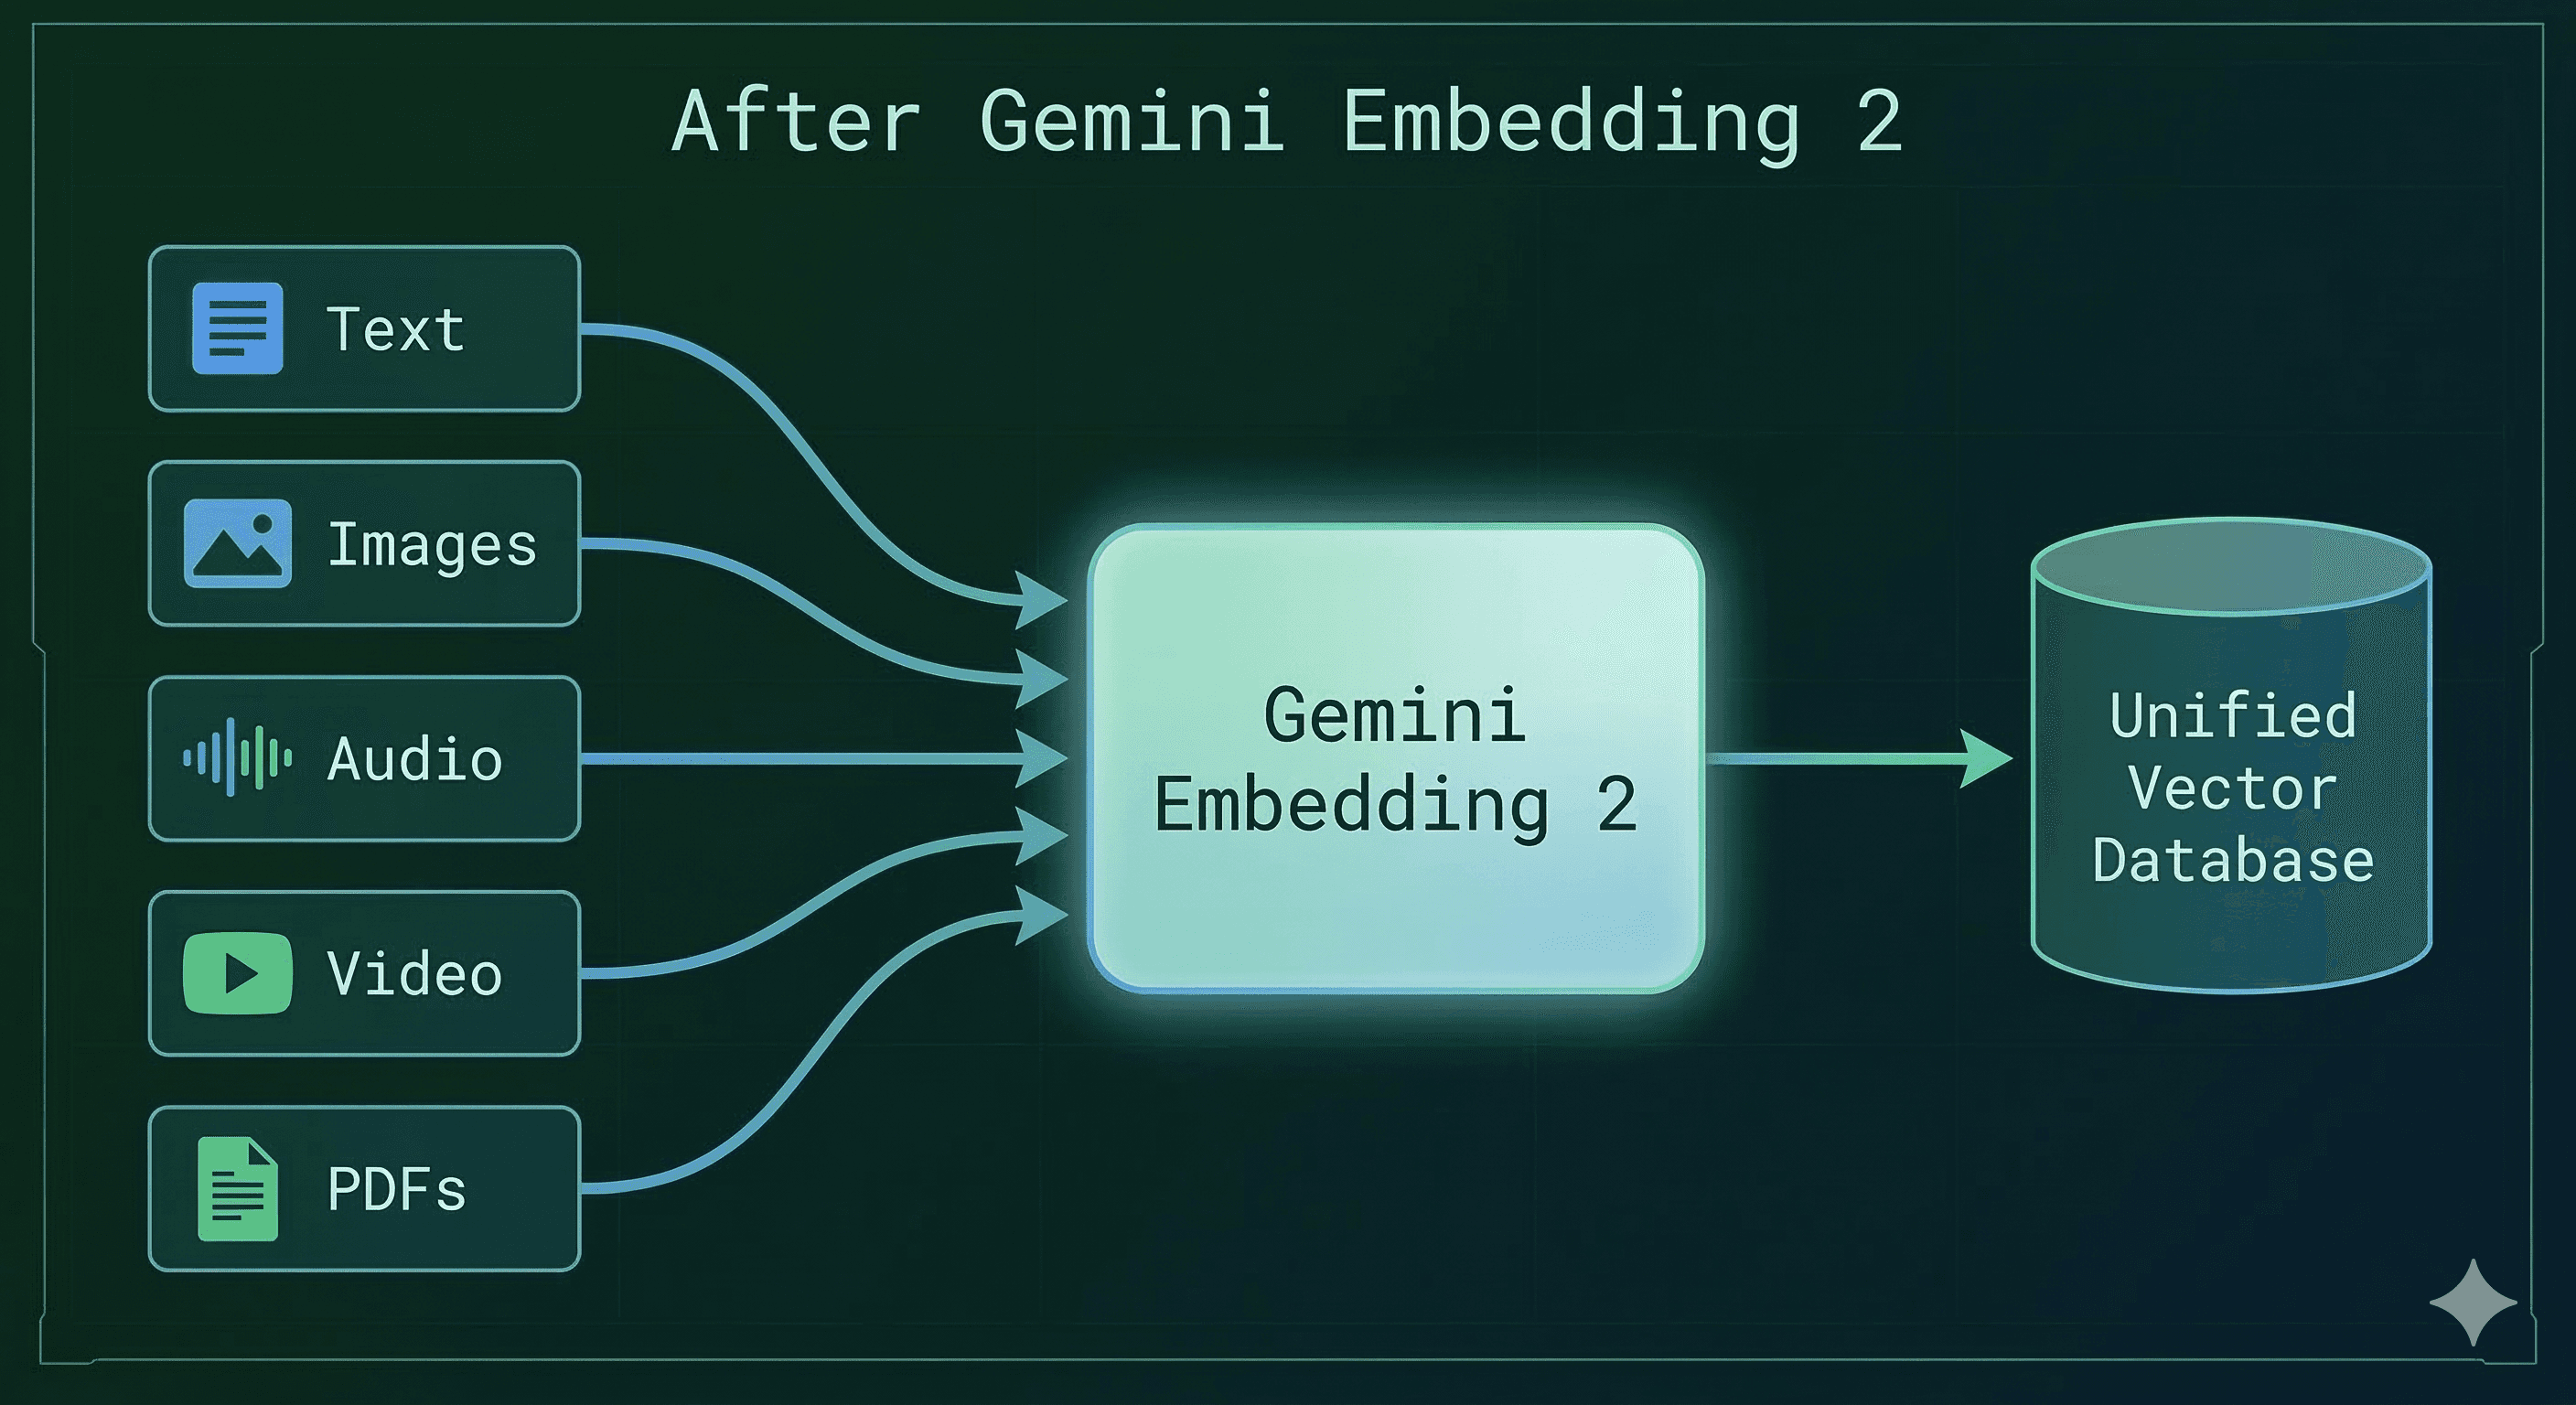
Gemini Embedding 2 को 10 मार्च 2026 को लॉन्च किया गया था, और डेवलपर कम्युनिटी इसके दीवाने हो रहे हैं। यह जेमिनी आर्किटेक्चर पर बनाया गया पहला मूल रूप से (natively) मल्टीमॉडल एम्बेडिंग मॉडल है, और यह टेक्स्ट, इमेज, वीडियो, ऑडियो और दस्तावेज़ों को एक एकीकृत एम्बेडिंग स्पेस में मैप करता है।
एक मॉडल। एक वेक्टर स्पेस। पांच मोडैलिटीज़ (modalities)। जरा इस बात को गहराई से सोचें।
व्यस्त डेवलपर्स के लिए संक्षेप (TL;DR)
मॉडल (Model):
gemini-embedding-2-previewमोडैलिटीज़ (Modalities): टेक्स्ट, इमेजेज (PNG/JPEG), वीडियो (128 सेकंड तक MP4/MOV), ऑडियो (80 सेकंड तक MP3/WAV), पीडीएफ (6 पेजों तक)
डाइमेंशन्स (Dimensions): 128 से 3,072 (मैट्रियोशका रिप्रेजेंटेशन लर्निंग के माध्यम से लचीला)
कॉन्टेक्स्ट विंडो (Context window): 8,192 टोकन
भाषाएं (Languages): 100 से अधिक
MTEB स्कोर: 67.99-68.17 (मल्टीमॉडल संस्करण) | Gemini Embedding 001, MTEB इंग्लिश पर 68.32 के साथ #1 स्थान पर है
इंटीग्रेशन्स (Integrations): LangChain, LlamaIndex, Haystack, Qdrant, Weaviate, ChromaDB, Pinecone, Vector Search
उपलब्धता (Available): Gemini API और Vertex AI के माध्यम से पब्लिक प्रीव्यू
आपको इसकी चिंता क्यों होनी चाहिए?
मुझे एक उदाहरण पेश करने दीजिए।
आप अपनी कंपनी के लिए एक नॉलेज बेस बना रहे हैं। आपका डेटा स्लैक (Slack) संदेशों (टेक्स्ट), प्रोडक्ट स्क्रीनशॉट्स (इमेजेज), ऑनबोर्डिंग वीडियो (वीडियो), कस्टमर सपोर्ट कॉल्स (ऑडियो), और अनुपालन दस्तावेज़ों (पीडीएफ) में बिखरा पड़ा है।
Gemini Embedding 2 से पहले, आपको इनमें से प्रत्येक के लिए एक अलग मॉडल या पाइपलाइन की आवश्यकता होती थी। आप इमेजेज के लिए CLIP, ऑडियो ट्रांसक्रिप्शन के लिए Whisper + ट्रांसक्रिप्ट के लिए टेक्स्ट एम्बेडिंग्स, और अपने टेक्स्ट दस्तावेज़ों के लिए एक और मॉडल को मिलाकर एक अजीब सी जुगाड़ू (Frankenstein) आर्किटेक्चर तैयार करते थे।
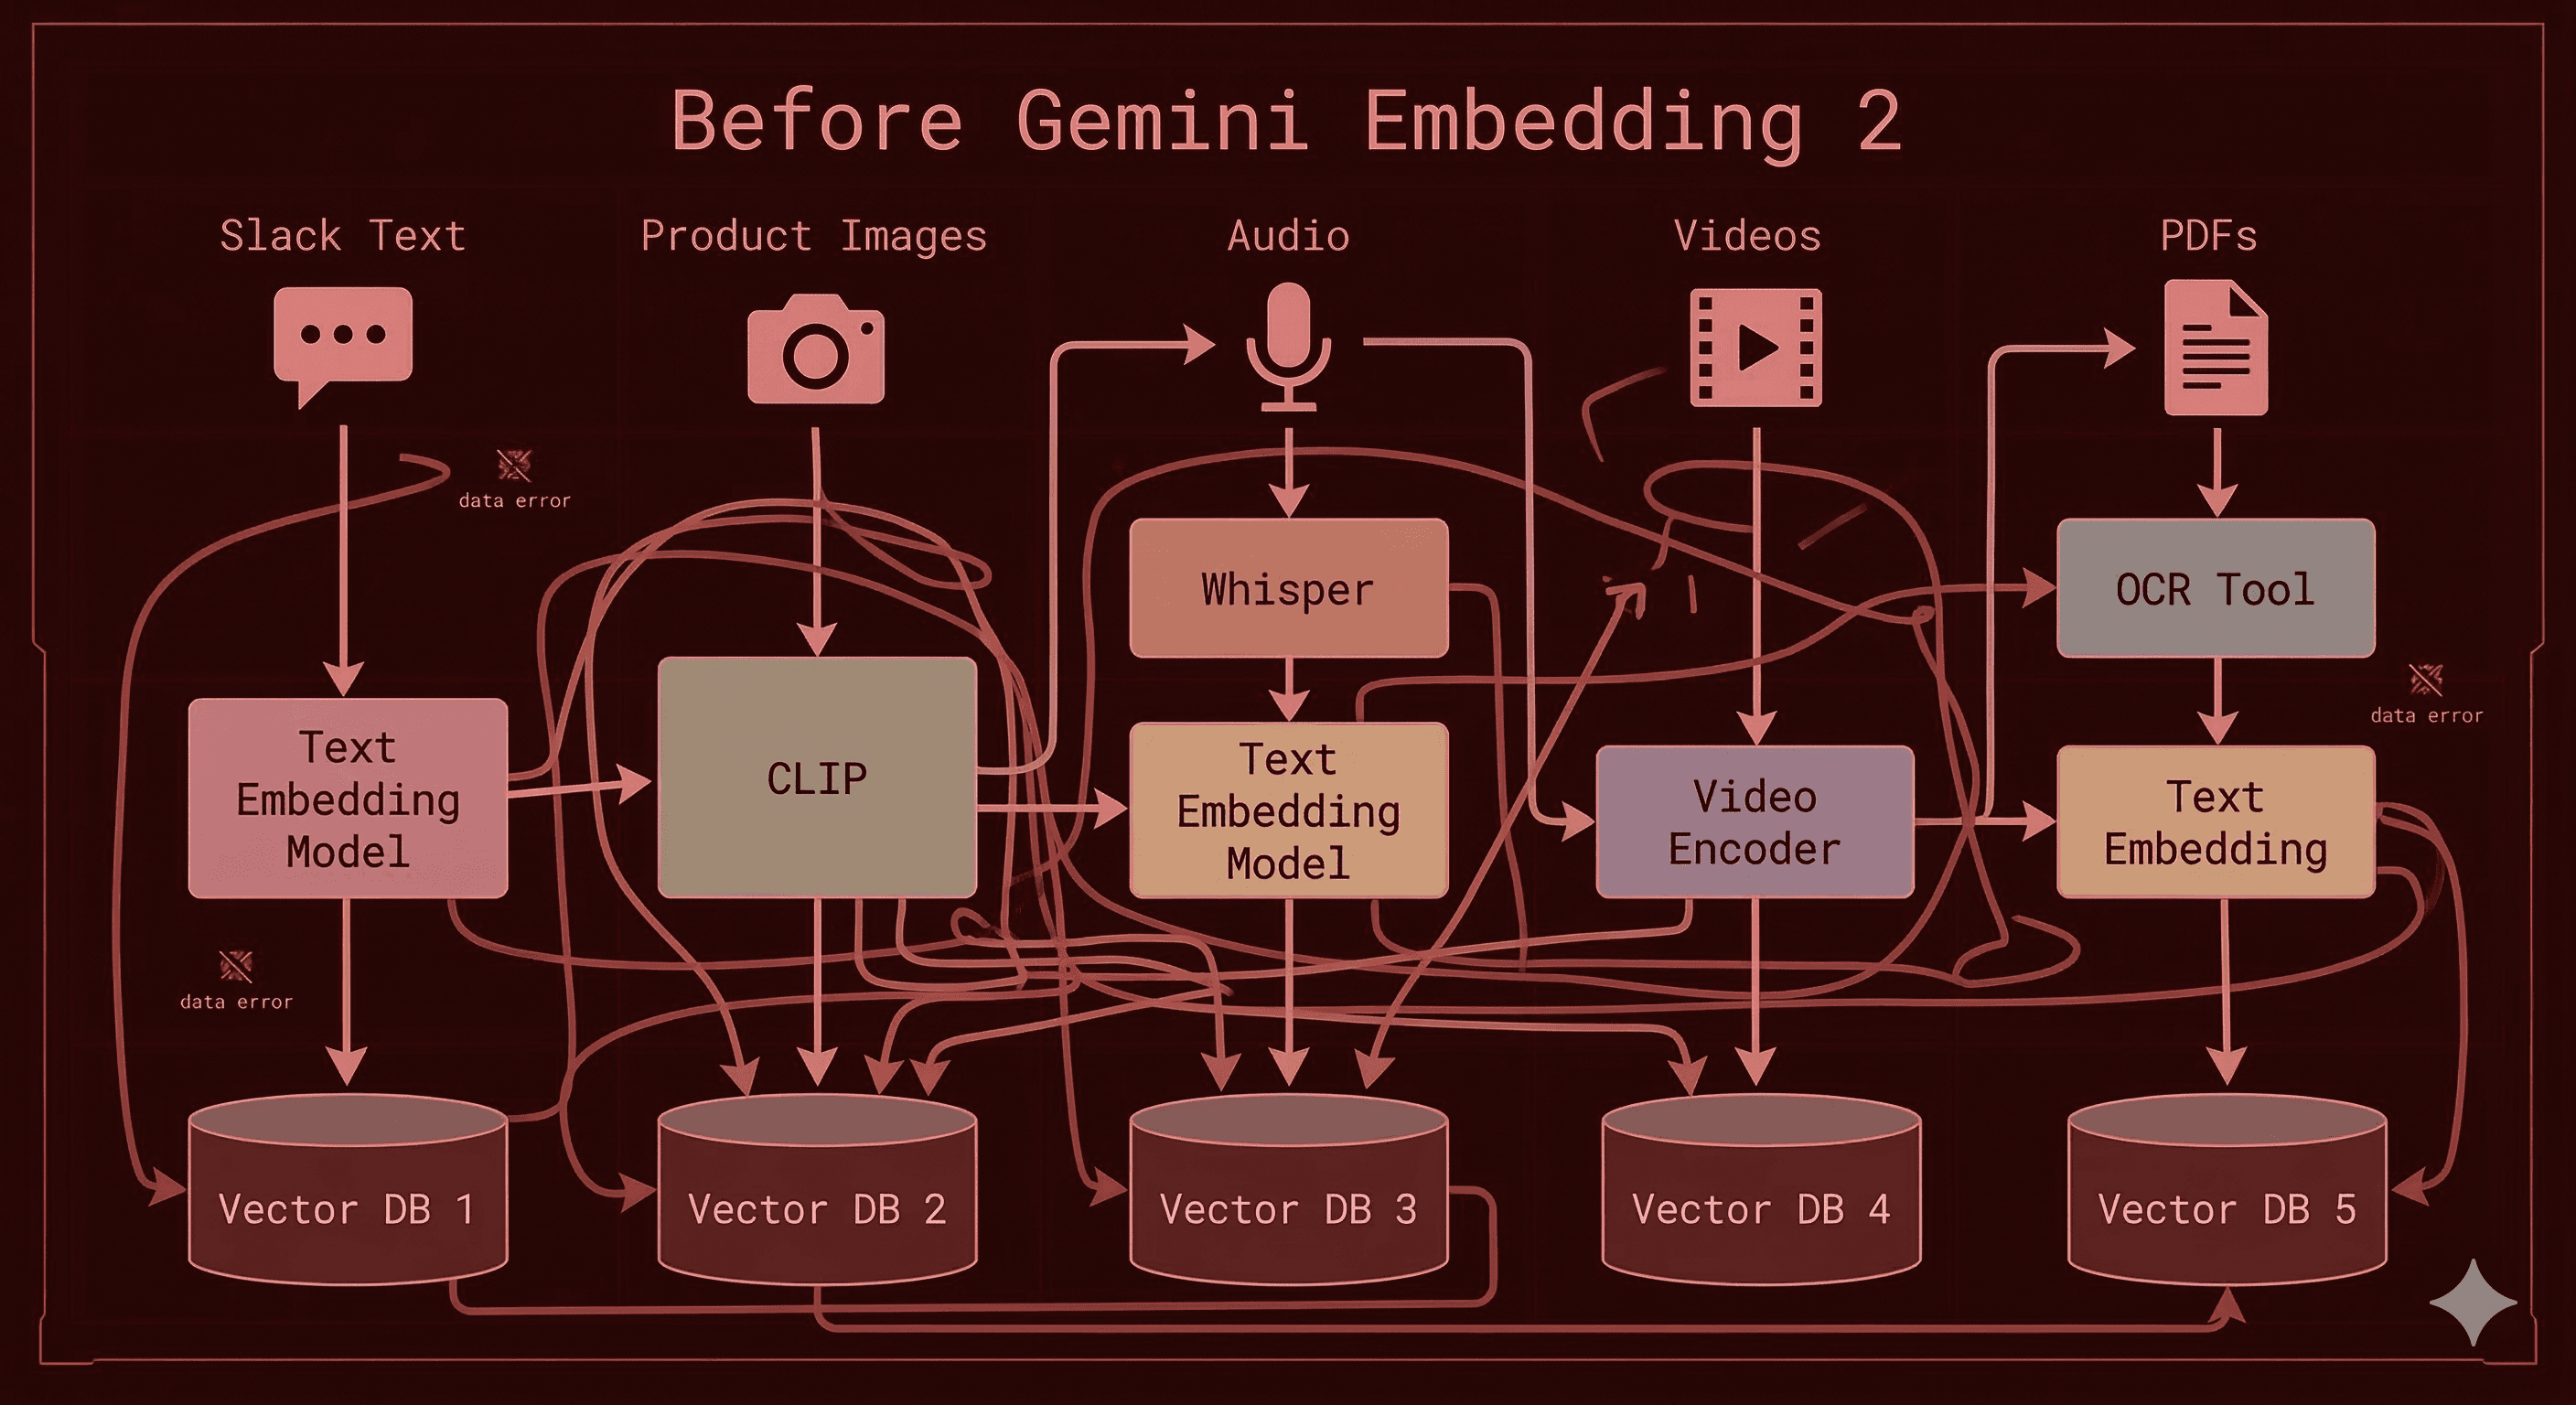
अब? सिर्फ एक एपीआई (API) कॉल। सब कुछ उसी वेक्टर स्पेस में चला जाता है। आप सचमुच एक ही क्वेरी के साथ इन सभी चीज़ों में से खोज सकते हैं।
यह कोई मामूली सुधार नहीं है। यह एक क्रांतिकारी बदलाव (paradigm shift) है।
Gemini Embedding 2 को क्या अलग बनाता है
1. मूल रूप से मल्टीमॉडल (बाहर से जोड़ा हुआ नहीं)
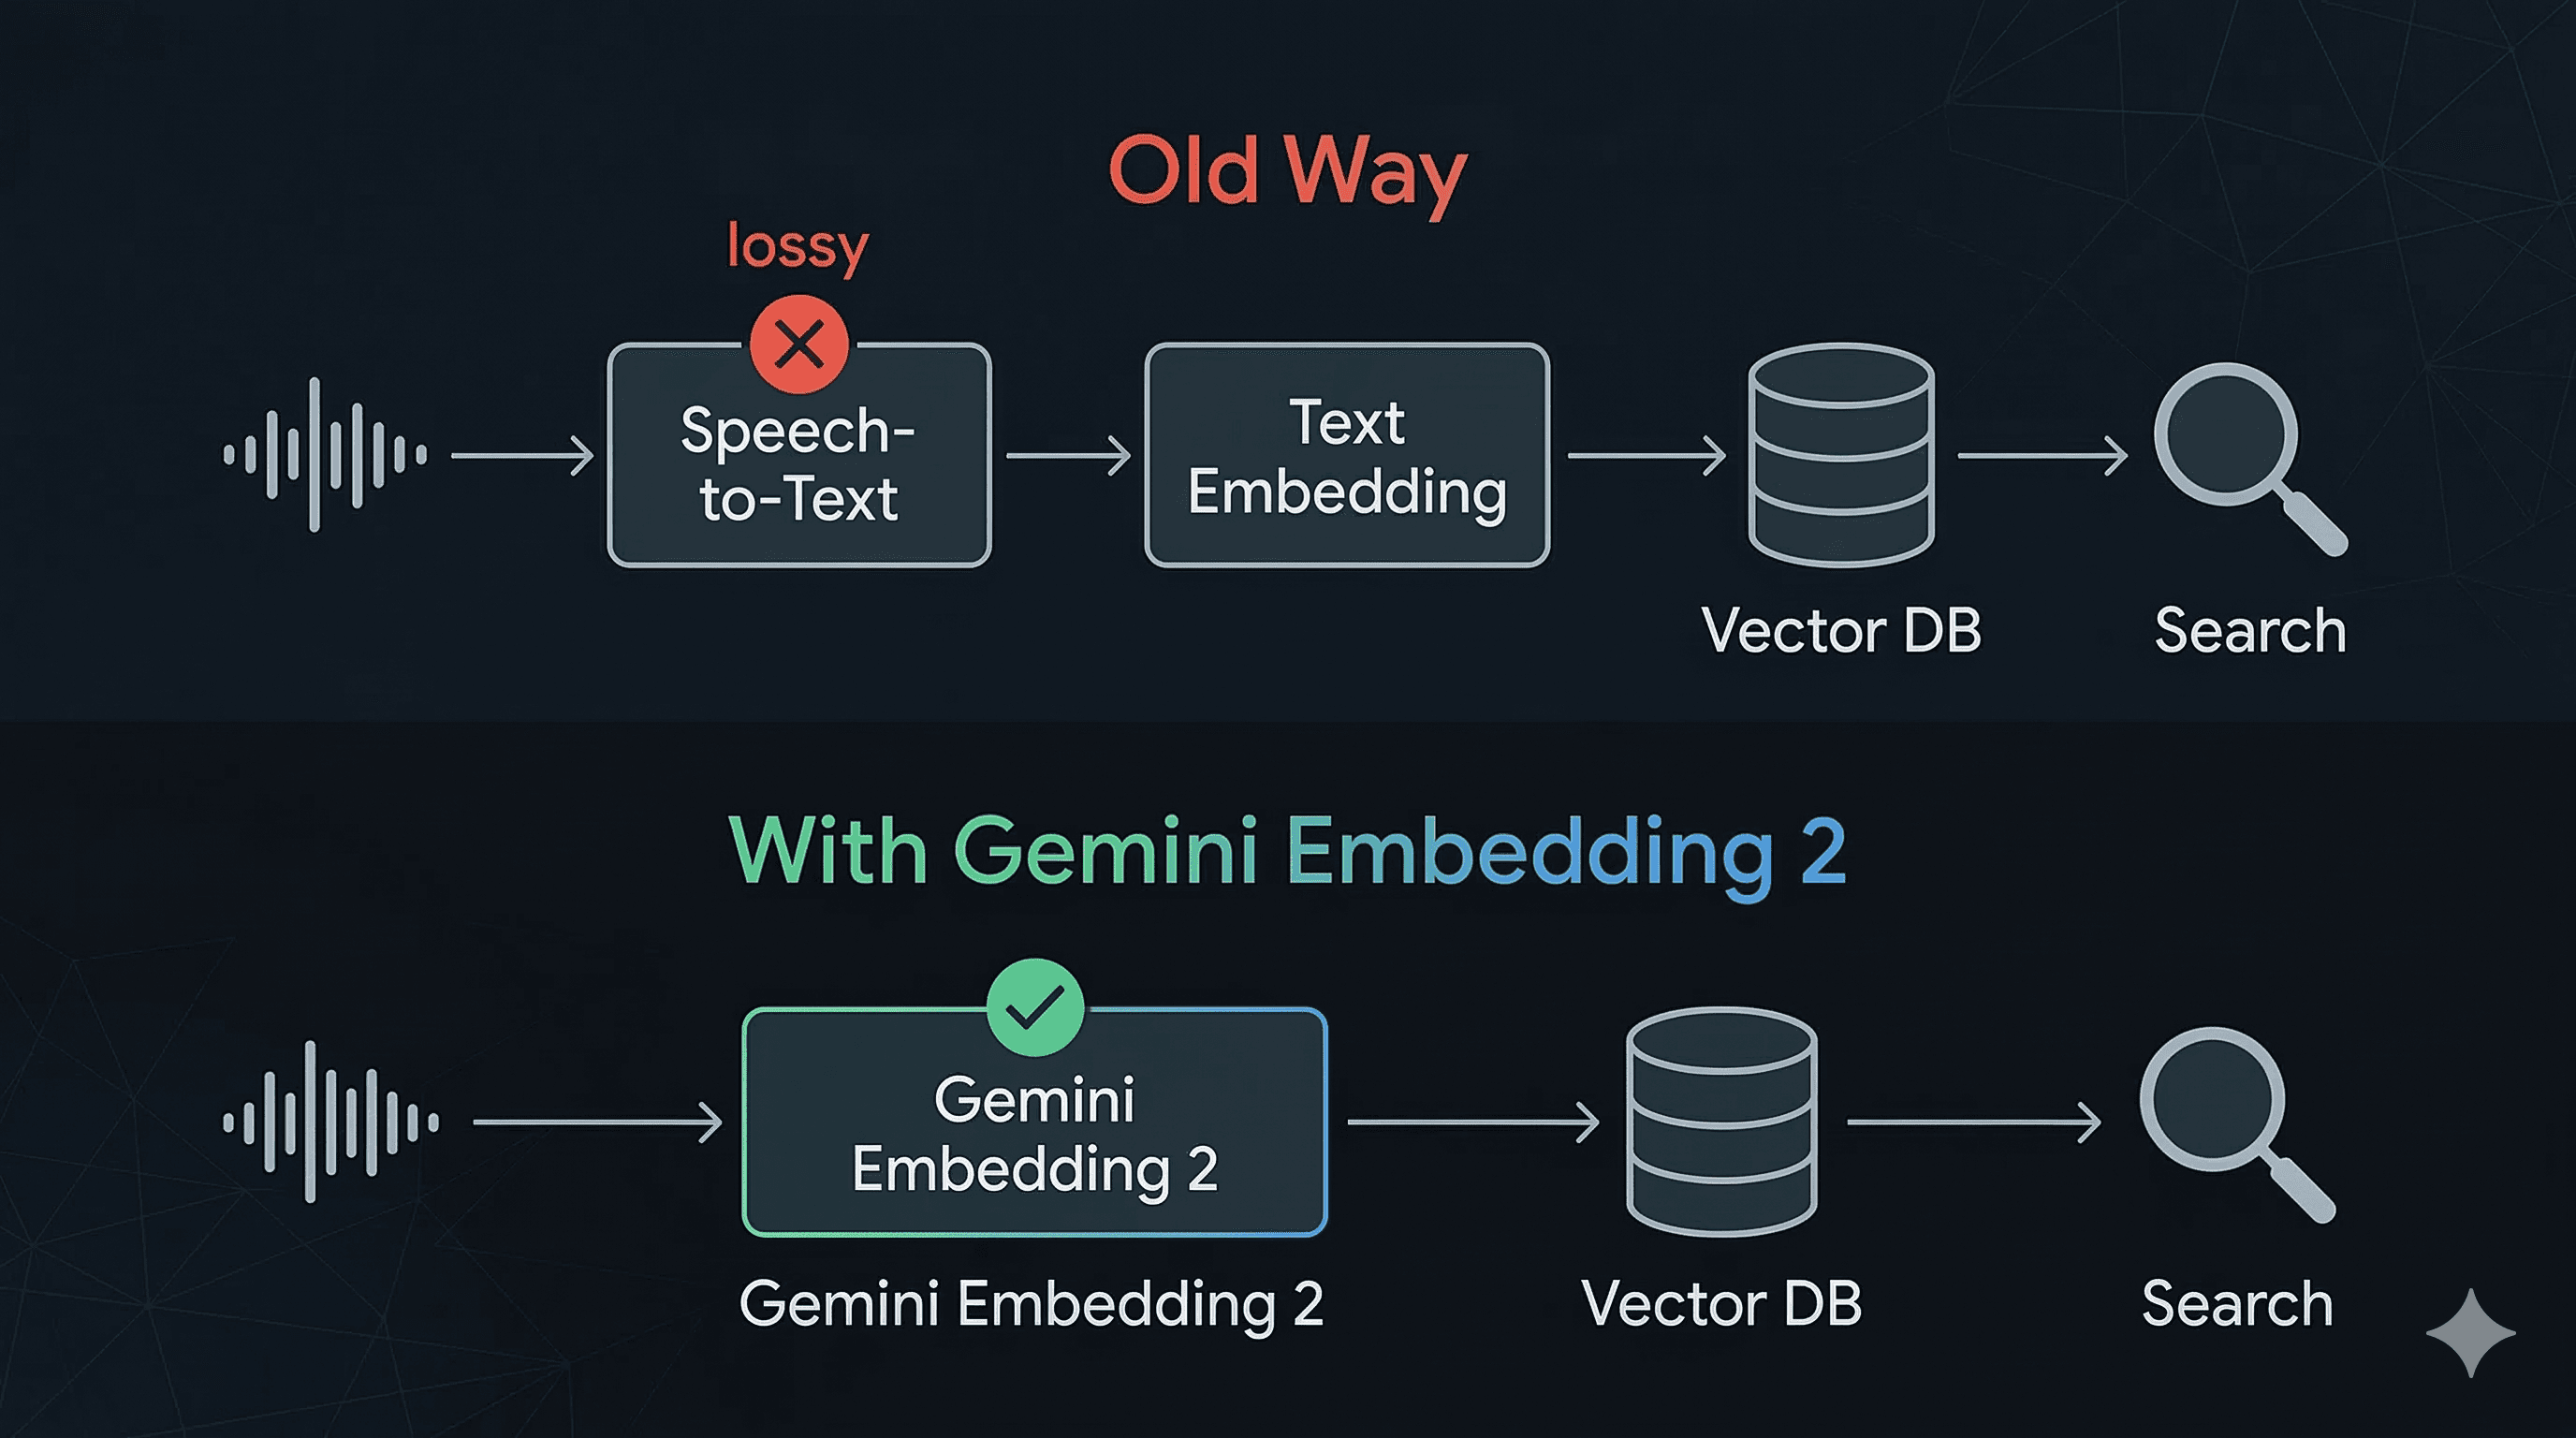
यह सबसे बड़ी बात है। Gemini Embedding 2 पहले आपके ऑडियो को टेक्स्ट में परिवर्तित नहीं करता और फिर उसे एम्बेड नहीं करता। यह आपकी छवियों को किसी अलग विज़न एनकोडर के माध्यम से नहीं चलाता। यह जेमिनी आर्किटेक्चर के माध्यम से मूल रूप से (natively) सभी पांच मोडैलिटीज़ को प्रोसेस करता है।
इसका मतलब है:
ऑडियो सीधे ऑडियो के रूप में जाता है। कोई नुकसानदेह स्पीच-टू-टेक्स्ट चरण नहीं। ट्रांसक्रिप्शन में कोई जानकारी नहीं खोती।
इमेजेज सीधे इमेजेज के रूप में जाती हैं। मॉडल वही देखता है जो आप देखते हैं।
वीडियो सीधे वीडियो के रूप में जाता है। इसमें टेम्पोरल समझ (temporal understanding) शामिल है।
पीडीएफ सीधे दस्तावेज़ों के रूप में जाते हैं। लेआउट, टेबल, आंकड़े, सब कुछ कैप्चर हो जाता है।
और आप इन्हें मिला भी सकते हैं। एक ही रिक्वेस्ट में इमेज + टेक्स्ट विवरण भेजें, और एक ही एम्बेडिंग प्राप्त करें जो दोनों के बीच के संबंध को कैप्चर करती है।
2. मैट्रियोशका रिप्रेजेंटेशन लर्निंग (MRL)
रूसी नेस्टिंग डॉल्स (Matryoshka dolls) के नाम पर आधारित, MRL आपको बिना दोबारा ट्रेनिंग दिए अपने एम्बेडिंग डाइमेंशन्स को स्केल करने की अनुमति देता है। इसका पूरा आउटपुट 3,072 डाइमेंशन्स का है, लेकिन आप इसे 1,536 या 768 तक छोटा कर सकते हैं और फिर भी ठोस सिमेंटिक क्वालिटी पा सकते हैं।
यह क्यों मायने रखता है? स्टोरेज लागत और लेटेंसी (latency) के कारण।
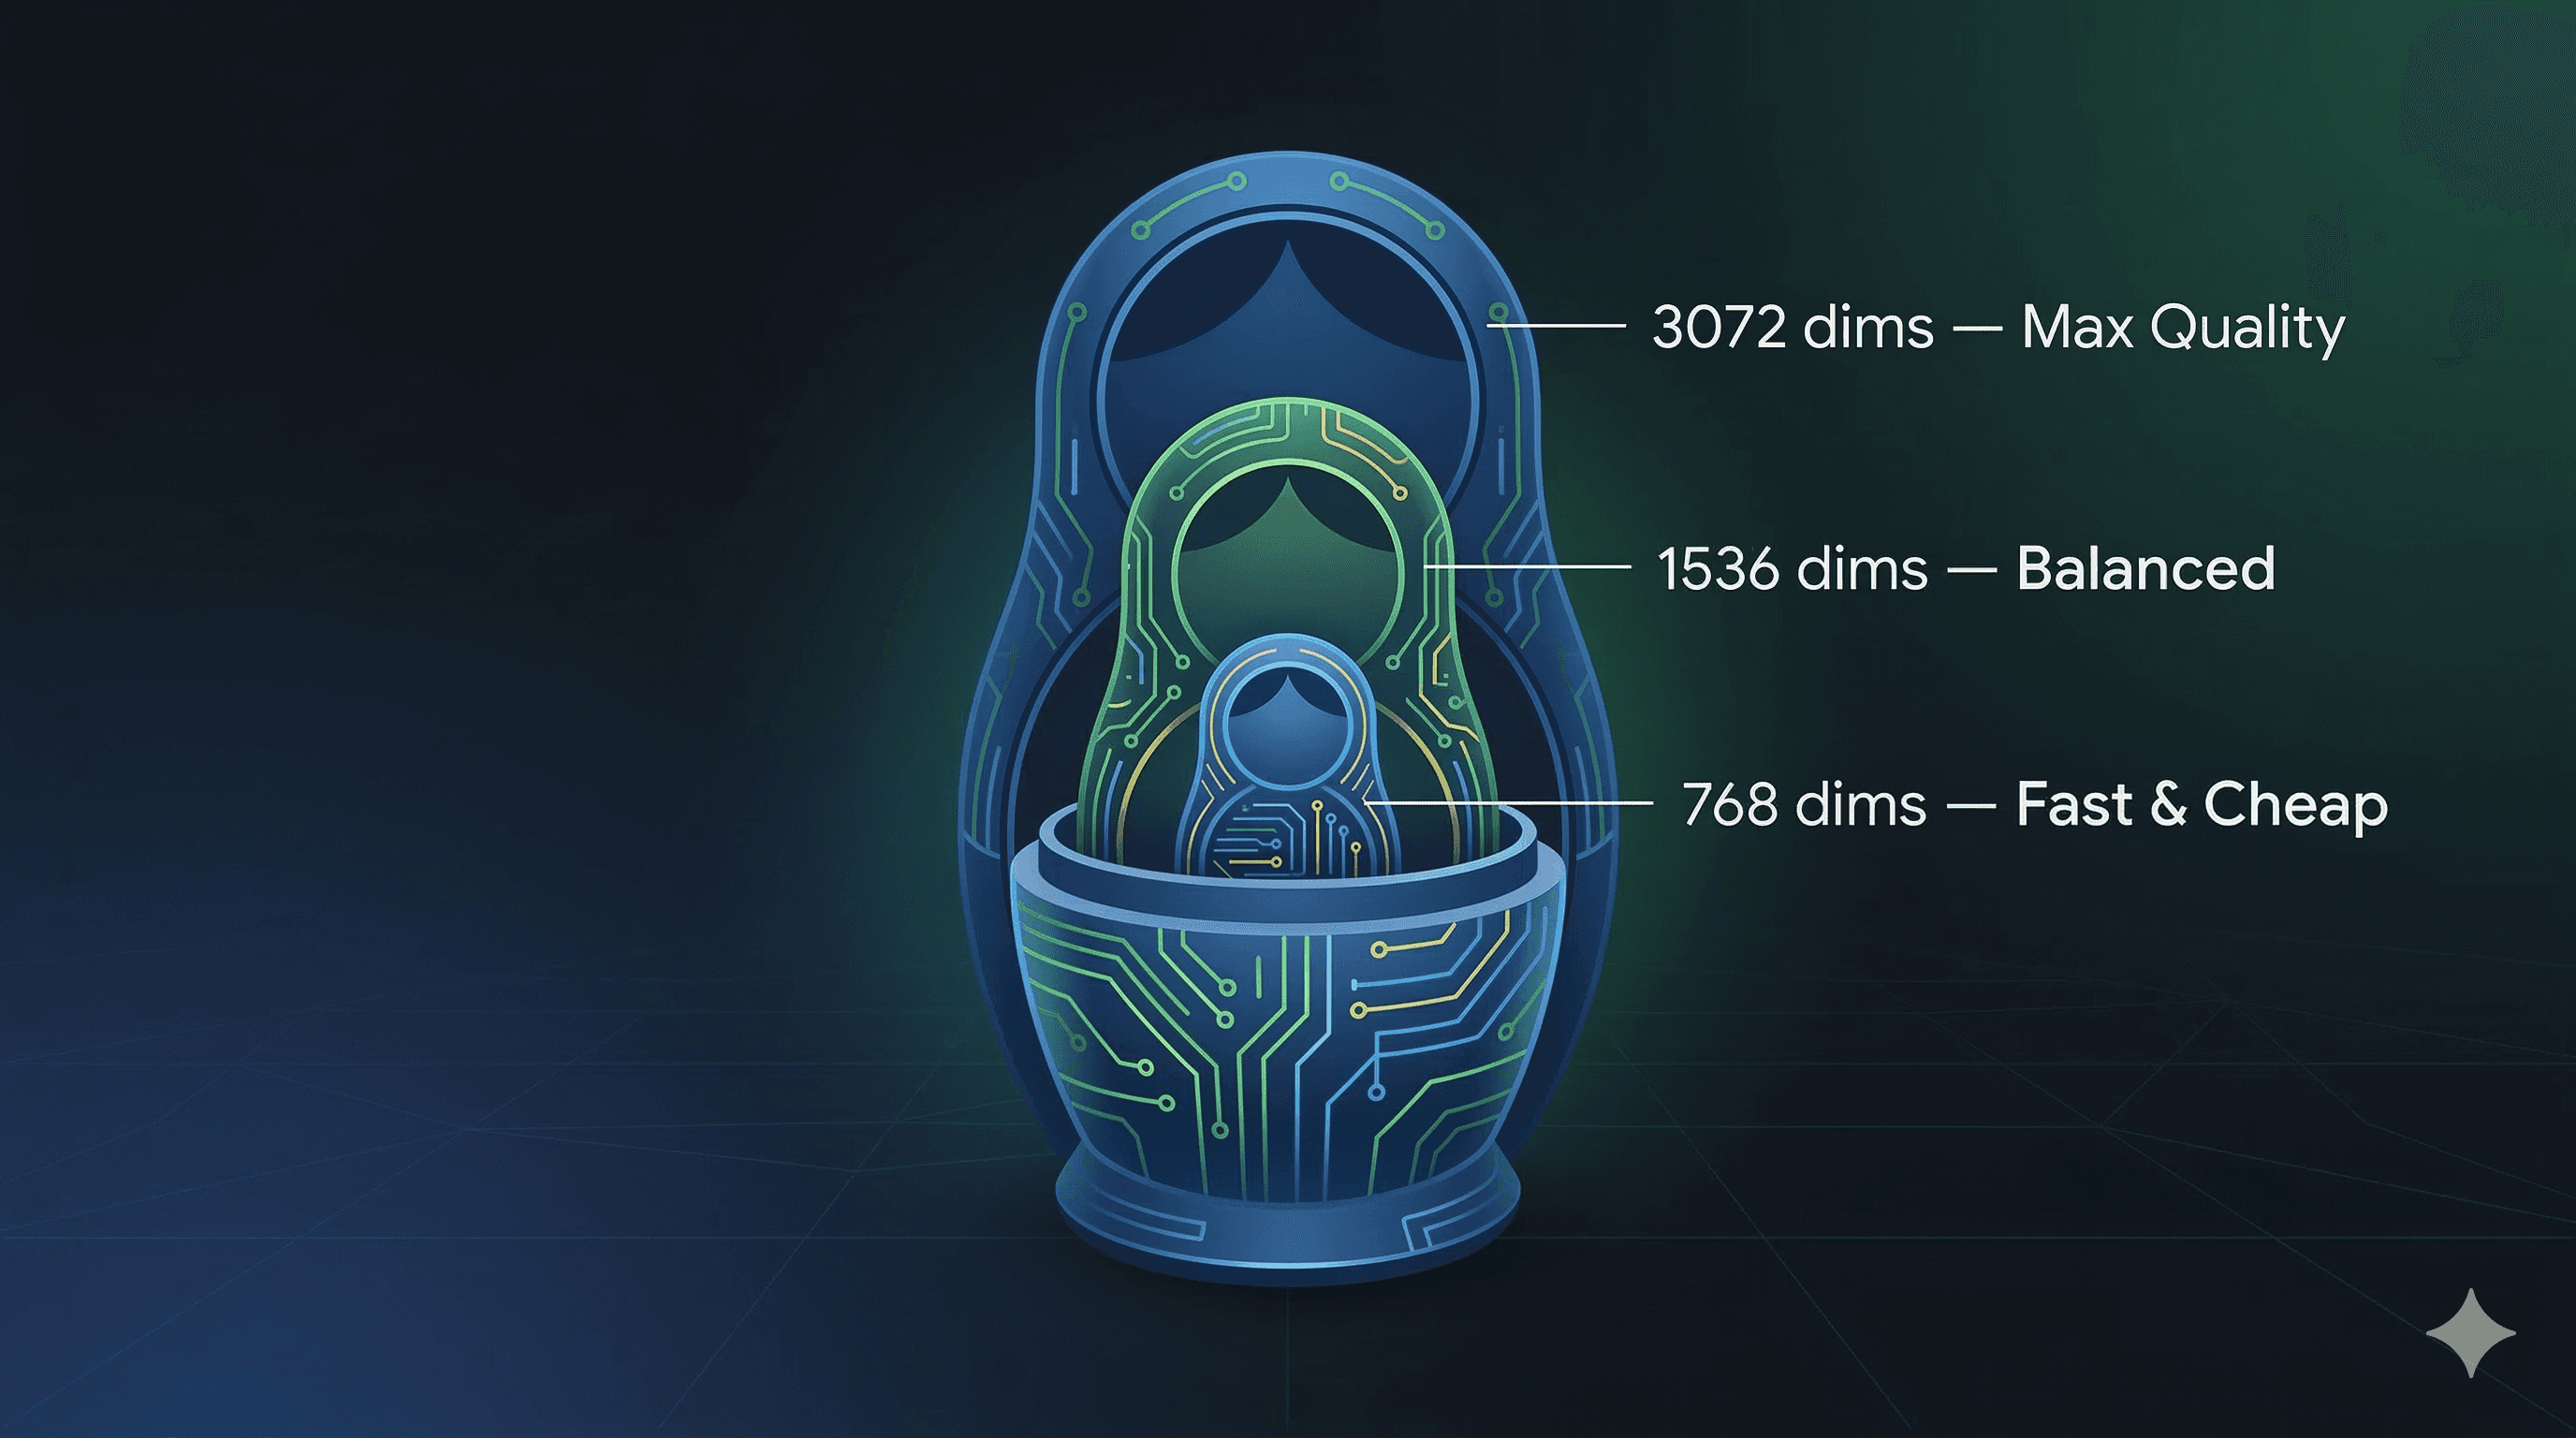
3,072 dims: अधिकतम गुणवत्ता। अपनी सबसे बेहतरीन खोज (retrieval) के लिए इसका उपयोग करें।
1,536 dims: बेहतरीन संतुलन। अधिकांश प्रोडक्शन सिस्टम यहीं काम करेंगे।
768 dims: तेज़, सस्ता, और फिर भी आश्चर्यजनक रूप से अच्छा। शुरुआती कैंडिडेट खोज के लिए बिल्कुल सही।
प्रो टिप: टू-पास रिट्रीवल (two-pass retrieval) सिस्टम चलाएं। गति के लिए पहला पास 768 dims पर करें, फिर सटीकता के लिए पूरे 3,072 dims के साथ टॉप-K परिणामों को री-स्कोर करें। इस रणनीति पर Qdrant का ब्लॉग इसे अच्छे से समझाता है।
3. नेटिव ऑडियो एम्बेडिंग (यह वॉयस AI के लिए बहुत बड़ी बात है)
यदि आप वॉयस एआई (Voice AI) के क्षेत्र में काम कर रहे हैं, तो ध्यान दें।
अधिकांश एम्बेडिंग मॉडल ऑडियो को पूरी तरह से अनदेखा कर देते हैं। आपको पहले ट्रांसक्राइब करना पड़ता था, जिससे स्वर-शैली (prosody), टोन और वक्ता की विशेषताएं खो जाती थीं, और फिर सीधे टेक्स्ट को एम्बेड करना पड़ता था।
Gemini Embedding 2 सीधे ऑडियो को एम्बेड करता है। MP3, WAV, प्रति क्लिप 80 सेकंड तक।
सोचिए इससे क्या राहें खुलती हैं:
पॉडकास्ट सर्च: सिर्फ ट्रांसक्रिप्ट कीवर्ड्स के बजाय अर्थ के आधार पर सेगमेंट खोजें
कस्टमर कॉल एनालिटिक्स: हजारों घंटों की कॉल्स में सिमेंटिक सर्च
वॉयस नोट रिट्रीवल: "वह रिकॉर्डिंग खोजें जहां मैंने Q3 बजट के बारे में बात की थी"
म्यूज़िक सिमिलैरिटी: ऑडियो को एम्बेड करें और सिमेंटिक रूप से समान ट्रैक खोजें
वॉयस एआई प्रोडक्ट्स बनाने वाली कंपनियों के लिए, यह सिस्टम से जटिलता की एक पूरी परत को हटा देता है।
4. इंटरलीव्ड मल्टीमॉडल इनपुट्स
यह एक ऐसी विशेषता है जिस पर अधिकांश लोग ध्यान नहीं दे रहे हैं।
आप एक ही कंटेंट एंट्री में कई मोडैलिटीज़ भेज सकते हैं, और मॉडल एक एग्रीगेटेड एम्बेडिंग तैयार करता है जो उनके बीच के संबंधों को कैप्चर करती है। इमेज + कैप्शन? वीडियो + विवरण? ऑडियो क्लिप + ट्रांसक्रिप्ट? सब कुछ एक ही एम्बेडिंग में।
वास्तविक दुनिया का डेटा इसी तरह काम करता है। कोई प्रोडक्ट लिस्टिंग केवल टेक्स्ट या केवल इमेज नहीं होती। यह दोनों का मिश्रण होती है। और अब आपकी एम्बेडिंग्स इसे दर्शा सकती हैं।
बेंचमार्क: यह वास्तव में कहां टिकता है?
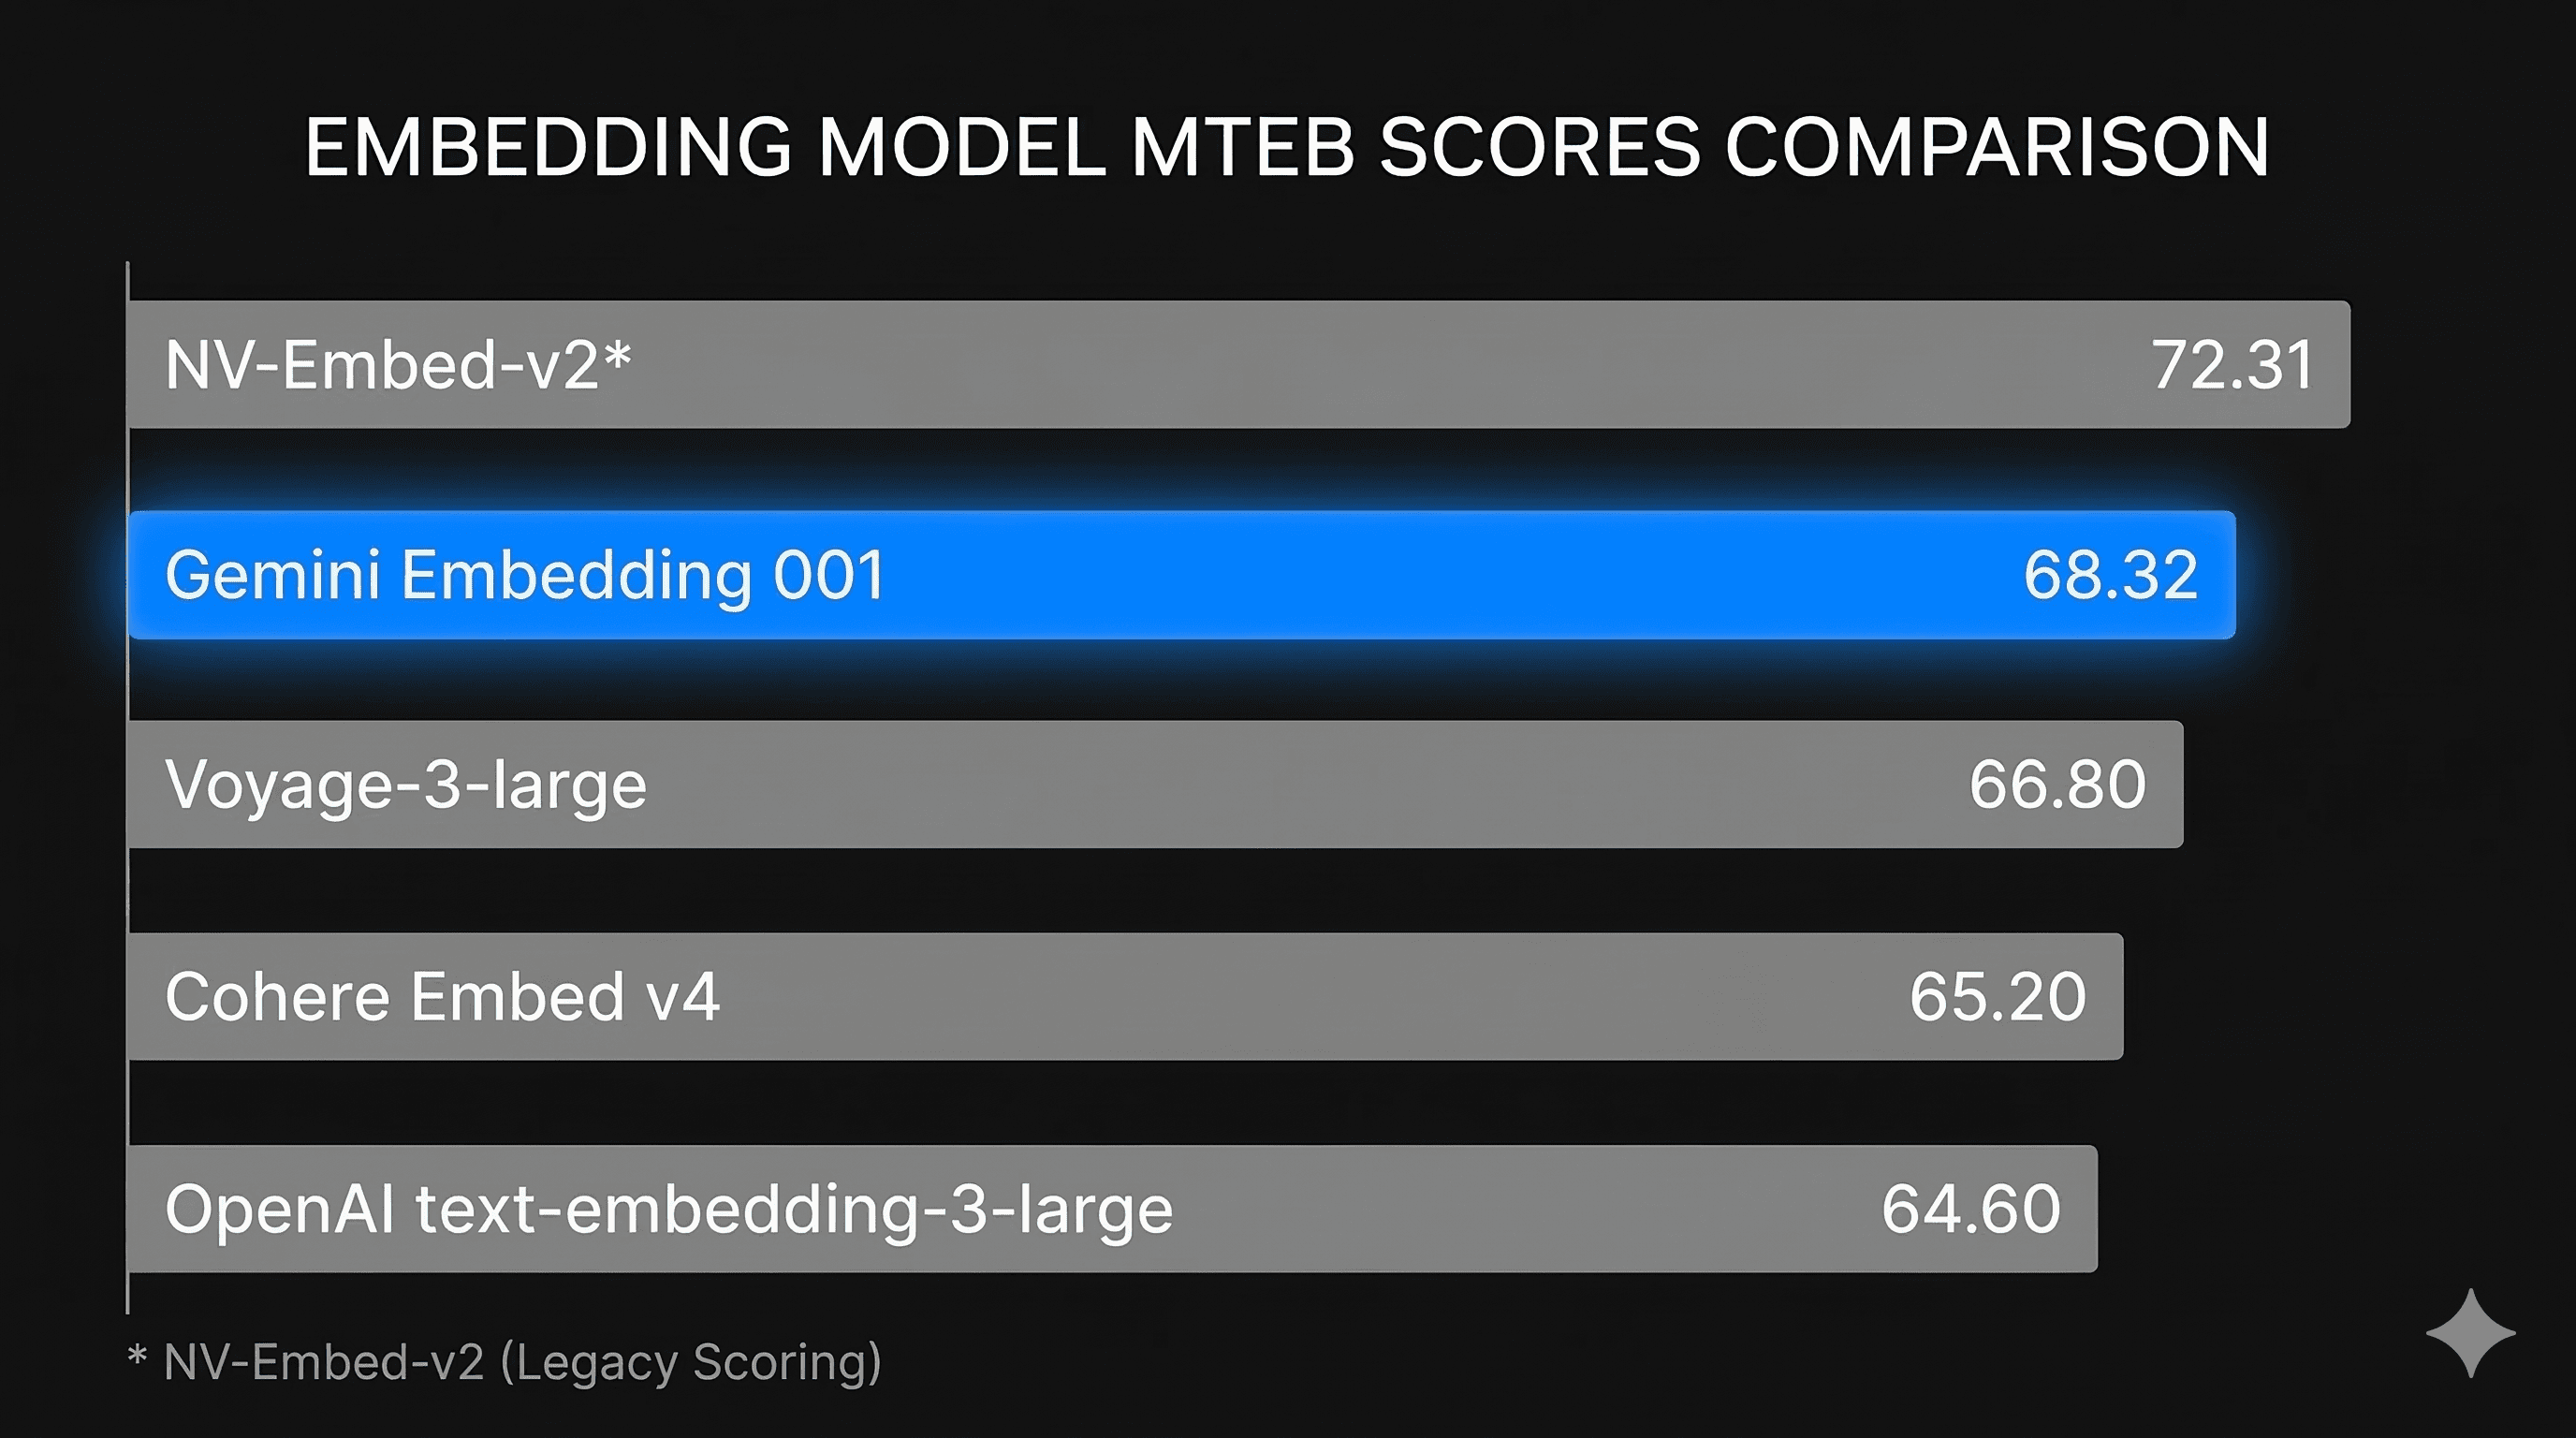
आइए आंकड़ों पर बात करते हैं। यहाँ मार्च 2026 की MTEB लीडरबोर्ड दी गई है:
रैंक | मॉडल | प्रदाता | MTEB औसत | Dims | कीमत |
|---|---|---|---|---|---|
1 | Gemini Embedding 001 | 68.32 | 3072 | ~$0.004/1K chars | |
2 | NV-Embed-v2 | NVIDIA | 72.31* | 4096 | फ्री (ओपन-वेट) |
3 | Qwen3-Embedding-8B | Alibaba | 70.58** | 4096 | फ्री (ओपन-वेट) |
6 | Voyage-3-large | Voyage AI | 66.80 | 2048 | $0.06/1M tokens |
8 | Cohere Embed v4 | Cohere | 65.20 | 1024 | $0.12/1M tokens |
9 | text-embedding-3-large | OpenAI | 64.60 | 3072 | $0.13/1M tokens |
लेगेसी MTEB (56 टास्क) से प्राप्त स्कोर। क्रॉस-लीडरबोर्ड तुलनाएं अनुमानित हैं।
स्रोत: MTEB एम्बेडिंग मॉडल लीडरबोर्ड, मार्च 2026
कुछ बातें तुरंत ध्यान खींचती हैं:
गूगल का Gemini Embedding 001 नए इंग्लिश MTEB लीडरबोर्ड पर #1 स्थान पर है जिसका औसत 68.32 है। और Gemini Embedding 2 (मल्टीमॉडल वर्शन) अपने अलग-अलग डाइमेंशन टियर्स में 67.99-68.17 स्कोर करता है। वह भी मल्टीमॉडल सपोर्ट के साथ, जो किसी अन्य शीर्ष मॉडल में नहीं है।
विशेष रूप से रिट्रीवल (खोजने) पर, जो कि RAG के लिए हममें से अधिकांश लोगों के लिए सबसे महत्वपूर्ण है, Gemini Embedding 001 का स्कोर 67.71 है। इसकी तुलना NV-Embed-v2 से करें जिसका स्कोर 62.65 है। यदि रिट्रीवल आपका मुख्य काम है, तो गूगल की बढ़त और भी अधिक महत्वपूर्ण हो जाती है।
कीमत का अंतर काफी बड़ा है। लगभग $0.004 प्रति 1K कैरेक्टर्स पर, Gemini Embedding, OpenAI ($0.13/1M tokens) और Cohere ($0.12/1M tokens) की तुलना में काफी सस्ता है। और वे ओपन-सोर्स मॉडल जो इससे अधिक स्कोर करते हैं? उनके लिए आपको अपने खुद के इन्फ्रास्ट्रक्चर को होस्ट और स्केल करना होगा।
कोड दिखाएं (Show Me the Code)
बहुत हुई थ्योरी। आइए अब कुछ बनाते हैं।
बेसिक: टेक्स्ट एम्बेडिंग (Text Embedding)
मल्टीमॉडल: टेक्स्ट + इमेज + ऑडियो एक ही बार में
यहीं से चीजें रोमांचक हो जाती हैं।
तीन मोडैलिटीज़। एक वेक्टर। आपके डेटाबेस में मौजूद बाकी सभी चीजों की तरह ही एक समान एम्बेडिंग स्पेस।
क्रॉस-मोडल सर्च: टेक्स्ट सर्च करें, इमेजेज पाएं
आपने टेक्स्ट टाइप किया। इसने सबसे प्रासंगिक इमेज ढूंढ ली। कोई CLIP नहीं। कोई अलग मॉडल नहीं। सिर्फ Gemini Embedding 2।
प्रोडक्शन RAG: LangChain + Qdrant
ऑडियो नॉलेज बेस: खोजने योग्य वॉयस नोट्स
यह उदाहरण LlamaIndex के audio-kb प्रोजेक्ट से प्रेरित है जो आपकी ऑडियो रिकॉर्डिंग्स को खोजने योग्य बनाने के लिए Gemini Embedding 2 का उपयोग करता है।
पूरा audio-kb टूल इंस्टॉल करें:
टास्क के प्रकार (Task Types): सही प्रकार चुनें
Gemini Embedding 2 विशेष टास्क प्रकारों का समर्थन करता है जो आपके विशेष उपयोग के मामले के लिए एम्बेडिंग को ऑप्टिमाइज़ करते हैं:
टास्क का प्रकार (Task Type) | कब उपयोग करें |
|---|---|
| सर्च के लिए दस्तावेज़ों को इंडेक्स करना |
| स्वयं सर्च क्वेरी के लिए |
| सिफ़ारिशें (recommendations), डुप्लिकेशन हटाना |
| स्पैम का पता लगाना, सेंटिमेंट एनालिसिस |
| दस्तावेज़ों का वर्गीकरण, विसंगति (anomaly) का पता लगाना |
| प्रासंगिक कोड ब्लॉक्स ढूंढना |
| QA प्रणालियाँ |
| तथ्य-जांच (fact-checking) पाइपलाइन्स |
इसे न छोड़ें। सही टास्क प्रकार का उपयोग करने से आपकी रिट्रीवल क्वालिटी में काफी सुधार हो सकता है। इंडेक्स करते समय RETRIEVAL_DOCUMENT और खोजते समय RETRIEVAL_QUERY का उपयोग करें। यह एक छोटी सी बात है जो बड़ा अंतर पैदा करती है।
डेवलपर कम्युनिटी काफी उत्साहित है
घोषणाएं 10 मार्च को X (ट्विटर) पर आईं और प्रतिक्रियाएं बहुत तेजी से देखने को मिलीं।
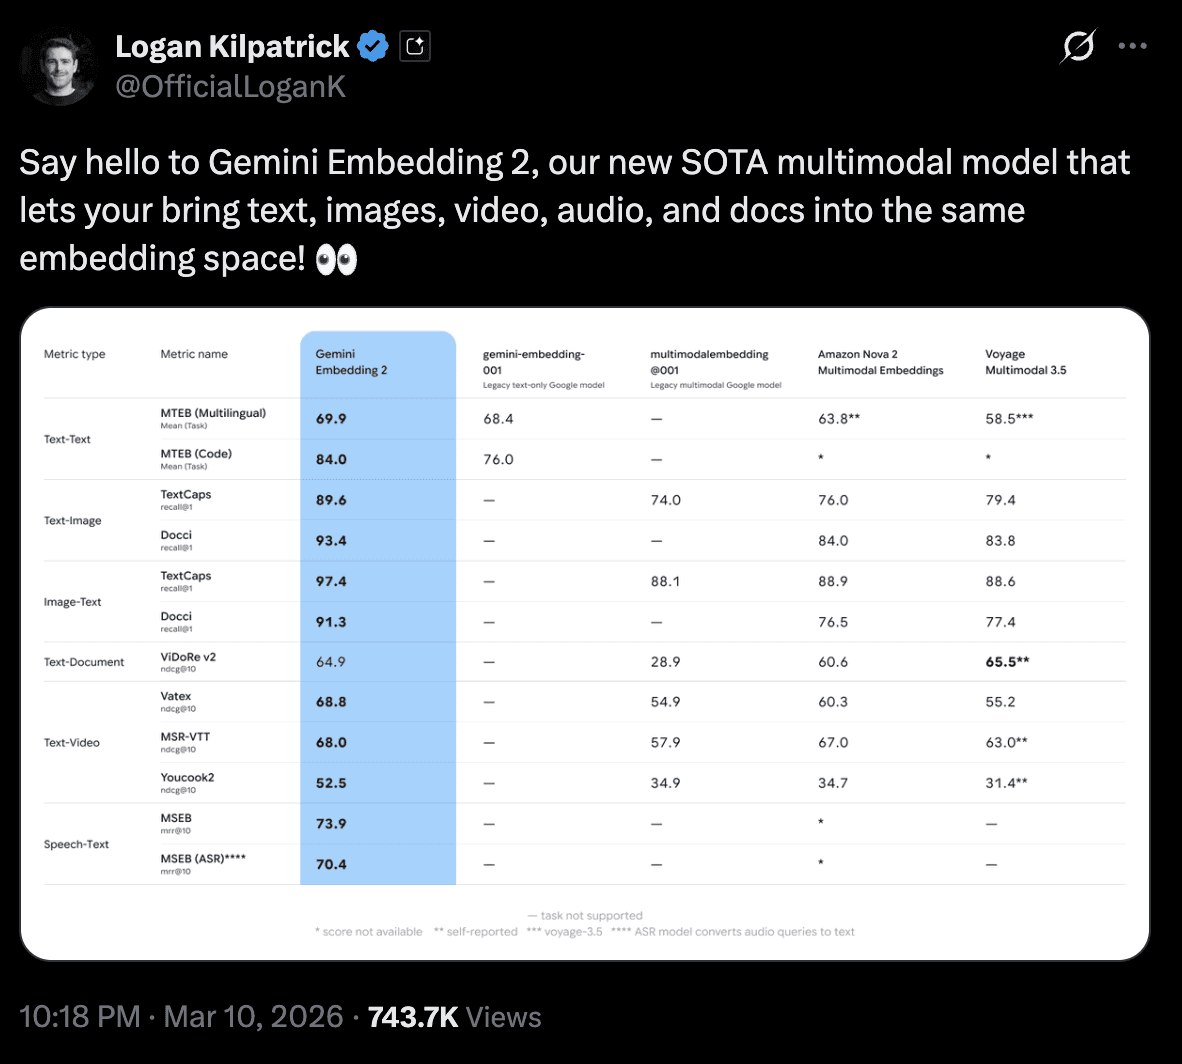
गूगल एआई की ओर से DEV Community पोस्ट को भी बेहतरीन प्रतिक्रिया मिल रही है। और Qdrant ने घोषणा के कुछ ही घंटों के भीतर एक इंटीग्रेशन गाइड जारी कर दी।
वॉयस एआई (Voice AI) का दृष्टिकोण
मैं वॉयस एआई के क्षेत्र में काम करता हूं। मैं हर दिन स्पीच पाइपलाइन्स के साथ प्रोजेक्ट्स बनाता हूं। इसलिए जब मैंने Gemini Embedding 2 की घोषणा में "नेटिव ऑडियो एम्बेडिंग" देखा, तो मैं खुद को रोक नहीं पाया।
यहाँ इसका कारण बताया गया है।
यदि आपने कभी भी कोई ऐसा टूल बनाया है जिसे वॉयस डेटा को खोजने, रिट्रीव करने या वर्गीकृत करने की आवश्यकता होती है, तो आप प्रक्रिया जानते हैं। आपकी पाइपलाइन कुछ इस तरह दिखती है:
हर चरण लेटेंसी (देरी) बढ़ाता है। हर चरण त्रुटि की संभावना को बढ़ाता है। और बीच का वह स्पीच-टू-टेक्स्ट चरण? वह असली बाधा है। न केवल गति में, बल्कि जानकारी के नुकसान में भी। जैसे ही आप ट्रांसक्राइब करते हैं, आप टोन, जोर, गति, वक्ता की विशेषताएं और इमोशनल कॉन्टेक्स्ट खो देते हैं। आपके पास केवल सपाट टेक्स्ट बचता है जो बमुश्किल यह कैप्चर कर पाता है कि वास्तव में क्या संदेश दिया गया था।
और यदि वह ऑडियो हिंग्लिश में हो? या कोड-स्विचिंग के साथ तमिल में? या किसी शोर-शराबे वाले कॉल सेंटर से अंग्रेजी में? STT इसे बिगाड़ देता है, और आगे की पूरी प्रक्रिया ठप हो जाती है। आपकी एम्बेडिंग्स उतनी ही अच्छी होती हैं जितना कि आपका ट्रांसक्रिप्ट, और ट्रांसक्रिप्ट अक्सर बेकार होता है।
Gemini Embedding 2 के साथ, वह पूरी मध्यम परत गायब हो जाती है:
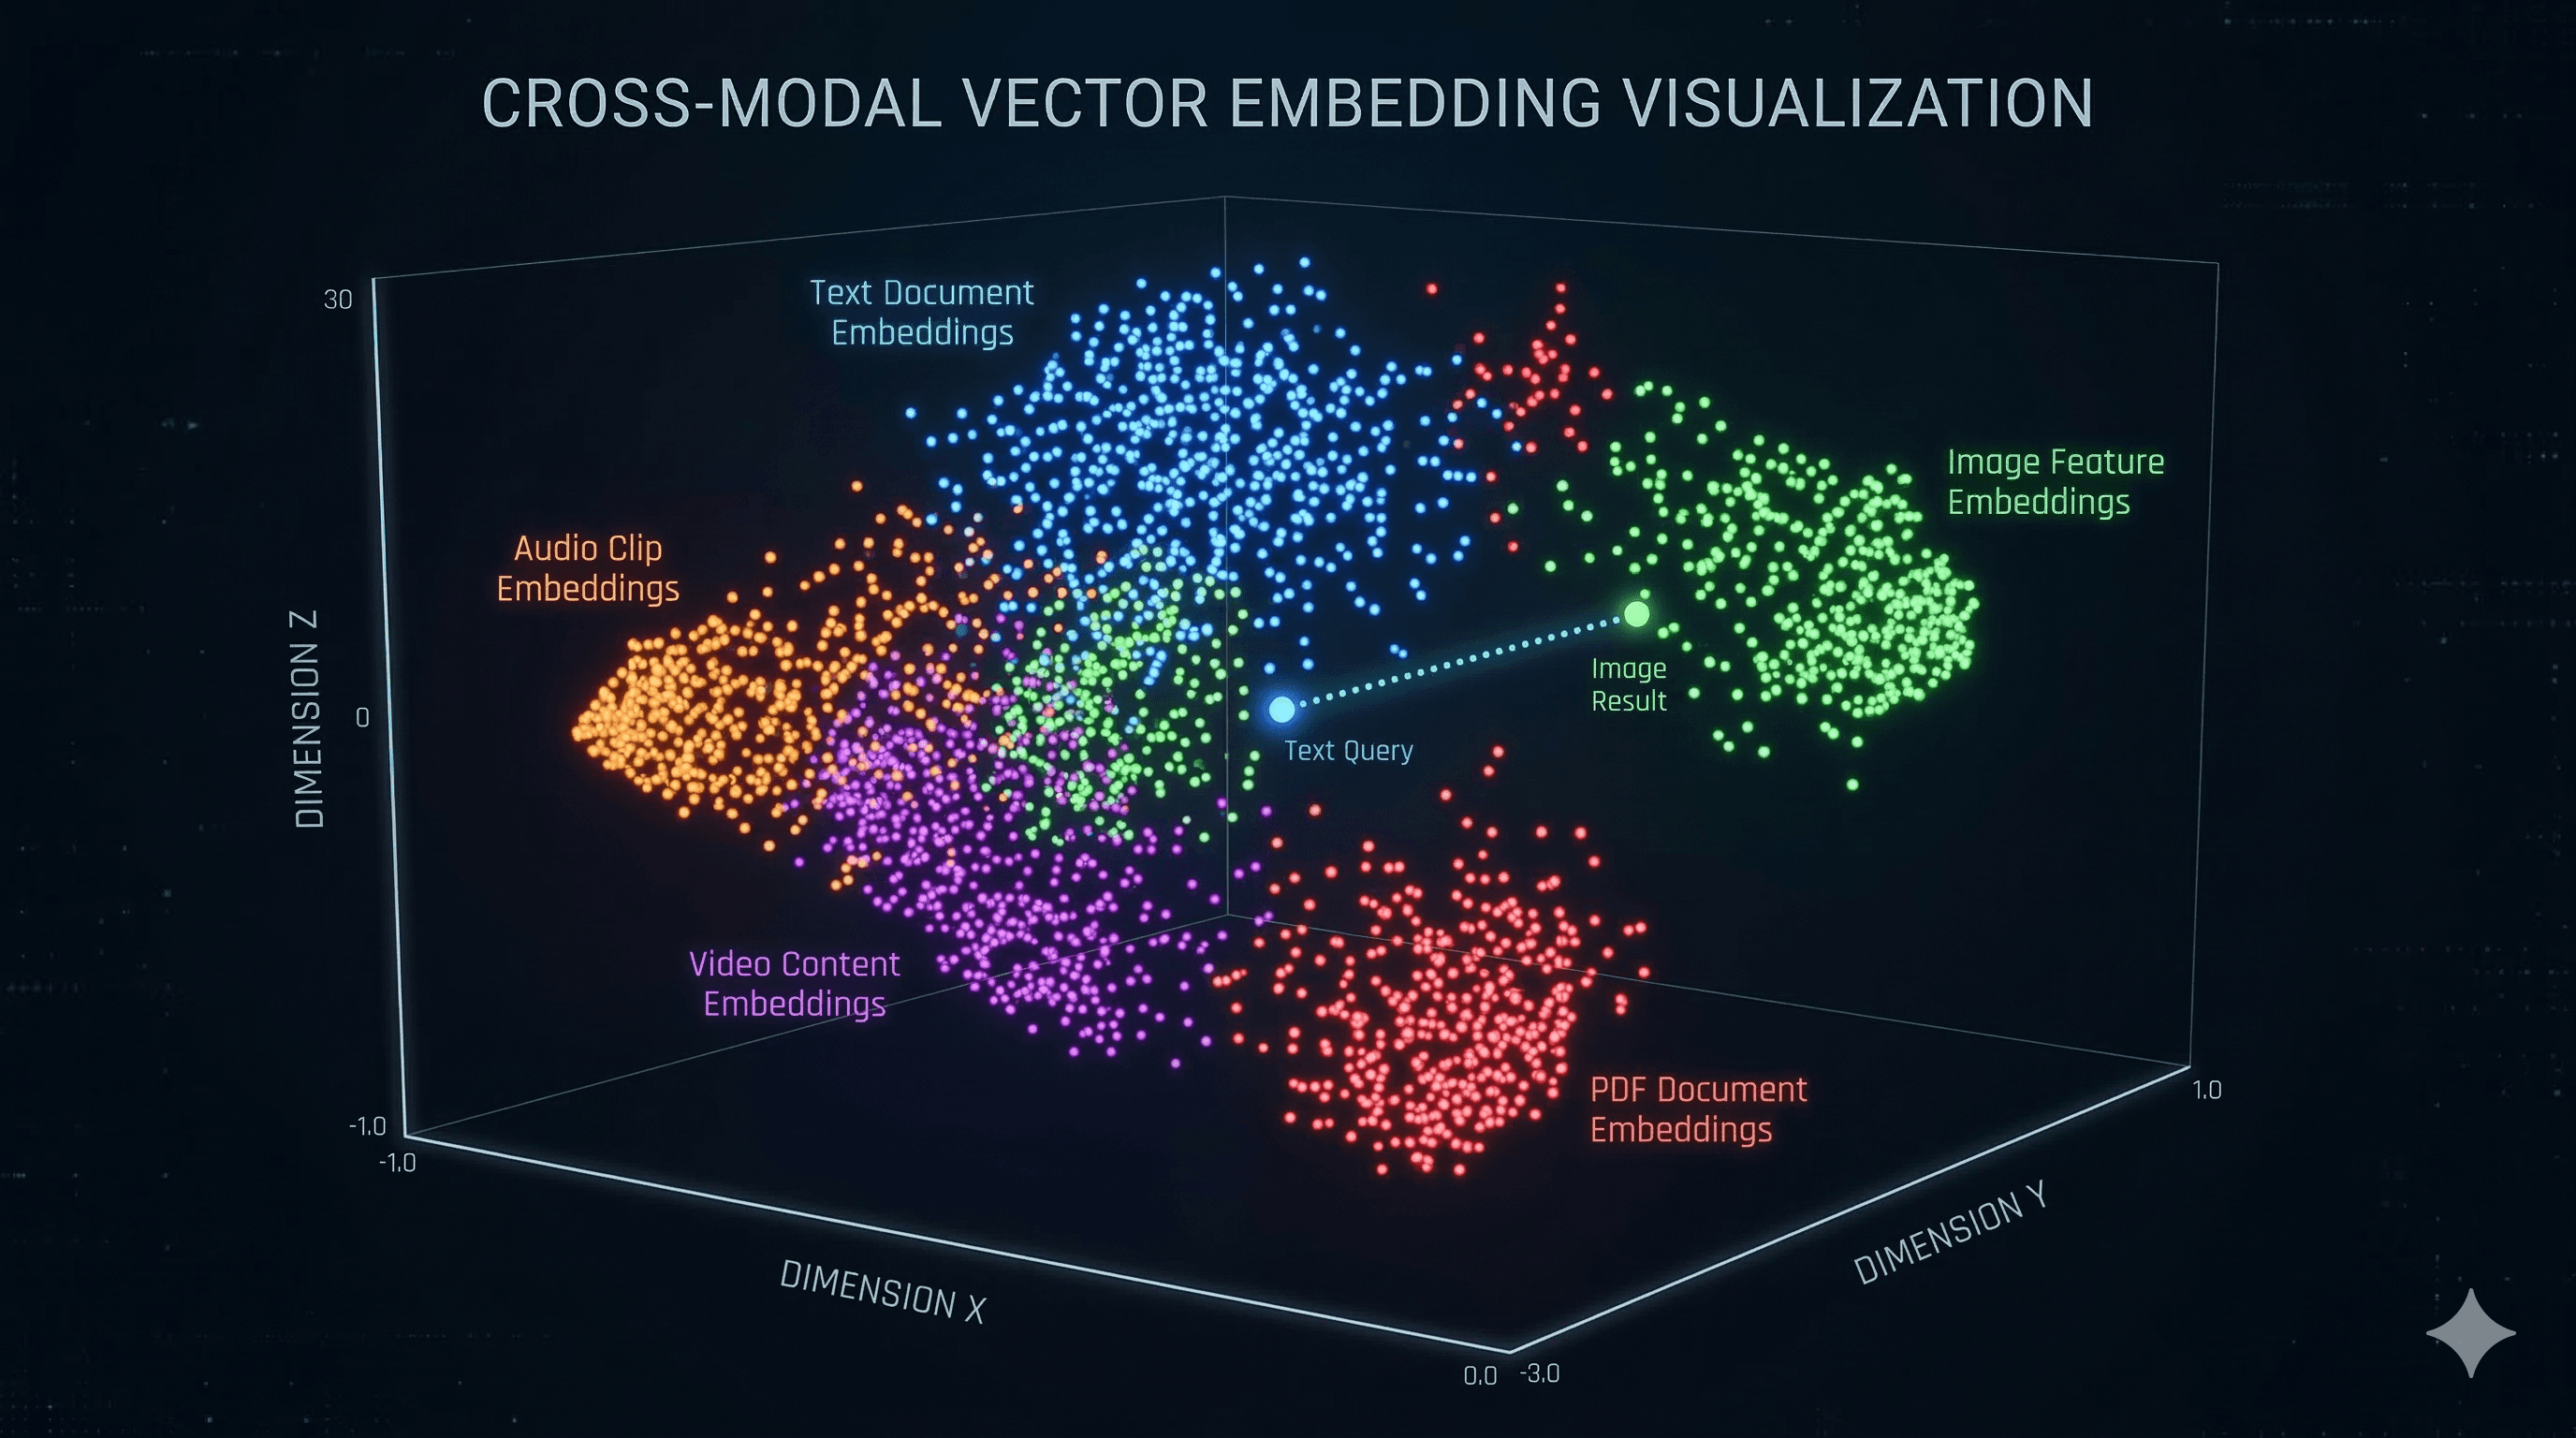
ऑडियो इनपुट जाता है। एम्बेडिंग आउटपुट आता है। कोई ट्रांसक्रिप्शन नहीं। कोई जानकारी का नुकसान नहीं। कोई STT निर्भरता नहीं।
जैसे ही मैंने यह देखा, मेरा दिमाग उन सभी जटिल और परेशान करने वाली पाइपलाइनों के बारे में सोचने लगा जिन पर मैंने काम किया है:
कॉल सेंटर सर्च: ग्राहक कॉल्स के हजारों घंटे। अभी आप सब कुछ ट्रांसक्राइब करते हैं, प्रार्थना करते हैं कि STT लहजे (accent) को संभाल ले, और फिर टेक्स्ट सर्च करते हैं। नेटिव ऑडियो एम्बेडिंग के साथ, आप इन सब को छोड़ कर सीधे ऑडियो को उसके अर्थ के आधार पर सर्च कर सकते हैं।
बहुभाषी वॉयस रिट्रीवल: यह मॉडल 100+ भाषाओं का समर्थन करता है। आप एक हिंदी ऑडियो क्लिप को एम्बेड कर सकते हैं और उसे अंग्रेजी टेक्स्ट क्वेरी से खोज सकते हैं। बहुभाषी बाजारों में काम करने वाली कंपनियों के लिए सोचिए इसके क्या मायने हैं। अपनी सामग्री को खोजने योग्य बनाने के लिए अब प्रति भाषा अलग STT मॉडल बनाए रखने की आवश्यकता नहीं है।
वॉयस नोट रिट्रीवल: "वह रिकॉर्डिंग खोजें जहां मैंने क्लाइंट के साथ मूल्य निर्धारण पर चर्चा की थी।" वह क्वेरी, टेक्स्ट के रूप में, बिना कभी रिकॉर्डिंग को ट्रांसक्राइब किए सही ऑडियो क्लिप ढूंढ लेती है। यही इसका वादा है।
उन चीज़ों को सहेजना जिन्हें शब्द कैप्चर नहीं कर सकते: व्यंग्य, निराशा, तात्कालिकता। किसी ग्राहक का सपाट लहजे में "बहुत बढ़िया, धन्यवाद" कहना, उत्साह से भरे लहजे से बहुत अलग होता है। ट्रांसक्रिप्ट्स इसे खो देते हैं। ऑडियो एम्बेडिंग्स शायद नहीं खोएंगी।
क्या यह आज इन सब के लिए पूरी तरह प्रोडक्शन-रेडी है? सच कहूं तो मुझे अभी नहीं पता। लंबे कॉल्स के लिए 80 सेकंड की ऑडियो सीमा एक बाधा है। और मैं अपने मौजूदा पाइपलाइनों को हटाने से पहले यह देखना चाहता हूं कि यह वास्तविक दुनिया के शोर-शराबे वाले ऑडियो को कैसे संभालता है।
लेकिन दिशा बिल्कुल स्पष्ट है। वॉयस एआई के लिए "पहले ट्रांसक्राइब करें, बाद में एम्बेड करें" का युग अब खत्म होने की कगार पर है। और यदि आप स्पीच डेटा के साथ कुछ भी बना रहे हैं, तो यह तकनीक अभी आपके रडार पर होनी चाहिए।
इंटीग्रेशन इकोसिस्टम: पहले दिन से तैयार
गूगल ने इसे अकेले लॉन्च नहीं किया है। Gemini Embedding 2 में पहले दिन से निम्नलिखित के साथ इंटीग्रेशन्स उपलब्ध हैं:
LangChain:
GoogleGenerativeAIEmbeddingsLlamaIndex:
GoogleGenAIEmbeddingQdrant: हाइब्रिड सर्च के लिए नामित वैक्टर (named vectors) के साथ नेटिव सपोर्ट
Weaviate: डायरेक्ट इंटीग्रेशन
ChromaDB: बिना किसी अतिरिक्त प्रयास के काम करता है
Pinecone: सर्वरलेस वेक्टर सर्च
Google Vector Search: BigQuery, AlloyDB, Cloud SQL
इसके अलावा गूगल एआई स्टूडियो में एक लाइव डेमो ऐप भी उपलब्ध है जहां आप वास्तविक समय में मल्टीमॉडल सर्च को काम करते हुए देख सकते हैं। पैट्रिक लोएबर ने इसे लॉन्च के दिन शेयर किया था।
महत्वपूर्ण माइग्रेशन नोट
यदि आप पहले से ही gemini-embedding-001 का उपयोग कर रहे हैं, तो ध्यान दें: एम्बेडिंग स्पेस आपस में असंगत हैं। आप एक ही वेक्टर स्टोर में दोनों मॉडलों की एम्बेडिंग्स को आपस में मिला नहीं सकते। जब आप अपग्रेड करेंगे तो आपको अपने मौजूदा डेटा को फिर से एम्बेड करना होगा।
इसके लिए योजना बनाएं। यह केवल "मॉडल का नाम बदलने और काम शुरू करने" जैसी स्थिति नहीं है।
क्विक स्टार्ट: 5 मिनट में एम्बेडिंग्स तैयार
अपनी एपीआई की (API key) Google AI Studio से प्राप्त करें और आप काम शुरू करने के लिए तैयार हैं।
मेरा नज़रिया
मैं पिछले कुछ समय से एम्बेडिंग मॉडल्स के साथ प्रयोग कर रहा हूं। केवल-टेक्स्ट से लेकर एकल मॉडल में वास्तव में मल्टीमॉडल एम्बेडिंग तक का यह सफर बेहद महत्वपूर्ण है। यह सिर्फ "वाह बढ़िया, एक नया मॉडल आया है" जैसा नहीं है। बल्कि यह कुछ ऐसा है जो "यह बदल देता है कि कौन सी आर्किटेक्चर अब संभव हैं"।
यह तथ्य कि अब आप यह कर सकते हैं:
कस्टमर सपोर्ट कॉल (ऑडियो) लें
बिना ट्रांसक्रिप्शन के इसे सीधे एम्बेड करें
इसे प्रोडक्ट डाक्यूमेंट्स (PDF), स्क्रीनशॉट्स (इमेज), और नॉलेज बेस आर्टिकल्स (टेक्स्ट) के साथ स्टोर करें
एक ही टेक्स्ट क्वेरी के साथ इन सब में सर्च करें
…और यह सब आसानी से काम करता है क्योंकि सब कुछ एक ही वेक्टर स्पेस में रहता है? यह हमारे पास पहले मौजूद तकनीक की तुलना में मौलिक रूप से अलग ब्लॉक है।
क्या यह एकदम सही है? नहीं। यह अभी भी प्रीव्यू में है। 80 सेकंड की ऑडियो सीमा और 6 पेज की पीडीएफ सीमा कुछ उपयोगों के लिए बाधा बन सकती है। और आप अपने वर्तमान एम्बेडिंग सेटअप से माइग्रेट करने का निर्णय लेने से पहले अपने विशिष्ट डेटा पर इसका गहन परीक्षण करना चाहेंगे।
लेकिन दिशा बिल्कुल स्पष्ट है। मल्टीमॉडल एम्बेडिंग्स ही रिट्रीवल का भविष्य हैं। और गूगल ने इसे एक एपीआई की के साथ हर डेवलपर के लिए सुलभ बना दिया है।
जाएं और इसके साथ कुछ बेहतरीन बनाएं।