आधुनिक स्पीच-टू-टेक्स्ट तकनीक और इसके उद्यम प्रभाव के भीतर
जानें कि आधुनिक स्पीच-टू-टेक्स्ट तकनीक कैसे काम करती है, इसकी वास्तविक सीमाएं क्या हैं, और उद्यम उत्पादन में उपयोग के लिए सटीकता, विलंबता और परिनियोजन का मूल्यांकन कैसे करते हैं।
हर लाइव कॉल, मीटिंग या सपोर्ट इंटरैक्शन वास्तविक समय (रियल-टाइम) में निर्णय पैदा करता है, फिर भी अधिकांश टीमें उन पर कार्रवाई करने के लिए अभी भी याददाश्त या देरी से लिखे गए नोट्स पर निर्भर रहती हैं। जब बातचीत सिस्टम द्वारा उन्हें कैप्चर करने की गति से अधिक तेज़ होती है, तो संदर्भ खो जाता है, एजेंट प्रश्नों को दोहराते हैं, और डाउनस्ट्रीम वर्कफ़्लो की गति बहुत धीमी हो जाती है। यह अंतर ठीक वही जगह है जहाँ स्पीच-टू-टेक्स्ट तकनीक अब आधुनिक ऑपरेशन्स के भीतर मौजूद है।
चूंकि आवाज़ (वॉइस) बिक्री, सहायता और कड़े नियमों वाले वर्कफ़्लो के लिए प्राथमिक इंटरफ़ेस बनती जा रही है, इसलिए सटीकता और विलंबता (लेटेंसी) को लेकर उम्मीदें बढ़ गई हैं। तेजी से बढ़ते स्पीच-टू-टेक्स्ट सर्विस प्लेटफॉर्म बाजार के 2033 तक $70 बिलियन तक पहुंचने का अनुमान है, जो दर्शाता है कि बिना अतिरिक्त कर्मचारियों के वास्तविक समय के निष्पादन को बढ़ाने के लिए स्पीच-टू-टेक्स्ट तकनीक कितनी महत्वपूर्ण हो गई है।
इस गाइड में, हम विश्लेषण करेंगे कि एंटरप्राइज़-ग्रेड STT वास्तव में कैसे काम करता है, यह कहाँ विफल होता है, और प्रोडक्शन उपयोग के लिए इसका मूल्यांकन कैसे किया जाए।
मुख्य बातें
स्पीच-टू-टेक्स्ट एक इंफ्रास्ट्रक्चर है: आधुनिक स्पीच-टू-टेक्स्ट तकनीक न केवल ट्रांसक्रिप्शन, बल्कि वास्तविक समय के निर्णय प्रणालियों का आधार है, जो सीधे एजेंट वर्कफ़्लो, ऑटोमेशन विश्वसनीयता और डाउनस्ट्रीम निष्पादन गति को प्रभावित करती है।
आर्किटेक्चर से परिणाम तय होते हैं: स्ट्रीमिंग-फर्स्ट, एंड-टू-एंड न्यूरल STT लाइव बातचीत में लगातार पुराने पाइपलाइनों से बेहतर प्रदर्शन करता है, विशेष रूप से रुकावटों, ओवरलैपिंग भाषण और टेलीफोनी-ग्रेड ऑडियो के दौरान।
सटीकता संदर्भ पर निर्भर करती है: केवल कम वर्ड एरर रेट (WER) ही पर्याप्त नहीं है; डोमेन अनुकूलन, संख्यात्मक हैंडलिंग, उच्चारण की तीव्रता और कॉन्फिडेंस स्कोरिंग प्रोडक्शन-ग्रेड उपयोगिता को निर्धारित करते हैं।
विलंबता (लेटेंसी) एक व्यावसायिक बाधा है: संवादात्मक प्रणालियों के लिए 100ms से कम समय में पहला ट्रांसक्रिप्ट मिलना महत्वपूर्ण है, जिससे एजेंट सहायता, रीयल-टाइम राउटिंग और रुकावट-जागरूक वॉयस इंटरैक्शन संभव हो पाता है।
परिनियोजन (डिप्लॉयमेंट) का विकल्प मायने रखता है: क्लाउड, ऑन-प्रिमाइस या हाइब्रिड STT डिप्लॉयमेंट सीधे डेटा नियंत्रण, अनुपालन स्थिति, लेटेंसी गारंटी और बड़े पैमाने पर दीर्घकालिक परिचालन लागत को प्रभावित करते हैं।
स्पीच-टू-टेक्स्ट तकनीक क्या है?
स्पीच-टू-टेक्स्ट तकनीक न्यूरल स्पीच रिकग्निशन सिस्टम का उपयोग करके लाइव या रिकॉर्ड किए गए ऑडियो को मशीन द्वारा पढ़े जाने योग्य टेक्स्ट में बदल देती है, जिसे वास्तविक संवादात्मक इनपुट के लिए ऑप्टिमाइज़ किया गया है, न कि स्क्रिप्टेड ऑडियो के लिए।
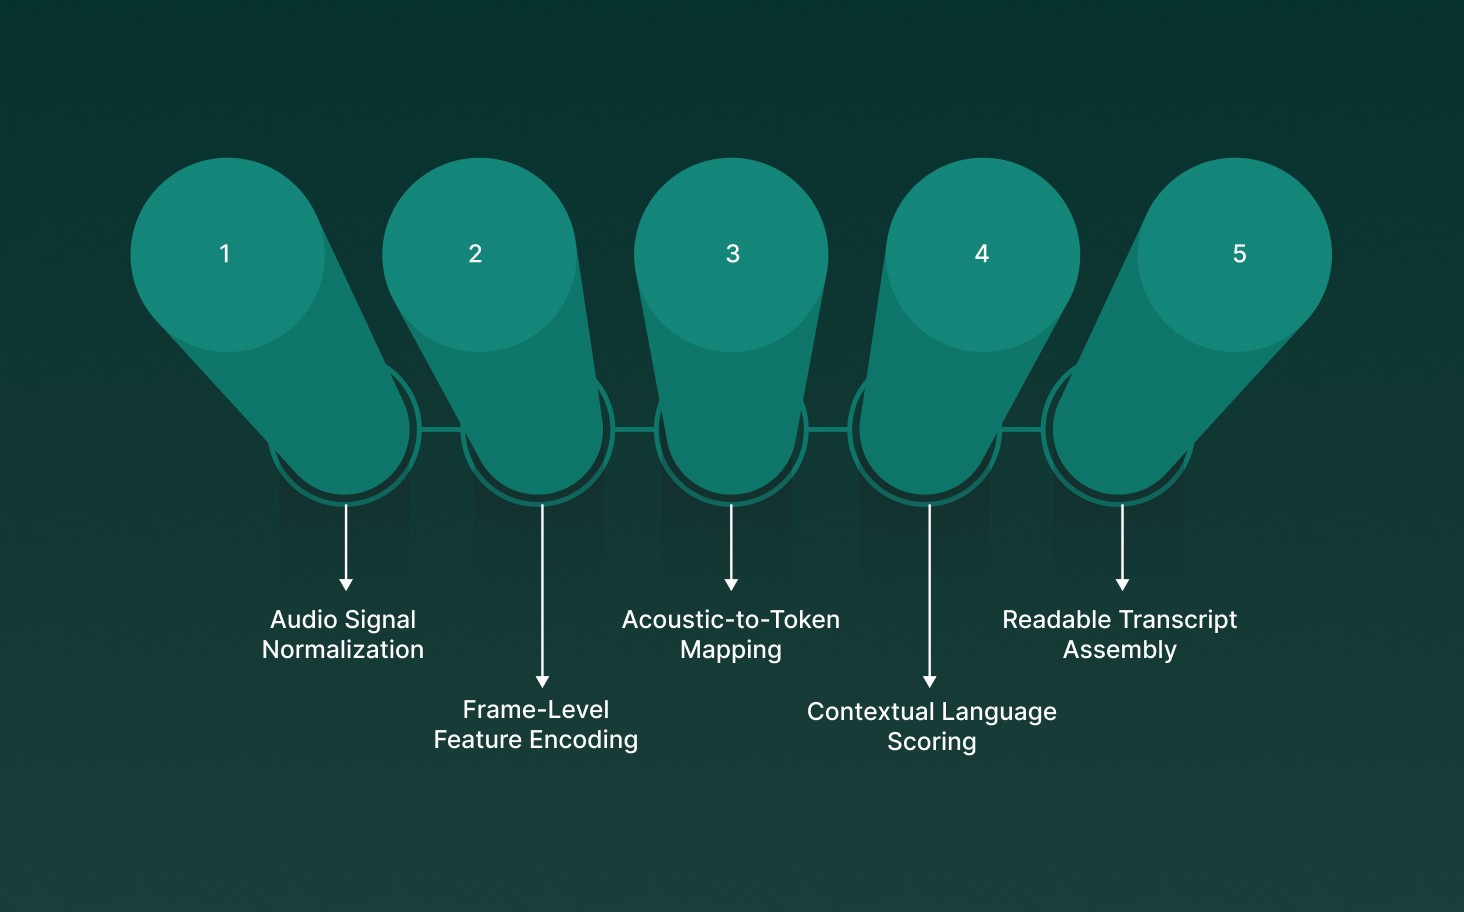
स्पीच-टू-टेक्स्ट तकनीक बारीकी से जुड़े तकनीकी स्तरों के माध्यम से काम करती है जो कच्चे साउंड को उपयोगी भाषा डेटा में बदल देते हैं:
ऑडियो सिग्नल नॉर्मलाइजेशन: अप्रत्याशित माइक्रोफ़ोन और फ़ोन-कॉल इनपुट को स्थिर करने के लिए आने वाले ऑडियो को सैंपल, डीनोइज़ और एम्प्लीट्यूड-लेवल किया जाता है।
फ्रेम-लेवल फीचर एन्कोडिंग: मिलीसेकंड ऑडियो फ्रेम को वर्णक्रमीय (स्पेक्ट्रल) विशेषताओं में परिवर्तित किया जाता है जो फोनम भेदभाव के लिए अनुकूलित होते हैं, न कि कच्चे वेवफॉर्म मिलान के लिए।
अकॉस्टिक-टू-टोकन मैपिंग: न्यूरल अकॉस्टिक मॉडल त्रुटि प्रसार को कम करने के लिए ध्वनि पैटर्न को पूरे शब्दों के बजाय सबवर्ड टोकन में अनुवादित करते हैं।
प्रासंगिक भाषा स्कोरिंग: संभाव्यतापूर्ण भाषा मॉडल आसपास के वाक्यांशों, संख्याओं और संवादात्मक संदर्भ का उपयोग करके अस्पष्टता को हल करते हैं।
पठनीय ट्रांसक्रिप्ट असेंबली: डिकोडिंग परतें एजेंटों, एनालिटिक्स या वर्कफ़्लो में डाउनस्ट्रीम उपयोग के लिए विराम चिन्ह, केसिंग और टाइमिंग मेटाडेटा लागू करती हैं।
इसके मूल में, स्पीच-टू-टेक्स्ट तकनीक एक आधारभूत परत के रूप में कार्य करती है जो वॉयस-संचालित प्रणालियों को वास्तविक समय में बोले गए इनपुट पर सोचने, प्रतिक्रिया देने और कार्य करने की अनुमति देती है।
यदि आप ऐसे वॉयस अनुभव बना रहे हैं जिन्हें वास्तविक समय में सुनने और प्रतिक्रिया देने की आवश्यकता है, तो एक्सप्लोर करें कि कैसे स्पीच-टू-टेक्स्ट और टेक्स्ट-टू-स्पीच तकनीक: इंटरैक्शन को स्मार्ट बनाना प्राकृतिक, प्रोडक्शन-रेडी बातचीत को सक्षम करने के लिए मिलकर काम करते हैं।
स्पीच-टू-टेक्स्ट सिस्टम के प्रकार
स्पीच-टू-टेक्स्ट सिस्टम इस बात के आधार पर भिन्न होते हैं कि ऑडियो को कैसे मॉडल किया जाता है, वक्ताओं को कैसे संभाला जाता है, और टेक्स्ट कितनी जल्दी उत्पन्न होता है, जो सीधे सटीकता, लेटेंसी और प्रोडक्शन विश्वसनीयता को प्रभावित करता है।
आर्किटेक्चरल स्पीच-टू-टेक्स्ट सिस्टम
आर्किटेक्चरल सिस्टम यह परिभाषित करते हैं कि ऑडियो सिग्नलों को टेक्स्ट में कैसे बदला जाता है, जो प्रासंगिक जागरूकता, त्रुटि प्रसार और वास्तविक संवादात्मक परिस्थितियों में मॉडल कितनी अच्छी तरह प्रदर्शन करते हैं, यह निर्धारित करते हैं।
अकॉस्टिक-फ़ोनेटिक पाइपलाइन: ऑडियो को HMM और DNN का उपयोग करके फोनम में मैप किया जाता है, फिर शब्दों में जोड़ा जाता है, जिससे शोर के प्रति संवेदनशील और त्रुटियों को बढ़ाने वाली कमजोर पाइपलाइनें बनती हैं।
एंड-टू-एंड न्यूरल मॉडल: एकल न्यूरल नेटवर्क सीधे ऑडियो-टू-टेक्स्ट मैपिंग सीखते हैं, जिससे चरणों के बीच का अंतर कम होता है और लंबी, प्राकृतिक बातचीत में प्रासंगिक निरंतरता में सुधार होता है।
विशेषीकृत ASR आर्किटेक्चर: CTC, ट्रांसड्यूसर और एनकोडर-डिकोडर मॉडल रीयल-टाइम या बैच ट्रांसक्रिप्शन आवश्यकताओं के आधार पर संरेखण, स्ट्रीमिंग व्यवहार और डिकोडिंग गति को अनुकूलित करते हैं।
स्पीकर रिकग्निशन-आधारित सिस्टम
स्पीकर रिकग्निशन डिज़ाइन यह निर्धारित करता है कि क्या कोई सिस्टम एक आवाज़ के अनुकूल बनता है या फोन, हेडसेट और बदलते अकॉस्टिक वातावरण में अप्रत्याशित कॉल करने वालों को विश्वसनीय रूप से संभालता है।
स्पीकर-डिपेंडेंट सिस्टम: मॉडल एकल वॉयस प्रोफाइल के लिए ट्यून किए जाते हैं, जिससे डिक्टेशन सटीकता में सुधार होता है लेकिन अपरिचित लहजे या बदलते माइक्रोफ़ोन के संपर्क में आने पर विफल हो जाते हैं।
स्पीकर-इंडिपेंडेंट सिस्टम: मॉडल पूर्व प्रशिक्षण के बिना वक्ताओं के बीच सामान्यीकरण करते हैं, जिससे वे फोन स्पीच रिकग्निशन और उच्च-मात्रा वाले ग्राहक इंटरैक्शन के लिए उपयुक्त हो जाते हैं।
एडेप्टिव स्पीकर मॉडलिंग: रनटाइम स्पीकर एम्बेडिंग डिकोडिंग को गतिशील रूप से समायोजित करती है, जिससे स्पष्ट उपयोगकर्ता नामांकन या पुनप्रशिक्षण के बिना बातचीत के बीच में सटीकता में सुधार होता है।
प्रोसेसिंग और लेटेंसी-आधारित सिस्टम
प्रोसेसिंग मोड यह नियंत्रित करता है कि टेक्स्ट कितनी जल्दी दिखाई देता है, जो सीधे संवादात्मक प्रवाह, रुकावटों को संभालने और लाइव वॉयस-संचालित अनुप्रयोगों में उपयोगिता को प्रभावित करता है।
स्ट्रीमिंग स्पीच-टू-टेक्स्ट: ऑडियो को क्रमिक रूप से डिकोड किया जाता है, भाषण जारी रहने के दौरान आंशिक ट्रांसक्रिप्ट जारी किए जाते हैं, जिससे रीयल-टाइम एजेंट सहायता और लाइव संवादात्मक AI संभव होता है।
बैच स्पीच-टू-टेक्स्ट: कैप्चर करने के बाद पूर्ण ऑडियो फ़ाइलों को संसाधित किया जाता है, जिससे गहन संदर्भ विश्लेषण की अनुमति मिलती है, लेकिन ये इंटरैक्टिव या लेटेंसी-सेंसिटिव उपयोग के मामलों के लिए अनुपयुक्त हैं।
सिंक्रोनस शॉर्ट-फॉर्म रिकग्निशन: बहुत छोटे ऑडियो सेगमेंट को तुरंत डिकोड किया जाता है, जिसे कमांड, वेक वर्ड्स और ब्रॉडकास्ट कैप्शनिंग परिदृश्यों के लिए अनुकूलित किया जाता है।
डिलिवरी और परिनियोजन (डिप्लॉयमेंट) मॉडल
डिप्लॉयमेंट मॉडल परिचालन नियंत्रण, स्केलेबिलिटी, अनुपालन स्थिति और मौजूदा एंटरप्राइज़ सिस्टम में स्पीच-टू-टेक्स्ट कितनी मजबूती से एकीकृत होता है, यह निर्धारित करते हैं।
क्लाउड स्पीच-टू-टेक्स्ट API: प्रबंधित API त्वरित ऑनबोर्डिंग, इलास्टिक स्केलिंग और उन्नत सुविधाएँ प्रदान करते हैं लेकिन डेटा लोकलाइजेशन और लेटेंसी ट्रेड-ऑफ़ पेश करते हैं।
सेल्फ-होस्टेड और ओपन मॉडल्स: टीमें स्वामित्व वाले इंफ्रास्ट्रक्चर पर मॉडल चलाती हैं, जिससे परिचालन जटिलता की कीमत पर डेटा और ट्यूनिंग पर नियंत्रण प्राप्त होता है।
एम्बेडेड डिवाइस स्पीच रिकग्निशन: स्पीच रिकग्निशन सीधे उपकरणों पर चलता है, जिससे लेटेंसी न्यूनतम होती है लेकिन यह कंप्यूट, मेमोरी और अपडेट लचीलेपन द्वारा सीमित होता.
स्पीच-टू-टेक्स्ट सिस्टम आपस में विनिमेय नहीं हैं; आर्किटेक्चर, स्पीकर हैंडलिंग और प्रोसेसिंग मोड को लेटेंसी लक्ष्यों, सटीकता आवश्यकताओं और वास्तविक प्रोडक्शन वर्कलोड के साथ संरेखित होना चाहिए।
स्पीच-टू-टेक्स्ट तकनीक के एंटरप्राइज़ उपयोग के मामले
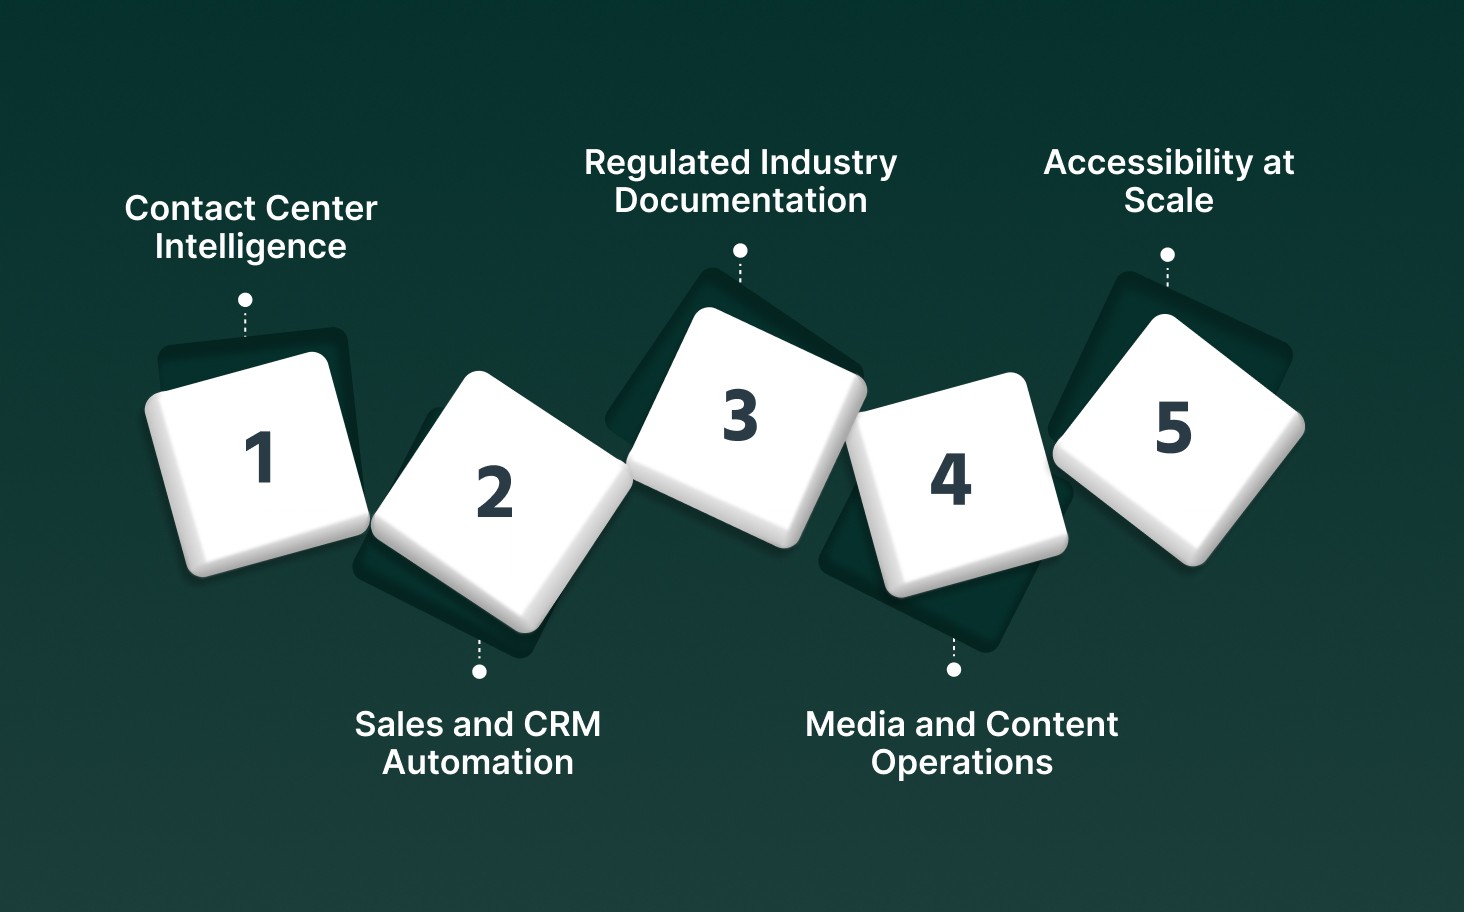
एंटरप्राइज़ स्पीच-टू-टेक्स्ट तकनीक उच्च-मात्रा वाले वॉयस इंटरैक्शन को संरचित डेटा में परिवर्तित करती है जो महत्वपूर्ण व्यावसायिक वर्कफ़्लो में ऑटोमेशन, अनुपालन और रीयल-टाइम निर्णय समर्थन को संचालित करती है।
स्पीच-टू-टेक्स्ट तकनीक के एंटरप्राइज़ डिप्लॉयमेंट आम तौर पर निम्नलिखित प्रोडक्शन-ग्रेड परिदृश्यों पर ध्यान केंद्रित करते हैं:
कॉन्टैक्ट सेंटर इंटेलिजेंस: लाइव कॉल ट्रांसक्रिप्शन बिना बैच प्रोसेसिंग या मैन्युअल समीक्षा की प्रतीक्षा किए एजेंट-असिस्ट सिस्टम, सेंटीमेंट स्कोरिंग और पोस्ट-कॉल एनालिटिक्स को फीड करता है।
बिक्री और CRM ऑटोमेशन: वॉयस नोट्स और ग्राहकों की बातचीत को तुरंत ट्रांसक्राइब किया जाता है और टाइमस्टैम्प, स्पीकर लेबल और एक्शन-आइटम निष्कर्षण के साथ सीधे CRM रिकॉर्ड में लिखा जाता है।
विनियमित उद्योग प्रलेखन (डॉक्यूमेंटेशन): डोमेन-प्रशिक्षित मॉडल ऑडिट, अनुपालन और रिकॉर्ड-रिटेंशन आवश्यकताओं को पूरा करने के लिए पर्याप्त रूप से चिकित्सा, कानूनी और वित्तीय शब्दावली को सटीक रूप से कैप्चर करते हैं।
मीडिया और कंटेंट ऑपरेशन्स: कैप्शनिंग, मॉडरेशन, स्थानीयकरण और डाउनस्ट्रीम कंटेंट विश्लेषण पाइपलाइनों के लिए ऑडियो और वीडियो स्ट्रीम को खोजने योग्य टेक्स्ट में ट्रांसक्राइब किया जाता है।
पैमाने पर सुलभता (एक्सेसिबिलिटी): लाइव एंटरप्राइज़ इंटरैक्शन के दौरान रीयल-टाइम कैप्शन और ट्रांसक्रिप्ट सुनने, भाषा या सीखने में भिन्नता वाले कर्मचारियों और ग्राहकों का समर्थन करते हैं।
सभी उद्योगों में, स्पीच-टू-टेक्स्ट तकनीक एक कनेक्टिव लेयर के रूप में कार्य करती है जो बोली जाने वाली बातचीत को परिचालन डेटा में बदल देती है जिस पर उद्यम वास्तविक समय में भरोसा कर सकते हैं, खोज सकते हैं और कार्रवाई कर सकते हैं।
आधुनिक स्पीच-टू-टेक्स्ट में सटीकता, भाषा समर्थन और डोमेन अनुकूलन
आधुनिक स्पीच-टू-टेक्स्ट सिस्टम लाइव, शोरगुल वाले और उद्योग-विशिष्ट संवादात्मक वातावरण में विश्वसनीय रूप से प्रदर्शन करने के लिए ट्रांसक्रिप्शन सटीकता, बहुभाषी कवरेज और डोमेन अनुकूलन को संतुलित करते हैं।
आधुनिक एंटरप्राइज़ STT प्रदर्शन निम्नलिखित बारीकी से जुड़े तकनीकी आयामों से आकार लेता है:
सटीकता माप फ्रेमवर्क: वर्ड एरर रेट, डायराइजेशन एरर, और टाइमस्टैम्प एलाइनमेंट मेट्रिक्स वास्तविक कॉल स्थितियों के तहत ट्रांसक्रिप्शन विश्वसनीयता को मापते हैं, न कि साफ लैब ऑडियो के तहत।
लेटेंसी-सटीकता ट्रेडऑफ़: स्ट्रीमिंग मॉडल एक सेकंड से भी कम समय में प्रतिक्रिया देने के लिए लुकअहेड संदर्भ का त्याग करते हैं, जिससे लाइव बातचीत के दौरान सटीकता के नुकसान से बचने के लिए आर्किटेक्चरल ऑप्टिमाइज़ेशन की आवश्यकता होती है।
बहुभाषी और उच्चारण हैंडलिंग: भाषा पहचान, उच्चारण सामान्यीकरण, और कोड-स्विचिंग समर्थन विफलता को रोकते हैं जब वक्ता भाषाओं को मिलाते हैं या वाक्य के बीच में उच्चारण बदलते हैं।
डोमेन शब्दावली अनुकूलन: फाइन-ट्यून्ड भाषा परतें और इंजेक्ट की गई शब्दावलियां वित्त और स्वास्थ्य सेवा में सामान्य संक्षिप्ताक्षरों, संख्याओं और विनियमित शब्दावली की पहचान में सुधार करती हैं।
कॉन्फिडेंस और एरर सिग्नलिंग: प्रति-टोकन कॉन्फिडेंस स्कोरिंग डाउनस्ट्रीम सिस्टम को अनिश्चितता को चिह्नित करने, फ़ॉलबैक ट्रिगर करने, या सत्यापन के लिए संवेदनशील ट्रांसक्रिप्ट को रूट करने की अनुमति देती है।
व्यवहार में, स्पीच-टू-टेक्स्ट सिस्टम केवल तभी अच्छा प्रदर्शन करते हैं जब सटीकता, भाषा हैंडलिंग और डोमेन अनुकूलन को उस विशिष्ट संवादात्मक वास्तविकता के लिए एक साथ इंजीनियर किया जाता है जिसमें वे काम करते हैं।
यदि आप प्रोडक्शन-ग्रेड सिस्टम के लिए प्रतिबद्ध होने से पहले मुफ्त टूल की तुलना कर रहे हैं, तो 2026 में मूल्यांकन करने के लिए शीर्ष 7 मुफ्त वॉयस-टू-टेक्स्ट सॉफ्टवेयर से शुरुआत करें।
सुलभता (एक्सेसिबिलिटी) और समावेशी संचार के लिए स्पीच-टू-टेक्स्ट
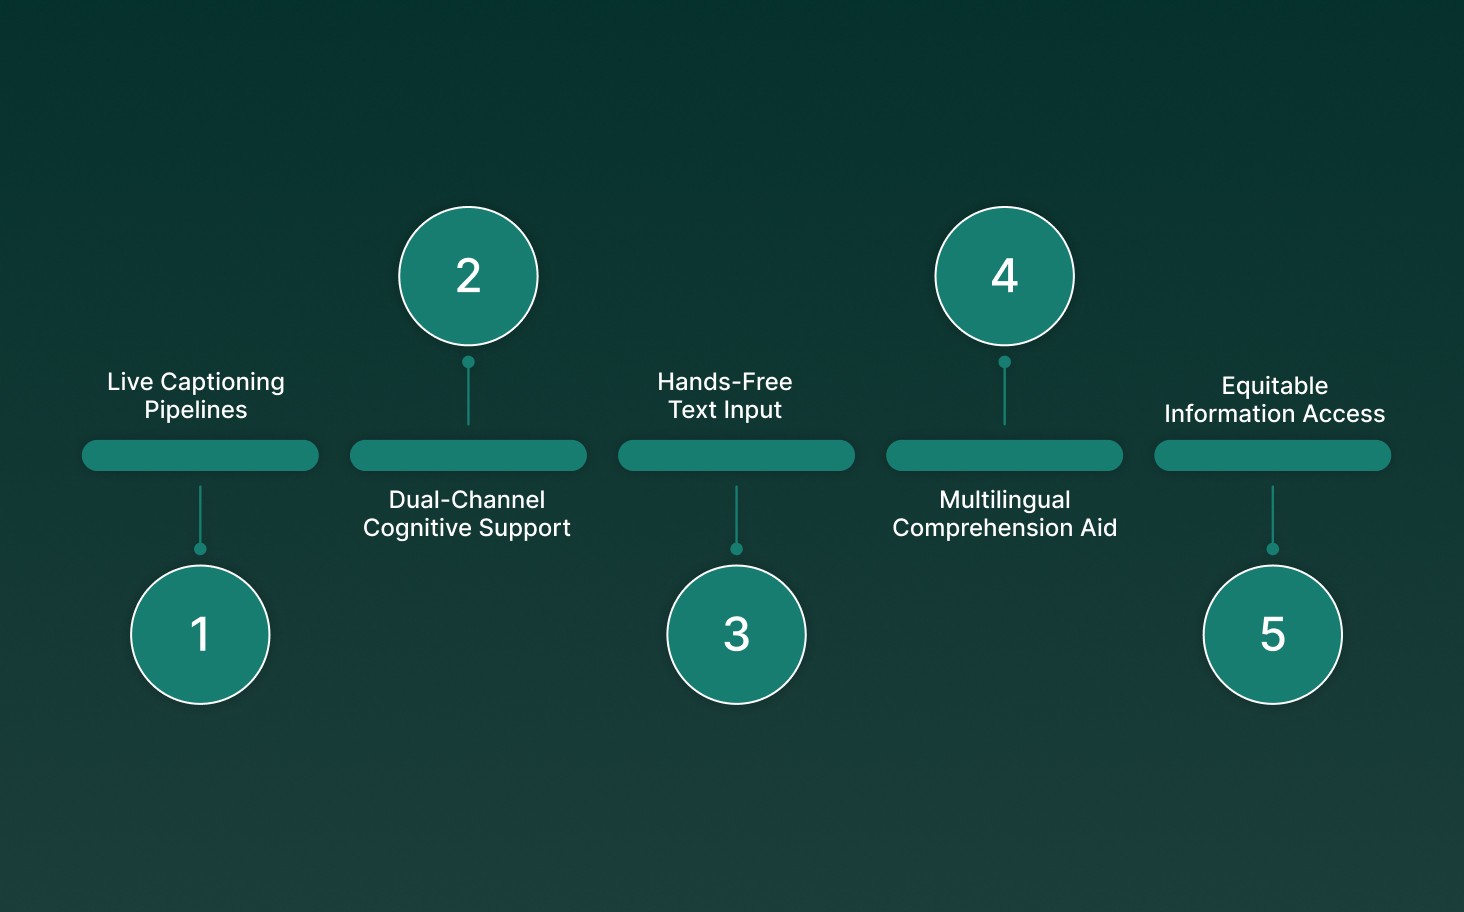
स्पीच-टू-टेक्स्ट लाइव भाषण को पठनीय टेक्स्ट स्ट्रीम में परिवर्तित करके समावेशी संचार की अनुमति देता है जो सुनने, संज्ञानात्मक, शारीरिक और भाषा-संबंधी पहुंच आवश्यकताओं में भागीदारी का समर्थन करता है।
समावेशी, वास्तविक दुनिया के वातावरण में, स्पीच-टू-टेक्स्ट निम्नलिखित तकनीकी क्षमताओं के माध्यम से सुलभता का समर्थन करता है:
लाइव कैप्शनिंग पाइपलाइन: स्ट्रीमिंग STT मीटिंग्स और इवेंट्स के लिए कम-लेटेंसी कैप्शन उत्पन्न करता है, जिससे टाइमिंग संरेखण सुरक्षित रहता है ताकि प्रतिभागी ऑडियो निर्भरता के बिना बातचीत का पालन कर सकें।
डबल-चैनल कॉग्निटिव सपोर्ट: सिंक्रोनाइज़्ड ऑडियो और टेक्स्ट आउटपुट डिस्लेक्सिया वाले उपयोगकर्ताओं के लिए डिकोडिंग लोड को कम करके और शॉर्ट-टर्म रिकॉल में सुधार करके समझ को सुदृढ़ करते हैं।
हैंड्स-फ्री टेक्स्ट इनपुट: डिक्टेशन-ग्रेड STT कीबोर्ड को वॉयस इनपुट से बदल देता है, जिससे गतिशीलता सीमाओं वाले उपयोगकर्ताओं को टेक्स्ट-आधारित सिस्टम बनाने, संपादित करने और नेविगेट करने की अनुमति मिलती है।
बहुभाषी समझ सहायता: रीयल-टाइम ट्रांसक्रिप्शन गैर-देशी वक्ताओं के लिए संवादात्मक गति को धीमा कर देता है और खोजने योग्य ट्रांसक्रिप्ट के माध्यम से अपरिचित शब्दों की बाद में समीक्षा की अनुमति देता है।
समान सूचना पहुंच: स्वचालित ट्रांसक्रिप्शन बोले गए कंटेंट के टिकाऊ रिकॉर्ड बनाता है, यह सुनिश्चित करता है कि अनुपस्थित प्रतिभागियों को सारांश पर निर्भरता के बिना समान जानकारी प्राप्त हो।
जब रीयल-टाइम सटीकता और कम लेटेंसी के लिए इंजीनियर किया जाता है, तो स्पीच-टू-टेक्स्ट एक आधारभूत सुलभता परत बन जाता है जो बोले जाने वाले संचार को सभी के लिए समावेशी, खोजने योग्य और उपयोगी बनाए रखने की अनुमति देता है।
यदि आप ऐसे वॉयस एजेंटों का मूल्यांकन कर रहे हैं जो विभिन्न क्षेत्रों और भाषाओं में विश्वसनीय रूप से काम कर सकते हैं, तो बहुभाषी क्षमताओं वाले शीर्ष 10 AI वॉयस एजेंट्स 2025 पर करीब से नज़र डालें।
स्पीच टू टेक्स्ट APIs और सिस्टम इंटीग्रेशन
स्पीच-टू-टेक्स्ट API प्रोडक्शन सिस्टम में रीयल-टाइम ट्रांसक्रिप्शन को एम्बेड करते हैं, जिससे एप्लिकेशन लाइव ऑडियो ग्रहण कर सकते हैं, संरचित भाषा डेटा निकाल सकते हैं और प्रोग्रामेटिक रूप से डाउनस्ट्रीम क्रियाओं को ट्रिगर कर सकते हैं।
एंटरप्राइज़ स्पीच-टू-टेक्स्ट इंटीग्रेशन आमतौर पर निम्नलिखित सिस्टम-स्तरीय घटकों पर निर्भर करते हैं:
स्ट्रीमिंग API इंटरफेस: WebSocket-आधारित STT एंडपॉइंट निरंतर ऑडियो फ्रेम स्वीकार करते हैं और आंशिक ट्रांसक्रिप्ट उत्सर्जित करते हैं, जिससे लाइव एजेंट सहायता, व्यवधान प्रबंधन और संवादात्मक स्थिति अपडेट संभव होते हैं।
बैच ट्रांसक्रिप्शन पाइपलाइन: REST-आधारित API संग्रहीत ऑडियो को असिंक्रोनस रूप से संसाधित करते हैं, टाइमस्टैम्प वाले ट्रांसक्रिप्ट लौटाते हैं जो एनालिटिक्स, अनुपालन समीक्षा और पोस्ट-call प्रोसेसिंग के लिए अनुकूलित होते हैं।
SDK और रनटाइम सपोर्ट: भाषा-विशिष्ट SDK प्रोडक्शन सेवाओं के भीतर प्रमाणीकरण, ऑडियो चंकिंग, पुनः प्रयास और बैकप्रेशर नियंत्रण का प्रबंधन करते हैं।
स्ट्रक्चर्ड आउटपुट स्कीमा: JSON प्रतिक्रियाओं में एनालिटिक्स, CRM या ऑटोमेशन इंजन में सीधे इनपुट के लिए शब्द-स्तरीय टाइमिंग, स्पीकर लेबल और कॉन्फिडेंस स्कोर शामिल होते हैं।
वर्कफ़्लो ऑर्केस्ट्रेशन हुक्स: ट्रांसक्राइब किया गया टेक्स्ट बिना किसी मैन्युअल हस्तक्षेप के टिकट निर्माण, इंटेंट राउटिंग, सारांश या डेटाबेस अपडेट जैसे डाउनस्ट्रीम लॉजिक को ट्रिगर करता है।
जब स्पीच-टू-टेक्स्ट API को प्लगइन्स के बजाय इंफ्रास्ट्रक्चर के रूप में डिज़ाइन किया जाता है, तो वे एंटरप्राइज़ सिस्टम में सफाई से एकीकृत हो जाते हैं और बड़े पैमाने पर विश्वसनीय, रीयल-टाइम वॉयस-संचालित वर्कफ़्लो का समर्थन करते हैं।
स्पीच-टू-टेक्स्ट की सीमाएँ और चुनौतियाँ
स्पीच-टू-टेक्स्ट सिस्टम तकनीकी और परिचालन बाधाओं का सामना करते हैं जो वास्तविक दुनिया के वातावरण में विश्वसनीयता को प्रभावित करते हैं, विशेष रूप से तब जब ऑडियो गुणवत्ता, भाषा जटिलता और लेटेंसी आवश्यकताएं आपस में टकराती हैं।
चुनौती क्षेत्र | व्यवहार में क्या टूटता है | उत्पादन में यह क्यों मायने रखता है |
शोरगुल वाला और कम-बैंडविड्थ ऑडियो | पृष्ठभूमि का शोर, कॉल कम्प्रेशन और 8–16kHz टेलीफोनी ऑडियो फोनम को विकृत करते हैं और मॉडल का विश्वास कम करते हैं। | कॉन्टैक्ट सेंटरों और फील्ड रिकॉर्डिंग्स में ट्रांसक्रिप्शन त्रुटियां तेजी से बढ़ती हैं जहां साफ ऑडियो अवास्तविक है। |
ओवरलैपिंग और तेज़ भाषण | एक साथ बोलने वाले और तेज़ बारी-बारी से बोलना टोकन संरेखण और डायराइजेशन सीमाओं को भ्रमित करते हैं। | मल्टी-स्पीकर कॉल अपनी एट्रिब्यूशन सटीकता खो देते हैं, जिससे एनालिटिक्स, अनुपालन लॉग और एजेंट-असिस्ट वर्कफ़्लो टूट जाते हैं। |
उच्चारण और बोली परिवर्तनशीलता | क्षेत्रीय उच्चारण और अनौपचारिक भाषण प्रमुख प्रशिक्षण वितरण से भिन्न होते हैं। | मॉडल उच्च-संसाधन उच्चारणों की ओर झुकते हैं, जिससे वैश्विक उपयोगकर्ता आधारों में असमान सटीकता होती है। |
डोमेन-विशिष्ट भाषा | संक्षिप्ताक्षर, संख्याएं और शब्दजाल सामान्य भाषा मॉडल के दायरे से बाहर हो जाते हैं। | विनियमित उद्योगों को महत्वपूर्ण ट्रांसक्रिप्शन त्रुटियों से बचने के लिए फाइन-ट्यूनिंग या शब्दावली इंजेक्शन की आवश्यकता होती है। |
लेटेंसी बनाम सटीकता समझौता | स्ट्रीमिंग मॉडल देरी को कम करने के लिए संदर्भ को सीमित करते हैं, जिससे आंशिक या सुधारे गए आउटपुट बढ़ जाते. | संवादात्मक प्रणालियों को स्थिर, उपयोगी ट्रांसक्रिप्ट के साथ रीयल-टाइम जवाबदेही को संतुलित करना चाहिए। |
परिचालन ओवरहेड | ओपन मॉडल को होस्टिंग, ट्यूनिंग और मॉनिटरिंग की आवश्यकता होती है; API लागत और डेटा बाधाएं जोड़ते हैं। | टीमों को नियंत्रण, स्केलेबिलिटी, अनुपालन स्थिति और स्वामित्व की कुल लागत के बीच चयन करना होगा। |
स्पीच-टू-टेक्स्ट सबसे अच्छा तब काम करता है जब इसकी सीमाओं का डिज़ाइन के समय ही अनुमान लगा लिया जाए, जिसमें वास्तविक परिचालन स्थितियों से मेल खाने के लिए आर्किटेक्चर, डिप्लॉयमेंट और डोमेन अनुकूलन को चुना जाता है।
यदि आप शुरुआत से वॉयस वर्कफ़्लो बना रहे हैं और STT पाइपलाइनों पर पूरा नियंत्रण चाहते हैं, तो पायथन में वॉयस AI बनाएं: पूर्ण स्पीच-टू-टेक्स्ट डेवलपर गाइड (2026) से शुरुआत करें।
स्पीच रिकग्निशन सॉफ्टवेयर में नवीनतम प्रगति
आधुनिक स्पीच रिकग्निशन सॉफ्टवेयर ट्रांसक्रिप्शन इंजन से कम-लेटेंसी, स्ट्रीमिंग भाषा प्रणालियों में विकसित हो गया है जो वास्तविक दुनिया के संवादात्मक ऑडियो के लिए अनुकूलित विशेष न्यूरल आर्किटेक्चर पर निर्मित हैं।
प्रोडक्शन-ग्रेड स्पीच रिकग्निशन सिस्टम को आकार देने वाली हालिया तकनीकी प्रगति में निम्नलिखित मुख्य नवाचार शामिल हैं:
न्यूरल स्ट्रीमिंग आर्किटेक्चर: ट्रांसड्यूसर और चंक-आधारित ट्रांसफार्मर मॉडल ऑडियो को क्रमिक रूप से डिकोड करते हैं, पूरे कथन के बफरिंग विलंब से बचते हुए फ्रेमों में संदर्भ बनाए रखते हैं।
आंशिक परिकल्पना स्थिरीकरण: कॉन्फिडेंस-वेटेड टोकन लॉकिंग लाइव स्ट्रीम में ट्रांसक्रिप्ट के उतार-चढ़ाव को कम करती है, जिससे डाउनस्ट्रीम सिस्टम को लगातार रीराइट के बिना शुरुआती परिणामों पर काम करने की अनुमति मिलती है।
उन्नत अकॉस्टिक फ्रंटएंड: सीखे गए स्पेक्ट्रल एनकोडर हस्तनिर्मित MFCC पाइपलाइनों की जगह लेते हैं, जिससे टेलीफोनी कम्प्रेशन, माइक्रोफ़ोन भिन्नता और पृष्ठभूमि शोर के खिलाफ मजबूती में सुधार होता है।
संयुक्त ASR-NLP कपलिंग: स्पीच डिकोडर्स पोस्ट-प्रोसेसिंग के बजाय डिकोडिंग के दौरान होमोफ़ोन, संख्याओं और संस्थाओं को स्पष्ट करने के लिए हल्के भाषा तर्क परतों को एकीकृत करते हैं।
एडेप्टिव रनटाइम ऑप्टिमाइज़ेशन: डायनेमिक बीम साइज़िंग और कंप्यूट थ्रॉटलिंग ऑडियो जटिलता और लेटेंसी लक्ष्यों के आधार पर रीयल-टाइम में अनुमान लागत को समायोजित करते हैं।
ये प्रगति आधुनिक स्पीच रिकग्निशन सॉफ्टवेयर को रीयल-टाइम, संदर्भ-जागरूक प्रणाली के रूप में काम करने की अनुमति देती है जो गति या विश्वसनीयता से समझौता किए बिना संवादात्मक AI, एनालिटिक्स और ऑटोमेशन का समर्थन करती है।
यदि आप मोबाइल उत्पादों में रीयल-टाइम वॉयस इंटरैक्शन ला रहे हैं, तो यह व्यावहारिक मार्गदर्शिका दिखाती है कि रिएक्ट नेटिव के साथ AI वॉयस चैटबॉट बनाते समय क्या आवश्यक है।
सही स्पीच-टू-टेक्स्ट तकनीक चुनना
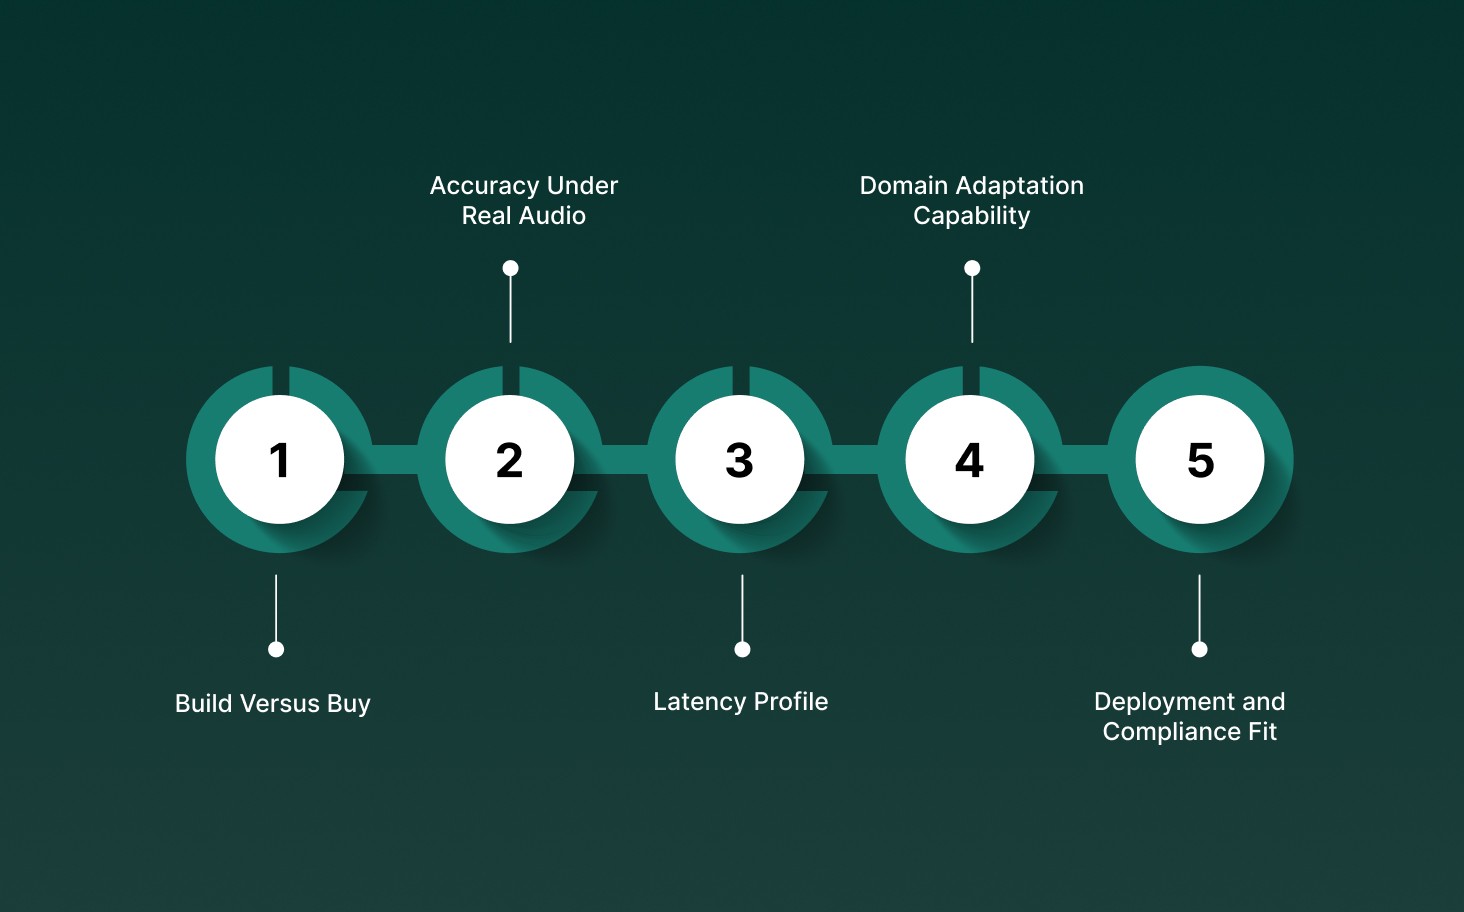
स्पीच-टू-टेक्स्ट तकनीक चुनने का अर्थ है सटीकता, लेटेंसी, डिप्लॉयमेंट मॉडल और डोमेन आवश्यकताओं को इस बात के साथ संरेखित करना कि वास्तव में प्रोडक्शन सिस्टम के भीतर वॉयस का उपयोग कैसे किया जाता है।
स्पीच-टू-टेक्स्ट विकल्पों का मूल्यांकन करते समय, टीमें आमतौर पर निम्नलिखित तकनीकी निर्णय कारकों का आकलन करती हैं:
बिल्ड बनाम बाय: ओपन-सोर्स मॉडल आर्किटेक्चरल नियंत्रण प्रदान करते हैं लेकिन अनुमान अनुकूलन, स्केलिंग और मॉनिटरिंग के स्वामित्व की आवश्यकता होती है, जबकि प्रबंधित API अनुकूलन की कीमत पर परिचालन भार को कम करते हैं।
वास्तविक ऑडियो के तहत सटीकता: साफ बेंचमार्क पर वर्ड एरर रेट टेलीफोनी ऑडियो, ओवरलैपिंग भाषण, उच्चारण और डोमेन-विशिष्ट शब्दावली पर प्रदर्शन की तुलना में कम मायने रखता है।
लेटेंसी प्रोफाइल: स्ट्रीमिंग सिस्टम को लाइव बातचीत के लिए 300ms से कम प्रतिक्रिया बजट को पूरा करना चाहिए, जबकि बैच सिस्टम गहराई, संदर्भ और पोस्ट-कॉल विश्लेषण के लिए अनुकूलित होते हैं।
डोमेन अनुकूलन क्षमता: फाइन-ट्यूनिंग, शब्दावली इंजेक्शन और संख्यात्मक हैंडलिंग यह निर्धारित करते हैं कि मॉडल वित्त, स्वास्थ्य सेवा और कानूनी वर्कफ़्लो जैसे विनियमित वातावरण में टिक पाते हैं या नहीं।
डिप्लॉयमेंट और अनुपालन अनुकूलता: क्लाउड, सिंगल-टेनेंट, या ऑन-प्रिमाइस डिप्लॉयमेंट विकल्प डेटा लोकलाइजेशन, अनुपालन स्थिति और दीर्घकालिक परिचालन लागत को प्रभावित करते हैं।
सही स्पीच-टू-टेक्स्ट तकनीक वह है जो आपकी ऑडियो स्थितियों, लेटेंसी सहनशीलता और डोमेन जटिलता के लिए इंजीनियर की गई है, न कि वह जिसमें कागज पर सबसे अधिक विशेषताएं हैं।
पल्स STT आधुनिक स्पीच-टू-टेक्स्ट के प्रति कैसे दृष्टिकोण रखता है
पल्स STT को रीयल-टाइम, एंटरप्राइज़-ग्रेड स्पीच रिकग्निशन के लिए इंजीनियर किया गया है, जो लाइव संवादात्मक वर्कलोड के लिए अल्ट्रा-लो लेटेंसी, बहुभाषी सटीकता और प्रोडक्शन-रेडी इंटेलिजेंस का संयोजन करता है।
आधुनिक स्पीच-टू-टेक्स्ट के लिए पल्स STT का दृष्टिकोण निम्नलिखित सिस्टम-स्तरीय क्षमताओं द्वारा परिभाषित किया गया है:
स्ट्रीमिंग-फर्स्ट आर्किटेक्चर: 70ms से कम समय में पहले ट्रांसक्रिप्ट के साथ ऑडियो को क्रमिक रूप से डिकोड किया जाता है, जिससे लाइव सिस्टम वक्ताओं के वाक्य समाप्त करने से पहले प्रतिक्रिया दे सकते हैं।
भाषा-जागरूक डिकोडिंग: स्वचालित भाषा पहचान और कोड-स्विच हैंडलिंग डिकोडिंग पथों को गतिशील रूप से समायोजित करते हैं क्योंकि वक्ता बातचीत के बीच में भाषा बदलते हैं।
टेलीफोनी बाधाओं के तहत सटीकता: मॉडल्स को कंप्रेस्ड 8kHz और 16kHz ऑडियो के लिए ऑप्टिमाइज़ किया गया है, जिससे वास्तविक कॉल-सेंटर स्थितियों में कम वर्ड एरर रेट बनी रहती है।
एम्बेडेड स्पीच इंटेलिजेंस: स्पीकर डायराइजेशन, भावना पहचान, अपशब्द फ़िल्टरिंग और वर्ड बूस्टिंग डिकोडिंग के दौरान लागू किए जाते हैं, बाद में अलग से नहीं जोड़े जाते।
एंटरप्राइज़ डिप्लॉयमेंट लचीलापन: पल्स STT क्लाउड या पूरी तरह से ऑन-प्रिमाइस वातावरण में चलता है, जो कड़े लेटेंसी, डेटा लोकलाइजेशन और अनुपालन आवश्यकताओं को पूरा करता है।
स्पीच-टू-टेक्स्ट को ऑफलाइन ट्रांसक्रिप्शन के बजाय रीयल-टाइम इंफ्रास्ट्रक्चर के रूप में मानकर, पल्स STT एंटरप्राइज़ पैमाने पर अनुमानित सटीकता और प्रतिक्रिया प्रदान करता है।
निष्कर्ष
स्पीच-टू-टेक्स्ट चुपचाप एक सहायक उपकरण से एक परिचालन बुनियादी ढांचे (इंफ्रास्ट्रक्चर) में स्थानांतरित हो गया है। जब यह विश्वसनीय, तेज़ और संदर्भ-जागरूक होता है, तो टीमें देर से प्रतिक्रिया देना बंद कर देती हैं और वास्तविक समय में कार्य करना शुरू कर देती हैं, जिससे बातचीत अनसुलझे मामलों के बजाय निर्णयों में बदल जाती है।
यह अंतर इस बात से आता है कि सिस्टम को कैसे बनाया और तैनात किया जाता है, न कि सतही विशेषताओं से। यदि भाषण आपके वर्कफ़्लो के केंद्र में है, तो मानक लोड के तहत निरंतरता, अनुमानित लेटेंसी और आपके डोमेन में भाषा के व्यवहार पर नियंत्रण है।
Smallest AI में, पल्स STT को ठीक उन्हीं प्रोडक्शन वास्तविकताओं के लिए डिज़ाइन किया गया है, जिसमें 70ms से कम ट्रांसक्रिप्शन से लेकर ऑन-प्रिमाइस डिप्लॉयमेंट शामिल है जब डेटा आपके स्टैक को नहीं छोड़ सकता। यदि आप डेमो के लिए नहीं, बल्कि वास्तविक वर्कलोड के लिए स्पीच सिस्टम का मूल्यांकन कर रहे हैं, तो यह देखने का सही समय है कि पल्स STT कैसे फिट बैठता है।
अक्सर पूछे जाने वाले प्रश्न
एक स्पीच-टू-टेक्स्ट रूपांतरण एल्गोरिदम लाइव फोन कॉल में रुकावटों को कैसे संभालता है?
क्या फोन स्पीच रिकग्निशन (आवाज पहचान) बुनियादी रूप से मानक स्पीच-टू-टेक्स्ट (STT) से अलग है?
कुछ स्पीच-टू-टेक्स्ट तकनीकें परिवर्णी शब्दों (acronyms) और संख्याओं को समझने में क्यों विफल हो जाती हैं?
क्या स्पीच रिकग्निशन (आवाज पहचानने वाली) सहायक तकनीक बिना सटीक व्याकरण के भी विश्वसनीय रूप से काम कर सकती है?
नवीनतम स्पीच रिकग्निशन सॉफ़्टवेयर को पुराने STT सिस्टम से क्या अलग करता है?