कॉल सेंटरों के लिए ऑडियो से टेक्स्ट कनवर्टर: बड़े पैमाने पर रिकॉर्डिंग्स को बैच में कैसे ट्रांसक्राइब करें
कॉल सेंटरों के लिए एक स्केलेबल ऑडियो-टू-टेक्स्ट कनवर्टर पाइपलाइन बनाना सीखें। इसमें बैच आर्किटेक्चर, शोर वाले ऑडियो की प्रीप्रोसेसिंग और डायरीकरण (diarization) शामिल है।
प्रत्येक कॉल सेंटर के पास रिकॉर्ड की गई बातचीत का एक बड़ा बैकलॉग होता है जिसका उपयोग शायद ही कभी उसके पूरे मूल्य के लिए किया जाता है। जब आप ऑडियो के माध्यम से छानबीन करने के बजाय जो कहा गया था उसे खोज और विश्लेषण कर सकते हैं, तो अनुपालन जांच (Compliance checks), कोचिंग, भावना कार्य (sentiment work) और विवाद समाधान सभी आसान हो जाते हैं। एंटरप्राइज़ वर्कलोड के लिए बनाया गया एक ऑडियो से टेक्स्ट कनवर्टर हजारों रिकॉर्डिंग्स को एसिंक्रोनस रूप से प्रोसेस कर सकता है, जिससे बिना किसी ट्रांसक्रिप्शन टीम को रखे रॉ कॉल्स को स्ट्रक्चर्ड, खोजने योग्य ट्रांसक्रिप्ट में बदला जा सकता है।
सवाल यह नहीं है कि स्पीच-टू-टेक्स्ट मौजूद है या नहीं; सवाल यह है कि क्या यह कॉन्टैक्ट-सेंटर की वास्तविकता में टिक पाता है। बड़े पैमाने पर बैच ट्रांसक्रिप्शन को सही तरीके से करने का मतलब है एक ऐसे आर्किटेक्चर को चुनना जो भारी वॉल्यूम के तहत क्रैश न हो, वास्तविक कॉल्स के ध्वनिक शोर (acoustic chaos) से निपट सके, और आउटपुट को उन सिस्टम्स में जोड़ सके जहां यह परिचालन रूप से मूल्यवान बनता है। यह लेख इस पूरी प्रक्रिया को शुरू से अंत तक समझाता है: कॉन्टैक्ट सेंटर्स में रिकॉग्निशन कैसे व्यवहार करता है, एक ऐसा पाइपलाइन कैसे डिजाइन करें जो विश्वसनीय रूप से चले, और पहली बार कतार (queue) बढ़ने पर बिखर जाने वाले डेमो से एक प्रोडक्शन डिप्लॉयमेंट को क्या अलग करता है।
कॉल सेंटर ऑडियो को मानक ट्रांसक्रिप्शन से क्या अलग बनाता है
अधिकांश सामान्य ट्रांसक्रिप्शन टूल साफ, एकल-वक्ता (single-speaker) ऑडियो जैसे कि पॉडकास्ट, व्याख्यान या डिक्टेशन के लिए अनुकूलित होते हैं। कॉल सेंटर रिकॉर्डिंग अधिक अव्यवस्थित और कम क्षमाशील होती हैं। आप अक्सर अलग-अलग चैनलों पर दो वक्ताओं (या, सबसे खराब स्थिति में, एक मिश्रित मोनो ट्रैक), टेलीफोनी कोडेक आर्टिफैक्ट्स और ओपन-प्लान ऑफिस से आने वाले बैकग्राउंड शोर के साथ काम कर रहे होते हैं। फिर उद्योग के अनुसार शब्दावली का अंतर आता है: स्वास्थ्य सेवा में नैदानिक शब्द होते हैं, वित्तीय सेवाओं में उत्पाद कोड और नियामक भाषा होती है, और टेलीकॉम सपोर्ट की अपनी शॉर्टहैंड भाषा होती है जिसे सामान्य मॉडल शायद ही कभी ठीक से सीखने के लिए देख पाते हैं।
विफलता के सामान्य कारकों में लहजे (accents), बैकग्राउंड शोर और डोमेन-विशिष्ट शब्दावली शामिल हैं। कॉन्टैक्ट सेंटर्स में, ये कभी-कभार होने वाली समस्याएं नहीं हैं; ये डेटासेट की डिफ़ॉल्ट स्थिति हैं। मूल्यांकन के योग्य किसी भी ऑडियो से टेक्स्ट कनवर्टर को प्राचीन बेंचमार्क पर नहीं, बल्कि आपकी रिकॉर्डिंग्स पर खुद को साबित करने की आवश्यकता है। उन मॉडलों के साथ जिन्हें टेलीफोनी और कॉन्टैक्ट-सेंटर स्थितियों के लिए ट्यून नहीं किया गया है, वास्तविक दुनिया की वर्ड एरर रेट (WER) साफ टेस्ट सेट पर दिखाए गए आंकड़ों की तुलना में काफी खराब होना कोई असामान्य बात नहीं है।
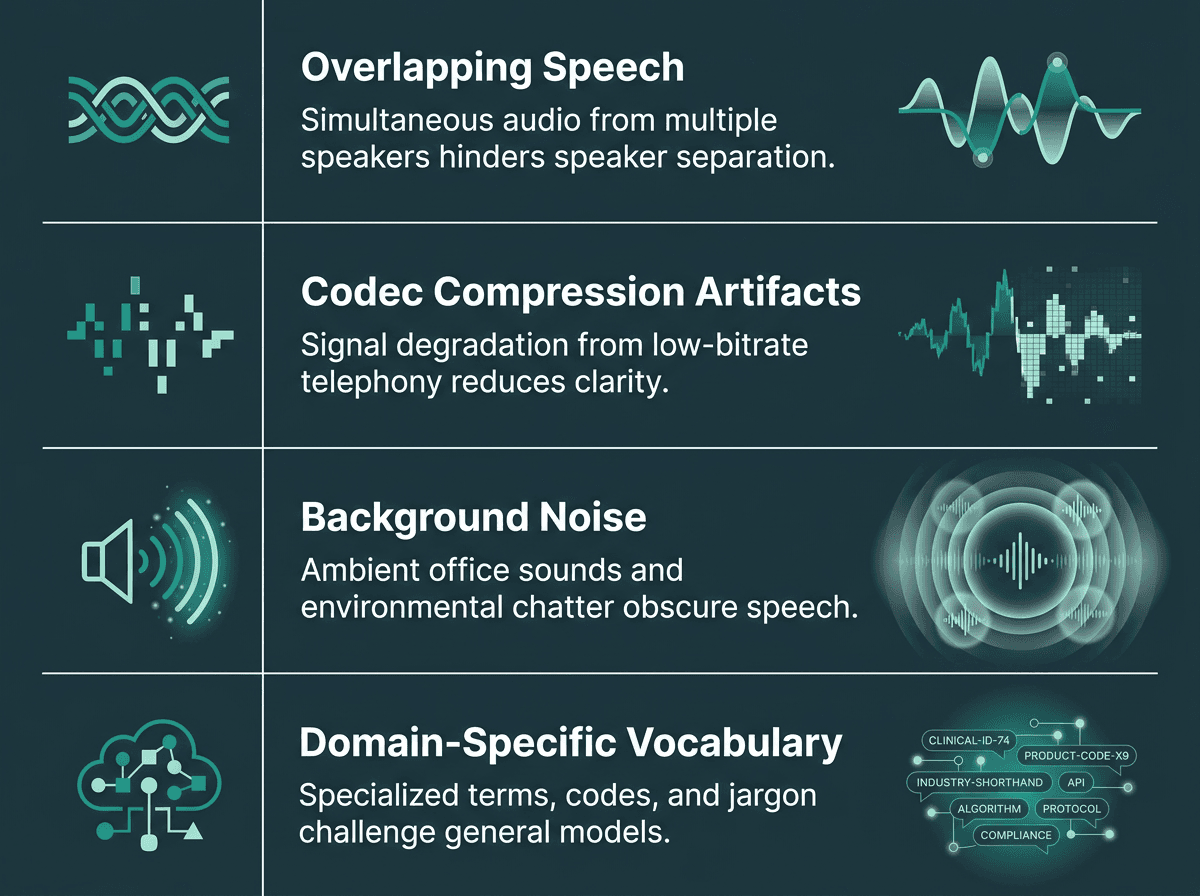
वास्तविक कॉल सेंटर ऑडियो चार जटिल सटीकता चुनौतियाँ पेश करता है जिन्हें संभालने के लिए सामान्य ट्रांसक्रिप्शन मॉडल नहीं बनाए गए हैं।
बैच बनाम रीयल-टाइम ट्रांसक्रिप्शन: सही मोड चुनना
रीयल-टाइम ट्रांसक्रिप्शन कम लेटेंसी के साथ ऑडियो स्ट्रीम करता है और टेक्स्ट लौटाता है, जो अक्सर 300 मिलीसेकंड से कम होता है। यह वह मोड है जो आप लाइव एजेंट सहायता के लिए चाहते हैं, जहां ग्राहक के आधे वाक्य में होने के दौरान ही एक संकेत (prompt) दिखाई देना चाहिए। बैच ट्रांसक्रिप्शन अलग तरह से काम करता है: आप सिस्टम को रिकॉर्ड की गई फ़ाइलों का एक ढेर सौंपते हैं, यह उन्हें एसिंक्रोनस रूप से प्रोसेस करता है, और तैयार होने पर आप परिणाम प्राप्त करते हैं। अधिकांश एंटरप्राइज़ बैच ट्रांसक्रिप्शन एपीआई को स्टोरेज में बड़ी मात्रा में ऑडियो फाइलों को प्रोसेस करने और एसिंक्रोनस रूप से ट्रांसक्रिप्शन वापस करने के लिए डिज़ाइन किया गया है।
अधिकांश एनालिटिक्स और अनुपालन (compliance) कार्य के लिए, बैच ही सही डिफ़ॉल्ट है। आप किसी लाइव बातचीत को नियंत्रित करने की कोशिश नहीं कर रहे हैं; आप यह समझने की कोशिश कर रहे हैं कि पिछले हफ्ते दस हजार कॉलों में क्या हुआ था। बैच पाइपलाइन्स बड़े पैमाने पर सस्ते होते हैं, क्षैतिज रूप से (horizontally) फैलाना आसान होता है, और जब आप डायराइजेशन, सेंटीमेंट टैगिंग या पीआईआई (PII) रेडैक्शन जैसी भारी पोस्ट-प्रोसेसिंग चाहते हैं तो अधिक लचीले होते हैं। इसका नुकसान समय का है: अंतर्दृष्टि (insights) सेकंड के बाद नहीं, बल्कि घंटों बाद दिखाई देती है। क्यूए, अनुपालन और ट्रेंड विश्लेषण के लिए, यह देरी आमतौर पर कोई मायने नहीं रखती।
कॉल सेंटर रिकॉर्डिंग्स को बैच ट्रांसक्राइब कैसे करें: चरण-दर-चरण वर्कफ़्लो
एक विश्वसनीय बैच ट्रांसक्रिप्शन सेटअप एएसआर (ASR) इंजन को ऑडियो मिलने से पहले ही शुरू हो जाता है। इसका लक्ष्य स्पीकर संदर्भ, मेटाडेटा या अनुपालन नियंत्रणों को खोए बिना रिकॉर्डिंग्स को स्टोरेज से खोजने योग्य ट्रांसक्रिप्ट्स में ले जाना है।
1. अपने कॉन्टैक्ट सेंटर प्लेटफॉर्म से कॉल रिकॉर्डिंग्स एक्सपोर्ट करें
अपने सीआरएम, डायलर, सीसीएएएस (CCaaS) प्लेटफॉर्म या कॉल रिकॉर्डिंग सिस्टम से रिकॉर्डिंग्स एक्सपोर्ट करके शुरुआत करें। प्रत्येक फ़ाइल में बुनियादी मेटाडेटा होना चाहिए जैसे कॉल आईडी, एजेंट आईडी, ग्राहक आईडी, कतार (queue), अभियान (campaign), भाषा, टाइमस्टैम्प और कॉल की अवधि। यह मेटाडेटा महत्वपूर्ण है क्योंकि ट्रांसक्रिप्ट केवल तभी उपयोगी है जब टीमें इसे सही बातचीत, एजेंट, ग्राहक या वर्कफ़्लो से जोड़ सकें।
2. ऑडियो फॉर्मेट को सामान्य (normalize) करें
प्लेटफ़ॉर्म के आधार पर कॉल रिकॉर्डिंग अक्सर अलग-अलग फ़ॉर्मेट में आती हैं: WAV, MP3, FLAC, OGG, या G.711 जैसे पुराने टेलीफ़ोनी फ़ॉर्मेट। ट्रांसक्रिप्शन से पहले, हर चीज़ को अपने एएसआर प्रदाता द्वारा समर्थित एक सुसंगत फ़ॉर्मेट में बदलें। कई टीमें कोडेक-संबंधित सटीकता समस्याओं को कम करने और बैच प्रोसेसिंग को प्रबंधित करना आसान बनाने के लिए फ़ाइलों को 16kHz मोनो WAV या FLAC में मानकीकृत करती हैं।
3. उपलब्ध होने पर डुअल-चैनल रिकॉर्डिंग्स को विभाजित करें
यदि रिकॉर्डिंग में एजेंट और ग्राहक के लिए अलग-अलग चैनल हैं, तो उस अलगाव को बनाए रखें। ट्रांसक्रिप्शन से पहले डुअल-चैनल ऑडियो को विभाजित करना आमतौर पर बाद में एकल मिश्रित ट्रैक से आवाजों को अलग करने की कोशिश करने की तुलना में अधिक साफ वक्ता एट्रिब्यूशन (speaker attribution) देता है। यह विशेष रूप से क्यूए, अनुपालन स्कोरिंग, भावना विश्लेषण और विवाद समाधान के लिए उपयोगी है, जहां यह जानना महत्वपूर्ण है कि किसने क्या कहा।
4. नियंत्रित बैचों में एएसआर को फाइलें सबमिट करें
एक बार फ़ाइलें तैयार हो जाने पर, उन्हें नियंत्रित बैचों में स्पीच-टू-टेक्स्ट इंजन को सबमिट करें। एक ही बार में सभी रिकॉर्डिंग भेजने के बजाय, फ़ाइल के आकार, प्राथमिकता, भाषा और उपलब्ध एपीआई सीमाओं के आधार पर जॉब्स को कतारबद्ध करें। यह कॉल वॉल्यूम बढ़ने पर असफल जॉब्स, दर-सीमा (rate-limit) समस्याओं और प्रोसेसिंग में देरी से बचने में मदद करता है।
5. कॉल आईडी और टाइमस्टैम्प के साथ ट्रांसक्रिप्ट स्टोर करें
आउटपुट को केवल प्लेन टेक्स्ट के रूप में स्टोर नहीं किया जाना चाहिए। प्रत्येक ट्रांसक्रिप्ट में मूल कॉल आईडी, टाइमस्टैम्प, स्पीकर लेबल, कॉन्फिडेंस स्कोर, भाषा मेटाडेटा और प्रोसेसिंग स्थिति शामिल होनी चाहिए। इससे ट्रांसक्रिप्ट्स खोजना, सटीक ऑडियो क्लिप निकालना, ट्रांसक्रिप्शन गुणवत्ता का ऑडिट करना और ट्रांसक्रिप्ट को सीआरएम या क्यूए सिस्टम से जोड़ना आसान हो जाता है।
6. डायराइजेशन, रेडैक्शन और कॉन्फिडेंस चेक चलाएं
ट्रांसक्रिप्शन के बाद, पोस्ट-प्रोसेसिंग लागू करें। स्पीकर डायराइजेशन (Speaker diarization) एजेंट और ग्राहक की बारी को अलग करता है। पीआईआई रेडैक्शन (PII redaction) संवेदनशील जानकारी जैसे कार्ड नंबर, राष्ट्रीय आईडी नंबर, जन्म तिथि और खाते के विवरण को छुपाता है। कॉन्फिडेंस चेक अनिश्चित आउटपुट को सीधे एनालिटिक्स में प्रवाहित करने के बजाय समीक्षा के लिए कम-गुणवत्ता वाले ट्रांसक्रिप्ट अनुभागों को फ्लैग करने में मदद करते हैं।
7. ट्रांसक्रिप्ट्स को क्यूए, बीआई, सीआरएम या अनुपालन वर्कफ़्लोज़ में भेजें
अंतिम चरण सक्रियण (activation) है। साफ ट्रांसक्रिप्ट्स को उन सिस्टम्स में भेजें जहां टीमें उनका उपयोग कर सकें: क्यूए डैशबोर्ड, अनुपालन समीक्षा कतारें, बीआई टूल्स, सीआरएम टाइमलाइन, एजेंट कोचिंग प्लेटफॉर्म, या कन्वर्सेशन इंटेलिजेंस लेयर्स। यह वह जगह है जहां बैच ट्रांसक्रिप्शन केवल एक बैक-ऑफिस प्रक्रिया से बढ़कर काम करता है। यह रिकॉर्ड की गई कॉलों को खोजने योग्य, विश्लेषण योग्य ग्राहक डेटा में बदल देता है जो कोचिंग, अनुपालन, प्रवृत्ति विश्लेषण और परिचालन निर्णय लेने में सहायता कर सकता है।
एक ऐसा बैच ट्रांसक्रिप्शन पाइपलाइन डिजाइन करना जो लोड के दौरान भी टिका रहे
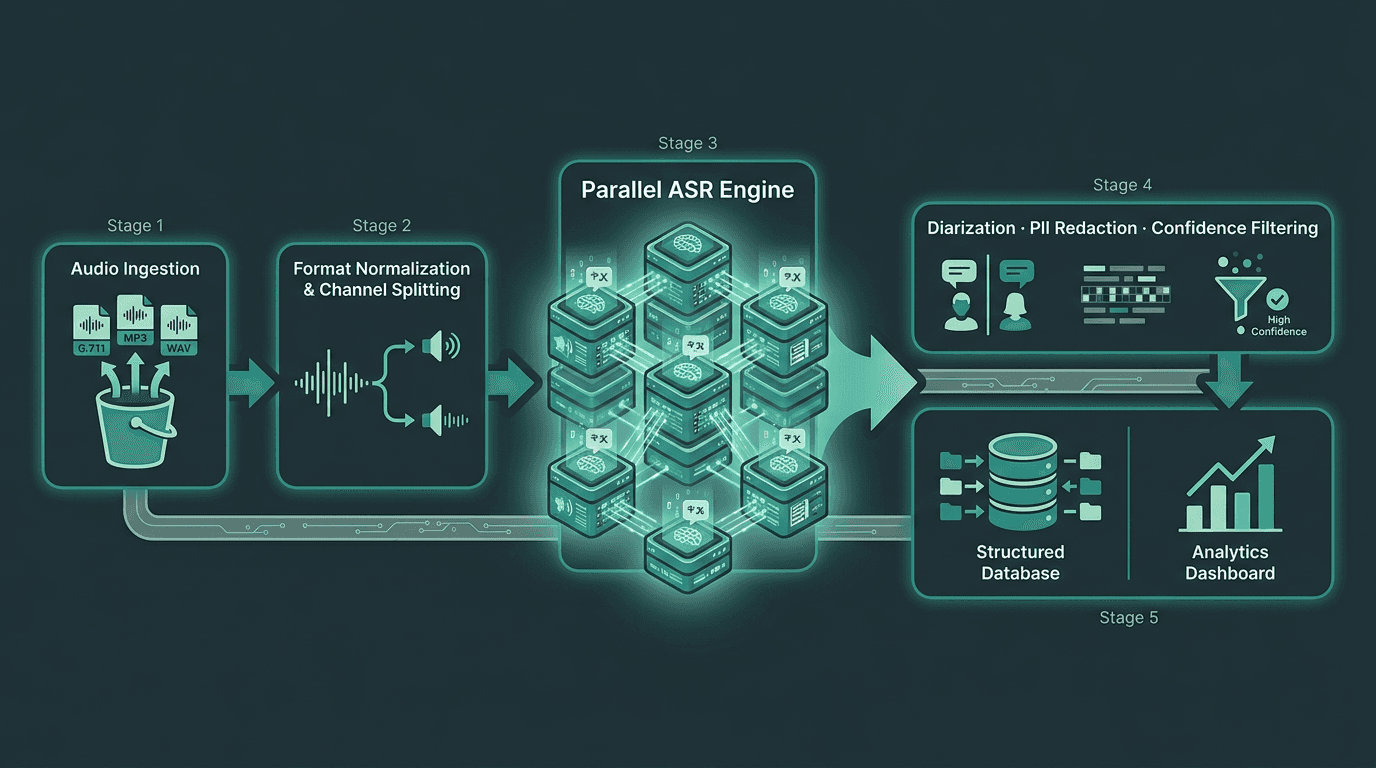
एक प्रोडक्शन बैच पाइपलाइन प्रीप्रोसेसिंग, एएसआर (ASR) और पोस्ट-प्रोसेसिंग को अलग-अलग, स्वतंत्र रूप से स्केलेबल चरणों में विभाजित करती है।
चरण 1: ऑडियो इंजेशन और प्रीप्रोसेसिंग
सटीकता अक्सर एएसआर इंजन द्वारा फाइल को देखने से पहले ही तय हो जाती है। कॉल रिकॉर्डिंग उसी फॉर्मेट में दिखाई देती हैं जो आपका रिकॉर्डिंग स्टैक उत्सर्जित करता है: पुराने पीबीएक्स सेटअप से G.711 mu-law, क्लाउड प्लेटफॉर्म से MP3, स्टीरियो WAV जहां एजेंट और ग्राहक अलग-अलग चैनलों पर होते हैं। काम शुरू करने से पहले एक हाउस फॉर्मेट चुनें और सब कुछ नॉर्मलाइज करें (16kHz मोनो WAV या FLAC व्यापक रूप से समर्थित है)। यदि आपके पास डुअल-चैनल ऑडियो है, तो इसे मिक्स करने के बजाय शुरुआत में ही अलग कर लें। प्रत्येक चैनल को अलग से ट्रांसक्राइब करना और फिर टाइमस्टैम्प के साथ मर्ज करना आमतौर पर बाद में एक ही मिश्रित सिग्नल से वक्ताओं को सुलझाने की कोशिश करने की तुलना में अधिक साफ डायराइजेशन देता है।
चरण 2: समानांतर एएसआर प्रोसेसिंग
आपका एएसआर लेयर समय तय करता है: यह निर्धारित करता है कि बैच रन दो घंटे में समाप्त हो जाएंगे या अगले दिन तक खिंच जाएंगे। अधिकांश एंटरप्राइज़ स्पीच-टू-टेक्स्ट एपीआई आपको समवर्ती रूप से (concurrently) जॉब सबमिट करने और समानांतरता (parallelism) को ट्यून करने की अनुमति देते हैं, हालांकि वास्तविक सीमा प्रदाता और आपकी योजना पर निर्भर करती है। थ्रूपुट की तुलना करने का एक व्यावहारिक तरीका रीयल-टाइम फैक्टर (RTF) है: 0.1 RTF का मतलब है कि एक घंटे का ऑडियो लगभग छह मिनट में ट्रांसक्राइब हो जाता है। यदि आप प्रति माह लगभग चार मिनट की 50,000 कॉलों को प्रोसेस कर रहे हैं, तो आपको निरंतर क्षमता की आवश्यकता होगी जो कभी न खत्म होने वाली कतार में न बदले। कॉल सेंटरों के लिए स्वचालित वाक् पहचान (ASR) के तंत्र में पारंगत होना आपको प्रतिबद्ध होने से पहले विक्रेता के प्रदर्शन दावों का परीक्षण करने में मदद करता है।
चरण 3: पोस्ट-प्रोसेसिंग और संवर्धन
कच्चे (raw) ट्रांसक्रिप्ट केवल शुरुआत हैं। पोस्ट-प्रोसेसिंग वह जगह है जहां आप टेक्स्ट को किसी ऐसी चीज़ में बदलते हैं जिसका उपयोग आपके क्यूए, एनालिटिक्स और अनुपालन सिस्टम वास्तव में कर सकते हैं:
स्पीकर डायराइजेशन: बातचीत को एजेंट बनाम ग्राहक में विभाजित करता है। यह भावना और अनुपालन स्कोरिंग के लिए बुनियादी है।
पीआईआई रेडैक्शन: क्रेडिट कार्ड नंबर, सोशल सिक्योरिटी नंबर और अन्य संवेदनशील फ़ील्ड को आपके वेयरहाउस में पहुंचने से पहले छुपाता है।
कस्टम शब्दावली अनुप्रयोग: उन शब्दों को ठीक करता है जिन्हें बेस मॉडल आमतौर पर खराब कर देते हैं (उत्पाद के नाम, आंतरिक कोड, नियामक भाषा)।
कॉन्फिडेंस फ़िल्टरिंग: डाउनस्ट्रीम एनालिटिक्स को अनुमानों से प्रदूषित करने के बजाय कम-कॉन्फिडेंस वाले सेगमेंट को मानवीय समीक्षा के लिए भेजता है।
टाइमस्टैम्प संरेखण: शब्दों को वापस ऑडियो टाइमलाइन से जोड़ता है ताकि आप कोचिंग या विवाद वर्कफ़्लो के लिए क्लिप निकाल सकें।
कठिन मामलों को संभालना: लहजे (Accents), शोर और कोड-स्विचिंग
अधिकांश बैच ट्रांसक्रिप्शन प्रोजेक्ट जोर-शोर से विफल नहीं होते; वे हाशिये पर विफल होते हैं। "सामान्य" कॉल ठीक लगती हैं, और फिर लंबे समय के बाद सटीकता ढह जाती है, जैसे भारी लहजे वाली कॉल, हवा के शोर वाली मोबाइल रिकॉर्डिंग, तेजी से की गई शिकायतें, द्विभाषी बातचीत जो विचार के बीच में भाषा बदल देती हैं। यदि आप वैश्विक ग्राहक आधार का समर्थन कर रहे हैं, तो आपको यह मान लेना चाहिए कि बहुभाषी ऑडियो और कोड-स्विचिंग सामान्य हैं, दुर्लभ नहीं। बहुभाषी और शोर वाले ऑडियो को संभालने पर गाइड रणनीति की गहराई में जाता है, लेकिन बड़ा आर्किटेक्चरल निर्णय सरल है: क्या आपका एएसआर इंजन स्वतंत्र रूप से भाषा का पता लगाता है, या आपको इसे प्रति फ़ाइल निर्दिष्ट करने की आवश्यकता है?
स्वचालित भाषा आईडी में समय लगता है और छोटे वाक्यों या दृढ़ता से उच्चारण वाले भाषण पर यह गलत अनुमान लगा सकता है। यदि आपका रूटिंग या आईवीआर पहले से ही जानता है कि कॉल किस भाषा की कतार में आई है, तो इसे प्रथम श्रेणी के मेटाडेटा के रूप में मानें और इसे ट्रांसक्रिप्शन जॉब में पास करें। आपको आमतौर पर मॉडल को नए सिरे से भाषा का अनुमान लगाने के लिए कहने की तुलना में कम लागत पर बेहतर सटीकता मिलेगी। शोर के पक्ष में, सबसे भरोसेमंद जीत शुरुआती दौर में मिलती है: यह उम्मीद करने के बजाय कि पहचानकर्ता शोर को पार कर लेगा, प्रीप्रोसेसिंग के दौरान शोर दमन (noise suppression) लागू करें। साफ ऑडियो पर प्रशिक्षित मॉडल शोर वाले इनपुट पर जल्दी खराब हो जाते हैं, और पोस्ट-प्रोसेसिंग उन शब्दों को फिर से नहीं बना सकती जो पहली बार में सही ढंग से पहचाने ही नहीं गए थे।
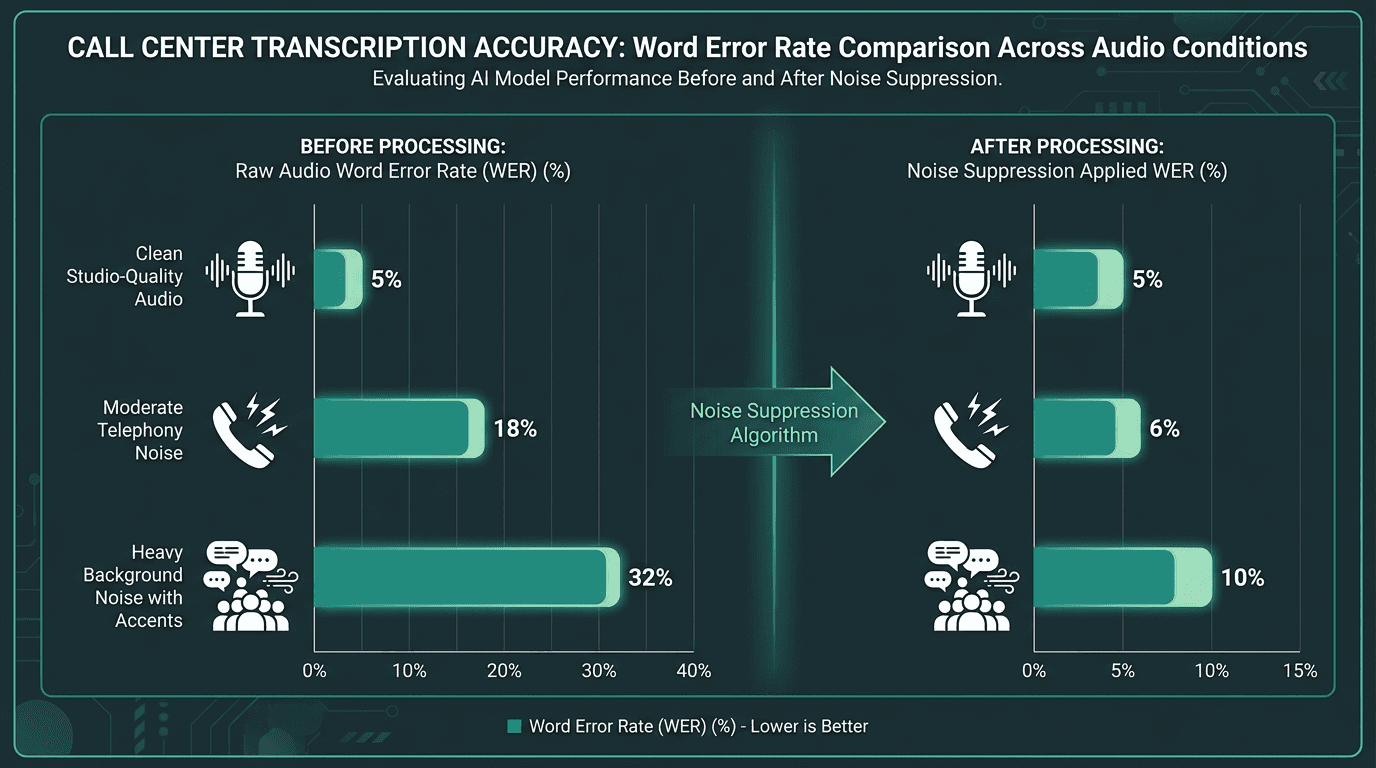
प्रीप्रोसेसिंग चरण में शोर दमन (noise suppression) लगातार साफ और खराब कॉल ऑडियो के बीच सटीकता के अंतर को कम करता है।
ट्रांसक्रिप्ट्स को डाउनस्ट्रीम व्यावसायिक मूल्य से जोड़ना
एक ट्रांसक्रिप्ट जो केवल स्टोरेज बकेट में रहती है, वह सिर्फ एक और वस्तु है। मूल्य तब दिखाई देता है जब ट्रांसक्रिप्ट्स एक विश्लेषण लेयर को फीड करते हैं जिस पर टीमें वास्तव में भरोसा करती हैं। इसका कारण सीधा है: रिकॉर्डिंग्स में इरादे, एजेंट के प्रदर्शन, उत्पाद घर्षण और अनुपालन जोखिम के बारे में टिकाऊ संकेत होते हैं। ट्रांसक्रिप्शन ही वह चीज़ है जो उन संकेतों को बड़े पैमाने पर खोजने योग्य बनाती है।
सबसे तेज़ लाभ कॉल सेंटर क्यूए और बातचीत एनालिटिक्स, स्क्रिप्ट पालन और अनुपालन के लिए स्वचालित जांच, और बड़ी मात्रा में कॉलों में भावना प्रवृत्ति ट्रैकिंग से मिलते हैं। एक बार जब ट्रांसक्रिप्ट भरोसेमंद हो जाते हैं, तो सारांश (summarization) इसके ऊपर एक व्यावहारिक लेयर बन जाता है, जिससे कॉल के बाद के रैप-अप समय में महत्वपूर्ण कमी आ सकती है। व्यापक एआई एकीकरण रीयल-टाइम ट्रांसक्रिप्शन और स्वचालित सुझावों जैसे टूल के माध्यम से औसत हैंडलिंग समय को भी कम कर सकता है। उन हितधारकों के लिए जिन्हें वित्त की कहानी की आवश्यकता है, कॉल सेंटरों में एआई का आरओआई (ROI) उन सुधारों को बजट के दायरे में रखने में मदद करता है।
ऑडियो से टेक्स्ट कन्वर्टर्स का मूल्यांकन करते समय अधिकांश टीमें क्या गलती करती हैं
पहली गलती: गलत कॉलों पर परीक्षण करना। साफ, "प्रतिनिधि" रिकॉर्डिंग्स के एक छोटे से सेट पर निर्मित प्रूफ-ऑफ-कांसेप्ट हमेशा बहुत अच्छा लगता है। प्रोडक्शन ऐसा नहीं होता। लंबा सिरा (भारी लहजे, मोबाइल पर हवा का शोर, तेज भावनात्मक भाषण) सटीकता को कम कर देगा और आप इसके ऊपर जो भी एनालिटिक्स बनाते हैं, उस पर विश्वास को कम कर देगा। इसका समाधान उबाऊ लेकिन प्रभावी है: एक स्तरीकृत (stratified) नमूने पर मूल्यांकन करें जो जानबूझकर आपके सबसे कठिन ऑडियो को अधिक शामिल करता है, न कि आपके सबसे आसान ऑडियो को।
दूसरी गलती: प्रति-मिनट की कीमत को पूरी लागत मान लेना। एपीआई दरों की तुलना करना आसान है; स्वामित्व की कुल लागत की तुलना करना नहीं। आप अभी भी प्रीप्रोसेसिंग कंप्यूट, कच्चे ऑडियो और ट्रांसक्रिप्ट के लिए स्टोरेज, पाइपलाइन को स्वस्थ रखने के लिए इंजीनियरिंग समय, और कम-कॉन्फिडेंस वाले सेगमेंट के लिए मानवीय समीक्षा के लिए भुगतान करते हैं। व्यवहार में, एक प्रदाता जो प्रति मिनट थोड़ा अधिक शुल्क लेता है लेकिन उच्च सटीकता और मजबूत पोस्ट-प्रोसेसिंग प्रदान करता है, वह कुल मिलाकर कम दर वाले विकल्प की तुलना में सस्ता हो सकता है जो आपको क्षतिपूर्ति लेयर्स बनाने के लिए मजबूर करता है। मजबूत कॉल सेंटर गुणवत्ता निगरानी ट्रांसक्रिप्ट की गुणवत्ता पर निर्भर करती है; एक बार जब त्रुटियां सिस्टम में प्रवेश करती हैं, तो वे स्कोरिंग और रिपोर्टिंग में फैल जाती हैं।
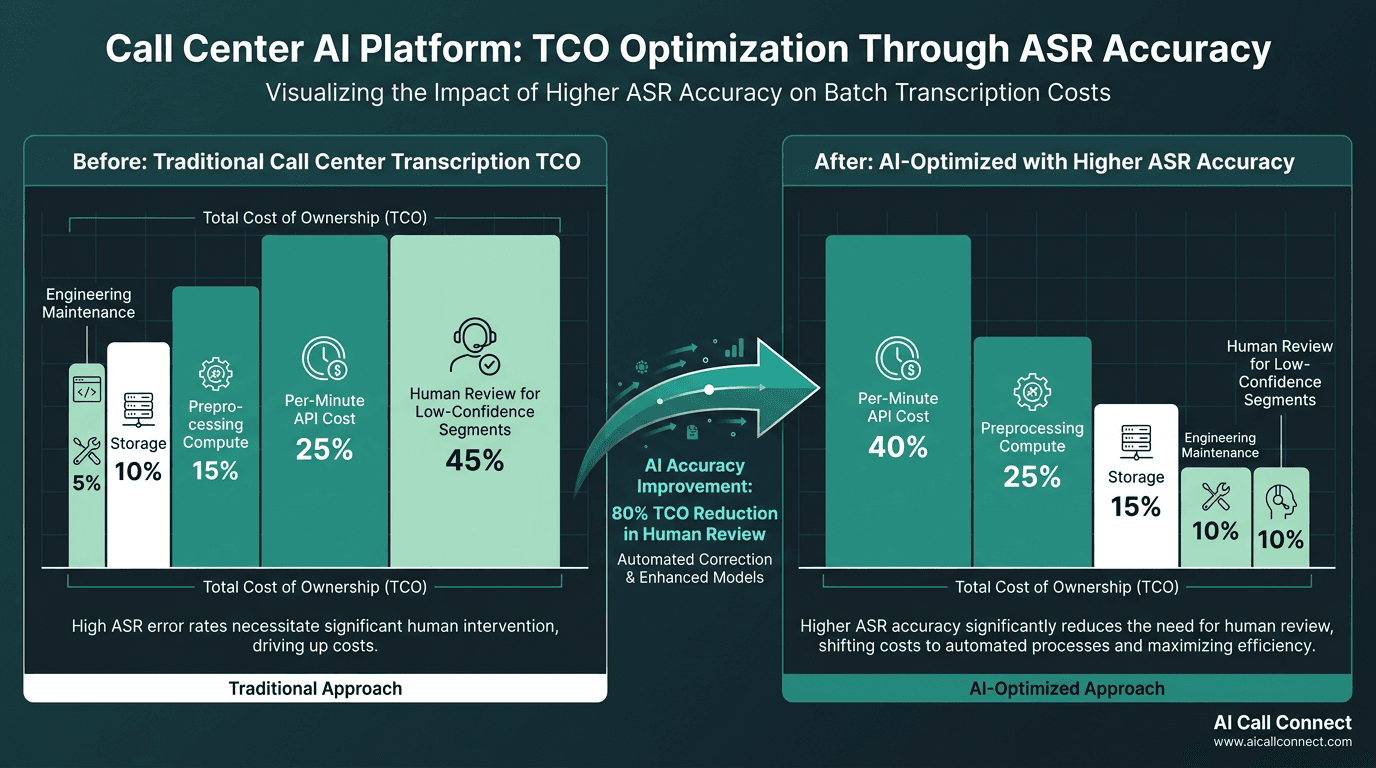
एएसआर लेयर पर उच्च सटीकता मानवीय समीक्षा के बोझ को कम करती है जो अक्सर कुल पाइपलाइन लागत पर हावी होती है।
उत्पादन परिनियोजन (Production Deployments) के लिए उन्नत विचार
पहला संस्करण चलने के बाद, कुछ निर्णय परिणामों पर हावी होने लगते हैं। भाषा मॉडल अनुकूलन सबसे अधिक प्रभाव डालने वाला माध्यम है जिसे आप बदल सकते हैं। अधिकांश एंटरप्राइज़ एएसआर प्रदाता आपकी खुद की ट्रांसक्राइब की गई कॉलों का उपयोग करके शब्दावली सूची या डोमेन फाइन-ट्यूनिंग का समर्थन करते हैं। एक अपेक्षाकृत छोटा अनुकूलन सेट भी बेस मॉडल की तुलना में डोमेन शब्दावली पर वर्ड एरर रेट को महत्वपूर्ण रूप से कम कर सकता है। यह वह जगह है जहां आप आमतौर पर इसे सबसे अधिक महसूस करते हैं: उत्पाद के नाम, आंतरिक पहचानकर्ता और नियामक शब्द जो आपकी कॉलों में सामान्य हैं और सामान्य प्रशिक्षण डेटा में दुर्लभ हैं।
विश्वसनीयता इंजीनियरिंग मॉडल की गुणवत्ता जितनी ही मायने रखती है। बैच जॉब्स विफल होते हैं; फाइलें दूषित हो जाती हैं; दर सीमाएं लागू होती हैं। एक प्रोडक्शन पाइपलाइन को जॉब की स्थिति को बनाए रखना चाहिए, एक्सपोनेंशियल बैकऑफ़ के साथ पुनः प्रयास करना चाहिए, और चुपचाप कॉलों को छोड़ने के बजाय विफलताओं को स्पष्ट रूप से सामने लाना चाहिए। रिकॉर्डिंग्स के एक छोटे से हिस्से को छोड़ने से भी क्यूए मेट्रिक्स और अनुपालन रिपोर्टिंग इस तरह से प्रभावित हो सकती है जिसे तब तक पहचानना मुश्किल होता है जब तक कि कोई ऑडिट इस मुद्दे को मजबूर न कर दे। सिस्टम को "पूर्ण" माने जाने से पहले ही ऑब्जर्वेबिलिटी (observability) को शामिल करें। एआई कैसे कॉल सेंटर संचालन को बदल रहा है इस पर व्यापक दृष्टिकोण एक उपयोगी अनुस्मारक है: ट्रांसक्रिप्शन कोई ऐसी सुविधा नहीं है जिसे आप बाद में जोड़ते हैं; यह बुनियादी ढांचा है, और यह किसी भी अन्य डेटा पाइपलाइन की तरह ही परिचालन अनुशासन का हकदार है।
मुख्य निष्कर्ष और अगले कदम
कॉल सेंटर ऑडियो के लिए बैच ट्रांसक्रिप्शन सिस्टम बनाने या उसका मूल्यांकन करने वाले किसी भी व्यक्ति के लिए आवश्यक बातें:
अपने सबसे कठिन ऑडियो पर सटीकता का मूल्यांकन करें, अपने सबसे साफ ऑडियो पर नहीं। एक स्तरीकृत नमूने पर वर्ड एरर रेट का बेंचमार्क लें जिसमें शोर, लहजे और डोमेन-विशिष्ट कॉल शामिल हों।
ट्रांसक्राइब करने से पहले प्रीप्रोसेस करें। इंजेशन के समय चैनल विभाजन, फॉर्मेट नॉर्मलाइजेशन और शोर दमन पोस्ट-प्रोसेसिंग सुधारों की तुलना में अधिक विश्वसनीय रूप से सटीकता में सुधार करते हैं।
पोस्ट-प्रोसेसिंग को एक अलग चरण के रूप में बनाएं। डायराइजेशन, पीआईआई रेडैक्शन और कॉन्फिडेंस फ़िल्टरिंग अपनी खुद की लेयर में होने चाहिए, न कि एएसआर जॉब में मिश्रित।
स्वामित्व की कुल लागत को मापें, न कि केवल प्रति-मिनट की कीमत को। इंजीनियरिंग समय, स्टोरेज और मानवीय समीक्षा लागत अक्सर बड़े पैमाने पर एपीआई लागत से अधिक हो जाती हैं।
अपने भाषा मॉडल को अपने डोमेन के अनुकूल बनाएं। एक बार बेस पाइपलाइन स्थिर हो जाने पर आपकी खुद की शब्दावली और अपने स्वयं के ऑडियो पर फाइन-ट्यूनिंग सबसे अधिक आरओआई वाले निवेश हैं।
हर चीज़ को ट्रैक करें। जॉब स्टेट ट्रैकिंग, रीट्राय लॉजिक और सटीकता की निगरानी प्रोडक्शन सिस्टम में वैकल्पिक नहीं हैं।
कॉल सेंटर एनालिटिक्स तेजी से बढ़ रहा है क्योंकि कंपनियां आखिरकार रिकॉर्ड की गई बातचीत को उपयोगी डेटा के रूप में मान रही हैं, न कि केवल एक संग्रह के रूप में। वह बदलाव ट्रांसक्रिप्शन से शुरू होता है जो सटीक, स्केलेबल और परिचालन रूप से विश्वसनीय हो। Smallest.ai का Pulse उसी वर्कलोड के इर्द-गिर्द बनाया गया है: टेलीफोनी की ध्वनिक बाधाओं के लिए ट्यून किया गया स्पीच-टू-टेक्स्ट, उस थ्रूपुट और पोस्ट-प्रोसेसिंग सपोर्ट के साथ जिसकी प्रोडक्शन डिप्लॉयमेंट मांग करते हैं। यदि आप कॉल सेंटर के लिए ऑडियो से टेक्स्ट कनवर्टर्स की तुलना कर रहे हैं, तो Pulse शुरुआत करने के लिए एक समझदारी भरा विकल्प है जब केवल सैद्धांतिक बेंचमार्क प्रदर्शन के बजाय "वास्तविक कॉल्स पर काम करना" अधिक मायने रखता है।
अक्सर पूछे जाने वाले प्रश्न
वास्तविक कॉल सेंटर ऑडियो पर बैच ट्रांसक्रिप्शन कितना सटीक है?
बैच ट्रांसक्रिप्शन सिस्टम आमतौर पर किन ऑडियो फॉर्मेट्स का समर्थन करता है?
कॉल सेंटर के संदर्भ में स्पीकर डायराइजेशन (speaker diarization) कैसे काम करता है?
कॉल सेंटरों के लिए बैच ट्रांसक्रिप्शन और रीयल-टाइम ट्रांसक्रिप्शन के बीच क्या अंतर है?
मैं कॉल सेंटर ट्रांसक्रिप्ट में पीआईआई (व्यक्तिगत रूप से पहचान योग्य जानकारी) को कैसे संभालूँ?
![यह ब्लॉग /blog पेज के शीर्ष पर प्रदर्शित किया जाएगा। एक समय में केवल एक ही ब्लॉग को प्रदर्शित किया जा सकता है। यदि कई ब्लॉग प्रदर्शित किए जाते हैं, तो सूची में केवल पहला प्रदर्शित ब्लॉग ही दिखाई देगा। Python में ऑडियो को टेक्स्ट में ट्रांसक्राइब करें, जिसमें साफ प्रीप्रोसेसिंग, API कॉल, डायराइजेशन, चंकिंग और प्रोडक्शन रीट्राय/कॉस्ट पैटर्न शामिल हैं जिन्हें आप आत्मविश्वास के साथ शिप कर सकते हैं। पेज का मेटा डेटा खाली। पायथन में ऑडियो को टेक्स्ट में कैसे ट्रांसक्राइब करें: डेवलपर्स के लिए एक चरण-दर-चरण API गाइड। Python में ऑडियो को टेक्स्ट में ट्रांसक्राइब करें, जिसमें साफ प्रीप्रोसेसिंग, API कॉल, डायराइजेशन, चंकिंग और प्रोडक्शन रीट्राय/कॉस्ट पैटर्न शामिल हैं जिन्हें आप आत्मविश्वास के साथ शिप कर सकते हैं। how-to-transcribe-audio-to-text-in-python-a-step-by-step-api-guide-for-developers smallest.ai/blog/how-to-transcribe-audio-to-text-in-python-a-step-by-step-api-guide-for-developers खाली खाली पृथ्वी भारद्वाज खाली। ऑडियो को टेक्स्ट में ट्रांसक्राइब करना तब तक एक हल की गई समस्या लगती है जब तक आप इसे शिप करने की कोशिश नहीं करते। अलग-अलग फ़ाइल प्रकार, अजीब सैंपल रेट्स, बैकग्राउंड का शोर, लहजे (accents), और कई वक्ताओं की बातचीत एक "त्वरित स्क्रिप्ट" को एक वास्तविक इंजीनियरिंग प्रयास में बदल देती है। इसके बाद "यह मेरे मशीन पर काम करता है" से लेकर Python कोड तक का व्यावहारिक रास्ता है जो विश्वसनीयता की समस्याओं के बिना वास्तविक दुनिया के ऑडियो को संभाल सकता है। यदि आप मीटिंग नोट्स, एक वॉयस-ड्रिवेन सपोर्ट बॉट, या एक ऑडियो इंडेक्सिंग पाइपलाइन बना रहे हैं, तो वही बुनियादी बातें बार-बार सामने आती हैं। आपके पास काम करने वाला Python कोड, इस बात की स्पष्ट समझ कि कौन से नॉब्स वास्तव में सटीकता को प्रभावित करते हैं, और प्रोटोटाइप से प्रोडक्शन तक का एक वास्तविक मैप होगा। ये अनुभाग क्रम में बने हैं, इसलिए आप इसे एक मेनू के बजाय एक अनुक्रम के रूप में मान सकते हैं। Python ऑडियो ट्रांसक्रिप्शन कैसे काम करता है: बुनियादी वर्कफ़्लो। कोड लिखना शुरू करने से पहले, पूर्ण ट्रांसक्रिप्शन प्रवाह को समझना मददगार होता है। एक स्पीच-टू-टेक्स्ट पाइपलाइन केवल "ऑडियो अपलोड करें और टेक्स्ट वापस पाएं" नहीं है। एक वास्तविक एप्लिकेशन में, आपको ऑडियो तैयार करना होगा, सही अनुरोध भेजना होगा, संरचित (structured) आउटपुट प्राप्त करना होगा, और उस आउटपुट को अपने उत्पाद या वर्कफ़्लो के लिए उपयोगी बनाना होगा। यहाँ मूल वर्कफ़्लो दिया गया है जिसका अधिकांश Python ऑडियो ट्रांसक्रिप्शन सिस्टम पालन करते हैं: ऑडियो फ़ाइल तैयार करें या होस्ट करें। उस ऑडियो स्रोत से शुरू करें जिसे आप ट्रांसक्राइब करना चाहते हैं। यह उपयोगकर्ता अपलोड की गई स्थानीय फ़ाइल, आपके CRM से कॉल रिकॉर्डिंग, मीटिंग रिकॉर्डिंग, पॉडकास्ट एपिसोड, या होस्ट की गई फ़ाइल URL हो सकती है। यदि फ़ाइल पहले से ही सुरक्षित रूप से होस्ट की गई है, तो आप URL सीधे ट्रांसक्रिप्शन API पर भेज सकते हैं। यदि यह स्थानीय रूप से संग्रहीत है, तो आप Python से रॉ ऑडियो फ़ाइल अपलोड कर सकते हैं। आवश्यकतानुसार ऑडियो प्रारूप को सामान्य (Normalize) करें। ऑडियो फ़ाइलें अक्सर विभिन्न प्रारूपों, बिटरेट्स, सैंपल रेट्स और चैनल लेआउट में आती हैं। उन्हें API पर भेजने से पहले, यदि आवश्यक हो तो फ़ाइल को सामान्य करें। एक सामान्य सुरक्षित प्रारूप मोनो, 16 kHz, 16-बिट WAV है, विशेष रूप से तब जब आप विभिन्न रिकॉर्डिंग्स में अनुमानित ट्रांसक्रिप्शन गुणवत्ता चाहते हैं। यह चरण असमर्थित प्रारूपों, स्टीरियो चैनल भ्रम, या शोर वाले रूपांतरणों के कारण होने वाली समस्याओं को कम करने में मदद करता है। फ़ाइल या URL को ट्रांसक्रिप्शन API पर भेजें। ऑडियो तैयार होने के बाद, आपका Python स्क्रिप्ट इसे स्पीच-टू-टेक्स्ट API पर भेजता है। एक स्थानीय फ़ाइल के लिए, इसका आम तौर पर मतलब ऑडियो बाइट्स को पढ़ना और उन्हें एक POST अनुरोध में भेजना है। होस्ट किए गए ऑडियो के लिए, आप JSON पेलोड में सार्वजनिक या हस्ताक्षरित (signed) URL भेजते हैं। दोनों मामलों में, आपके अनुरोध में प्रमाणीकरण (authentication) शामिल होना चाहिए, जो आमतौर पर एक पर्यावरण चर (environment variable) में संग्रहीत API कुंजी के माध्यम से होता है। भाषा, डायराइजेशन, टाइमस्टैम्प और फ़ॉर्मेटिंग विकल्प पास करें। अधिकांश ट्रांसक्रिप्शन API आपको यह नियंत्रित करने देते हैं कि आउटपुट कैसे जनरेट होना चाहिए। उदाहरण के लिए, आप en जैसी भाषा कोड पास कर सकते हैं, बहु-वक्ता बातचीत के लिए स्पीकर डायराइजेशन सक्षम कर सकते हैं, शब्द-स्तरीय टाइमस्टैम्प का अनुरोध कर सकते हैं, या स्वचालित भाषा पहचान की अनुमति दे सकते हैं। ये विकल्प महत्वपूर्ण हैं क्योंकि वे प्रभावित करते हैं कि अंतिम ट्रांसक्रिप्ट खोज, कैप्शन, एनालिटिक्स, QA, या डाउनस्ट्रीम ऑटोमेशन के लिए कितनी उपयोगी होगी। संरचित JSON प्राप्त करें। एक अच्छा स्पीच-टू-टेक्स्ट API केवल प्लेन टेक्स्ट ही नहीं लौटाता है। यह आमतौर पर संरचित JSON लौटाता है जिसमें पूर्ण ट्रांसक्रिप्ट, शब्द-स्तरीय समय, खोजी गई भाषा, आत्मविश्वास स्कोर (confidence scores) और डायराइजेशन सक्षम होने पर स्पीकर की जानकारी शामिल होती है। यही संरचना एक ट्रांसक्रिप्ट को एक साधारण टेक्स्ट ब्लॉक से उस डेटा में बदल देती है जिसके साथ आपका एप्लिकेशन काम कर सकता है। ट्रांसक्रिप्ट, वर्ड टाइमस्टैम्प, स्पीकर लेबल और कॉन्फिडेंस मेटाडेटा निकालें। प्रतिक्रिया प्राप्त करने के बाद, Python में JSON को पार्स करें। डिस्प्ले के लिए पूरा ट्रांसक्रिप्ट, ऑडियो या वीडियो के साथ टेक्स्ट सिंक करने के लिए वर्ड टाइमस्टैम्प, बातचीत के लिए स्पीकर लेबल और गुणवत्ता जांच के लिए कॉन्फिडेंस स्कोर निकालें। उदाहरण के लिए, कम-आत्मविश्वास वाले शब्दों को मानवीय समीक्षा के लिए फ़्लैग किया जा सकता है, इससे पहले कि ट्रांसक्रिप्ट को ग्राहक-सामना करने वाले या अनुपालन-संवेदनशील वर्कफ़्लो में धकेला जाए। ट्रांसक्रिप्ट को स्टोर या पोस्ट-प्रोसेस करें। अंत में, ट्रांसक्रिप्ट और मेटाडेटा को अपने डेटाबेस, ऑब्जेक्ट स्टोरेज, CRM, QA प्लेटफॉर्म, BI टूल या सर्च इंडेक्स में स्टोर करें। आप पोस्ट-प्रोसेसिंग चरण भी चला सकते हैं जैसे विराम चिह्न सफाई, संपादन (redaction), संक्षेपीकरण (summarization), कीवर्ड निष्कर्षण, स्पीकर फ़ॉर्मेटिंग, या विषय टैगिंग। यही वह जगह है जहाँ ट्रांसक्रिप्शन कच्चे टेक्स्ट से परे उपयोगी हो जाता है: यह खोजने योग्य कॉल आर्काइव, मीटिंग सारांश, सहायता QA, कैप्शन, अनुपालन समीक्षा, या वॉयस एनालिटिक्स को शक्ति प्रदान कर सकता है। एक साधारण Python ट्रांसक्रिप्शन वर्कफ़्लो आमतौर पर इस तरह दिखता है: 1. ऑडियो तैयार करें या होस्ट करें: audio_path = "preprocessed_audio.wav" 2. ऑडियो को ट्रांसक्रिप्शन API पर भेजें: response = transcribe_audio(audio_path) 3. संरचित फ़ील्ड निकालें: transcript = response.get("transcription", "") words = response.get("words", []) utterances = response.get("utterances", []) language = response.get("language", "unknown") 4. परिणाम संग्रहीत या पोस्ट-प्रोसेस करें: print("Transcript:", transcript) print("Detected language:", language) print("Word count:", len(words)) print("Speaker turns:", len(utterances)) यह वर्कफ़्लो वास्तविक कार्यान्वयन में जाने से पहले आपको एक स्पष्ट मानसिक मॉडल देता है। API स्तर पर वास्तव में 'ऑडियो को टेक्स्ट में ट्रांसक्राइब करें' का क्या अर्थ है? इससे पहले कि आप Python लिखें, यह स्पष्ट करने में मदद मिलती है कि जब आप "ट्रांसक्राइब" पर क्लिक करते हैं तो स्पीच-टू-टेक्स्ट API क्या कर रहा होता है। आप किसी ब्लैक बॉक्स में फ़ाइल मेल नहीं कर रहे हैं और एक पैराग्राफ वापस नहीं पा रहे हैं। सेवा आमतौर पर ऑडियो को एक ध्वनिक मॉडल (sound to phonemes), एक भाषा मॉडल (phonemes to likely words in context), और फिर एक पोस्ट-प्रोसेसिंग परत के माध्यम से चलाती है जो विराम चिह्न, कैपिटलाइजेशन और कभी-कभी स्पीकर लेबल के साथ चीजों को साफ करती है। वे परतें भी हैं जहां गुणवत्ता अंतराल तेजी से दिखाई देते हैं। एक मॉडल जो साफ, स्टूडियो अंग्रेजी पर बहुत अच्छा दिखता है, वह अक्सर कॉल-सेंटर ऑडियो, भारी पृष्ठभूमि शोर, या बातचीत जो बीच में भाषाएं बदलती हैं, पर बिखर जाता है। इसीलिए API का चुनाव उतना ही मायने रखता है जितना कि आपका Python रैपर। यदि आप अंतर्निहित यांत्रिकी के बारे में अधिक जानना चाहते हैं, तो स्पीच रिकग्निशन Python गाइड विस्तार से बताता है कि आधुनिक रिकग्निशन सिस्टम व्यवहार में कैसे व्यवहार करते हैं। एक आधुनिक स्पीच-टू-टेक्स्ट API की आंतरिक पाइपलाइन, कच्चे ऑडियो से संरचित ट्रांसक्रिप्ट तक। अपना Python वातावरण सेट करना। एक नए वर्चुअल वातावरण का उपयोग करें। ऑडियो टूलिंग डिपेंडेंसी क्लैश के लिए कुख्यात है, और पैकेजों को अलग करना आपको अपने पाइपलाइन के बजाय अपनी मशीन को डीबग करने से बचाता है। अपने वातावरण को तैयार करने के लिए इन कमांड्स को चलाएं: python -m venv stt-env # macOS / Linux source stt-env/bin/activate # Windows stt-env\Scripts\activate pip install requests python-dotenv pydub अपनी API कुंजी को कोड में डालने के बजाय `.env` फ़ाइल में रखें। यह बुनियादी स्वच्छता है, और जब आप स्थानीय परीक्षण से उत्पादन में जाते हैं तो यह कुंजी रोटेशन को दर्द रहित भी बनाता है। `.env` में `SMALLEST_API_KEY=your_api_key_here` जोड़ें, फिर नीचे दिए गए स्निपेट के साथ इसे लोड करें। SMALLEST_API_KEY=your_api_key_here from dotenv import load_dotenv load_dotenv() ऑडियो प्रीप्रोसेसिंग: वह चरण जिसे अधिकांश ट्यूटोरियल छोड़ देते हैं। बहुत सारे ट्रांसक्रिप्शन वॉकथ्रू एक प्राचीन WAV से शुरू होते हैं और नाटक करते हैं कि यह सामान्य है। ऐसा नहीं है। फ़ोन रिकॉर्डिंग अक्सर 8 kHz पर आती हैं, जो 16 kHz की उम्मीद करने वाले मॉडल के लिए एक खराब मेल है। वीडियो MP4 या MKV के रूप में दिखाई देता है जिसके अंदर ऑडियो छुपा होता है। ज़ूम निर्यात में प्रति स्पीकर अलग मोनो ट्रैक शामिल हो सकते हैं, जो यह बदलता है कि आपको मॉडल में ऑडियो कैसे फीड करना चाहिए। `pydub` बिना किसी परेशानी के अधिकांश कष्टप्रद प्रारूप कार्य को कवर करता है। यहाँ एक छोटा प्रीप्रोसेसिंग फ़ंक्शन है जो ऑडियो को उस आकार में परिवर्तित करता है जिसे अधिकांश API पसंद करते हैं: from pydub import AudioSegment def preprocess_audio(input_path: str, output_path: str) -> str: """ Convert an audio file to mono, 16 kHz, 16-bit PCM WAV. This format is commonly preferred for speech-to-text pipelines. """ audio = AudioSegment.from_file(input_path) audio = audio.set_channels(1) audio = audio.set_frame_rate(16000) audio = audio.set_sample_width(2) audio.export(output_path, format="wav") return output_path if __name__ == "__main__": preprocess_audio("input_audio.mp3", "preprocessed_audio.wav") व्यवहार में, API को कॉल करने से पहले इस सब के माध्यम से सब कुछ चलाएं। अकेले रीसैंपलिंग से बहुत फर्क पड़ सकता है, खासकर जब मूल रिकॉर्डिंग टेलीफोनी-ग्रेड की हो। जैसा कि मोज़िला के कॉमन वॉयस दस्तावेज़ में उल्लेख किया गया है, 16 kHz मोनो WAV कई ओपन-सोर्स और वाणिज्यिक स्पीच मॉडल में मानक इनपुट प्रारूप है। ट्रांसक्रिप्शन API पर भेजने से पहले ऑडियो को प्रीप्रोसेस करना सटीकता में काफी सुधार करता है। Python में अपना पहला ट्रांसक्रिप्शन API कॉल करना। एक बार जब आपके पास एक साफ ऑडियो फ़ाइल हो, तो API कॉल सीधी होती है। नीचे दिया गया उदाहरण Smallest.ai के Pulse का उपयोग करता है, जो एक स्पीच-टू-टेक्स्ट API है जिसका उद्देश्य कम-विलंबता, उच्च-सटीकता ट्रांसक्रिप्शन है, जिसमें रीयल-टाइम परिदृश्यों के लिए स्ट्रीमिंग समर्थन है। import os import requests from dotenv import load_dotenv load_dotenv() def transcribe_audio(file_path: str) -> dict: """ Send a local audio file to Smallest.ai Pulse STT and return the transcription response as JSON. """ api_key = os.getenv("SMALLEST_API_KEY") if not api_key: raise ValueError("Missing SMALLEST_API_KEY in environment variables.") url = "https://api.smallest.ai/waves/v1/pulse/get_text" params = { "language": "en", "word_timestamps": "true", "diarize": "false", } headers = { "Authorization": f"Bearer {api_key}", "Content-Type": "audio/wav", } with open(file_path, "rb") as audio_file: response = requests.post( url, headers=headers, params=params, data=audio_file, यहाँ दो विवरण दिखने से कहीं अधिक मायने रखते हैं। `raise_for_status` HTTP विफलताओं को अपवादों (exceptions) में बदल देता है, इसलिए आप त्रुटियों से स्पष्ट रूप से निपटते हैं बजाय इसके कि चुपचाप एक खाली स्ट्रिंग प्रिंट करें और इसे "पूर्ण" कहें। और word_timestamps=true आपको शब्द-स्तरीय समय देता है, जिसकी आपको उसी क्षण आवश्यकता होगी जब आपको वीडियो में टेक्स्ट सिंक करना हो, खोज हिट को हाइलाइट करना हो, या किसी भी प्रकार का उपयोगी ऑडियो इंडेक्स बनाना हो। यदि आप एक समृद्ध पाइपलाइन बना रहे हैं, तो स्पीच-टू-टेक्स्ट डेवलपर गाइड स्ट्रीमिंग और रीयल-टाइम पैटर्न पर आगे बढ़ता है। एक होस्ट किए गए ऑडियो URL को ट्रांसक्राइब करना। import os import requests from dotenv import load_dotenv load_dotenv() def transcribe_audio_url(audio_url: str) -> dict: """ Send a hosted audio URL to Smallest.ai Pulse STT and return the transcription response as JSON. """ api_key = os.getenv("SMALLEST_API_KEY") if not api_key: raise ValueError("Missing SMALLEST_API_KEY in environment variables.") url = "https://api.smallest.ai/waves/v1/pulse/get_text" params = { "language": "en", "word_timestamps": "true", "diarize": "true", } headers = { "Authorization": f"Bearer {api_key}", "Content-Type": "application/json", } payload = { "url": audio_url, } response = requests.post( url, API प्रतिक्रिया को संभालना और संरचित डेटा निकालना। एक ट्रांसक्रिप्शन प्रतिक्रिया आमतौर पर एकल ट्रांसक्रिप्ट फ़ील्ड से अधिक होती है। अच्छे API संरचना लौटाते हैं: शब्द समय, आत्मविश्वास स्कोर, खोजी गई भाषा, और कभी-कभी वक्ता मेटाडेटा। यहाँ एक विशिष्ट प्रतिक्रिया आकार और उपयोगी भागों को बाहर निकालने का एक सरल तरीका है: def parse_transcript(response: dict) -> None: """ Print the transcript, word-level timestamps, confidence scores, and detected language. """ full_text = response.get("transcription", "") print(f"Transcript: {full_text}") words = response.get("words", []) for word in words: text = word.get("word", "") start = word.get("start") end = word.get("end") confidence = word.get("confidence") start_text = f"{start:.2f}s" if isinstance(start, (int, float)) else "?" end_text = f"{end:.2f}s" if isinstance(end, (int, float)) else "?" confidence_text = ( f"{confidence:.2f}" if isinstance(confidence, (int, float)) else "?" ) print(f"[{start_text} - {end_text}] {text} (confidence: {confidence_text})") language = response.get("language", "unknown") print(f"Detected language: {language}") आत्मविश्वास स्कोर को एक रूटिंग सिग्नल के रूप में मानें, न कि सामान्य ज्ञान के रूप में। जब कोई शब्द ~0.7 से नीचे गिरता है, तो मॉडल आपको बता रहा होता है कि वह अनुमान लगा रहा है, अक्सर शोर, किसी अपरिचित संज्ञा (proper noun), या ओवरलैपिंग भाषण के कारण। उत्पादन में, कम-विश्वास वाले स्पैन डाउनस्ट्रीम सिस्टम में अनिश्चितता को लीक करने देने के बजाय मानवीय समीक्षा को ट्रिगर करने के लिए एक अच्छी जगह हैं। एक ट्रांसक्रिप्शन API प्रतिक्रिया की शारीरिक रचना: ट्रांसक्रिप्ट, शब्द-स्तरीय टाइमस्टैम्प और आत्मविश्वास स्कोर। स्पीकर डायराइजेशन: यह जानना कि किसने क्या कहा। एकल-स्पीकर ऑडियो आसान मोड है। मीटिंग, पॉडकास्ट और सपोर्ट कॉल वे जगहें हैं जहाँ चीजें दिलचस्प हो जाती हैं, क्योंकि "क्या कहा गया था" पर्याप्त नहीं है, आपको "किसने कहा" की आवश्यकता है। यह डायराइजेशन है, और आप आमतौर पर अपने अनुरोध मापदंडों में `diarize: True` के साथ इसे चालू करते हैं। जब डायराइजेशन सक्षम होता है, तो Pulse शब्द-स्तरीय और उच्चारण-स्तरीय आउटपुट में स्पीकर लेबल जोड़ता है, ताकि आप ट्रांसक्रिप्ट को एक बातचीत के रूप में फिर से बना सकें। def format_diarized_transcript(response: dict) -> str: """ Format diarized utterances into a readable speaker-by-speaker transcript. """ utterances = response.get("utterances", []) lines = [] for utterance in utterances: speaker = utterance.get("speaker", "unknown_speaker") text = utterance.get("text", "").strip() start = utterance.get("start", 0) if not text: continue lines.append(f"[{start:.1f}s] {speaker}: {text}") return "\n".join(lines) एक पेंच है: जब लोग एक-दूसरे के ऊपर बात करते हैं तो डायराइजेशन खराब हो जाता है। कॉल-सेंटर ऑडियो में, रुकावटें आम हैं, और सबसे साफ समाधान अक्सर अपस्ट्रीम होता है (जब आपके पास अलग चैनल हों, फिर ट्रांसक्राइब करें) बजाय इसके कि मॉडल से क्रॉस-टॉक को पूरी तरह से सुलझाने की उम्मीद की जाए। स्पीकर डायराइजेशन पाइपलाइन्स गाइड बहु-वक्ता रणनीतियों पर अधिक गहराई से बात करती है। लंबी ऑडियो फ़ाइलें और चंकिंग रणनीतियाँ संभालना। ट्रांसक्रिप्शन API आमतौर पर फ़ाइल आकार या अवधि पर सीमाएं लगाते हैं। भले ही आपका ऐसा न करे, एक एकल अनुरोध के माध्यम से 90 मिनट की रिकॉर्डिंग को धक्का देना मुसीबत को बुलावा देना है: एक टाइमआउट और आप वापस शून्य पर आ जाते हैं। पाइपलाइन को लचीला रखने के लिए लंबी ऑडियो को छोटे टुकड़ों में बांटना (chunking) मानक तरीका है। लंबी ऑडियो फ़ाइलों के लिए एक मजबूत चंकिंग रणनीति: `pydub` के `make_chunks` विधि का उपयोग करके ऑडियो को 30-60 सेकंड के खंडों में विभाजित करें। सीमाओं पर शब्दों को कटने से बचाने के लिए टुकड़ों के बीच 1-2 सेकंड का ओवरलैप जोड़ें। प्रत्येक टुकड़े को स्वतंत्र रूप से ट्रांसक्राइब करें और क्रम में परिणाम एकत्र करें। एक सरल स्ट्रिंग संरेखण (alignment) जांच का उपयोग करके ओवरलैप क्षेत्र में डुप्लिकेट शब्दों को हटाकर ट्रांसक्रिप्ट को मर्ज करें। मूल फ़ाइल में अपनी प्रारंभ स्थिति के अनुसार प्रत्येक टुकड़े के शब्द टाइमस्टैम्प को ऑफसेट करके वैश्विक टाइमस्टैम्प को सुरक्षित रखें। from pydub import AudioSegment def split_audio_with_overlap( input_path: str, output_dir: str, chunk_length_ms: int = 60_000, overlap_ms: int = 2_000, ) -> list[str]: """ Split long audio into overlapping chunks. Default: 60-second chunks with 2-second overlap. """ audio = AudioSegment.from_file(input_path) chunk_paths = [] start = 0 chunk_index = 0 while start < len(audio): end = min(start + chunk_length_ms, len(audio)) chunk = audio[start:end] chunk_path = f"{output_dir}/chunk_{chunk_index:04d}.wav" chunk.export(chunk_path, format="wav") chunk_paths.append(chunk_path) if end == len(audio): break start = end - overlap_ms chunk_index += 1 return chunk_paths वह ओवरलैप "ज्यादातर काम करता है" और एक ऐसे सिस्टम के बीच का अंतर है जो सीमाओं पर अनुमानित रूप से व्यवहार करता है। इसके बिना, सीमा पर आने वाले शब्द कट जाते हैं और या तो गायब हो जाते हैं या विकृत होकर वापस आते हैं। एक सेकंड का ओवरलैप मुश्किल से प्रसंस्करण लागत को बदलता है, लेकिन यह किनारे के मामलों की एक पूरी श्रेणी को समाप्त कर देता है। यदि आप लहजे, कोड-स्विचिंग, या बहुभाषी ऑडियो से निपट रहे हैं, तो बहुभाषी ऑडियो के लिए स्पीच-टू-टेक्स्ट गाइड अतिरिक्त नुकसानों को रेखांकित करता है। ओवरलैपिंग सेगमेंट के साथ लंबी ऑडियो को चंक करना स्प्लिट पॉइंट पर वर्ड-बाउंड्री त्रुटियों को रोकता है। उत्पादन विचार: त्रुटि हैंडलिंग, पुन: प्रयास (retries), और लागत नियंत्रण। लैपटॉप स्क्रिप्ट एक डेमो है; उत्पादन वह जगह है जहाँ गन्दी चीजें दिखाई देती हैं। दर सीमाएं (Rate limits) लागू होती हैं, नेटवर्क बंद हो जाते हैं, और उपयोगकर्ता उन प्रारूपों में ऑडियो अपलोड करते हैं जिनकी आपने योजना नहीं बनाई थी (या रिकॉर्डिंग जो होनी चाहिए उससे कहीं अधिक लंबी हैं)। यदि आप उन तीनों के लिए पहले से योजना बनाते हैं, तो बाकी ज्यादातर इंजीनियरिंग है। दर सीमाओं और क्षणिक विफलताओं के लिए, घातीय बैकऑफ़ (exponential backoff) का उपयोग करें। `tenacity` इसे साफ रखता है: `@retry(wait=wait_exponential(multiplier=1, min=2, max=30), stop=stop_after_attempt(5))`। उस डेकोरेटर को अपने API कॉल पर रखें और आप अपनी खुद की पुन: प्रयास स्थिति मशीन लिखे बिना अधिकांश अल्पकालिक मुद्दों से पार पा लेंगे। pip install tenacity import os import requests from dotenv import load_dotenv from tenacity import retry, stop_after_attempt, wait_exponential load_dotenv() @retry( wait=wait_exponential(multiplier=1, min=2, max=30), stop=stop_after_attempt(5), ) def transcribe_with_retries(file_path: str) -> dict: """ Transcribe audio with retries for transient API or network failures. """ api_key = os.getenv("SMALLEST_API_KEY") if not api_key: raise ValueError("Missing SMALLEST_API_KEY in environment variables.") url = "https://api.smallest.ai/waves/v1/pulse/get_text" params = { "language": "en", "word_timestamps": "true", "diarize": "false", } headers = { "Authorization": f"Bearer {api_key}", "Content-Type": "audio/wav", } with open(file_path, "rb") as audio_file: लागत उत्पादन का दूसरा आश्चर्य है। अधिकांश ट्रांसक्रिप्शन API प्रति मिनट बिल करते हैं, जिसका अर्थ है कि "बस इसे चलाएं" तेजी से महंगा हो सकता है। दो आदतें खर्च को अनुमानित रखती हैं: अपलोड करने से पहले अवधि की जांच करें (और ऐप लेयर पर अपने कैप से ऊपर की किसी भी चीज़ को अस्वीकार करें), और परिणाम कैश करें ताकि एक ही फ़ाइल को दो बार ट्रांसक्राइब न किया जाए। ऑडियो का एक कंटेंट हैश एक व्यावहारिक कैश कुंजी बनाता है। यदि आप बड़े पैमाने पर निर्माण कर रहे हैं, तो स्पीच-टू-टेक्स्ट गाइड उच्च-थ्रूपुट आर्किटेक्चर, एसिंक वर्कर्स, कतारों और उन पैटर्नों में प्रवेश करता है जो लंबे समय तक चलने वाले पाइपलाइनों को स्थिर रखते हैं। ट्रांसक्रिप्शन सटीकता के बारे में अधिकांश डेवलपर्स क्या गलत समझते हैं। एक 5% WER तब तक छोटा लगता है जब तक आप इसका अनुवाद नहीं करते: लगभग हर 20 शब्दों में से 1 गलत है। 500 शब्दों की मीटिंग सारांश में, यह लगभग 25 त्रुटियां हैं। अत्याधुनिक मॉडल भी साफ बेंचमार्क स्थितियों की तुलना में शोर वाले, सहज संवादात्मक भाषण पर सार्थक रूप से उच्च शब्द त्रुटि दर दिखाते हैं (कभी-कभी 20% से अधिक) यही कारण है कि अपने स्वयं के ऑडियो पर परीक्षण करना गैर-परक्राम्य है। इसलिए बेंचमार्क ऐसे करें जैसे आपका कोई मतलब हो। अपने API का परीक्षण उस ऑडियो पर करें जो आपके उत्पाद से मेल खाता हो, न कि साफ डेमो क्लिप पर। वास्तविक वातावरण से 10-15 मिनट कैप्चर करें, सटीकता मापें, और उसके बाद ही प्रतिबद्ध हों। डोमेन शब्दावली वह जगह है जहाँ सामान्य मॉडल सबसे अधिक लड़खड़ाते हैं, चिकित्सा शब्द, उत्पाद के नाम, आंतरिक संक्षिप्त शब्द। यदि आपका प्रदाता कस्टम शब्दावली या डोमेन अनुकूलन प्रदान करता है, तो इसका उपयोग तब करें जब विशेष शब्दावली काम का हिस्सा हो। सारांश और अगले कदम। Python में एक भरोसेमंद ऑडियो-टू-टेक्स्ट पाइपलाइन आमतौर पर चार विषयों पर निर्भर करती है: API द्वारा देखे जाने से पहले ऑडियो को सामान्य करें, प्रतिक्रिया को संरचित डेटा के रूप में मानें (एकल स्ट्रिंग नहीं), ओवरलैप के साथ लंबी रिकॉर्डिंग को चंक करें, और पुन: प्रयास और त्रुटि हैंडलिंग को प्रथम-श्रेणी की सुविधाओं के रूप में बनाएं। यहाँ दिए गए स्निपेट जानबूझकर छोटे रखे गए हैं ताकि आप उन्हें बिना दोबारा लिखे अपने खुद के स्टैक में डाल सकें। जैसे-जैसे उपयोग बढ़ेगा, आप संभवतः एसिंक प्रोसेसिंग, एक जॉब कतार और परिणामों के लिए टिकाऊ स्टोरेज जोड़ेंगे, लेकिन कोर फ्लो नहीं बदलता है। यदि आप स्पीच-टू-टेक्स्ट प्रदाताओं की तुलना कर रहे हैं, तो Smallest.ai का Pulse उन डेवलपर्स के लिए बनाया गया है जो विलंबता, ट्रांसक्रिप्शन गुणवत्ता और एक ऐसे API की परवाह करते हैं जो सफाई से एकीकृत होता है। यह स्ट्रीमिंग ट्रांसक्रिप्शन, स्पीकर डायराइजेशन, वर्ड-स्तरीय टाइमस्टैम्प और आउट ऑफ द बॉक्स बहुभाषी ऑडियो का समर्थन करता है, जो ऊपर दिए गए उत्पादन पैटर्नों के साथ संरेखित होता है। आज ही Python में ऑडियो ट्रांसक्राइब करना शुरू करने के लिए Pulse और Waves API का अन्वेषण करें। Python में उत्पादन के लिए तैयार ट्रांसक्रिप्शन पाइपलाइन के चार स्तंभ। गशवर्क टीम: इसे अनदेखा करें। Python में ऑडियो ट्रांसक्रिप्शन बनाएं। आज ही स्पीच-टू-टेक्स्ट वर्कफ़्लो का परीक्षण शुरू करें। निर्माण शुरू करें https://app.smallest.ai/ FAQ पंक्ति केवल तभी दिखाई देगी जब FAQ उत्तर सेट होगा। कृपया सुनिश्चित करें कि प्रश्न और उत्तर दोनों सेट हैं। FAQ अनुभाग की दृश्यता FAQ प्रश्न 1 के सेट होने से जुड़ी है।](https://framerusercontent.com/images/5h0IzsaRLohS5uAxf7C2xhgJnOI.png?width=1456&height=816)