बेंचमार्क
टेक्स्ट-टू-स्पीच लीडरबोर्ड
ElevenLabs, OpenAI, Cartesia और Murf की तुलना में Smallest Lightning के लिए श्रोताओं की पसंद, गुणवत्ता स्कोर और पहले ऑडियो का समय, पूरी कार्यप्रणाली और पुनः प्रस्तुत करने योग्य स्क्रिप्ट के साथ।
अंतिम बार अपडेट किया गया
16 अक्टूबर 2026
अनुभाग 01
विलंबता की तुलना
एक साझा मिलीसेकंड स्केल पर प्लॉट किया गया है ताकि वास्तविक स्प्रेड दिखाई दे। औसत उन कॉल्स को छुपा देते हैं जो टूटे हुए लगते हैं, इसलिए जहां भी परसेंटाइल मौजूद होते हैं, वे दिखाई देते हैं।
टेक्स्ट-टू-स्पीच, पहले ऑडियो तक का समय
सबसे तेज़ वाले को पहले क्रमबद्ध किया गया है। वेंडर की श्रेणियों को उनके पूरे स्पैन में कैप्सूल के रूप में खींचा गया है, न कि मध्यबिंदु पर संकुचित किया गया है।

इन आंकड़ों के अनुसार मर्फ़ (Murf) और कार्टेशिया (Cartesia) लाइटनिंग (Lightning) से अधिक तेज़ हैं। कार्टेशिया का आंकड़ा 90वां पर्सेंटाइल है और वेलसैड (WellSaid) का आंकड़ा प्रति 30 अक्षरों के हिसाब से है, इसलिए इस पूरे सेट को एक समान मापदंड पर नहीं मापा गया है।
200 ms से कम
200 से 300 मिलीसेकंड
400 ms से अधिक
सबसे छोटा मापा गया
प्रतिशतक (परसेंटाइल) क्यों, माध्य (मीन) क्यों नहीं
एक वॉयस एजेंट का मूल्यांकन उसके सबसे खराब प्रदर्शन के आधार पर किया जाता है। 200 ms औसत और 2 सेकंड P99 वाला मॉडल, 300 ms औसत और 400 ms P99 वाले मॉडल की तुलना में अधिक बार खराब महसूस होता है, और केवल औसत मान आपको यह नहीं बता सकता कि आपके पास कौन सा मॉडल है। जहाँ हमारे पास प्रतिशतक (percentiles) उपलब्ध हैं, हम उन्हें प्रकाशित करते हैं और जहाँ नहीं हैं, वहाँ अंतर को चिह्नित करते हैं।
टेक्स्ट-टू-स्पीच, पहले ऑडियो तक का समय
अनुभाग 02
हम बेंचमार्क कैसे करते हैं
पैरामीटर पहले ही स्पष्ट रूप से बता दिए गए हैं, न कि किसी खुलासे के पीछे छिपाए गए हैं। सार्वजनिक बेंचमार्क को ओवरफिट और प्रभावित किया जा सकता है, जो कि आपकी कार्यप्रणाली को दिखाने का एक तर्क है, न कि किसी एक संख्या के पीछे छिपने का।
डेटासेट
ईएसबी (ESB) सुइट, 9 डेटासेट, अंग्रेजी। बहुभाषी के लिए फ्लर्स (FLEURS), 26 भाषाएं। खराब रिकॉर्डिंग स्थितियों के लिए वाइल्डएएसआर (WildASR)। आंतरिक अंग्रेजी और हिंदी विरूपण (perturbation) सुइट्स। इमर्जेंटटीटीएस (EmergentTTS), 1,645-नमूनों के सार्वजनिक सेट से लिए गए 1,088 नमूने। एआईईडब्ल्यूएफ (AIEWF), 30 टर्न के 10 रनों में 300 कार्य। साथ ही 44 वास्तविक हिंदी-अंग्रेजी संग्रह कॉल।
सटीकता मीट्रिक
Whisper नॉर्मलाइज़र के तहत शब्द त्रुटि दर (Word error rate), साथ में वर्ण त्रुटि दर (character error rate) भी दी गई है। यह विकल्प महत्वपूर्ण है: एक तीसरे पक्ष के बोर्ड ने पल्स को 8.0% पर रिपोर्ट किया, जहां इनवर्स टेक्स्ट नॉर्मलाइज़ेशन ने शब्दों में लिखे गए नंबरों को त्रुटियों के रूप में गिना, जबकि अन्यथा यह 5.1% था। नंबरों से भरपूर कॉल ऑडियो पर नॉर्मलाइज़र उत्तर को बदल देता है।
विलंबता मीट्रिक
पहले ट्रांसक्रिप्ट का समय भाषण के समाप्त होने से लेकर पूरे ट्रांसक्रिप्ट तक चलता है। पहले बाइट का समय प्राप्त पहला ऑडियो बाइट होता है। वॉयस-टू-वॉयस का मतलब उपयोगकर्ता के भाषण के समाप्त होने से लेकर एजेंट के ऑडियो शुरू होने तक का समय है। इसे P50, P90, P95 और P99 के रूप में रिपोर्ट किया जाता है, जहाँ भी रन ने उन्हें उत्पन्न किया है।
ग्राउंड ट्रुथ (वास्तविक तथ्य)
कॉल बेंचमार्क के लिए मैन्युअल मानव ट्रांसक्रिप्शन। सार्वजनिक डेटासेट अपने स्वयं के प्रकाशित संदर्भों का उपयोग करते हैं, जिनमें कोई संशोधन नहीं किया गया है।
हार्डवेयर
सिंगल L40S, 48 GB पर थ्रूपुट। 16 kHz linear16 पर स्ट्रीमिंग परीक्षण। प्रतिस्पर्धी मॉडल उनके सार्वजनिक प्रोडक्शन API के माध्यम से कॉल किए गए हैं, न कि सेल्फ-होस्टेड।
रीफ़्रेश करने की आवृत्ति
त्रैमासिक रूप से, और तुरंत जैसे ही तुलना सेट में कोई भी मॉडल नया संस्करण शिप करता है। प्रत्येक तालिका की अपनी माप तिथि होती है।
इसे फिर से बनाएं
मूल्यांकन वॉकथ्रू और स्क्रिप्ट सार्वजनिक हैं, और नीचे दिए गए प्रत्येक परिणाम को आपके अपने ऑडियो के साथ फिर से जनरेट किया जा सकता है।
अनुभाग 03
लिखावट से वाचन
इमर्जेंटटीटीएस (EmergentTTS) बेंचमार्क पर ब्लाइंड हेड-टू-हेड श्रोता प्राथमिकता, और फिर उन्हीं मॉडलों को हर आयाम (डायमेंशन) के आधार पर रेट किया गया।
प्रत्येक प्रतियोगी के खिलाफ लाइटनिंग की जीत की दर
1,088 नमूने। ठोस रेखा 50% को दर्शाती है, जहाँ किसी भी मॉडल को प्राथमिकता नहीं दी गई है।
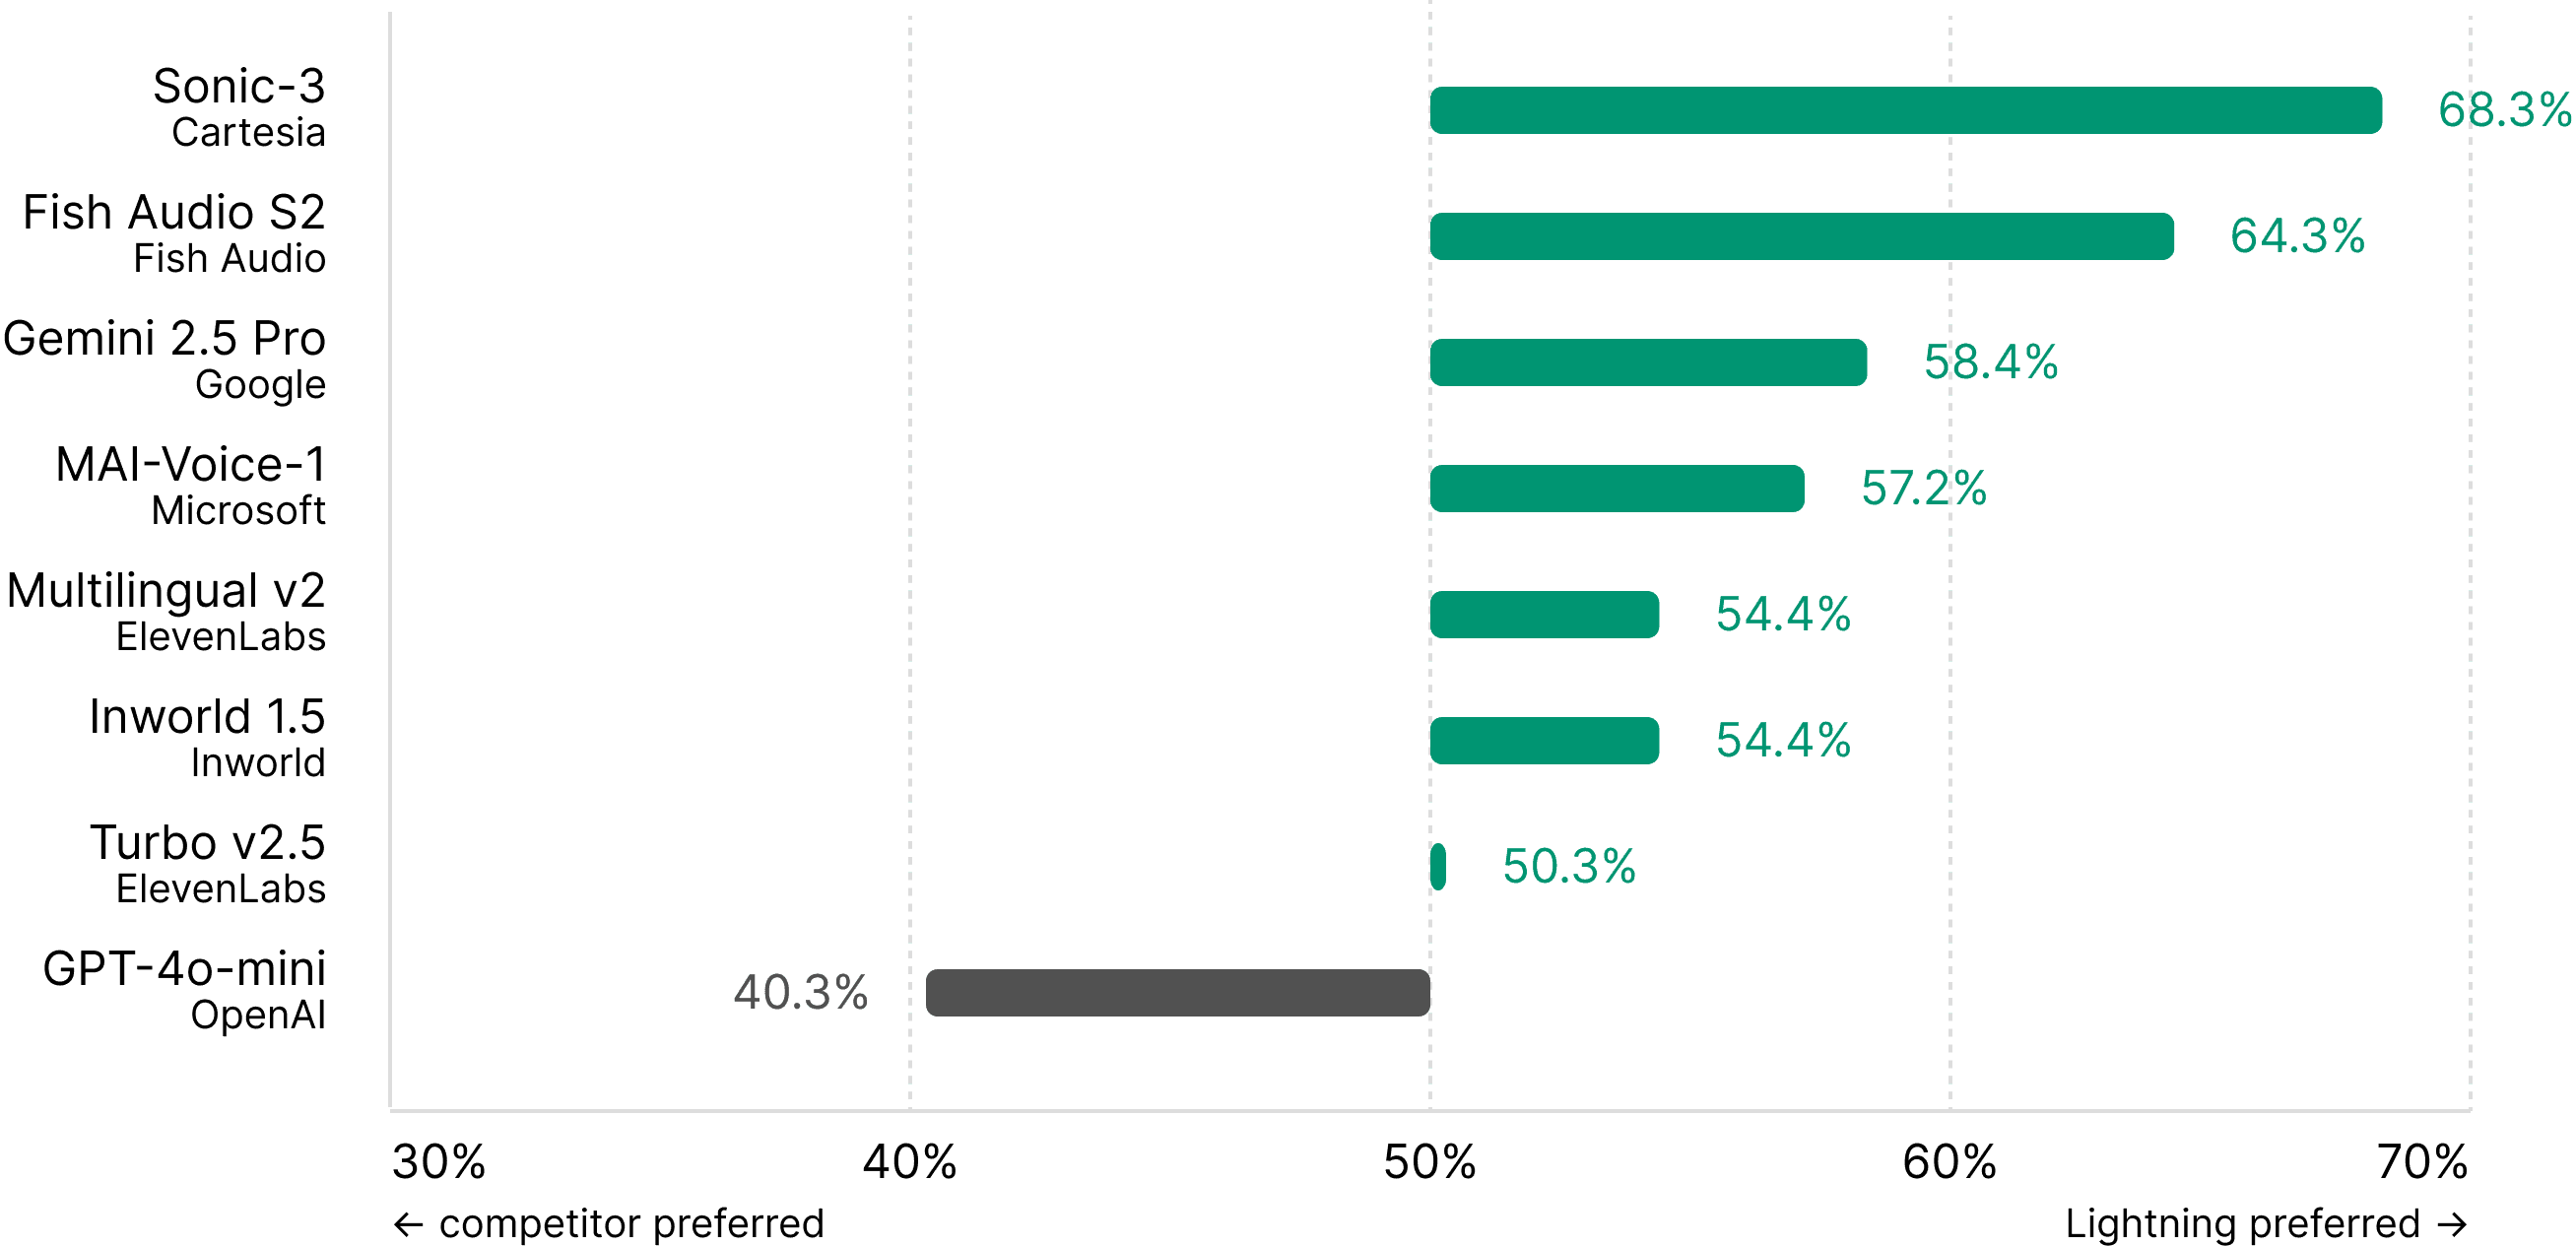
GPT-4o-mini TTS इस बेंचमार्क पर Lightning को पछाड़ देता है। वह पंक्ति बनी रहेगी। ये 1,088 नमूने सार्वजनिक EmergentTTS सेट के 1,645 नमूनों का एक उपसमुच्चय (subset) हैं।
सबसे छोटा मापा गया
प्राकृतिकता
मीट्रिक
कुल मिलाकर
प्राकृतिकता
स्वर-शैली
स्वर-शैली (Prosody)
लाइटनिंग प्रो
3.16
२.५५
3.06
2.81
जीपीटी-4ओ-मिनी
3.13
2.41
3.06
2.73
ईएल टर्बो v2.5
3.16
2.52
3.07
2.73
सोनिक-3
3.20
2.57
3.12
2.83
अभिव्यक्तिशीलता
कुल मिलाकर
पराभाषिकी
भावनाएं
3.55
3.64
३.४७
3.45
3.60
3.30
3.44
3.59
3.28
3.38
3.56
2.83
एमओएस वी2
औसत MOS
यूटीएमओएस (UTMOS), अनुमानित
डब्ल्यूवी-एमओएस (WV-MOS), अनुमानित
4.22
3.77
5.05
4.16
3.76
४.५५
3.98
३.३७
४.६०
3.76
2.77
4.76
डिलीवरी
प्राकृतिक गति
प्लेसमेंट रोकें
प्राकृतिक सांस लेना
उच्चारण शैली
सीमा निरंतरता
4.72
४.६६
3.82
4.98
४.९६
4.57
4.54
3.06
४.९६
4.94
4.51
४.४९
3.14
4.95
4.93
4.01
४.२८
2.79
४.९६
4.93
प्रदर्शन लाइटनिंग का लाभ अभिव्यक्ति, प्रदायगी और सांस लेने में है, जहां अंतर बड़ा है: प्राकृतिक रूप से सांस लेने पर 2.79 के मुकाबले 3.82। यह ऊपर दिए गए हेड-टू-हेड चार्ट का भी खंडन करता है, जहां 68.3% मामलों में सोनिक-3 की तुलना में लाइटनिंग को प्राथमिकता दी गई थी। ब्लाइंड वरीयता और आयामी रेटिंग विभिन्न चीजों को मापती हैं, और केवल चापलूसी वाली रेटिंग के बजाय दोनों की रिपोर्ट की जाती है। UTMOS और WV-MOS मॉडल द्वारा अनुमानित हैं, न कि मानव रेटिंग।
सिंथेसिस सटीकता, जिसे व्हिस्पर (Whisper) के साथ वापस ट्रांसक्राइब किया गया और इनपुट टेक्स्ट के मुकाबले स्कोर किया गया
मीट्रिक
लाइटनिंग v3.1
लाइटनिंग v3.1 प्रो
वर
1.57%
1.36%
सीईआर
0.67%
0.40%
मतिभ्रम
0.03%
0.00%
हिन्दी, तमिल, कन्नड़, तेलुगु, मलयालम, मराठी और गुजराती सहित 15 भाषाएं, स्वचालित भाषा पहचान और वाक्य के बीच में भाषा बदलने की सुविधा के साथ।
40 समवर्ती स्ट्रीम पर पहले बाइट तक का समय लगभग 200 मिलीसेकंड।
मूल्य निर्धारण: एक ही उत्पाद के लिए हमारी अपनी सामग्रियों में तीन अलग-अलग आंकड़े दिखाई देते हैं, प्रति 10 हजार वर्णों पर $0.05, $0.145 और $0.175। समाधान होने तक यहां प्रकाशित नहीं किया गया है।
स्रोत डेटा और आगे पढ़ने के लिए सामग्री
खंड 04
अक्सर पूछे जाने वाले प्रश्न
आप टेक्स्ट-टू-स्पीच की गुणवत्ता को कैसे मापते हैं?
क्या लाइटनिंग हर तुलना में जीतती है?
TTFB, TTFT और voice-to-voice में क्या अंतर है?
Lightning किन भाषाओं का समर्थन करता है?
क्या ये संख्याएँ स्वतंत्र हैं?
ये बेंचमार्क कितनी बार रीफ़्रेश किए जाते हैं?