एक हाई-परफॉर्मेंस रियल-टाइम एएसआर (ASR) एपीआई को क्या खास बनाता है?
एक हाई-परफॉर्मेंस रियल-टाइम ASR API को परिभाषित करने वाले प्रमुख मैट्रिक्स के बारे में जानें — जैसे लेटेंसी, सटीकता, एनरिचमेंट फीचर्स, और बहुत कुछ।
रीयल-टाइम ऑटोमैटिक स्पीच रिकग्निशन एक सीमित क्षमता से निकलकर आधुनिक वॉइस एप्लिकेशन्स का एक मुख्य आधार बन गया है। चाहे आप एक लाइव कैप्शनिंग सिस्टम, एक वॉइस असिस्टेंट, एक टेलीफोनी कंप्लायंस इंजन, या एक संवादात्मक AI वर्कफ़्लो बना रहे हों, आपके रीयल टाइम ASR API की गुणवत्ता यह तय करती है कि आपका प्रोडक्ट यूज़र्स के लिए कितना रिस्पॉन्सिव और इंटेलिजेंट महसूस होता है।
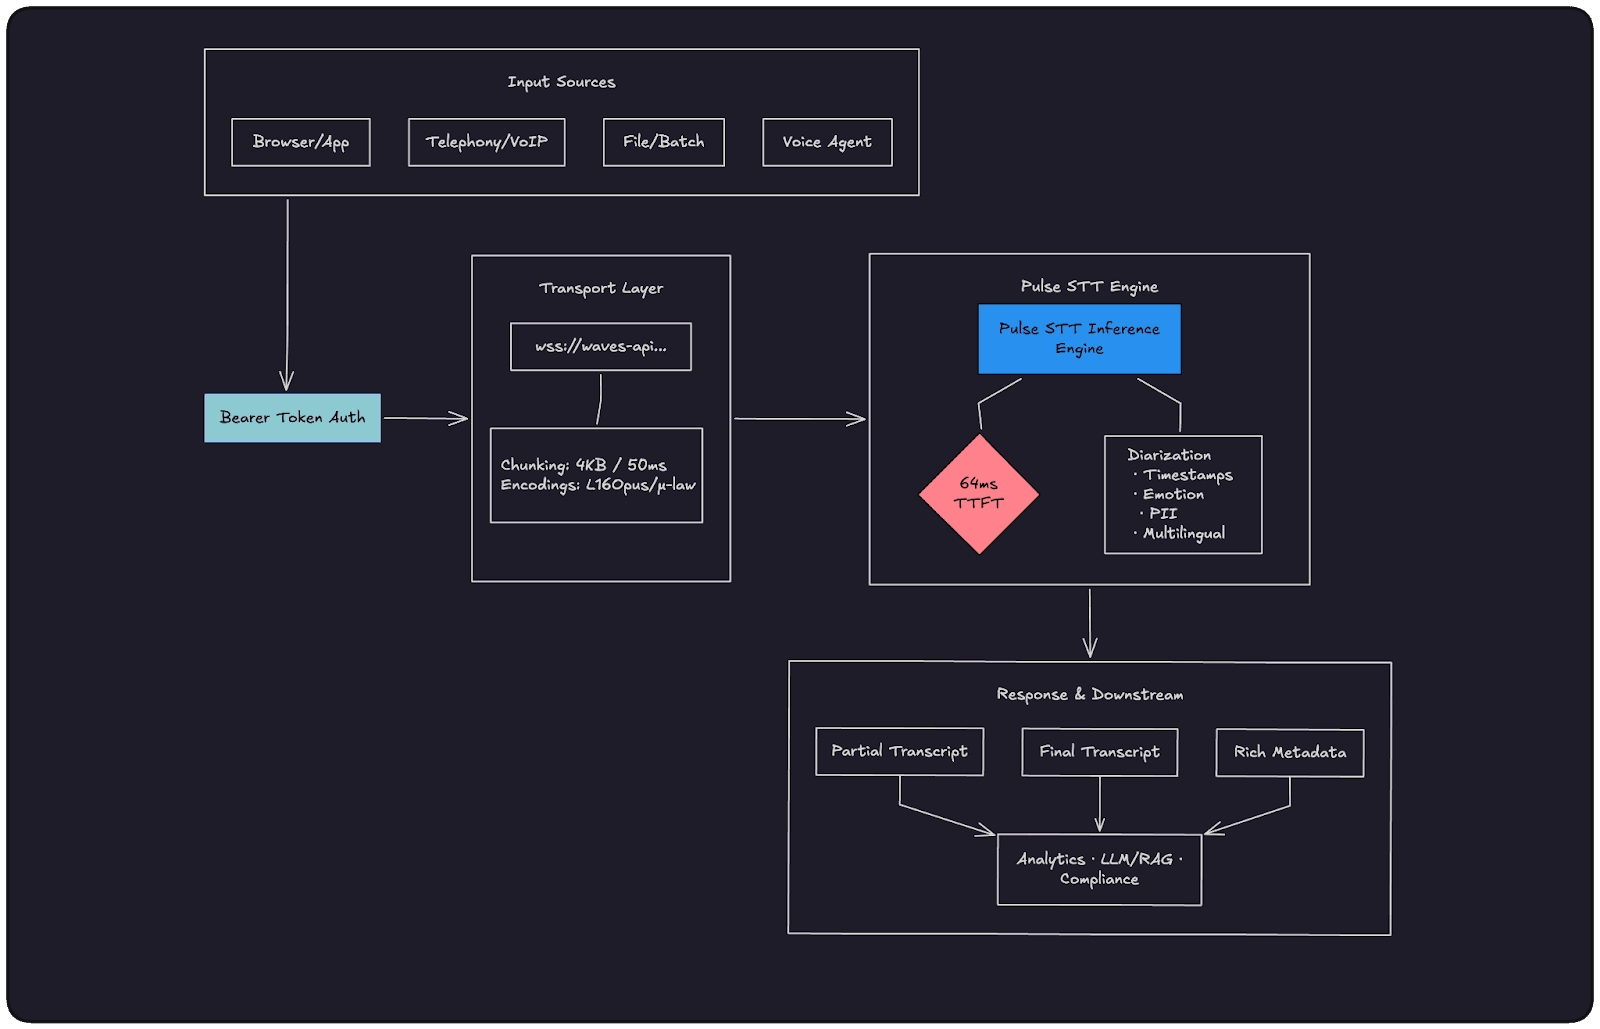
यह गाइड आपके एप्लिकेशन्स में Pulse स्पीच-टू-टेक्स्ट (STT) API को इंटीग्रेट करने के लिए ज़रूरी हर चीज़ को कवर करती है। केवल 64 मिलीसेकंड के टाइम टू फर्स्ट ट्रांसक्रिप्ट (TTFT) के साथ, Pulse स्पीच-टू-टेक्स्ट (STT) API को विशेष रूप से लाइव, लेटेंसी-सेंसिटिव वर्कलोड के लिए तैयार किया गया है।
हम ऑथेंटिकेशन, वेबसॉकेट कनेक्शन्स, ऑडियो एनकोडिंग, रिस्पॉन्स हैंडलिंग, एडवांस्ड फीचर्स और प्रोडक्शन से जुड़ी बेस्ट प्रैक्टिसेज के बारे में पूरे कोड उदाहरणों के साथ जानेंगे।
रीयल-टाइम ASR क्या है और यह क्यों मायने रखता है?
ऑटोमैटिक स्पीच रिकग्निशन (ASR) वह टेक्नोलॉजी है जो बोली जाने वाली ऑडियो को टेक्स्ट में बदलती है। एक रीयल टाइम ASR API इससे भी आगे जाता है; यह ऑडियो के आते ही उसे एक निरंतर स्ट्रीम में प्रोसेस करता है, और पूरे ऑडियो फ़ाइल के अपलोड होने और उसका विश्लेषण होने का इंतज़ार करने के बजाय मिलीसेकंड के भीतर आंशिक (पार्शियल) और अंतिम ट्रांसक्रिप्ट वापस कर देता है।
हाई-लेवल आर्किटेक्चर: Waves Pulse API प्रोसेस कैसे काम करता है:
स्ट्रीमिंग ASR के लिए मुख्य उपयोग के मामले (Use Cases):
लाइव बातचीत और कॉल एनालिटिक्स
वॉइस असिस्टेंट और संवादात्मक एजेंट
लाइव कैप्शनिंग और एक्सेसिबिलिटी (सुगम्यता)
स्ट्रीमिंग कंप्लायंस और PII रिडैक्शन (व्यक्तिगत जानकारी छिपाना)
Pulse स्पीच-टू-टेक्स्ट (STT) API क्यों सबसे अलग है
Pulse STT API को शुरू से ही स्ट्रीमिंग-फर्स्ट वर्कलोड के लिए डिज़ाइन किया गया था। इसकी सबसे बड़ी खासियत इसका 64 ms टाइम टू फर्स्ट ट्रांसक्रिप्ट (TTFT) है — यानी वह समय जब ऑडियो डेटा पहली बार सर्वर पर पहुंचता है और जब पहले ट्रांसक्राइब किए गए शब्द वापस मिलते हैं। यह कई स्थापित क्लाउड STT प्रदाताओं की तुलना में काफी तेज़ है, जिनका TTFT आमतौर पर 200 से 500 ms के बीच होता है।
Pulse STT स्पीकर डायराइजेशन, वर्ड टाइमस्टैम्प, इमोशन डिटेक्शन, उम्र और जेंडर का अनुमान, PII रिडैक्शन, और न्यूमेरिक फ़ॉर्मेटिंग जैसी एडवांस्ड फीचर्स को सीधे अपने ट्रांसक्रिप्शन आउटपुट में शामिल करता है, जिससे अलग से डाउनस्ट्रीम एनालिसिस पाइपलाइन की आवश्यकता समाप्त हो जाती है।
एक बेहतरीन रीयल-टाइम ASR API की क्या खूबियाँ होती हैं?
सभी स्पीच रिकग्निशन API एक ही काम के लिए नहीं बने होते हैं। पॉडकास्ट प्रोसेसिंग के लिए ऑप्टिमाइज़ किए गए बैच ट्रांसक्रिप्शन API की इंजीनियरिंग प्राथमिकताएं लाइव वॉइस एजेंट या टेलीफोनी कंप्लायंस के लिए डिज़ाइन किए गए API से बहुत अलग होती हैं। किसी ASR प्रदाता को चुनने से पहले, यहाँ वे पहलू दिए गए हैं जो प्रोडक्शन में वास्तव में मायने रखते हैं।
1. टाइम टू फर्स्ट ट्रांसक्रिप्ट (TTFT)
संवादात्मक एप्लिकेशन्स के लिए यह सबसे महत्वपूर्ण मीट्रिक है। TTFT उस समय को मापता है जब ऑडियो पहली बार सर्वर पर पहुंचता है और पहले ट्रांसक्राइब किए गए शब्द वापस आते हैं। 200-500ms पर (वह रेंज जिसमें अधिकांश पुराने क्लाउड प्रदाता हैं), एक स्पष्ट रुकावट या देरी महसूस होती है जो स्वाभाविक बातचीत के अनुभव को बिगाड़ देती है। 100ms से कम होने पर, बातचीत बिल्कुल रीयल-टाइम महसूस होती है। यही कारण है कि Pulse STT का 64ms TTFT केवल एक मार्केटिंग नंबर नहीं बल्कि एक इंजीनियरिंग लक्ष्य है — यह वह सीमा है जहाँ वॉइस AI केवल एक डेमो न लगकर एक वास्तविक प्रोडक्ट की तरह काम करने लगता है।
2. पार्शियल बनाम फाइनल ट्रांसक्रिप्ट
एक अच्छा स्ट्रीमिंग ASR API आपको स्पीकर द्वारा अपना वाक्य पूरा करने का इंतज़ार नहीं करवाता है। जैसे ही शब्दों की पहचान होती है, यह पार्शियल ट्रांसक्रिप्ट वापस कर देता है, जिससे आपका UI रीयल टाइम में अपडेट हो जाता है, और फिर स्पीच सेगमेंट पूरा होने पर फाइनल ट्रांसक्रिप्ट सबमिट करता है। यह अंतर बहुत मायने रखता है: पार्शियल्स लाइव डिस्प्ले और लो-लेटेंसी इंटेंट डिटेक्शन के लिए बेहतरीन हैं; जबकि फाइनल्स वे होते हैं जिन्हें आप LLM को पास करते हैं, डेटाबेस में लिखते हैं, या कंप्लायंस लॉगिंग के लिए उपयोग करते हैं। एक ऐसा API जो केवल फाइनल्स वापस करता है, वह आपको लेटेंसी और रिलायबिलिटी (विश्वसनीयता) के बीच किसी एक को चुनने के लिए मजबूर करता है।
3. वास्तविक परिस्थितियों में वर्ड एरर रेट (WER)
क्लीन स्टूडियो ऑडियो पर मापे गए बेंचमार्क WER नंबर प्रोडक्शन के उपयोग के लिए लगभग अर्थहीन हैं। आपको यह जानने की आवश्यकता है कि मॉडल टेलीफोनी ऑडियो (8kHz, mulaw-एनकोडेड, बैकग्राउंड नॉइज़), गैर-मूल लहजे (non-native accents), डोमेन-विशिष्ट शब्दावली (मेडिकल, लीगल, फाइनेंशियल) और वाक्य के बीच में भाषाओं को बदलने (कोड-स्विचिंग) पर कैसा प्रदर्शन करता है। किसी प्रदाता को चुनने से पहले, ऐसे ऑडियो पर टेस्ट करें जो आपके वास्तविक वर्कलोड जैसा दिखता हो, न कि किसी चुनिंदा डेटासेट पर।
4. नेटिव एनरिचमेंट बनाम अलग से जोड़ी गई पाइपलाइन
कई ASR प्रदाता आपको केवल ट्रांसक्राइब किया गया टेक्स्ट देते हैं और कुछ नहीं, जिससे आपको स्पीकर डायराइजेशन, PII रिडैक्शन, सेंटिमेंट एनालिसिस या वर्ड-लेवल टाइमस्टैम्प के लिए अलग-अलग सर्विसेज को खुद जोड़ना पड़ता है। प्रत्येक अतिरिक्त सर्विस लेटेंसी, लागत और विफलता की संभावना को बढ़ाती है। एक अच्छी तरह से डिज़ाइन किया गया रीयल-टाइम ASR API इन क्षमताओं को नेटिव रूप से स्ट्रीमिंग पाथ में शामिल करता है ताकि आपको अपनी ज़रूरत की हर चीज़ — ट्रांसक्रिप्ट, स्पीकर ID, टाइमस्टैम्प, इमोशन्स — के साथ एक सिंगल JSON रिस्पॉन्स मिले, बिना किसी मल्टी-स्टेज पाइपलाइन को बनाए और प्रबंधित किए।
5. ऑडियो फ़ॉर्मेट और कोडेक फ्लेक्सिबिलिटी
आपका ऑडियो सोर्स आपके कोडेक को निर्धारित करता है। ब्राउज़र-आधारित एप्लिकेशन्स आमतौर पर WebRTC के माध्यम से Opus जनरेट करते हैं। PSTN टेलीफोनी 8kHz पर mulaw पर चलती है। इंटरनल मीटिंग टूल्स अक्सर 16kHz या उससे अधिक पर linear16 कैप्चर करते हैं। एक ऐसा ASR API जो केवल एक फ़ॉर्मेट स्वीकार करता है, वह आपको अपने सर्वर पर ऑडियो ट्रांसकोड करने के लिए मजबूर करता है, जिससे एक भी शब्द पहचानने से पहले CPU ओवरहेड और लेटेंसी बढ़ जाती है। Production-grade स्ट्रीमिंग API के लिए linear16, mulaw, alaw और Opus/OGG का सपोर्ट होना बुनियादी आवश्यकता है।
6. सेशन मैनेजमेंट और कनेक्शन रिलायबिलिटी
एक लंबी कॉल या मल्टी-टर्न वॉइस एजेंट सेशन के लिए, आपके वेबसॉकेट कनेक्शन को केवल कुछ सेकंड के लिए नहीं, बल्कि कई मिनटों तक सक्रिय और स्थिर रहने की आवश्यकता होती है। एक अच्छा API निरंतर सेशन्स के लिए डिज़ाइन किया गया होता है — यह शांति (silence) को आसानी से संभालता है, समय से पहले सेगमेंट्स को बंद नहीं करता है, और स्पष्ट रीकनेक्शन सेमेंटिक्स प्रदान करता है ताकि आपका एप्लिकेशन ट्रांसक्रिप्ट कॉन्टेक्स्ट खोए बिना टूटे हुए कनेक्शन को आसानी से रीकवर कर सके।
7. बहुभाषी (Multilingual) और कोड-स्विचिंग सपोर्ट
वैश्विक स्तर के एप्लिकेशन्स हर सेशन में केवल एक भाषा मानकर नहीं चल सकते। यूज़र्स बातचीत के बीच में हिंदी और अंग्रेजी बदलते रहते हैं। सपोर्ट एजेंट्स एक ही शिफ्ट के भीतर कई भाषाओं में कॉलर्स को सेवा देते हैं। एक ऐसा ASR API जो कनेक्शन के समय ही आपको एक निश्चित भाषा घोषित करने के लिए बाध्य करता है, इन मामलों में विफल हो जाएगा। अंतरराष्ट्रीय प्रोडक्ट्स के लिए ऑटो-डिटेक्शन और बातचीत के बीच में भाषा बदलना कोई एक्स्ट्रा फीचर नहीं — बल्कि एक आवश्यकता है।
Waves Pulse STT API को इन सभी सीमाओं को ध्यान में रखकर बनाया गया था। इस गाइड का बाकी हिस्सा आपको स्टेप-बाय-स्टेप बताएगा कि इसे वास्तविक कोड के साथ कैसे इंटीग्रेट किया जाए, ताकि आप अपने खुद के वर्कलोड पर इन दावों का परीक्षण कर सकें।
Pulse STT API के साथ शुरुआत करना
स्टेप 1: अपनी API की (Key) बनाएं
Waves API के सभी अनुरोधों को API की से जुड़े Bearer टोकन के साथ ऑथेंटिकेट किया जाता है।
Smallest AI Console API Keys पेज पर जाएं।
साइन अप करें या अपने अकाउंट में लॉग इन करें।
Create New API Key पर क्लिक करें, इसे एक विवरणात्मक नाम दें, और जनरेट की गई की (key) को तुरंत कॉपी कर लें (यह दोबारा नहीं दिखाई जाएगी)।
इसे एक एनवायरनमेंट वेरिएबल के रूप में एक्सपोर्ट करें:
|
स्टेप 2: Bearer टोकन के साथ ऑथेंटिकेट करें
Waves API के प्रत्येक अनुरोध में Bearer टोकन के रूप में फ़ॉर्मेट की गई आपकी की (key) के साथ एक ऑथराइजेशन हेडर शामिल होना चाहिए:
Authorization: Bearer YOUR_SMALLEST_API_KEY |
वेबसॉकेट कनेक्शन्स के लिए, wss:// कनेक्शन स्थापित करते समय इसे कनेक्शन हेडर के हिस्से के रूप में पास किया जाता है।
पायथन बैच ट्रांसक्रिप्शन उदाहरण
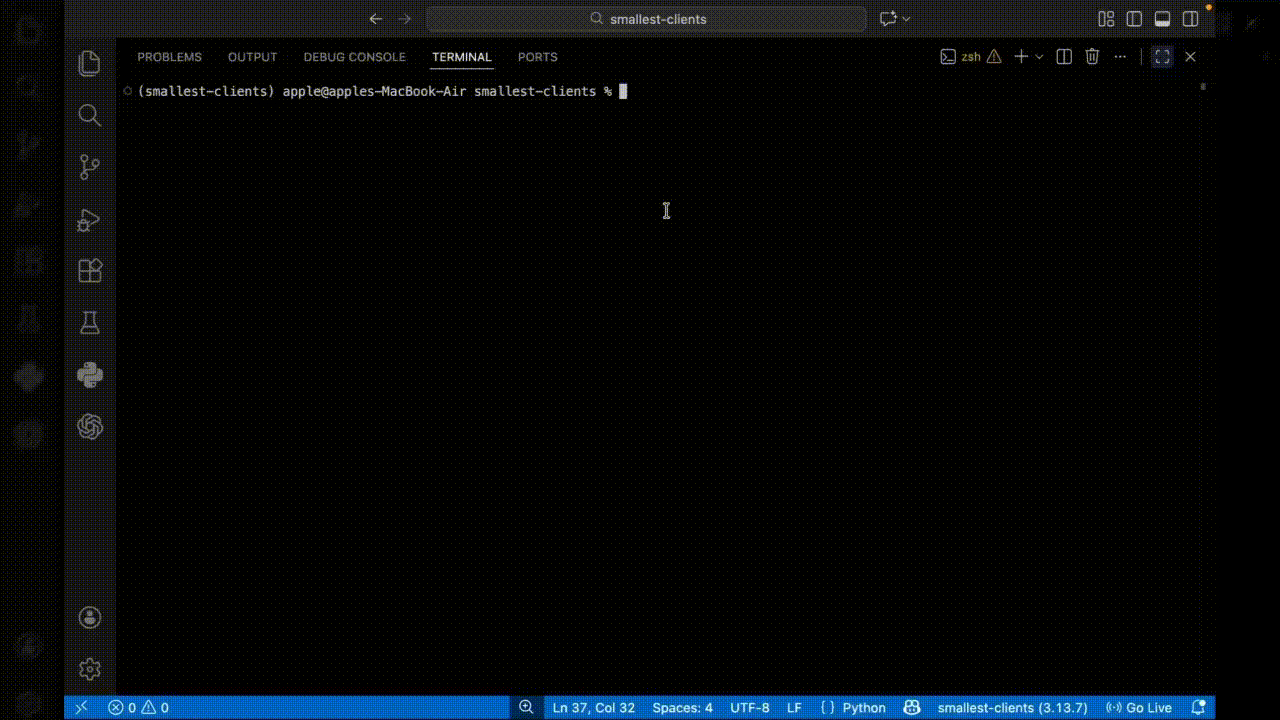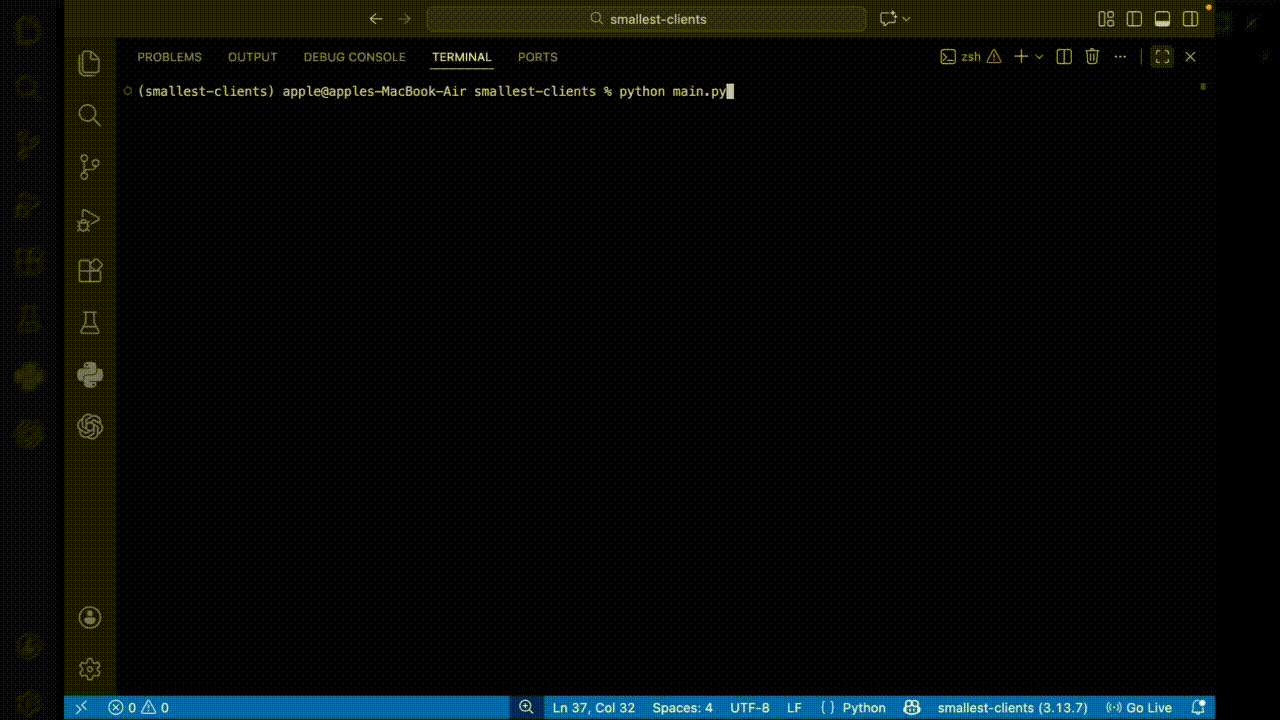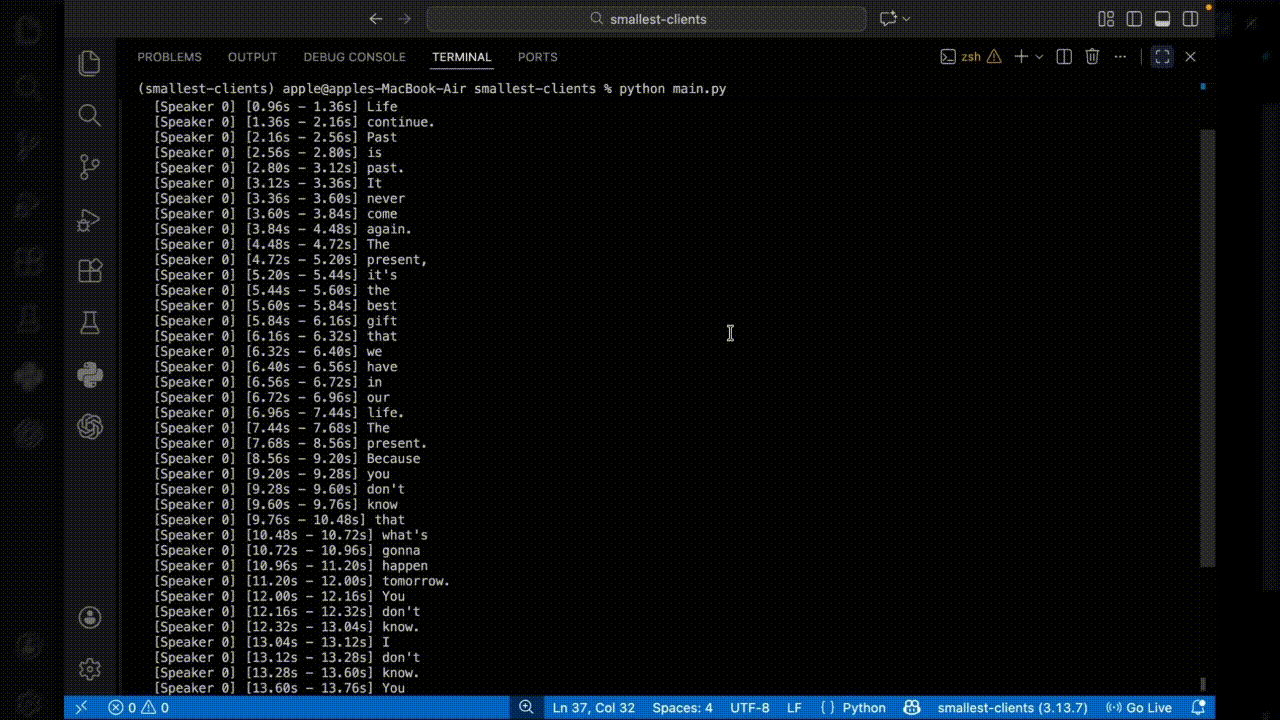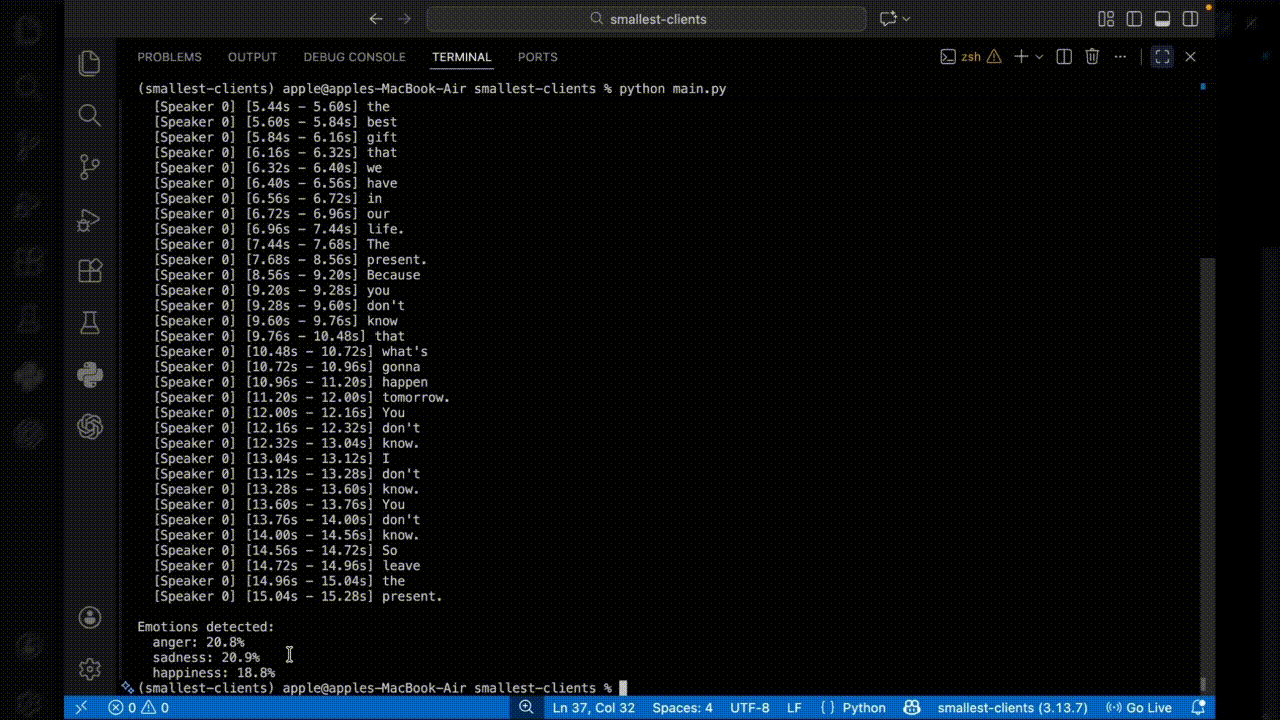
यह उदाहरण स्पीकर की पहचान और इमोशन एनालिसिस के साथ पूरे बैच ट्रांसक्रिप्शन को प्रदर्शित करता है। कोड एक WAV फ़ाइल को रीड करता है, सभी उपलब्ध फीचर्स को कॉन्फ़िगर करता है, और वर्ड-लेवल विवरण और इमोशनल कॉन्टेक्स्ट सहित पूर्ण API रिस्पॉन्स को प्रोसेस करता है।
आउटपुट:
वेबसॉकेट इम्प्लीमेंटेशन: रीयल टाइम ASR API से कनेक्ट करना
Pulse STT रीयल टाइम ASR API को इस वेबसॉकेट कनेक्शन के ज़रिए एक्सेस किया जाता है: wss://waves-api.smallest.ai/api/v1/pulse/get_text
कॉन्फ़िगरेशन पैरामीटर्स को वेबसॉकेट URL पर क्वेरी स्ट्रिंग पैरामीटर्स के रूप में पास किया जाता है, न कि किसी अलग JSON इनिशियलाइजेशन मैसेज में। सॉकेट खोलते समय आपकी भाषा, एनकोडिंग, सैंपल रेट और फीचर फ्लैग्स को कनेक्शन URL में ही शामिल कर दिया जाता है।
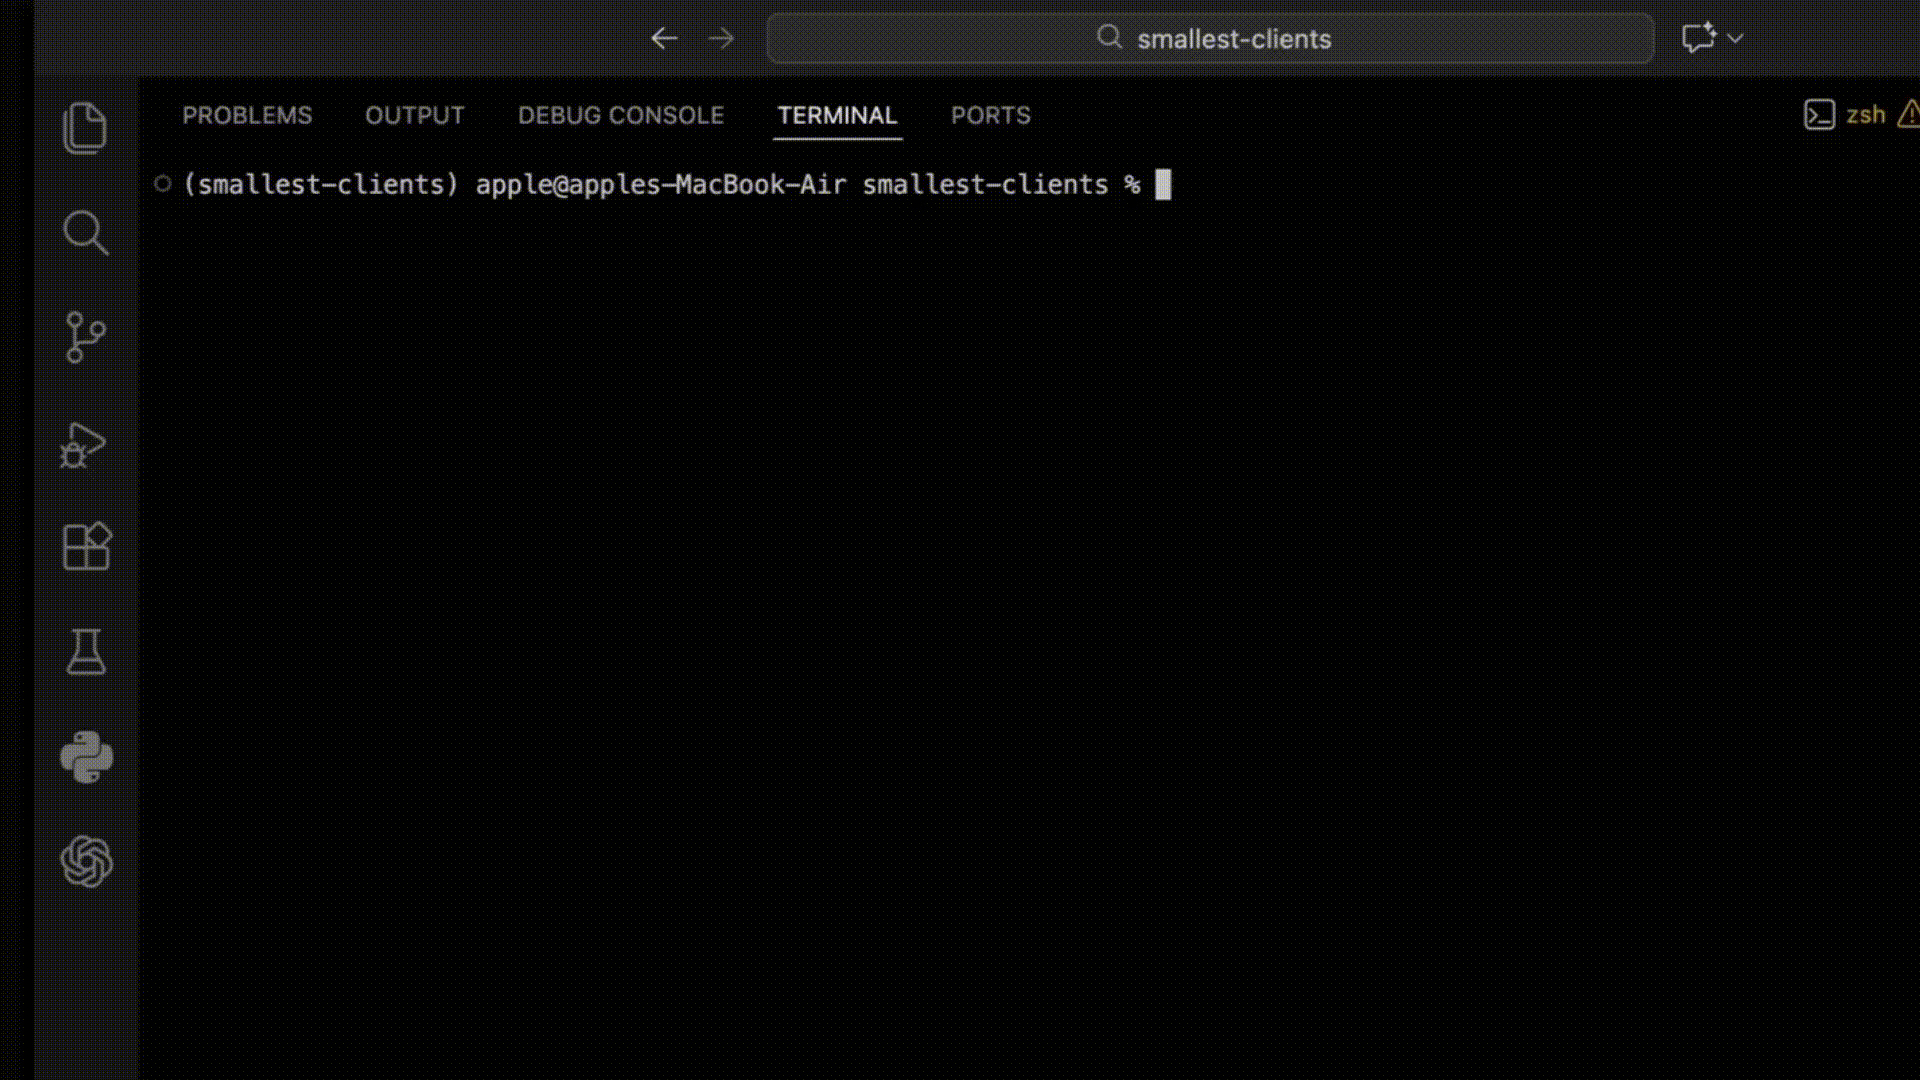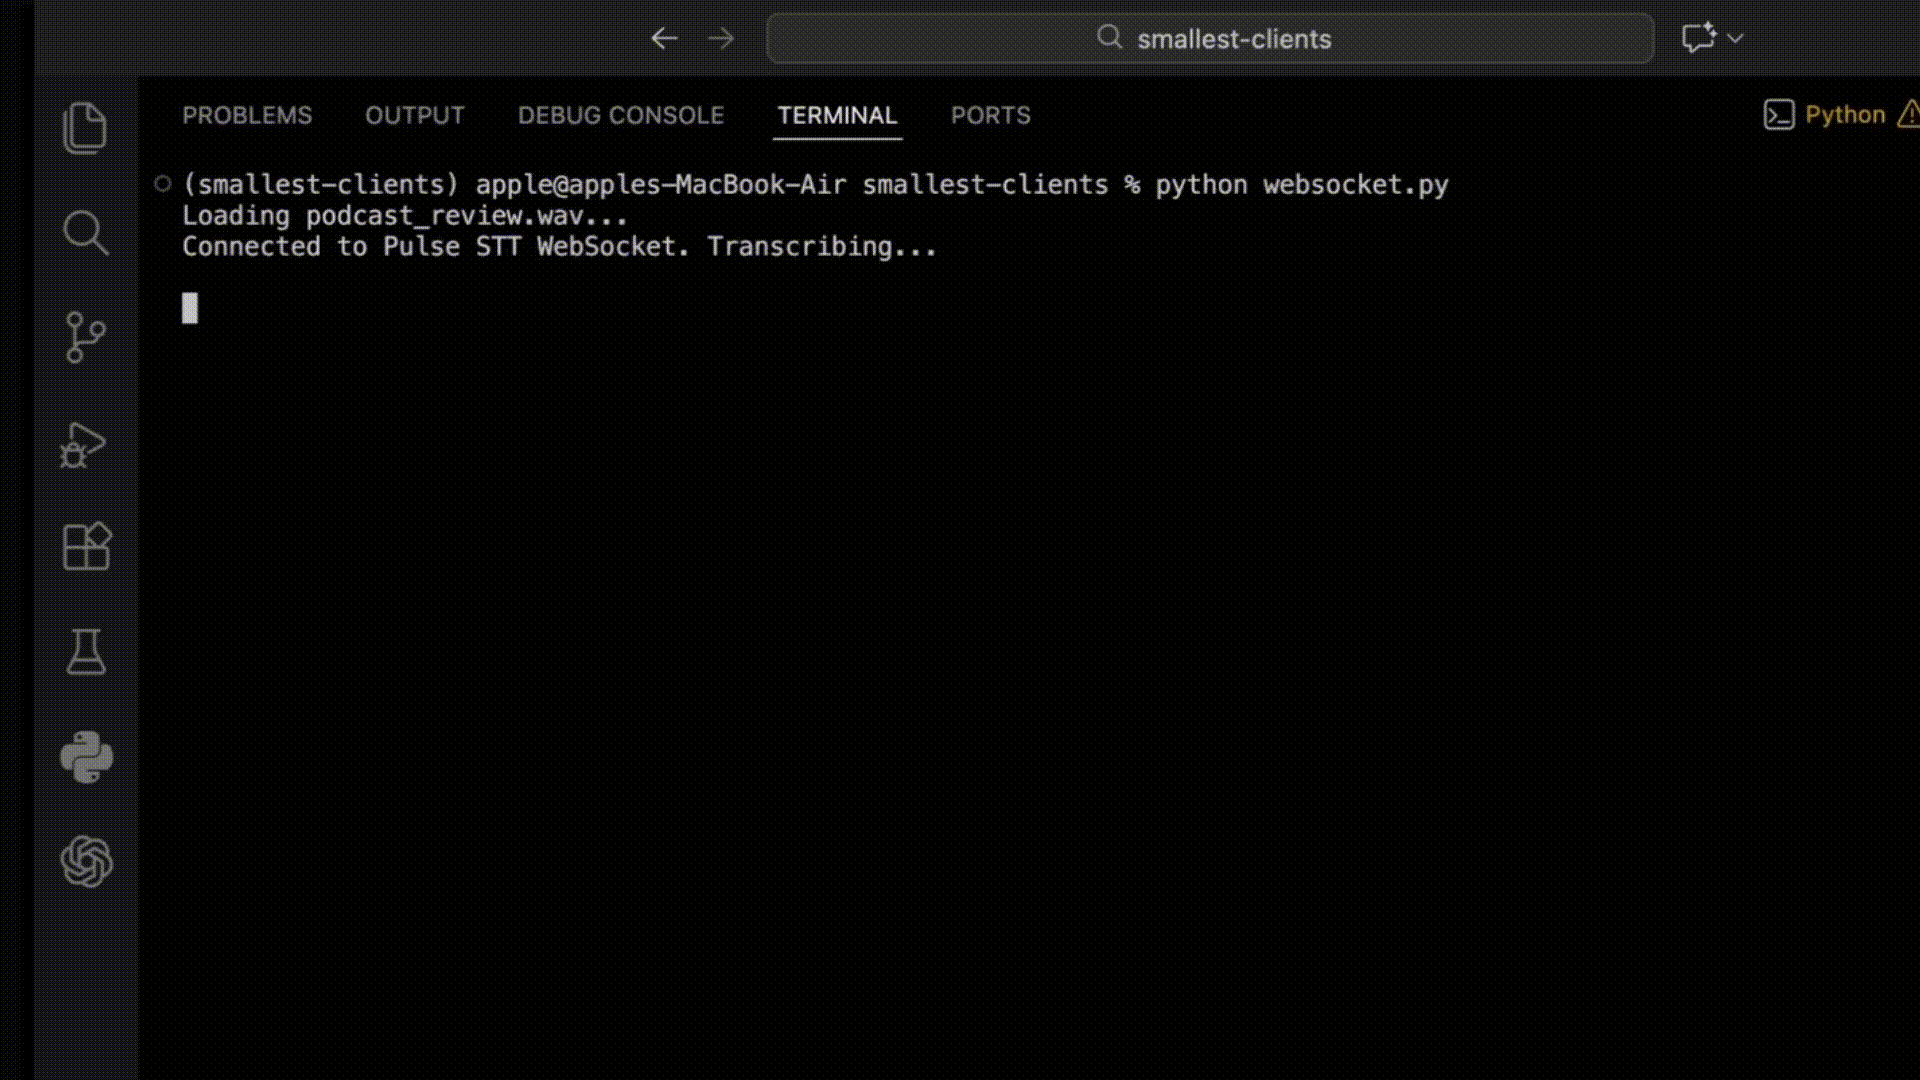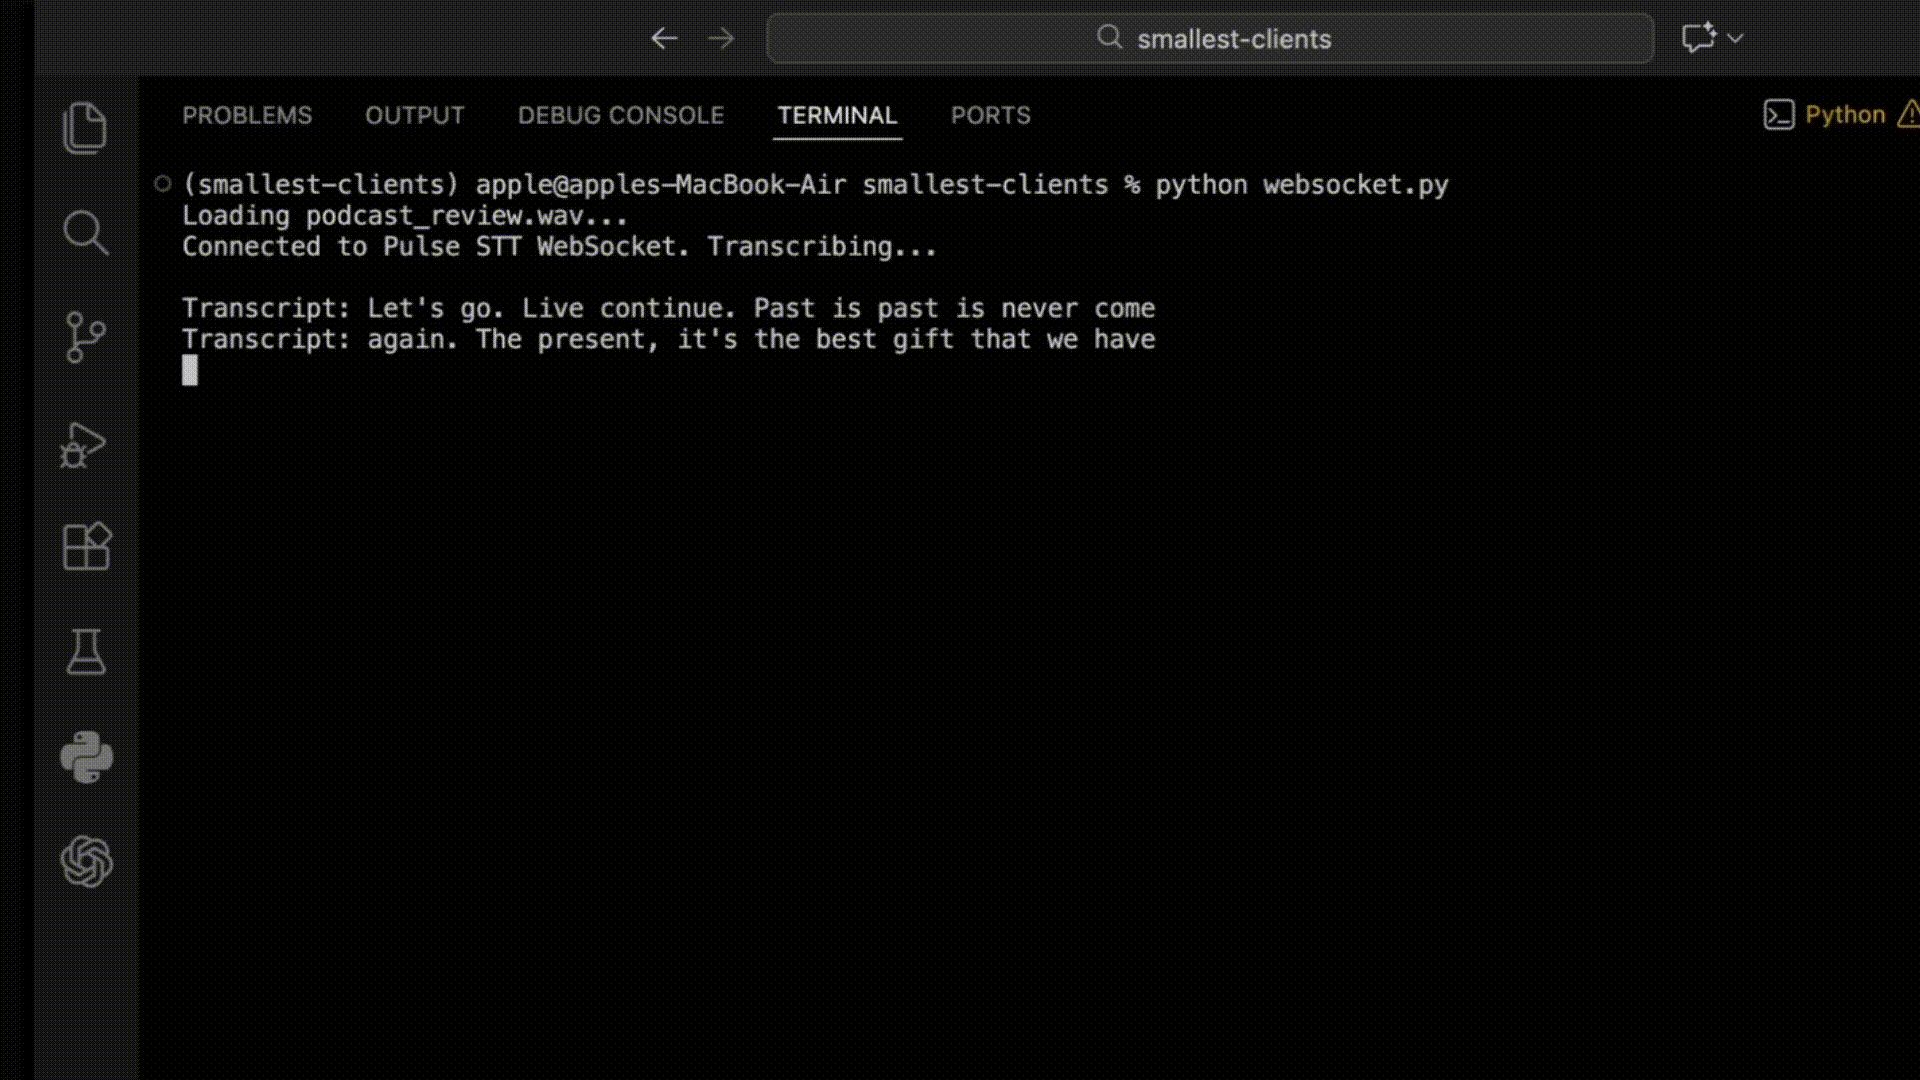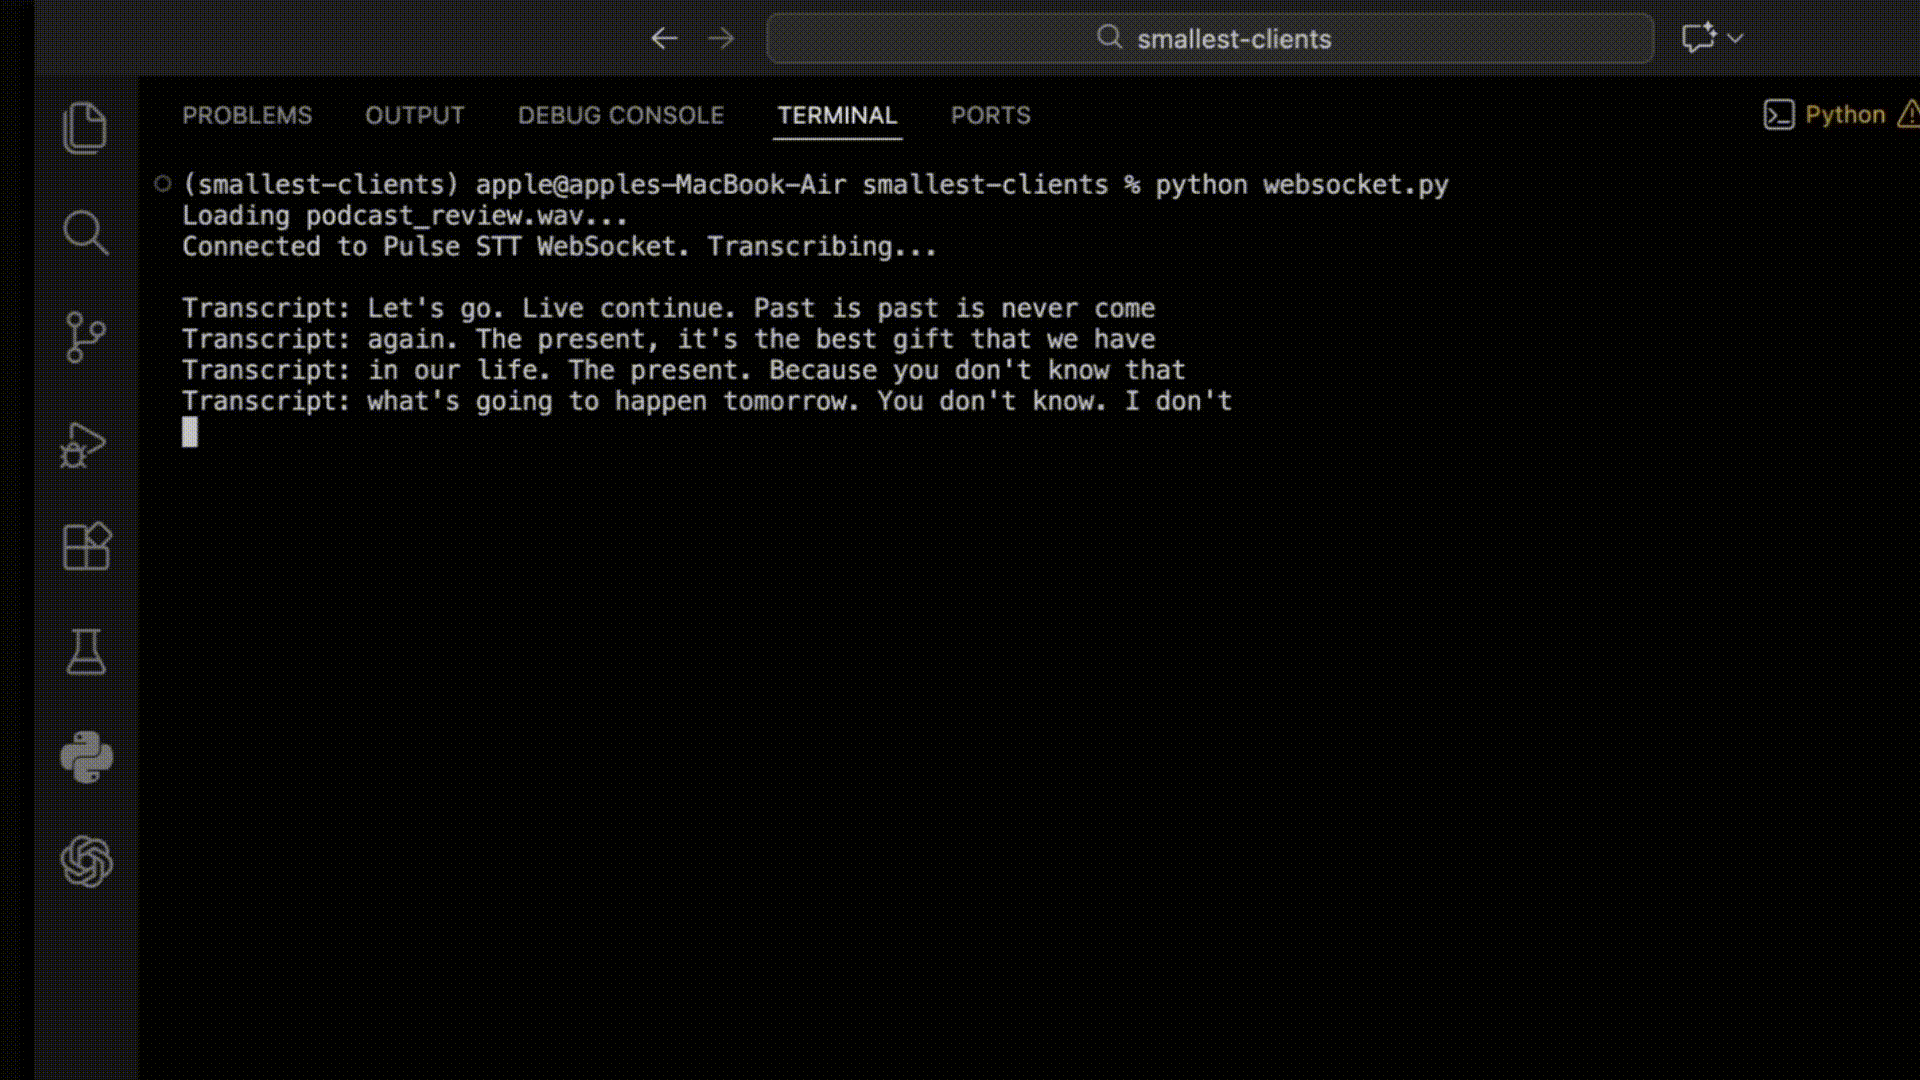
पायथन वेबसॉकेट कनेक्शन उदाहरण
यहाँ पायथन की websockets लाइब्रेरी का उपयोग करके कनेक्ट करने का तरीका बताया गया है:
आउटपुट:
स्ट्रीमिंग ऑडियो: फ़ॉर्मेट, सैंपल रेट और चंक साइज
अपने ऑडियो फ़ॉर्मेट को सही ढंग से कॉन्फ़िगर करना बहुत महत्वपूर्ण है। घोषित किए गए encoding/sample_rate और वास्तविक ऑडियो डेटा के बीच विसंगति होने से सटीकता में कमी आएगी या प्रक्रिया पूरी तरह विफल हो जाएगी।
सपोर्टेड ऑडियो एनकोडिंग
linear16: 16-बिट, लिटिल-एंडियन, साइन्ड PCM (सामान्य उद्देश्य, उच्चतम गुणवत्ता)
linear32: 32-बिट, लिटिल-एंडियन, फ्लोटिंग-पॉइंट PCM (हाई-प्रिसिजन पाइपलाइन्स)
alaw: A-law कंपेंडेड PCM (8-बिट) (यूरोपीय टेलीफोनी)
mulaw: μ-law कंपेंडेड PCM (8-बिट) (उत्तर अमेरिकी PSTN/VoIP)
opus / ogg_opus: Opus कंप्रेस्ड ऑडियो (WebRTC, ब्राउज़र्स, लो-बैंडविड्थ)
सपोर्टेड सैंपल रेट
रीयल टाइम ASR API 8,000 Hz से 48,000 Hz तक के सैंपल रेट स्वीकार करता है:
8,000 Hz — स्टैंडर्ड टेलीफोनी (PSTN, VoIP)
16,000 Hz — अधिकांश वॉइस/स्पीच एप्लिकेशन्स के लिए अनुशंसित
24,000 Hz+ — हाई-क्वालिटी/स्टूडियो कैप्चर
अनुशंसित चंक साइज (Recommended Chunk Size)
ऑडियो स्ट्रीम करते समय, अनुशंसित चंक साइज 4,096 बाइट्स है। छोटे चंक लेटेंसी को कम किए बिना ओवरहेड बढ़ाते हैं; बड़े चंक अनावश्यक बफरिंग डिले का कारण बनते हैं।
API रिस्पॉन्स को संभालना
Pulse STT API द्वारा लौटाया गया प्रत्येक मैसेज एक JSON ऑब्जेक्ट होता है।
मुख्य रिस्पॉन्स स्कीमा (Core Response Schema)
पार्शियल ट्रांसक्रिप्ट (
is_final: false): स्पीकर के बोलते रहने के दौरान मिलने वाले मध्यवर्ती परिणाम। लाइव UI डिस्प्ले को अपडेट करने के लिए बेहतरीन।फाइनल ट्रांसक्रिप्ट (
is_final: true): पूरे हो चुके स्पीच सेगमेंट के अंतिम परिणाम। इन्हें डेटाबेस में सेव करना या LLM को पास करना सुरक्षित है।
रीयल टाइम ASR API के एडवांस्ड फीचर्स
Pulse STT एडवांस्ड फीचर्स को सीधे स्ट्रीमिंग पाथ में उपलब्ध कराता है।
1. स्पीकर डायराइजेशन (Speaker Diarization)
URL में diarize=true जोड़कर पहचानें कि किसी भी समय कौन बोल रहा है। words ऐरे और utterances ऐरे दोनों में एक इंटीजर speaker ID और एक speaker_confidence स्कोर शामिल होगा।
2. वर्ड और सेंटेंस टाइमस्टैम्प
word_timestamps=true: प्रति-शब्द शुरू/समाप्त होने का समय जनरेट करता है (SRT/VTT जैसे सबटाइटल्स ट्रैक के लिए महत्वपूर्ण)।sentence_timestamps=true: शब्दों को आसानी से पढ़े जाने वाले वाक्यों के रूप में संकलित करता है।
3. लैंग्वेज डिटेक्शन और बहुभाषी सपोर्ट
मल्टी-स्पीकर स्ट्रीम्स के लिए जहाँ भाषा पहले से ज्ञात नहीं होती है, Pulse STT स्ट्रीमिंग के दौरान ही ऑटो-डिटेक्शन का सपोर्ट करता है। भाषा पैरामीटर को multi या auto पर सेट करें। API सेशन को रीस्टार्ट किए बिना आसानी से भाषाओं के बीच स्विच (जैसे, अंग्रेजी से स्पेनिश से हिंदी) कर लेगा।
बेस्ट प्रैक्टिसेज और परफॉरमेंस ऑप्टिमाइज़ेशन
अपने रीयल टाइम ASR API से न्यूनतम लेटेंसी और उच्चतम सटीकता प्राप्त करने के लिए, इन दिशानिर्देशों का पालन करें:
बेहतर ऑडियो कॉन्फ़िगरेशन:
वॉइस असिस्टेंट/मीटिंग्स:
sample_rate=16000परencoding=linear16का उपयोग करें।टेलीफोनी/PSTN: ट्रांसकोडिंग ओवरहेड से बचने के लिए
sample_rate=8000परencoding=mulawका उपयोग करें।ब्राउज़र/WebRTC: अपने सर्वर पर डिकंप्रेशन साइकिल्स को छोड़ने के लिए
encoding=opusका उपयोग करें।
स्ट्रीमिंग रेट: ऑडियो चंक्स को लगभग नेचुरल प्लेबैक रेट पर भेजें (प्रत्येक 50-100 ms में बस्ट्स)। रीयल-टाइम से तेज़ डेटा भेजने से दबाव (backpressure) बन सकता है; बहुत धीमा भेजने से स्पीच सेगमेंट समय से पहले बंद हो सकते हैं।
ऑडियो क्वालिटी: हमेशा ऑडियो को मोनो (सिंगल चैनल) के रूप में रिकॉर्ड करें। ASR मॉडल्स मोनो स्पीच पर ही ट्रेन किए जाते हैं। जब भी संभव हो कैप्चर लेयर (जैसे ब्राउज़र MediaDevices या RNNoise) पर नॉइज़ सप्रेशन का उपयोग करें।
कनेक्शन चालू रखें: 64ms के TTFT लक्ष्य की तुलना में कनेक्शन सेटअप ओवरहेड काफी अधिक होता है। वाक्य बोलने के बीच में बंद/चालू करने के बजाय पूरे सेशन की अवधि के लिए अपना वेबसॉकेट कनेक्शन खुला रखें।
अगले कदम
Pulse STT API एक उद्देश्य-निर्मित रीयल टाइम ASR API है जो तेज़, सटीक और समृद्ध स्ट्रीमिंग ट्रांसक्रिप्शन प्रदान करता है। इसका सिंगल-एंडपॉइंट डिज़ाइन मल्टी-स्टेज स्पीच इंटेलिजेंस पाइपलाइन बनाने और प्रबंधित करने की आवश्यकता को समाप्त करता है।
बिल्डिंग शुरू करने के लिए तैयार हैं?
कुकबुक एक्सप्लोर करें: Smallest AI Cookbook में रीयल-टाइम माइक्रोफोन ट्रांसक्रिप्शन, टेलीफोनी इंटीग्रेशन और वॉइस एजेंट्स के लिए रेडी-टू-डिप्लॉय उदाहरण शामिल हैं।
फीचर्स के साथ प्रयोग करें: रिच कन्वर्सेशन एनालिटिक्स अनलॉक करने के लिए अपने URL में
diarize=trueऔरsentence_timestamps=trueजोड़कर देखें।
कम्युनिटी से जुड़ें: आप जो कुछ भी बना रहे हैं उसे शेयर करने के लिए Discord सर्वर पर Smallest AI टीम और अन्य डेवलपर्स से जुड़ें!