एआई ट्रांसक्रिप्शन (AI Transcription) क्या है और यह कैसे काम करता है?
एआई ट्रांसक्रिप्शन कैसे काम करता है, इसका एक विस्तृत विश्लेषण, जिसमें ऑडियो प्री-प्रोसेसिंग और अकूस्टिक मॉडलिंग से लेकर लैंग्वेज मॉडल्स और अंतिम फॉर्मेटिंग तक शामिल है।
स्वचालित स्पीच-टू-टेक्स्ट रूपांतरण आधुनिक अनुप्रयोगों का एक अभिन्न अंग बन गया है, जिसमें मीटिंग सहायकों से लेकर मीडिया सामग्री विश्लेषण तक शामिल हैं। एआई ट्रांसक्रिप्शन के पीछे की कार्यप्रणाली को समझना उन डेवलपर्स और उत्पाद प्रबंधकों के लिए महत्वपूर्ण है जो प्रभावी आवाज-सक्षम सिस्टम बनाना चाहते हैं। यह लेख मुख्य प्रक्रिया को एक स्पष्ट, चरण-दर-चरण विवरण में विभाजित करता है, जो बोली जाने वाली भाषा को पाठ में बदलने वाली तकनीक को सरल बनाता है।
हम संपूर्ण एआई ट्रांसक्रिप्शन वर्कफ़्लो को समझेंगे:
चरण 1: ऑडियो इनपुट और प्री-प्रोसेसिंग
चरण 2: फीचर एक्सट्रैक्शन (विशेषता निष्कर्षण)
चरण 3: एकोस्टिक मॉडलिंग
चरण 4: लैंग्वेज मॉडलिंग और डिकोडिंग
चरण 5: पोस्ट-प्रोसेसिंग और फ़ॉर्मेटिंग
चरण 1: ऑडियो इनपुट और प्री-प्रोसेसिंग
भाषण से पाठ तक की यात्रा एक कच्चे ऑडियो सिग्नल के साथ शुरू होती है। यह माइक्रोफ़ोन से लाइव स्ट्रीम या कोई पूर्व-रिकॉर्ड की गई फ़ाइल (जैसे WAV, MP3, या FLAC) हो सकती है। हालाँकि, यह कच्चा डेटा अक्सर अव्यवस्थित होता है और मशीन लर्निंग मॉडल द्वारा सीधे विश्लेषण के लिए उपयुक्त नहीं होता है। प्रारंभिक चरण, प्री-प्रोसेसिंग, बाद के चरणों की सटीकता में सुधार के लिए ऑडियो को साफ और सामान्य करने के लिए डिज़ाइन किया गया है।
मुख्य प्री-प्रोसेसिंग कार्यों में शामिल हैं:
प्रारूप रूपांतरण (Format Conversion): ऑडियो को एक सुसंगत, असम्पीडित प्रारूप (जैसे पल्स-कोड मॉड्यूलेशन या PCM) में मानकीकृत करना जिसे मॉडल आसानी से समझ सकें।
शोर में कमी (Noise Reduction): पृष्ठभूमि के शोर, जैसे गुनगुनाहट, क्लिक या आसपास की बातचीत को छानने के लिए एल्गोरिदम लागू करना, जो भाषण की पहचान में हस्तक्षेप कर सकते हैं।
नॉर्मलाइजेशन (Normalization): ऑडियो की आवाज़ को एक मानक स्तर पर समायोजित करना। यह उन समस्याओं को रोकता है जहां धीमी आवाज़ छूट जाती है या तेज़ आवाज़ सिग्नल को विकृत कर देती है।
रीसैंपलिंग (Resampling): ऑडियो की नमूना दर (sample rate) को उस दर से मेल खाने के लिए बदलना जिस पर एआई मॉडल को प्रशिक्षित किया गया था। भाषण पहचान के लिए एक सामान्य दर 16 kHz है।
चरण 2: फीचर एक्सट्रैक्शन (विशेषता निष्कर्षण)
कंप्यूटर ऑडियो तरंगों को इंसानों की तरह नहीं 'सुनते'। उन्हें ध्वनि के गणितीय प्रतिनिधित्व की आवश्यकता होती है। फीचर एक्सट्रैक्शन साफ किए गए ऑडियो सिग्नल को ऐसे प्रारूप में बदलने की प्रक्रिया है जिसे मशीन लर्निंग मॉडल समझ सके। इसमें ऑडियो को छोटे, ओवरलैपिंग फ्रेम में तोड़ना शामिल है, जो आमतौर पर लगभग 25 मिलीसेकंड लंबे होते हैं।
प्रत्येक फ्रेम के लिए, सिस्टम सुविधाओं के एक सेट की गणना करता है जो ध्वनि की आवश्यक विशेषताओं का प्रतिनिधित्व करते हैं। इसके लिए सबसे आम तकनीक मेल-फ्रीक्वेंसी सेपस्ट्रल कोइफिशिएंट्स (MFCCs) बनाना है। MFCCs ऑडियो स्पेक्ट्रम का एक संक्षिप्त प्रतिनिधित्व हैं जो मानव कान की गैर-रेखीय आवृत्ति धारणा की नकल करते हैं, जो भाषण के लिए सबसे महत्वपूर्ण आवृत्तियों पर जोर देते हैं। इस चरण का आउटपुट संख्यात्मक वैक्टर का एक अनुक्रम है, जिसमें से प्रत्येक ध्वनि के एक छोटे से हिस्से का 'फिंगरप्रिंट' है।
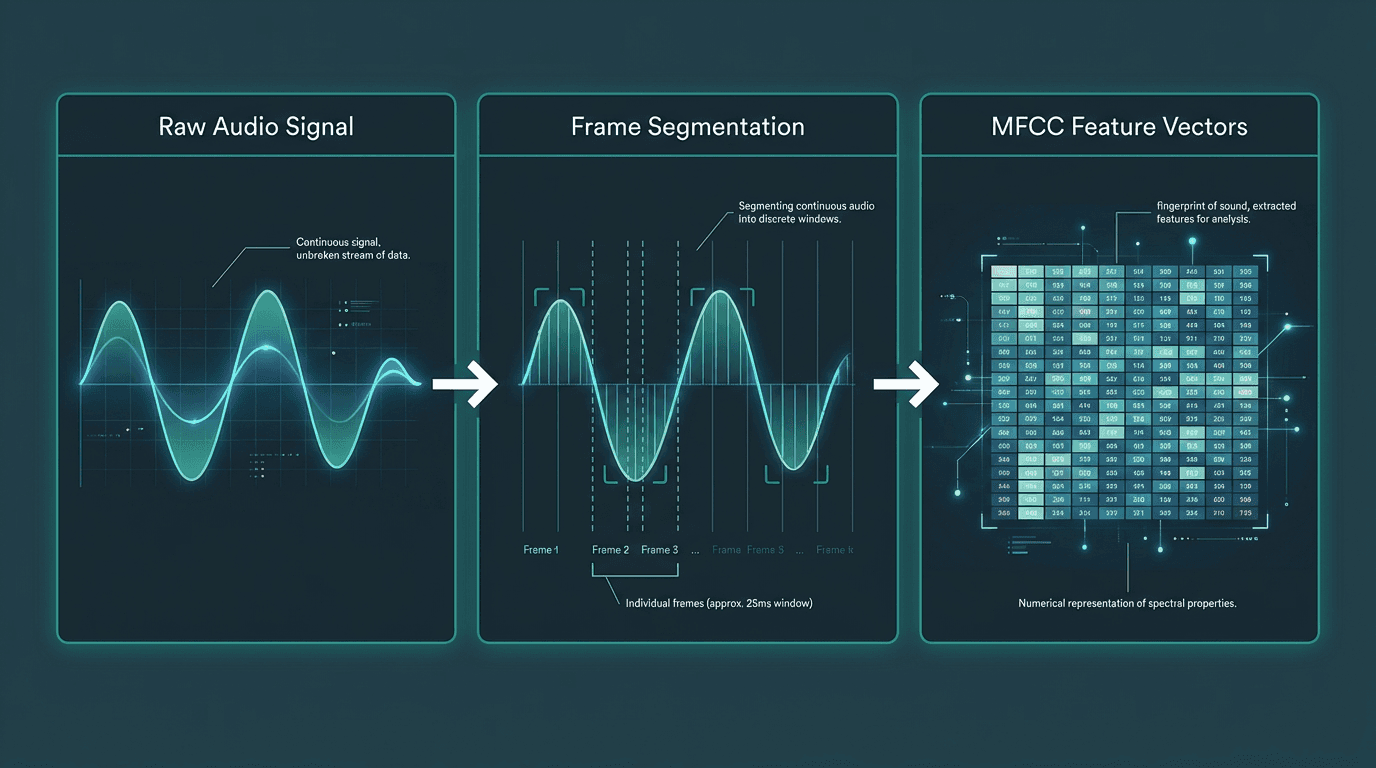
फीचर एक्सट्रैक्शन मॉडल के लिए एक निरंतर ऑडियो सिग्नल को संख्यात्मक वैक्टर के अनुक्रम में परिवर्तित करता है।
चरण 3: एकोस्टिक मॉडलिंग
एकोस्टिक मॉडल ऑटोमैटिक स्पीच रिकग्निशन (ASR) सिस्टम का मुख्य घटक है। इसका काम पिछले चरण से फीचर वैक्टर के अनुक्रम को लेना और उन्हें फोनम (phonemes) के सबसे संभावित अनुक्रम में मैप करना है। फोनम किसी भाषा में ध्वनि की सबसे छोटी इकाइयाँ हैं (उदाहरण के लिए, 'cat' में 'k' की ध्वनि)।
आधुनिक एकोस्टिक मॉडल आमतौर पर डीप न्यूरल नेटवर्क पर आधारित होते हैं। इन मॉडलों को हजारों घंटों के लेबल वाले ऑडियो डेटा पर प्रशिक्षित किया जाता है, जहां मानव ट्रांसक्राइबर्स ने ऑडियो अंशों को उनके संबंधित ध्वन्यात्मक ट्रांसक्रिप्शन के साथ जोड़ा है। इस प्रशिक्षण के माध्यम से, मॉडल उन जटिल पैटर्न को सीखता है जो विशिष्ट एकोस्टिक विशेषताओं को विशिष्ट फोनम से जोड़ते हैं। उदाहरण के लिए, यह उच्चारण, पिच और गति में भिन्नता के बावजूद भी 's' ध्वनि बनाम 'sh' ध्वनि के विशिष्ट संख्यात्मक 'फिंगरप्रिंट' को पहचानना सीखता है। इस चरण का आउटपुट ऑडियो के प्रत्येक समय फ्रेम के लिए सभी संभावित फोनम पर एक संभाव्यता वितरण (probability distribution) होता है।
चरण 4: लैंग्वेज मॉडलिंग और डिकोडिंग
एकोस्टिक मॉडल संभावित ध्वनियों का एक अनुक्रम प्रदान करता है, लेकिन यह भाषा, व्याकरण या संदर्भ को नहीं समझता है। यहीं पर लैंग्वेज मॉडल की भूमिका आती है। लैंग्वेज मॉडल एक सांख्यिकीय मॉडल है जो शब्दों के दिए गए अनुक्रम की संभावना की गणना करता है। इसे भारी मात्रा में टेक्स्ट डेटा (पुस्तकों, लेखों, वेबसाइटों) पर प्रशिक्षित किया जाता है और यह सीखता है कि कौन से शब्द दूसरों के बाद आने की संभावना रखते हैं।
डिकोडर लैंग्वेज मॉडल से शब्द अनुक्रम संभावनाओं के साथ एकोस्टिक मॉडल से ध्वन्यात्मक संभावनाओं को जोड़ता है। यह शब्दों के सबसे संभावित अनुक्रम की खोज करता है जो दी गई ध्वनियों को उत्पन्न कर सकता था। उदाहरण के लिए, एकोस्टिक मॉडल ऐसी आवाज़ें सुन सकता है जिन्हें या तो "recognize speech" या "wreck a nice beach" के रूप में समझा जा सकता है। लैंग्वेज मॉडल जानता है कि "recognize speech" एक बहुत अधिक सामान्य और संभावित वाक्यांश है, इसलिए डिकोडर इसे सही ट्रांसक्रिप्शन के रूप में चुनेगा। यह प्रक्रिया, जो अक्सर बीम सर्च जैसे एल्गोरिदम का उपयोग करती है, उच्च सटीकता प्राप्त करने और सुसंगत वाक्य बनाने के लिए महत्वपूर्ण है।
घटक | इनपुट | आउटपुट | मुख्य कार्य |
|---|---|---|---|
एकोस्टिक मॉडल | ऑडियो विशेषताएं (MFCCs) | फोनम की संभावनाएं | ध्वनियों को ध्वन्यात्मक इकाइयों में मैप करता है |
लैंग्वेज मॉडल | शब्दों का अनुक्रम | उस अनुक्रम की संभावना | व्याकरण और संदर्भ को समझता है |
चरण 5: पोस्ट-प्रोसेसिंग और फ़ॉर्मेटिंग
डिकोडर से मिलने वाला कच्चा आउटपुट शब्दों की एक श्रृंखला होती है। अंतिम चरण इस कच्चे पाठ को एक पठनीय, उपयोगी प्रारूप में बदलना है। यहीं पर आउटपुट को बेहतर बनाने के लिए नेचुरल लैंग्वेज प्रोसेसिंग (NLP) तकनीकों को लागू किया जाता है। यह चरण ट्रांसक्रिप्शन को वास्तविक दुनिया के अनुप्रयोगों के लिए व्यावहारिक बनाने के लिए अत्यंत महत्वपूर्ण है।
सामान्य पोस्ट-प्रोसेसिंग कार्यों में शामिल हैं:
विराम चिह्न और कैपिटलाइज़ेशन: मॉडल वाक्यों के प्रारंभ और संज्ञाओं में अल्पविराम, पूर्ण विराम, प्रश्न चिह्न लगाने और सही कैपिटलाइज़ेशन की भविष्यवाणी और उपयोग करते हैं।
इन्वर्स टेक्स्ट नॉर्मलाइजेशन: बोली जाने वाली संख्याओं को वापस अंकों में बदलना (जैसे, "एक हजार चौबीस" बनकर "1024" हो जाता है)।
स्पीकर डायराइजेशन (Speaker Diarization): कई लोगों के साथ बातचीत में, यह प्रक्रिया पहचानती है कि किसने कब बात की और उसी के अनुसार पाठ को लेबल करती है (जैसे, "स्पीकर 1: ...", "स्पीकर 2: ...")। बैठकों या ग्राहक सेवा कॉलों का विश्लेषण करने के लिए यह आवश्यक है।
फ़िलर शब्द हटाना: अधिक स्पष्ट ट्रांसक्रिप्ट बनाने के लिए "अम," "अह," और "यू नो" जैसे गैर-अर्थपूर्ण शब्दों को स्वचालित रूप से हटाना।
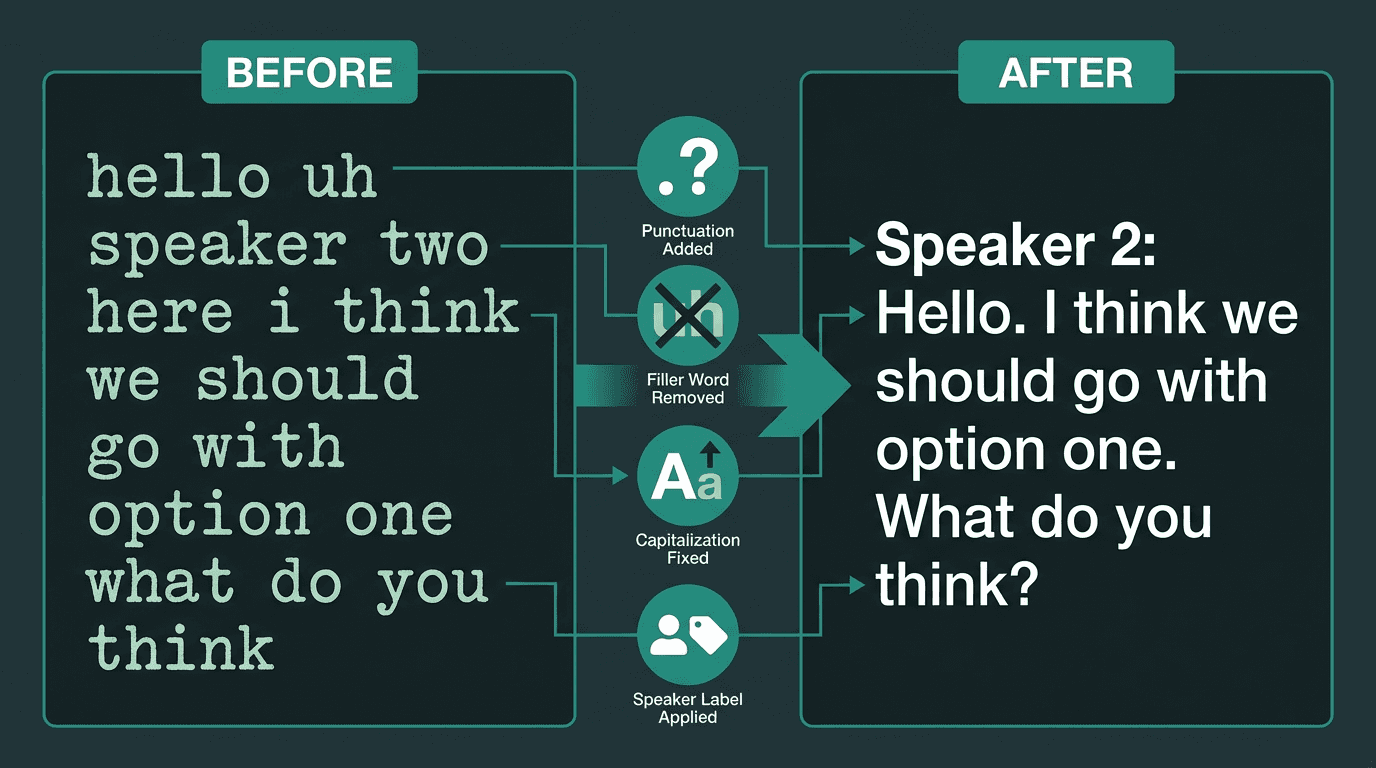
पोस्ट-प्रोसेसिंग कच्चे पाठ को स्पीकर लेबल और उचित फ़ॉर्मेटिंग के साथ एक परिष्कृत, पठनीय ट्रांसक्रिप्ट में बदल देती है।
एआई ट्रांसक्रिप्शन में सामान्य चुनौतियाँ
हालांकि आधुनिक प्रणालियाँ अविश्वसनीय रूप से शक्तिशाली हैं, वे त्रुटिहीन नहीं हैं। कई कारक ट्रांसक्रिप्शन सटीकता को प्रभावित कर सकते हैं। आदर्श परिस्थितियों में, शीर्ष इंजन 95-98% सटीकता तक पहुँच सकते हैं (GoTranscript, 2025)। हालाँकि, 2025 के एक अध्ययन में पाया गया कि सामान्य चुनौतियों के कारण वास्तविक दुनिया की सटीकता औसतन 61.92% के करीब हो सकती है (BrassTranscripts, Ditto, 2026, 2025)।
सामान्य बाधाओं में शामिल हैं:
पृष्ठभूमि का शोर: शोर-शराबा वाला वातावरण, संगीत, या अन्य एक साथ होने वाली बातचीत प्राथमिक वक्ता की आवाज़ को धुंधला कर सकती है।
एकाधिक वक्ता: आपस में टकराती हुई बातचीत (क्रॉसटॉक) ASR सिस्टम के लिए सही ढंग से विश्लेषण करने के लिए सबसे कठिन चुनौतियों में से एक है।
उच्चारण और बोलियाँ: मुख्य रूप से एक उच्चारण पर प्रशिक्षित मॉडल विभिन्न क्षेत्रीय बोलियों या गैर-देशी लहजे वाले वक्ताओं को सही ढंग से ट्रांसक्राइब करने में संघर्ष कर सकते हैं।
तकनीकी शब्दावली: विशेष शब्दावली या उचित संज्ञाएं जो लैंग्वेज मॉडल के प्रशिक्षण डेटा में मौजूद नहीं हैं, अक्सर गलत समझी जाती हैं। इसे कस्टम शब्दावली के साथ कम किया जा सकता है।
खराब ऑडियो गुणवत्ता: कम गुणवत्ता वाले माइक्रोफ़ोन, वक्ता से दूरी, और अत्यधिक गूँज इनपुट सिग्नल को खराब कर देती है, जिससे सटीक ट्रांसक्रिप्शन मुश्किल हो जाता है।
ट्रांसक्रिप्शन तकनीक का भविष्य
गहन शिक्षण (deep learning) में नवाचारों और विशाल डेटासेट की उपलब्धता के कारण एआई ट्रांसक्रिप्शन का क्षेत्र तेजी से आगे बढ़ रहा है। वैश्विक बाजार, जिसका मूल्य 2024 में $4.5 बिलियन था, 2034 तक $19.2 बिलियन तक पहुंचने का अनुमान है (Market.us, 2025)। यह वृद्धि ग्राहक सहायता के लिए एआई ट्रांसक्रिप्शन और रीयल-टाइम मीटिंग विश्लेषण जैसे अनुप्रयोगों द्वारा संचालित है, जिसके सालाना 25.62% की दर से बढ़ने की उम्मीद है (Sonix, 2026)।
भविष्य के विकास चुनौतीपूर्ण परिस्थितियों में सटीकता में सुधार, संदर्भ और इरादे की बेहतर समझ, और अन्य एआई क्षमताओं के साथ मजबूत एकीकरण पर ध्यान केंद्रित करेंगे। जैसे-जैसे मॉडल अधिक कुशल होंगे, हम एज डिवाइसेस पर अधिक शक्तिशाली रीयल-टाइम एआई स्पीच रिकग्निशन देखेंगे। डेवलपर्स और व्यवसायों के लिए, सर्वश्रेष्ठ ट्रांसक्रिप्शन सॉफ़्टवेयर का चयन सटीकता, गति और स्पीकर डायराइजेशन जैसी विशिष्ट आवश्यकताओं पर निर्भर करेगा।
}
अक्सर पूछे जाने वाले प्रश्न
ASR और AI ट्रांसक्रिप्शन में क्या अंतर है?
एआई (AI) ट्रांसक्रिप्शन कितना सटीक है?
क्या एआई (AI) विभिन्न भाषाओं और लहजों (accents) को ट्रांसक्राइब कर सकता है?
स्पीकर डायराइजेशन (speaker diarization) क्या है?
मैं अपने ट्रांसक्रिप्शन की सटीकता में कैसे सुधार कर सकता हूँ?