वॉयस रिकॉग्निशन बनाम स्पीच रिकॉग्निशन: आपके एप्लिकेशन के लिए आपको किसकी आवश्यकता है?
अपनी एप्लिकेशन के लिए सही तकनीक चुनने के लिए वॉयस रिकग्निशन (कौन बोल रहा है) और स्पीच रिकग्निशन (क्या कहा जा रहा है) के बीच मुख्य अंतर जानें।
वॉइस रिकग्निशन बनाम स्पीच रिकग्निशन: आपके एप्लिकेशन के लिए किसकी आवश्यकता है?
स्पीच रिकग्निशन तकनीक बोले गए शब्दों को टेक्स्ट में बदलती है, जिसका ध्यान इस बात पर केंद्रित होता है कि क्या कहा जा रहा है। इसके विपरीत, वॉइस रिकग्निशन (जिसे स्पीकर रिकग्निशन भी कहा जाता है) किसी विशिष्ट व्यक्ति की आवाज़ की पहचान या सत्यापन करता है, जिसका ध्यान इस बात पर केंद्रित होता है कि कौन बोल रहा है। हालाँकि अक्सर इन्हें एक-दूसरे के स्थान पर उपयोग किया जाता है, लेकिन ये अलग-अलग अनुप्रयोगों वाली विशिष्ट तकनीकें हैं, जो मीटिंग ट्रांसक्राइब करने से लेकर बैंक खातों को सुरक्षित करने तक काम आती हैं।
डेवलपर्स, प्रोडक्ट मैनेजर्स और व्यावसायिक लीडर्स के लिए इस अंतर को समझना महत्वपूर्ण है। सही तकनीक का चुनाव यह निर्धारित करता है कि आपका एप्लिकेशन कमांड को समझ सकता है, ऑडियो ट्रांसक्राइब कर सकता है, या बायोमेट्रिक सटीकता के साथ उपयोगकर्ताओं को प्रमाणित कर सकता है।
इन तकनीकों का वैश्विक बाज़ार इनके बढ़ते महत्व को दर्शाता है; एक विश्लेषण का अनुमान है कि वॉइस रिकग्निशन मार्केट का आकार 2025 में 6.03 बिलियन अमरीकी डॉलर से बढ़कर 2033 तक 19.51 बिलियन अमरीकी डॉलर हो जाएगा (स्काईक्वेस्ट टेक्नोलॉजी, 2025)।
स्पीच रिकग्निशन क्या है? 'क्या'
स्पीच रिकग्निशन, जिसे ऑटोमैटिक स्पीच रिकग्निशन (ASR) भी कहा जाता है, वह तकनीक है जो मानव भाषण को लिखित पाठ (टेक्स्ट) में परिवर्तित करती है। इसका प्राथमिक कार्य यह समझना है कि क्या कहा जा रहा है, चाहे बोलने वाला कोई भी हो। यह ध्वनि तरंगों का विश्लेषण करके, ध्वन्यात्मक इकाइयों की पहचान करके और सबसे संभावित शब्दों के अनुक्रम का अनुमान लगाने के लिए कस्टम भाषा मॉडल का उपयोग करके काम करता है।
स्पीच रिकग्निशन, जिसे औपचारिक रूप से ऑटोमैटिक स्पीच रिकग्निशन (ASR) के रूप में जाना जाता है, एक ऐसी तकनीक है जो मशीन को मानव भाषण को संसाधित करने और उसे लिखित, मशीन-पठनीय प्रारूप में बदलने में सक्षम बनाती है। जैसा कि IBM (2026) द्वारा परिभाषित किया गया है, इसका प्राथमिक लक्ष्य बोली जाने वाली भाषा का पाठ में अनुवाद करना है। एलेक्सा या गूगल असिस्टेंट जैसे वर्चुअल असिस्टेंट आपके इरादे का पता लगाने से पहले आपके द्वारा कहे गए शब्दों को समझने के लिए पहले कदम के रूप में ASR का उपयोग करते हैं। हमारा वॉइस एआई प्लेटफॉर्म उद्यम अनुप्रयोगों के लिए डिज़ाइन किए गए उच्च-सटीकता वाले ASR मॉडल प्रदान करता है।
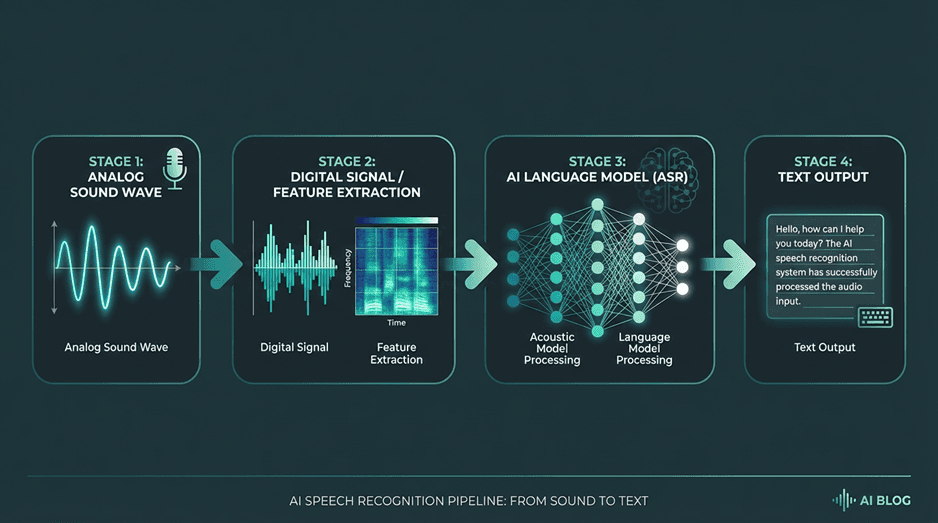
स्पीच रिकग्निशन सिस्टम एनालॉग ध्वनि तरंगों को डिजिटल डेटा में परिवर्तित करते हैं, फिर इसे टेक्स्ट में ट्रांसक्राइब करने के लिए एआई मॉडल का उपयोग करते हैं।
स्पीच रिकग्निशन कैसे काम करता है
आधुनिक एआई स्पीच रिकग्निशन तकनीक एक जटिल पाइपलाइन के माध्यम से संचालित होती है। इस प्रक्रिया में आम तौर पर कई प्रमुख चरण शामिल होते हैं:
ध्वनिक विश्लेषण (Acoustic Analysis): एक माइक्रोफ़ोन स्पीकर से ध्वनि तरंगों को कैप्चर करता है। सिस्टम इन एनालॉग तरंगों को डिजिटल सिग्नल में परिवर्तित करता है।
विशेषता निष्कर्षण (Feature Extraction): पृष्ठभूमि के शोर को हटाने के लिए डिजिटल सिग्नल को साफ किया जाता है और छोटे टुकड़ों में तोड़ दिया जाता है। सिस्टम किसी भाषा में ध्वनि की सबसे छोटी इकाइयों, जिन्हें फोनीम्स (phonemes) कहते हैं (जैसे 'cat' में 'k' की ध्वनि), की पहचान करने के लिए इन टुकड़ों का विश्लेषण करता है।
भाषा मॉडलिंग (Language Modeling): सिस्टम विशाल मात्रा में टेक्स्ट डेटा पर प्रशिक्षित भाषा मॉडल का उपयोग करके पहचाने गए फोनीम्स के आधार पर शब्दों के सबसे संभावित अनुक्रम का अनुमान लगाता है। यह चरण वाक्य के संदर्भ पर विचार करके 'to', 'too', और 'two' जैसे समरूप शब्दों के बीच अंतर करने में मदद करता है।
टेक्स्ट आउटपुट: शब्दों का सबसे संभावित अनुक्रम तैयार किया जाता है और टेक्स्ट के रूप में आउटपुट दिया जाता है।
स्पीच रिकग्निशन के सामान्य अनुप्रयोग
चूंकि यह सामग्री पर ध्यान केंद्रित करता है, इसलिए ASR किसी भी ऐसे एप्लिकेशन का आधार है जिसे बोली जाने वाली भाषा को समझने या उसका दस्तावेजीकरण करने की आवश्यकता होती है:
वर्चुअल असिस्टेंट: सिरी, एलेक्सा और गूगल असिस्टेंट को उपयोगकर्ता के आदेशों और प्रश्नों को समझने में सक्षम बनाना।
ट्रांसक्रिप्शन सेवाएं: बैठकों, साक्षात्कारों और मीडिया सामग्री के लिए ऑडियो और वीडियो फ़ाइलों को स्वचालित रूप से टेक्स्ट में परिवर्तित करना। यह रीयल-टाइम स्पीच रिकग्निशन का एक मुख्य कार्य है।
इन-कार सिस्टम: ड्राइवरों को वॉइस कमांड के साथ नेविगेशन, संगीत और कॉल को नियंत्रित करने में सक्षम बनाना।
स्वास्थ्य सेवा: चिकित्सकों को रोगी के नोट्स सीधे इलेक्ट्रॉनिक स्वास्थ्य रिकॉर्ड (EHR) में डिक्टेट करने की अनुमति देना, जिसे मेडिकल डिक्टेशन के रूप में जाना जाता है।
ग्राहक सेवा: विश्लेषण के लिए कॉल को ट्रांसक्राइब करना और इंटरैक्टिव वॉइस रिस्पॉन्स (IVR) सिस्टम को संचालित करना। Smallest.ai कॉन्टैक्ट सेंटर इंटेलिजेंस के लिए विशेष मॉडल प्रदान करता है।
वॉइस रिकग्निशन क्या है? 'कौन'
वॉइस रिकग्निशन, जिसे स्पीकर रिकग्निशन भी कहा जाता है, एक बायोमेट्रिक तकनीक है जो यह पहचानती है कि कौन बोल रहा है। यह 'वॉइसप्रिंट' बनाने के लिए पिच, टोन और लहजे जैसी अनूठी वोकल विशेषताओं का विश्लेषण करती है। इस तकनीक का उपयोग प्रमाणीकरण और वैयक्तिकरण के लिए किया जाता है, जो बोले गए शब्दों को समझने के बजाय स्पीकर की पहचान की पुष्टि करती है।
वॉइस रिकग्निशन, या स्पीकर रिकग्निशन, एक बायोमेट्रिक तकनीक है जिसका उपयोग किसी व्यक्ति की विशिष्ट वोकल विशेषताओं के आधार पर उसकी पहचान करने के लिए किया जाता है। इसे इस बात से कोई सरोकार नहीं होता कि क्या शब्द कहे जा रहे हैं; इसके बजाय, यह अंतर्निहित वॉइसप्रिंट का विश्लेषण करता है। नेशनल इंस्टीट्यूट ऑफ स्टैंडर्ड्स एंड टेक्नोलॉजी (NIST, 2025) के अनुसार, स्पीकर रिकग्निशन तकनीक का उद्देश्य भाषण के ध्वनिक गुणों से यह निर्धारित करना है कि कौन बोल रहा है।
वॉइस रिकग्निशन कैसे काम करता है
किसी स्पीकर की पहचान करने की प्रक्रिया में एक 'वॉइसप्रिंट' बनाना और उसका मिलान करना शामिल है, जो किसी व्यक्ति की अनूठी वोकल विशेषताओं का एक डिजिटल मॉडल होता है। ये विशेषताएं शारीरिक लक्षणों (वोकल ट्रैक्ट का आकार) और व्यवहार संबंधी तौर-तरीकों (लहजा, गति और उच्चारण) का संयोजन होती हैं।
वॉइस रिकग्निशन के संचालन के दो प्राथमिक तरीके हैं, और आप हमारे ब्लॉग पर विस्तार से जान सकते हैं कि वॉइस रिकग्निशन कैसे काम करता है:
स्पीकर की पहचान (Speaker Identification): यह इस प्रश्न का उत्तर देता है, “कौन बोल रहा है?” सिस्टम एक मिलान खोजने के लिए ज्ञात वॉइसप्रिंट के डेटाबेस के साथ एक वॉइस सैंपल की तुलना करता है (एक-से-अनेक तुलना)। इसका उपयोग कानून प्रवर्तन में किसी रिकॉर्डिंग से संदिग्ध की पहचान करने के लिए किया जाता है।
स्पीकर सत्यापन (या प्रमाणीकरण) (Speaker Verification): यह इस प्रश्न का उत्तर देता है, “क्या यह वही व्यक्ति है जिसका यह दावा कर रहा है?” सिस्टम एक विशिष्ट उपयोगकर्ता के लिए पहले से दर्ज वॉइसप्रिंट के साथ एक लाइव वॉइस सैंपल की तुलना करता (एक-से-एक तुलना) है। सुरक्षा अनुप्रयोगों के लिए इसी पद्धति का उपयोग किया जाता है।
वॉइस रिकग्निशन के सामान्य अनुप्रयोग
पहचान पर ध्यान केंद्रित होने के कारण वॉइस रिकग्निशन सुरक्षा और वैयक्तिकरण के लिए आदर्श है:
बायोमेट्रिक प्रमाणीकरण: बैंक और वित्तीय संस्थान धोखाधड़ी को रोकने के लिए फोन पर खातों तक पहुँचने के लिए ग्राहकों के वॉइस वेरिफिकेशन का उपयोग करते हैं। Smallest.ai इस उद्देश्य के लिए सुरक्षित वॉइस बायोमेट्रिक्स समाधान प्रदान करता है।
डिवाइस सुरक्षा: किसी विशिष्ट उपयोगकर्ता की आवाज़ से स्मार्टफोन या स्मार्ट होम डिवाइस को अनलॉक करना।
वैयक्तिकरण: गूगल होम जैसे स्मार्ट स्पीकर व्यक्तिगत कैलेंडर, संगीत प्लेलिस्ट और समाचार अपडेट प्रदान करने के लिए आवाज़ से परिवार के विभिन्न सदस्यों की पहचान कर सकते हैं।
कानून प्रवर्तन: आपराधिक जांच में वॉइस रिकॉर्डिंग से संदिग्धों की पहचान करना।
कन्वर्सेशनल एआई: लौटकर आने वाले ग्राहक को पहचानकर चैटबॉट इंटरैक्शन को व्यक्तिगत बनाना। यह कन्वर्सेशनल एआई में वॉइस रिकग्निशन का एक प्रमुख पहलू है।
वॉइस रिकग्निशन बनाम स्पीच रिकग्निशन: एक आमने-सामने की तुलना
हालाँकि दोनों तकनीकें मानव आवाज़ का विश्लेषण करती हैं, लेकिन उनके लक्ष्य, तरीके और आउटपुट मौलिक रूप से भिन्न हैं। निम्नलिखित तालिका प्रमुख अंतरों को दर्शाती है ताकि आपको यह तय करने में मदद मिल सके कि कौन सी तकनीक आपकी आवश्यकताओं के अनुकूल है।
विशेषता | स्पीच रिकग्निशन (ASR) | वॉइस रिकग्निशन (स्पीकर रिकग्निशन) |
|---|---|---|
प्राथमिक लक्ष्य | यह समझना कि क्या कहा जा रहा है। | यह पहचानना कि कौन बोल रहा है। |
मुख्य कार्य | बोले गए शब्दों को टेक्स्ट में ट्रांसक्राइब करना। | एक वॉइसप्रिंट का किसी ज्ञात पहचान से मिलान करना। |
आउटपुट | टेक्स्ट की एक स्ट्रिंग। | एक उपयोगकर्ता पहचान या सत्यापन (हाँ/ना) का परिणाम। |
मुख्य तकनीक | ध्वनिक (Acoustic) और भाषा मॉडल। | बायोमेट्रिक विश्लेषण और पैटर्न मिलान। |
उदाहरण उपयोग मामला | एक टेक्स्ट संदेश डिक्टेट करना। | अपनी आवाज़ से अपने फ़ोन को अनलॉक करना। |
निर्भरता | भाषा-निर्भर (प्रत्येक भाषा के लिए मॉडल की आवश्यकता होती है)। | भाषा-स्वतंत्र (वोकल विशेषताओं का विश्लेषण करता है, शब्दों का नहीं)। |
निर्णय चेकलिस्ट: ASR बनाम स्पीकर रिकग्निशन
यह निर्धारित करने के लिए इन प्रश्नों का उपयोग करें कि आपके एप्लिकेशन के लिए कौन सी तकनीक सही है।
सुरक्षा स्तर: क्या आपका प्राथमिक लक्ष्य उपयोगकर्ता को प्रमाणित करना और संवेदनशील जानकारी तक पहुँच को सुरक्षित करना है? यदि हाँ, तो आपको इसकी बायोमेट्रिक क्षमताओं के लिए वॉइस रिकग्निशन की आवश्यकता है।
उपयोगकर्ता नामांकन (Enrollment): क्या आप उपयोगकर्ताओं से पहले से नमूने प्रदान करके अपनी आवाज़ दर्ज करने की मांग कर सकते हैं? वॉइस रिकग्निशन के लिए नामांकन आवश्यक है, लेकिन सामान्य उद्देश्य वाले स्पीच रिकग्निशन के लिए नहीं।
भाषा समर्थन: क्या आपके एप्लिकेशन को एक या अधिक विशिष्ट भाषाओं में शब्दों को समझने और ट्रांसक्राइब करने की आवश्यकता है? यदि ऐसा है, तो आपको उपयुक्त भाषा मॉडल के साथ स्पीच रिकग्निशन की आवश्यकता है।
परिचालन वातावरण: क्या एप्लिकेशन का उपयोग शोर-शराबे वाले वातावरण में किया जाएगा? हालाँकि दोनों तकनीकें शोर से प्रभावित होती हैं, लेकिन स्पीच रिकग्निशन सिस्टम में अक्सर शब्दों को अलग करने के लिए उन्नत शोर रद्दीकरण (noise cancellation) होता है, जबकि पृष्ठभूमि का शोर वॉइस रिकग्निशन के लिए एक स्पष्ट वॉइसप्रिंट बनाने में हस्तक्षेप कर सकता है।
आपको दोनों की आवश्यकता कब होती है?
कुछ सबसे शक्तिशाली वॉइस-सक्षम एप्लिकेशन एक व्यापक उपयोगकर्ता अनुभव बनाने के लिए दोनों तकनीकों को मिलाते हैं। इन हाइब्रिड सिस्टम में, वॉइस रिकग्निशन पहले उपयोगकर्ता की पहचान करता है, और फिर स्पीच रिकग्निशन उनके आदेशों को संसाधित करता है। यह तालमेल सुरक्षा और कार्यक्षमता दोनों को सक्षम बनाता है।
एक स्मार्ट होम सिस्टम पर विचार करें। जब कोई उपयोगकर्ता कहता है, “हे गूगल, मेरी खरीदारी सूची में दूध जोड़ें,” तो डिवाइस एक साथ दो क्रियाएं करता है:
वॉइस रिकग्निशन: यह स्पीकर की पहचान उसके अनूठे वॉइसप्रिंट से 'अंजलि' के रूप में करता है।
स्पीच रिकग्निशन: यह कमांड “मेरी खरीदारी सूची में दूध जोड़ें” को टेक्स्ट में ट्रांसक्राइब करता है।
इसके बाद सिस्टम इन परिणामों को मिलाकर 'दूध' को अंजलि की विशिष्ट खरीदारी सूची में जोड़ता है, न कि घर में किसी और की सूची में। पहचान और ट्रांसक्रिप्शन का यही अनूठा मिश्रण आधुनिक वॉइस सहायकों को इतना प्रभावी बनाता है। ऐसे सिस्टम बनाने की चाह रखने वाले डेवलपर्स अक्सर स्पीच-टू-टेक्स्ट एपीआई के सुइट पर भरोसा करते हैं जो इन जटिल कार्यों को संभाल सकते हैं। Smallest.ai प्लेटफॉर्म एकीकृत एपीआई प्रदान करता है जो दोनों क्षमताएं प्रदान करते हैं।
अपनी आवश्यकताओं के लिए सही तकनीक चुनना
वॉइस रिकग्निशन बनाम स्पीच रिकग्निशन के बीच का चुनाव आपके एप्लिकेशन के प्राथमिक लक्ष्य पर निर्भर करता है। खुद से एक सरल प्रश्न पूछें: क्या यह जानना अधिक महत्वपूर्ण है कि कौन बोल रहा है या वे क्या कह रहे हैं?
आपको स्पीच रिकग्निशन की आवश्यकता है यदि आपके एप्लिकेशन को निम्नलिखित कार्य करने हैं:
ऑडियो को टेक्स्ट में ट्रांसक्राइब करना।
बोले गए आदेशों पर कार्य करना।
वॉइस सर्च कार्यक्षमता सक्षम करना।
वीडियो सामग्री के लिए क्लोज्ड कैप्शन प्रदान करना।
आपको वॉइस रिकग्निशन की आवश्यकता है यदि आपके एप्लिकेशन को निम्नलिखित कार्य करने हैं:
सुरक्षित पहुँच के लिए उपयोगकर्ताओं को प्रमाणित करना।
विभिन्न उपयोगकर्ताओं के लिए अनुभवों को व्यक्तिगत बनाना।
रिकॉर्ड की गई बातचीत में बोलने वालों की पहचान करना।
किसी डिवाइस या सेवा के अनधिकृत उपयोग को रोकना।
अपने उद्देश्य को स्पष्ट रूप से परिभाषित करके, आप सही टूल का चयन कर सकते हैं और एक अधिक सहज, प्रभावी और सुरक्षित उत्पाद बना सकते हैं। Smallest.ai पर, हमारा वॉइस एआई प्लेटफॉर्म डेवलपर्स को इन क्षमताओं को किसी भी एप्लिकेशन में एकीकृत करने के लिए आवश्यक शक्तिशाली स्पीच मॉडल और टूल प्रदान करता है। अपने विशिष्ट उपयोग के मामले पर चर्चा करने के लिए हमारी टीम से संपर्क करें।
अक्सर पूछे जाने वाले प्रश्न
क्या आवाज़ की पहचान (वॉइस रिकग्निशन) पासवर्ड से ज़्यादा सुरक्षित है?
क्या स्पीच रिकग्निशन (आवाज़ पहचानना) अलग-अलग लहजों और बोलियों को समझ सकता है?
क्या मैं ऑफ़लाइन स्पीच रिकग्निशन (आवाज़ पहचानना) का उपयोग कर सकता हूँ?
आवाज पहचान (voice recognition) बनाम भाषण पहचान (speech recognition) के कुछ उदाहरण क्या हैं?
स्पीकर वेरिफिकेशन (वक्ता सत्यापन) और आइडेंटिफिकेशन (वक्ता पहचान) के बीच क्या अंतर है?
ASR और NLP के बीच क्या अंतर है?
वॉइस बायोमेट्रिक्स और स्पीच-टू-टेक्स्ट के बीच क्या अंतर है?