भावनाओं के साथ टेक्स्ट से स्पीच का एक तकनीकी मार्गदर्शिका: यह कैसे काम करता है, अभिव्यंजक एआई आवाज़ों का मूल्यांकन कैसे करें, और 2026 में कौन से प्लेटफॉर्म सबसे आगे हैं।
भावनाओं के साथ टेक्स्ट टू स्पीच (टीटीएस) अब रिसर्च लैब से बाहर निकलकर प्रोडक्शन की एक अहम जरूरत बन गया है। चाहे आप कोई कन्वर्सेशनल एआई एजेंट बना रहे हों, कोई नरेशन टूल, या फिर कोई आईवीआर (IVR) सिस्टम, एक सपाट और बेजान आवाज यूजर के अनुभव को इस कदर खराब कर देती है कि वे इसे तुरंत भांप लेते हैं। 'तकनीकी रूप से सही' और 'वास्तव में आश्वस्त करने वाली' आवाज के बीच का अंतर पूरी तरह से इस बात पर निर्भर करता है कि उसमें भावनाओं की अभिव्यक्ति (इमोशनल एक्सप्रेसिवनेस) कितनी है।
आगे के लेख में यह बताया गया है कि पर्दे के पीछे इमोशनल स्पीच सिंथेसिस कैसे काम करता है, कौन सी चीजें वास्तव में एक्सप्रेसिव आवाजों को उन आवाजों से अलग करती हैं जो केवल पिच (आवाज के उतार-चढ़ाव) को बदलती हैं, आज उपलब्ध सर्वोत्तम विकल्पों का मूल्यांकन कैसे करें, और वास्तविक उत्पादों में इस सोच को कैसे लागू करें। इसका उद्देश्य आपके विशिष्ट उपयोग के मामले (यूज केस) के लिए एक्सप्रेसिव एआई आवाजों को चुनने और उन्हें लागू करने के लिए एक स्पष्ट रूपरेखा प्रदान करना है।
टीटीएस में 'भावना' (Emotion in TTS) का वास्तव में क्या अर्थ है
ज्यादातर लोग यह मान लेते हैं कि इमोशनल टीटीएस का मतलब सिर्फ किसी आवाज को 'खुश' या 'उदास' बनाना है। यह सोच बहुत सीमित है और इसके कारण गलत फैसले लिए जा सकते हैं। स्पीच सिंथेसिस में भावनाओं की अभिव्यक्ति एक बहु-आयामी समस्या है जो अफेक्टिव कंप्यूटिंग पर आधारित है। यह एक ऐसा अंतःविषय क्षेत्र (इंटरडिसिप्लिनरी फील्ड) है जो यह अध्ययन करता है कि सिस्टम किस प्रकार मानवीय भावनात्मक स्थितियों को पहचान सकते हैं, उनकी व्याख्या कर सकते हैं और उनका अनुकरण कर सकते हैं।
आधुनिक शोध अब अलग-अलग इमोशन लेबलों से हटकर निरंतर आयामी मॉडलों (कंटीन्यूअस डाइमेंशनल मॉडल्स) की ओर बढ़ गया है। पीएडी (PAD) मॉडल भावनात्मक स्थितियों को तीन अक्षों (एक्सिस) पर दर्शाता है: प्लेज़र (प्रसन्नता), अराउज़ल (उत्तेजना), और डोमिनेंस (प्रभुत्व)। एक आवाज जो 'उत्साहित' लगती है, वह प्लेज़र और अराउज़ल दोनों पर उच्च स्तर पर होती है। एक आवाज जो 'तनावपूर्ण' लगती है, वह अराउज़ल पर तो उच्च होती है लेकिन प्लेज़र पर कम होती है। यह आयामी ढांचा स्पष्ट करता है कि सबसे बेहतरीन एक्सप्रेसिव टीटीएस सिस्टम नाटकीय होने के बजाय सूक्ष्म (न्यूआंस्ड) क्यों महसूस होते हैं।
इसका व्यावहारिक प्रभाव यह है कि: जब आप भावनात्मक आउटपुट के लिए किसी भी टीटीएस सिस्टम का मूल्यांकन करते हैं, तो आप केवल यह नहीं देखते कि उसमें कोई 'हंसमुख' (cheerful) प्रीसेट है या नहीं। बल्कि आप यह देख रहे होते हैं कि क्या वह आवाज के उतार-चढ़ाव (प्रोसॉडी), बोलने की गति, सूक्ष्म-विरामों (माइक्रो-पॉजेस) और इंटोनेशन कॉन्टूर को इस तरह से नियंत्रित कर सकता है जो केवल टोनल रूप से अलग न लगे, बल्कि संदर्भ के अनुसार उपयुक्त भी महसूस हो। तकनीकी रूप से सही भाषण और भावनात्मक रूप से आश्वस्त करने वाले भाषण के बीच का अंतर वास्तविक है, और यही कारण है कि यह विषय केवल एक सामान्य वेंडर तुलना से कहीं अधिक ध्यान आकर्षित करने का हकदार है।
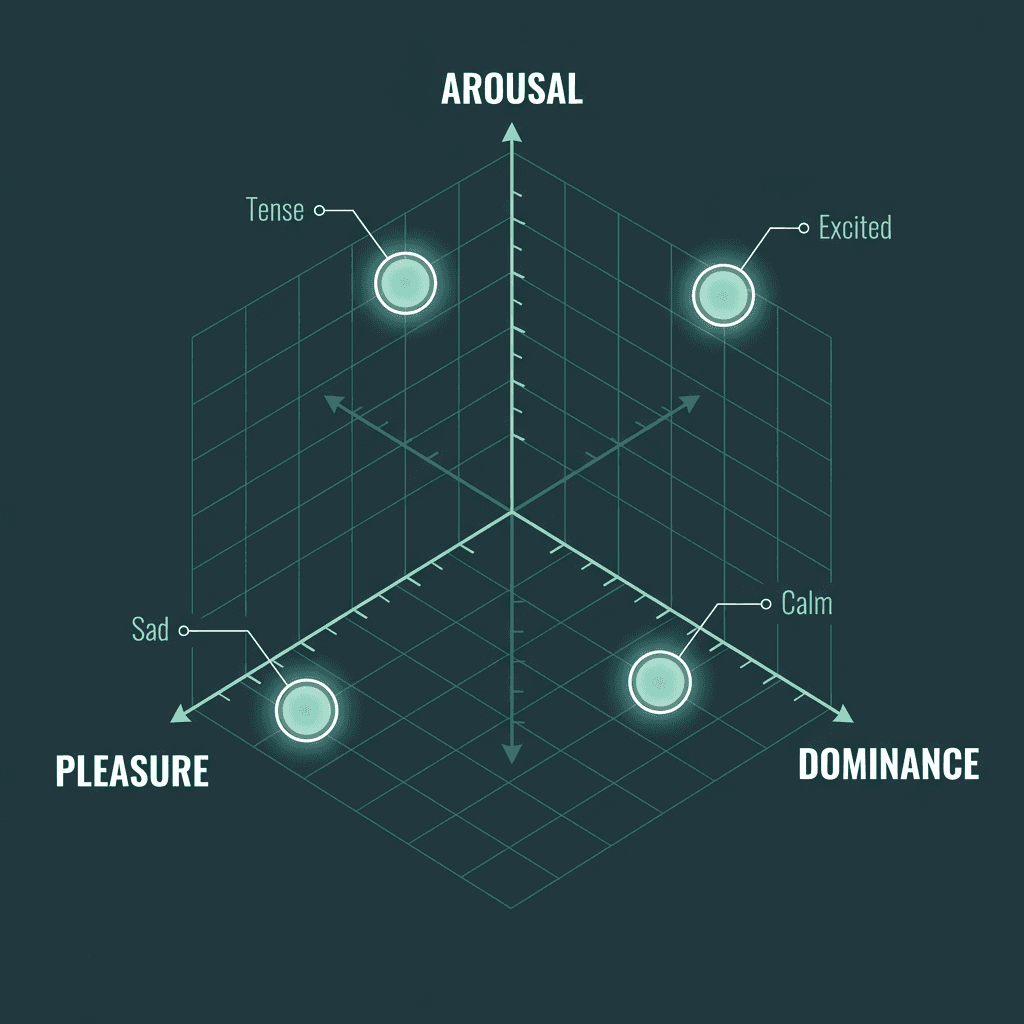
पीएडी (PAD) मॉडल भावनात्मक स्थितियों को अलग-अलग श्रेणियों के बजाय तीन निरंतर आयामों में दर्शाता है।
एक्सप्रेसिव आवाजों के पीछे का टेक्नोलॉजी स्टैक
तीन परतें (लेयर्स) यह तय करती हैं कि कोई टीटीएस सिस्टम कितना एक्सप्रेसिव हो सकता है: लिंग्विस्टिक फ्रंट-एंड, एकॉस्टिक मॉडल और वोकोडर। अधिकांश सतही तुलनाएं केवल आउटपुट ऑडियो को देखती हैं। प्रत्येक परत को समझने से आपको यह अनुमान लगाने में मदद मिलती है कि कोई सिस्टम वास्तविक दुनिया की स्थितियों में कहां विफल हो सकता है।
लिंग्विस्टिक फ्रंट-एंड वाक्यात्मक संरचना (सिंटैक्टिक स्ट्रक्चर), विराम चिह्नों के उद्देश्य और सिमेंटिक संदर्भ के लिए टेक्स्ट का विश्लेषण करता है। एक अच्छी तरह से डिज़ाइन किया गया फ्रंट-एंड यह अनुमान लगा लेता है कि ग्राहक सहायता स्क्रिप्ट में विस्मयादिबोधक चिह्न (!) के लिए बच्चों की कहानी में उसी विराम चिह्न की तुलना में एक अलग प्रोसॉडी (उतार-चढ़ाव) की आवश्यकता होगी। इसके बाद, एकॉस्टिक मॉडल उन भाषाई विशेषताओं को स्पीच मापदंडों से जोड़ता है; ट्रांसफॉर्मर-आधारित आर्किटेक्चर और डिफ्यूजन मॉडल्स ने यहां पुराने कॉनकैटिनेटिव तरीकों की जगह ले ली है, जिससे भावनाओं पर अधिक सटीक नियंत्रण संभव हो पाता है। वोकोडर एकॉस्टिक विशेषताओं को वेवफॉर्म में बदलता है, और न्यूरल वोकोडर्स (HiFi-GAN वेरिएंट इसके सामान्य उदाहरण हैं) उन सूक्ष्म तिम्ब्रे (timbral) गुणों को बनाए रखते हैं जो भावनात्मक भाषण को प्रोसेस्ड लगने के बजाय स्वाभाविक बनाते हैं। कुछ पाइपलाइनें एक जनरेटर और डिस्क्रिमिनेटर को एक-दूसरे के विपरीत प्रशिक्षित करके अधिक यथार्थवादी और भावनात्मक रूप से विविध भाषण उत्पन्न करने के लिए जनरेटिव एडवरसेरियल नेटवर्क (GANs) को भी शामिल करती हैं।
एक मानक जिसे जानना जरूरी है: स्पीच सिंथेसिस मार्कअप लैंग्वेज (SSML) एक W3C-अनुशंसित विशिष्टता है जो डेवलपर्स को संश्लेषित (सिंथेसाइज्ड) भाषण में पिच, गति, वॉल्यूम और जोर को नियंत्रित करने का एक संरचित तरीका देती है। एसएसएमएल को नियंत्रण का आधार (फ्लोर) समझें, उसकी सीमा (सीलिंग) नहीं। सबसे बेहतरीन एक्सप्रेसिव टीटीएस प्लेटफॉर्म इससे कहीं आगे जाते हैं, और वे मैन्युअल रूप से ट्यून किए गए मार्कअप के बजाय सीखी गई भावनात्मक प्रस्तुतियों (लर्नड इमोशनल रिप्रेजेंटेशन्स) का उपयोग करते हैं। इसके बावजूद, एसएसएमएल नियतात्मक (डिटरमिनिस्टिक), नियम-आधारित समायोजन के लिए उपयोगी बना हुआ है जब आपको अनुमानित आउटपुट की आवश्यकता होती है।
एक्सप्रेसिव एआई आवाजों का मूल्यांकन: एक व्यावहारिक रूपरेखा
किसी वेंडर की वेबसाइट पर डेमो ऑडियो सुनना पर्याप्त नहीं है। डेमो को बहुत सावधानी से चुना और सजाया जाता है। वास्तव में मायने यह रखता है कि कोई आवाज आपके कंटेंट पर, बड़े पैमाने पर और कठिन परिस्थितियों (एज केसेस) में कैसा प्रदर्शन करती है। विशिष्ट प्लेटफॉर्म की तुलना करने से पहले, उन्हें एक सुसंगत मूल्यांकन ढांचे के माध्यम से परखें।
मापदंड | क्या परीक्षण करना है | यह क्यों मायने रखता है |
|---|---|---|
प्रोसॉडिक रेंज (Prosodic range) | विभिन्न विराम चिह्नों और संदर्भ संकेतों के साथ एक ही वाक्य चलाएं | यह प्रकट करता है कि भावना का अनुमान लगाया गया है या इसे केवल एक स्थिर शैली की परत (स्टेटिक स्टाइल लेयर) के रूप में लागू किया गया है |
शैली की निरंतरता (Style consistency) | एक ही भावनात्मक शैली में 50+ वाक्य उत्पन्न करें | असंगति लंबे समय तक चलने वाले कंटेंट में जुड़ाव (इमर्शन) को तोड़ देती है |
लेटेंसी (Latency) | स्ट्रीमिंग उपयोग के मामलों के लिए टाइम-टू-फर्स्ट-ऑडियो-बाइट मापें | रीयल-टाइम एजेंटों और इंटरैक्टिव अनुप्रयोगों के लिए अत्यंत महत्वपूर्ण |
बहुभाषी भावनात्मक स्थानांतरण | गैर-अंग्रेजी भाषाओं में भावनात्मक शैलियों का परीक्षण करें | कई सिस्टम केवल अंग्रेजी डेटा पर ही भावनाओं का प्रशिक्षण देते हैं |
एपीआई नियंत्रण की सूक्ष्मता | जांचें कि क्या आप केवल श्रेणी ही नहीं, बल्कि भावना की तीव्रता भी सेट कर सकते हैं | मोटे नियंत्रण नाटकीय आउटपुट देते हैं; बारीक नियंत्रण स्वाभाविक आउटपुट देते हैं |
आवाज की क्लोनिंग + भावना | परीक्षण करें कि क्या कस्टम क्लोन की गई आवाजें अपनी भावनात्मक रेंज बनाए रखती हैं | कुछ प्लेटफॉर्म क्लोनिंग करते समय अभिव्यक्ति (एक्सप्रेसिवनेस) को हटा देते हैं |
2026 में सर्वश्रेष्ठ एक्सप्रेसिव एआई वॉयस प्लेटफॉर्म
एक्सप्रेसिव टीटीएस का बाजार काफी परिपक्व हो गया है, लेकिन ये प्लेटफॉर्म एक जैसे नहीं हैं। यहाँ प्रमुख विकल्पों पर एक ईमानदार नज़र डाली गई है, जिसमें Smallest.ai सबसे आगे है और इसके कारण आगे स्पष्ट हो जाएंगे।
प्लेटफॉर्म | भावनात्मक नियंत्रण | लेटेंसी (स्ट्रीमिंग) | कीमत (शुरुआती) | किसके लिए सर्वश्रेष्ठ है |
|---|---|---|---|---|
Smallest.ai | बारीक शैली + तीव्रता नियंत्रण; वास्तविक समय में भावनात्मक अनुमान (इन्फ्रेंस) | ~100ms (लाइटनिंग मॉडल) | निःशुल्क योजना उपलब्ध; भुगतान ~$0.000020/अक्षर से शुरू (लाइटनिंग V2) | डेवलपर्स जिन्हें एजेंटों और उत्पादों के लिए कम-लेटेंसी वाली एक्सप्रेसिव आवाजों की आवश्यकता है |
ElevenLabs | आवाज डिजाइन और शैली अतिशयोक्ति स्लाइडर्स के माध्यम से भावना | ~300-500ms | निःशुल्क योजना; क्रिएटर $22/माह पर | कंटेंट निर्माता, ऑडियो पुस्तकें |
OpenAI TTS | सीमित; प्रॉम्प्ट निर्देश के माध्यम से टोन | ~200ms | एपीआई उपयोग स्तरों में शामिल | OpenAI इकोसिस्टम के भीतर सरल एकीकरण |
Cartesia | सोनिक मॉडल में वॉयस कंट्रोल के माध्यम से भावना | ~90ms | निःशुल्क योजना; स्टार्टअप $39/माह पर | वास्तविक समय के वॉयस ऐप्स |
Deepgram Aura | बुनियादी अभिव्यक्ति; गति के लिए अनुकूलित | ~150ms | $0.015/1K अक्षरों से भुगतान योजना (Aura-1) | उच्च-वॉल्यूम, गति-संवेदनशील पाइपलाइन |
Smallest.ai का लाइटनिंग (Lightning) मॉडल विशेष रूप से उन परिदृश्यों के लिए बनाया गया है जहाँ भावनात्मक सूक्ष्मता और प्रतिक्रिया की गति दोनों का एक साथ होना आवश्यक है। अधिकांश प्लेटफॉर्म एक्सप्रेसिवनेस और गति के बीच समझौता करने पर मजबूर करते हैं। Smallest.ai का आर्किटेक्चर विशेष रूप से उस समझौते से बचने के लिए डिज़ाइन किया गया है।
वास्तविक उत्पादों में एक्सप्रेसिव टीटीएस को लागू करना
कन्वर्सेशनल एआई एजेंट्स
यह वह जगह है जहाँ एक्सप्रेसिव टीटीएस सबसे मापने योग्य प्रभाव प्रदान करता है। एक ऐसा एजेंट जो यूजर के परेशान होने पर उबाऊ लगे, या अच्छी खबर देते समय बिल्कुल रूखा लगे, वह किसी गलत उत्तर की तुलना में अधिक तेजी से विश्वास खो देता है। कार्यान्वयन का सबसे महत्वपूर्ण पहलू गतिशील भावना चयन (डायनेमिक इमोशन सिलेक्शन) है: सिस्टम को बातचीत की स्थिति से भावनात्मक संदर्भ का अनुमान लगाना चाहिए और उसके अनुसार आवाज की शैली को समायोजित करना चाहिए, न कि पूरी बातचीत में एक ही स्थिर व्यक्तित्व को लागू रखना चाहिए। एजेंट आर्किटेक्चर में आवाज कैसे फिट बैठती है, इसे करीब से समझने के लिए स्पीच एनालिटिक्स उपयोग के मामले का विश्लेषण अवश्य पढ़ना चाहिए।
नरेशन और लॉन्ग-फॉर्म ऑडियो
ऑडियोबुक्स, ई-लर्निंग मॉड्यूल और डॉक्यूमेंट्री नरेशन के लिए लंबे पैराग्राफों में निरंतर भावनात्मक सुसंगतता की आवश्यकता होती है। यहाँ विफलता का मुख्य कारण भटकाव (ड्रिफ्ट) है: एक आवाज जो गर्मजोशी और जुड़ाव के साथ शुरू होती है, लेकिन जैसे-जैसे मॉडल लंबे अनुक्रमों को प्रोसेस करता है, धीरे-धीरे सपाट होती जाती है। हमेशा पूरे अध्यायों या मॉड्यूल पर परीक्षण करें, न कि केवल नमूना वाक्यों पर। सुलभ शुरुआती बिंदुओं के लिए, एक यथार्थवादी टेक्स्ट-टू-स्पीच आपको उत्पादन स्तर पर जाने से पहले प्रोटोटाइप बनाने में मदद कर सकता है।
इंटरैक्टिव मनोरंजन और गेमिंग
गेम संवाद और इंटरैक्टिव फिक्शन किसी भी अन्य उपयोग के मामले की तुलना में सबसे व्यापक भावनात्मक रेंज की मांग करते हैं। पात्रों को बातचीत के बीच में अपनी भावनात्मक स्थिति बदलनी पड़ती है, और वे बदलाव अचानक लगने के बजाय स्वाभाविक महसूस होने चाहिए। इस क्षेत्र के कुछ डेवलपर्स कैरेक्टर वर्क के लिए सेलिब्रिटी एआई आवाजों का पता लगाते हैं, हालांकि अधिक टिकाऊ दृष्टिकोण पहचानने योग्य चेहरों या आवाजों पर निर्भर रहने के बजाय मजबूत भावनात्मक रेंज वाली विशिष्ट मूल आवाजें बनाना है।
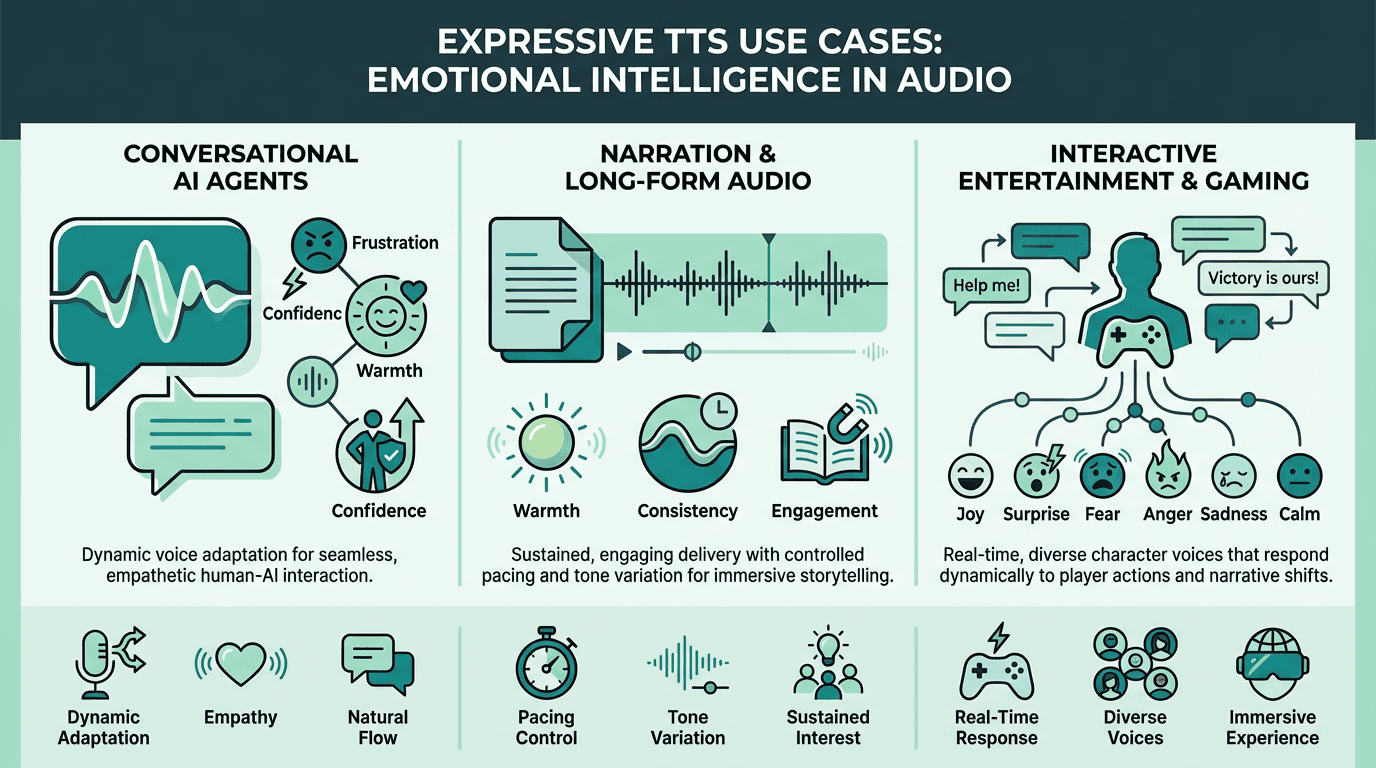
कन्वर्सेशनल एजेंटों, नरेशन और इंटरैक्टिव मनोरंजन में इमोशनल टीटीएस की आवश्यकताएं काफी भिन्न होती हैं।
इमोशनल वॉयस क्वालिटी के बारे में अधिकांश गाइड क्या गलत बताते हैं
अधिकांश टीटीएस तुलनात्मक लेख 'स्वाभाविकता' (naturalness) और 'अभिव्यक्ति' (expressiveness) को एक दूसरे का पर्यायवाची मानते हैं। वे ऐसे नहीं हैं। एक आवाज न्यूट्रल रजिस्टर में बेहद स्वाभाविक लग सकती है, लेकिन जब उससे आग्रह या गर्मजोशी व्यक्त करने के लिए कहा जाए, तो वह पूरी तरह से बिखर सकती है। स्वाभाविकता कमियों या बनावटीपन की अनुपस्थिति के बारे में है। अभिव्यक्ति उद्देश्य की उपस्थिति के बारे में है। आपको दोनों की आवश्यकता है, लेकिन उनके लिए अलग-अलग मूल्यांकन मानदंडों की आवश्यकता होती है।
दूसरी आम गलती मीन ओपिनियन स्कोर (MOS) बेंचमार्क को बहुत अधिक महत्व देना है। एमओएस नियंत्रित सुनने के परीक्षणों में कथित स्वाभाविकता को मापता है, जो आमतौर पर तटस्थ भाषण पर होता है। यह आपको इस बारे में लगभग कुछ नहीं बताता कि कोई आवाज वास्तविक परिनियोजन (डिप्लॉयमेंट) वातावरण में भावनात्मक रूप से भरे कंटेंट पर कैसा प्रदर्शन करती है। अपने वास्तविक कंटेंट डोमेन पर कार्य-विशिष्ट श्रवण परीक्षणों के साथ एमओएस डेटा को पूरक करें। कोई भी बेंचमार्क इसका विकल्प नहीं हो सकता।
इमोशनल वॉयस सिंथेसिस तकनीकी रूप से कैसे विकसित हुआ है, इसके गहन ज्ञान के लिए, इंसानों जैसी एआई आवाजों के लिए एक संपूर्ण गाइड में नियम-आधारित प्रणालियों से लेकर आधुनिक न्यूरल आर्किटेक्चर तक के विकास को विस्तार से शामिल किया गया है।
एक्सप्रेसिव एआई आवाजों का नैतिकता और जिम्मेदार उपयोग
एआई आवाज में भावनात्मक अभिव्यक्ति एक विशिष्ट चिंता पैदा करती है जो तटस्थ (न्यूट्रल) टीटीएस में नहीं होती: हेरफेर करने की क्षमता। एक आवाज जो आश्वस्त करने वाले तरीके से संकट, गर्मजोशी या अधिकार का अनुकरण कर सकती है, उसमें वास्तविक प्रेरक शक्ति होती है। नैतिकता सही और गलत के सुस्थापित मानकों पर आधारित है जो यह निर्धारित करते हैं कि मनुष्यों को क्या करना चाहिए, यह परिभाषा मार्ककुला सेंटर फॉर एप्लाइड एथिक्स द्वारा प्रदान की गई है और वे मानक सीधे यहाँ लागू होते हैं। उपभोक्ताओं के सामने आने वाले उत्पादों में भावनात्मक रूप से एक्सप्रेसिव आवाजों को तैनात करने वाले डेवलपर्स को प्रकटीकरण मानदंडों, आवाज क्लोनिंग के लिए सहमति ढांचे और उन संदर्भों के बारे में ध्यान से सोचना चाहिए जिनमें भावनात्मक अनुकरण उपयुक्त है या शोषक।
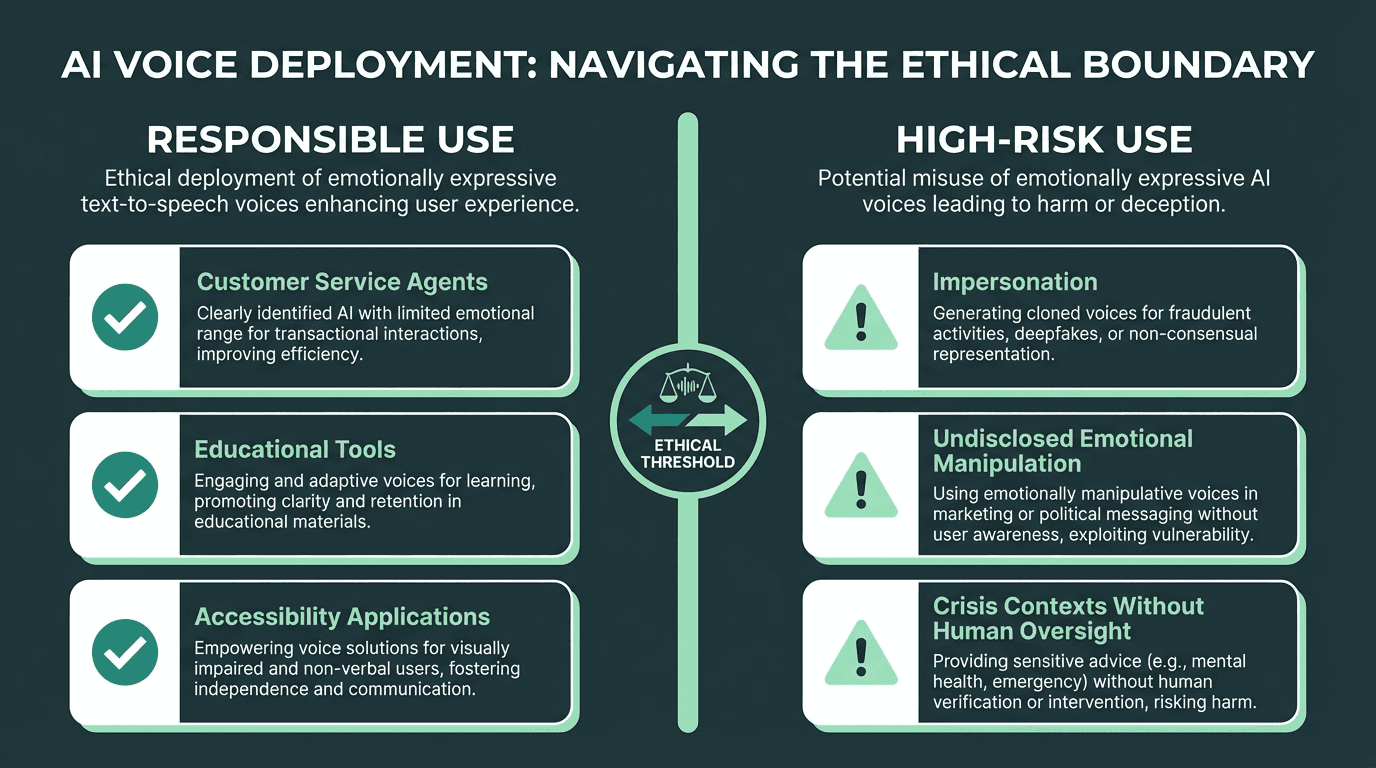
भावनात्मक रूप से एक्सप्रेसिव एआई आवाजों के जिम्मेदार परिनियोजन के लिए स्पष्ट उपयोग-मामले की सीमाएं और उपयोगकर्ता पारदर्शिता की आवश्यकता होती है।
मुख्य निष्कर्ष
आगे ले जाने योग्य बातें:
इमोशनल टीटीएस आयामी होता है, श्रेणीबद्ध नहीं। प्लेटफॉर्म का मूल्यांकन उनकी प्रोसॉडिक रेंज और तीव्रता नियंत्रण पर करें, न कि केवल उनके द्वारा विज्ञापित किए जाने वाले इमोशन प्रीसेट की संख्या पर।
टेक्नोलॉजी स्टैक मायने रखता है। एकॉस्टिक मॉडल आर्किटेक्चर और वोकोडर की गुणवत्ता अभिव्यक्ति की सीमा तय करती है। न्यूरल वोकोडर्स और ट्रांसफॉर्मर-आधारित एकॉस्टिक मॉडल वर्तमान मानक हैं।
एसएसएमएल एक आधार है, सीमा नहीं। नियतात्मक नियंत्रण के लिए इसका उपयोग करें, लेकिन उन प्लेटफार्मों को चुनें जो मार्कअप-आधारित अभिव्यक्ति से आगे जाते हैं।
अपने कंटेंट पर परीक्षण करें, वेंडर के डेमो पर नहीं। लेटेंसी, लंबे पैराग्राफों में शैली की निरंतरता, और बहुभाषी भावनात्मक स्थानांतरण वे विफलता बिंदु हैं जिन्हें अधिकांश तुलनाएं छोड़ देती हैं।
नैतिकता वैकल्पिक नहीं है। भावनात्मक रूप से एक्सप्रेसिव आवाजों में प्रेरक शक्ति होती है जो तटस्थ टीटीएस में नहीं होती। प्रकटीकरण और उपयुक्त उपयोग-मामले का दायरा तय करना गैर-परक्राम्य (नॉन-नेगोशिएबल) है।
अधिकांश टीटीएस सिस्टम ऐसा भाषण उत्पन्न करते हैं जो तकनीकी रूप से तो समझने योग्य होता है लेकिन भावनात्मक रूप से बेजान होता है, और उस अंतर का सीधा असर उपयोगकर्ता के अनुभव, जुड़ाव और किसी भी ऐसे उत्पाद में विश्वास पर पड़ता है जहाँ आवाज एक प्राथमिक इंटरफ़ेस है। Smallest.ai का लाइटनिंग मॉडल विशेष रूप से उस अंतर को पाटने के लिए बनाया गया है, जो 100ms से कम की स्ट्रीमिंग लेटेंसी को बारीक भावनात्मक शैली नियंत्रण के साथ जोड़ता है जो लंबे समय तक चलने वाले कंटेंट और वास्तविक समय के एजेंट इंटरैक्शन में बना रहता है। यदि आप जो बना रहे हैं उसमें आवाज की गुणवत्ता एक अलग पहचान बनाने वाली विशेषता है, तो Smallest.ai के माध्यम से उपलब्ध यथार्थवादी टेक्स्ट-टू-स्पीच क्षमताओं का मूल्यांकन आपकी विशिष्ट आवश्यकताओं के अनुसार किया जाना चाहिए। प्रतिबद्ध होने से पहले मुफ्त योजना के साथ शुरुआत करें और अपने वास्तविक कंटेंट पर परीक्षण करें।
भावनाओं के साथ टेक्स्ट-टू-स्पीच (टैक्स्ट से आवाज़ बनाना) क्या है और यह सामान्य टीटीएस (TTS) से कैसे अलग है?
क्या मैं एआई-जनरेटेड आवाज़ में भावनाओं की तीव्रता को नियंत्रित कर सकता हूँ?
मैं अपने उपयोग के मामले (use case) के लिए सही एक्सप्रेसिव टीटीएस (TTS) प्लेटफॉर्म कैसे चुनूं?
क्या ग्राहक-उन्मुख उत्पादों में भावनात्मक एआई वॉयस सिंथेसिस का उपयोग करना नैतिक रूप से सही है?
एक्सप्रेसिव वॉइस एप्लिकेशन्स के लिए Smallest.ai को क्या अलग बनाता है?