एआई में स्पीच रिकग्निशन के शीर्ष 6 व्यावहारिक उपयोग के मामले
जानें कि AI में स्पीच रिकग्निशन कैसे काम करता है, इसके प्रमुख उपयोग के मामले, मुख्य घटक, चुनौतियाँ और रीयल-टाइम, बहुभाषी ऑटोमेशन में भविष्य की प्रगति क्या है।
क्या आपने कभी सोचा है कि आपके सिस्टम बिना घंटों के मैनुअल हस्तक्षेप के लोगों की बातों को आसानी से समझ सकें, खासकर तब जब ऑडियो का हर एक सेकंड मायने रखता हो? बिल्कुल इसी समय टीमें AI में स्पीच रिकग्निशन खोजना शुरू करती हैं। चाहे बात ऑटोमेशन को बढ़ाना हो, बारीक बातचीत को संभालना हो, या अंततः पहले प्रयास में विश्वसनीय ट्रांसक्रिप्ट प्राप्त करना हो, सटीकता और उत्पादकता दांव पर होने पर स्पीच रिकग्निशन एक रणनीतिक प्राथमिकता बन जाती है।
और बाजार भी प्रतिक्रिया दे रहा है; वैश्विक स्पीच और वॉयस रिकग्निशन बाजार के 2025 में 9.66 बिलियन अमेरिकी डॉलर से बढ़कर 2030 तक लगभग 23.11 बिलियन अमेरिकी डॉलर होने का अनुमान है, जो कि 19.1% की कंपाउंड एनुअल ग्रोथ रेट (CAGR) से बढ़ेगा। यह काफी हद तक रीयल-टाइम ट्रांसक्रिप्शन, वॉयस इंटरफेस और वॉयस-सक्षम ऑटोमेशन समाधानों को अपनाने के कारण संभव होगा।
यदि आप गति, निरंतरता या परिचालन लचीलेपन को बेहतर बनाने के लिए स्पीच रिकग्निशन की तलाश कर रहे हैं, तो आप सही समय पर सही प्रश्न पूछ रहे हैं।
इस गाइड में, हम यह जानेंगे कि स्पीच रिकग्निशन कैसे काम करता है, इसके मुख्य घटक, वास्तविक दुनिया के अनुप्रयोग और प्रोडक्शन में इसे अपनाते समय किन बातों का ध्यान रखना चाहिए।
मुख्य बातें
न्यूरल आर्किटेक्चर ASR सटीकता को बढ़ाते हैं: आधुनिक ASR विभिन्न डोमेन में उच्च-सटीकता वाले ट्रांसक्रिप्शन के साथ विलंबता को संतुलित करने के लिए CTC, RNN-T और ट्रांसफॉर्मर मॉडल का उपयोग करता है।
रीयल-टाइम ASR मिलीसेकंड के भीतर प्रतिक्रिया देता है: स्ट्रीमिंग पाइपलाइन हर कुछ मिलीसेकंड में आंशिक टोकन उत्सर्जित करती हैं, जिससे 300 ms के भीतर मंशा का पता लगाना संभव हो जाता है।
टेलीफोनी ऑडियो रिकग्निशन संबंधी चुनौतियां पैदा करता है: VoIP संपीड़न और पृष्ठभूमि का शोर फोनेम्स (ध्वनियों) को विकृत कर देता है, जिससे वास्तविक बातचीत में प्रतिस्थापन और विलोपन त्रुटियां बढ़ जाती हैं।
नियतात्मक सामान्यीकरण डेटा अखंडता की रक्षा करता है: सामान्य सामान्यीकरण संरचित फ़ील्ड को तोड़ देता है; ASR को तारीखों, राशियों और अक्षरांकीय (अल्फान्यूमेरिक) मानों के लिए नियम-आधारित पुनर्लेखन की आवश्यकता होती है।
ASR 100 ms से कम की विलंबता की ओर बढ़ रहा है: भविष्य के सिस्टम गति और अनुपालन के लिए अल्ट्रा-लो लेटेंसी, मल्टीमॉडल सिग्नल और ऑन-डिवाइस अनुमान को लक्षित करते हैं।
AI में स्पीच रिकग्निशन क्या है?
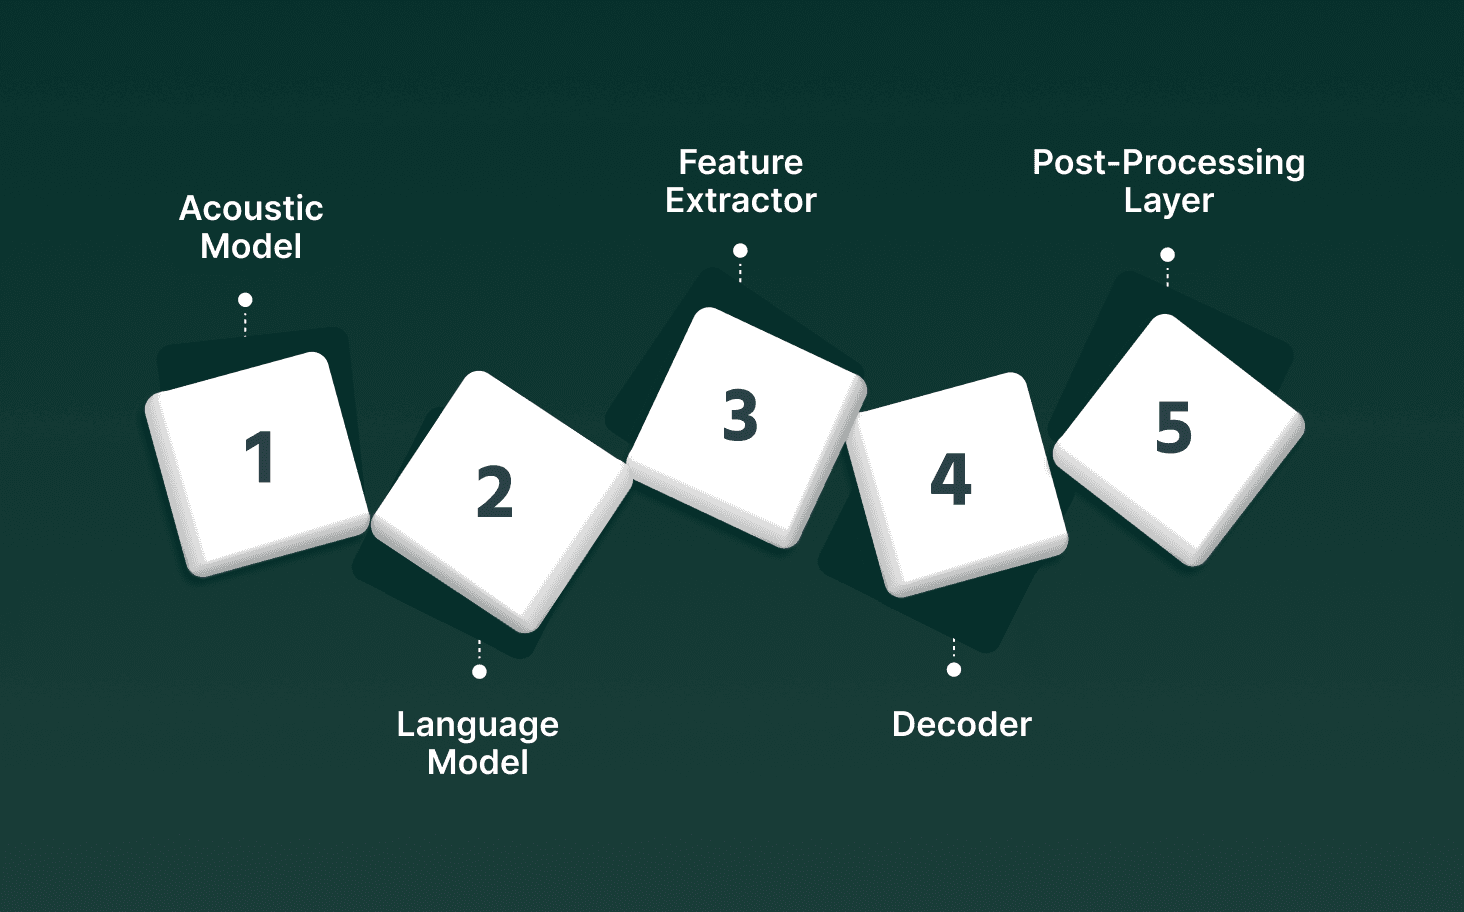
AI में स्पीच रिकग्निशन से तात्पर्य उन प्रणालियों से है जो बोली जाने वाली भाषा को विभिन्न लहजों, शोर की स्थितियों और रीयल-टाइम वातावरण में उच्च सटीकता के साथ मशीन-पठनीय पाठ में परिवर्तित करती हैं। आधुनिक आर्किटेक्चर न्यूरल एकूस्टिक मॉडल, बड़े पैमाने के भाषा मॉडल और स्ट्रीमिंग इंफ्रेंस पाइपलाइनों पर निर्भर करते हैं जो संपर्क केंद्रों, वॉयस ऑटोमेशन और एंटरप्राइज़ वर्कफ़्लो के लिए तत्काल ट्रांसक्रिप्शन का समर्थन करते हैं।
मुख्य घटक
एकूस्टिक मॉडल (Acoustic Model): बड़े बहुभाषी डेटासेट पर प्रशिक्षित CNN, RNN-T, या ट्रांसफॉर्मर एनकोडर का उपयोग करके कच्चे तरंग रूपों को फोनेम्स के संभाव्यता वितरण में परिवर्तित करता है।
भाषा मॉडल (Language Model): प्रतिस्थापन और प्रविष्टि त्रुटियों को कम करने के लिए संदर्भ के आधार पर शब्द अनुक्रमों की भविष्यवाणी करता है, अक्सर डोमेन-विशिष्ट शब्दावली के लिए अनुकूलित ट्रांसफॉर्मर एलएम का उपयोग करता है।
फीचर एक्सट्रैक्टर (Feature Extractor): MFCC, लॉग-मेल स्पेक्ट्रोग्राम, या स्ट्रीमिंग एम्बेडिंग उत्पन्न करता है जो सटीक फोनेम भविष्यवाणी के लिए अस्थायी विवरण को सुरक्षित रखता है।
डिकोडर (Decoder): सटीकता के साथ विलंबता को संतुलित करते हुए, CTC, RNN-T, या ध्यान-आधारित डिकोडिंग के माध्यम से संभावित टेक्स्ट अनुक्रमों के साथ एकूस्टिक आउटपुट को संरेखित करता है।
पोस्ट-प्रोसेसिंग लेयर (Post-Processing Layer): प्रोडक्शन के लिए तैयार टेक्स्ट तैयार करने के लिए विराम चिह्न, संख्या स्वरूपण, अपशब्द फ़िल्टर, डायरीकरण टैग और डोमेन-विशिष्ट प्रतिस्थापन लागू करता है।
AI में स्पीच रिकग्निशन एक सटीक, मॉडल-संचालित पाइपलाइन के रूप में काम करता है जिसे एंटरप्राइज़ वातावरण में सटीकता, गति और डोमेन जागरूकता के साथ लाइव या रिकॉर्ड किए गए भाषण को संरचित पाठ में बदलने के लिए बनाया गया है।
AI में स्पीच रिकग्निशन की मुख्य विशेषताएं
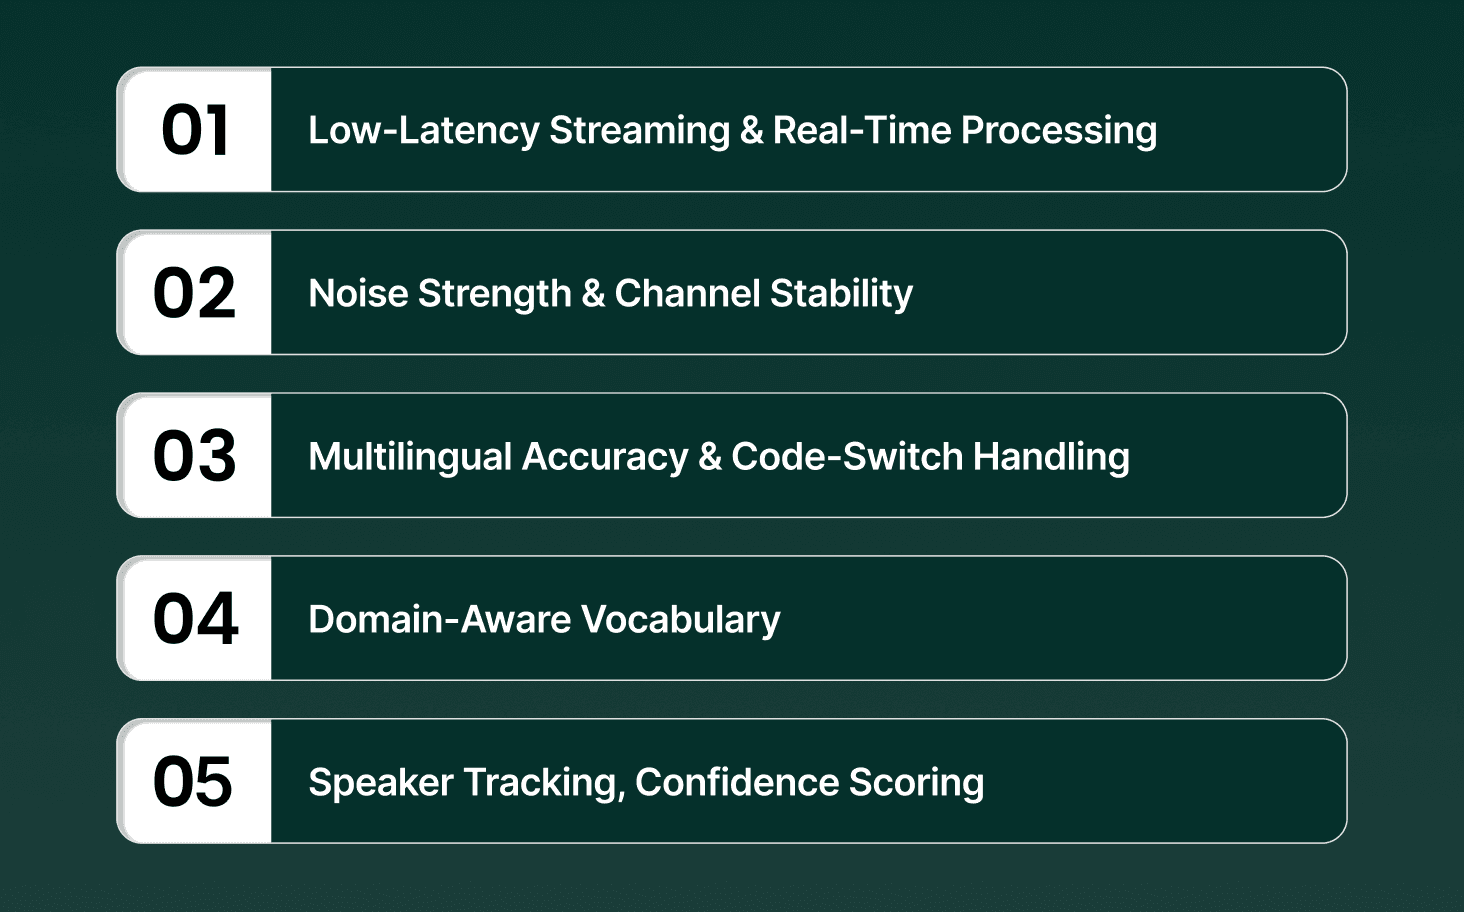
स्पीच रिकग्निशन सिस्टम को बैकग्राउंड के शोर, उच्चारण में बदलाव, चैनल विरूपण और रीयल-टाइम विलंबता आवश्यकताओं जैसी परिवर्तनशील परिस्थितियों में सटीकता के साथ बड़े पैमाने पर ऑडियो संसाधित करने के लिए बनाया गया है। आधुनिक इंजन एंटरप्राइज़ वर्कलोड में ट्रांसक्रिप्ट को स्थिर रखने के लिए न्यूरल एनकोडर, डोमेन-विशिष्ट भाषा मॉडल और अनुकूली सामान्यीकरण पाइपलाइनों का उपयोग करते हैं।
कम-विलंबता स्ट्रीमिंग और रीयल-टाइम प्रोसेसिंग: हर कुछ मिलीसेकंड में उत्सर्जित आंशिक परिकल्पनाओं के साथ ट्रांसक्रिप्शन का समर्थन करता है, जिससे लाइव रूटिंग, एजेंट क्रियाएं और तत्काल वर्कफ़्लो ट्रिगर संभव होते हैं।
शोर प्रतिरोध और चैनल स्थिरता: संवर्द्धन तकनीकों और शोर-प्रशिक्षित एकूस्टिक मॉडलों का उपयोग करके वीओआईपी संपीड़न, हैंडसेट विरूपण, दूर-क्षेत्र के माइक और पृष्ठभूमि के शोर में सटीकता बनाए रखता है।
बहुभाषी सटीकता और कोड-स्विच हैंडलिंग: विविध भाषण पैटर्नों के लिए उपयुक्त मिश्रित-टोकन शब्दावली और संयुक्त एकूस्टिक मॉडलिंग के माध्यम से एक ही उच्चारण के भीतर त्वरित भाषा परिवर्तन को संसाधित करता है।
डोमेन-जागरूक शब्दावली और संरचित आउटपुट स्वरूपण: डोमेन-भारी शब्दों (आईडी, SKU कोड, दवा के नाम) को पहचानता है और ऑटोमेशन-तैयार टेक्स्ट के लिए सुसंगत विराम चिह्न, तिथियां और संख्यात्मक स्वरूपण लागू करता है।
स्पीकर ट्रैकिंग, विश्वसनीयता स्कोरिंग और स्केलेबल आर्किटेक्चर: डायरीकरण के माध्यम से वक्ताओं को अलग करता है, सत्यापन तर्क के लिए टोकन-स्तरीय विश्वसनीयता स्कोर निर्दिष्ट करता है, और GPU या मिश्रित-परिशुद्धता अनुमान के माध्यम से उच्च-समवर्ती वर्कलोड का समर्थन करता है।
AI में स्पीच रिकग्निशन सटीक, विलंबता-जागरूक प्रसंस्करण पर केंद्रित है जो डोमेन, भाषाओं और वास्तविक दुनिया की एकूस्टिक स्थितियों में भाषण को विश्वसनीय रूप से संरचित पाठ में परिवर्तित करता है।
यह देखने के लिए कि स्पीच रिकग्निशन स्वचालित कॉलिंग प्रणालियों से कैसे जुड़ता है, पढ़ें AI फोन एजेंट क्या हैं और वे कैसे काम करते हैं।
AI में स्पीच रिकग्निशन के शीर्ष उपयोग के मामले
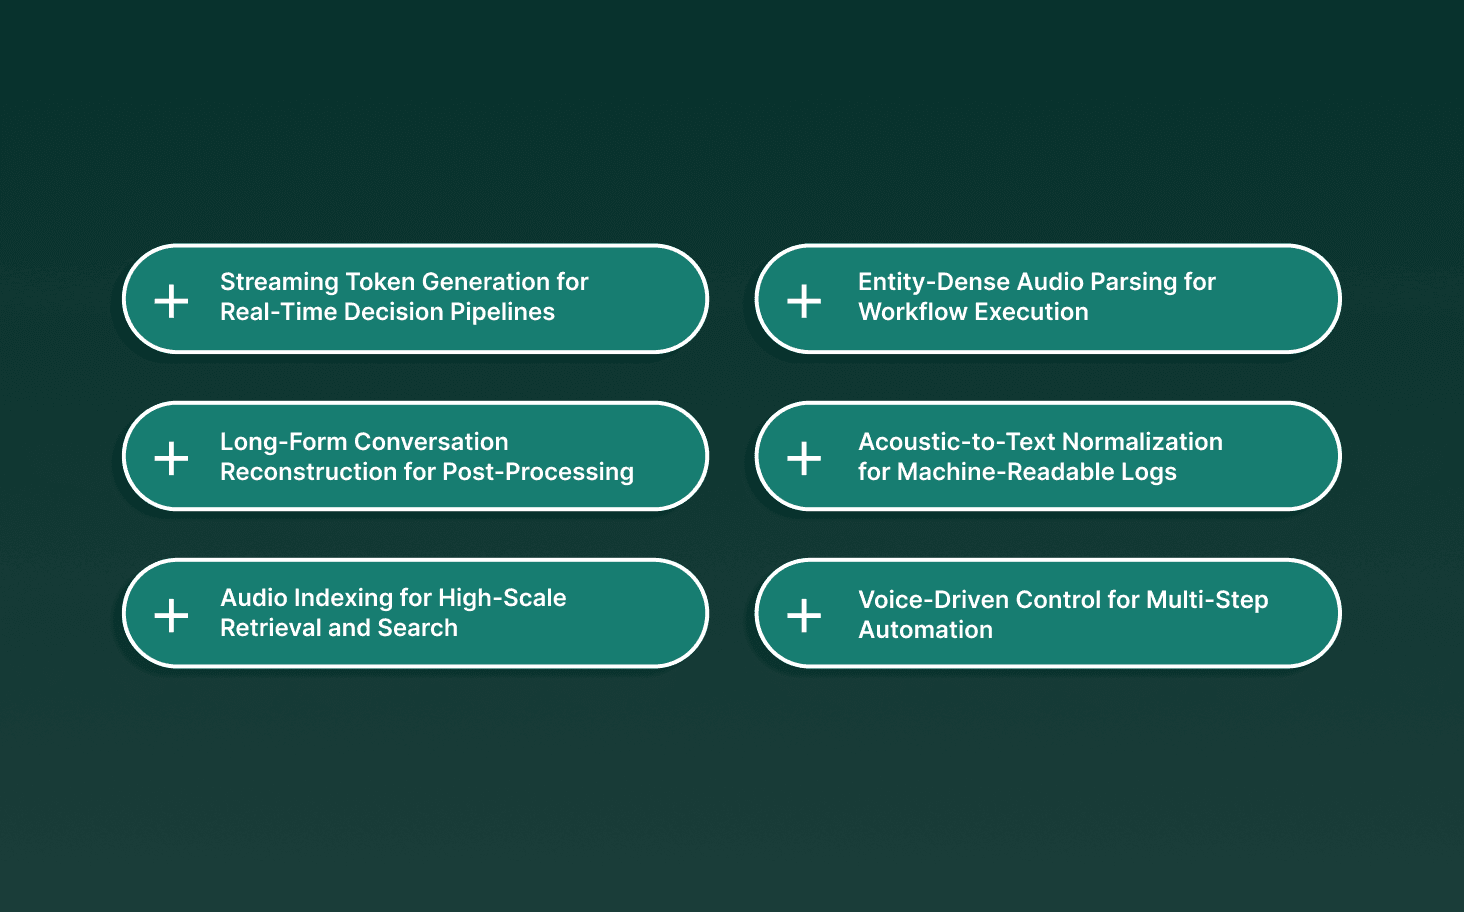
स्पीच रिकग्निशन उन प्रणालियों का समर्थन करता है जो समय-संरेखित टोकन स्ट्रीम, स्थिर इकाई निष्कर्षण, नियतात्मक स्वरूपण और दीर्घ-संदर्भ पुनर्निर्माण पर निर्भर करती हैं। ये उपयोग के मामले दर्शाते हैं कि ASR ऑटोमेशन इंजन, LLM पाइपलाइन और ऑडियो-प्रोसेसिंग बुनियादी ढांचे के भीतर कैसे काम करता है।
1. रीयल-टाइम निर्णय पाइपलाइनों के लिए स्ट्रीमिंग टोकन जनरेशन
ASR हर कुछ मिलीसेकंड में आंशिक परिकल्पना उत्सर्जित करता है ताकि डाउनस्ट्रीम इंजन उच्चारण समाप्त होने से पहले कार्रवाई कर सकें। यह वाक्य के बीच में निर्णय अपडेट करने की अनुमति देता है और रीयल-टाइम प्रणालियों में संदर्भ अंतराल को रोकता है।
लाभ
प्रारंभिक मंशा संकेत: वृद्धिशील पाठ की आपूर्ति करता है जो उपयोगकर्ता के बोलने के दौरान ही रूटिंग या संवाद तर्क को अपडेट करता है।
कम-विलंबता अनुकूलन: लाइव इंटरैक्शन के दौरान गलत संरेखण या मतिभ्रम को रोकने के लिए LLMs को एक निरंतर संदर्भ प्रदान करता है।
स्थिर संरेखण: विश्वसनीय रीयल-टाइम अनुमान के लिए आवश्यक मोनोटोनिक टोकन क्रम को बनाए रखता.
उदाहरण: एक ट्रांसड्यूसर मॉडल भाषण के पहले 300 ms के भीतर "मुझे ट्रांसफर करें..." उत्सर्जित करता है, जिससे वाक्य पूरा होने से पहले सिस्टम को रूटिंग पथ चुनने की अनुमति मिलती है।
2. वर्कफ़्लो निष्पादन के लिए एंटिटी-सघन ऑडियो पार्सिंग
ASR भाषा-मॉडल बहाव के बिना लंबी अंक अनुक्रम, अल्फ़ान्यूमेरिक पहचानकर्ता और टाइमस्टैम्प वाक्यांश जैसे संरचित तत्वों को निकालता है जो डाउनस्ट्रीम ऑटोमेशन को दूषित कर सकते हैं।
लाभ
सटीक स्लॉट भरना: ऑटो-करेक्शन के बिना "A91–B3–77" जैसे संरचित मूल्यों को कैप्चर करता है।
कैनोनिकल आउटपुट: संख्याओं या कोडों के बोले गए रूपों को मशीन-पठनीय रूपों में परिवर्तित करता है।
अस्पष्टता समाधान: विशेषीकृत स्कोरिंग और पुनर्लेखन नियमों का उपयोग करके ध्वनि रूप से समान खंडों में अंतर करता है।
उदाहरण: ASR "four zero zero dash nine delta" को "400ID" जैसे LM-पक्षपाती अनुमान के बजाय "400-9D" के रूप में ट्रांसक्राइब करता है।
3. पोस्ट-प्रोसेसिंग के लिए लंबी बातचीत का पुनर्निर्माण
ASR लंबी बातचीत में सारांश, विषय निष्कर्षण, तर्क ट्रैकिंग और बहु-चरण संदर्भ प्रतिधारण के लिए आवश्यक टाइम-स्टैम्प्ड, वक्ता-सुसंगत ट्रांसक्रिप्ट तैयार करता है।
लाभ
बारी की सटीकता: बातचीत के ओवरलैप होने के दौरान भी वक्ता के अलगाव को बनाए रखता है।
संदर्भ स्थिरता: संदर्भ निरंतरता बनाए रखने के लिए लंबे खंडों में विचलन को कम करता है।
सटीक टाइमस्टैम्पिंग: कालानुक्रमिक तर्क और घटना का पता लगाने का समर्थन करता है।
उदाहरण: ASR 40-मिनट की बातचीत में वक्ता की बारी के अनुसार टोकन संरेखित करता है, जिससे LLM को सही वक्ता को प्रतिबद्धता या प्रश्न सौंपने की अनुमति मिलती है।
4. मशीन-पठनीय लॉग के लिए एकूस्टिक-टू-टेक्स्ट सामान्यीकरण
ASR आउटपुट को नियतात्मक प्रारूपों में सामान्यीकृत किया जाता है, विशेष रूप से अंकों, तारीखों और प्रतीकों के लिए, ताकि ऑटोमेशन सिस्टम उन्हें विश्वसनीय रूप से ग्रहण और परिवर्तित कर सकें।
लाभ
सुसंगत संरचना: "twenty three slash oh four" जैसे रूपों को "23/04" में परिवर्तित करता है।
नियतात्मक पुनर्लेखन: LM-संचालित फ़ॉर्मेटिंग विचलनों से बचाता है जो डाउनस्ट्रीम प्रोसेसिंग को बाधित करते हैं।
संशोधन अनुकूलता: संवेदनशील-डेटा मास्किंग के लिए स्थिर टोकन सीमाएं तैयार करता है।
उदाहरण: सामान्यीकरण संभाव्य अनुमान के बजाय पूर्वनिर्धारित पुनर्लेखन नियमों का उपयोग करके "पांच सौ छह डॉलर" को "$506.00" से मैप करता है।
5. उच्च-पैमाने की पुनर्प्राप्ति और खोज के लिए ऑडियो अनुक्रमण
ASR लंबे ऑडियो को टाइमस्टैम्प संरेखण के साथ खोजने योग्य पाठ धाराओं में बदल देता है, जिससे बड़े डेटासेट में वाक्यांश-स्तरीय नेविगेशन और पुनर्प्राप्ति की अनुमति मिलती है।
लाभ
उच्च-रिकॉल खोजने की क्षमता: घंटों के ऑडियो में सटीक और सिमेंटिक वाक्यांश पुनर्प्राप्ति का समर्थन करता है।
टाइमस्टैम्प लिंकिंग: किसी भी टोकन से जुड़े सटीक ऑडियो क्षण को तुरंत चलाने की अनुमति देता है।
हाइब्रिड एम्बेडिंग उपयोग: मजबूत मिलान के लिए टेक्स्ट टोकन और एकूस्टिक वैक्टर को जोड़ता है।
उदाहरण: एक पुनर्प्राप्ति प्रणाली "सीमा पार हो गई" वाक्यांश की हर घटना को सामने लाती है और ASR टाइमस्टैम्प का उपयोग करके ऑडियो में प्रत्येक सटीक क्षण को खोलती है।
6. बहु-चरण ऑटोमेशन के लिए वॉयस-संचालित नियंत्रण
ASR बहु-पैरामीटर बोले गए आदेशों, सुधारों और श्रृंखलाबद्ध चरणों की व्याख्या करता है, जिससे सरल एक-चरण क्रियाओं के बजाय जटिल वर्कफ़्लो संभव होते हैं।
लाभ
पैरामीटर निष्कर्षण: एक ही उच्चारण में बहु-भाग निर्देशों की पहचान करता है।
अस्पष्टता हैंडलिंग: पहले के खंडों पर गलत कार्रवाई किए बिना सुधारों की व्याख्या करता है।
विश्वसनीयता गेटिंग: जब ASR निश्चितता थ्रेसहोल्ड से नीचे गिरती है तो निष्पादन को रोकता है।
उदाहरण: "प्रविष्टि बनाएं, तत्काल टैग करें, नोट जोड़ें: दो दिनों में अनुवर्ती कार्रवाई" कमांड को पैरामीटर सीमाओं को सुरक्षित रखते हुए तीन अलग-अलग सिस्टम क्रियाओं में पार्स किया जाता है।
ये उपयोग के मामले दिखाते हैं कि कैसे स्पीच रिकग्निशन सटीक, समय-संरेखित और संरचनात्मक रूप से विश्वसनीय आउटपुट प्रदान करता है जो रीयल-टाइम निर्णय प्रणालियों, पुनर्प्राप्ति इंजनों, ऑटोमेशन वर्कफ़्लो और दीर्घ-संदर्भ AI तर्क को सक्षम बनाता है।
देखें कि कैसे Smallest.ai सटीक बहुभाषी पहचान, त्रुटिहीन संख्यात्मक हैंडलिंग और वास्तविक संचालन के लिए निर्मित बड़े पैमाने पर वॉयस ऑटोमेशन प्रदान करता है। आज ही डेमो प्राप्त करें।
ASR तकनीक के बारे में क्या जानना चाहिए
ऑटोमैटिक स्पीच रिकग्निशन (ASR) तकनीक न्यूरल आर्किटेक्चर पर निर्भर करती है जो सख्त विलंबता, सटीकता और स्केलेबिलिटी आवश्यकताओं के साथ निरंतर ऑडियो संकेतों को संरचित पाठ में परिवर्तित करती है। आधुनिक ASR इंजन एंटरप्राइज़ वर्कफ़्लो का समर्थन करने के लिए अप्रत्याशित भाषण पैटर्न, एकूस्टिक परिवर्तनशीलता और डोमेन-विशिष्ट भाषा बाधाओं को संभालने पर ध्यान केंद्रित करते हैं।
सटीकता और विलंबता के लिए मुख्य मॉडल आर्किटेक्चर: ASR CTC, RNN-Transducer, और ट्रांसफॉर्मर एनकोडर-डिकोडर मॉडल का उपयोग करता है, जिनमें से प्रत्येक को स्ट्रीमिंग और ऑफ़लाइन ट्रांसक्रिप्शन में विभिन्न विलंबता-सटीकता समझौतों के लिए अनुकूलित किया गया है।
डेटा विविधता और टोकनाइजेशन मॉडल प्रदर्शन को आकार देते हैं: सटीकता बड़े, विविध डेटासेट (लहजे, बोलने की दर, उपकरण, शोर) और सबवर्ड टोकनाइजेशन विधियों जैसे BPE या यूनीग्राम मॉडल पर निर्भर करती है जो बहुभाषी लिपियों का समर्थन करते हैं।
स्ट्रीमिंग बनाम गैर-स्ट्रीमिंग इंफ्रेंस मोड: स्ट्रीमिंग ASR वास्तविक समय में क्रमिक ट्रांसक्रिप्ट उत्पन्न करता है, जबकि गैर-स्ट्रीमिंग ASR उच्च सटीकता और दीर्घ-संदर्भ स्थिरता के लिए पूर्ण ऑडियो खंडों को संसाधित करता है।
सामान्यीकरण, स्वरूपण और डोमेन मैपिंग: ASR पाइपलाइनें डाउनस्ट्रीम ऑटोमेशन के लिए आवश्यक संरचित रूपों में बोली जाने वाली तिथियों, संख्याओं, मुद्राओं और अल्फ़ान्यूमेरिक्स को बदलने के लिए नियतात्मक नियमों पर निर्भर करती हैं।
विश्वसनीयता बाधाएं: विलंबता, एकूस्टिक परिवर्तनशीलता और मूल्यांकन मेट्रिक्स
मॉडल को 300-500 ms एंड-टू-एंड विलंबता के तहत काम करना चाहिए, कोडेक संपीड़न या प्रतिध्वनि जैसे विकृतियों को संभालना चाहिए, और WER, CER, और इकाई-विशिष्ट सटीकता मेट्रिक्स का उपयोग करके मापा जाना चाहिए।
ASR तकनीक वास्तविक दुनिया की ऑडियो स्थितियों में सटीक, संरचित पाठ आउटपुट का उत्पादन करने के लिए आर्किटेक्चर डिज़ाइन, डेटासेट विविधता, विलंबता नियंत्रण और डोमेन-जागरूक प्रसंस्करण को जोड़ती है।
AI में स्पीच रिकग्निशन के साथ चुनौतियां
स्पीच रिकग्निशन सिस्टम सख्त सटीकता, विलंबता और सुदृढ़ता आवश्यकताओं के तहत काम करते हैं। चुनौतियां अक्सर वास्तविक दुनिया की टेलीफोनी स्थितियों, मिश्रित-भाषा भाषण, डोमेन-सघन शब्दावली और ऐसे वातावरण में सतह पर आती हैं जहां डाउनस्ट्रीम ऑटोमेशन के लिए स्वरूपण परिशुद्धता महत्वपूर्ण होती है।
चुनौती | क्या इसे कठिन बनाता है | वास्तविक परिनियोजन में प्रभाव |
टेलीफोनी संपीड़न और शोर | VoIP कोडेक्स (G.711, Opus) उच्च-आवृत्ति संकेतों को विकृत करते हैं; पृष्ठभूमि का शोर फोनेम्स को छुपा देता है। | सपोर्ट कॉल या IVR रूटिंग के दौरान उच्च प्रतिस्थापन और विलोपन त्रुटियां। |
उच्चारण, बोलियाँ और बोलने की परिवर्तनशीलता | उच्चारण, गति और लय में त्वरित बदलाव के लिए विविध एकूस्टिक कवरेज की आवश्यकता होती है। | मॉडल खाता संख्या, आइटम नाम या दवा की शर्तों जैसी डोमेन संस्थाओं की गलत व्याख्या करते हैं। |
कोड-स्विचिंग (भाषा मिश्रण) | मिश्रित-भाषा के उच्चारण एकभाषी टोकन भविष्यवाणी पैटर्न को तोड़ते हैं। | बहुभाषी क्षेत्रों में आंशिक ट्रांसक्रिप्ट या छूटे हुए शब्द आम हैं। |
डोमेन-भारी शब्दावली | पॉलिसी आईडी, SKU सूचियां, अल्फ़ान्यूमेरिक स्ट्रिंग्स और चिकित्सा शब्द सामान्य कॉर्पोरा से बाहर होते हैं। | पहचानकर्ताओं, नियामक बयानों और परिचालन निर्देशों का गलत प्रतिपादन। |
अत्यधिक-सामान्यीकरण | सामान्य सामान्यीकरण नियम संरचित डेटा (तारीखें, शुल्क, दावा कोड) को विकृत करते हैं। | डाउनस्ट्रीम सिस्टम असंगत या अनुपयोगी पाठ प्राप्त करते हैं। |
रीयल-टाइम विलंबता बाधाएं | स्ट्रीमिंग ASR को 200–500 ms के भीतर आंशिक परिकल्पना उत्पन्न करनी होगी। | धीमी ट्रांसक्रिप्ट लाइव एजेंट सहायता, कॉल रूटिंग या स्वचालित क्रियाओं को अवरुद्ध करती हैं। |
स्पीच रिकग्निशन को सिग्नल की गुणवत्ता, भाषाई परिवर्तनशीलता, डोमेन विशिष्टता और विलंबता के दबावों से जुड़ी चुनौतियों का सामना करना पड़ता है, जिनमें से सभी को सटीक, उत्पादन-ग्रेड एंटरप्राइज़ उपयोग के लिए संबोधित किया जाना चाहिए।
यदि आप यह तलाश कर रहे हैं कि वॉयस तकनीक आपके वर्कफ़्लो में कैसे फिट होती है, तो अगला कदम उठाएं और पढ़ें यह समझना कि टेक्स्ट-टू-स्पीच क्या है और यह कैसे काम करता है।
AI में स्पीच रिकग्निशन के उद्योग उदाहरण
स्पीच रिकग्निशन उन क्षेत्रों का समर्थन करता है जो उच्च मात्रा में ऑडियो स्ट्रीम, विनियमित संचार, संरचित डेटा कैप्चर और रीयल-टाइम इंटरैक्शन पर निर्भर करते हैं। इसे अपनाने के मुख्य केंद्र टेलीफोनी, अनुपालन संचालन, स्वास्थ्य सेवा प्रलेखन, प्रमाणीकरण और ऐसे क्षेत्र वातावरण हैं जहां मैन्युअल ट्रांसक्रिप्शन व्यावहारिक नहीं है।
संपर्क केंद्र (कॉन्टैक्ट सेंटर्स): रीयल-टाइम QA, रूटिंग, भावना ट्रैकिंग और स्वचालित सारांश के लिए लाइव कॉल को ट्रांसक्राइब करता है। सिस्टम टेलीफोनी ऑडियो में उच्च सटीकता के साथ पॉलिसी नंबर, ऑर्डर आईडी, खाता सत्यापन वाक्यांश और व्यवधान पैटर्न की पहचान करते हैं।
स्वास्थ्य सेवा (हेल्थकेयर): डोमेन-अनुकूलित शब्दावली का उपयोग करके चिकित्सक के डिक्टेशन, नैदानिक नोट्स, दवा के नाम और प्रक्रिया की शर्तों को कैप्चर करता है। मैन्युअल चार्टिंग पर खर्च होने वाले समय को कम करता है और संरचित EMR प्रविष्टि का समर्थन करता।
वित्तीय सेवाएं: ऑडिट के लिए कॉल लॉगिंग, अनुपालन के लिए कीवर्ड पहचान, और दावों, भुगतान निर्देशों और KYC डेटा के ट्रांसक्रिप्शन का समर्थन करता है। ASR इंजन को संख्याओं और नियामक शर्तों के लिए सख्त सटीकता आवश्यकताओं को संभालना चाहिए।
बीमा (इन्शुरन्स): एडजस्टर नोट्स, क्लेम कॉल और फील्ड रिपोर्ट को खोजने योग्य टेक्स्ट में परिवर्तित करता है। मॉडल कवरेज शर्तों, नुकसान के विवरण और लंबे अल्फ़ान्यूमेरिक अनुक्रमों पर ध्यान केंद्रित करते हैं।
लॉजिस्टिक्स और फील्ड सर्विसेज: तकनीशियनों को कोलाहलपूर्ण बाहरी या गोदाम की स्थितियों में हाथों-मुक्त जॉब नोट्स, उपकरण रीडिंग और निरीक्षण रिपोर्ट बनाने की अनुमति देता है।
रिटेल और ई-कॉमर्स: मिश्रित भाषाओं और विविध ग्राहक लहजों में सहायता कॉल, वॉयस-आधारित ऑर्डर ट्रैकिंग और उत्पाद पूछताछ को ट्रांसक्राइब करता है।
सरकार और सार्वजनिक सुरक्षा: आपातकालीन कॉल, घटना विवरण और रेडियो संचार को संसाधित करता है जहां स्पष्टता, टाइमस्टैम्प सटीकता और वक्ता का अलगाव महत्वपूर्ण होता है।
स्पीच रिकग्निशन उन क्षेत्रों में दिखाई देता है जो संचालन, अनुपालन और रीयल-टाइम निर्णय प्रणालियों का समर्थन करने के लिए सटीक, टाइमस्टैम्प्ड और डोमेन-जागरूक ट्रांसक्रिप्शन पर निर्भर करते हैं।
AI में स्पीच रिकग्निशन का भविष्य
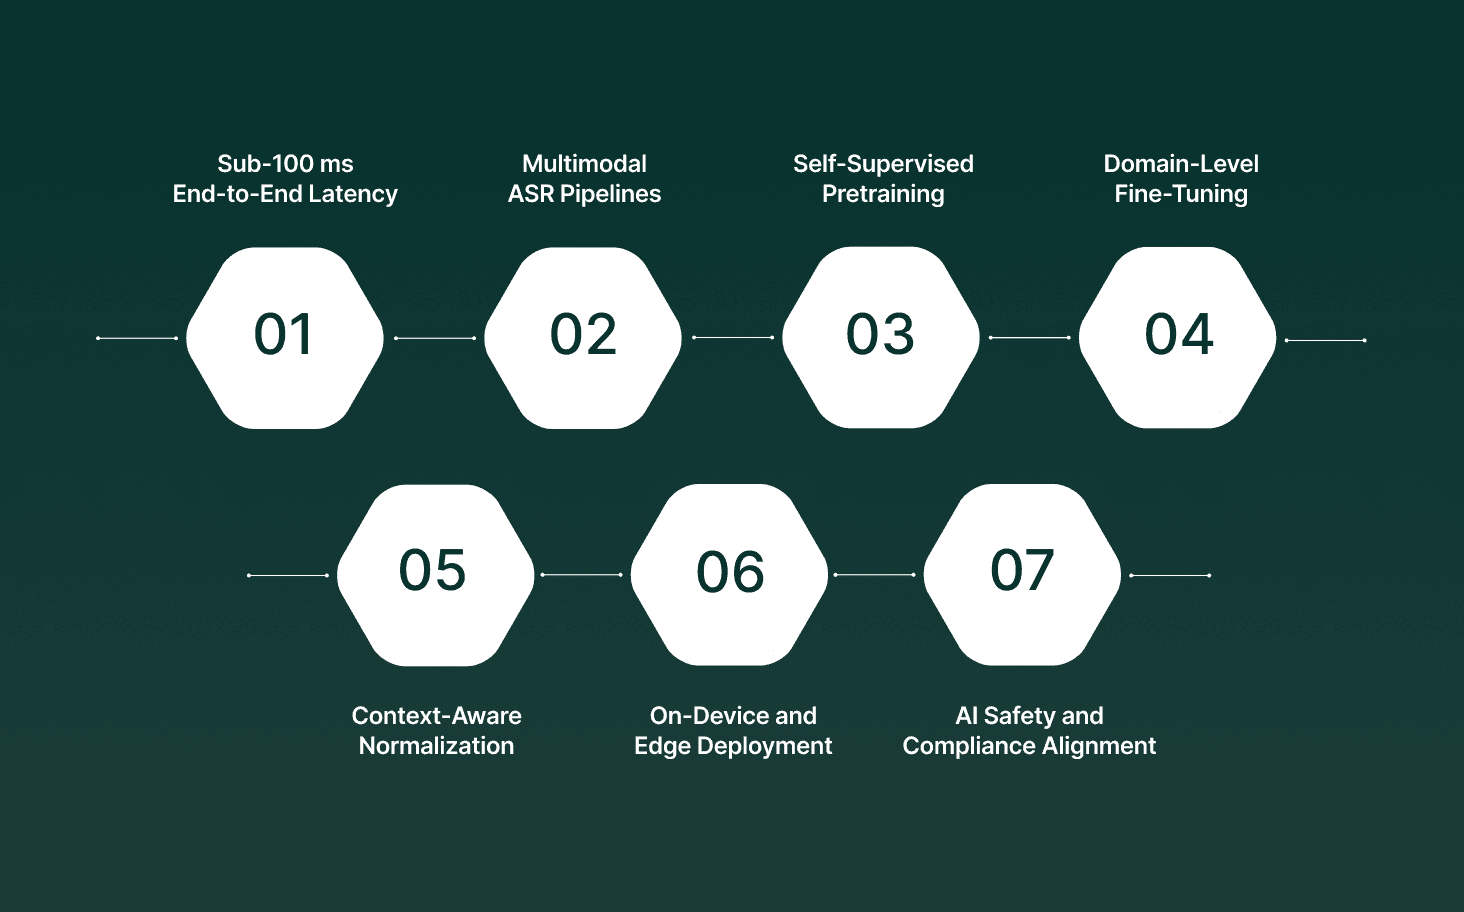
स्पीच रिकग्निशन का अगला चरण अल्ट्रा-लो लेटेंसी मॉडल, डोमेन-अनुकूली प्रशिक्षण पाइपलाइनों और मल्टीमॉडल सिस्टम पर केंद्रित है जो भावना, मंशा और संरचित मेटाडेटा जैसे संदर्भ संकेतों के साथ भाषण की व्याख्या करते हैं।
प्रगति टेलीफोनी शोर, बहुभाषी तरलता, अनुपालन संरेखण और ऑटोमेशन सिस्टम के साथ कड़े एकीकरण के तहत सटीकता पर केंद्रित है।
100 ms से कम की एंड-टू-एंड विलंबता: मॉडल कुछ मिलीसेकंड के भीतर एकूस्टिक एन्कोडिंग, डिकोडिंग और फ़ॉर्मेटिंग को पूरा करेंगे, जिससे रीयल-टाइम एजेंट क्रियाएं, डायनेमिक कॉल रूटिंग और त्वरित वॉयस-संचालित वर्कफ़्लो संभव होंगे।
मल्टीमॉडल ASR पाइपलाइनें: भविष्य के इंजन अस्पष्टता को कम करने के लिए ऑडियो, टेक्स्ट इतिहास, मेटाडेटा और डोमेन ग्राफ़ को जोड़ेंगे, जिससे क्लेम नंबर, दवा कोड या उत्पाद SKU जैसी इकाई-सघन बातचीत की पहचान में सुधार होगा।
बड़े पैमाने पर स्व-पर्यवेक्षित प्री-ट्रेनिंग: बड़ी ऑडियो-टेक्स्ट प्री-ट्रेनिंग ASR प्रणालियों को कम लेबल वाले डेटासेट के साथ अनदेखे लहजों, कम संसाधन वाली भाषाओं और स्वाभाविक भाषण में सामान्यीकरण करने की अनुमति देगी।
डोमेन-स्तरीय फाइन-ट्यूनिंग: उद्यम पूर्ण मॉडल के बजाय हल्के एडेप्टर को प्रशिक्षित करेंगे, जिससे नई शब्दावली, नियामक भाषा, या मौसमी शब्दावली बदलावों के लिए त्वरित अपडेट की अनुमति मिलेगी।
संदर्भ-जागरूक सामान्यीकरण: ASR आउटपुट उद्योग के संदर्भ के आधार पर स्वचालित रूप से फ़ॉर्मेटिंग नियमों को लागू करेंगे, जैसे कि बोले गए टैक्स आईडी, पॉलिसी अनुक्रम, या खुराक निर्देशों को मानकीकृत लिखित रूपों के साथ बदलना।
ऑन-डिवाइस और एज डिप्लॉयमेंट: छोटे क्वांटाइज़्ड मॉडल टेलीफ़ोनी गेटवे, कियोस्क या हैंडहेल्ड डिवाइस पर चलेंगे जहाँ गोपनीयता, गति या नियामक बाधाओं के लिए स्थानीय डेटा की आवश्यकता होती है।
AI सुरक्षा और अनुपालन संरेखण: ऑडिट और गवर्नेंस मानकों को पूरा करने के लिए सिस्टम संपादन, पूर्वाग्रह की जांच और स्वचालित विसंगति का पता लगाने (जैसे वित्तीय या चिकित्सा संदर्भों में गलत सुनी गई संख्याएं) को एकीकृत करेंगे।
स्पीच रिकग्निशन विलंबता-मुक्त अनुमान, डोमेन-जागरूक सटीकता और मल्टीमॉडल इंटेलिजेंस की ओर बढ़ रहा है जो परिचालन वातावरण में सटीक, अनुपालन और रीयल-टाइम ऑटोमेशन का समर्थन करता है।
Smallest.ai स्पीच रिकग्निशन क्षमताओं को कैसे मजबूत करता है
Smallest.ai बड़े पैमाने पर कॉल हैंडलिंग, ऑन-प्रिमाइसेस परिनियोजन और उद्यम सुरक्षा आवश्यकताओं के लिए निर्मित रीयल-टाइम, बहुभाषी, इकाई-सटीक वॉयस ऑटोमेशन का समर्थन करके स्पीच रिकग्निशन को मजबूत करता है। इसके वॉयस एजेंट जटिल वर्कफ़्लो, संख्यात्मक-भारी भाषण और विविध लहजों में उच्च स्थिरता के साथ काम करते हैं, जिससे डाउनस्ट्रीम ऑटोमेशन के लिए ASR आउटपुट अधिक विश्वसनीय हो जाते हैं।
मुख्य विशेषताएं
कस्टम प्रशिक्षित वॉयस एजेंट: विशेषज्ञ वातावरण में विश्वसनीयता बढ़ाते हुए, डोमेन-विशिष्ट शब्दों, संख्यात्मक पैटर्न और बार-बार होने वाले वाक्यांशों की पहचान को बेहतर बनाने के लिए मॉडल आपके डेटा के अनुकूल बनाए जाते हैं।
ऑन-प्रिमाइसेस डिप्लॉयमेंट: आपके हार्डवेयर पर ASR और एजेंट मॉडल चलाने का समर्थन करता है, जिससे अनुमान नियंत्रण, कम विलंबता और अनुपालन या डेटा निवास आवश्यकताओं के साथ सख्त संरेखण की अनुमति मिलती है।
उच्च-मात्रा समवर्ती: समानांतर ऑडियो स्ट्रीम में ट्रांसक्रिप्ट स्थिरता और समय की सटीकता बनाए रखते हुए, एक साथ हजारों कॉलों को प्रबंधित करने के लिए निर्मित।
संख्यात्मक सटीकता की गारंटी: वॉयस मॉडल को उच्च सटीकता के साथ अंक अनुक्रम, क्रेडिट कार्ड, फोन नंबर और बहु-भाग कोड को संभालने के लिए इंजीनियर किया गया है, जिससे प्रतिस्थापन या फ़ॉर्मेटिंग त्रुटियां कम से कम होती हैं।
बहुभाषी पहचान: 16+ वैश्विक भाषाओं में भाषण को समझने का समर्थन करता है, जिससे लहजे, मिश्रित-भाषा वाक्यांशों और क्षेत्रीय उच्चारण भिन्नताओं के लिए सटीक ASR की अनुमति मिलती है।
जटिल वर्कफ़्लो हैंडलिंग: एजेंट सैकड़ों पूर्वनिर्धारित कॉर्नर मामलों को संसाधित करते हैं, जिससे ट्रांसक्रिप्ट निरंतरता में सुधार होता है और लंबे, शाखायुक्त संवादात्मक प्रवाह में गलत व्याख्या कम होती है।
एनालिटिक्स और मूल्यांकन परत: विस्तृत इंटरैक्शन लॉग और प्रदर्शन अंतर्दृष्टि प्रदान करता है, जिससे ASR सटीकता, इकाई स्थिरता और बारी-बारी व्यवहार की व्यवस्थित समीक्षा की अनुमति मिलती है।
डेवलपर SDK: Python, Node.js, और REST APIs कस्टम इंफ्रास्ट्रक्चर ओवरहेड के बिना सीधे टेलीफोनी या बैकएंड सिस्टम में स्पीच पाइपलाइनों को एकीकृत करते हैं।
Smallest.ai सटीक संख्यात्मक हैंडलिंग, स्केलेबल रीयल-टाइम प्रदर्शन, बहुभाषी सटीकता और उद्यम-ग्रेड परिनियोजन और सुरक्षा नियंत्रणों द्वारा समर्थित अनुकूलन योग्य वर्कफ़्लो व्यवहार प्रदान करके स्पीच रिकग्निशन को मजबूत करता है।
निष्कर्ष
AI में स्पीच रिकग्निशन उन टीमों के लिए एक बुनियादी परत बनता जा रहा है जो बिना स्क्रिप्ट वाले भाषण की सटीक, रीयल-टाइम व्याख्या पर भरोसा करती हैं। अब जो सबसे ज्यादा मायने रखता है वह है नियंत्रित सेटिंग्स में आदर्श सटीकता के बजाय वास्तविक परिस्थितियों, मिश्रित लहजे, संख्यात्मक अनुक्रम, शोर और उच्च मात्रा के वर्कलोड के तहत ट्रांसक्रिप्ट की स्थिरता।
यदि आपकी टीम विश्वसनीयता और ऑटोमेशन की गुणवत्ता को मजबूत करने के तरीकों की तलाश कर रही है, तो परिचालन गहराई के लिए इंजीनियर किए गए प्लेटफ़ॉर्म के माध्यम से AI में स्पीच रिकग्निशन को अपनाना एक मापने योग्य अंतर ला सकता है। Smallest.ai सटीकता, पैमाने और बहुभाषी प्रदर्शन के लिए निर्मित वॉयस एजेंट और बुनियादी ढांचा प्रदान करता है।
देखें कि कैसे Smallest.ai आपके स्पीच वर्कफ़्लो का समर्थन कर सकता है। आज ही डेमो प्राप्त करें।
AI में स्पीच रिकग्निशन के बारे में अक्सर पूछे जाने वाले प्रश्न (FAQs)
1. स्पीच रिकग्निशन में AI एक दूसरे के ऊपर बोलने वाले वक्ताओं को कैसे संभालता है?
अधिकांश प्रणालियाँ डायरीकरण मॉडल का उपयोग करती हैं जो स्पीकर एम्बेडिंग बनाती हैं, जिससे स्पीच रिकग्निशन में AI एक साथ बात करते समय भी आवाज़ों को अलग कर सकता है।
2. क्या स्पीच रिकग्निशन AI उपयोगकर्ता की आवाज़ में अनिश्चितता या झिझक का पता लगा सकता है?
हाँ। आधुनिक मॉडल पॉज़, पिच परिवर्तन और लंबे अक्षरों जैसे एकूस्टिक संकेतों को ट्रैक करते हैं, जो डाउनस्ट्रीम प्रणालियों को झिझक या अनिश्चितता की व्याख्या करने में मदद करते हैं।
3. क्या स्पीच रिकग्निशन AI के उदाहरण डेटा में प्रशिक्षण के दौरान शोर या विकृत ऑडियो शामिल होता है?
उच्च गुणवत्ता वाले डेटासेट में जानबूझकर पृष्ठभूमि का शोर, प्रतिध्वनि और कोडेक कलाकृतियां शामिल की जाती हैं ताकि मॉडल वास्तविक टेलीफोनी स्थितियों में विश्वसनीय रूप से प्रदर्शन करें।
4. AI स्पीच रिकग्निशन कार्यों में लंबी संख्याओं या कोडों को गलत पढ़ने से कैसे रोकता है?
विशेषीकृत स्कोरिंग नियम, बाधित डिकोडिंग और पोस्ट-प्रोसेसिंग लेयर्स अंक-सघन उच्चारणों में ऑटो-करेक्शन बहाव को कम करते हैं।
5. वास्तविक दुनिया का स्पीच रिकग्निशन AI उदाहरण क्या है जिसमें बातचीत को ट्रांसक्राइब करना शामिल नहीं है?
एक मजबूत उदाहरण कमांड पार्सिंग है: AI "फ़ाइल खोलें, उसका नाम बदलें, फिर उसे आर्काइव करें" जैसे बहु-चरण बोले गए निर्देशों की व्याख्या करता है, जो अनुक्रमिक स्वचालित क्रियाओं को ट्रिगर करता है।