संयुक्त ब्लॉकफ़्लोट8 क्वांटाइजेशन और कम-परिशुद्धता अंकगणित (reduced-precision arithmetic) के तहत उच्च गुणवत्ता वाले स्पीच सिंथिसिस प्रदान करने वाला दुनिया का पहला टीटीएस (TTS) मॉडल।
मुख्य विशेषताएं
NVIDIA L40S की तुलना में 4 गुना कम ऑन-प्रिमाइसेस (on-prem) इन्फ्रेंस लागत
समान सिस्टम लागत पर लगभग 3.6 गुना अधिक प्रभावी कंप्यूट थ्रूपुट, जिससे लगभग 4 गुना अधिक कन्करेंसी (concurrency) संभव होती है
95% से अधिक लेयर्स LoFi कम्प्यूटेशनल फिडेलिटी में चल रही हैं, बिना किसी मापने योग्य ऑडियो गिरावट के
80% से अधिक मॉडल BlockFloat8 (BFP8) में डिप्लॉय किया गया है
BFP8 के माध्यम से मॉडल के आकार में लगभग 2 गुना कमी
आक्रामक न्यूमेरिकल ऑप्टिमाइज़ेशन के बावजूद शून्य श्रव्य आर्टिफैक्ट्स (audible artifacts)
Lightning V2 दुनिया का पहला ऐसा TTS मॉडल है जो प्रोडक्शन ऑडियो क्वालिटी पर कम्प्यूटेशनल फिडेलिटी और BlockFloat8 को कंबाइन करता है
टेक्स्ट-टू-स्पीच (TTS) क्यों LLMs या इमेज मॉडल्स की तुलना में संख्यात्मक रूप से अधिक नाजुक है
टेक्स्ट-टू-स्पीच बुनियादी रूप से LLMs की तुलना में संख्यात्मक रूप से अधिक नाजुक है क्योंकि यह डिस्क्रीट टोकन्स के बजाय एक सतत तरंग (continuous waveform) उत्पन्न करता है। लैंग्वेज मॉडल्स में, छोटी क्वांटाइजेशन त्रुटियां संभावना वितरण (probability distributions) को थोड़ा प्रभावित करती हैं — अगला टोकन बदल सकता है, फिर भी टोकन सीमाओं पर प्राकृतिक रीसेट पॉइंट्स के कारण आउटपुट अक्सर सुसंगत रहता है। हालांकि, TTS में, प्रत्येक संख्यात्मक मान सीधे श्रव्य सिग्नल ऊर्जा में योगदान देता है। त्रुटि को अवशोषित करने के लिए कोई सीमा नहीं है। एक छोटा सा विक्षेपण केवल संभावनाओं को नहीं बदलता — यह फेज़, हार्मोनिक संरचना और तरंग निरंतरता को बदल देता है। जो बात LLM में सांख्यिकीय रूप से मामूली है, वह ऑडियो में प्रत्यक्ष रूप से स्पष्ट हो सकती है।
भाषण मिलीसेकंड के भीतर एक विस्तृत डायनामिक रेंज में भी फैला होता है — कम ऊर्जा वाले फ्रिकेटिव्स से लेकर उच्च ऊर्जा वाले स्वरों और त्वरित ट्रांजिएंट्स तक। जब परिशुद्धता कम की जाती है (जैसे, BlockFloat8 या LoFi कंप्यूट के साथ), तो छोटे संख्यात्मक विचलन कम ऊर्जा वाले फोनेम्स को नष्ट कर सकते हैं, बैकग्राउंड हिस (hiss) ला सकते हैं, टिम्बर को विकृत कर सकते हैं, या पिच में अस्थिरता पैदा कर सकते हैं। क्वांटाइजेशन त्रुटि औसत रूप से समाप्त नहीं होती है; यह संरचित ध्वनिक आर्टिफैक्ट्स के रूप में प्रकट होती है। भाषण मॉडलों में, त्रुटि प्रत्यक्ष अनुभव को प्रभावित करती है — और मानव श्रवण प्रणाली इस मामले में बहुत संवेदनशील है।
जब मेट्रिक्स झूठ बोलते हैं: हमारे PCC अवलोकन
प्रयोगों के दौरान सबसे आश्चर्यजनक अवलोकनों में से एक PCC (पियर्सन कोरिलेशन कोफिशिएंट) को लेकर था, जिसे अक्सर स्वर्ण-मानक समानता मीट्रिक माना जाता है।
जब NVIDIA L40S पर चल रहे PyTorch मॉडल की तुलना CPU (AMD EPYC 7352 24-Core Processor) से की गई, तो समान इनपुट्स के साथ एंड-टू-एंड PCC केवल 0.72 था। कम PCC (इतना कम कि इसे बेमेल माना जाता है) के बावजूद, ऑडियो बिल्कुल समान और अच्छे थे।
इसने एक विश्वसनीय शुद्धता मीट्रिक के बिना टेनस्टोरेंट (tenstorrent) पर पोर्ट करते समय चुनौती खड़ी की:
उदाहरण के लिए, एक लेयर में:
PCC अत्यधिक उच्च था
सापेक्ष त्रुटि बहुत कम थी
PCC इतना उच्च था कि यह राउंड होकर 1.0 हो गया
फिर भी उसी लेयर के कारण श्रव्य आउटपुट में खराबी आ गई।
इसे ठीक-ठीक पहचानने में एक महीने से अधिक की जांच लगी। शुरुआती संदेह कम PCC मानों वाली लेयर्स पर था। विडंबना यह है कि समस्याग्रस्त लेयर मानक मेट्रिक्स के अनुसार संख्यात्मक रूप से "सटीक" दिखाई दे रही थी।
यह एक महत्वपूर्ण अंतर्दृष्टि पर प्रकाश डालता है:
पारंपरिक संख्यात्मक समानता मेट्रिक्स हमेशा प्रत्यक्ष ऑडियो गुणवत्ता के विश्वसनीय संकेतक नहीं होते हैं।
TTS के लिए अद्वितीय आर्किटेक्चरल सीमाएं
कुछ लेयर संरचनाएं आधुनिक TTS आर्किटेक्चर में अंतर्निहित होती हैं।
उन्हें बदलने से:
रोबोटिक आवाज के प्रभाव पैदा होते हैं
हार्मोनिक अस्थिरता होती है
सूक्ष्म लेकिन अस्वीकार्य आर्टिफैक्ट्स उत्पन्न होते हैं
सामने आई कुछ परिशुद्धता आवश्यकताएं LLM की दुनिया में लगभग अनसुनी होंगी। लैंग्वेज मॉडलिंग में जो विचलन स्वीकार्य है, वह वेवफॉर्म जनरेशन में विनाशकारी हो जाता है।
यह BlockFloat8 + LoFi को अत्यधिक चुनौतीपूर्ण क्यों बनाता है
इन कारणों से, TTS पाइपलाइन में BlockFloat8 और LoFi कंप्यूट को आक्रामक रूप से लागू करना, LLMs या इमेज मॉडल्स की तुलना में काफी अधिक चुनौतीपूर्ण है।
इन्हें प्राप्त करने के लिए:
95%+ LoFi लेयर कवरेज
80%+ BlockFloat8 अपनाना
कोई श्रव्य आर्टिफैक्ट्स न होना
इसकी आवश्यकता थी:
आर्किटेक्चरल को-डिजाइन
चुनिंदा परिशुद्धता बनाए रखना
कस्टम कर्नेल इम्प्लीमेंटेशन
लेयर-वार प्रयोग
मानक मेट्रिक्स से परे प्रत्यक्ष सत्यापन
TTS संख्यात्मक रूप से नाजुक है क्योंकि यह क्रमिक सुधार के माध्यम से एक सतत, प्रत्यक्ष रूप से संवेदनशील सिग्नल उत्पन्न करता है। छोटे विचलन समय के साथ बढ़ते जाते हैं और सीधे वेवफॉर्म में दिखाई देते हैं।
यही कारण है कि यह ऑप्टिमाइज़ेशन समस्या मौलिक रूप से दिखने की तुलना में अधिक कठिन है।
हार्डवेयर-स्तर का लाभ: टेनस्टोरेंट क्यों महत्वपूर्ण है
Nvidia GPUs व्यापक रूप से समानांतर स्ट्रीमिंग मल्टीप्रोसेसरों (SMs) के इर्द-गिर्द बने हैं। हालांकि थ्रूपुट वर्कलोड के लिए यह बेहद शक्तिशाली हैं, लेकिन SMs काफी हद तक स्वतंत्र निष्पादन इकाइयों (execution units) के रूप में कार्य करते हैं। जब एक SM द्वारा उत्पादित डेटा की आवश्यकता दूसरे को होती है, तो इसे आमतौर पर साझा मेमोरी पदानुक्रमों को पार करना पड़ता है और अक्सर ग्लोबल मेमोरी से होकर गुजरना पड़ता है।
यह मॉडल बड़े बैच वर्कलोड के लिए अच्छा काम करता है, लेकिन यह सिंगल-सैंपल TTS के लिए अक्षमताएं पैदा करता है, जहां लेटेंसी और मेमोरी मूवमेंट का दबदबा होता.
मेमोरी मूवमेंट की समस्या
पारंपरिक GPU निष्पादन में:
कई कंप्यूट इकाइयां ओवरलैपिंग वेट टाइल्स प्राप्त कर सकती हैं
मध्यवर्ती एक्टिवेशन अक्सर ग्लोबल मेमोरी में चले जाते हैं
लेयर ट्रांज़िशन के लिए अक्सर DRAM से डेटा को पुनः लोड करने की आवश्यकता होती है
हाई-बैंडविड्थ मेमोरी (HBM) के साथ भी, DRAM एक्सेस बना रहता है:
ऊर्जा के लिहाज से महंगा
भारी लेटेंसी वाला
इन्फ्रेंस लागत में एक प्रमुख योगदानकर्ता
हाई बैंडविड्थ मेमोरी मूवमेंट को समाप्त नहीं करता है - यह केवल इसे कम कष्टदायक बनाता है।
सिंगल-स्ट्रीम रियल-टाइम TTS इन्फ्रेंस के लिए, आप इस लागत को कम करने के लिए बैचिंग पर भरोसा नहीं कर सकते। आपको हर बार पूरी मेमोरी लेटेंसी का भुगतान करना पड़ता है।
टेनस्टोरेंट समीकरण को कैसे बदलता है
टेनस्टोरेंट का आर्किटेक्चर बड़े वितरित SRAM के साथ कंप्यूट कोर्स को सीधे जोड़ने वाले नेटवर्क-ऑन-चिप (NoC) को पेश करता है।
यह सक्षम बनाता है:
बिना DRAM राउंड-ट्रिप्स के सीधे कोर-टू-कोर डेटा मूवमेंट
वेट टाइल्स की मल्टीकास्टिंग - वेट्स का एक हिस्सा एक बार में प्राप्त किया जा सकता है और सभी कोर्स में ब्रॉडकास्ट किया जा सकता है
कम अनावश्यक मेमोरी फ़ेच
न्यूनतम ग्लोबल मेमोरी ट्रैफ़िक के कारण कम बिजली की खपत
एक सामान्य matmul में, DRAM से स्वतंत्र रूप से एक ही वेट ब्लॉक लाने वाली कई इकाइयों के बजाय, ब्लॉक को एक बार लाया जाता है और कोर में कुशलतापूर्वक वितरित किया जाता है।
मेमोरी मूवमेंट - न कि रॉ FLOPs - अक्सर इन्फ्रेंस में वास्तविक बाधा होती है। NoC + SRAM डिज़ाइन सीधे इस बाधा पर प्रहार करता है।
40 गुना कम हार्डवेयर लागत पर नेटिव BlockFloat8 सपोर्ट
BlockFloat8 सपोर्ट आधुनिक हाई-एंड GPU आर्किटेक्चर में मौजूद है, लेकिन इसके लिए आमतौर पर प्रीमियम हार्डवेयर स्तरों की आवश्यकता होती है। उदाहरण के लिए, नेटिव FP8 क्षमता वाले NVIDIA के Blackwell-क्लास GPUs की कीमत प्रति एक्सेलरेटर लगभग $40,000 की रेंज में है।
इसके विपरीत, टेनस्टोरेंट लगभग $1,000 की श्रेणी वाले हार्डवेयर पर कुशल BlockFloat8 निष्पादन को सक्षम बनाता है।
कम-परिशुद्धता कंप्यूट को सक्षम करने के लिए यह हार्डवेयर खरीद लागत में लगभग 40 गुना का अंतर है।
यह लागत-प्रदर्शन समीकरण को मौलिक रूप से बदल देता है।
BlockFloat8 केवल उपलब्ध ही नहीं है — यह वास्तविक समय के इन्फ्रेंस के लिए आर्थिक रूप से व्यावहारिक बन जाता है, जिसमें छोटे और मध्यम आकार के TTS मॉडल भी शामिल हैं जहां प्रीमियम एक्सेलरेटर मूल्य निर्धारण को उचित नहीं ठहराया जा सकता है।
जब BFP8 हार्डवेयर स्तर पर किफायती होता है, तो आक्रामक संख्यात्मक अनुकूलन केवल सैद्धांतिक न रहकर डिप्लॉयमेंट के योग्य बन जाता है।
मापे गए परिणाम
हार्डवेयर | लागत | कन्करेंसी (concurrency) | लेटेंसी (ms) | लागत लाभ |
L40s | $9000 | 3 | 300 | 1x |
P150 | $1400 | 1 | 250 | 2.6x |
P100 [1] | $1000 | 1 | 250 | 3.6x |
तालिका 1: मापी गई लेटेंसी, कन्करेंसी
[1] P100 और P150 में सिंगल-चिप इन्फ्रेंस के लिए समान लेटेंसी होने की उम्मीद है, क्योंकि lightning V2 मल्टी-चिप इन्फ्रेंस नहीं करता है और QSFP का उपयोग नहीं करता है, इसलिए लेटेंसी P150 के समान होने की उम्मीद है। मापी गई लेटेंसी P150 की हैं।
यह क्यों महत्वपूर्ण है
Lightning V2 को केवल क्वांटाइज और डिप्लॉय नहीं किया गया था।
इसे हार्डवेयर के साथ को-ऑप्टिमाइज़ किया गया था।
NoC ने मेमोरी के दबाव को कम किया।
SRAM लोकैलिटी ने ऊर्जा लागत और अनावश्यक DRAM मूवमेंट को कम किया।
नेटिव BlockFloat8 ने कंप्यूट लागत को कम किया।
इसका परिणाम न केवल तेज़ इन्फ्रेंस था — बल्कि यह इन्फ्रेंस की इकोनॉमिक्स में एक संरचनात्मक बदलाव था।
एक ठोस तुलना
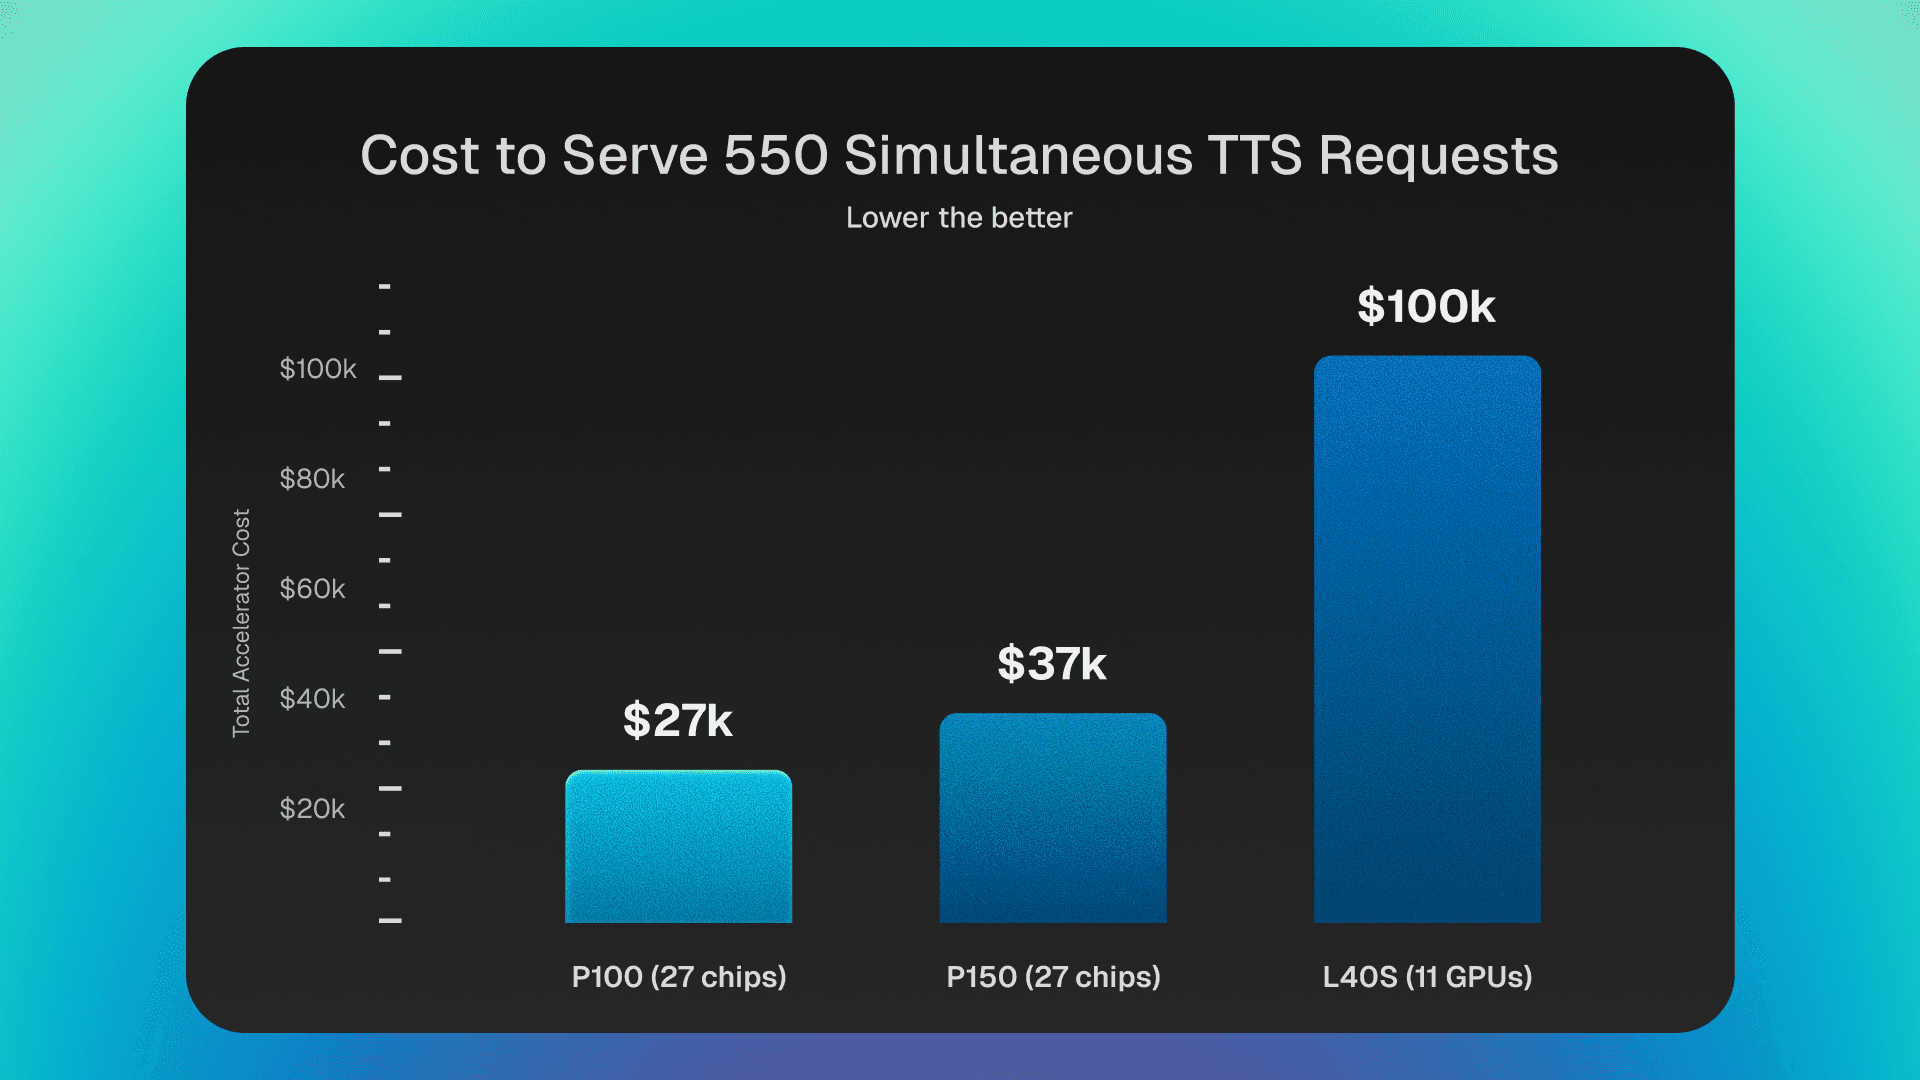
धारणा (सरलता के लिए): प्रत्येक प्रतिक्रिया लगभग 5 सेकंड का ऑडियो उत्पन्न करती है (यह प्रति अनुरोध थोड़ा भिन्न हो सकता है)।
तालिका 1 से, प्रत्येक L40S प्रति सेकंड 3.33×3×5=50 सेकंड का ऑडियो उत्पन्न कर सकता है, जबकि एक P150 प्रति सेकंड 4×5=20 सेकंड का ऑडियो उत्पन्न कर सकता है।
एक वॉयस एजेंट पाइपलाइन (AST → LLM → TTS) पर विचार करें जो 100% हार्डवेयर उपयोग पर काम कर रही है, जहां वर्तमान पीढ़ी के पूरा होने से पहले TTS चरण का अगला इनपुट हमेशा तैयार रहता है।
5-सेकंड की अवधि के भीतर 550×5=2750 सेकंड के ऑडियो उत्पन्न करने के बराबर वर्कलोड बनाए रखने के लिए - जो पूर्ण उपयोग पर 550 ओवरलैपिंग 5-सेकंड के अनुरोधों के निरंतर प्रवाह के अनुरूप है (यानी, प्रभावी रूप से 550 समवर्ती कॉलों का समर्थन करता है):
चूंकि प्रत्येक अनुरोध ~5 सेकंड का ऑडियो उत्पन्न करता है, और एक सिंगल NVIDIA GPU प्रति सेकंड लगभग 10 अनुरोधों को प्रोसेस कर सकता है (3 प्रतिक्रियाओं के लिए मापे गए ~300 ms के आधार पर), प्रत्येक GPU 10×5=50 ऑडियो-सेकंड प्रति सेकंड प्रदान करता है। इसलिए, 11 GPUs सामूहिक रूप से ~550 ऑडियो-सेकंड प्रति सेकंड प्रदान करते हैं, जो इस वर्कलोड को बनाए रखने के लिए पर्याप्त है।
NVIDIA को 11× L40S GPUs की आवश्यकता होगी, जिसकी लागत एक्सेलरेटर हार्डवेयर में लगभग ~$100,000 होगी।
इसी तरह, टेनस्टोरेंट को 27× P100[1] (कुल लगभग ~$27,000) या 27× P150 (कुल लगभग ~$37,000) की आवश्यकता होगी।
यह समान वर्कलोड की सेवा के लिए अग्रिम एक्सेलरेटर लागत में ~3-4 गुना की कमी है।
~$27K और ~$100K के बीच का अंतर मामूली नहीं है — यह निर्णायक है। कई डिप्लॉयमेंट्स के लिए, केवल यही अंतर यह निर्धारित करता है कि ऑन-प्रिमाइसेस (on-prem) इन्फ्रेंस व्यावहारिक है या नहीं।
संरचनात्मक प्रभाव
यह बदलाव तीन महत्वपूर्ण तरीकों से TTS के अर्थशास्त्र को बदलता है:
ऑन-प्रिमाइसेस व्यवहार्य हो जाता है- बिना छह अंकों के GPU बजट की आवश्यकता के।
पूंजीगत व्यय (Capital expenditure) में काफी गिरावट आती है, जिससे छोटी टीमें उच्च गुणवत्ता वाले वॉयस मॉडल डिप्लॉय कर सकती हैं।
वॉयस-नेटिव एप्लिकेशन बनाने की बाधाएं कम हो जाती हैं, विशेष रूप से लेटेंसी-सेंसिटिव और प्राइवेसी-सेंसिटिव वर्कलोड के लिए।
जब ऑडियो गुणवत्ता से समझौता किए बिना इन्फ्रेंस की लागत 4 गुना कम हो जाती है, तो नए डिप्लॉयमेंट मॉडल व्यावहारिक हो जाते हैं। रीयल-टाइम स्पीच सिस्टम अब हाई-एंड GPU इन्फ्रास्ट्रक्चर तक सीमित नहीं हैं।
यह केवल प्रदर्शन में सुधार नहीं है।
यह एक आर्थिक द्वार का खुलना है।
भविष्य के कार्य
टेनस्टोरेंट पर Lightning V2 एक महत्वपूर्ण मील का पत्थर है। हमारा नवीनतम मॉडल, Lightning V3, गुणवत्ता और आर्किटेक्चरल दक्षता में पहले से ही V2 से आगे है। हम समान को-डिजाइन सिद्धांतों के साथ टेनस्टोरेंट पर Lightning V3 को डिप्लॉय करने की योजना बना रहे हैं, जिसका लक्ष्य समान या अधिक लागत बचत प्राप्त करना है।
कर्नेल और प्रोग्राम ऑप्टिमाइज़ेशन
जबकि वर्तमान परिणाम मजबूत हार्डवेयर लाभ प्रदर्शित करते हैं, कई प्रोग्राम कॉन्फ़िगरेशन अभी भी सब-ऑप्टिमल (sub-optimal) हैं। इसमें सुधार की अभी भी काफी गुंजाइश है।
क्षमता को स्पष्ट करने के लिए:
एक अत्यधिक अनुकूलित लेयर (~6B MACs) वर्तमान में लेती है:
NVIDIA L40S पर ~60 μs
टेनस्टोरेंट P100 [1] और P150 पर ~31 μs
यह दर्शाता है कि जब लेयर्स को टेनस्टोरेंट के आर्किटेक्चर का लाभ उठाने के लिए पूरी तरह से अनुकूलित किया जाता है, तो प्रदर्शन में सुधार केवल क्रमिक नहीं होते हैं — वे गुणात्मक होते हैं (एक ऐसे डिवाइस पर 2 गुना बेहतर जो 9 गुना सस्ता है, यानी 18x -> )।
अधिक लेयर्स में इस स्तर के ऑप्टिमाइज़ेशन का विस्तार करने से 8-12 गुना लाभ मिलने की उम्मीद है।
उद्देश्य स्पष्ट है:
न केवल कम लागत — बल्कि वास्तविक समय के भाषण इन्फ्रेंस के लिए दक्षता की सीमा को संरचनात्मक रूप से फिर से परिभाषित करना।
हमारे शोध पत्र में इस बारे में और पढ़ें: https://arxiv.org/pdf/2604.03279