2026 में ऑडियोबुक्स के लिए AI वॉयस नैरेटर कैसे चुनें
2026 में ऑडियोबुक्स के लिए एआई नैरेटर आवाज का चयन, जिसमें गुणवत्ता, थ्रूपुट, मूल्य निर्धारण, लाइसेंसिंग, बहुभाषी समर्थन और लेबलिंग के लिए एक व्यावहारिक चेकलिस्ट शामिल है।
AI-जनरेटेड वॉयसओवर नैरेशन बाजार तेजी से बढ़ रहा है, और प्रकाशकों के लिए व्यावहारिक सवाल अब यह नहीं रह गया है कि क्या AI नैरेशन व्यावहारिक है, बल्कि यह हो गया है कि लंबे फॉर्म के प्रोडक्शन के लिए किस प्लेटफॉर्म पर भरोसा किया जाए। प्रकाशकों, स्वतंत्र लेखकों और प्रोडक्शन स्टूडियो के लिए, व्यावहारिक सवाल एक ही है: लंबे समय के नैरेशन के लिए वास्तव में किस टेक्स्ट-टू-स्पीच मॉडल पर भरोसा किया जा सकता है?
सही चुनाव करने का मतलब है चमकीले डेमो से आगे देखना और जो मायने रखता है उस पर ध्यान केंद्रित करना: आवाज की गुणवत्ता, थ्रूपुट और लेटेंसी (लैटेंसी), मूल्य निर्धारण, लाइसेंसिंग, बहुभाषी कवरेज और नैतिक ढांचे जो तेजी से आवश्यक मानक बनते जा रहे हैं। चाहे आप एक स्वतंत्र लेखक हों जो एक पुस्तक प्रकाशित करना चाहते हैं, या कोई प्रकाशक जो पूरी कैटलॉग को स्केल करने की योजना बना रहे हैं, वही मानदंड लागू होते हैं। आप देखेंगे कि कौन सी आवाज ऑडियोबुक्स के लिए व्यावहारिक है, कौन से तकनीकी बेंचमार्क मापने योग्य हैं, मूल्य निर्धारण और लाइसेंसिंग वास्तव में कैसे काम करते हैं, आपको किन नैतिक और कानूनी सीमाओं का सम्मान करना होगा, और प्रतिबद्ध होने से पहले एक व्यावहारिक मूल्यांकन कैसे चलाना है।
वास्तव में कौन सी चीज़ किसी आवाज़ को 'ऑडियोबुक-रेडी' बनाती है
अधिकांश टीमें एक डेमो क्लिप से शुरुआत करती हैं। यह तर्कसंगत है, लेकिन यह एक जाल भी है। तीस सेकंड की क्लिप आपको यह नहीं बताएगी कि आठ घंटे तक कोई आवाज़ कैसा व्यवहार करती है, क्या यह अध्यायों के बदलावों के बीच अपना संतुलन बनाए रखती है, या चौथे अध्याय तक पहुँचते-पहुँचते यह आपकी विशिष्ट शब्दावली को कितना बिगाड़ देती है। ऑडियोबुक्स के लिए दो मिनट के व्याख्यात्मक वीडियो या IVR प्रॉम्प्ट की तुलना में अधिक ऊंचे और भिन्न स्तर की आवश्यकता होती है।
"ठीक-ठाक" और ऑडियोबुक-रेडी आवाज़ के बीच का अंतर आमतौर पर चार जगहों पर दिखाई देता है। पहला: प्रोसोडी कंसिस्टेंसी (लहजे की निरंतरता)। आवाज़ को हजारों वाक्यों में बिना नीरस हुए या जहाँ ज़रूरत न हो वहाँ अजीब ज़ोर दिए बिना लय, तनाव और स्वर-शैली को बनाए रखना होता है। दूसरा: इमोशनल रेंज (भावनात्मक दायरा)। विशेष रूप से फिक्शन मॉडल को संवाद, आंतरिक विचारों और दृश्य-सेटिंग के बीच आसानी से बदलाव करने के लिए मजबूर करता है बिना ऐसा लगे कि वह तीन अलग-अलग पुस्तकें पढ़ रहा है। तीसरा: उच्चारण की सटीकता। संज्ञाओं, विदेशी शब्दों और तकनीकी शब्दों को विश्वसनीय रूप से संभालने की आवश्यकता होती है, आदर्श रूप से फोनेम-स्तरीय नियंत्रण या मजबूत SSML समर्थन के माध्यम से। चौथा: साफ ऑडियो। क्लिक, सांस लेने की अजीब आवाज़ें और पिच की खामियाँ जिन्हें आप एक छोटे से नमूने में अनदेखा कर सकते हैं, तब थका देने वाली हो जाती हैं जब कोई श्रोता घंटों तक हेडफ़ोन पहने रहता है।
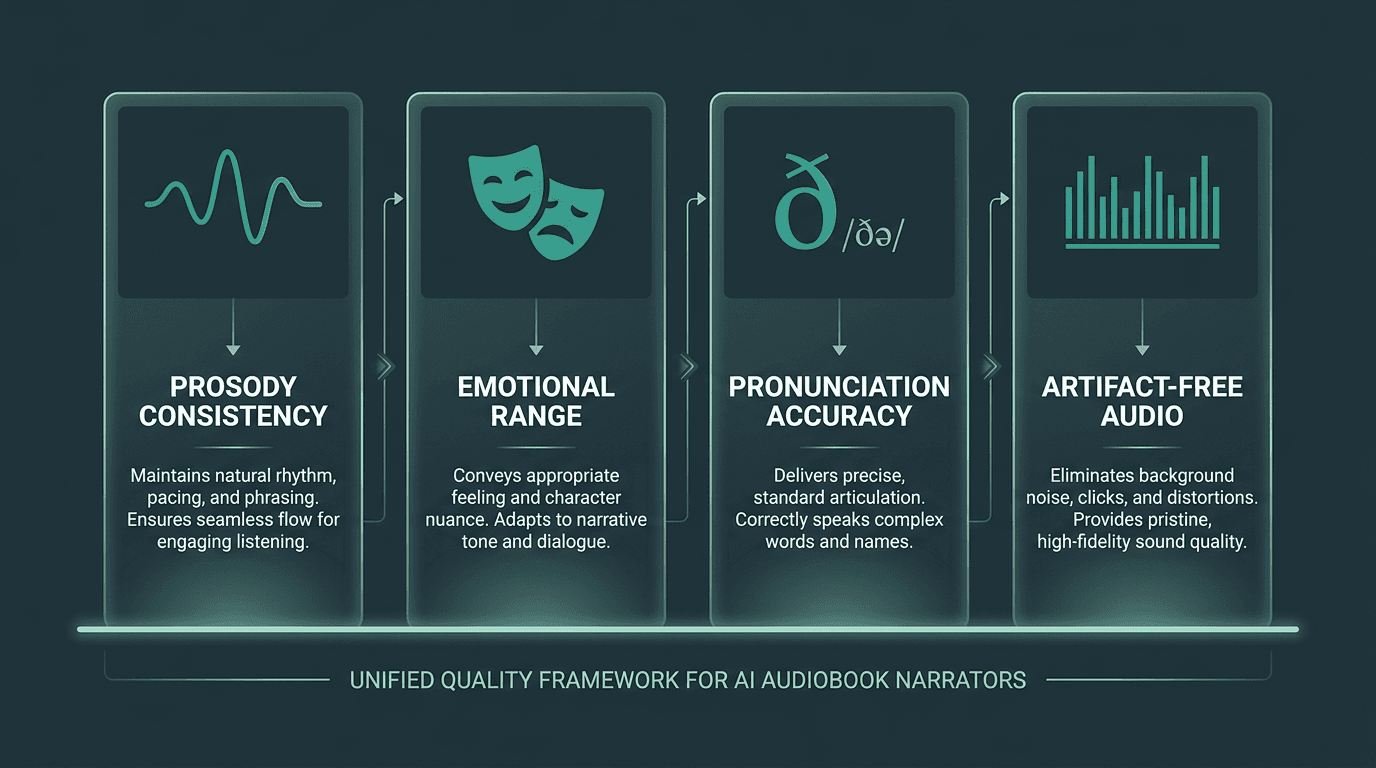
चार गुणवत्ता स्तंभ जो यह निर्धारित करते हैं कि क्या कोई TTS आवाज़ पूरी लंबाई की ऑडियोबुक को संभाल सकती है।
प्रतिबद्ध होने से पहले मापने योग्य तकनीकी बेंचमार्क
रीयल-टाइम वॉयस एजेंटों में लेटेंसी पर सबसे अधिक ध्यान दिया जाता है, लेकिन ऑडियोबुक प्रोडक्शन में इस समस्या का अपना एक अलग रूप है। यदि आप बैचों में अध्यायों को रेंडर कर रहे हैं, तो कच्चे थ्रूपुट का महत्व फर्स्ट-टोकन लेटेंसी से अधिक होता है। एक मॉडल जो रीयल-टाइम से 10 गुना तेजी से चलता है, वह लगभग एक घंटे में 10 घंटे की ऑडियोबुक रेंडर कर सकता है। जो मॉडल रीयल-टाइम से 2 गुना गति से चलता है उसे लगभग पांच घंटे चाहिए होते हैं। जब आप बड़े पैमाने पर प्रोडक्शन कर रहे होते हैं, तो यह अंतर केवल सैद्धांतिक नहीं रह जाता।
यदि आप वेंडर्स की तुलना शुरू करने से पहले एक व्यापक तकनीकी आधार चाहते हैं, तो वॉयस मॉडल आर्किटेक्चर और उपयोग के मामलों को समझना आपके विचारों को स्थिर करने का एक ठोस स्थान है। एक TTS मॉडल के पीछे का आर्किटेक्चर (डिफ्यूजन-बेस्ड डिकोडर, फ्लो-मैचिंग दृष्टिकोण, ट्रांसफार्मर-बेस्ड वोकोडर) सीधे आउटपुट गुणवत्ता और थ्रूपुट दोनों में दिखाई देता है।
साइन अप करने से पहले किसी भी TTS वेंडर से अनुरोध करने योग्य विशिष्ट बेंचमार्क:
थ्रूपुट दर: बैच मोड में प्रति सेकंड संसाधित किए गए वर्ण या शब्द, न कि केवल स्ट्रीमिंग मोड में।
मीन ओपिनियन स्कोर (MOS): उद्योग-मानक अवधारणात्मक गुणवत्ता रेटिंग, आदर्श रूप से वेंडर के अपने परीक्षण के बजाय किसी तीसरे पक्ष के मूल्यांकन से।
डोमेन-विशिष्ट टेक्स्ट पर वर्ड एरर रेट (WER): सामान्य बेंचमार्क वाक्यों के बजाय अपनी वास्तविक पांडुलिपि के साथ परीक्षण करें।
SSML समर्थन की गहराई: क्या आप विराम, ज़ोर, फोनेम उच्चारण और बोलने की गति को बारीकी से नियंत्रित कर सकते हैं?
ऑडियो प्रारूप विकल्प: ऑडियोबुक वितरण के लिए न्यूनतम 24kHz; ACX और Findaway अनुपालन के लिए 44.1kHz या 48kHz को प्राथमिकता दी जाती है।
लंबे इनपुट में स्थिरता: क्या लगातार 500 शब्दों के इनपुट के बाद गुणवत्ता गिरती है? 2,000-शब्दों के टुकड़ों के साथ परीक्षण करें।
मूल्य निर्धारण की वास्तविकताएं: आप वास्तव में किस चीज के लिए भुगतान कर रहे हैं
TTS का मूल्य निर्धारण इतना जटिल है कि आप केवल देखकर इसका अनुमान नहीं लगा सकते; आपको गणित लगाना होगा। कई प्रदाता प्रति वर्ण (अक्सर प्रति 1,000 वर्ण) शुल्क लेते हैं। एक सामान्य ऑडियोबुक लगभग 60,000 से 100,000 शब्दों की होती है, या लगभग 360,000 से 600,000 वर्णों की। $0.015 प्रति 1,000 वर्णों (एक सामान्य मध्य-श्रेणी दर) पर, यह कच्चे API खर्च में $5.40 से $9.00 प्रति टाइटल बैठता है। $0.030 प्रति 1,000 वर्णों पर, आप उसी पांडुलिपि के लिए $10.80 से $18.00 पर पहुंच जाते हैं।
एक अकेली किताब के लिए, ये संख्याएँ बहुत आसान लगती हैं। इसे महीने में 50 टाइटल्स से गुणा करें और मूल्य निर्धारण स्तर रणनीति की तरह दिखने लगते हैं, न कि कोई मामूली बात। आपको वॉयस क्लोनिंग शुल्क (अक्सर एक अलग एकमुश्त या मासिक ऐड-ऑन), जेनरेट किए गए ऑडियो के लिए स्टोरेज, और यदि टीम के कई सदस्य API का उपयोग करते हैं तो प्रति-सीट लाइसेंसिंग के लिए भी बजट बनाना होगा। Smallest.ai का मूल्य निर्धारण बड़े पैमाने पर पारदर्शी रहने के लिए डिज़ाइन किया गया है, जो तब मायने रखता है जब आप किसी एक प्रोजेक्ट पर बहस करने के बजाय पूरे कैटलॉग का पूर्वानुमान लगा रहे हों।
एक बार-बार होने वाली समस्या: कोई प्रदाता एक आकर्षक प्रति-वर्ण दर का विज्ञापन करता है, फिर सबसे अच्छी आवाज़ों को प्रीमियम स्तरों के पीछे बंद कर देता है। इसे उत्पाद की सीमा मानें, असुविधा नहीं। उसी सटीक आवाज़ का परीक्षण करें जिसे आप उपयोग करने की योजना बना रहे हैं, उसी स्तर पर जिसके लिए आप भुगतान करने की योजना बना रहे हैं; डेमो आवाज़ और वास्तविक प्रोडक्शन आवाज़ हमेशा एक जैसी नहीं होती हैं।
नैतिक और कानूनी स्तर जिसे आप अनदेखा नहीं कर सकते
वॉयस AI इसके इर्द-गिर्द बने नियमों की तुलना में तेज़ी से आगे बढ़ रहा है, और अब यह अंतर कम होने लगा है। ऑडियो पब्लिशर्स एसोसिएशन ने 2024 में नामकरण दिशानिर्देश जारी किए जो एक व्यावहारिक सीमा रेखा खींचते हैं (APA AI नैरेशन नामकरण दिशानिर्देश, 2024): “AI वॉयस” एक सामान्य सिंथेटिक आवाज़ है जिसका कोई विशिष्ट मानव स्रोत नहीं होता है, जबकि एक “अधिकृत वॉयस रेप्लिका” (AVR) को एक विशिष्ट, लाइसेंस प्राप्त मानव वॉयस एक्टर से क्लोन किया जाता है। ये लेबल आपस में बदलने योग्य नहीं हैं, और उत्पाद सूची में गलत लेबल का उपयोग करना तेजी से अनुपालन का विषय बनता जा रहा है, न कि विपणन पसंद का।
SAG-AFTRA के 2023 के कदमों ने जोखिमों को स्पष्ट कर दिया: वॉयस एक्टर के अधिकार अब आपकी प्रोडक्शन योजना में एक कानूनी चर हैं। यदि आपके वर्कफ़्लो में वॉयस क्लोनिंग शामिल है, तो आपको यह जानना होगा कि वह आवाज़ कहाँ से आई और उसके पीछे क्या अनुमतियाँ हैं। एक गंभीर TTS प्रदाता को स्पष्ट रूप से यह बताने में सक्षम होना चाहिए कि क्या मॉडलों को सहमति वाले डेटा पर प्रशिक्षित किया गया था और क्या क्लोनिंग के लिए स्रोत वॉयस एक्टर से स्पष्ट सहमति की आवश्यकता है।
रिटेल वितरण भी प्रकटीकरण की अपेक्षाओं को कड़ा कर रहा है। APA दिशानिर्देश वर्तमान सर्वोत्तम अभ्यास के लिए एक मजबूत प्रतिनिधित्व हैं, और शुरुआत में ही इसके साथ तालमेल बिठाना बाद में सुधारात्मक कदम उठाने की तुलना में सस्ता है। सिंथेटिक आवाज़ के इर्द-गिर्द नैतिक और नियामक चर्चा तेज़ी से आगे बढ़ रही है, यही वजह है कि यह लेबलिंग नियम अब एक प्रोडक्शन आवश्यकता के रूप में सामने आ रहा है, न कि भविष्य की चिंता के रूप में।
बहुभाषी नैरेशन: एक क्षमता का अंतर जो पहले से कहीं अधिक मायने रखता है
वैश्विक ऑडियोबुक वितरण ने बहुभाषी नैरेशन को एक प्रोडक्शन आवश्यकता बना दिया है, न कि कोई बोनस सुविधा। एक किताब जो अंग्रेजी में काम करती है, उसका स्पेनिश, पुर्तगाली या हिंदी में वास्तविक लाभ हो सकता है। कठिन हिस्सा यह तय करना है कि क्या एक ही TTS मॉडल लगातार गुणवत्ता के साथ उस कार्यभार को संभाल सकता है, या क्या आपको प्रति भाषा अलग मॉडल (और अलग QA) की आवश्यकता है।
अधिकांश एंटरप्राइज़ TTS वेंडर आपको बताएंगे कि वे 20 से 50+ भाषाओं का समर्थन करते हैं। वह संख्या “मूल श्रोताओं को अच्छी लगने वाली आवाज़” के समान नहीं है। एक मॉडल हिंदी पाठ को स्वीकार कर सकता है और फिर भी ऐसा ऑडियो उत्पन्न कर सकता है जो लय, तनाव या ध्वन्यात्मकता में अजीब लगे। मूल-भाषी मूल्यांकन ही एकमात्र परीक्षण है जो मायने रखता है; भाषाओं की संख्या का विज्ञापन नहीं। यदि आप वैश्विक पहुंच की योजना बना रहे हैं, तो पूर्व-प्रशिक्षित बहुभाषी वॉयस मॉडल प्रति भाषा अलग मॉडल पाइपलाइन बनाए रखने की तुलना में एकीकरण के काम को कम कर सकते हैं।
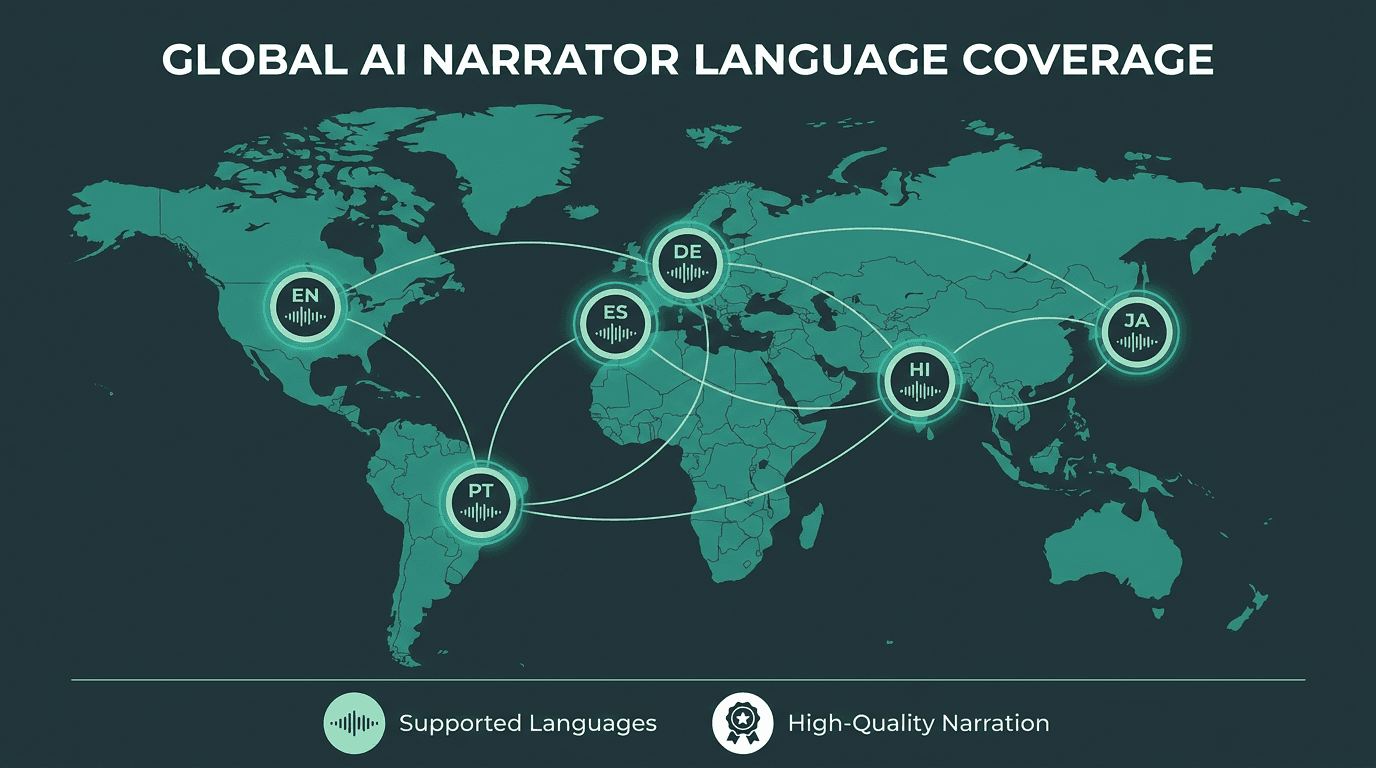
भाषा समर्थन की चौड़ाई और भाषा की गुणवत्ता दो अलग-अलग मेट्रिक्स हैं। वैश्विक प्रकाशकों को दोनों की आवश्यकता है।
व्यावहारिक मूल्यांकन चलाना: एक ढांचा जो वास्तव में काम करता है
यदि आप पहले से ही एक रूब्रिक और एक श्रोता पैनल के साथ संरचित TTS मूल्यांकन चलाते हैं, तो आप आगे बढ़ सकते हैं। यदि आप ऐसा नहीं करते हैं, तो यह एक व्यावहारिक प्रक्रिया है जो एक सप्ताह के भीतर पूरी हो जाती है और आपको एक ऐसे निर्णय पर पहुँचाती है जिसका आप आंतरिक रूप से बचाव कर सकते हैं।
एक परीक्षण कॉपर्स (corpus) के साथ शुरुआत करें जो आपकी पुस्तक जैसा दिखता हो, न कि किसी वेंडर के तैयार पैराग्राफ जैसा। पांडुलिपि से तीन अंश निकालें: एक संवाद-प्रधान दृश्य, एक सघन वर्णनात्मक गद्यांश, और उचित संज्ञाओं या तकनीकी शब्दों से भरा एक खंड। वे तीन क्लिप्स आपके कंटेंट के लिए मायने रखने वाली चीज़ों का कड़ा परीक्षण करेंगी। समान SSML का उपयोग करके (या जानबूझकर बिना SSML के, यदि आप इसे मैन्युअल रूप से ट्यून करने की अपनी क्षमता के बजाय बुनियादी व्यवहार को मापना चाहते हैं) प्रत्येक अंश को हर मॉडल के माध्यम से चलाएं।
मूल्यांकन स्कोरिंग रूब्रिक (प्रत्येक मॉडल के लिए प्रत्येक आयाम को 1-5 रेटिंग दें):
स्वाभाविकता: क्या आवाज़ एक मानव कथावाचक की तरह लगती है, या यह सिंथेटिक महसूस होती है?
लहजे की सटीकता: क्या तनाव और लय प्रत्येक वाक्य के इच्छित अर्थ से मेल खाते हैं?
संवाद प्रबंधन: क्या आवाज़ पात्रों की आवाज़ों या कथा शैली में बदलाव के बीच अंतर कर सकती है?
उचित संज्ञा का उच्चारण: क्या नाम, स्थान और तकनीकी शब्द सही ढंग से उच्चारित किए जा रहे हैं?
असंगति गणना (Artifact count): 500-शब्दों के नमूने में कितने क्लिक, सांस की विसंगतियां, या पिच टूटने की आवाज़ें दिखाई देती हैं?
श्रोता की थकान: 20 मिनट तक लगातार सुनने के बाद, क्या आवाज़ आकर्षक बनी रहती है?
इसे ब्लाइंड (गुप्त) रखें। कम से कम तीन लोगों से यह जाने बिना नमूनों को स्कोर करवाएं कि किस मॉडल ने कौन सा ऑडियो तैयार किया है। पूर्वाग्रह वास्तविक होता है, और यदि आप पहले से ही किसी वेंडर को पसंद करते हैं तो आप उसमें ऐसी गुणवत्ता "ढूंढ" लेंगे जो वहां नहीं है। ब्लाइंड स्कोरिंग आउटपुट को अपने दम पर खड़े होने के लिए मजबूर करती है।
ऑडियोबुक्स के लिए वॉयस क्लोनिंग: यह कब समझदारी है और कब नहीं
वॉयस क्लोनिंग कोई व्यापक समाधान नहीं है; यह एक लक्षित उपकरण है। सबसे साफ उपयोग का मामला उस लेखक का है जो अपनी पुस्तक को खुद "सस्वर पढ़ना" चाहता है लेकिन एक बूथ में दिन नहीं बिता सकता, या एक स्थापित कथावाचक जो अपनी आवाज़ को उन टाइटल्स के लिए लाइसेंस देना चाहता है जिन्हें वे व्यक्तिगत रूप से रिकॉर्ड नहीं कर सकते। दोनों ही मामलों में, क्लोन सहमति प्राप्त स्रोत ऑडियो से आता है, और तैयार ऑडियोबुक APA की अधिकृत वॉयस रेप्लिका की परिभाषा में फिट बैठती है।
जटिल हिस्सा उच्च-मात्रा वाले कैटलॉग प्रोडक्शन में दिखाई देता है, जहां एक प्रकाशक प्रति-शीर्षक नैरेशन शुल्क का भुगतान किए बिना दर्जनों टाइटल्स में एक सुसंगत आवाज़ चाहता है। इसका अर्थशास्त्र आकर्षक लग सकता है। लेकिन यदि अंतर्निहित वॉयस मॉडल खराब लाइसेंस प्राप्त डेटा पर बनाया गया है, तो कानूनी जोखिम सैद्धांतिक नहीं रह जाता। क्लोनिंग की पेशकश करने वाले किसी भी TTS प्रदाता को अपने सहमति ढांचे के लिए दस्तावेज़ पेश करने में सक्षम होना चाहिए। यदि वे ऐसा नहीं कर सकते हैं, तो इसे एक गंभीर खतरे का संकेत मानें, भले ही नमूने कितने भी अच्छे क्यों न लगें।
यदि आप क्लोनिंग के बिना निरंतरता चाहते हैं, तो अन्य रास्ते भी हैं। व्यावहारिक रूप से, एक क्लोन की गई आवाज़ और एक उच्च-गुणवत्ता वाली सिंथेटिक आवाज़ के बीच का चुनाव अक्सर कच्चे ऑडियो गुणवत्ता की तुलना में ब्रांड की निरंतरता और अधिकारों के प्रबंधन पर निर्भर करता है।
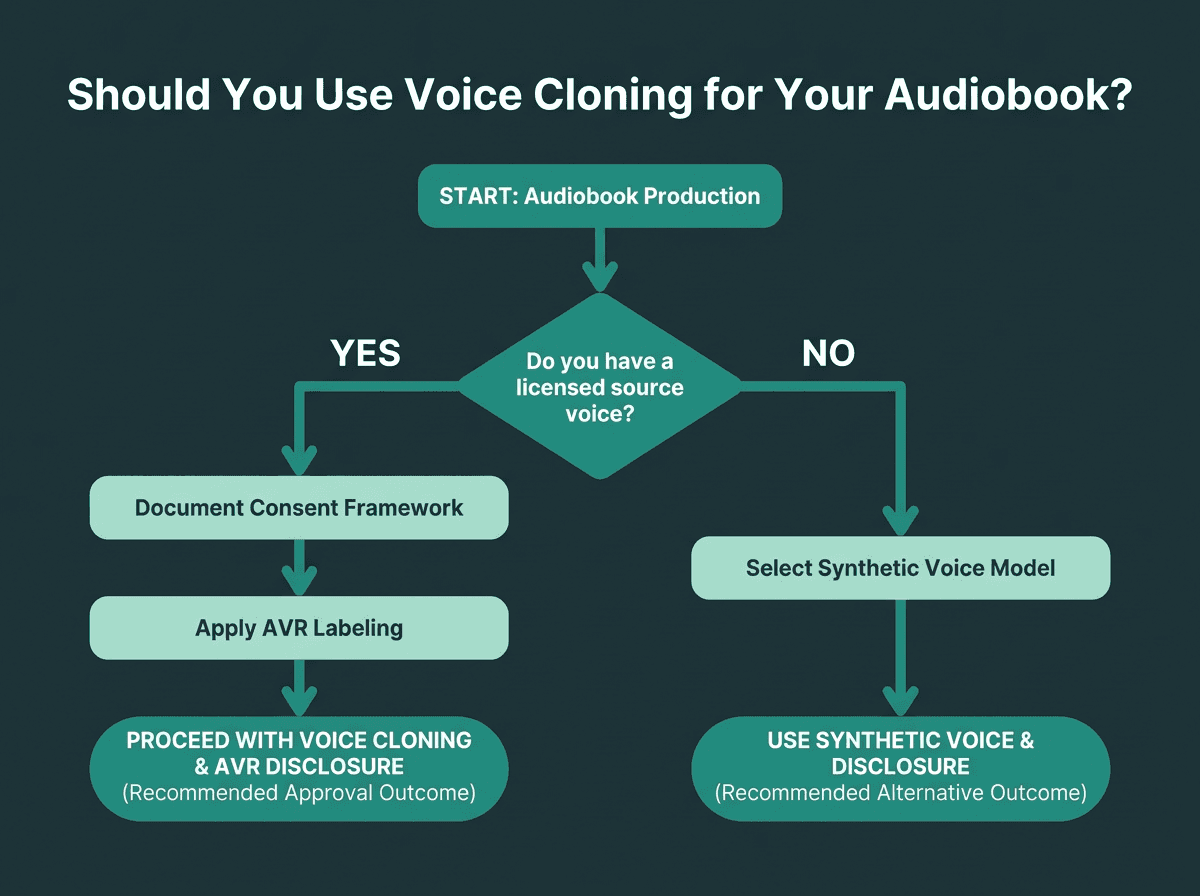
यह निर्धारित करने के लिए एक संरचित निर्णय पथ कि क्या वॉयस क्लोनिंग आपके ऑडियोबुक प्रोडक्शन वर्कफ़्लो में फिट बैठती है।
ऑडियोबुक प्रोडक्शन के लिए अपना 2026 वॉयस एजेंट स्टैक कैसे चुनें
एक TTS मॉडल ऑडियोबुक पाइपलाइन का केवल एक हिस्सा है। यदि आप बड़े पैमाने पर प्रोडक्शन कर रहे हैं, तो आपको सटीकता की पुष्टि करने के लिए ट्रांसक्रिप्शन, सामान्यीकरण और शोर नियंत्रण के लिए पोस्ट-प्रोसेसिंग, और वितरण एकीकरण की भी आवश्यकता होगी जो हर रिलीज को एक कस्टम प्रोजेक्ट न बना दे। अलगाव में TTS का मूल्यांकन करना वह तरीका है जिससे टीमों को शेड्यूल के अंत में दर्दनाक एकीकरण आश्चर्यों का सामना करना पड़ता है।
एक अकेला वेंडर बिलिंग और सपोर्ट को सरल बना सकता है, लेकिन यह निर्भरता को भी केंद्रित करता है। श्रेणी में सर्वश्रेष्ठ लचीलापन बनाए रखता है, लेकिन आप इसके लिए एकीकरण समय के रूप में भुगतान करते हैं। इसका कोई सार्वभौमिक उत्तर नहीं है; यह इंजीनियरिंग क्षमता और प्रोडक्शन की मात्रा पर निर्भर करता है।
AI-जनरेटेड नैरेशन में वेंडर्स की कतार बदलती रहेगी क्योंकि बाजार परिपक्व हो रहा है। यदि आप खुद को मालिकाना प्रारूपों या गैर-पोर्टेबल वॉयस मॉडलों में बांधते हैं, तो आप प्रभावी रूप से बाद में स्विच करने की लागत का पहले ही भुगतान कर रहे हैं। उन प्रदाताओं को प्राथमिकता दें जो मानक ऑडियो प्रारूप आउटपुट करते हैं और प्रलेखित API के साथ उनका समर्थन करते हैं।
मुख्य निष्कर्ष और अगले कदम
ऑडियोबुक्स के लिए AI नरेटर आवाज़ चुनते समय जो निर्णय सबसे अधिक मायने रखते हैं:
वेंडर के डेमो क्लिप के बजाय अपनी वास्तविक पांडुलिपि सामग्री पर आवाज़ की गुणवत्ता का मूल्यांकन करें।
केवल स्ट्रीमिंग लेटेंसी ही नहीं, बल्कि बैच मोड में थ्रूपुट को मापें।
उस विशिष्ट वॉयस टियर और वॉल्यूम के मूल्य निर्धारण ढांचे को समझें जिसका आप वास्तव में उपयोग करेंगे।
किसी भी वॉयस क्लोनिंग सुविधा के पीछे सहमति और लाइसेंसिंग ढांचे को सत्यापित करें।
शुरुआत से ही अपने आउटपुट लेबलिंग को APA दिशानिर्देशों के साथ संरेखित करें।
मूल-भाषी मूल्यांकन के साथ बहुभाषी गुणवत्ता का परीक्षण करें, न कि भाषाओं की संख्या से।
पोर्टेबिलिटी को ध्यान में रखकर अपना स्टैक बनाएं: मानक प्रारूप, प्रलेखित API।
अधिकांश प्रकाशक TTS विकल्पों की कमी से नहीं जूझते; वे एक ऐसी निर्णय प्रक्रिया की कमी से जूझते हैं जो लंबे समय के नैरेशन से मेल खाती हो। लघु-फॉर्म कंटेंट के लिए ट्यून किए गए उपकरण ऑडियोबुक्स पर सूक्ष्म तरीकों से विफल हो जाते हैं, और अक्सर आपको तब तक पता नहीं चलता जब तक आप प्रोडक्शन में गहराई से नहीं उतर जाते। एक संरचित मूल्यांकन उन मुद्दों को जल्दी उजागर करता है, जब स्विच करना अभी भी सस्ता होता है।
पैमाने पर लंबे समय का नैरेशन तैयार करने वाली टीमों के लिए, Smallest.ai का Lightning TTS API कम-लेटेंसी स्पीच जनरेशन, SSML नियंत्रण, बहुभाषी समर्थन और प्रोडक्शन उपयोग के लिए बनाए गए वॉयस क्लोनिंग वर्कफ़्लो की पेशकश करता है। 100ms से कम लेटेंसी, व्यापक SSML समर्थन और एक पारदर्शी सहमति ढांचे के इर्द-गिर्द निर्मित वॉयस क्लोनिंग के साथ, यह उन विफलता मोड को लक्षित करता है जो ऑडियोबुक पाइपलाइनों को पटरी से उतार देते हैं।
अक्सर पूछे जाने वाले प्रश्न
एआई वॉयस बनाम अधिकृत वॉयस रेप्लिका: ऑडियोबुक्स के लिए क्या अंतर है?
एक सामान्य ऑडियोबुक में कितने वर्ण (characters) होते हैं, और टीटीएस एपीआई (TTS API) शुल्क में उसकी कितनी लागत आती है?
क्या एक ही टीटीएस (TTS) मॉडल फिक्शन (काल्पनिक) और नॉन-फिक्शन (गैर-काल्पनिक) दोनों तरह के वर्णन को अच्छी तरह से संभाल सकता है?
प्रमुख ऑडियोबुक वितरण प्लेटफ़ॉर्म किन ऑडियो विशिष्टताओं (specs) की मांग करते हैं?
स्मॉलेस्ट.एआई (Smallest.ai) का लाइटनिंग एपीआई (Lightning API) लंबी अवधि के ऑडियोबुक विवरण (नरेशन) का समर्थन कैसे करता है?