ElevenLabs बनाम Smallest.ai 2026: आवाज की गुणवत्ता, विलंबता (Latency), और कीमतों की तुलना
डेवलपर्स और टीमों के लिए वॉयस क्वालिटी, लेटेंसी, प्राइसिंग और रीयल-टाइम वॉयस एआई उपयोग के मामलों पर 2026 में ElevenLabs बनाम Smallest.ai की तुलना करें।
'ElevenLabs vs' का सवाल वॉयस एजेंट, संवादात्मक AI उत्पाद और रियल-टाइम ऑडियो पाइपलाइन बनाने वाले डेवलपर्स के बीच लगातार उठता रहता है। ElevenLabs की ब्रांड पहचान मजबूत है और इसकी वॉयस क्वालिटी वाकई प्रभावशाली है। लेकिन पहचान और परफॉर्मेंस एक ही बात नहीं है, खासकर तब जब आपका उत्पाद इस बात पर निर्भर करता है कि पहला ऑडियो बाइट कितनी तेजी से आता है और आप बड़े पैमाने पर कितना भुगतान करते हैं।
यह गाइड वॉयस क्वालिटी, लेटेंसी और प्राइसिंग में वास्तविक अंतरों को स्पष्ट करती है, और फिर प्रत्येक प्लेटफॉर्म को उन उपयोग मामलों से जोड़ती है जहाँ वे वास्तव में फिट बैठते हैं। अंत तक, आपके पास निर्णय लेने के लिए एक स्पष्ट ढांचा होगा, न कि केवल सुविधाओं की एक सूची।
प्रत्येक प्लेटफॉर्म वास्तव में क्या है
ElevenLabs एक वॉयस AI कंपनी है जिसने एक्सप्रेसिव, भावनात्मक रूप से सूक्ष्म टेक्स्ट-टू-स्पीच पर अपनी पहचान बनाई है। उनके मॉडल को लॉन्ग-फॉर्म कंटेंट, ऑडियोबुक्स और डबिंग वर्कफ़्लो में स्वाभाविक लगने वाली आवाज़ तैयार करने के लिए प्रशिक्षित किया गया है। उनका उत्पाद क्षेत्र व्यापक है: वॉयस क्लोनिंग, बहुभाषी TTS, एक संवादात्मक AI लेयर और ऑडियो टूल्स का एक बढ़ता हुआ सुइट।
Smallest.ai को विशेष रूप से रियल-टाइम वॉयस AI के लिए बनाया गया है। इसका मुख्य उत्पाद एक लो-लेटेंसी TTS इंजन है जिसे वॉयस एजेंटों, टेलीफोनी सिस्टम और किसी भी ऐसे एप्लिकेशन में एकीकृत करने के लिए डिज़ाइन किया गया है जहाँ टेक्स्ट इनपुट और ऑडियो आउटपुट के बीच का अंतर कम से कम होना चाहिए। इसका ध्यान पूरी तरह से स्पष्ट और सीमित है: उत्पादन स्तर पर तेज, सटीक, और किफायती स्पीच सिंथिसिस। TTS Benchmark Report: Smallest.ai vs ElevenLabs यह दस्तावेज करता है कि यह फोकस मापने योग्य परफॉर्मेंस अंतरों में कैसे बदलता है।
किसी भी सिंगल मीट्रिक की तुलना करने से पहले इस अंतर को समझना महत्वपूर्ण है। ElevenLabs एक्सप्रेसिवनेस (भाव-अभिव्यक्ति) को बेहतर बनाने पर ध्यान देता है। Smallest.ai बड़े पैमाने पर स्पीड और लागत को कम करने पर ध्यान देता है। दोनों में से कोई भी गलत नहीं है। वे अलग-अलग समस्याओं का समाधान कर रहे हैं, और यह जानना कि आपकी समस्या कौन सी है, सबसे महत्वपूर्ण कदम है।
वॉयस क्वालिटी: वे कहाँ भिन्न हैं और यह क्यों मायने रखता है
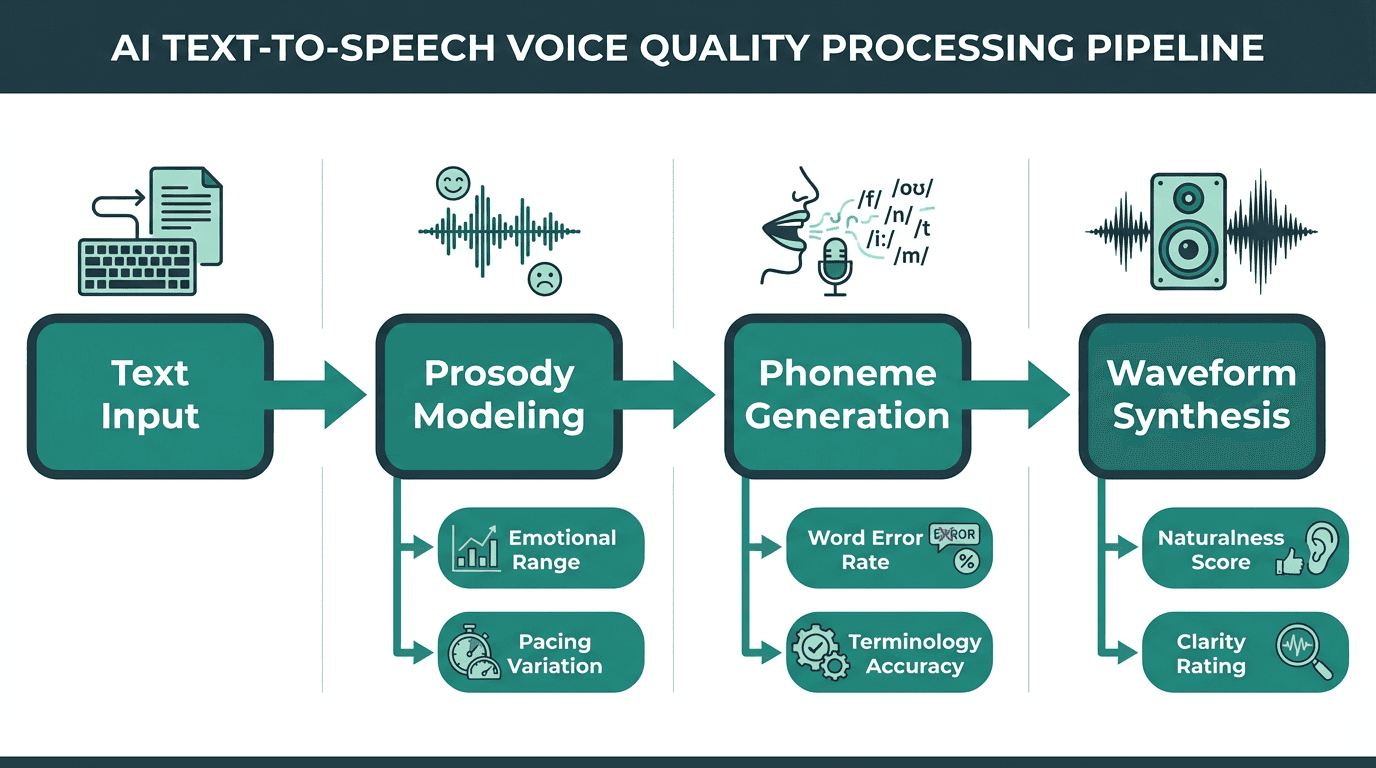
TTS में वॉयस क्वालिटी कई प्रोसेसिंग चरणों का परिणाम होती है, न कि केवल एक सेटिंग का
ElevenLabs कुछ सबसे एक्सप्रेसिव सिंथेटिक आवाज़ें तैयार करता है। उनके मॉडल भावनात्मक दायरे, गति के उतार-चढ़ाव और स्वाभाविक लगने वाले ठहराव को इस तरह से संभालते हैं जो नरेशन और कंटेंट क्रिएशन के लिए अच्छी तरह काम करते हैं। यदि आप कोई ऑडियोबुक बना रहे हैं या किसी वीडियो को डब कर रहे हैं, तो वह एक्सप्रेसिवनेस वास्तव में मूल्यवान है।
हालाँकि, वॉयस एजेंटों के लिए एक्सप्रेसिवनेस क्वालिटी का केवल एक पहलू है। संवादात्मक संदर्भ में छोटे कथनों में निरंतरता, डोमेन-विशिष्ट शब्दावली पर सटीकता और काल्पनिक अजीब आवाज़ों (hallucinated prosody artifacts) की अनुपस्थिति अधिक मायने रखती है। यहाँ Word Error Rate and voice quality को समझना आवश्यक है: एक आवाज जो सुनने में सुंदर लगती है लेकिन उत्पाद के नामों का गलत उच्चारण करती है या संख्याओं पर अटकती है, वह उस साधारण आवाज की तुलना में बदतर उपयोगकर्ता अनुभव पैदा करती है जो शब्दों को सही ढंग से बोलती है।
Smallest.ai के वॉयस मॉडल को बातचीत के दौरान छोटे वाक्यों में स्पष्टता और निरंतरता के लिए ट्यून किया गया है। आवाज़ें बिना नाटकीय हुए स्वाभाविक हैं, जो कि आप बिल्कुल तब चाहते हैं जब कोई वॉयस एजेंट ऑर्डर पुष्टिकरण पढ़ रहा हो या बिलिंग से जुड़े किसी प्रश्न का उत्तर दे रहा हो। TTS Benchmark Report: Smallest.ai vs ElevenLabs दोनों प्लेटफॉर्मों में डेटा-आधारित क्वालिटी तुलना प्रदान करता है, जिसमें 2025 में परीक्षण किए गए स्वाभाविकता स्कोर और निरंतरता मीट्रिक शामिल हैं।
एजेंट की भूमिका के आधार पर वॉयस क्वालिटी की आवश्यकताएं भी बदलती हैं। एक कस्टमर सपोर्ट एजेंट को समस्याओं को शांत करने के लिए स्पष्टता की आवश्यकता होती है, जिससे एक न्यूट्रल और सुसंगत आवाज आदर्श बन जाती है। एक आउटबाउंड सेल्स एजेंट को तालमेल बनाने के लिए अधिक एक्सप्रेसिव, प्रेरक टोन से लाभ हो सकता है। इंटरनल असिस्टेंट टूल, जिनका उपयोग मीटिंग को संक्षेप में प्रस्तुत करने जैसे कार्यों के लिए किया जाता है, पूरी तरह से न्यूट्रल और व्यावहारिक हो सकते हैं। Smallest.ai के मॉडल को सपोर्ट और ऑपरेशनल भूमिकाओं के लिए आवश्यक "हमेशा चालू, न्यूट्रल मददगार स्वभाव" के लिए ट्यून किया गया है, जो विश्वसनीयता और एक अनुमानित उपयोगकर्ता अनुभव सुनिश्चित करता है। इसके विपरीत, एक्सप्रेसिवनेस में ElevenLabs की ताकत कंटेंट क्रिएशन, कैरेक्टर वॉयस और स्टोरीटेलिंग परिदृश्यों के साथ बेहतर तालमेल बिठाती है जहाँ भावनात्मक प्रस्तुति प्राथमिक लक्ष्य होती है।
लेटेंसी: वह संख्या जो रियल-टाइम वॉयस को परिभाषित करती है
टाइम टू फर्स्ट ऑडियो (TTFA) वह मीट्रिक है जो रियल-टाइम के लिए बने प्लेटफॉर्मों को एसिंक (async) के लिए बने प्लेटफॉर्मों से अलग करती है। वॉयस एजेंट की बातचीत में, जोड़ी गई लेटेंसी का हर 100 मिलीसेकंड महसूस किया जा सकता है। 400ms से ऊपर, उपयोगकर्ता ठहराव महसूस करने लगते हैं। 800ms से ऊपर, बातचीत अधूरी या टूटी हुई सी लगती है।
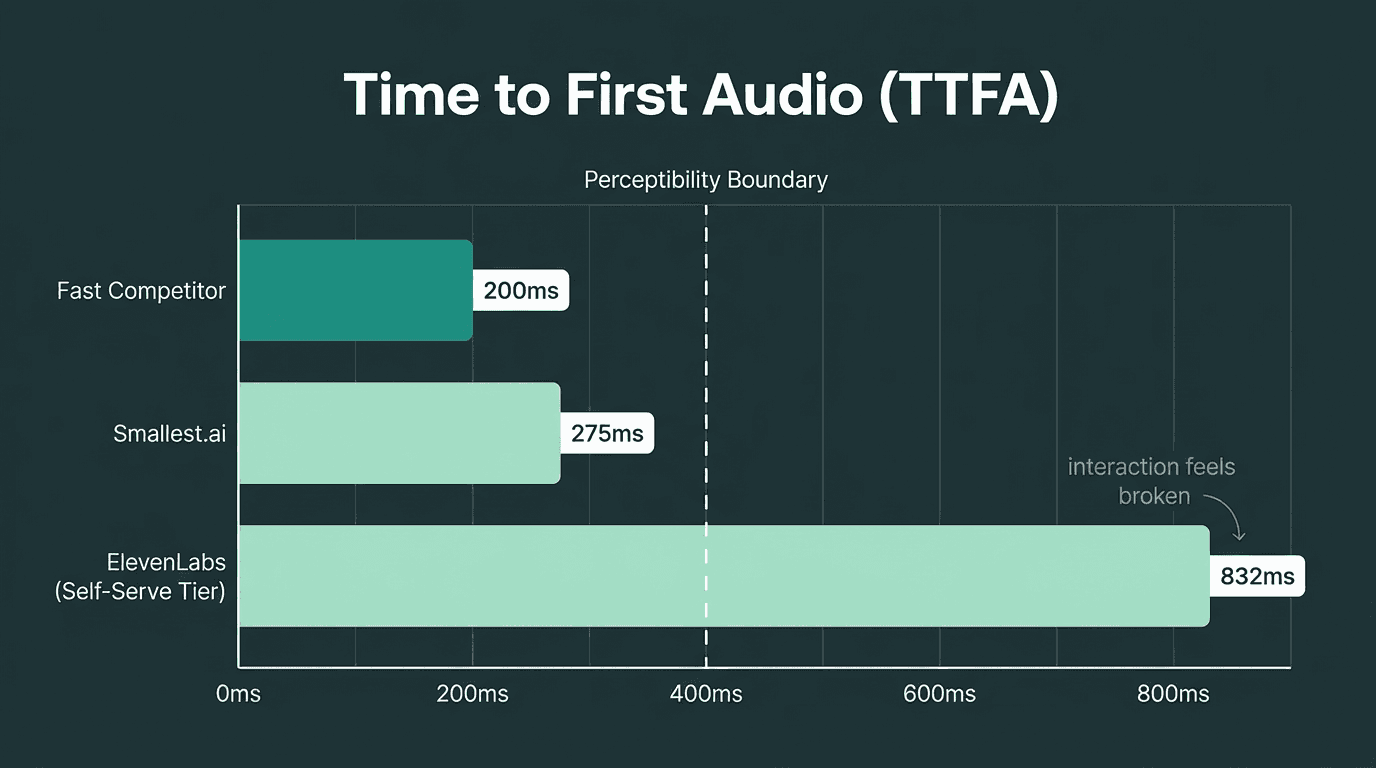
TTFA लेटेंसी सीधे यह निर्धारित करती है कि कोई वॉयस एजेंट रिस्पॉन्सिव महसूस होता है या टूटा हुआ
जैसा कि TTS Benchmark Report: Smallest.ai vs ElevenLabs में प्रलेखित है, सेल्फ-सर्व स्तरों पर ElevenLabs का TTFA 300ms की सीमा से काफी ऊपर है, जिसकी रियल-टाइम वॉयस एजेंटों को स्वाभाविक महसूस होने के लिए आवश्यकता होती है। ElevenLabs तेज़ 'Turbo' विकल्प प्रदान करता है, लेकिन वे वॉयस क्वालिटी में समझौते लाते हैं और विशिष्ट प्लान कॉन्फ़िगरेशन और क्रेडिट मैकेनिक्स के पीछे सीमित हैं।
Smallest.ai को बुनियादी उम्मीद के रूप में 300ms से कम TTFA के आस-पास बनाया गया है, न कि किसी प्रीमियम स्तर के रूप में। आर्किटेक्चर स्ट्रीमिंग डिलीवरी को प्राथमिकता देता है ताकि पूरा वाक्य सिंथिसिस होने से पहले ही ऑडियो बजना शुरू हो जाए। उन डेवलपर्स के लिए जो यह समझना चाहते हैं कि वॉयस उत्पादों में लेटेंसी इतनी महत्वपूर्ण क्यों है, how to solve the voice AI latency problem का विस्तृत विवरण तकनीकी मूल कारणों और उन्हें कम करने की रणनीतियों को कवर करता है।
उपयोगकर्ता के दृष्टिकोण से, ये लेटेंसी नंबर सीधे बातचीत की गुणवत्ता में अनुवादित होते हैं। 300ms से कम का रिस्पॉन्स लगभग तत्काल महसूस होता है, जैसे मानव बातचीत में एक स्वाभाविक मोड़। 500ms पर, एक छोटा लेकिन ध्यान देने योग्य ठहराव होता है जो बातचीत को धीमा महसूस करा सकता है। एक बार जब लेटेंसी 800ms को पार कर जाती है, तो उपयोगकर्ता अक्सर यह मान लेता है कि कनेक्शन टूट गया है या एजेंट "सोच रहा है," और वह बॉट के ऊपर बोलना शुरू कर सकता है, जिससे निराशाजनक बातचीत बाधित हो सकती है। यही कारण है कि लाइव वॉयस एजेंटों के लिए 300ms से कम होना महत्वपूर्ण है। एसिंक्रोनस नोटिफिकेशन के लिए 400-700ms की लेटेंसी स्वीकार्य हो सकती है, जैसे कि वन-वे ऑर्डर स्टेटस अपडेट, लेकिन यह लाइव, इंटरैक्टिव सेटिंग में विफल हो जाती है। 800ms से अधिक की लेटेंसी केवल उन उपयोग मामलों के लिए उपयुक्त है जहाँ उपयोगकर्ता वास्तविक समय में प्रतीक्षा नहीं कर रहे हैं, जैसे बाद में प्लेबैक के लिए ऑडियो फाइलें जनरेट करना।
Smallest.ai लेटेंसी बेंचमार्क देखें और स्वयं API का परीक्षण करें
प्राइसिंग: बड़े पैमाने पर आप वास्तव में क्या भुगतान करते हैं
ElevenLabs क्रेडिट-आधारित प्राइसिंग मॉडल का उपयोग करता है जहाँ मानक मॉडल के लिए आम तौर पर एक करैक्टर एक क्रेडिट के बराबर होता है। प्लान स्तर के आधार पर टर्बो मॉडल की लागत प्रति करैक्टर 0.5 क्रेडिट जितनी कम हो सकती है, जो तब तक छूट की तरह लगती है जब तक आप इस बात पर ध्यान नहीं देते कि टर्बो एक्सेस उच्च मासिक सब्सक्रिप्शन स्तरों के पीछे सीमित है। ElevenLabs' own pricing page क्रेडिट सिस्टम को विस्तार से समझाता है, लेकिन एक बार जब आप क्रेडिट को विभिन्न स्तरों पर प्रति-मिनट या प्रति-करैक्टर दर में बदलते हैं, तो गणित हमेशा सहज नहीं होता है। हमारा आंतरिक विश्लेषण सामान्य उपयोग पैटर्नों में वास्तविक प्रति-मिनट लागतों का मॉडल तैयार करने के लिए उन आधिकारिक नंबरों का उपयोग करता है।
इस गाइड में एक स्पष्ट और निष्पक्ष तुलना के लिए, इस बात पर ध्यान केंद्रित करें कि ElevenLabs और Smallest.ai बड़े पैमाने पर कैसा व्यवहार करते हैं। ElevenLabs की क्रेडिट-आधारित प्राइसिंग का अर्थ है कि जैसे ही आप प्लान स्तरों को पार करते हैं और टर्बो मॉडल सक्षम करते हैं, आपकी प्रभावी प्रति-मिनट दर बदल जाती है, जबकि Smallest.ai एक सरल प्रति-मिनट दर प्रदर्शित करता है जो आपके उपयोग बढ़ने पर भी स्थिर रहती है।
Smallest.ai $0.05 प्रति मिनट से शुरू होने वाली TTS प्राइसिंग प्रदान करता है। प्रति माह 100,000 मिनट के वॉयस आउटपुट को संभालने वाले उत्पाद के लिए, वह प्रति-मिनट का अंतर आपके इंफ्रास्ट्रक्चर बिल में एक महत्वपूर्ण राशि जोड़ देता है। आप अपने स्वयं के उपयोग का मॉडल तैयार करने के लिए सीधे वर्तमान Smallest.ai pricing plans की समीक्षा कर सकते हैं।
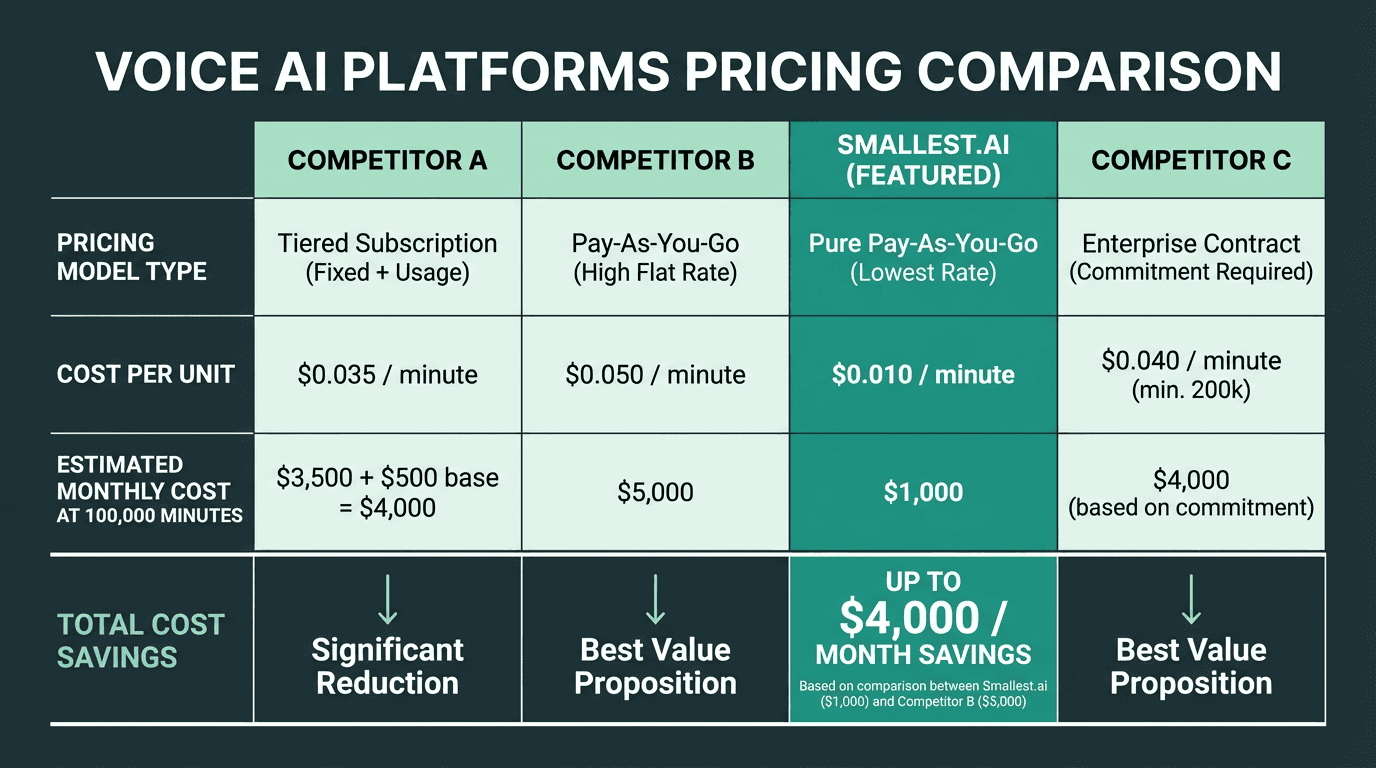
प्राइसिंग के अंतर उत्पादन-स्तर के उपयोग की मात्रा पर काफी बढ़ जाते हैं
उपयोग के मामले के आधार पर सबसे उपयुक्त
यह वह जगह है जहाँ तुलना उपयोगी हो जाती है। सही प्लेटफॉर्म लगभग पूरी तरह से इस बात पर निर्भर करता है कि आप क्या बना रहे हैं।
ElevenLabs कब सही विकल्प है
ElevenLabs तब सबसे उपयुक्त होता है जब आपकी प्राथमिकता गैर-रियल-टाइम डिलीवरी के लिए एक्सप्रेसिव, हाई-फिडेलिटी ऑडियो हो:
ऑडियोबुक उत्पादन और लॉन्ग-फॉर्म नरेशन जहाँ भावनात्मक दायरा मायने रखता है
वीडियो डबिंग और लोकलाइजेशन वर्कफ़्लो जहाँ सिंक और एक्सप्रेसिवनेस महत्वपूर्ण हैं
कंटेंट क्रिएशन टूल्स जहाँ उपयोगकर्ता पॉलिश की हुई ऑडियो सामग्री जनरेट कर रहे हैं, न कि लाइव बातचीत
वॉयस क्लोनिंग प्रोजेक्ट्स जहाँ मूल आवाज़ को उच्च स्पष्टता (high fidelity) के साथ संरक्षित करने की आवश्यकता होती है
प्रोटोटाइपिंग और डेमो जहाँ लेटेंसी कोई बाधा नहीं है और वॉयस क्वालिटी ही मुख्य यूएसपी है
Smallest.ai कब बेहतर विकल्प है
यदि आपके उत्पाद में कोई उपयोगकर्ता वास्तविक समय में वॉयस रिस्पॉन्स की प्रतीक्षा कर रहा है, तो Smallest.ai का आर्किटेक्चर उसी विशिष्ट समस्या के लिए बनाया गया है। कस्टमर सपोर्ट, आउटबाउंड कॉलिंग सिस्टम, IVR प्रतिस्थापन और संवादात्मक AI सहायकों में वॉयस एजेंट सभी इस बात पर निर्भर करते हैं कि TTFA इतना कम हो कि बातचीत स्वाभाविक लगे। एक ऐसे प्लेटफॉर्म के लिए प्रति मिनट तीन गुना अधिक भुगतान करना जिसकी लेटेंसी 4 गुना अधिक है, एक ऐसा कठिन समझौता है जिसे सही ठहराना मुश्किल है जब उपयोगकर्ता अनुभव दोनों ही पहलुओं पर प्रभावित होता है।
विशेष रूप से एंटरप्राइज़ संपर्क केंद्र परिनियोजन के लिए, बड़े पैमाने पर लेटेंसी, लागत और विश्वसनीयता का संयोजन और भी अधिक स्पष्ट हो जाता है। Smallest.ai vs Sierra AI for enterprise contact centers की तुलना यह कवर करती है कि ये विचार उच्च-मात्रा, रियल-टाइम टेलीफोनी वातावरण में कैसे काम करते हैं।
एक ऐसे संपर्क केंद्र पर विचार करें जो प्रति दिन 50,000 इनबाउंड सपोर्ट कॉल को स्वचालित करता है, जिसमें प्रत्येक कॉल औसतन तीन मिनट की होती है। इस मात्रा में, सकारात्मक ग्राहक अनुभव के लिए कम लेटेंसी से समझौता नहीं किया जा सकता है, और परिचालन लागतों के प्रबंधन के लिए अनुमानित प्रति-मिनट प्राइसिंग आवश्यक है। Smallest.ai का मॉडल व्यवसाय को प्रति कॉल एक स्पष्ट, निश्चित लागत की गणना करने की अनुमति देता है। एक क्रेडिट-आधारित, उच्च-लेटेंसी सेटअप न केवल देरी के साथ कॉल करने वालों को निराश करने का जोखिम उठाएगा बल्कि अप्रत्याशित मासिक बिल भी पेश करेगा जो उपयोग पैटर्न और प्लान स्तरों के साथ बदलते रहते हैं। बड़े पैमाने पर निर्माण करने वाली टीमों को किसी प्लेटफॉर्म के प्रति प्रतिबद्ध होने से पहले इन दो मौलिक रूप से भिन्न मॉडलों के विपरीत अपने स्वयं के कॉल वॉल्यूम और लेटेंसी आवश्यकताओं का मूल्यांकन करना चाहिए।
रियल-टाइम वॉयस एजेंट परिनियोजन के लिए Smallest.ai का अन्वेषण करें
अधिकांश तुलनाएँ कहाँ गलत होती हैं
अधिकांश 'ElevenLabs vs' लेख वॉयस सैंपल की तुलना करते हैं और काम पूरा मान लेते हैं। यह वॉयस AI उत्पाद चलाने की परिचालन वास्तविकता को छोड़ देता है। कुछ चीजें जिन पर शायद ही कभी पर्याप्त ध्यान दिया जाता है:
स्ट्रीमिंग आर्किटेक्चर लो-लेटेंसी के समान नहीं है। कुछ प्लेटफॉर्म ऑडियो स्ट्रीम करते हैं लेकिन फिर भी उनका TTFA अधिक होता है क्योंकि मॉडल को जनरेट करना शुरू करने में समय लगता है। वास्तविक लो-लेटेंसी TTS पहले सिंथिसिस पास के भीतर ऑडियो वितरित करना शुरू कर देता है, न कि पूरा वाक्य तैयार होने के बाद। यह एक आर्किटेक्चरल निर्णय है, न कि एक ट्यूनिंग पैरामीटर।
क्रेडिट-आधारित प्राइसिंग वास्तविक लागतों को छुपाती है। जब आप प्रोडक्शन उपयोग के लिए किसी प्लेटफॉर्म का मूल्यांकन कर रहे हों, तो सब कुछ प्रति-मिनट या प्रति-करैक्टर दर में बदलें और अपने वास्तविक उपयोग के विपरीत इसका मॉडल तैयार करें। एक प्लेटफॉर्म जो स्टार्टर स्तर पर किफायती दिखता है, वह उच्च उपयोग बैंड में जाने के बाद महंगा हो सकता है जहाँ प्रति-यूनिट दर बदल जाती है।
छोटे कथनों में वॉयस क्वालिटी लॉन्ग-फॉर्म कंटेंट में वॉयस क्वालिटी से अलग होती है। एक मॉडल जो ऑडियोबुक स्वाभाविकता पर अच्छा स्कोर करता है, वह दो शब्दों की पुष्टि या फोन नंबरों पर अजीब आवाज (prosody) उत्पन्न कर सकता है। अपने वास्तविक कंटेंट प्रकारों का परीक्षण करें, न कि सामान्य डेमो वाक्यों का।
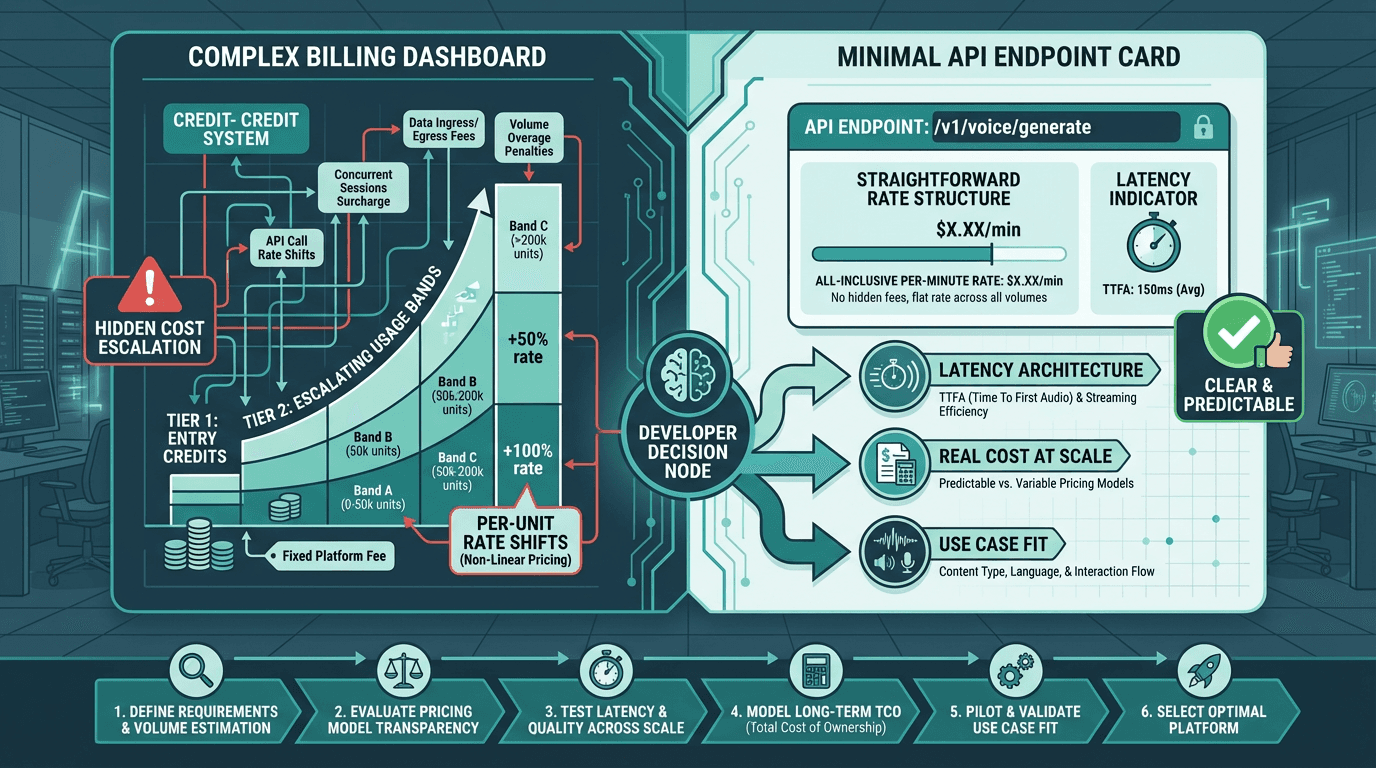
सही प्लेटफॉर्म का चयन आपकी विशिष्ट उत्पादन आवश्यकताओं पर निर्भर करता है, न कि केवल डेमो क्वालिटी पर
मुख्य निष्कर्ष और अगले कदम
ElevenLabs एक्सप्रेसिव, एसिंक वॉयस कंटेंट के लिए एक मजबूत प्लेटफॉर्म है। यदि आप ऐसे ऑडियो एसेट का उत्पादन कर रहे हैं जहाँ श्रोता वास्तविक समय में प्रतीक्षा नहीं कर रहा है, तो वॉयस क्वालिटी वाकई उत्कृष्ट है और टूलींग परिपक्व है। उस संदर्भ में प्राइसिंग और लेटेंसी के समझौते स्वीकार्य हैं।
रियल-टाइम वॉयस AI के लिए, गणित अलग है। 400ms से ऊपर की लेटेंसी उपयोगकर्ता के अनुभव को इस तरह से खराब करती है जिसकी भरपाई वॉयस एक्सप्रेसिवनेस से नहीं की जा सकती। और प्रोडक्शन के पैमाने पर, लागत का 3 गुना अंतर कोई छोटी बात नहीं है। Smallest.ai vs ElevenLabs: A Head-to-Head Comparison पोस्ट विशिष्ट बेंचमार्क डेटा पर गहराई से जाती है यदि आप अपने स्वयं के उपयोग के मामले के विपरीत इन नंबरों को सत्यापित करना चाहते हैं।
यह तुलना जिस समस्या को सामने लाती है वह बिल्कुल स्पष्ट है: रियल-टाइम वॉयस उत्पाद बनाने वाले डेवलपर्स को एक ऐसे TTS इंजन की आवश्यकता होती है जो लाइव महसूस कराने के लिए पर्याप्त तेज़ हो, वास्तविक कंटेंट को संभालने के लिए पर्याप्त सटीक हो, और यूनिट इकोनॉमिक्स को प्रभावित किए बिना स्केल करने के लिए पर्याप्त किफायती हो। यही वह समस्या है जिसे हल करने के लिए Smallest.ai का Lightning TTS मॉडल बनाया गया है। यदि आपका उत्पाद एक वॉयस एजेंट, एक संवादात्मक सहायक, या कोई रियल-टाइम ऑडियो एप्लिकेशन है, तो Smallest.ai मूल्यांकन और प्रोडक्शन परिनियोजन दोनों के लिए अधिक तार्किक प्रारंभिक बिंदु है।
Smallest.ai Lightning TTS आज़माएं और अपने स्वयं के कंटेंट पर लेटेंसी का परीक्षण करें
अक्सर पूछे जाने वाले प्रश्न
क्या आवाज़ की गुणवत्ता के मामले में ElevenLabs, Smallest.ai से बेहतर है?
ElevenLabs और Smallest.ai के बीच लेटेंसी (latency) में क्या अंतर है?
ElevenLabs की मूल्य निर्धारण (pricing) प्रणाली कैसे काम करती है और इसकी तुलना दूसरों से कैसे की जाती है?
क्या मैं ElevenLabs की तरह वॉइस क्लोनिंग के लिए Smallest.ai का उपयोग कर सकता हूँ?
कस्टमर सपोर्ट वॉयस एजेंट के लिए कौन सा प्लेटफॉर्म बेहतर है?