पिछले सप्ताह मैंने वॉयस एजेंट बनाने पर एक टॉक दी थी, और उसके बाद हर कोई जिस विषय पर बात करना चाहता था वह था लाइव डेमो। स्लाइड्स नहीं। डेमो।
तो यह पोस्ट उसी डेमो का लिखित रूप है। इसके अंत तक आपके लैपटॉप पर एक वॉयस एजेंट काम कर रहा होगा जिससे आप ब्राउज़र में बात कर सकते हैं, उसे बीच वाक्य में टोक सकते हैं, और हर बार बात पूरी होने के बाद उसकी लेटेंसी (देरी) को प्रिंट होते देख सकते हैं।
इसका स्टैक पूरी तरह से बदला जा सकता है, लेकिन मैंने किसका उपयोग किया और क्यों, वह यहाँ दिया गया है।
ऑर्केस्ट्रेटर के रूप में Pipecat। यह ओपन सोर्स है, पायथन (Python) पर आधारित है, और पूरा एजेंट एक सूची की तरह पढ़ा जाता है।
स्पीच-टू-टेक्स्ट (आवाज़ से टेक्स्ट) के लिए Smallest AI Pulse और टेक्स्ट-टू-स्पीच (टेक्स्ट से आवाज़) के लिए Lightning v3.1 Pro। वॉयस एजेंट बनाने के लिए ये बेहतरीन मॉडल्स में से एक हैं। दोनों आधिकारिक Pipecat प्लगइन्स हैं, और आप किसी भी एक को केवल एक लाइन कोड से बदल सकते हैं।
LLM के रूप में Claude Haiku 4.5, क्योंकि उस दिन मेरे नेटवर्क पर इसके पहले टोकन की स्पीड सबसे तेज़ थी। इसके बारे में नीचे और विस्तार से बताया गया है।
आइए शुरुआत करते हैं।
एक वॉयस एजेंट केवल बोलने वाला LLM नहीं है
हममें से अधिकांश लोग इसी सोच के साथ शुरुआत करते हैं।
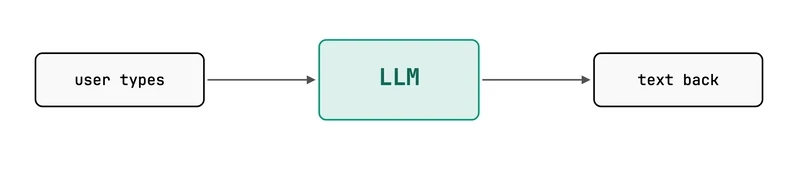
एक बॉक्स। टेक्स्ट इनपुट, टेक्स्ट आउटपुट। LLM ऐप्स बनाने के बारे में आप जो कुछ भी जानते हैं वह इसी के भीतर है।
इसके विपरीत, एक वॉयस एजेंट इस तरह दिखता है।
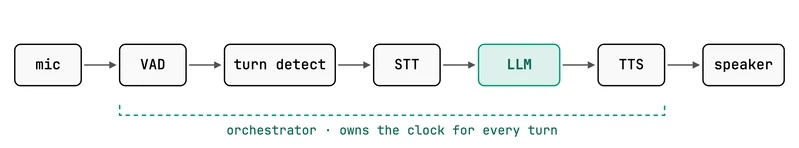
LLM अभी भी बीच में है, लेकिन अब यह वॉयस एक्टिविटी डिटेक्शन, टर्न डिटेक्शन, स्पीच-टू-टेक्स्ट, टेक्स्ट-टू-स्पीच और एक रियल-टाइम ट्रांसपोर्ट से घिरा हुआ है। और यहाँ एक घड़ी भी है। इंसान औसतन दस भाषाओं में बात पूरी होने के बीच लगभग 200 ms का अंतर छोड़ते हैं (Stivers et al., PNAS 2009)। हम नेटवर्क हॉप्स के रहते 200 ms के समय को नहीं छू पाएंगे, लेकिन इसके बाद बीतने वाला हर एक मिलीसेकंड महसूस होता है।
इस सेक्शन से जो मुख्य बात सीखने वाली है वह यह है कि वॉयस AI की हर मुश्किल चीज़ तीरों (arrows) में है, न कि बॉक्सों में। अच्छे मॉडल्स चुनना मायने रखता है, लेकिन उनके बीच की टाइमिंग ही असली इंजीनियरिंग है।
हर चीज़ को स्ट्रीम होना क्यों ज़रूरी है
यदि प्रत्येक चरण पिछले चरण के समाप्त होने की प्रतीक्षा करता है, तो आप उनकी पूरी अवधि जोड़ देते हैं।
record → transcribe → think → synthesize → play      (धीमा, हर चरण प्रतीक्षा करता है)
stream → stream     → stream → stream     → stream   (तेज़, कोई भी चरण खत्म होने की प्रतीक्षा नहीं करता)
record → transcribe → think → synthesize → play      (धीमा, हर चरण प्रतीक्षा करता है)
stream → stream     → stream → stream     → stream   (तेज़, कोई भी चरण खत्म होने की प्रतीक्षा नहीं करता)
record → transcribe → think → synthesize → play      (धीमा, हर चरण प्रतीक्षा करता है)
stream → stream     → stream → stream     → stream   (तेज़, कोई भी चरण खत्म होने की प्रतीक्षा नहीं करता)
एक स्ट्रीमिंग पाइपलाइन में, जब आप बात कर ही रहे होते हैं तभी स्पीच-टू-टेक्स्ट आंशिक ट्रांसक्रिप्ट देना शुरू कर देता है, LLM टोकन स्ट्रीम करता है, और टेक्स्ट-टू-स्पीच उत्तर के पहले हिस्से पर ही बोलना शुरू कर देता है। यही कारण है कि TTS के लिए जो मीट्रिक सबसे अधिक मायने रखता है वह टाइम टू फर्स्ट बाइट (TTFB) है, न कि कुल सिंथेसिस समय। जैसे ही पहला ऑडियो आता है, यूज़र सुनना शुरू कर देता है जबकि बाकी का हिस्सा पीछे जेनरेट हो रहा होता है।
Pipecat यह सब आपके लिए संभालता है। आपका काम सही बॉक्सों को सही क्रम में रखना है।
सेटअप
आपको पायथन (Python) 3.11 या नया वर्शन, एक Smallest AI API की (key) और एक Anthropic API की की आवश्यकता होगी।
mkdir voice-agent && cd voice-agent
python3 -m venv venv
source venv/bin/activate
pip install "pipecat-ai[smallest,anthropic,silero,webrtc,runner]>=1.6.0"
mkdir voice-agent && cd voice-agent
python3 -m venv venv
source venv/bin/activate
pip install "pipecat-ai[smallest,anthropic,silero,webrtc,runner]>=1.6.0"
mkdir voice-agent && cd voice-agent
python3 -m venv venv
source venv/bin/activate
pip install "pipecat-ai[smallest,anthropic,silero,webrtc,runner]>=1.6.0"
अपनी कीज़ (keys) को एक .env फ़ाइल में रखें।
SMALLEST_API_KEY=your_smallest_key
ANTHROPIC_API_KEY
SMALLEST_API_KEY=your_smallest_key
ANTHROPIC_API_KEY
SMALLEST_API_KEY=your_smallest_key
ANTHROPIC_API_KEY
ये एक्स्ट्रा चीज़ें मायने रखती हैं। smallest Pulse और Lightning सर्विसेज़ लाता है, anthropic LLM लाता है, silero वॉयस एक्टिविटी डिटेक्टर लाता है, और webrtc तथा runner आपको एक लोकल ब्राउज़र क्लाइंट और डेव सर्वर प्रदान करते हैं ताकि आपको कोई फ्रंटएंड न बनाना पड़े।
पूरा एजेंट
यहाँ पूरी bot.py फ़ाइल दी गई है। यह लगभग 100 लाइनों की है, और इसके ठीक बाद मैं इसके दिलचस्प हिस्सों के बारे में बताऊंगा।
import os
from dotenv import load_dotenv
from loguru import logger
from pipecat.audio.vad.silero import SileroVADAnalyzer
from pipecat.frames.frames import Frame, LLMRunFrame, MetricsFrame
from pipecat.metrics.metrics import TTFBMetricsData
from pipecat.pipeline.pipeline import Pipeline
from pipecat.pipeline.runner import PipelineRunner
from pipecat.pipeline.task import PipelineParams, PipelineTask
from pipecat.processors.aggregators.llm_context import LLMContext
from pipecat.processors.aggregators.llm_response_universal import LLMContextAggregatorPair
from pipecat.processors.frame_processor import FrameDirection, FrameProcessor
from pipecat.runner.types import RunnerArguments
from pipecat.runner.utils import create_transport
from pipecat.services.anthropic.llm import AnthropicLLMService
from pipecat.services.smallest.stt import SmallestSTTService
from pipecat.services.smallest.tts import SmallestTTSService, SmallestTTSSettings
from pipecat.transports.base_transport import BaseTransport, TransportParams
load_dotenv(override=True)
SYSTEM_PROMPT = """You are Pixel, a friendly voice assistant.
You are speaking out loud, so follow these rules.
- Never use bullet points, markdown, emoji or headings.
- Keep answers to one or two short sentences.
- Say numbers and dates the way a person would say them.
- If you get interrupted, answer the new question naturally."""
class LatencyMeter(FrameProcessor):
"""Prints time-to-first-byte for every service, every turn."""
async def process_frame(self, frame: Frame, direction: FrameDirection):
await super().process_frame(frame, direction)
if isinstance(frame, MetricsFrame):
for d in frame.data:
if isinstance(d, TTFBMetricsData) and d.value > 0:
name = d.processor.split("#")[0].replace("Service", "")
logger.info(f"⏱ {name:<14} time-to-first-byte {d.value * 1000:6.0f} ms")
await self.push_frame(frame, direction)
async def run_bot(transport: BaseTransport, runner_args: RunnerArguments):
stt = SmallestSTTService(api_key=os.getenv("SMALLEST_API_KEY"))
llm = AnthropicLLMService(
api_key=os.getenv("ANTHROPIC_API_KEY"),
settings=AnthropicLLMService.Settings(model="claude-haiku-4-5-20251001"),
)
tts = SmallestTTSService(
api_key=os.getenv("SMALLEST_API_KEY"),
settings=SmallestTTSSettings(voice="meher"),
)
context = LLMContext(
[
{"role": "system", "content": SYSTEM_PROMPT},
{"role": "user", "content": "Say hello in one short sentence."},
]
)
ctx = LLMContextAggregatorPair(context)
pipeline = Pipeline(
[
transport.input(),
stt,
ctx.user(),
llm,
tts,
LatencyMeter(),
transport.output(),
ctx.assistant(),
]
)
task = PipelineTask(pipeline, params=PipelineParams(enable_metrics=True))
@transport.event_handler("on_client_connected")
async def on_client_connected(transport, client):
await task.queue_frames([LLMRunFrame()])
@transport.event_handler("on_client_disconnected")
async def on_client_disconnected(transport, client):
await task.cancel()
await PipelineRunner(handle_sigint=runner_args.handle_sigint).run(task)
async def bot(runner_args: RunnerArguments):
transport = await create_transport(
runner_args,
{
"webrtc": lambda: TransportParams(
audio_in_enabled=True,
audio_out_enabled=True,
vad_analyzer=SileroVADAnalyzer(),
),
},
)
await run_bot(transport, runner_args)
if __name__ == "__main__":
from pipecat.runner.run import main
main()import os
from dotenv import load_dotenv
from loguru import logger
from pipecat.audio.vad.silero import SileroVADAnalyzer
from pipecat.frames.frames import Frame, LLMRunFrame, MetricsFrame
from pipecat.metrics.metrics import TTFBMetricsData
from pipecat.pipeline.pipeline import Pipeline
from pipecat.pipeline.runner import PipelineRunner
from pipecat.pipeline.task import PipelineParams, PipelineTask
from pipecat.processors.aggregators.llm_context import LLMContext
from pipecat.processors.aggregators.llm_response_universal import LLMContextAggregatorPair
from pipecat.processors.frame_processor import FrameDirection, FrameProcessor
from pipecat.runner.types import RunnerArguments
from pipecat.runner.utils import create_transport
from pipecat.services.anthropic.llm import AnthropicLLMService
from pipecat.services.smallest.stt import SmallestSTTService
from pipecat.services.smallest.tts import SmallestTTSService, SmallestTTSSettings
from pipecat.transports.base_transport import BaseTransport, TransportParams
load_dotenv(override=True)
SYSTEM_PROMPT = """You are Pixel, a friendly voice assistant.
You are speaking out loud, so follow these rules.
- Never use bullet points, markdown, emoji or headings.
- Keep answers to one or two short sentences.
- Say numbers and dates the way a person would say them.
- If you get interrupted, answer the new question naturally."""
class LatencyMeter(FrameProcessor):
"""Prints time-to-first-byte for every service, every turn."""
async def process_frame(self, frame: Frame, direction: FrameDirection):
await super().process_frame(frame, direction)
if isinstance(frame, MetricsFrame):
for d in frame.data:
if isinstance(d, TTFBMetricsData) and d.value > 0:
name = d.processor.split("#")[0].replace("Service", "")
logger.info(f"⏱ {name:<14} time-to-first-byte {d.value * 1000:6.0f} ms")
await self.push_frame(frame, direction)
async def run_bot(transport: BaseTransport, runner_args: RunnerArguments):
stt = SmallestSTTService(api_key=os.getenv("SMALLEST_API_KEY"))
llm = AnthropicLLMService(
api_key=os.getenv("ANTHROPIC_API_KEY"),
settings=AnthropicLLMService.Settings(model="claude-haiku-4-5-20251001"),
)
tts = SmallestTTSService(
api_key=os.getenv("SMALLEST_API_KEY"),
settings=SmallestTTSSettings(voice="meher"),
)
context = LLMContext(
[
{"role": "system", "content": SYSTEM_PROMPT},
{"role": "user", "content": "Say hello in one short sentence."},
]
)
ctx = LLMContextAggregatorPair(context)
pipeline = Pipeline(
[
transport.input(),
stt,
ctx.user(),
llm,
tts,
LatencyMeter(),
transport.output(),
ctx.assistant(),
]
)
task = PipelineTask(pipeline, params=PipelineParams(enable_metrics=True))
@transport.event_handler("on_client_connected")
async def on_client_connected(transport, client):
await task.queue_frames([LLMRunFrame()])
@transport.event_handler("on_client_disconnected")
async def on_client_disconnected(transport, client):
await task.cancel()
await PipelineRunner(handle_sigint=runner_args.handle_sigint).run(task)
async def bot(runner_args: RunnerArguments):
transport = await create_transport(
runner_args,
{
"webrtc": lambda: TransportParams(
audio_in_enabled=True,
audio_out_enabled=True,
vad_analyzer=SileroVADAnalyzer(),
),
},
)
await run_bot(transport, runner_args)
if __name__ == "__main__":
from pipecat.runner.run import main
main()पाइपलाइन ही आरेख (diagram) है
Pipeline([...]) सूची को ऊपर से नीचे तक पढ़ें। यह सचमुच पहले दिखाया गया आरेख ही है।
ऑडियो ट्रांसपोर्ट से आता है, स्पीच-टू-टेक्स्ट इसे शब्दों में बदलता है, यूज़र एग्रीगेटर उन शब्दों को बातचीत के इतिहास में जोड़ता है, LLM एक उत्तर स्ट्रीम करता है, TTS उस उत्तर को ऑडियो में बदलता है, और ट्रांसपोर्ट इसे चलाता है (प्ले करता है)। फ्रेम्स सूची में नीचे की ओर बढ़ते हैं, और प्रत्येक प्रोसेसर केवल उन फ्रेम्स पर ध्यान देता है जिन्हें वह समझता है।
मैं चाहता हूँ कि आप आखिरी लाइन, ctx.assistant() पर ध्यान दें। यह स्पीकर के बाद आती है, LLM के बाद नहीं। यह जानबूझकर किया गया है, और इसी वजह से रुकावटें (interruptions) ठीक से काम करती हैं। मैं इस पर वापस आऊंगा।
सिस्टम प्रॉम्प्ट को सुनने के अनुकूल लिखा गया है
एक अच्छा टेक्स्ट प्रॉम्प्ट बुलेट पॉइंट्स, मार्कडाउन और लंबे विस्तृत उत्तर देता है। लेकिन ज़ोर से बोलने पर, वह 45 सेकंड का एकालाप (monologue) बन जाता है जिसे यूज़र चौथे सेकंड में ही टोक देता है। इसलिए वॉयस प्रॉम्प्ट फ़ॉर्मेटिंग को मना करता है, उत्तरों को छोटा रखता है और संख्याओं को वैसे बोलने के लिए कहता है जैसे लोग बोलते हैं। जैसे "$1,234.56" को "वन थाउजेंड टू हंड्रेड थर्टी फोर डॉलर्स एंड फिफ्टी सिक्स सेंट्स" के रूप में आना चाहिए, न कि "डॉलर साइन वन कॉमा टू थ्री फोर" की तरह।
VAD ट्रांसपोर्ट पर रहता है
SileroVADAnalyzer() को ट्रांसपोर्ट में पास किया जाता है, न कि इसे एक अलग चरण के रूप में जोड़ा जाता है। VAD एक छोटा मॉडल है जो केवल एक प्रश्न का उत्तर देता है, "क्या इस समय कोई बोल रहा है?"। यह आगे की सभी गतिविधियों को नियंत्रित करता है, और इसी के ज़रिए एजेंट यह जान पाता है कि आप उसके बोलते समय ही बीच में बोल रहे हैं।
लेटेंसी मीटर
LatencyMeter एक बहुत छोटा कस्टम प्रोसेसर है। जब आप enable_metrics=True सेट करते हैं, तो Pipecat पहले से ही प्रत्येक सर्विस के लिए टाइम-टू-फर्स्ट-बाइट को मापता है। यह प्रोसेसर बस उन मैट्रिक्स को पकड़ता है जब वे वहाँ से गुज़रते हैं और उन्हें प्रिंट कर देता है। यह इस फ़ाइल की सबसे उपयोगी 15 लाइनें हैं, क्योंकि यह "यह धीमा महसूस हो रहा है" को हर चरण के एक सटीक आंकड़े (नंबर) में बदल देता है।
इसे चलाएं
http://localhost:7860 खोलें, Connect पर क्लिक करें और माइक्रोफ़ोन की अनुमति दें। पिक्सेल (Pixel) आपका स्वागत करेगा।
हेडफ़ोन पहनें। मैं इसे लेकर बहुत गंभीर हूँ। उनके बिना, एजेंट आपके लैपटॉप के माइक से अपनी ही आवाज़ सुनता है, उसे लगता है कि कोई बात करने लगा है और वह सुनने के लिए रुक जाता है। खुद को ही।
प्रोडक्शन में, ब्राउज़र इको कैंसलेशन WebRTC के ज़रिए इसे आपके लिए संभाल लेता है। लेकिन डेवलपमेंट के दौरान आपके लैपटॉप पर, हेडफ़ोन ही इसका समाधान हैं।
इसे बीच में रोकें (टोकें)
पिक्सेल से कहें कि वह आपको एक रोबोट की कहानी सुनाए जो गाना सीखता है। उसे कुछ सेकंड तक बोलने दें, फिर उसके ऊपर बोलते हुए कुछ और पूछें।
यह तुरंत रुक जाता है और नए सवाल का जवाब देता है। इसे बार्ज-इन (barge-in) कहते हैं, और यहाँ अभी दो चीज़ें हुईं।
VAD ने आपको सुना, और Pipecat ने प्रोसेस हो रहे LLM और TTS के काम को रद्द कर दिया और प्लेबैक रोक दिया।
बातचीत के इतिहास (history) में केवल कहानी का वही हिस्सा शामिल है जो वास्तव में आपको सुनाया गया था।
दूसरा बिंदु वॉयस एजेंट्स में आने वाला एक सूक्ष्म बग (बारीक गलती) है। यदि आपकी हिस्ट्री कहती है कि एजेंट ने पूरा वाक्य बोला था, तो एजेंट अब उन बातों पर विश्वास करने लगेगा जो यूज़र ने कभी सुनी ही नहीं। कल्पना कीजिए कि उसने कहा "मैं इसे मंगलवार को दोपहर 3 बजे के लिए बुक कर सकता हूँ और एक पुष्टिकरण भेज सकता हूँ" और आपने उसे "मंगलवार" पर ही रोक दिया। आपकी हिस्ट्री अब दावा करेगी कि दोपहर 3 बजे के लिए सहमति बन गई थी।
इसीलिए ctx.assistant() को transport.output() के बाद रखा जाता है। यह उसे रिकॉर्ड करता है जो बोला गया था, न कि उसे जो जेनरेट किया गया था।
लेटेंसी पढ़ें
हर बार बात पूरी होने के बाद टर्मिनल कुछ इस तरह प्रिंट करता है। ये बेंगलुरु में मेरे लैपटॉप से, लोकलहोस्ट पर WebRTC के माध्यम से मिले वास्तविक आंकड़े हैं।
⏲️  AnthropicLLM   time-to-first-byte    874 ms
⏲️  SmallestTTS    time-to-first-byte    180 ms
⏲️  AnthropicLLM   time-to-first-byte    874 ms
⏲️  SmallestTTS    time-to-first-byte    180 ms
⏲️  AnthropicLLM   time-to-first-byte    874 ms
⏲️  SmallestTTS    time-to-first-byte    180 ms
उस दिन कुछ बार चलाने पर, Claude Haiku का पहला टोकन 0.6 से 1.0 सेकंड के बीच आया और Lightning का पहला ऑडियो बाइट 150 से 250 ms के बीच आया। यह एक लैपटॉप और एक नेटवर्क का परिणाम है, इसलिए इसे मापने के एक उदाहरण के रूप में देखें, न कि किसी अंतिम बेंचमार्क के रूप में। जब मैंने दिन की शुरुआत में VPN चालू किया था, तो यही कोड स्पष्ट रूप से धीमा था। आपका नेटवर्क आपके लेटेंसी बजट का एक हिस्सा है।
इन लाइनों को करीब से देखने से मैंने कुछ बातें सीखीं।
LLM आमतौर पर सबसे बड़ा हिस्सा होता है। मेरे टेस्ट में यह हर बार TTS के आंकड़े से कई गुना अधिक था।
मॉडल के चयन को खुद मापें, पहले से मान न लें। टॉक की सुबह मेरी OpenAI की (key) ने काम करना बंद कर दिया था, इसलिए मैंने Claude का इस्तेमाल किया। चूंकि मेरे पास दोनों थे, मैंने उन्हें मापा। उस दिन मेरे नेटवर्क से, gpt-4o-mini का पहला टोकन आने में 2.3 से 3.0 सेकंड का समय लगा और उसी हेडलेस टेस्ट में Claude Haiku 4.5 को 1.2 से 1.7 सेकंड का समय लगा। आपके क्षेत्र में यह परिणाम बदल सकता है, और यही कारण है कि यह मीटर यहाँ मौजूद है।
इस सेटअप में स्पीच-टू-टेक्स्ट TTFB लाइन के रूप में नहीं दिखता है, क्योंकि स्ट्रीमिंग STT अलग तरीके से रिपोर्ट करता है। यह मीटर शून्य (0) वैल्यूज़ को फ़िल्टर कर देता है ताकि आप भ्रमित करने वाला "0 ms" न पढ़ें।
यदि आप एक सिंगल टारगेट चाहते हैं, तो Voice AI & Voice Agents प्राइमर के जून 2026 के संस्करण में 1.5 सेकंड की वॉयस-टू-वॉयस लेटेंसी को "हासिल करने के लिए एक महत्वपूर्ण लक्ष्य" कहा गया है। फिर अपने p95 को मापें, न कि अपने औसत को। औसत धीमी कॉल्स को छिपा देता है, और लोग उन्हीं को याद रखते हैं।
एक लाइन में मॉडल बदलें
इस एजेंट का हर मॉडल केवल एक लाइन का है। किसी दूसरी Smallest आवाज़ को आजमाने के लिए, TTS लाइन बदलें।
tts = SmallestTTSService(
    api_key=os.getenv("SMALLEST_API_KEY"),
    settings=SmallestTTSSettings(voice="nolan"),
)
tts = SmallestTTSService(
api_key=os.getenv("SMALLEST_API_KEY"),
settings=SmallestTTSSettings(voice="nolan"),
)tts = SmallestTTSService(
api_key=os.getenv("SMALLEST_API_KEY"),
settings=SmallestTTSSettings(voice="nolan"),
)कोई दूसरा LLM चाहते हैं? llm = ... लाइन को किसी अन्य Pipecat LLM सर्विस से बदल दें। दूसरा स्पीच-टू-टेक्स्ट वेंडर चाहिए? वही तरीका अपनाएं। रीस्टार्ट करें, दोबारा कनेक्ट करें, और ध्यान दें कि आपने पाइपलाइन को बिल्कुल नहीं छुआ।
यही एक ऑर्केस्ट्रेटर का पूरा उद्देश्य है। मॉडल्स आपस में बदले जा सकने वाले हिस्से हैं। लेकिन वह लूप (loop) ही असली इंजीनियरिंग है जो आपकी अपनी है।
Pipecat या LiveKit?
लोग हमेशा यह सवाल पूछते हैं। दोनों ही अच्छे, ओपन सोर्स ऑर्केस्ट्रेटर हैं। किसी एक को चुनें, आप कभी भी दोनों को एक साथ नहीं चलाते। Pipecat प्रोसेसर्स की एक पाइपलाइन है जिसे आप पायथन में तैयार करते हैं, यही वजह है कि ऊपर दिया गया एजेंट एक सूची की तरह पढ़ा जाता है। LiveKit Agents को LiveKit के मीडिया सर्वर के इर्द-गिर्द बनाया गया है और इसमें आप stt, llm और tts के साथ एक AgentSession परिभाषित करते हैं। Smallest के पास LiveKit के लिए भी एक आधिकारिक प्लगइन है (livekit-plugins-smallestai), इसलिए यही मॉडल विकल्प वहाँ भी काम करेंगे।
आगे क्या है
अब आपके पास लगभग 100 लाइनों में बार्ज-इन और लेटेंसी रीडआउट वाला एक स्ट्रीमिंग वॉयस एजेंट है। अगली पोस्ट में हम इसी एजेंट को एक वास्तविक फ़ोन नंबर पर सेट करेंगे। पाइपलाइन वही रहेगी और केवल ट्रांसपोर्ट बदलेगा। उसके बाद, मैं वॉयस एजेंट्स के कठिन हिस्सों (एंडपॉइंटिंग, इको, टूल-कॉल लेटेंसी, 8 kHz फ़ोन ऑडियो) और इस सबको प्रोडक्शन में कैसे ले जाएं, इस बारे में बात करूंगा।
यदि आप इसके साथ कुछ बनाते हैं, तो मुझे टैग करें, मुझे इसे देखना बहुत पसंद आएगा।
संदर्भ (References)

