कम-संसाधन वाली भाषाओं के लिए सबसे अच्छा स्पीच-टू-टेक्स्ट API चुनें

भाषाओं की संख्या महज़ एक मार्केटिंग का आंकड़ा है। डब्लूईआर (WER) को बेंचमार्क करने, मूल्यांकन कॉर्पस बनाने और प्रोडक्शन में टिकने वाले एसटीटी (STT) एपीआई को चुनने के लिए संपर्क केंद्र (कॉन्टैक्ट सेंटर) की एक गाइड।
कम-संसाधन वाली भाषाओं (low-resource languages) के लिए सबसे अच्छा स्पीच-टू-टेक्स्ट (STT) API चुनना कोई ऐसा सवाल नहीं है जिसका जवाब आप किसी वेंडर के समर्थित-भाषाओं वाले पेज को पढ़कर दे सकें। भाषाओं की संख्या एक मार्केटिंग नंबर है। वास्तव में मायने यह रखता है कि क्या मॉडल आपके ऑडियो पर, आपके डोमेन में, और आपके वक्ताओं के बीच स्वीकार्य वर्ड एरर रेट (WER) देता है या नहीं। यह गाइड एक एंटरप्राइज़ कांटेक्ट सेंटर टीम को हर चरण में मदद करती है: स्ट्रीमिंग या बैच डिप्लॉयमेंट मोड चुनना, एक मजबूत मूल्यांकन कॉर्पस बनाना, कम ट्रेनिंग डेटा को बढ़ाना, अनुकूलन (adaptation) रणनीतियों को लागू करना और प्रोडक्शन में सटीकता की निगरानी करना।
यह किसके लिए है: कांटेक्ट सेंटर इंजीनियरिंग और ऑपरेशंस टीमें जो सीमित ट्रेनिंग डेटा वाली भाषाओं (क्षेत्रीय बोलियां, अल्पसंख्यक भाषाएं, अत्यधिक कोड-मिश्रित भाषण) के लिए STT इंफ्रास्ट्रक्चर का मूल्यांकन कर रही हैं।
स्ट्रीमिंग बनाम बैच: बेंचमार्क करने से पहले सही मोड चुनना
दो मेट्रिक्स यह तय करते हैं कि कौन सा डिप्लॉयमेंट मोड आपके वर्कफ़्लो के अनुकूल है।
TTFR (टाइम-टू-फर्स्ट-रिजल्ट): भाषण शुरू होने के कितने समय बाद आपको पहला ट्रांसक्रिप्ट टोकन मिलता है। यह लाइव एजेंट सहायता, रीयल-टाइम कैप्शन और इंटरप्ट डिटेक्शन के लिए प्रासंगिक है।
RTF (रीयल-टाइम फैक्टर): कुल प्रोसेसिंग समय को ऑडियो की अवधि से विभाजित करने पर प्राप्त मूल्य। RTF < 1.0 का मतलब है कि सिस्टम ऑडियो चलने की तुलना में तेज़ी से ट्रांसक्राइब करता है। बैच QA के लिए, RTF ही थ्रूपुट को सीमित करता है।
लाइव कांटेक्ट सेंटर के काम (एजेंट सहायता, लाइव कैप्शन, रीयल-टाइम सेंटिमेंट एस्केलेशन) के लिए, आपको एक स्ट्रीमिंग वेबसॉकेट (WebSocket) कनेक्शन की आवश्यकता होती है जहां TTFR 200ms से काफी कम हो। Smallest का Waves Pulse रीयल-टाइम मोड लगभग 64ms TTFR को लक्षित करता है, जो वेबसॉकेट के माध्यम से 4096-बाइट चंक्स में 50-100ms के अंतराल पर 16kHz पर linear16 के रूप में एन्कोडेड ऑडियो स्ट्रीम करता है। यह बिना किसी ध्यान देने योग्य देरी के डाउनस्ट्रीम एजेंट-सहायता लॉजिक को फीड करने के लिए पर्याप्त कम है।
ऐतिहासिक QA, अनुपालन ऑडिट (compliance audit), या कॉर्पस-व्यापी वेंडर तुलना के लिए, बैच मोड सही विकल्प है। HTTPS POST एंडपॉइंट का उपयोग करें और फ़ाइलों को एसिंक्रोनस रूप से प्रोसेस करें।
Smallest वॉयस एजेंट Bearer API की ऑथेंटिकेशन और लंबे समय तक चलने वाले कामों के लिए एसिंक वेबहुक सपोर्ट के साथ /waves/v1/tts प्रदान करता है, यहाँ एक नमूना स्निपेट दिया गया है।
भाषा रूटिंग पर नोट: अधिकांश प्रबंधित (managed) APIs आपको एक विशिष्ट भाषा कोड पिन करने या स्वचालित पहचान (automatic detection) को सक्षम करने की अनुमति देते हैं। कम-संसाधन वाली भाषाओं के लिए, स्वचालित पहचान अतिरिक्त भिन्नता पैदा कर सकती है क्योंकि मॉडल कम डेटा वाली भाषाओं को उनकी अधिक-संसाधन वाली मिलती-जुलती भाषाओं के रूप में गलत पहचान सकता है। ISO 639-1 कोड को पिन करने से वह भिन्नता कम हो जाती है। यदि आपका कांटेक्ट सेंटर वास्तव में बहुभाषी ट्रैफ़िक को संभालता है (जैसे, किसी क्षेत्रीय भाषा और अंग्रेजी के बीच कोड-स्विचिंग), तो मल्टी-लैंग्वेज डिटेक्शन पैरामीटर का उपयोग करें (जिसे Smallest AI Wave TTS 32 से अधिक भाषाओं में प्रदान करता है) और पूरे कॉर्पस का औसत निकालने के बजाय प्रत्येक भाषा के लिए अलग-अलग WER मापें।
व्यावहारिक सिफारिश: यह पुष्टि करने के लिए कि TTFR और RTF सहनशीलता के भीतर हैं, सबसे पहले लाइव कॉल पर 30 मिनट का स्ट्रीमिंग पायलट चलाएं। किसी भी वेंडर या अनुकूलन (adaptation) रणनीति को अंतिम रूप देने से पहले सांख्यिकीय रूप से स्थिर WER/CER नंबर उत्पन्न करने के लिए अपने पूरे मूल्यांकन कॉर्पस पर एक बैच चलाएं।
एक छोटा मूल्यांकन कॉर्पस बनाना जो वास्तव में आपकी भाषा को मापता हो
किसी वेंडर का भाषा समर्थन पेज आपको केवल यह बताता है कि मॉडल को उस भाषा के कुछ डेटा पर ट्रेन किया गया था। यह आपके ऑडियो पर सटीकता के बारे में कुछ नहीं बताता। अपना खुद का कॉर्पस बनाएं।
आकार का लक्ष्य: प्रति उपयोग के मामले (use case) में 50-200 ऑडियो फ़ाइलें। शुरुआती चरण के लिए छोटा आकार भी स्वीकार्य है; 30 से कम फ़ाइलें होने पर WER अनुमान अविश्वसनीय हो जाते हैं क्योंकि एक अकेला विसंगत परिणाम (outlier) पूरे औसत को बिगाड़ देता है। Waves मूल्यांकन गाइड एक व्यावहारिक शुरुआती बिंदु के रूप में इसी 50-200 की सीमा का उपयोग करती है।
कवर करने के लिए कॉर्पस मैट्रिक्स:
सत्यापित संदर्भ ट्रांसक्रिप्ट (मानव-समीक्षित, न कि ऑटो-जेनरेटेड)
यदि आपके उपयोग के मामले में बहु-पक्षीय कॉल शामिल हैं तो वक्ता (speaker) लेबल
यदि आपको अलाइनमेंट सत्यापन की आवश्यकता है तो शब्द या वाक्य टाइमस्टैम्प
मेटाडेटा टैग: रिकॉर्डिंग वातावरण (फोन, वीओआईपी, व्यक्तिगत रूप से), चैनल का प्रकार, SNR टियर (साफ/शोरयुक्त/बहुत शोरयुक्त), उच्चारण या बोली लेबल
प्रत्येक फ़ाइल के लिए एनोटेशन आवश्यकताएं:
आयाम (Dimension) | शामिल करने के लिए वेरिएंट |
उच्चारण/बोली | यदि मौजूद हों तो कम से कम 2-3 क्षेत्रीय वेरिएंट |
ऑडियो गुणवत्ता | साफ (SNR > 20 dB), शोरयुक्त (SNR 10-20 dB), खराब (SNR < 10 dB) |
कोड-स्विचिंग | एकभाषी बनाम मिश्रित-भाषा वाले वाक्य |
चैनल | ब्रॉडबैंड (16kHz+) बनाम नैरोबैंड टेलीफोनी (8kHz) |
रिकॉर्डिंग वातावरण | मोबाइल हैंडसेट, लैंडलाइन, वीओआईपी (VoIP), हेडसेट |
वक्ता जनसांख्यिकी | आयु वर्ग, लिंग, पढ़ना बनाम स्वाभाविक बातचीत |
मूल्यांकन करने से पहले चेकपॉइंट: किसी भी वेंडर का मूल्यांकन करने से पहले अपने संदर्भ ट्रांसक्रिप्ट पर अपना नॉर्मलाइजेशन पाइपलाइन चलाएं। WER विराम चिह्नों को हटाने, संख्या नॉर्मलाइजेशन ("3" बनाम "three"), और केस फ़ोल्डिंग के प्रति संवेदनशील होता है। अपनी नॉर्मलाइजेशन मान्यताओं को मानकीकृत करें, और फिर उन्हें फ्रीज कर दें। यदि आप मूल्यांकन के बीच में नॉर्मलाइजेशन बदलते हैं, तो आपकी वेंडर तुलनाएं अर्थहीन हो जाएंगी।
महत्वपूर्ण चेतावनी: "भाषा समर्थित" को पासिंग क्राइटेरिया न मानें। हर बड़ा प्रबंधित API बहुभाषी समर्थन का दावा करता है। OpenAI का Whisper आधिकारिक तौर पर 98 भाषाओं का समर्थन करता है (मानक भाषा कोड सूची के लिए Whisper टोकननाइज़र सोर्स देखें, जो बेस मॉडल के टोकन सेट सहित 99 कोड परिभाषित करता है)। AssemblyAI के यूनिवर्सल मॉडल अपने समर्थित-भाषाओं के दस्तावेज़ीकरण के अनुसार 99 भाषाओं को कवर करते हैं। AWS Transcribe, Google Cloud Speech-to-Text V2, और Deepgram प्रत्येक अपनी समर्थित-भाषाओं के पेज प्रकाशित करते हैं। उसी मॉडल पर अंग्रेजी जैसी उच्च-संसाधन भाषा और कम-संसाधन वाली क्षेत्रीय भाषा के बीच वास्तविक WER का अंतर 30-50 प्रतिशत अंक हो सकता है। मापें, केवल मान न लें।
कम-संसाधन वाले कॉर्पस के लिए डेटा संवर्द्धन (Data Augmentation) और सिंथेटिक स्पीच
कम-संसाधन वाली भाषाएं दो जटिल समस्याओं से पीड़ित होती हैं: मॉडल के प्री-ट्रेनिंग कॉर्पस में कम ऑडियो-टेक्स्ट ट्रेनिंग डेटा होता है, और हो सकता है कि आपका मूल्यांकन ऑडियो उस ध्वनिक स्थिति (acoustic conditions) से मेल न खाए जिससे ट्रेनिंग डेटा आया था। संवर्द्धन (Augmentation) दूसरी समस्या का समाधान करता है और यह उजागर करने में मदद करता है कि मॉडल कहां विफल होता है।
परीक्षण से पहले आपके मूल्यांकन कॉर्पस पर लागू करने के लिए संवर्द्धन विधियां:
शोर शामिल करना (Noise injection): 5, 10, और 20 dB के SNR स्तरों पर बड़बड़ाहट का शोर, HVAC और कीबोर्ड का शोर जोड़ें। यह आपको एक बिंदु के WER के बजाय सटीकता में गिरावट के ग्राफ को मापने में मदद करता है।
गति और टेम्पो में बदलाव: प्लेबैक गति को ±10-15% बदलें। यह तेज बोलने वालों और धीमी, सोच-समझकर की जाने वाली बातचीत दोनों का अनुकरण करता है, जो कांटेक्ट सेंटर रिकॉर्डिंग में आम हैं।
प्रतिध्वनि (Reverberation): विभिन्न रिकॉर्डिंग वातावरणों का अनुकरण करने के लिए रूम इम्पल्स रिस्पांस लागू करें। फोन पर बोलने वाले व्यक्ति की आवाज एक प्रतिध्वनि वाले कार्यालय में बोलने वाले व्यक्ति से बहुत अलग लगती है।
टेलीफोन-बैंड फ़िल्टरिंग: 8kHz टेलीफोनी परिदृश्यों के लिए, ब्रॉडबैंड फ़ाइलों पर एक बैंडपास फ़िल्टर (300Hz-3400Hz) लागू करें। कई कम-संसाधन भाषा डिप्लॉयमेंट में PSTN चैनल शामिल होते हैं, और ब्रॉडबैंड ऑडियो पर प्रशिक्षित मॉडल नैरोबैंड इनपुट पर खराब प्रदर्शन करते हैं।
शब्दावली की कमी के लिए सिंथेटिक डेटा: यदि आपके डोमेन में उत्पाद के नाम, चिकित्सा शब्दावली, या स्थानों के नाम शामिल हैं जिन्हें मॉडल लगातार गलत पहचानता है, तो उन शब्दों के लिए TTS ऑडियो जनरेट करें, इसे अपने लक्षित STT मॉडल के साथ ट्रांसक्राइब करें, और मापें कि क्या वे शब्द आउटपुट में दिखाई देते हैं। एक ऐसे TTS सिस्टम का उपयोग करें जो आपकी लक्षित भाषा का समर्थन करता हो (मई 2023 में घोषित मेटा का MMS प्रोजेक्ट, 1,107 से अधिक भाषाओं के लिए TTS कवर करता है, जिसमें कई ऐसी भाषाएं भी शामिल हैं जिनके पास व्यावसायिक TTS समर्थन नहीं है)। सिंथेटिक स्पीच की कमियों पर नज़र रखें: TTS का लहजा स्वाभाविक बातचीत की तुलना में अधिक सपाट होता है, और मॉडल कभी-कभी सिंथेटिक बनाम स्वाभाविक ऑडियो पर अलग-अलग त्रुटियां उत्पन्न करते हैं। यदि उसी शब्दावली पर आपका सिंथेटिक-डेटा WER आपके प्राकृतिक-ऑडियो WER से काफी बेहतर है, तो हो सकता है कि यह सुधार प्रोडक्शन में दिखाई न दे।
ऑडियो नॉर्मलाइजेशन कॉन्ट्रैक्ट: मूल्यांकन से पहले सब कुछ 16kHz मोनो WAV में रीसॅम्पल करें। यह अकेला कदम प्रारूप-प्रेरित भिन्नता के एक बड़े वर्ग को समाप्त कर देता है। यदि आपका प्रोडक्शन पाइपलाइन 8kHz टेलीफोनी का उपयोग करता है, तो एक अलग 8kHz परीक्षण विभाजन बनाए रखें और दोनों के लिए मेट्रिक्स रिपोर्ट करें। एक ही WER गणना में अलग-अलग बिटरेट को कभी न मिलाएं।
वेंडर अनुकूलन (Adaptation) विकल्प: लेक्सिकॉन इंजेक्शन से लेकर फ़ाइन-ट्यूनिंग तक
सही अनुकूलन रणनीति इस बात पर निर्भर करती है कि आपका बेसलाइन WER आपके स्वीकार्य स्तर से कितना दूर है। शुरुआत आसान तरीकों से करें; बड़ी रणनीतियों पर तभी जाएं जब आपके पास साक्ष्य हों कि गहरा अनुकूलन आवश्यक है।
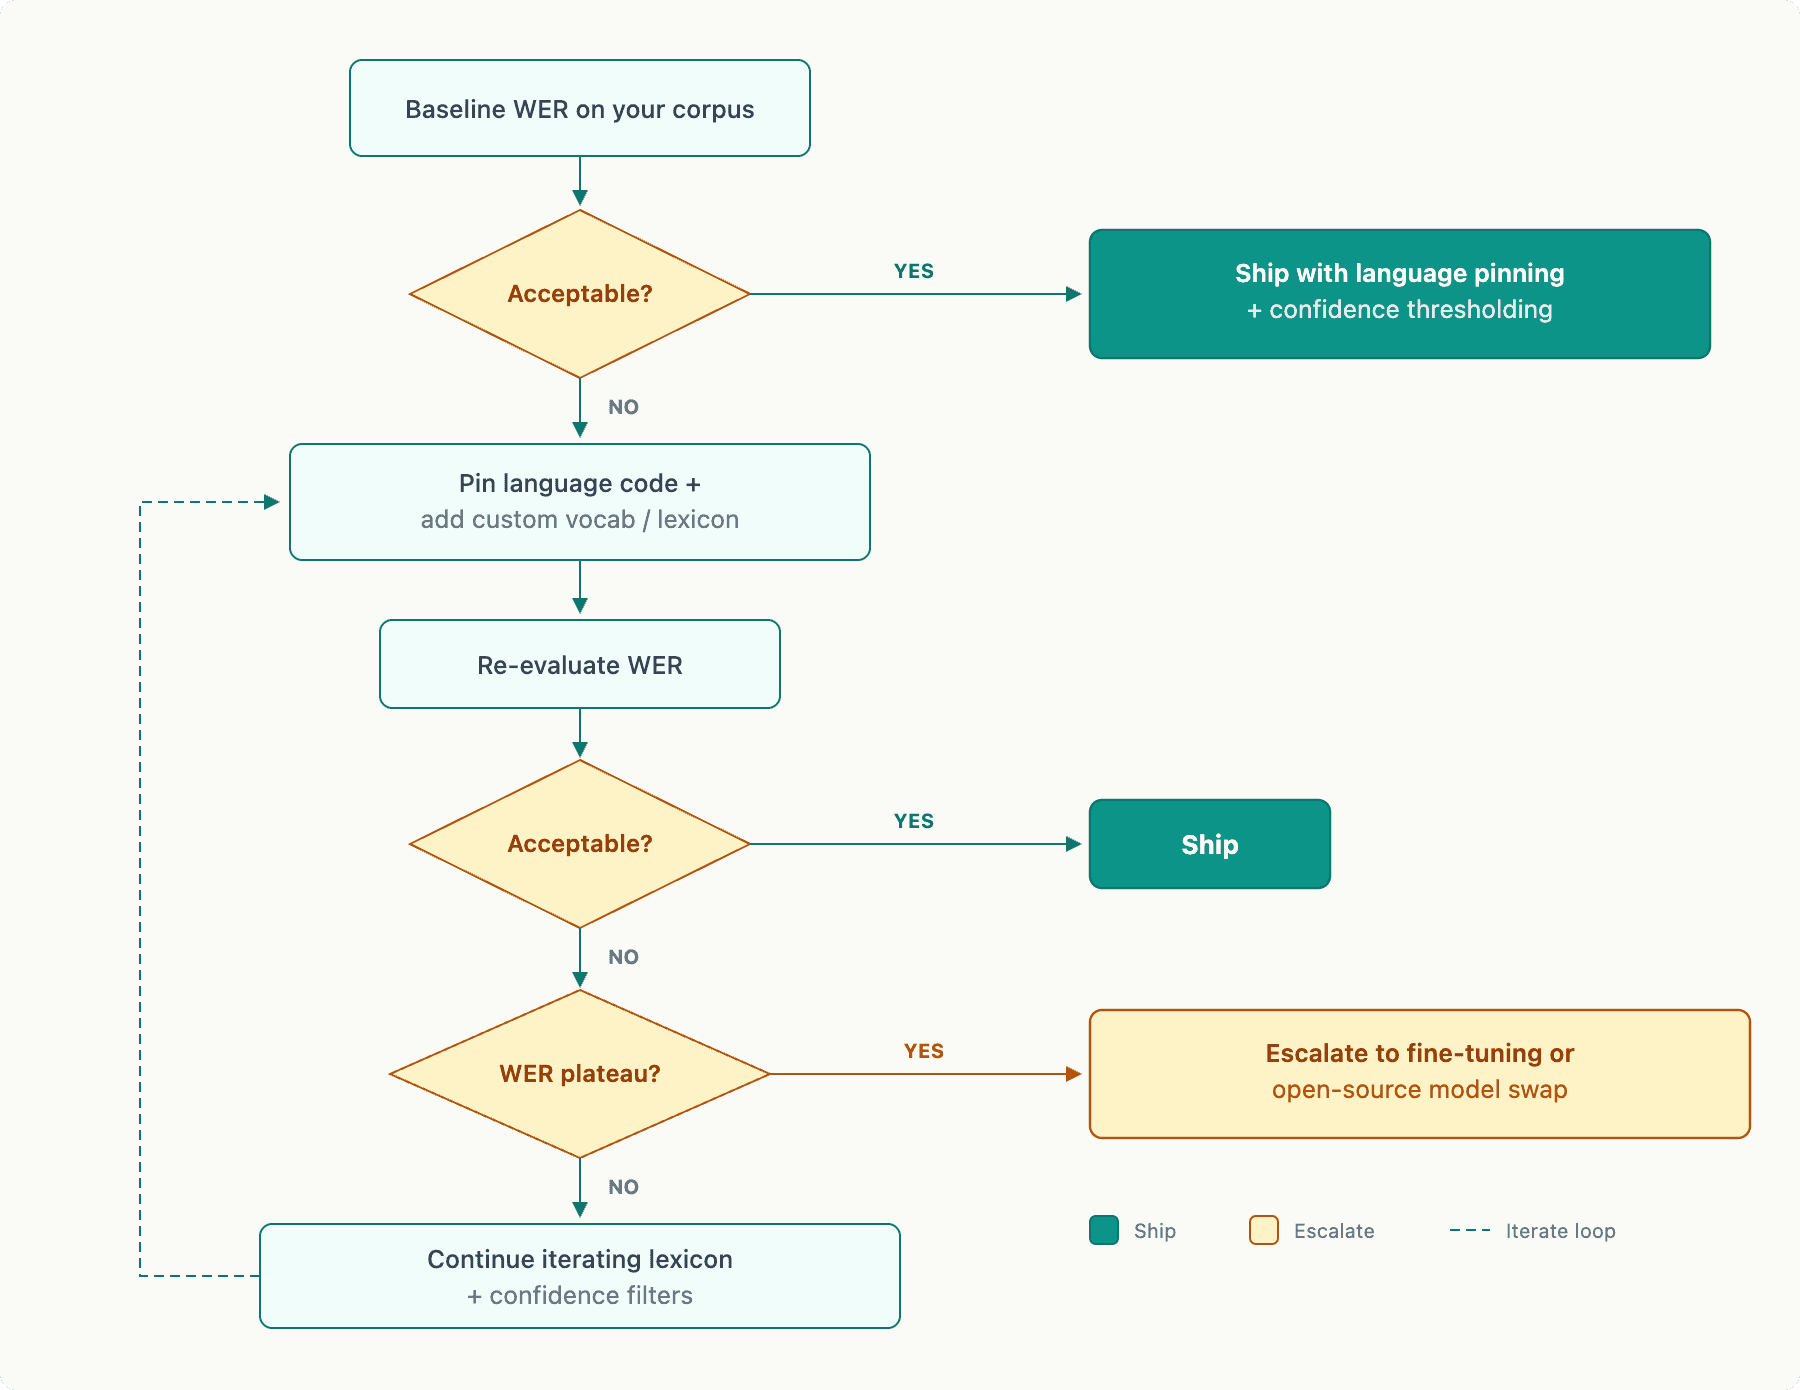
अनुकूलन निर्णय ट्री (Decision tree):
कस्टम शब्दावली और लेक्सिकॉन इंजेक्शन सबसे कम प्रयास और सबसे तेज परिणाम देने वाला अनुकूलन तरीका है। इसका उपयोग तब करें जब:
आपके डोमेन में विशिष्ट संज्ञाएं (कंपनी के नाम, उत्पाद श्रृंखला, एजेंट के नाम) हों जिन्हें मॉडल लगातार गलत सुनता है
भाषा में रूपात्मक जटिलता (morphological complexity) हो जिसके कारण मूल-शब्द पहचान विफल हो जाती है
कोड-स्विचिंग में कम-संसाधन वाली भाषा में तकनीकी अंग्रेजी शब्दों का उपयोग शामिल हो
अधिकांश प्रबंधित APIs किसी न किसी रूप में वर्ड बूस्ट या कस्टम वोकैबुलरी पैरामीटर प्रदान करते हैं। प्रभावशीलता वेंडर और भाषा के आधार पर काफी भिन्न होती है। अपने लेक्सिकॉन कवरेज (इसमें कितने डोमेन शब्द शामिल हैं) का दस्तावेजीकरण करें और सुधार को अलग से देखने के लिए केवल डोमेन-शब्द वाले हिस्से पर WER को मापें।
फ़ाइन-ट्यूनिंग के लिए लेबल किए गए ऑडियो-टेक्स्ट पेयर्स की आवश्यकता होती है (सार्थक सुधार देखने के लिए आमतौर पर न्यूनतम 1-10 घंटे), इसमें लंबे समय (वेंडर के आधार पर दिनों से लेकर हफ्तों तक) की आवश्यकता होती है, और आपके छोटे कॉर्पस के प्रति ओवरफिटिंग से बचने के लिए सावधानीपूर्वक मूल्यांकन डिज़ाइन की आवश्यकता होती है। एक अलग परीक्षण सेट का उपयोग करें जिसका उपयोग फ़ाइन-ट्यूनिंग विकास के दौरान कभी नहीं किया गया था। यदि आपका एकमात्र लेबल वाला डेटा 50 फ़ाइलें हैं, तो 40 पर फ़ाइन-ट्यूनिंग करना और 10 पर परीक्षण करना अविश्वसनीय होगा; फ़ाइन-ट्यूनिंग चक्र शुरू करने से पहले अधिक डेटा एकत्र करें।
हाइब्रिड पाइपलाइन विकल्प: जिन भाषाओं के लिए कोई भी प्रबंधित API स्वीकार्य प्रदर्शन नहीं करता है, उनके लिए दो-चरणीय दृष्टिकोण पर विचार करें। भाषा का पता लगाने, बिना भाषण वाले हिस्से को हटाने, या एक रफ पहली-बार की ट्रांसक्रिप्ट उत्पन्न करने के लिए एक ओपन-सोर्स मॉडल (wav2vec2 XLS-R, Meta का SeamlessM4T, या Massively Multilingual Speech प्रोजेक्ट के MMS-आधारित मॉडल) का उपयोग प्री-फ़िल्टर के रूप में करें। फिर अंतिम ट्रांसक्रिप्शन के लिए ऑडियो को प्रबंधित क्लाउड STT एंडपॉइंट पर भेजें। यह लेटेंसी को बढ़ाता है लेकिन उन भाषाओं के लिए WER को काफी कम कर सकता है जहां ओपन-सोर्स मॉडल को विशेष रूप से अधिक बोली-प्रतिनिधि डेटा पर प्रशिक्षित किया गया था।
Waves Pulse को मूल्यांकन मोड में चलाना: अपने कॉर्पस के खिलाफ Waves Pulse का बेंचमार्क करते समय, डायरलाइजेशन (diarization), भावना पहचान (emotion detection), और PII/PCI रेडैक्शन को एक साथ सक्षम करें। ये सुविधाएं अनुरोध के समय सक्षम की जाती हैं, और इन्हें चलाना बिल्कुल प्रोडक्शन की स्थितियों से मेल खाता है। सुविधाओं को अक्षम करके बेंचमार्क न करें और फिर उन्हें प्रोडक्शन में सक्षम न करें; रेडैक्शन और डायरलाइजेशन अतिरिक्त प्रोसेसिंग लोड जोड़ते हैं जो आपके RTF और TTFR माप को प्रभावित करता है।
सफलता को मापना और प्रोडक्शन में सटीकता की निगरानी करना
मूल्यांकन शुरू करने से पहले अपनी स्वीकार्यता सीमाएं (acceptance thresholds) निर्धारित करें। बाद में सीमाएं निर्धारित करने से पक्षपाती निर्णय हो सकते हैं।
मैट्रिक | परिभाषा | सामान्य उपकरण |
WER | (S + D + I) / N, जहां N = संदर्भ शब्द संख्या |
|
CER | WER के बराबर कैरेक्टर-स्तर का माप |
|
TTFR | ऑडियो शुरू होने से लेकर पहले ट्रांसक्रिप्ट टोकन तक का वास्तविक समय | कस्टम उपकरण |
RTF | प्रोसेसिंग समय / ऑडियो अवधि | प्रति फ़ाइल लॉग किया गया |
कॉन्फिडेंस | API से प्रति-शब्द या प्रति-वाक्य स्कोर | API रिस्पांस फ़ील्ड |
jiwer का उपयोग करके एक बुनियादी WER/CER फ्रेमवर्क:
गणना करने से पहले reference और hypothesis दोनों पर नॉर्मलाइजेशन (लोअरकेस, विराम चिह्न हटाना, संख्या विस्तार) लागू करें। वेंडर तुलनाओं में विसंगत नॉर्मलाइजेशन ही बढ़े हुए या घटे हुए WER नंबरों का सबसे आम स्रोत है।
भाषा टियर के अनुसार स्वीकार्यता सीमा तालिका:
भाषा टियर | WER लक्ष्य (कांटेक्ट सेंटर QA) | CER लक्ष्य | रोलबैक ट्रिगर |
उच्च-संसाधन (जैसे, अंग्रेजी, स्पेनिश) | < 15% | < 10% | > 25% |
मध्यम-संसाधन (जैसे, हिंदी, अरबी) | < 25% | < 18% | > 40% |
कम-संसाधन (जैसे, क्षेत्रीय बोलियां, अल्पसंख्यक भाषाएं) | < 40% | < 30% | > 55% |
ये केवल शुरुआती बिंदु हैं, अंतिम नियम नहीं। गलत पहचान के लिए आपके एप्लिकेशन की सहनशीलता इस बात पर निर्भर करती है कि डाउनस्ट्रीम प्रोसेसिंग स्वचालित है (कम सहनशीलता) या मानव-समीक्षित है (अधिक सहनशीलता)।
उत्पादन निगरानी लूप (Production monitoring loop):
अपने प्रोडक्शन ट्रैफ़िक से साप्ताहिक रूप से 20-50 नए कॉल का नमूना लें।
उस नमूने के लिए मानव-सत्यापित ट्रांसक्रिप्ट प्राप्त करें (या एक टियर दृष्टिकोण का उपयोग करें: उच्च-विश्वास वाले वाक्यों को ऑटो-सत्यापित करें, कम-विश्वास वाले वाक्यों को मैन्युअल रूप से सत्यापित करें)।
नए नमूने पर फिर से WER/CER की गणना करें और अपनी बेसलाइन से तुलना करें।
ऑडियो गुणवत्ता स्तर (साफ/शोरयुक्त/खराब) और भाषा वेरिएंट के आधार पर विभाजित करें। साफ-ऑडियो WER का स्थिर रहना जबकि शोरयुक्त-ऑडियो WER का खराब होना यह दर्शाता है कि आपका मॉडल किसी विशिष्ट चैनल स्थिति पर भटक रहा है।
पूर्ण बेंचमार्क को दोबारा चलाएं जब: कांटेक्ट सेंटर स्क्रिप्ट में महत्वपूर्ण बदलाव हो, आप विभिन्न उच्चारणों वाले नए एजेंटों को शामिल करें, या आप टेलीफोनी प्रदाता बदलते हैं (जो ऑडियो कोडेक और बिटरेट को बदलता है)।
सामान्य विफलता मोड और उन्हें अलग करने का तरीका:
कोड-स्विचिंग त्रुटियां: केवल भाषा परिवर्तन वाले वाक्यों का एक कॉर्पस हिस्सा बनाएं। उस हिस्से पर अलग से WER मापें। यदि कोड-स्विच WER आपके एकभाषी WER से दोगुना है, तो समस्या भाषा रूटिंग या सीमा पहचान (boundary detection) की है, न कि बेस मॉडल की।
कम SNR गिरावट: WER बनाम SNR बिन का ग्राफ़ बनाएं। यदि WER 10 dB SNR से नीचे तेजी से बढ़ता है, तो प्री-प्रोसेसिंग शोर में कमी (जैसे, RNNoise या SpeexDSP) मॉडल अनुकूलन से अधिक मदद कर सकती है।
संख्या और तारीख की गलत पहचान: अपने कॉर्पस से संख्याओं वाले सभी वाक्यों को निकालें और केवल संख्याओं के लिए WER की गणना करें। कई कम-संसाधन वाले मॉडल बोली जाने वाली संख्या के बजाय लिखित संख्या को बेहतर तरीके से संभालते हैं। आपके संख्या पैटर्नों के लिए एक कस्टम लेक्सिकॉन अक्सर इसे हल कर देता है।
विराम चिह्न और विभाजन विफलताएं: यदि डाउनस्ट्रीम NLP वाक्य सीमाओं पर निर्भर करता है, तो शब्द सटीकता से अलग वाक्य-स्तर संरेखण (alignment) सटीकता को मापें। वाक्य टाइमस्टैम्प समर्थन (Waves Pulse में उपलब्ध) आपको सीधे सीमा पहचान को सत्यापित करने की अनुमति देता है।
गोपनीयता और डिप्लॉयमेंट आर्किटेक्चर: लॉन्च से पहले की चेकलिस्ट
गोपनीयता की आवश्यकताओं को आपके डिप्लॉयमेंट आर्किटेक्चर को APIs के मूल्यांकन से पहले आकार देना चाहिए, न कि बाद में।
PII/PCI रेडैक्शन पाइपलाइन में दो बिंदुओं पर हो सकता है: STT API के भीतर (API रेडैक्टेड टेक्स्ट लौटाता है और मूल को कभी संग्रहीत नहीं करता है) या आपके द्वारा संचालित पोस्ट-प्रोसेसिंग लेयर में। API के भीतर रेडैक्शन (जैसे Waves Pulse द्वारा समर्थित) परिचालन रूप से सरल है और संवेदनशील डेटा को कभी भी प्लेन टेक्स्ट के रूप में ट्रांसक्रिप्शन सेवा से बाहर जाने से रोकता है। पोस्ट-STT रेडैक्शन आपको रेडैक्शन नियमों पर अधिक नियंत्रण देता है लेकिन इसके लिए आपको ट्रांजिट में रॉ ट्रांसक्रिप्ट को संभालना होगा। प्रत्येक दृष्टिकोण के लेटेंसी निहितार्थ हैं: API के भीतर रेडैक्शन ट्रांसक्रिप्शन के साथ समानांतर में चलता है और न्यूनतम TTFR ओवरहेड जोड़ता है; पोस्ट-STT रेडैक्शन ट्रांसक्रिप्ट आपके एप्लिकेशन तक पहुंचने से पहले एक अनुक्रमिक प्रोसेसिंग चरण जोड़ता है।
ऑन-प्रिमाइसेस बनाम प्रबंधित API समझौते (tradeoffs): प्रबंधित APIs इंफ्रास्ट्रक्चर के बोझ को कम करते हैं लेकिन इसके लिए आपको वेंडर के डेटा हैंडलिंग और प्रतिधारण (retention) नीतियों पर भरोसा करना होगा। स्पष्ट रूप से सत्यापित करें: वेंडर के डेटा प्रतिधारण SLA के बारे में पूछें, क्या ट्रांसक्रिप्शन के बाद ऑडियो संग्रहीत किया जाता है, और प्रोसेसिंग किस क्षेत्राधिकार में होती है। HIPAA-कवर कांटेक्ट सेंटर्स या PCI-स्कोप वाले वर्कफ़्लो के लिए, API सटीकता के बावजूद ऑन-प्रिमाइसेस या प्राइवेट-क्लाउड डिप्लॉयमेंट की आवश्यकता हो सकती है। Smallest AI अनुपालन आवश्यकताओं वाले एंटरप्राइज़ वातावरण के लिए ऑन-प्रिमाइसेस डिप्लॉयमेंट का समर्थन करता है।
लॉन्च से पहले सुरक्षा चेकलिस्ट:
TLS 1.2+ पर प्रसारित सभी ऑडियो (वेबसॉकेट और HTTPS एंडपॉइंट्स के लिए ट्रांजिट में एन्क्रिप्शन सत्यापित करें)
API कुंजियाँ (keys) एक निर्धारित शेड्यूल पर घुमाई (rotate) जाती हैं; सोर्स कोड में कोई कुंजियाँ संग्रहीत नहीं हैं
सिंथेटिक कार्ड नंबर, SSN और जन्म तिथि पैटर्न वाले टेस्ट कॉर्पस के साथ PII/PCI रेडैक्शन सत्यापित किया गया
वेंडर के साथ लिखित में डेटा प्रतिधारण नीति की पुष्टि की गई
पहुंच नियंत्रण: केवल एप्लिकेशन सर्विस खातों के पास API कुंजी तक पहुंच है; प्रोडक्शन में कोई डेवलपर व्यक्तिगत कुंजी नहीं है
ऑडिट लॉगिंग सक्षम: कॉल ID, टाइमस्टैम्प, भाषा कोड और उपयोग किए गए फ़ीचर फ़्लैग के साथ लॉग किया गया प्रत्येक ट्रांसक्रिप्शन अनुरोध
विनियमित वर्कफ़्लो में कम-विश्वास वाले ट्रांसक्रिप्ट (विश्वास < सीमा) के लिए मानव-इन-द-लूप समीक्षा प्रक्रिया परिभाषित की गई
डिप्लॉयमेंट निर्णय चेकलिस्ट (स्ट्रीमिंग बनाम बैच बनाम हाइब्रिड):
आवश्यकता | स्ट्रीमिंग का उपयोग करें | बैच का उपयोग करें | हाइब्रिड का उपयोग करें |
लाइव एजेंट सहायता / रीयल-टाइम कैप्शन | हाँ | नहीं | संभव |
कॉल के बाद QA / अनुपालन ऑडिट | नहीं | हाँ | संभव |
कॉर्पस-व्यापी वेंडर मूल्यांकन | नहीं | हाँ | नहीं |
मिश्रित: लाइव ट्रांसक्रिप्शन + एसिंक QA | नहीं | नहीं | हाँ |
लेटेंसी लक्ष्य < 200ms TTFR | हाँ | लागू नहीं | निर्भर करता है |
थोक प्रोसेसिंग के लिए लागत अनुकूलन | नहीं | हाँ | हाँ |
एक बार जब आप अपनी सटीकता सीमाओं की पुष्टि कर लेते हैं, अपने डिप्लॉयमेंट मोड को लॉक कर लेते हैं, और अपने गोपनीयता नियंत्रणों को सत्यापित कर लेते हैं, तो ट्रैफ़िक के एक हिस्से पर 1-सप्ताह का प्रोडक्शन पायलट चलाएं (आमतौर पर 10-15% कॉल पर्याप्त होते हैं)। पायलट के दौरान WER, TTFR, RTF, डायरलाइजेशन कवरेज और विश्वास वितरण को ट्रैक करें। पायलट मेट्रिक्स की तुलना अपने लॉन्च से पहले के बेंचमार्क से करें। यदि वे WER पर 5 प्रतिशत अंक से अधिक भिन्न होते हैं, तो पूर्ण रोलआउट से पहले जांच करें: प्रोडक्शन ऑडियो की स्थितियां अक्सर मूल्यांकन कॉर्पस स्थितियों से इस तरह भिन्न होती हैं जो केवल बड़े पैमाने पर दिखाई देती हैं।
यहाँ वर्णित संपूर्ण वर्कफ़्लो (कॉर्पस डिज़ाइन, संवर्द्धन, WER/CER बेंचमार्किंग, अनुकूलन एस्केलेशन और प्रोडक्शन मॉनिटरिंग) में केवल एक API के लिए साइन अप करने और कुछ नमूना फ़ाइलों का परीक्षण करने की तुलना में अधिक समय लगता है। साफ ऑडियो वाली उच्च-संसाधन भाषाओं के लिए, वह शॉर्टकट अक्सर ठीक रहता है। कांटेक्ट सेंटर वातावरण में कम-संसाधन वाली भाषाओं के लिए, वह शॉर्टकट एक ऐसा डिप्लॉयमेंट तैयार करता है जो डेमो में तो पर्याप्त दिखता है लेकिन प्रोडक्शन में विफल हो जाता है। इस गाइड में दी गई संरचना आपके ग्राहकों या आपकी अनुपालन स्थिति को प्रभावित करने से पहले उन विफलताओं को सामने लाने के लिए ही बनाई गई है।
अक्सर पूछे जाने वाले प्रश्न
कम-संसाधन वाली भाषाओं (low-resource languages) के लिए सबसे अच्छा स्पीच-टू-टेक्स्ट एपीआई कौन सा है?
मैं किसी विक्रेता के समर्थित-भाषाओं (supported-languages) वाले पेज पर भरोसा क्यों नहीं कर सकता?
स्पीच-टू-टेक्स्ट एपीआई (API) का मूल्यांकन करने के लिए मुझे कितनी ऑडियो फाइलों की आवश्यकता होगी?
टीटीएफआर (TTFR) और आरटीएफ (RTF) में क्या अंतर है?
क्या मैं अनुपालन (कम्प्लायंस) के लिए ऑन-प्रिमाइसेस पर स्पीच-टू-टेक्स्ट चला सकता हूँ?