शीर्ष ओपन-सोर्स एसटीटी (STT) एपीआई: 2026 में रीयल-टाइम ट्रांसक्रिप्शन
2026 के लिए 8 सबसे अच्छे ओपन-सोर्स स्पीच-टू-टेक्स्ट API की तुलना करें। अपने AI ऐप्स को सक्षम बनाने के लिए सटीकता, गति और स्केलेबिलिटी के विकल्पों का मूल्यांकन करें।
डेमो में भाषण को टेक्स्ट में ट्रांसक्राइब करना आसान है, लेकिन वास्तविक समय का उपयोग एक अलग कहानी बयां करता है। लहजे बदलते हैं, पृष्ठभूमि का शोर आता है, लोग बीच में टोकते हैं, और ट्रांसक्रिप्ट बातचीत से पीछे रह सकती हैं। तभी टीमों को एहसास होता है कि सबसे अच्छा स्पीच-टू-टेक्स्ट API वह नहीं है जो डेमो में प्रभावशाली लग रहा था, बल्कि वह है जो प्रोडक्शन में विश्वसनीय रूप से काम करता है।
डेवलपर्स, प्रोडक्ट टीमों और लाइव ऑडियो को संभालने वाले व्यवसायों के लिए, ट्रांसक्रिप्शन वर्कफ्लो के केंद्र में है। त्रुटियाँ विश्लेषण में बाधा डालती हैं, देरी ऑटोमेशन को बाधित करती है, और पैमाना (स्केल) लागत और विश्वसनीयता में कमियों को उजागर करता है। जो ओपन-सोर्स और क्लाउड AI APIs इन परिस्थितियों में टिके रहते हैं, वे ही हैं जिन्हें आप एकीकृत करना चाहते हैं।
यह गाइड शीर्ष ओपन-सोर्स और प्रोडक्शन-रेडी स्पीच-टू-टेक्स्ट APIs को कवर करती है, जिसमें क्षमताओं, एकीकरण आवश्यकताओं, मुफ्त स्तरों (फ्री टियर) और वास्तविक समय के परिदृश्यों में मायने रखने वाली अनूठी विशेषताओं पर ध्यान केंद्रित किया गया है।
मुख्य बातें
वास्तविक समय की सटीकता मायने रखती है: डेमो में चमकने वाले APIs अक्सर लाइव, शोरगुल वाले, या बहु-लहजे वाले ऑडियो के साथ लड़खड़ा जाते हैं।
विलंबता (लेटेंसी) वॉयस वर्कफ़्लो को प्रभावित करती है: यदि देरी बातचीत या ऑटोमेशन को धीमा कर देती है, तो सटीक ट्रांसक्रिप्ट भी नुकसान पहुँचाती हैं।
एकीकरण लचीलापन: ऐसे APIs की तलाश करें जो आपके स्टैक के साथ काम करते हैं, जैसे कि पायथन, जावास्क्रिप्ट, क्लाउड या ऑन-प्रीम।
उपयोग के अनुकूल संरेखण: वह API चुनें जो आपके वर्कफ़्लो के अनुकूल हो, जैसे कि संपर्क केंद्र, मीडिया संपादन, शोध, या हाइब्रिड सेटअप।
स्केलेबिलिटी और विश्वसनीयता: प्रोडक्शन वर्कलोड को ऐसे APIs की आवश्यकता होती है जो वॉल्यूम बढ़ने पर भी प्रदर्शन बनाए रखें।
स्पीच-टू-टेक्स्ट AI APIs क्या हैं?
स्पीच-टू-टेक्स्ट AI APIs उन्नत वाक् पहचान प्रणाली (स्पीच रिकग्निशन) का उपयोग करके बोले गए ऑडियो को संरचित, मशीन-पठनीय टेक्स्ट में परिवर्तित करते हैं। इन APIs को वास्तविक समय या बैच ट्रांसक्रिप्शन के लिए डिज़ाइन किया गया है, जो लाइव कॉल, मीटिंग और मीडिया रिकॉर्डिंग में सटीकता, कम विलंबता और प्रोडक्शन-स्तरीय वर्कलोड के लिए अनुकूलित हैं।
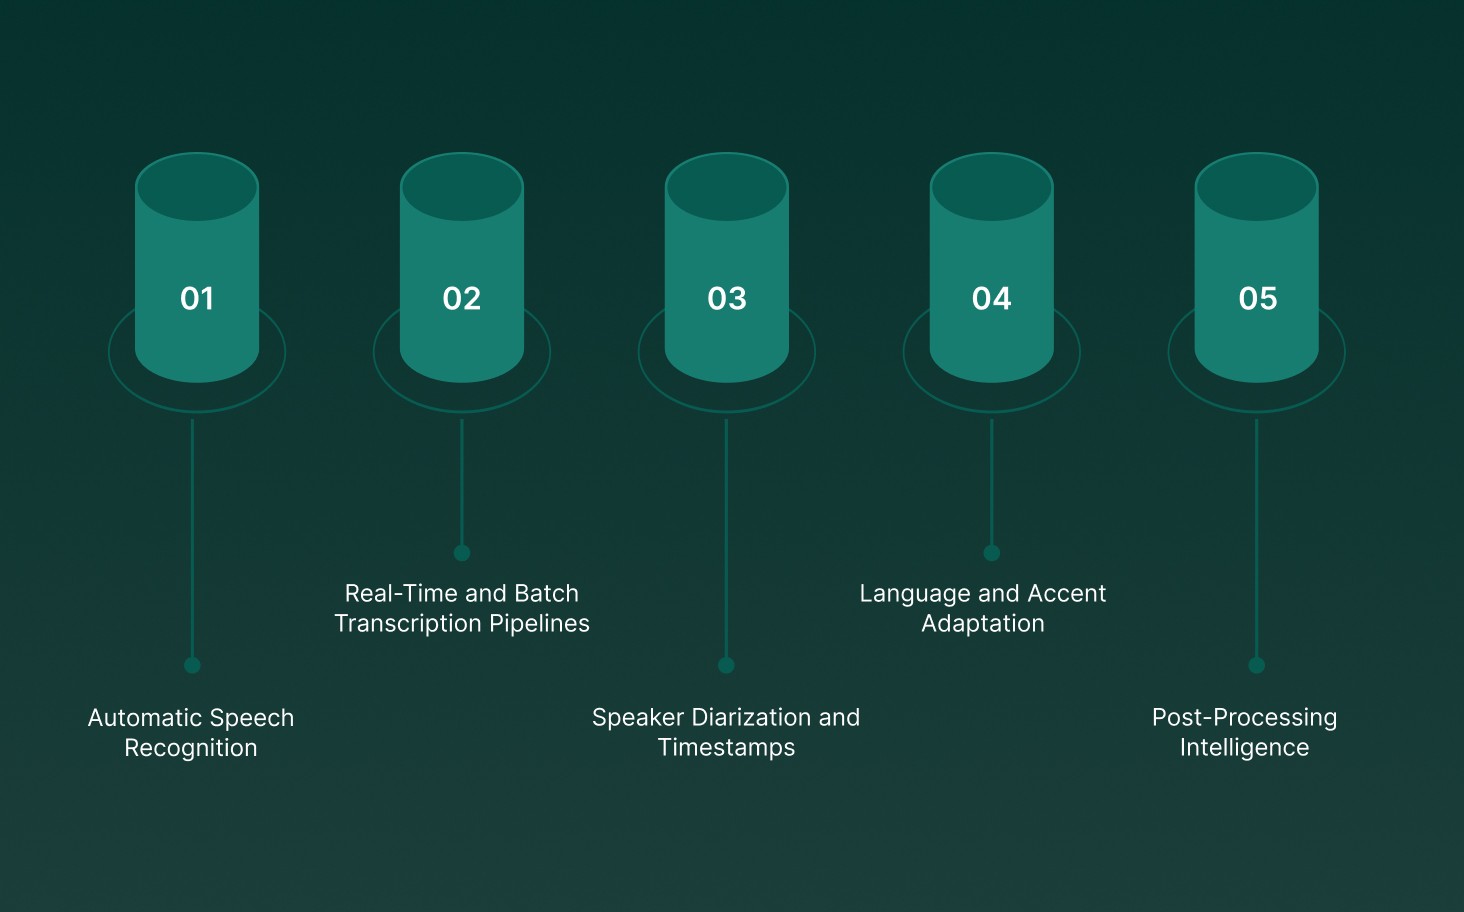
आधुनिक स्पीच-टू-टेक्स्ट APIs मुख्य तकनीकी क्षमताएं प्रदान करते हैं जो बुनियादी ट्रांसक्रिप्शन से परे जाती हैं:
स्वचालित वाक् पहचान (ASR): न्यूरल ध्वनिक और भाषा मॉडल पृष्ठभूमि के शोर, आपस में टकराती आवाजों और विभिन्न लहजों के बावजूद त्रुटियों को कम करते हुए ऑडियो संकेतों को शब्दों में मैप करते हैं।
वास्तविक समय और बैच ट्रांसक्रिप्शन पाइपलाइन: वास्तविक समय के APIs लाइव बातचीत के लिए मिलीसेकंड में आंशिक ट्रांसक्रिप्ट प्रदान करते हैं, जबकि बैच पाइपलाइन लंबे समय की रिकॉर्डिंग के लिए उच्च सटीकता और थ्रूपुट पर ध्यान केंद्रित करती हैं।
स्पीकर डायराइजेशन और टाइमस्टैम्प: कई वक्ताओं का पता लगाएं और उन्हें लेबल करें, जिससे बैठकों, साक्षात्कारों या बहु-प्रतिभागी कॉलों में सटीक एट्रिब्यूशन मिलता है।
भाषा और लहजा अनुकूलन: मॉडल बिना पूर्ण री-ट्रेनिंग के क्षेत्रीय लहजे, डोमेन-विशिष्ट शब्दावली और उच्चारण पैटर्न के अनुकूल हो जाते हैं।
पोस्ट-प्रोसेसिंग इंटेलिजेंस: ट्रांसक्रिप्ट डाउनस्ट्रीम एनालिटिक्स, भावना विश्लेषण (सेंटीमेंट एनालिसिस), सर्च इंडेक्सिंग और अनुपालन जांच में काम आ सकती हैं।
मूल रूप से, वॉयस-संचालित अनुप्रयोगों के लिए एक स्पीच-टू-टेक्स्ट API अत्यंत महत्वपूर्ण है, जो वास्तविक समय ट्रांसक्रिप्शन, वॉयस एनालिटिक्स और बड़े पैमाने पर ऑटोमेशन को सक्षम बनाता है।
स्पीच-टू-टेक्स्ट AI APIs कैसे काम करते हैं?
ये APIs स्टूडियो-परफेक्ट रिकॉर्डिंग के बजाय गति और सटीकता के लिए बनाई गई बहु-चरणीय पाइपलाइन के माध्यम से कच्चे ऑडियो को संरचित टेक्स्ट में संसाधित करते हैं। मुख्य चरणों में शामिल हैं:
ऑडियो अंतर्ग्रहण और सामान्यीकरण: वॉल्यूम की भिन्नता, चैनल की विसंगतियों और गति के अंतर को संभालने के लिए ऑडियो स्ट्रीम या फ़ाइलों को पुन: नमूना (रीसैंपल), शोर-मुक्त (डीनॉइज) और सामान्यीकृत किया जाता है।
ध्वनिक विशेषता निष्कर्षण (अकॉस्टिक फीचर एक्सट्रैक्शन): ऑडियो तरंगों को स्पेक्ट्रल विशेषताओं में परिवर्तित किया जाता है जो पृष्ठभूमि के शोर को फ़िल्टर करते हुए फोनम, समय और वक्ता की विशेषताओं को कैप्चर करते हैं।
न्यूरल डिकोडिंग और हाइपोथिसिस जेनरेशन: AI मॉडल रोलिंग शब्द पूर्वानुमान उत्पन्न करते हैं, वाक्य के पूरा होने की प्रतीक्षा किए बिना आंशिक ट्रांसक्रिप्ट को लगातार अपडेट करते हैं।
प्रासंगिक रीस्कोरिंग और त्रुटि सुधार: गलत पहचान को कम करने के लिए भाषा मॉडल संवादात्मक संदर्भ, डोमेन-विशिष्ट शब्दावली और पूर्व संवादों को लागू करते हैं।
क्रमिक आउटपुट और इवेंट हैंडलिंग: अंतिम ट्रांसक्रिप्ट टाइमस्टैम्प, स्पीकर लेबल और व्यवधान मार्करों के साथ वितरित किए जाते हैं, जो लाइव एप्लिकेशन या एनालिटिक्स पाइपलाइनों के लिए तैयार होते हैं।
खोजें कि कैसे AI वॉयस-संचालित इंटरैक्शन आकार दे रहे हैं AI वॉयस-संचालित इंटरैक्शन के भविष्य और उनके प्रभाव को
आधुनिक स्पीच-टू-टेक्स्ट APIs स्थिर दस्तावेज़ प्रोसेसर की तरह कम और कम-विलंबता वाले इंजनों की तरह अधिक व्यवहार करते हैं, जो कई भाषाओं और वातावरणों में वास्तविक दुनिया की मानवीय बातचीत के साथ तालमेल बिठाने में सक्षम हैं।
8 सर्वश्रेष्ठ स्पीच-टू-टेक्स्ट AI APIs
वास्तविक समय की ऑडियो स्ट्रीम शुरू होने के बाद सभी स्पीच-टू-टेक्स्ट APIs समान प्रदर्शन नहीं करते हैं। कुछ मॉडल डेमो में आशाजनक दिखते हैं लेकिन लाइव ट्रैफिक के तहत धीमे हो जाते हैं। अन्य स्ट्रीमिंग को अच्छी तरह से संभालते हैं लेकिन पैमाने (स्केल) के साथ खराब हो जाते हैं।
निम्नलिखित अनुभाग शीर्ष ओपन-सोर्स, प्रोडक्शन-रेडी स्पीच-टू-टेक्स्ट APIs पर प्रकाश डालता है, जो उनकी क्षमताओं, विलंबता और सर्वोत्तम उपयोग के मामलों पर केंद्रित है।
1. Pulse STT
Pulse STT लाइव बातचीत के लिए बनाया गया एक प्रोडक्शन-ग्रेड, रीयल-टाइम स्पीच-टू-टेक्स्ट API है, जो Smallest AI द्वारा 70ms से कम की विलंबता, उच्च सटीकता और मजबूत बहुभाषी समर्थन प्रदान करता है।
मुख्य क्षमताओं में शामिल हैं:
अल्ट्रा-लो लेटेंसी ट्रांसक्रिप्शन: 70ms से कम समय में पहली ट्रांसक्रिप्ट, बिना किसी व्यवधान के बातचीत सुनिश्चित करती है।
उच्च शब्द सटीकता: 30+ भाषाओं में न्यूनतम शब्द त्रुटि दर बनाए रखता है, वास्तविक दुनिया के भाषण के लिए अनुकूलित।
बहु-भाषा और बोली कवरेज: अमेरिका, यूरोप और भारत में फैली 36 भाषाओं का समर्थन करता है।
स्वचालित भाषा पहचान और कोड-स्विचिंग: लाइव ऑडियो स्ट्रीम में मिश्रित-भाषा भाषण को सहजता से संभालता है।
उन्नत स्पीच इंटेलिजेंस: सादे टेक्स्ट से परे स्पीकर डायराइजेशन, भावना विश्लेषण और भावना पहचान।
ऑन-प्रीम और एंटरप्राइज परिनियोजन (डिप्लॉयमेंट): कम विलंबता, सख्त डेटा नियंत्रण और SOC 2 Type II, HIPAA, PCI, और ISO मानकों के अनुपालन के लिए स्थानीय परिनियोजन।
इसके लिए सर्वोत्तम उपयोग: वास्तविक समय की ग्राहक सेवा, बहुभाषी संपर्क केंद्र और उच्च-मात्रा वाले प्रोडक्शन वॉयस वर्कफ़्लो जहां विलंबता और सटीकता सबसे अधिक मायने रखती है।
वास्तविक समय के वॉयस प्रदर्शन, 100ms से कम की विलंबता और उद्यम-स्तर की सुरक्षा का अनुभव करने के लिए स्केल करने के लिए निर्मित वॉयस एजेंटों के साथ। आज ही Smallest.ai आज़माएं।
2. Google Cloud Speech-to-Text API
Google Cloud Speech-to-Text एक शक्तिशाली क्लाउड-आधारित API है जो उन्नत न्यूरल नेटवर्क मॉडल का उपयोग करके ऑडियो को उच्च सटीकता के साथ टेक्स्ट में बदल देता है। यह वास्तविक समय स्ट्रीमिंग और बैच प्रोसेसिंग दोनों का समर्थन करता है, जिससे यह उद्यम और डेवलपर वर्कफ़्लो के लिए उपयुक्त हो जाता है।
तत्काल और बैच ट्रांसक्रिप्शन: न्यूनतम देरी के साथ लाइव बातचीत को संसाधित करता है और बड़े पैमाने पर अनुप्रयोगों के लिए पूर्व-रिकॉर्ड की गई ऑडियो फाइलों को कुशलतापूर्वक परिवर्तित करता है।
बेहतर पठनीयता: साफ, पेशेवर ट्रांसक्रिप्ट उत्पन्न करने के लिए स्वचालित रूप से विराम चिह्न, कैपिटलाइज़ेशन और फ़ॉर्मेटिंग जोड़ता है।
वैश्विक भाषा कवरेज: अंतर्राष्ट्रीय उपयोगकर्ताओं के लिए लहजे अनुकूलन सहित 125 से अधिक भाषाओं और वेरिएंट का समर्थन करता है।
स्पीकर की पहचान और समय: कई वक्ताओं के बीच अंतर करता है और विस्तृत विश्लेषण के लिए सटीक शब्द-स्तरीय टाइमस्टैम्प प्रदान करता.
शोर के प्रति लचीला: शोरगुल वाले वातावरण या आपस में टकराती बातचीत में भी ट्रांसक्रिप्शन सटीकता बनाए रखता है, जिससे यह वास्तविक दुनिया के ऑडियो के लिए आदर्श बनता है।
पक्ष (Pros)
वास्तविक समय और बैच ट्रांसक्रिप्शन समर्थन
साफ आउटपुट के लिए स्वचालित विराम चिह्न और फ़ॉर्मेटिंग
लहजे के अनुकूलन के साथ 125+ भाषाओं को पहचानता है
वक्ताओं को ट्रैक करता है और शब्द-स्तरीय टाइमस्टैम्प प्रदान करता है
शोरगुल वाले या बहु-स्पीकर वातावरण में अच्छा प्रदर्शन करता है
विपक्ष (Cons)
निःशुल्क स्तर का उपयोग सीमित है
जटिल सेटअपों के लिए Google क्लाउड इन्फ्रास्ट्रक्चर से परिचित होने की आवश्यकता हो सकती है
उन्नत सुविधाओं के लिए अक्सर सशुल्क योजनाओं की आवश्यकता होती है
इसके लिए सर्वोत्तम: उद्यम, डेवलपर्स और टीमें जो बहुभाषी वॉयस असिस्टेंट, स्वचालित मीटिंग ट्रांसक्रिप्ट, या वास्तविक समय ट्रांसक्रिप्शन पाइपलाइन बना रही हैं जो विश्वसनीय और स्केलेबल क्लाउड प्रदर्शन की मांग करती हैं।
3. AssemblyAI
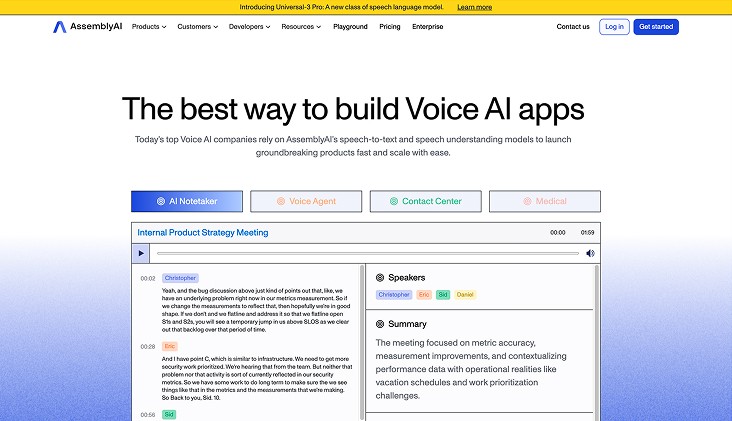
AssemblyAI उन डेवलपर्स और टीमों के लिए बनाया गया एक मजबूत स्पीच-टू-टेक्स्ट API है जिन्हें बुद्धिमान ऑडियो विश्लेषण के साथ तेज, सटीक ट्रांसक्रिप्शन की आवश्यकता होती है। यह लाइव स्ट्रीम और प्री-रिकॉर्डेड ऑडियो दोनों को संभालता है, जिससे भाषण व्यावहारिक अंतर्दृष्टि में बदल जाता है।
स्मार्ट ऑडियो अंतर्दृष्टि: विषयों, भावना, नामित संस्थाओं (नेम्ड एंटिटीज) और सामग्री मॉडरेशन फ़्लैग की पहचान करता है, जो सादे टेक्स्ट से परे संदर्भ-समृद्ध जानकारी प्रदान करता है।
वैश्विक भाषा समर्थन: 30 से अधिक भाषाओं और क्षेत्रीय लहजों को संभालता है, जिससे विविध उपयोगकर्ताओं के लिए विश्वसनीय ट्रांसक्रिप्शन सुनिश्चित होता है।
आसान डेवलपर एकीकरण: वेब, मोबाइल या बैकएंड अनुप्रयोगों में एम्बेड करने के लिए न्यूनतम सेटअप की आवश्यकता होती है, जिससे त्वरित परिनियोजन सक्षम होता है।
लाइव और बैच ट्रांसक्रिप्शन: वास्तविक समय की बातचीत को कम विलंबता के साथ तुरंत परिवर्तित करता है और बड़ी ऑडियो या वीडियो फ़ाइलों को कुशलतापूर्वक ट्रांसक्राइब करता है।
पक्ष (Pros)
लाइव स्ट्रीम और बैच ट्रांसक्रिप्शन दोनों का समर्थन करता है
भावना, विषयों और संस्थाओं जैसी सार्थक अंतर्दृष्टि निकालता है
कई भाषाओं और लहजों में विश्वसनीय
त्वरित और सरल API एकीकरण
बुनियादी स्पीच-टू-टेक्स्ट में संदर्भ जोड़ता है
विपक्ष (Cons)
मुफ़्त स्तर का उपयोग सीमित है
उन्नत सुविधाओं के लिए भुगतान योजनाओं की आवश्यकता होती है
केवल क्लाउड-आधारित, कोई ऑफ़लाइन मोड नहीं
इसके लिए सर्वोत्तम: डेवलपर्स, मीडिया टीमें और व्यवसाय जो AI वॉयस असिस्टेंट, ट्रांसक्रिप्शन प्लेटफॉर्म या एनालिटिक्स सिस्टम बना रहे हैं, जिन्हें समृद्ध ऑडियो इंटेलिजेंस के साथ तेज़, सटीक स्पीच-टू-टेक्स्ट की आवश्यकता होती है।
4. AWS Transcribe
AWS Transcribe एक क्लाउड-आधारित वाक् पहचान सेवा है जो लाइव ऑडियो और प्री-रिकॉर्डेड फ़ाइलों दोनों के लिए सटीक और स्केलेबल ट्रांसक्रिप्शन प्रदान करती है। यह बैठकों और साक्षात्कारों से लेकर मीडिया सामग्री और एनालिटिक्स पाइपलाइनों तक, उद्यम-स्तरीय वर्कफ़्लो का समर्थन करने के लिए बनाया गया है।
मल्टी-स्पीकर डिटेक्शन: स्वचालित रूप से कई वक्ताओं की पहचान और वर्गीकरण करता है, जिससे यह समूह कॉल, पैनल चर्चा और साक्षात्कार रिकॉर्डिंग के लिए आदर्श बन जाता है।
कस्टम भाषा समर्थन: आप उद्योग-विशिष्ट शब्दों, संक्षिप्ताक्षरों या ब्रांड नामों को कैप्चर करने के लिए कस्टम शब्दावली और भाषा मॉडल बना सकते हैं, जिससे ट्रांसक्रिप्शन सटीकता में सुधार होता है।
समय-संरेखित और स्वरूपित आउटपुट: उपशीर्षक, विश्लेषण या सामग्री अनुक्रमण के लिए टाइमस्टैम्प, विराम चिह्न और संरचित स्वरूपण के साथ ट्रांसक्रिप्ट प्रदान करता है।
AWS इकोसिस्टम एकीकरण: S3, Lambda और Comprehend जैसी अन्य AWS सेवाओं के साथ सहजता से जुड़ता है, जिससे पूरी तरह से स्वचालित ट्रांसक्रिप्शन, स्टोरेज और डाउनस्ट्रीम विश्लेषण सक्षम होता है।
पक्ष (Pros)
लाइव स्ट्रीमिंग और थोक ऑडियो प्रोसेसिंग दोनों का समर्थन करता है
स्वचालित रूप से कई वक्ताओं के बीच अंतर करता है
डोमेन-विशिष्ट शब्दों के लिए कस्टम शब्दावली
टाइमस्टैम्प और अच्छी तरह से स्वरूपित ट्रांसक्रिप्ट तैयार करता है
वर्कफ़्लो ऑटोमेशन के लिए अन्य AWS टूल के साथ आसान एकीकरण
विपक्ष (Cons)
इंटरनेट/क्लाउड एक्सेस की आवश्यकता है; कोई ऑफ़लाइन समर्थन नहीं
उच्च-मात्रा के उपयोग के साथ लागत जमा हो सकती है
AWS इकोसिस्टम के बाहर सीमित लचीलापन
इसके लिए सर्वोत्तम: संरचित, विश्वसनीय और स्केलेबल आउटपुट के साथ बैठकों, कॉलों, मीडिया सामग्री, या वॉयस-संचालित अनुप्रयोगों के लिए एक मजबूत, क्लाउड-संचालित ट्रांसक्रिप्शन समाधान की तलाश करने वाले उद्यम और डेवलपर्स।
5. OpenAI Whisper
OpenAI Whisper एक ओपन-सोर्स स्पीच-टू-टेक्स्ट मॉडल है जो शोरगुल वाले वातावरण और विविध लहजों में भी उच्च-सटीकता वाले ट्रांसक्रिप्शन के लिए बनाया गया है। इसे ऑफ़लाइन उपयोग के लिए डिज़ाइन किया गया है, जिससे डेवलपर्स और शोधकर्ताओं को डेटा और प्रोसेसिंग पर पूरा नियंत्रण मिलता है।
स्वचालित बहुभाषी ट्रांसक्रिप्शन: मैन्युअल सेटअप के बिना 97 भाषाओं में भाषण का पता लगाता है और ट्रांसक्राइब करता है।
शोर-प्रतिरोधी पहचान: चुनौतीपूर्ण ध्वनिक परिस्थितियों में भी उच्च सटीकता बनाए रखता है।
ऑफ़लाइन क्षमता: क्लाउड निर्भरता को समाप्त करते हुए और गोपनीयता सुनिश्चित करते हुए स्थानीय स्तर पर चल सकता है।
बैच प्रोसेसिंग: किसी भी लंबाई की ऑडियो फाइलों को कुशलतापूर्वक संभालता है, जिससे यह बड़े पैमाने पर ट्रांसक्रिप्शन परियोजनाओं के लिए आदर्श बन जाता है।
पक्ष (Pros)
स्वचालित पहचान के साथ 97 भाषाओं का समर्थन करता है
शोरगुल वाले या जटिल ऑडियो वातावरण में विश्वसनीय रूप से काम करता है
डेटा-संवेदनशील अनुप्रयोगों के लिए पूरी तरह से ऑफ़लाइन परिनियोजन
ओपन-सोर्स, वर्कफ़्लो में अनुकूलन और एकीकरण की अनुमति देता है
विपक्ष (Cons)
वास्तविक समय स्ट्रीमिंग के लिए अनुकूलित नहीं है
बड़ी फ़ाइलों को संसाधित करने के लिए पर्याप्त स्थानीय कंप्यूटिंग संसाधनों की आवश्यकता होती है
इसके लिए सर्वोत्तम: कई भाषाओं और शोरगुल वाली ऑडियो स्थितियों के लिए सटीक, ऑफ़लाइन, ओपन-सोर्स ट्रांसक्रिप्शन की आवश्यकता वाले डेवलपर्स, शोधकर्ता और टीमें।
6. Microsoft Azure Speech Service
Microsoft Azure Speech Service एक क्लाउड-आधारित स्पीच-टू-टेक्स्ट प्लेटफ़ॉर्म है जो वास्तविक समय और बैच ट्रांसक्रिप्शन दोनों के लिए बनाया गया है, जो Microsoft के AI और उत्पादकता इकोसिस्टम के साथ कसकर एकीकृत है।
लाइव और बैच ट्रांसक्रिप्शन: बड़े पैमाने पर उच्च सटीकता के साथ स्ट्रीमिंग ऑडियो या प्री-रिकॉर्डेड फ़ाइलों को ट्रांसक्राइब करता है।
कस्टम स्पीच और शब्दावली: उद्योग-विशिष्ट शब्दों, शब्दजाल और क्षेत्रीय लहजे के लिए मॉडल के अनुकूलन की अनुमति देता है।
स्पीकर की पहचान और डायराइजेशन: स्पष्ट बातचीत मैपिंग के लिए कॉल, मीटिंग या सम्मेलनों के दौरान कई वक्ताओं को पहचानता है।
भाषा और लहजा समर्थन: बहुभाषी सामग्री के लिए कोड-स्विचिंग क्षमताओं सहित 100 से अधिक भाषाओं और बोलियों को कवर करता है।
Azure इकोसिस्टम एकीकरण: विश्लेषण और वर्कफ़्लो ऑटोमेशन के लिए Microsoft Teams, Power BI और अन्य Azure संज्ञानात्मक सेवाओं (कॉग्निटिव सर्विसेज) के साथ सहजता से काम करता है।
पक्ष (Pros)
व्यापक भाषा और लहजा कवरेज
लाइव स्ट्रीमिंग और बैच प्रोसेसिंग का समर्थन करता है
उद्योग-विशिष्ट शब्दावली के लिए अनुकूलन योग्य
Microsoft टूल और सेवाओं के साथ गहरा एकीकरण
विपक्ष (Cons)
सर्वोत्तम प्रदर्शन के लिए Azure इकोसिस्टम से परिचित होने की आवश्यकता है
निःशुल्क-स्तर की सीमाएँ बड़े पैमाने पर उपयोग को प्रतिबंधित कर सकती हैं
उन्नत सुविधाओं के लिए सदस्यता-आधारित मूल्य निर्धारण की आवश्यकता हो सकती है
इसके लिए सर्वोत्तम: Microsoft इन्फ्रास्ट्रक्चर, बहुभाषी मीटिंग ट्रांसक्रिप्शन और AI-संचालित वॉयस एनालिटिक्स समाधानों का लाभ उठाने वाले उद्यम।
7. ElevenLabs
ElevenLabs गति को प्रासंगिक समझ के साथ जोड़ते हुए, लाइव ट्रांसक्रिप्शन और मीडिया प्रोसेसिंग पर केंद्रित उच्च-सटीकता वाले स्पीच-टू-टेक्स्ट APIs प्रदान करता है।
रियल-टाइम स्ट्रीमिंग ट्रांसक्रिप्शन: Scribe v2 रियलटाइम लाइव स्पीच को 150ms से कम समय में टेक्स्ट में बदल देता है, जिससे वास्तविक समय के अनुप्रयोगों के लिए तेज़, सटीक ट्रांसक्रिप्शन सक्षम होता है।
बैच ट्रांसक्रिप्शन: अपलोड किए गए ऑडियो और वीडियो को संसाधित करता है, मीडिया वर्कफ़्लो के लिए उपयुक्त साफ, संपादन योग्य ट्रांसक्रिप्ट प्रदान करता है।
बहु-भाषा कवरेज: वैश्विक सामग्री में विश्वसनीय ट्रांसक्रिप्शन सुनिश्चित करते हुए, 90+ भाषाओं और विविध लहजों का समर्थन करता है।
प्रासंगिक ऑडियो विश्लेषण: समृद्ध, अधिक व्यावहारिक ट्रांसक्रिप्ट के लिए स्पीकर की पहचान, इकाई (एंटिटी) का पता लगाना और गतिशील ऑडियो टैगिंग जोड़ता है।
पक्ष (Pros)
अल्ट्रा-लो लेटेंसी लाइव AI ट्रांसक्रिप्शन (<150ms)
90+ भाषाओं और लहजों का समर्थन करता है
स्पीकर ID और एंटिटी डिटेक्शन के साथ संदर्भ-जागरूक ट्रांसक्रिप्शन
लाइव और बैच मीडिया प्रोसेसिंग दोनों के लिए उपयुक्त
विपक्ष (Cons)
API एकीकरण और डेवलपर सेटअप की आवश्यकता है
बड़े पैमाने पर ट्रांसक्रिप्शन वर्कफ़्लो के लिए उच्च उपयोग लागत
इसके लिए सर्वोत्तम: मीडिया वर्कफ़्लो, लाइव एजेंट और वास्तविक समय ट्रांसक्रिप्शन एप्लिकेशन जिन्हें तेज़, सटीक और API-सुलभ समाधानों की आवश्यकता होती है।
8. Reverie Speech-to-Text API
Reverie Speech-to-Text API बहुभाषी और क्षेत्रीय भाषा प्रसंस्करण के लिए मजबूत समर्थन के साथ वास्तविक समय और बैच ट्रांसक्रिप्शन प्रदान करता है, जो विविध वॉयस इनपुट को संभालने वाले व्यवसायों के लिए आदर्श है।
लाइव और बैच ट्रांसक्रिप्शन: लाइव बातचीत और पहले से रिकॉर्ड किए गए ऑडियो को जल्दी और सटीक रूप से टेक्स्ट में बदलता है।
बहुभाषी और क्षेत्रीय समर्थन: सटीक ट्रांसक्रिप्शन के लिए लहजे और बोली अनुकूलन के साथ कई भारतीय और वैश्विक भाषाओं को संभालता है।
स्पीकर की पहचान और संदर्भ जागरूकता: बेहतर बातचीत समझ के लिए वक्ताओं के बीच अंतर करता है और संदर्भ को कैप्चर करता है।
कस्टम शब्दावली और डोमेन अनुकूलन: ट्रांसक्रिप्शन सटीकता बढ़ाने के लिए उद्योग-विशिष्ट शब्दों को शामिल करने की अनुमति देता है।
पक्ष (Pros)
भाषाओं और क्षेत्रीय बोलियों की एक विस्तृत श्रृंखला का समर्थन करता है
लाइव और रिकॉर्डेड दोनों ऑडियो ट्रांसक्रिप्शन प्रदान करता है
स्पीकर पृथक्करण और संदर्भ-जागरूक ट्रांसक्रिप्शन
विशिष्ट उद्योगों के लिए अनुकूलन योग्य शब्दावली
विपक्ष (Cons)
उन्नत सुविधाओं के लिए डेवलपर एकीकरण की आवश्यकता हो सकती है
उच्च-मात्रा वाले ट्रांसक्रिप्शन के लिए मुफ़्त-स्तर का उपयोग सीमित है
इसके लिए सर्वोत्तम: ग्राहक बातचीत और उद्यम वर्कफ़्लो के लिए प्रासंगिक समझ के साथ सटीक, बहुभाषी ट्रांसक्रिप्शन की आवश्यकता वाले व्यवसाय।
यदि आप सर्वोत्तम टूल की तलाश कर रहे हैं, तो खोजें वास्तविक समय और प्रोडक्शन उपयोग के लिए शीर्ष 8 वॉयस-टू-टेक्स्ट सॉफ़्टवेयर
सर्वश्रेष्ठ स्पीच-टू-टेक्स्ट AI APIs का चयन कैसे करें?
सही स्पीच-टू-टेक्स्ट AI API का चयन करना तब सबसे अच्छा काम करता है जब निर्णय यह दर्शाते हैं कि वास्तव में आपके सिस्टम और टीमों के माध्यम से ऑडियो कैसे प्रवाहित होता है। सबसे अच्छा API आवश्यक रूप से वह नहीं है जिसकी डेमो सटीकता सबसे अधिक है, बल्कि वह है जो वास्तविक ट्रैफ़िक, बहु-लहजे वाली बातचीत और शोरगुल वाले वातावरण में विश्वसनीय रूप से प्रदर्शन करता है।
सही स्पीच-टू-टेक्स्ट AI API का निर्धारण करने वाले मुख्य निर्णय कारकों में शामिल हैं:
प्राथमिक ऑडियो वर्कफ़्लो: आपके द्वारा संसाधित किए जाने वाले ऑडियो के प्रकार के आधार पर विभिन्न APIs उत्कृष्ट प्रदर्शन करते हैं, लाइव मीटिंग्स, मीडिया संपादन, कॉल सेंटर की बातचीत, या शोध रिकॉर्डिंग, सभी की विलंबता और ट्रांसक्रिप्शन आवश्यकताएं अलग-अलग होती हैं।
ट्रांसक्रिप्शन त्रुटियों के लिए सहनशीलता: कुछ वर्कफ़्लो त्वरित संपादन के साथ मामूली त्रुटियों को सहन कर सकते हैं, जबकि अन्य को जोखिम प्रबंधित करने के लिए शब्द-स्तरीय सटीकता, स्पीकर की पहचान या हाइब्रिड मानव समीक्षा की आवश्यकता होती है।
भाषा और लहजा कवरेज: वैश्विक टीमों या बहु-क्षेत्रीय सामग्री को ऐसे APIs की आवश्यकता होती है जो सटीकता को कम किए बिना कई भाषाओं, क्षेत्रीय लहजे और कोड-स्विचिंग को संभाल सकें।
विलंबता और वास्तविक समय प्रदर्शन: लाइव वर्कफ़्लो के लिए, कम-विलंबता वाली स्ट्रीमिंग महत्वपूर्ण है। यदि ट्रांसक्रिप्ट पीछे रह जाती हैं या अपडेट में देरी होती है, तो अत्यधिक सटीक APIs भी वॉयस सिस्टम को बाधित कर सकते हैं।
लागत और स्केलेबिलिटी: उपयोग-आधारित मूल्य निर्धारण, सदस्यता मॉडल, या पे-एस-यू-गो फीस बड़े पैमाने पर अलग-अलग व्यवहार करते हैं। लंबे समय का या उच्च-मात्रा वाला ट्रांसक्रिप्शन छोटी लागत के अंतर को भी बड़ा कर सकता है।
डेटा संवेदनशीलता और अनुपालन: यदि ऑडियो में संवेदनशील या विनियमित जानकारी है, तो मजबूत डेटा सुरक्षा, प्रतिधारण नियंत्रण और HIPAA या SOC 2 जैसे अनुपालन प्रमाणपत्रों वाले APIs की तलाश करें।
सबसे अच्छा स्पीच-टू-टेक्स्ट AI API बेंचमार्क स्कोर के अनुकूल होने से पहले आपके वर्कफ़्लो के अनुकूल होना चाहिए। आपके ऑडियो प्रकार, वॉल्यूम, विलंबता आवश्यकताओं और जोखिम सहनशीलता की स्पष्ट समझ बाद में महंगी रीवर्किंग को रोकने में मदद करती है।
अंतिम विचार!
जैसे-जैसे कॉल की मात्रा बढ़ती है और अप्रत्याशित परिदृश्य सामने आते हैं, ट्रांसक्रिप्शन टूल जल्द ही कम पड़ सकते हैं। जो समाधान वास्तव में अलग खड़े होते हैं वे वे हैं जो दबाव में विश्वसनीय रहते हैं और लगातार सुधारों के बिना बातचीत को सुचारू रूप से चलाते रहते हैं। इस तरह की निरंतरता परिचालन संबंधी घर्षण को कम करती है और दैनिक वॉयस वर्कफ़्लो में विश्वास पैदा करती है।
वास्तविक समय की वॉयस प्रणालियों का प्रबंधन करने वाली टीमों के लिए, Smallest AI सर्वोत्तम स्पीच-टू-टेक्स्ट AI APIs प्रदान करता है, जिसे लैब परीक्षणों के बजाय प्रोडक्शन वातावरण के लिए डिज़ाइन किया गया है। Pulse STT मांग वाले वॉयस अनुप्रयोगों के लिए कम विलंबता, निरंतर सटीकता और स्केलेबल नियंत्रण प्रदान करता है।
जानें कि लाइव वॉयस वर्कफ़्लो में Pulse कैसा प्रदर्शन करता है Smallest AI टीम से जुड़कर या इसका प्रत्यक्ष परीक्षण करके।
अक्सर पूछे जाने वाले प्रश्न
क्या सर्वश्रेष्ठ स्पीच-टू-टेक्स्ट AI APIs रीयल-टाइम व्यवधानों को अच्छी तरह से संभालते हैं?
विभिन्न लहजों (accents) या बोलियों (dialects) के साथ स्पीच-टू-टेक्स्ट AI APIs कैसा प्रदर्शन करते हैं?
क्या मुफ्त स्पीच-टू-टेक्स्ट AI APIs प्रोडक्शन उपयोग के लिए उपयुक्त हैं?
एक स्पीच-टू-टेक्स्ट ऐप और एक API में क्या अंतर है?
क्या एआई ट्रांसक्रिप्शन एपीआई (APIs) बहु-व्यक्ति बातचीत में वक्ताओं को अलग करने का समर्थन करते हैं?