रैपिडा पर सबसे छोटा एआई: एक स्व-होस्ट करने योग्य वॉयस स्टैक में अपने खुद के स्पीच मॉडल लाएं
Smallest AI अब Rapida पर TTS और STT के लिए उपलब्ध है, जो कम-लेटेंसी वॉइस AI, सेल्फ-होस्टिंग, मॉडल लचीलापन, डायराइजेशन और PII/PCI संपादन की सुविधा प्रदान करता है।
अधिकांश वॉइस एआई प्लेटफॉर्म आपसे अपने डेटा, क्रेडेंशियल्स और डिप्लॉयमेंट के मामले में उन पर भरोसा करने को कहते हैं। रैपिडा (Rapida) इसके विपरीत सवाल पूछता है: क्या होगा अगर आपको ऐसा करने की आवश्यकता ही न पड़े?
Rapida एक ओपन-सोर्स वॉइस एआई ऑर्केस्ट्रेशन प्लेटफॉर्म है जो तीन विचारों के इर्द-गिर्द बनाया गया है: ओनरशिप (इसे मैनेज्ड या सेल्फ-होस्टेड चलाएं, आपका डेटा आपका ही रहेगा), कंट्रोल (अपने खुद के मॉडल और इंटीग्रेशन चुनें, कोई वेंडर लॉक-इन नहीं), और स्केल (वास्तविक वर्कलोड के लिए प्रोडक्शन-ग्रेड ऑब्जर्वेबिलिटी)। यह उस तरह का प्लेटफॉर्म है जिसका उपयोग एजेंसियां अपने ग्राहकों के लिए व्हाइट-लेबल वॉइस प्रोडक्ट्स बनाते समय करती हैं, और एंटरप्राइजेस तब इसका उपयोग करते हैं जब "हमारा कॉल ऑडियो किसी तीसरे पक्ष को भेजें" ऐसा वाक्य न हो जिस पर उनकी अनुपालन (compliance) टीम हस्ताक्षर करने के लिए तैयार हो।
हमें यह साझा करते हुए खुशी हो रही है कि Smallest AI अब Rapida के भीतर TTS और STT प्रोवाइडर के रूप में उपलब्ध है, जिसे सीधे प्रोवाइडर्स और मॉडल्स डैशबोर्ड से कॉन्फ़िगर किया जा सकता है, चाहे आप Rapida को मैनेज्ड चला रहे हों या अपने खुद के इंफ्रास्ट्रक्चर पर सेल्फ-होस्टेड।
यह इंटीग्रेशन क्यों महत्वपूर्ण है
Rapida को Go भाषा में लिखा गया है और रियल-टाइम, द्विदिश (bidirectional) ऑडियो स्ट्रीमिंग के लिए gRPC पर बनाया गया है, जिसका अर्थ है कि इसके पीछे जो भी स्पीच प्रोवाइडर काम कर रहा है, उसे वास्तव में लो-लेटेंसी पाइपलाइन के साथ तालमेल बिठाना होगा। इसका यह भी अर्थ है कि प्रोवाइडर लेयर को उन चीजों के साथ अच्छी तरह से काम करना होगा जिनकी एंटरप्राइज और एजेंसी डिप्लॉयमेंट्स वास्तव में मांग करते हैं: PII रिडक्शन (redaction), स्पीकर डायराइजेशन (diarization), वर्ड-लेवल टाइमस्टैम्प, पंक्चुएशन कंट्रोल; इनमें से कोई भी वैकल्पिक नहीं है जब आप रेगुलेटेड कॉल डेटा संभाल रहे हों या किसी क्लाइंट के लिए ऑडिट-रेडी ट्रांसक्रिप्ट बना रहे हों।
यही वह सतह है जिसे यह इंटीग्रेशन प्रदर्शित करता है। Pulse, WebSocket पर Rapida के रीयल-टाइम STT के रूप में प्लग इन होता है, जिसमें वर्ड और सेंटेंस टाइमस्टैम्प, डायराइजेशन, PII/PCI रिडक्शन, इन्वर्स टेक्स्ट नॉर्मलाइजेशन और पंक्चुएशन फॉर्मेटिंग सभी ऑप्ट-इन टॉगल के रूप में उपलब्ध हैं। Lightning, TTS के रूप में प्लग इन होता है, जिसमें स्टैंडर्ड lightning_v3.1 पूल (वॉइस क्लोनिंग, 12 भाषाएं) और प्रीमियम lightning_v3.1_pro पूल (विशेष रूप से तैयार की गई अमेरिकी, ब्रिटिश और भारतीय अंग्रेजी और हिंदी आवाजें) दोनों को प्रत्येक असिस्टेंट डिप्लॉयमेंट के अनुसार चुना जा सकता है।
चूंकि Rapida व्यवधानों (interruptions) को पाइपलाइन-स्तर के विषय के रूप में देखता है, इसलिए बीच में बोलने (barge-in) पर, यह अगली बारी के लिए TTS कनेक्शन को बंद करता है और फिर से खोलता है, इसलिए Smallest AI की तरफ से किसी कस्टम इंटरप्शन हैंडलिंग की आवश्यकता नहीं होती है। आपको वह लो-लेवल कंट्रोल मिलता है जिसके लिए Rapida बनाया गया है, और इसके लिए आपको खुद से प्लंबिंग तैयार करने की आवश्यकता नहीं होती है।
शुरुआत कैसे करें
सेटअप पूरी तरह से Rapida डैशबोर्ड से होता है, इसके लिए किसी SDK की आवश्यकता नहीं है।
चरण 1: प्रोवाइडर्स और मॉडल्स खोलें
अपने Rapida डैशबोर्ड में, Providers and Models पर जाएं।
चरण 2: Smallest AI क्रेडेंशियल जोड़ें
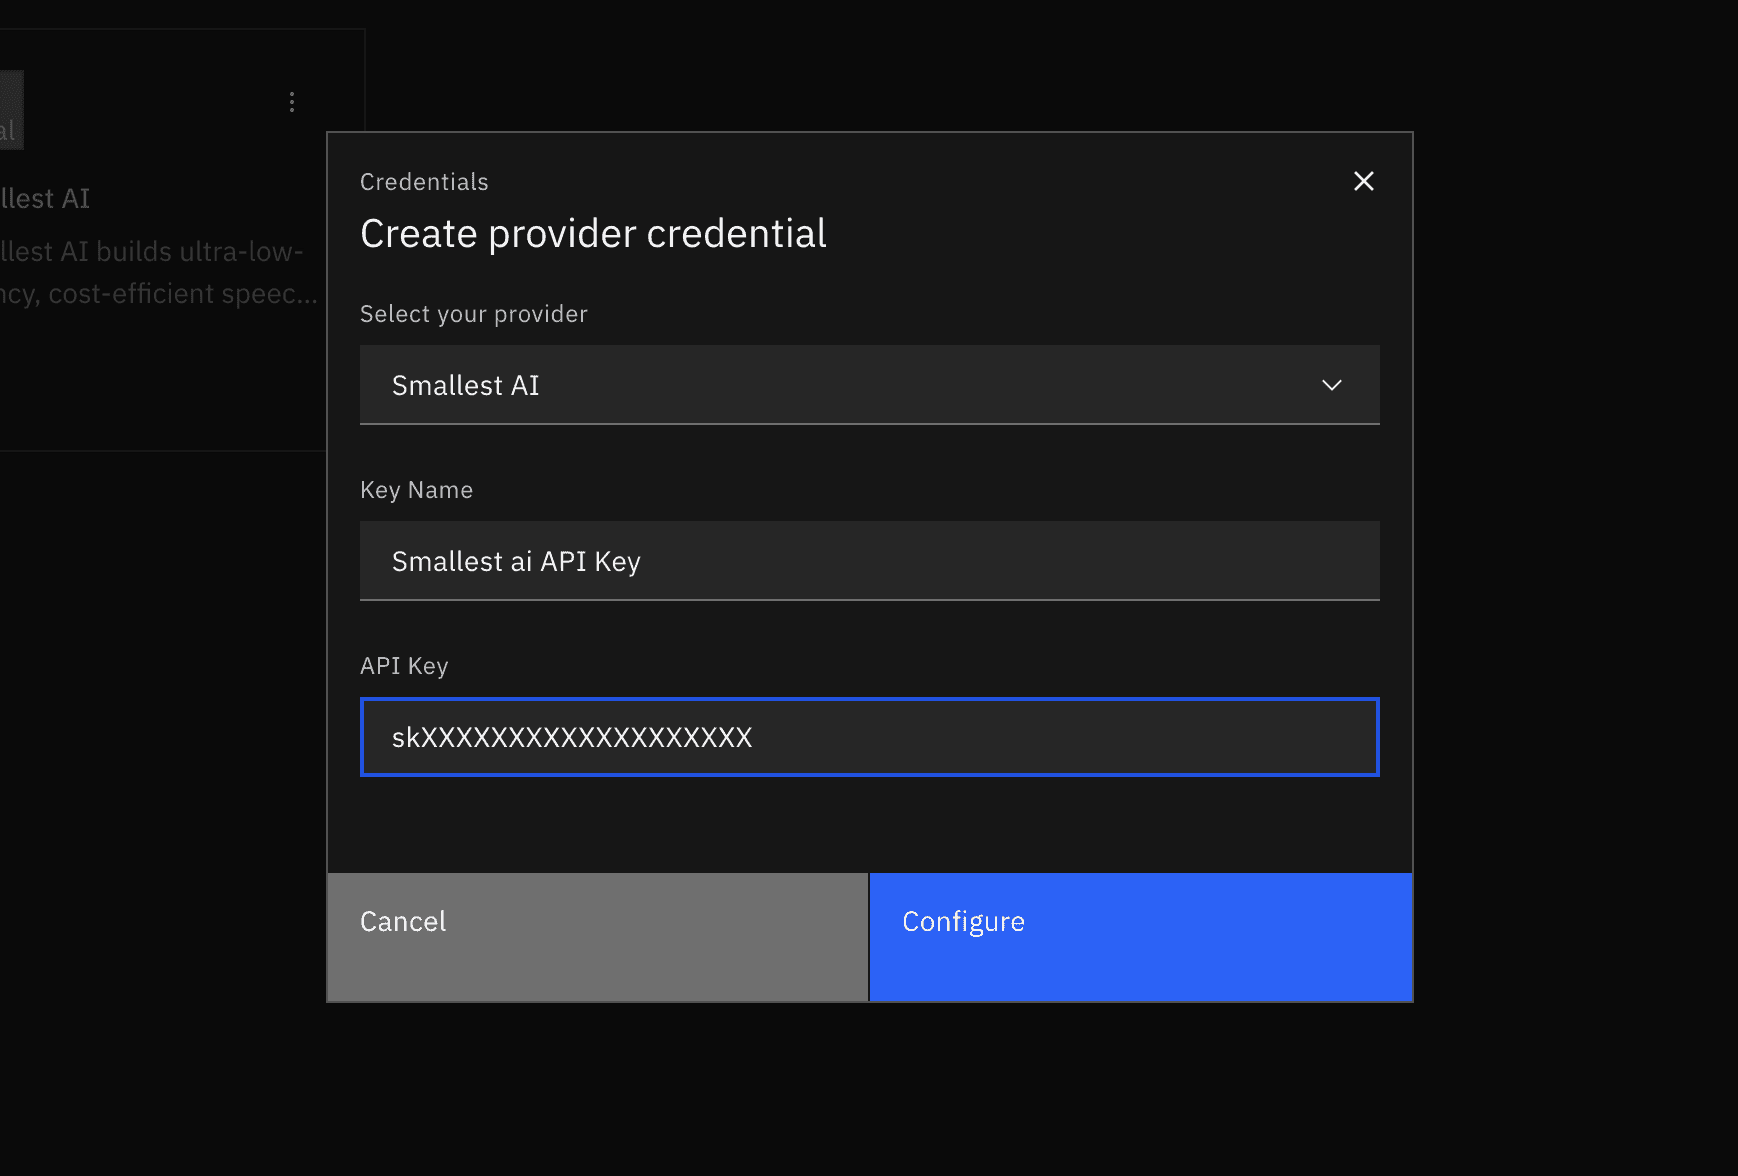
एक नया प्रोवाइडर क्रेडेंशियल जोड़ें, Smallest AI चुनें, और Smallest AI डैशबोर्ड से अपनी API कुंजी पेस्ट करें।
चरण 3: STT कॉन्फ़िगर करें
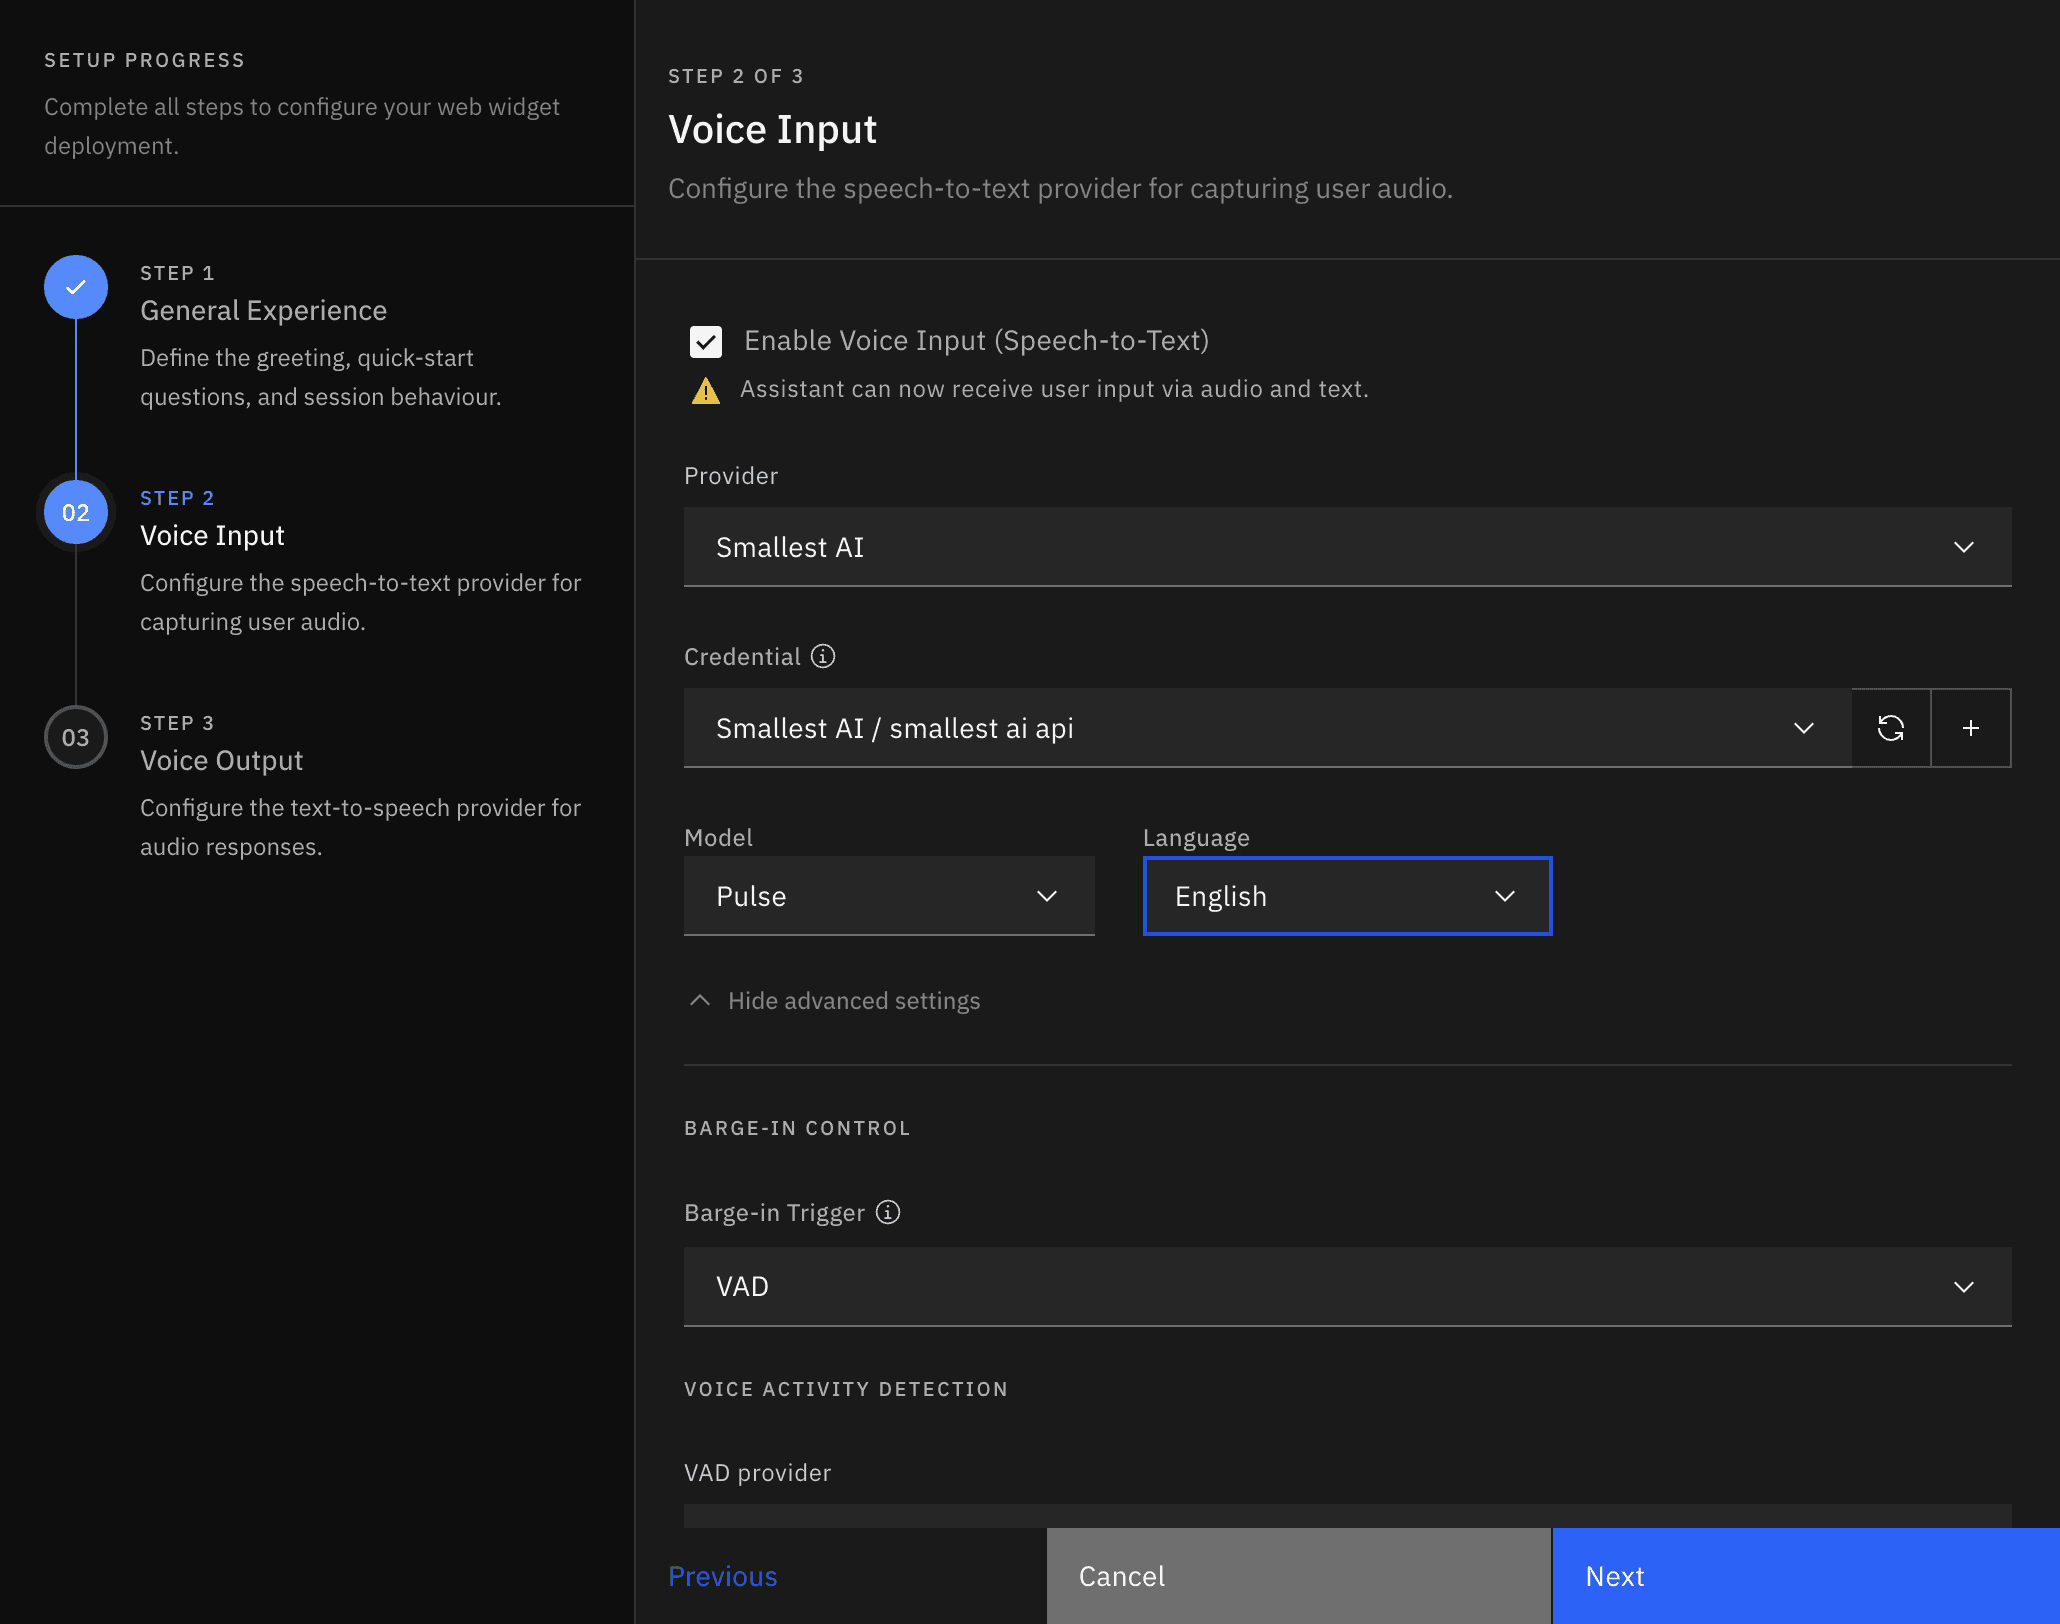
स्पीच-टू-टेक्स्ट प्रोवाइडर को Smallest AI पर सेट करें। मॉडल pulse है, Rapida का इंटीग्रेशन Pulse के रीयल-टाइम WebSocket पर स्ट्रीम करता है, इसलिए pulse-pro (प्री-रिकॉर्डेड, केवल-HTTP संस्करण) यहां उपलब्ध नहीं है। भाषा सेट करें, या ऑटो-डिटेक्ट के लिए इसे खाली छोड़ दें।
वहां से, यदि आपको आवश्यकता हो तो फीचर टॉगल का एक सेट उपलब्ध है: वर्ड और सेंटेंस टाइमस्टैम्प, स्पीकर डायराइजेशन, PII/PCI रिडक्शन, इन्वर्स टेक्स्ट नॉर्मलाइजेशन और पंक्चुएशन फॉर्मेटिंग।
चरण 4: TTS कॉन्फ़िगर करें
अपने असिस्टेंट के डिप्लॉयमेंट पर, टेक्स्ट-टू-स्पीच प्रोवाइडर को Smallest AI पर सेट करें और एक मॉडल चुनें:

lightning_v3.1, स्टैंडर्ड पूल, वॉइस क्लोनिंग समर्थित, 12 भाषाएं (जैसेmagnus,devansh,kartik,maithili,liam,avery, और अन्य आवाजें)lightning_v3.1_pro, अंग्रेजी और हिंदी में अमेरिकी, ब्रिटिश और भारतीय आवाजों के विशेष रूप से तैयार प्रीमियम पूल (जैसेmeher,kaitlyn,blake,sophie,sam,aviraj, और अन्य आवाजें)
वॉइस ड्रॉपडाउन आपके द्वारा चुने गए मॉडल के दायरे में ही काम करता है, यदि आपने lightning_v3.1 चुना है तो प्रो आवाजें दिखाई नहीं देंगी, इसलिए एक गलत मैच वाला जोड़ा ऐसा नहीं है जिसे आप यूजर इंटरफेस (UI) से चुन सकें। भाषा सेट करें, और वैकल्पिक रूप से गति (Speed) को 0.5x और 2.0x के बीच सेट करें।
कॉन्फ़िगरेशन संदर्भ (Reference)
Rapida, STT के लिए प्रोवाइडर विकल्पों को listen.* कुंजियों के रूप में और TTS के लिए speak.* कुंजियों के रूप में सहेजता है।
STT की तरफ, listen.model डिफ़ॉल्ट रूप से pulse पर सेट होता है और यह एकमात्र मॉडल है जो रीयल-टाइम एंडपॉइंट से जुड़ा है। listen.language डिफ़ॉल्ट रूप से ऑटो-डिटेक्ट पर सेट होता है। सात फीचर फ़्लैग, word_timestamps, sentence_timestamps, diarize, redact_pii, redact_pci, numerals, और smart_format, सभी ऑप्ट-इन हैं; Rapida इन्हें Smallest AI को तभी भेजता है जब आप इन्हें स्पष्ट रूप से सेट करते हैं, इसलिए इन्हें ऐसे ही छोड़ देने से डिफ़ॉल्ट व्यवहार में कोई बदलाव नहीं होता है।
TTS की तरफ, speak.model डिफ़ॉल्ट रूप से lightning_v3.1 पर, speak.voice.id डिफ़ॉल्ट रूप से magnus पर, speak.language डिफ़ॉल्ट रूप से en पर, और speak.speed डिफ़ॉल्ट रूप से 0.5-2.0 की सीमा के साथ 1.0 पर सेट होता है।
कुछ महत्वपूर्ण बातें जो जानने योग्य हैं
Rapida, TTS अनुरोधों को Smallest AI के स्ट्रीमिंग WebSocket एंडपॉइंट पर भेजता है, और STT अनुरोधों को Pulse के रीयल-टाइम WebSocket एंडपॉइंट पर भेजता है।
बीच में बोलने (Barge-in) को पाइपलाइन स्तर पर संभाला जाता है: Rapida रुकावट आने पर TTS कनेक्शन को बंद और पुन: खोलता है, इसलिए आपको स्वयं रुकावट हैंडल करने का लॉजिक बनाने की आवश्यकता नहीं है।
यदि कोई असमर्थित वॉइस/मॉडल कॉम्बिनेशन भेजा जाता है, मान लीजिए,
lightning_v3.1के तहत टाइप की गई केवल-प्रो वॉइस, तो Rapida अटकने के बजाय उसे उस बारी पर एक त्रुटि (error) के रूप में दिखाता है। डैशबोर्ड का मॉडल-स्कोप्ड ड्रॉपडाउन इससे बचने का मुख्य उपाय है; यह केवल फ्री-टाइप की गई वॉइस आईडी के लिए बैकअप है।
आप क्या बना सकते हैं?
Rapida और Smallest AI का मेल उन टीमों के लिए एकदम सही है जिन्हें अपनी वॉइस क्वालिटी के साथ-साथ अपने वॉइस स्टैक पर ओनरशिप की भी आवश्यकता होती है:
एजेंसी ग्राहकों के लिए व्हाइट-लेबल वॉइस एजेंट, जो आपके अपने इंफ्रास्ट्रक्चर के तहत सेल्फ-होस्टेड हों
PII/PCI रिडक्शन और डायराइज्ड, ऑडिट-रेडी ट्रांसक्रिप्ट के साथ रेगुलेटेड-इंडस्ट्री कॉल हैंडलिंग
अंग्रेजी, हिंदी और 10+ अन्य भाषाओं में बहुभाषी (Multilingual) असिस्टेंट
आंतरिक वॉइस टूलिंग जहां डेटा रेजिडेंसी और वेंडर कंट्रोल वास्तव में मायने रखते हैं
स्पीच क्वालिटी से समझौता किए बिना, अपने स्टैक के मालिक बनें
यदि आपके डिप्लॉयमेंट पर नियंत्रण ही वह समझौता रहा है जिसने आपको अधिक तेज या अधिक स्वाभाविक लगने वाले वॉइस मॉडल का उपयोग करने से रोका है, तो यह इंटीग्रेशन उस समझौते को समाप्त कर देता है। इसे Rapida डैशबोर्ड में एक बार कॉन्फ़िगर करें, और Pulse तथा Lightning उस वातावरण के भीतर चलेंगे जिस पर आपने भरोसा करना चुना है।
इंटीग्रेशन से जुड़ी समस्याओं के लिए, Rapida रिपॉजिटरी पर एक समस्या (issue) दर्ज करें या Discord पर हमसे संपर्क करें।
अक्सर पूछे जाने वाले प्रश्न
रैपिडा (Rapida) के साथ सबसे छोटा एआई (AI) एकीकरण क्या है?
क्या मैं स्पीच प्रोवाइडर के रूप में Smallest AI के साथ Rapida को सेल्फ-होस्ट कर सकता हूँ?
रैपिडा (Rapida) किन सबसे छोटे एआई (AI) मॉडल्स का समर्थन करता है?
क्या मुझे एसटीटी (STT) और टीटीएस (TTS) दोनों के लिए Smallest AI का उपयोग करने की आवश्यकता है?
क्या रैपिडा (Rapida), स्मॉलेस्ट एआई (Smallest AI) के एसटीटी (STT) के साथ पीआईआई (PII) या पीसीआई (PCI) रिडैक्शन का समर्थन करता है?
यदि मैं एक असमर्थित आवाज़ और मॉडल संयोजन चुनता हूँ तो क्या होगा?
