Smallest.ai Pulse STT और Lightning TTS का उपयोग करके रीयल-टाइम LiveKit वॉइस AI सेटअप, कोड के साथ, स्ट्रीमिंग पाइपलाइन नोट्स, और प्रोडक्शन की कमियां।
एक लाइवकिट (LiveKit) वॉयस एआई एजेंट बनाना जो बेहद तेज़ और सुचारू लगे, आरेखों (diagrams) के सुझावों की तुलना में कहीं अधिक कठिन है। लाइवकिट आपको बुनियादी ढांचा तो दे देता है, लेकिन आपके एसटीटी (STT) और टीटीएस (TTS) विकल्प ही यह तय करते हैं कि परिणाम एक वास्तविक बातचीत की तरह सुनाई देगा या फिर बफ़रिंग की समस्या वाले किसी उबाऊ फ़ोन ट्री की तरह। नीचे संपूर्ण एकीकरण (end-to-end integration) दिया गया है: कैसे एजेंट्स पाइपलाइन को तैयार किया जाता है, कैसे Smallest.ai के पल्स (Pulse - STT) और लाइटनिंग (Lightning - TTS) को जोड़ा जाता है, और वे व्यावहारिक निर्णय जो एक साधारण डेमो को एक बेहतरीन प्रोडक्ट में बदल देते हैं।
यह उन डेवलपर्स के लिए है जिन्हें पायथन (Python) और एपीआई (API) की बुनियादी समझ है। यदि आपके पास पहले से ही लाइवकिट रूम चल रहा है, तो आप सीधे शुरुआत कर सकते हैं। यदि लाइवकिट एजेंट्स आपके लिए नए हैं, तो आगे बढ़ने से पहले लाइवकिट एजेंट्स क्विकस्टार्ट 10 मिनट का एक बेहतरीन सेटअप गाइड है।
लाइवकिट एजेंट्स वास्तव में कैसे काम करते हैं
लाइवकिट (LiveKit) रीयल-टाइम वॉयस, वीडियो और फिजिकल एआई एजेंट्स के लिए एक ओपन-सोर्स फ्रेमवर्क और डेवलपर प्लेटफॉर्म है (लाइवकिट, 2026)। लाइवकिट एजेंट्स GitHub पर Apache 2.0 लाइसेंस के तहत उपलब्ध है, और आप अपने खुद के इंफ्रास्ट्रक्चर पर भी इस पूरे स्टैक को चला सकते हैं। यह उन टीमों के लिए एक व्यावहारिक जीत है जो डेटा रेसिडेंसी नियमों, तंग बजट, या ऐसी किसी भी स्थिति से निपट रही हैं जहाँ होस्टेड इन्फरेंस का उपयोग करना संभव नहीं है।
मूल रूप से, एजेंट्स एक तीन-चरणीय स्ट्रीमिंग पाइपलाइन है। एक उपयोगकर्ता कमरे में बोलता है, ऑडियो स्ट्रीम एक एसटीटी मॉडल को फीड की जाती है जो टेक्स्ट उत्सर्जित करता है, उस टेक्स्ट को प्रतिक्रिया के लिए एक एलएलएम (LLM) के पास भेजा जाता है, और प्रतिक्रिया को एक टीटीएस मॉडल को सौंप दिया जाता है जो वापस कमरे में बोलता है (लाइवकिट, 2026)। महत्वपूर्ण विवरण यह है कि ये चरण आपस में ओवरलैप होते हैं: प्रत्येक चरण पूरी तरह से समाप्त परिणाम की प्रतीक्षा करने के बजाय आंशिक आउटपुट को आगे स्ट्रीम करता है। इस तरह आपको एक सेकंड से भी कम की विलंबता (latency) मिलती है, और यही कारण है कि रीयल-टाइम एजेंट्स के लिए स्ट्रीमिंग टीटीएस बेहद आवश्यक है। यदि आप इसके वैचारिक तर्क को विस्तार से समझना चाहते हैं, तो स्ट्रीमिंग आर्किटेक्चर क्यों गैर-परक्राम्य है इसे स्पष्ट रूप से समझाता है।
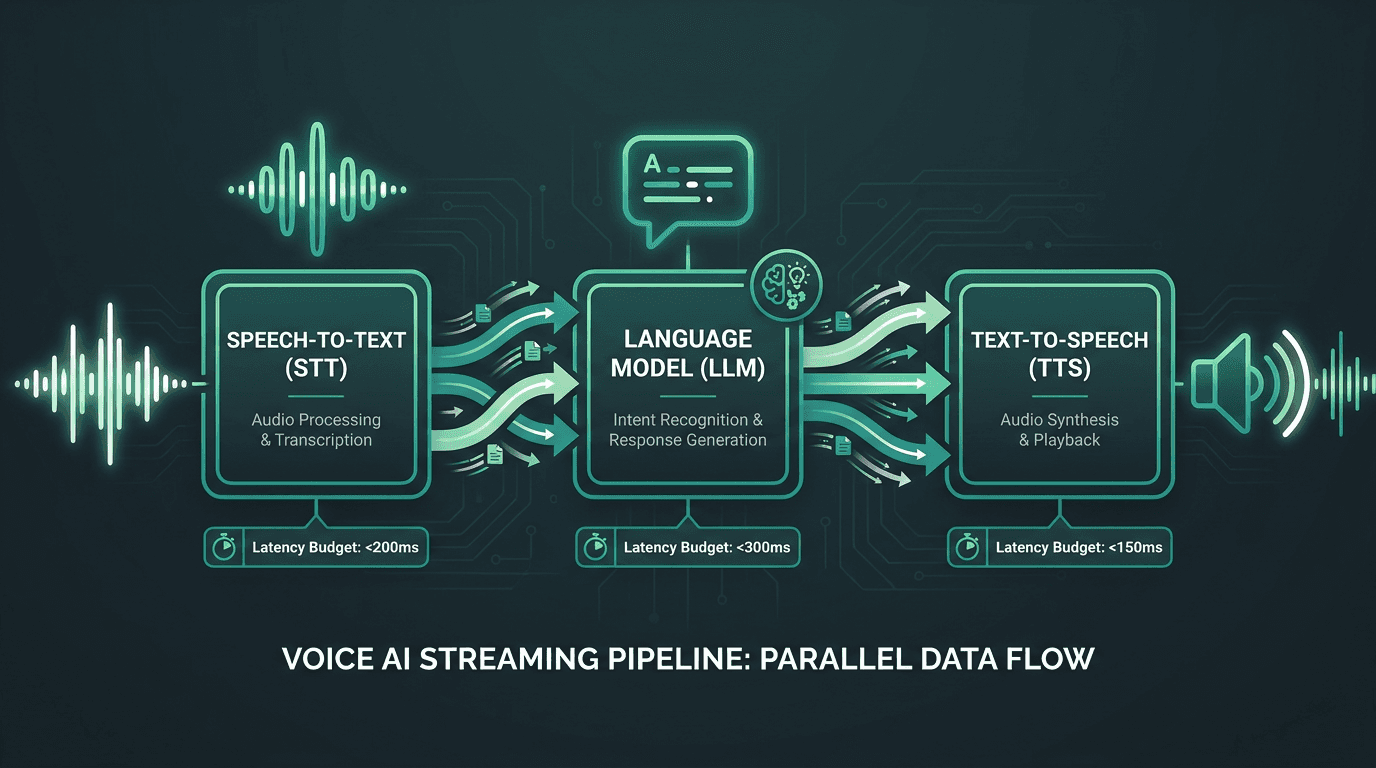
लाइवकिट एजेंट्स पाइपलाइन के तीनों चरणों को एक साथ ओवरलैप करते हैं, जिससे महसूस होने वाली विलंबता एक सेकंड से कम बनी रहती है।
लाइवकिट आपको मॉडल को उस पाइपलाइन में जोड़ने के दो तरीके देता है। आप लाइवकिट इन्फरेंस (उनकी होस्टेड लेयर) के माध्यम से रूट कर सकते हैं, या आप किसी भी चरण में तीसरे पक्ष के प्रदाताओं को बदलने के लिए प्लगइन सिस्टम का उपयोग कर सकते हैं (लाइवकिट, 2026)। Smallest.ai एसटीटी और टीटीएस दोनों के लिए प्लगइन्स प्रदान करता है, और यही एकीकरण पथ यहाँ कवर किया गया है।
अपना वातावरण सेट करना (Setting Up Your Environment)
इससे पहले कि आप एजेंट कोड लिखें, तीन बुनियादी चीजें तैयार कर लें: एक लाइवकिट क्लाउड अकाउंट (या आपका अपना लाइवकिट सर्वर), एक Smallest.ai एपीआई कुंजी (API key), और पायथन 3.10+। लाइवकिट एजेंट्स पायथन एसडीके और Smallest.ai प्लगइन दोनों ही pip के साथ आसानी से इंस्टॉल हो जाते हैं।
शुरुआती सरलता: Smallest.ai प्लगइन पल्स (STT) और लाइटनिंग (TTS) दोनों को कवर करता है, इसलिए आप पाइपलाइन के प्रत्येक हिस्से के लिए अलग-अलग डिपेंडेंसी को संभालने की उलझन से बच जाते हैं। वर्तमान प्लगइन संस्करणों और मॉडल मापदंडों के लिए Smallest.ai दस्तावेज़ों पर नज़र रखें; नए मॉडल आने पर वॉयस आईडी और भाषा कोड बदलते रहते हैं।
स्पीच-टू-टेक्स्ट के लिए पल्स (Pulse) को जोड़ना
पल्स (Pulse) Smallest.ai का रीयल-टाइम एसटीटी मॉडल है। यह लाइवकिट एसटीटी मॉडल दस्तावेज़ में एक समर्थित प्रदाता के रूप में दिखाई देता है, जिसका अर्थ है कि आप एक ऐसे एकीकरण के साथ काम कर रहे हैं जिसे लाइवकिट ने मान्यता दी है और उम्मीद करता है कि लोग इसे चलाएं। प्रोडक्शन टीमों के लिए, यह कोई साधारण विवरण नहीं है; यह एक संकेत है कि इसकी अनुकूलता (compatibility) को बनाए रखा जा रहा है।
यहाँ ट्रांसक्रिप्शन के लिए पल्स का उपयोग करने वाली एक न्यूनतम एजेंट परिभाषा दी गई है:
उस कोड स्निपेट पर कुछ व्यावहारिक बातें। smallest.STT एक model तर्क लेता है, जहाँ आप वह पल्स संस्करण चुनते हैं जिसे आप चलाना चाहते हैं। smallest.TTS एक voice_id लेता है, जो लाइटनिंग की आवाज़ों में से एक को मैप करता है। दोनों ही मामलों में, प्लगइन स्वचालित रूप से SMALLEST_API_KEY से क्रेडेंशियल प्राप्त कर लेता है। यदि आप प्रतिबद्ध होने से पहले आंकड़ों के साथ प्रदाता की पसंद की जांच करना चाहते हैं, तो वास्तविक-विश्व एसटीटी विलंबता बेंचमार्क पोस्ट वास्तविक परिस्थितियों में ट्रांसक्रिप्शन गति पर केंद्रित है।
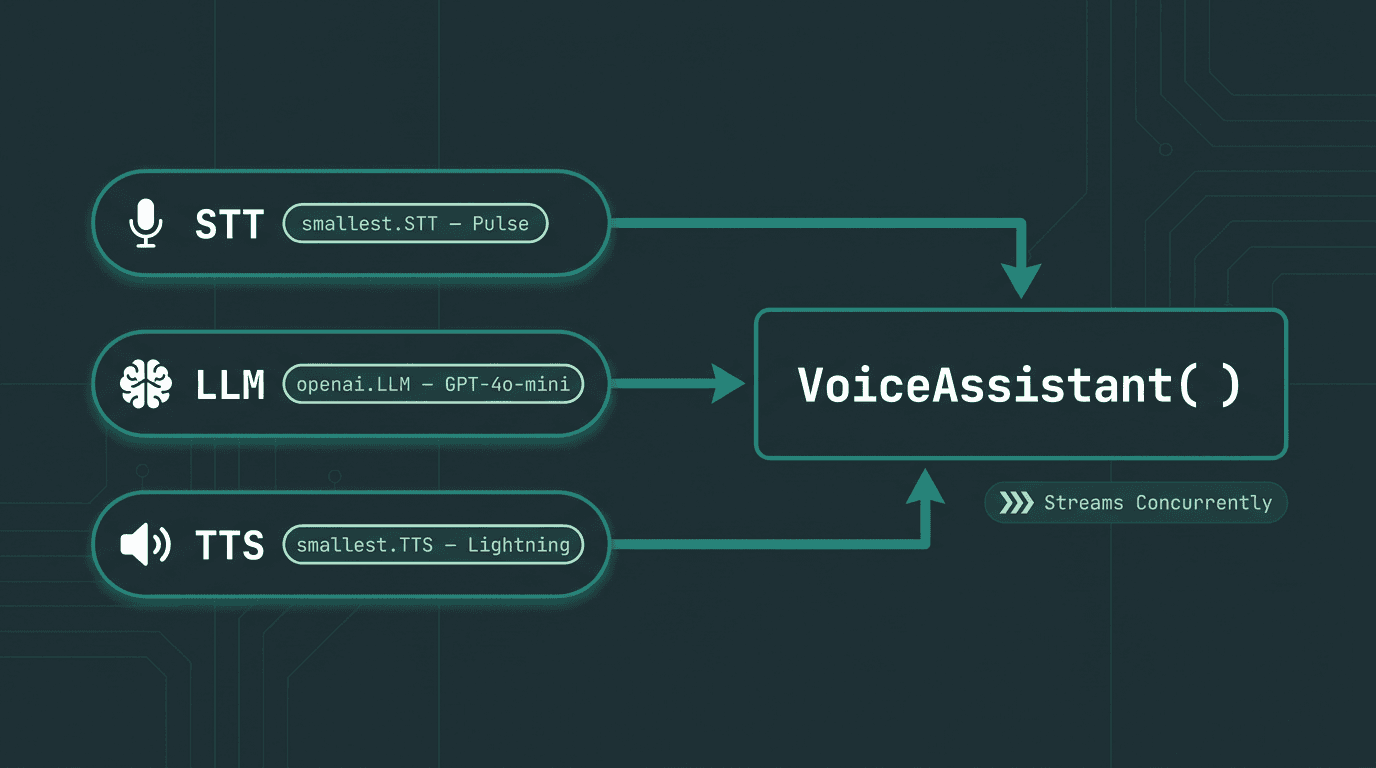
तीनों प्रदाता — पल्स एसटीटी (Pulse STT), ओपनएआई एलएलएम (OpenAI LLM), और लाइटनिंग टीटीएस (Lightning TTS) — समवर्ती स्ट्रीमिंग चरणों के रूप में सीधे वॉयस असिस्टेंट कंस्ट्रक्टर में पास किए जाते हैं।
कम-विलंबता वाले स्पीच सिंथेसिस के लिए लाइटनिंग टीटीएस जोड़ना
टीटीएस वह जगह है जहाँ बहुत से वॉयस एजेंट्स चुपचाप विफल हो जाते हैं। आपके पास बेहतरीन रिकग्निशन और एक स्मार्ट एलएलएम हो सकता है, लेकिन अगर आपके सिंथेसाइज़र को पहला श्रव्य हिस्सा (audible chunk) बनाने में 800ms का समय लगता है, तो उपयोगकर्ताओं को सिस्टम अभी भी धीमा ही लगेगा। लाइटनिंग को स्ट्रीमिंग सिंथेसिस के लिए बनाया गया है: यह पूरे वाक्य की प्रतीक्षा करने के बजाय आंशिक टेक्स्ट से ऑडियो उत्सर्जित करना शुरू कर देता है, जो कि बिल्कुल वैसा ही व्यवहार है जिसके लिए लाइवकिट पाइपलाइन को डिज़ाइन किया गया है (लाइवकिट, 2026)।
लाइवकिट टीटीएस मॉडल दस्तावेज़ स्ट्रीमिंग इंटरफ़ेस का वर्णन करता है: जैसे ही एलएलएम टेक्स्ट जनरेट करता है, फ्रेमवर्क टेक्स्ट चंक्स को टीटीएस में भेजता है। लाइटनिंग का स्ट्रीमिंग एपीआई सीधे उस अनुबंध के अनुकूल है। क्या समर्थित है (और कौन सी आवाजें उपलब्ध हैं) के पैरामीटर-दर-पैरामीटर विवरण के लिए, Smallest.ai का लाइवकिट एकीकरण पृष्ठ इस विशिष्ट पेयरिंग के लिए सबसे संपूर्ण संदर्भ है।
यदि आपके उत्पाद को एक विशिष्ट व्यक्तित्व (persona) की आवश्यकता है, तो लाइटनिंग वेव्स एपीआई (Waves API) के माध्यम से वॉयस क्लोनिंग का भी समर्थन करता है। आप एक क्लोन की गई आवाज़ बनाते हैं, फिर परिणामी voice_id को smallest.TTS में पास करते हैं। बहुभाषी रोलआउट के लिए, लाइटनिंग v2 बहुभाषी टीटीएस मॉडल मूल्यांकन समर्थित भाषाओं और उनमें स्वाभाविकता कैसे बनी रहती है, इसका विश्लेषण करता है।
प्रत्येक पाइपलाइन चरण के लिए प्रदाता विकल्पों की तुलना करना
चरण (Stage) | प्रदाता (Provider) | लाइवकिट प्लगइन समर्थन | स्ट्रीमिंग | उल्लेखनीय ताकत |
|---|---|---|---|---|
STT | Smallest.ai Pulse | हाँ (आधिकारिक) | हाँ | कम प्रथम-टोकन विलंबता, बहुभाषी |
STT | अन्य प्रदाता | भिन्न होता है | भिन्न होता है | प्रदाता पर निर्भर करता है |
TTS | Smallest.ai Lightning | हाँ (आधिकारिक) | हाँ | कम-विलंबता स्ट्रीमिंग सिंथेसिस, वॉयस क्लोनिंग |
TTS | अन्य प्रदाता | भिन्न होता है | भिन्न होता है | प्रदाता पर निर्भर करता है |
LLM | कोई भी OpenAI-संगत | हाँ | हाँ | विस्तृत मॉडल विकल्प |
यदि आप इस बारे में पूरी जानकारी चाहते हैं कि इस एकीकरण को कैसे लागू किया गया और आधिकारिक लिस्टिंग का क्या अर्थ है, तो Smallest.ai लाइवकिट के प्लगइन इकोसिस्टम में शामिल हुआ में इसके तकनीकी विवरण मौजूद हैं। जब आप ट्रांसक्रिप्शन गुणवत्ता और गति की तुलना कर रहे हों, तो यह पल्स एसटीटी बनाम डीपग्राम (Pulse STT vs Deepgram) तुलना के साथ अच्छी तरह से मेल खाता है, जो प्रदर्शन डेटा पर आधारित है।
प्रोडक्शन से जुड़ी वे बातें जिन पर अधिकांश गाइड ध्यान नहीं देते
एक डेमो ज्यादातर केवल वायर फ्रेमवर्क को जोड़ना होता है। प्रोडक्शन वह जगह है जहाँ वास्तविक मुश्किलें सामने आती हैं और जाने का नाम नहीं लेतीं। ये वे मुद्दे हैं जो लॉन्च के रास्ते में टीमों को बार-बार परेशान करते हैं।
एंडपॉइंटिंग और टर्न डिटेक्शन (Endpointing and turn detection): लाइवकिट एजेंट्स में वॉयस एक्टिविटी डिटेक्शन (VAD) शामिल है ताकि यह तय किया जा सके कि उपयोगकर्ता ने एसटीटी में ऑडियो भेजने से पहले बोलना कब बंद कर दिया है। शांत कमरों में डिफ़ॉल्ट सेटिंग्स ठीक काम करती हैं, लेकिन वास्तविक उपयोगकर्ता बीच में रुकते हैं, दोबारा शुरू करते हैं, और पृष्ठभूमि के शोर के बीच बात करते हैं। यही वह जगह है जहाँ min_endpointing_delay और max_endpointing_delay की ट्यूनिंग काम आती है। यदि यह बहुत आक्रामक है तो आप लोगों की बात को बीच में ही काट देंगे; और यदि बहुत सुस्त है तो एजेंट इतनी देर तक शांत रहेगा कि वह खराब महसूस होने लगेगा।
बीच में टोकने को संभालना (Interruption handling): लोग बीच में टोकते हैं। आपके एजेंट को इसे एक सामान्य व्यवहार के रूप में लेना चाहिए, न कि एक त्रुटि (error) के रूप में। लाइवकिट का VoiceAssistant बीच में टोकने (barge-in) का समर्थन करता है: जब उपयोगकर्ता तब बोलना शुरू करता है जब एजेंट बोल रहा होता है, तो वर्तमान टीटीएस प्लेबैक रद्द हो जाता है और पाइपलाइन फिर से शुरू हो जाती है। यह डिफ़ॉल्ट रूप से सक्षम होता है, लेकिन फिर भी आपको एक ऐसे टीटीएस प्रदाता की आवश्यकता होती है जो स्ट्रीम्स को साफ-सफाई से रद्द कर सके। लाइटनिंग इसका समर्थन करता है, और आपको अभी भी उन आवाज़ों और वाक्यों के साथ इसका परीक्षण करना चाहिए जिनका आपका उत्पाद वास्तव में उपयोग करता है।
त्रुटि सुधार और फ़ॉलबैक (Error recovery and fallback): आपको अपने वर्कर और एसटीटी/टीटीएस एपीआई के बीच नेटवर्क की समस्याएँ देखने को मिलेंगी। इसके लिए पहले से योजना बनाएं। एक्सपोनेंशियल बैकऑफ़ के साथ पुनः प्रयासों (retries) का उपयोग करें, और यदि आपका प्राथमिक एंडपॉइंट अनुपलब्ध है तो फ़ॉलबैक टीटीएस आवाज़ पर विचार करें। कम-विलंबता वाली वॉयस बातचीत कैसे बनाएं लेख रीयल-टाइम वॉयस फ़्लो के लिए लचीलेपन के पैटर्न पर गहराई से बात करता है।
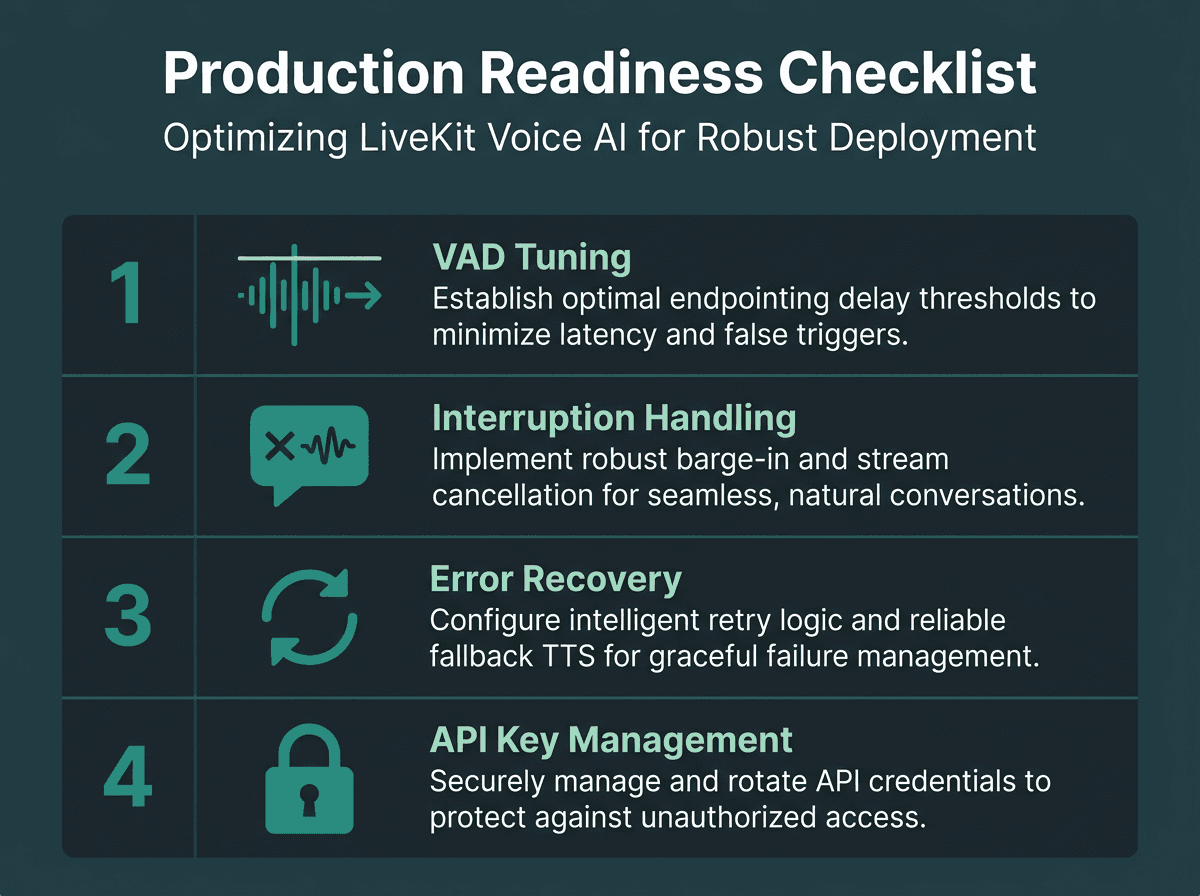
चार लाइवकिट वॉयस एआई चेक्स जिन्हें अधिकांश ट्यूटोरियल छोड़ देते हैं — लेकिन प्रोडक्शन डिप्लॉयमेंट में जिनकी सख्त आवश्यकता होती है।
उन्नत: मल्टी-टर्न संदर्भ और एजेंट स्थिति (Multi-Turn Context and Agent State)
सिंगल-टर्न एजेंट्स ज्यादातर विलंबता का अभ्यास होते हैं। मल्टी-टर्न एजेंट्स मेमोरी (मेमोरी प्रबंधन) की समस्या होते हैं। डिफ़ॉल्ट रूप से, लाइवकिट का VoiceAssistant एलएलएम को पूरी बातचीत का इतिहास भेजता है, जो तब तक काम करता है जब तक कि सत्र संदर्भ विंडो (context window) पर दबाव डालने के लिए पर्याप्त लंबा न हो जाए। व्यवहार में, दो पैटर्न अधिकांश वास्तविक डिप्लॉयमेंट को कवर करते हैं।
पहला: एक स्लाइडिंग विंडो (sliding window)। अंतिम N टर्न रखें और बाकी को छोड़ दें। इसे लागू करना आसान है और यह आमतौर पर उन सहायता और सहायक परिदृश्यों के अनुकूल होता है जहाँ सबसे हालिया बातचीत सबसे अधिक मायने रखती है। दूसरा: समय-समय पर संक्षेपण (periodic summarization)। हर K टर्न पर, एलएलएम से अब तक की बातचीत का सारांश देने के लिए कहें, फिर मूल ट्रांसक्रिप्ट इतिहास को उस सारांश के साथ बदलें। आप पूरे चैट लॉग के पूर्ण टोकन लागत का भुगतान किए बिना शब्दार्थ को बनाए रखते हैं।
मुख्य बातें और अगले कदम
लाइवकिट आपको रीयल-टाइम वॉयस एआई के लिए एक मजबूत ओपन-सोर्स आधार देता है, और प्लगइन सिस्टम आपको एसटीटी या टीटीएस के लिए किसी एक वेंडर तक सीमित होने से बचाता है। यदि आप एक मानसिक मॉडल को अपनाते हैं, तो इसे इस तरह समझें: स्ट्रीमिंग ही असली उत्पाद है। जब प्रत्येक चरण आंशिक परिणामों को तेज़ी से उत्सर्जित करता है, तो एजेंट संवेदनशील महसूस होता है, भले ही इसके पीछे के मॉडल वास्तविक काम कर रहे हों।
इस गाइड में जो कुछ भी कवर किया गया है उसका संक्षिप्त विवरण:
लाइवकिट एजेंट्स एक समवर्ती (concurrent) STT-LLM-TTS स्ट्रीमिंग पाइपलाइन का उपयोग करते हैं, न कि क्रमिक (sequential) पाइपलाइन का
Smallest.ai के पल्स और लाइटनिंग समर्थित प्लगइन एकीकरण हैं जो लाइवकिट दस्तावेज़ों में सूचीबद्ध हैं
स्ट्रीमिंग टीटीएस सिंथेसिस (फर्स्ट-चंक्स लेटेंसी) महसूस होने वाली संवेदनशीलता के लिए कुल जनरेशन समय से अधिक मायने रखती है
प्रोडक्शन डिप्लॉयमेंट को वीएडी ट्यूनिंग, बीच में टोकने (barge-in) और त्रुटि सुधार के लिए स्पष्ट हैंडलिंग की आवश्यकता होती है
मल्टी-टर्न संदर्भ प्रबंधन एक डिज़ाइन निर्णय है, न कि कोई डिफ़ॉल्ट व्यवहार जिसे आप अनदेखा कर सकें
अधिकांश टीमें पहले डेमो में विफल नहीं होती हैं। वे बाद में लड़खड़ाती हैं, जब उपयोगकर्ता एजेंट को एक तकनीकी वस्तु के बजाय एक संवादी भागीदार के रूप में आंकना शुरू करते हैं। वह अंतर काफी हद तक विलंबता (latency) का होता है, विशेष रूप से एसटीटी और टीटीएस पर। Smallest.ai पल्स और लाइटनिंग को सीधे उस पर प्रहार करने के लिए तैनात करता है: लाइटनिंग का कम-विलंबता वाला स्ट्रीमिंग सिंथेसिस पहले टेक्स्ट चंक से ऑडियो बनाना शुरू करता है, और पल्स को लाइवकिट की अपेक्षा के अनुरूप स्ट्रीमिंग-फर्स्ट सेटअप में रीयल-टाइम ट्रांसक्रिप्शन के लिए ट्यून किया गया है। जब आप प्रोटोटाइप से प्रोडक्शन की ओर बढ़ने के लिए तैयार हों, तो एपीआई संदर्भों, समर्थित वॉयस आईडी और भाषा कवरेज के लिए Smallest.ai का लाइवकिट एकीकरण पृष्ठ सबसे अच्छा शुरुआती बिंदु है।
क्या Smallest.ai एक आधिकारिक LiveKit प्लगइन है, या सिर्फ एक कम्युनिटी इंटीग्रेशन?
LiveKit में Pulse STT और Lightning TTS के साथ मुझे कितने एंड-टू-एंड लेटेंसी (विलंबता) की उम्मीद करनी चाहिए?
क्या Lightning, LiveKit एजेंट के अंदर क्लोन की गई आवाज़ का उपयोग कर सकता है?
क्या लाइवकिट एजेंट्स (LiveKit Agents) का उपयोग करना मुफ्त है?
पल्स (Pulse) रीयल-टाइम ट्रांसक्रिप्शन के लिए किन भाषाओं का समर्थन करता है?